AI LAB
2026/09/28
Sarvam AIが「Saaras V4」を公開、インド22言語と英語の音声認識を業務向けに強化
インド向け音声業務を左右する、言語と表記への対応
インドの顧客との通話を文字に起こすとき、課題になるのは音声の聞き取りだけではありません。地域ごとに異なる言語を識別し、会話に混ざる英語の製品名を残し、後続の業務で扱える表記に整える必要があります。Sarvam AIが公開した音声認識モデル「Saaras V4」は、こうした多言語環境での利用を意識したサービスです。インドの憲法上の指定言語22言語すべてと英語に対応し、英語については世界各地のアクセントも対象にしています。この「22言語」は、インドで話される言語のすべてを意味するわけではありません。制度上指定された言語の範囲を示しています。それでも、複数地域の顧客対応を担う企業にとって、同じモデルでこれらの言語を扱える点は、導入候補を検討する際の判断材料になるでしょう。日本語への対応は、今回示された対応範囲には含まれていません。
企業が注目したいのは、対応言語の数に加え、認識した内容の出力形式まで選べる設計です。Saaras V4には、通常の文字起こし、発話に忠実な記録、英語が混ざる会話への対応など、五つの出力モードがあります。同じ録音でも、応対内容の検索に使うのか、発話そのものを確認するのかによって、必要なテキストは異なります。
インドに拠点や顧客を持つ日本企業にとっては、「何言語を認識できるか」と「認識結果をどの業務に渡せるか」を一緒に評価する製品と捉えると分かりやすいでしょう。ただし、Sarvam AIが掲げる精度は同社の評価に基づきます。広い言語対応が、そのまま自社の通話での認識品質を保証するわけではありません。
音声の特徴を圧縮し、30億パラメータのモデルで文章化
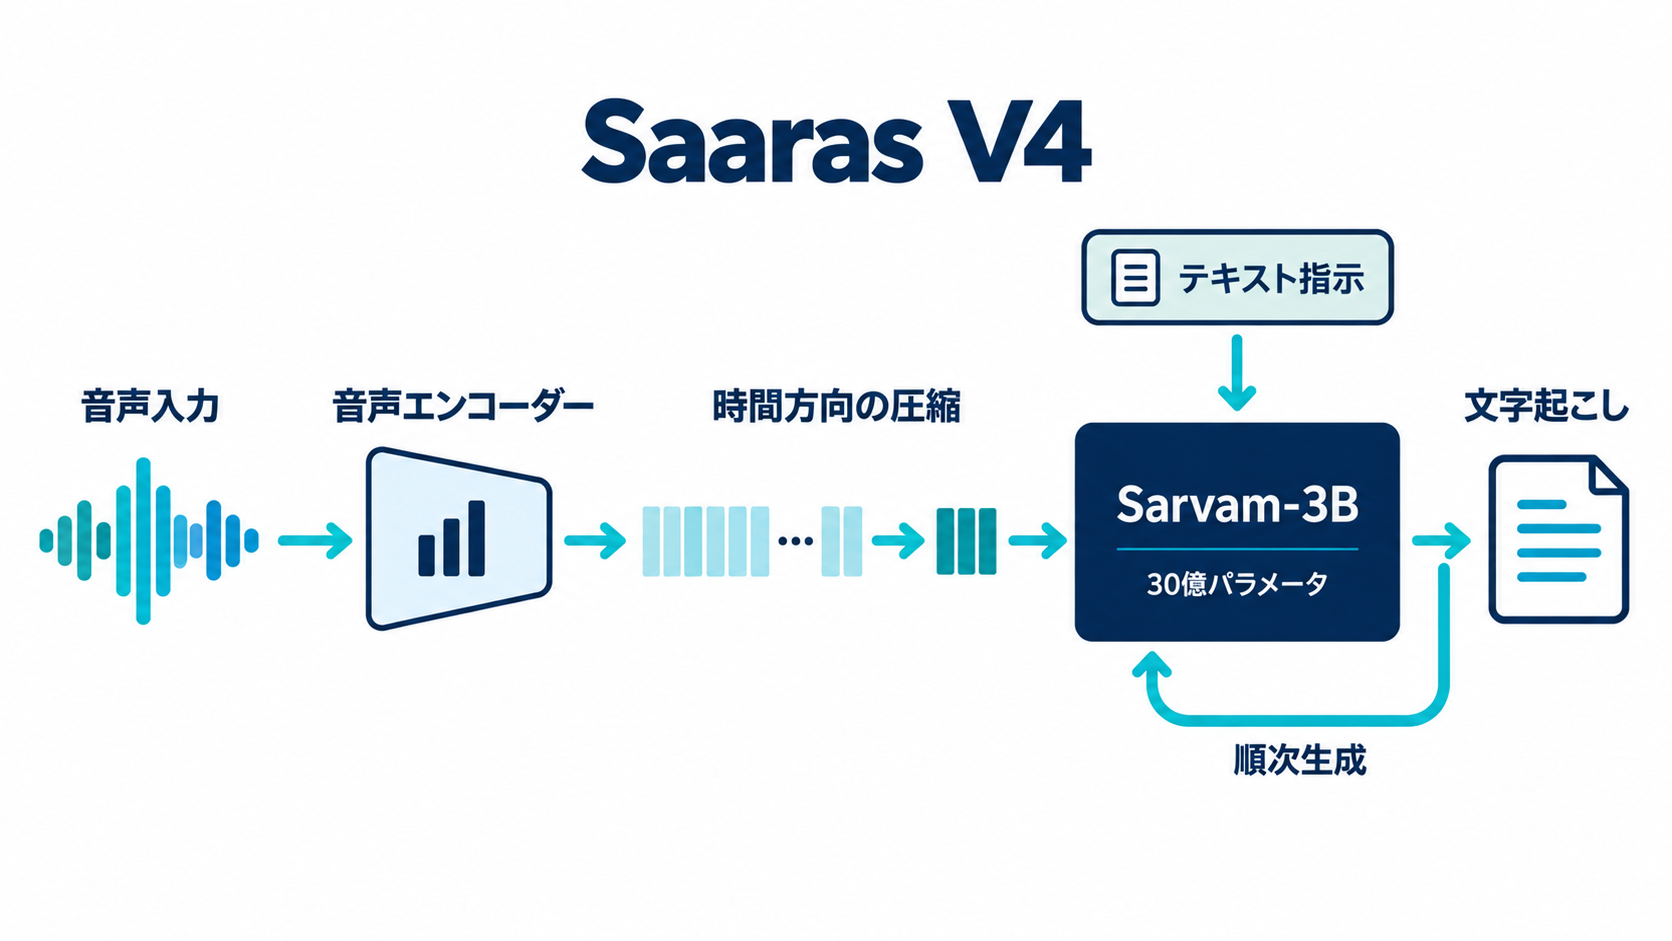
Saaras V4は、音声を読み取るエンコーダーと、文字列を生成するデコーダーを組み合わせた構成です。音声エンコーダーは、入力された波形を、発音や音響上の特徴を含む数値表現に変換します。音をそのまま文章生成部分へ渡すのではなく、認識に必要な特徴へ置き換える段階と考えると理解しやすいでしょう。両者の間には、時間方向の情報列を短くするアダプターがあります。この部分が音声由来の系列を圧縮し、言語モデルが扱う表現の空間へ変換します。長い録音では、音声の特徴を細かく保持するほど情報列も長くなります。そのため、デコーダーが一度に扱える文脈の容量に収める工夫が必要です。Saaras V4では、この中間処理がその役割を担っています。
文章生成を担当するのは、Sarvam AIが社内でゼロから学習した「Sarvam-3B」です。パラメータ数は30億で、ハイブリッド型の状態空間言語モデルと説明されています。デコーダーは音声の特徴とテキストの指示を受け取り、出力したトークンを次の生成の入力に戻しながら、順番に文字起こし結果を組み立てます。トークンは、モデルが文章を処理する際の単語や文字列の断片に相当します。
ただし、モデルの構成だけから業務上の優劣を判断することはできません。音声情報をどう処理するかという設計の理解と、実際の認識精度や応答時間の検証は分けて考える必要があります。また、長い音声を扱うための構成であっても、無制限の録音を一度に投入できるという意味ではありません。利用時には、各APIが定める音声長の上限も確認する必要があります。
ベンチマークは好成績、ただし評価範囲の確認が必要
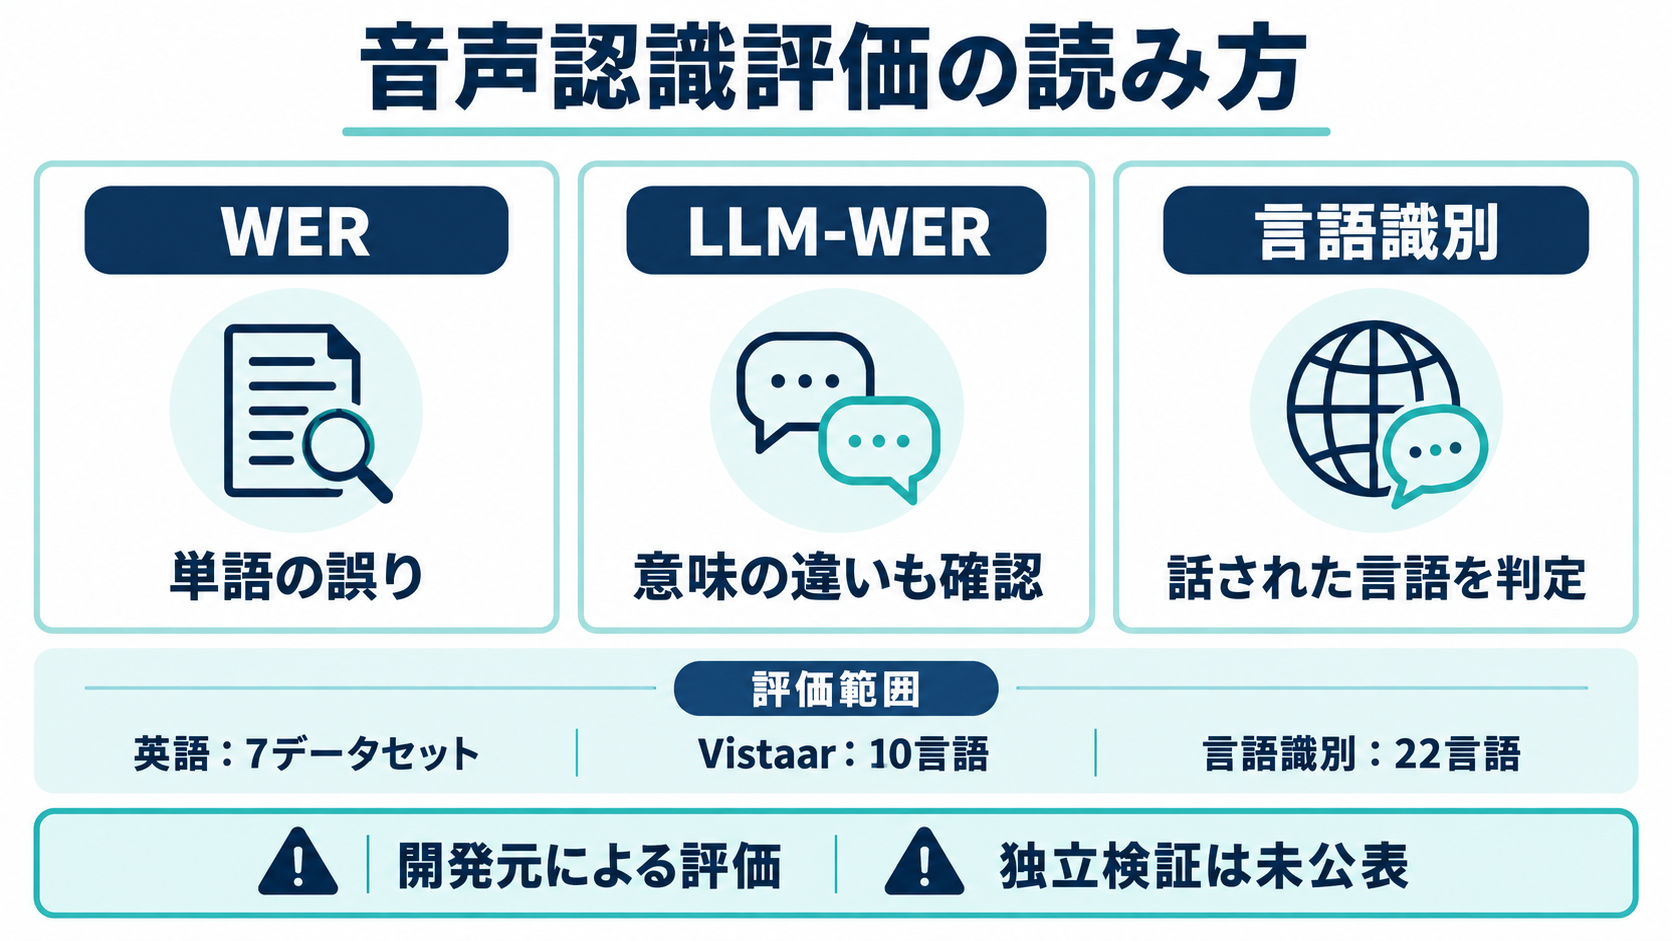
Sarvam AIは、Saaras V4がインドの指定言語22言語全体で最高水準の精度を達成したと説明しています。英語については七つのデータセットで評価し、同社が比較したモデルの中で平均WERが最も低かったと報告しました。WERは単語誤り率を意味し、正解に対する単語の置き換え、抜け、余分な挿入を測る指標です。基本的には数値が低いほど、認識結果が正解に近いことを示します。英語評価のうち六つは、AIモデルやデータセットを共有するHugging Faceの「Open ASR Leaderboard」で使われるデータセットです。残る一つには、インドのアクセントを持つ英語を収録したAI4Bharatの「Svarah」を用いています。採点前の表記統一処理も同リーダーボードのコードに従っており、評価方法をそろえる姿勢が示されています。
インドの言語に関しては、「Vistaar」で10言語を評価し、WERとLLM-WERの両方を報告しています。LLM-WERは意味の確認を加え、実質的な意味の誤りと、意味を変えない綴りや書式の違いを区別するための評価です。文字体系や表記の違いがある環境では、文字列の不一致だけで業務への影響を測り切れないため、この区別には意味があります。
雑音を含む「Kathbath Noisy」では、LLM-WERで測った誤り率がDeepgram Nova-3とGPT-4o Transcribeの半分未満だったとしています。また、確認済みのIndicVoicesの発話を使った言語識別では、主要10言語の誤り率が2.9%、22言語全体では5.22%でした。言語を当てる精度と、発話を書き起こす精度は別の指標です。
これらはいずれも開発元が報告した結果で、独立した再現検証はまだ公表されていません。22言語対応という製品仕様、10言語で示された文字起こし評価、22言語での言語識別評価を混同せず、自社が必要とする言語と録音条件に絞って確かめることが大切です。
五つの出力モードで、記録の目的に合わせて表記を選択
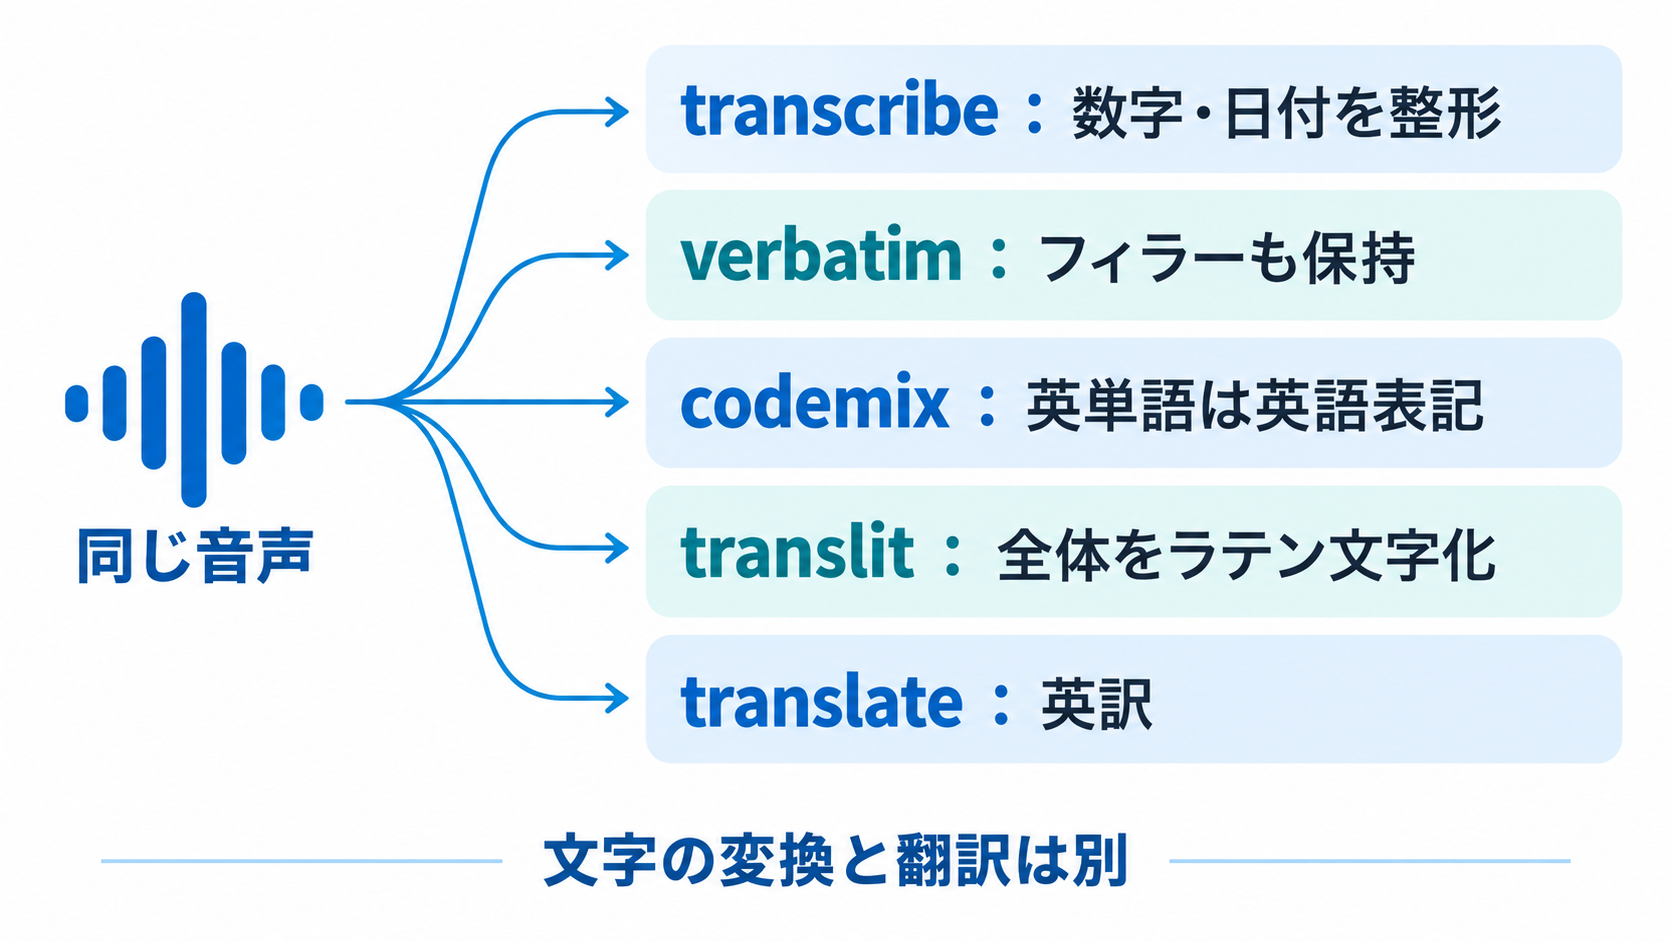
Saaras V4では、同じ音声に対して五つの表現を選べます。切り替えにはAPIの`mode`パラメータを使います。ここで変わるのは、単に文字起こしの見た目だけではありません。話し方をどこまで残すか、数字をどう記録するか、英語の単語をどの文字で表すかなど、後続の業務に関わる出力方針です。標準の`transcribe`は、対象言語の文字を使い、数字や日付の表記を正規化します。`verbatim`では、言いよどみなどのフィラーや、発話された数の表現も残します。検索や集計に適した記録が必要なのか、実際の発話を詳しく確認したいのかによって、選ぶべきモードが変わるでしょう。
`codemix`は、対象言語の文字を使いつつ、会話中の英単語を英語表記のまま残すモードです。現地語の説明に英語のサービス名や製品名が混ざる場面で、表記方針を指定できます。`translit`は発話全体をラテン文字、つまりアルファベットで表します。これは文字の表し方を変える処理であり、英語への翻訳とは異なります。
英語の内容が必要な場合は、`translate`を選びます。このモードは英訳を返し、数字の表記も正規化します。現地の会話を英語で確認する用途には候補になりますが、日本語への翻訳モードとして案内されているわけではありません。
Sarvam AIは、こうした処理をモデル内で扱うことで、後処理を重ねる際の誤りの連鎖を減らせると説明しています。企業側では、すべての用途に同じモードを当てはめず、保存する記録の目的を先に決めるのがよさそうです。例えば応対品質の確認では発話の細部が必要でも、顧客管理システムへの転記では数字や名称の表記統一を優先する場合があります。どの情報を残し、どこを整えるかという業務上の判断が、モード選択の出発点になります。
固有名詞を補助するkeytermsは、正解を保証する辞書ではない
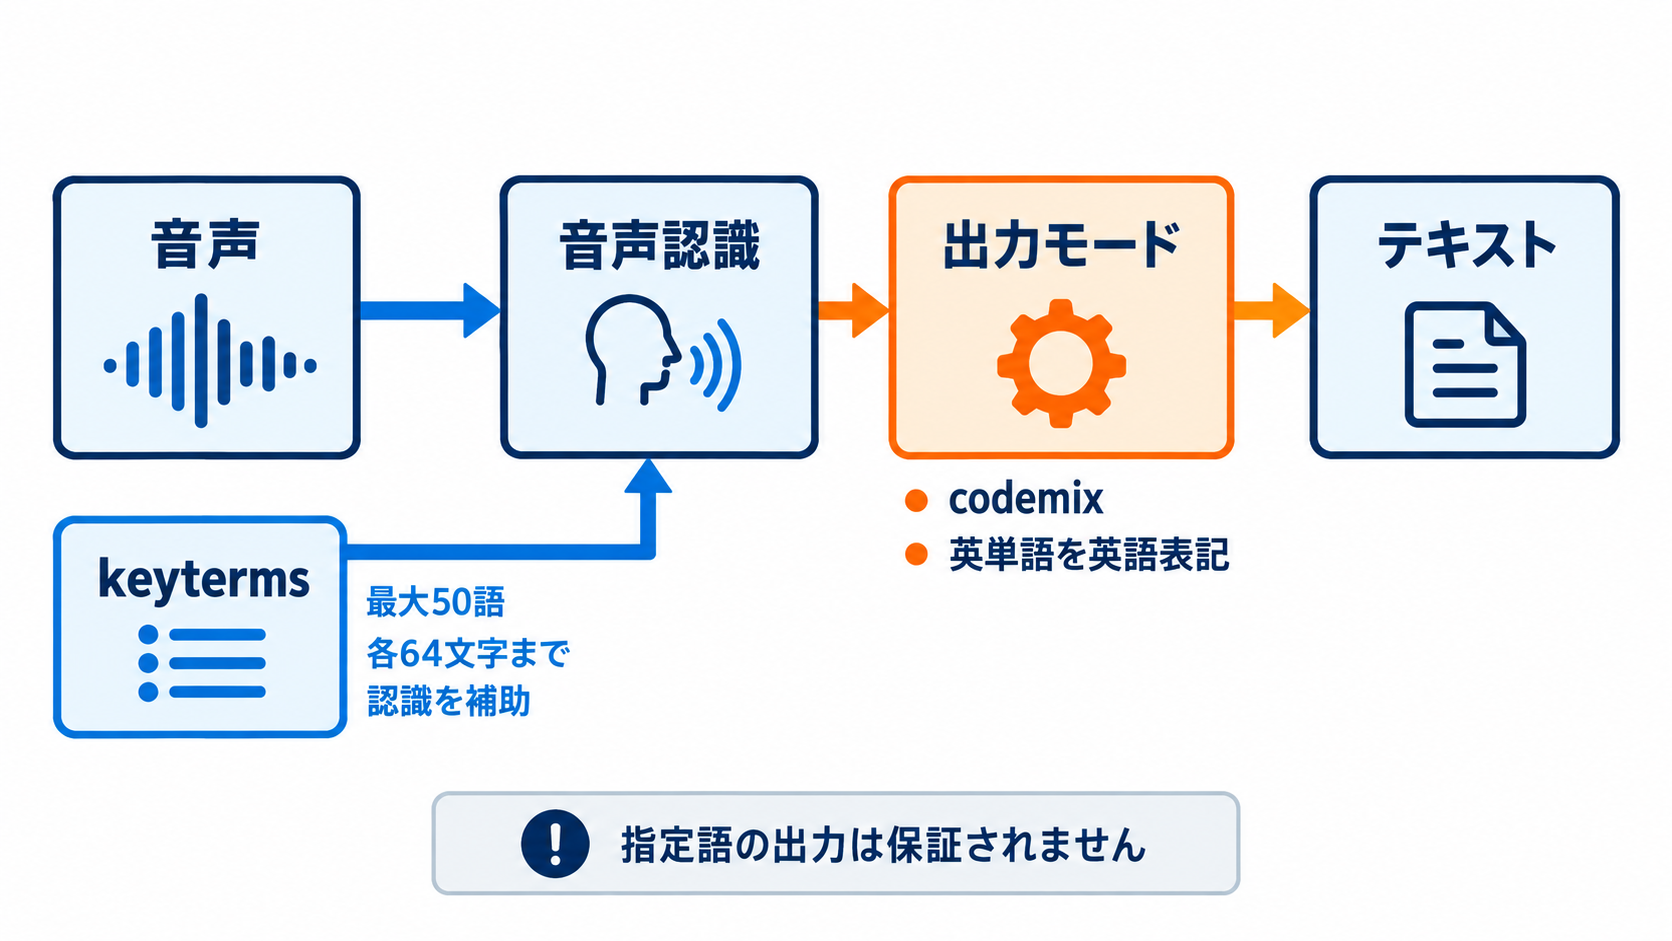
V4で追加された「keyterm prompting」は、認識してほしい単語を事前に与える機能です。製品名、ブランド名、社内用語など、一般的な会話だけでは判断しにくい語を扱う場面で、検証する価値があるでしょう。APIでは`keyterms`にJSON形式のリストを渡します。指定できるのは最大50語で、各項目は64文字までです。この機能は`model="saaras:v4"`でのみ利用できます。注意したいのは、指定語句が必ず出力される仕組みではない点です。keytermsは認識の候補に偏りを与える補助情報であり、確定した置換ルールではありません。登録すれば聞き取りの誤りがなくなると考えると、実際の品質との間にずれが生まれます。導入時には、指定ありと指定なしで同じ音声を比較する必要があります。
文字の扱いも別に考える必要があります。Sarvam AIは、インドの決済サービス「PhonePe」のようなブランド名をラテン文字で残したい場合、`codemix`モードを使うよう案内しています。語を認識しやすくする指定と、その語をどの文字で出力するかという指定は、目的が異なります。両者を組み合わせて初めて、求める記録形式に近づけられるということです。
同社は、IndicContextEvalのL5というキーワード指定条件でWERが16.03%となり、同ベンチマークで最も低い値だったと報告しています。ただし、この数値をそのまま自社の製品名の誤認識率と読み替えることはできません。評価条件や音声の内容が変われば、結果も変わり得ます。
実務では、候補語を上限まで詰め込むよりも、業務上の誤りにつながる名称を優先して試す進め方が考えられます。似た発音の名称を取り違えないか、実際には発話されていない指定語に引き寄せられないかも確認対象です。正解した件数だけでなく、どの種類の誤りが増減したかを見ると、設定の効果を判断しやすくなります。
APIは利用可能、応答速度と処理時間は分けて評価
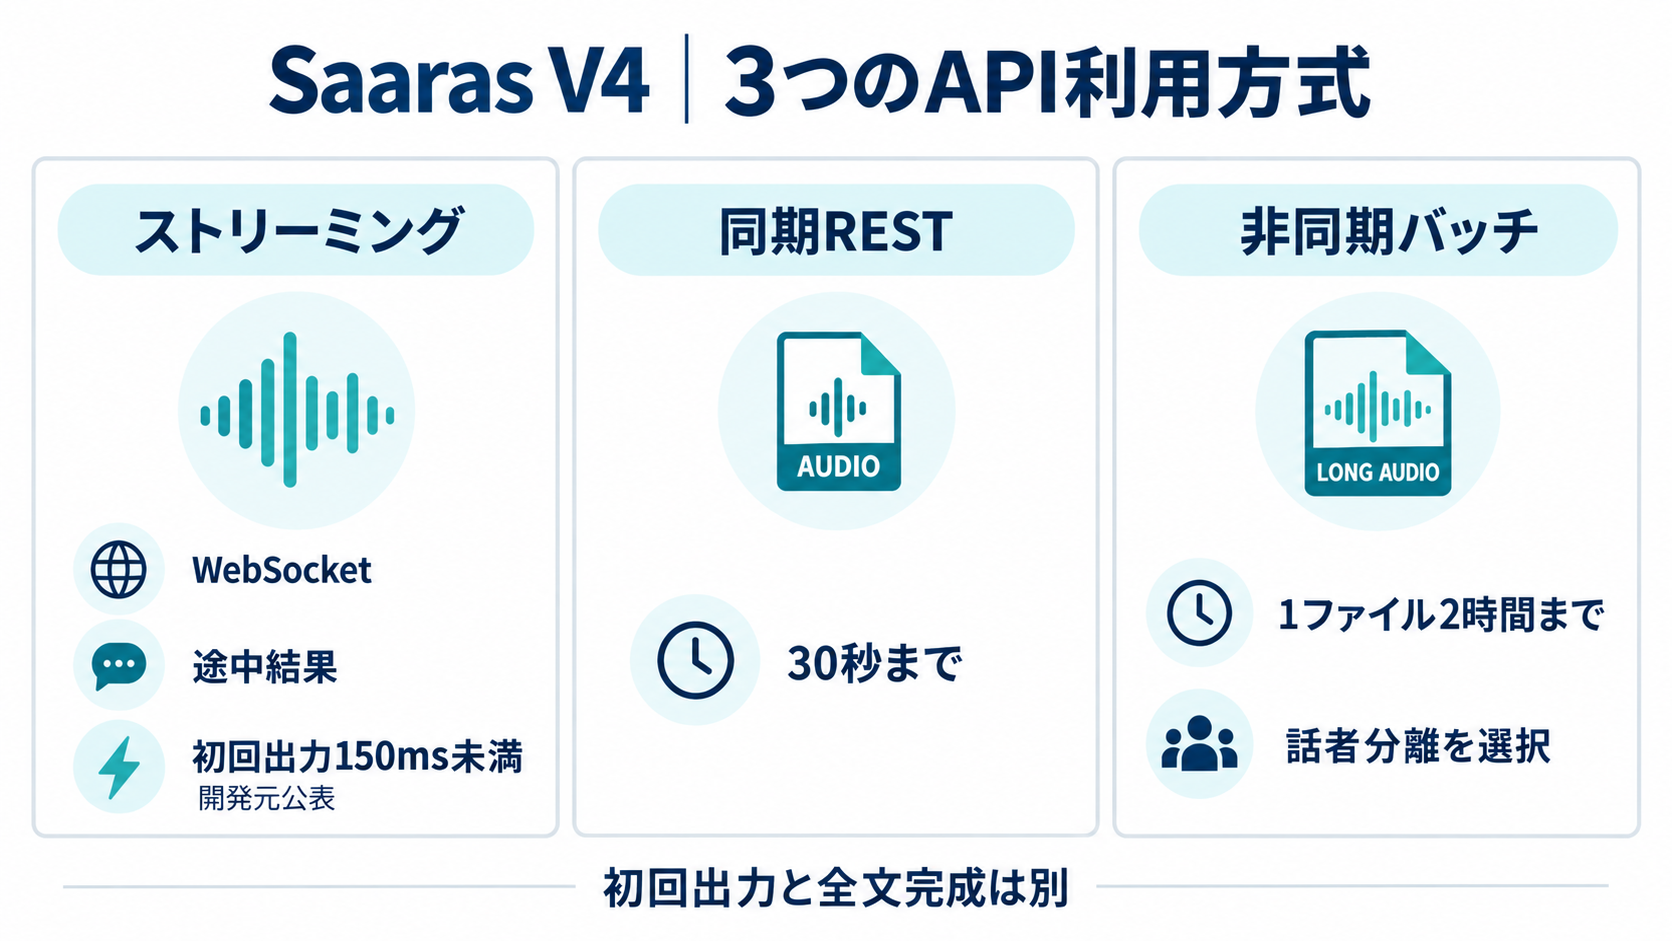
Saaras V4はSarvam AIのAPIを通じて利用でき、モデル指定には`model="saaras:v4"`を使います。標準モデルは引き続きSaaras v3です。V4は同じリクエスト構造を使うため、モデル指定の変更自体は一行で済むと案内されています。ただし、接続方法が変わらないことと、出力内容の確認が不要であることは別です。既存業務から切り替える際は、表記や認識結果も比較する必要があります。処理方式は用途に応じて選べます。WebSocketによるストリーミングは途中結果を返し、開発元は最初のトークンが出るまでの時間を150ミリ秒未満としています。RESTによる同期処理は30秒までの音声、非同期のバッチ処理は1ファイル当たり最大2時間に対応します。バッチでは、誰が話したかを区別する話者分離も選択できます。
150ミリ秒未満という値は、文字起こし全体が完成するまでの時間ではありません。最初の出力が現れるまでの指標です。リアルタイムの応対支援を検討するなら、途中結果がどの程度書き換わるか、発話が終わってから確定までにどれほどかかるかも評価したいところです。利用者が感じる待ち時間は、最初の応答だけでは決まりません。
2026年9月26日時点で示された音声認識の料金は、リアルタイム、ストリーミング、バッチで1時間当たり30インドルピー、話者分離ありでは45インドルピーです。話者分離の要否によって単価が変わるため、単純な録音時間に加え、どの記録で発話者の区別が必要かを整理すると費用を見積もりやすくなります。
開発環境ではPython 3.9以上とNode.js 18以上のSDKに加え、LiveKit Agents、Pipecat、Vercel AI SDKとの連携が案内されています。これらは音声エージェントやAIアプリケーションの開発に使う基盤です。既存システムとの接続しやすさも、精度や料金と合わせて確認するポイントになります。
日本企業の導入判断は、実際の通話と運用条件から
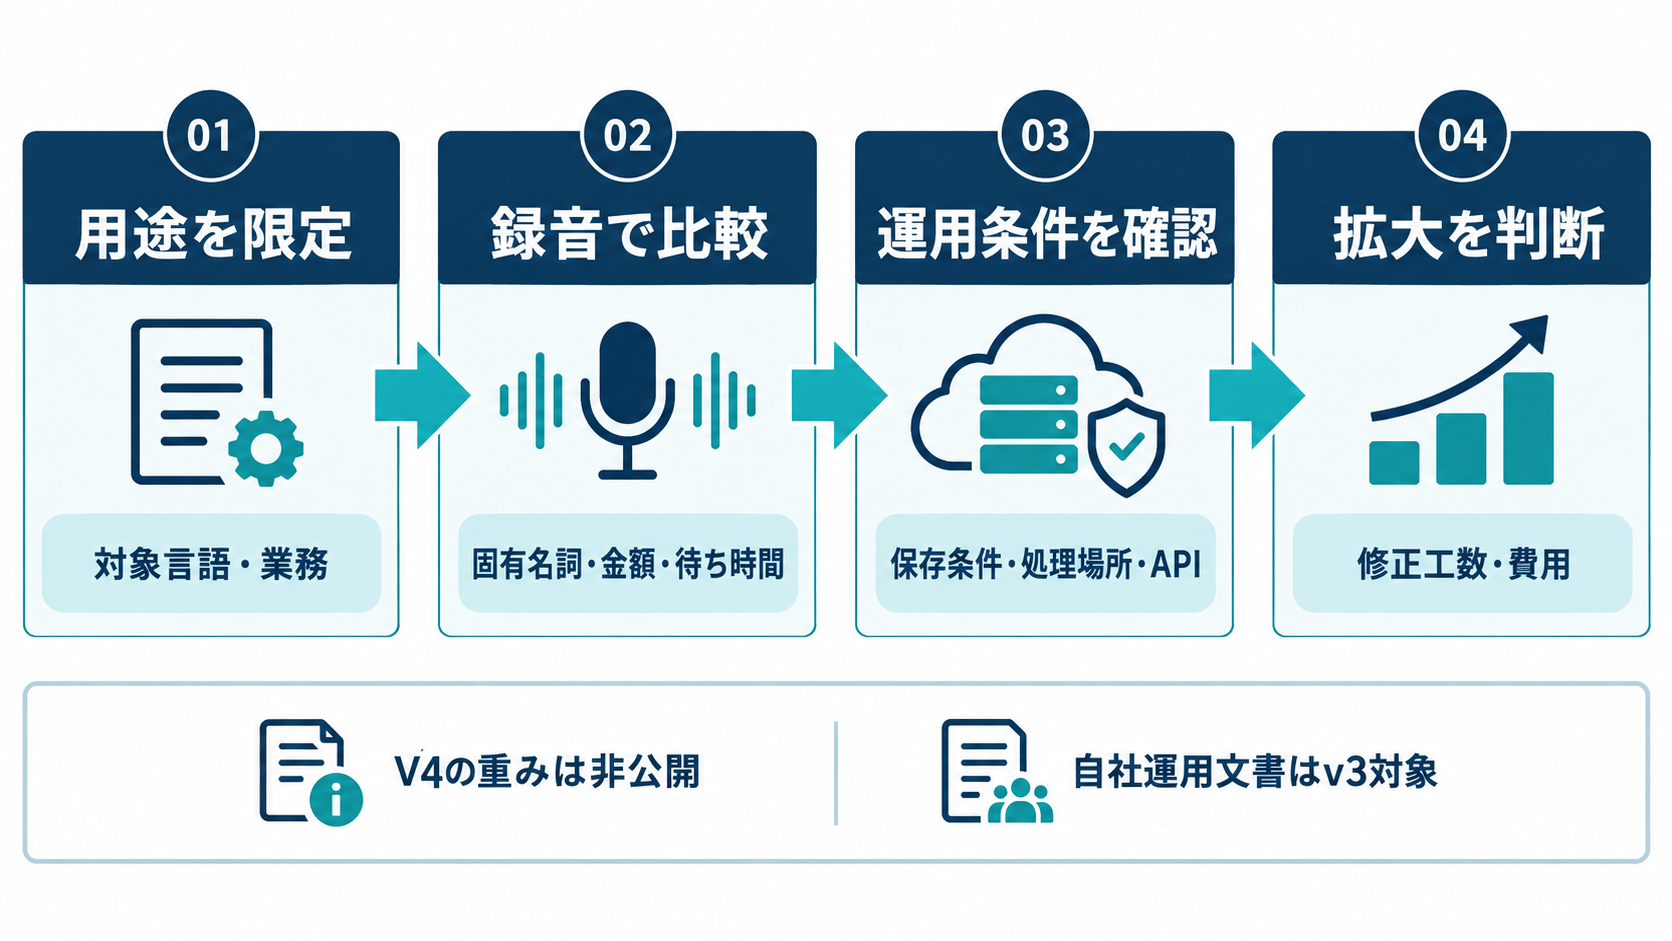
Saaras V4を検討する際は、インドの言語への対応範囲と、自社が必要とする運用条件を並べて評価することが出発点になります。Sarvam AIはDeepgram Nova-3、ElevenLabs Scribe v2、OpenAI GPT-4o Transcribeを比較対象に挙げていますが、対応言語数だけで採用先は決まりません。重要語句の指定、話者分離、出力形式、リアルタイム処理の要否によって、必要な機能が変わります。提供形態には明確な制約があります。Saaras V4のモデルの重みは公開されておらず、利用可能な経路として示されているのはAPIです。AWSの機械学習基盤であるAmazon SageMaker上でのセルフホスティング文書は、現時点ではv3のみを対象としています。V4も自社環境に配置できると見込んで設計を進めることは避けるべきでしょう。
顧客の通話を扱う場合は、認識精度に加え、音声データの保存条件や処理場所が社内の要件に合うかを確認する必要があります。今回の公開情報だけでは、これらの運用条件を判断し切れません。APIで接続できることを導入可能という結論に直結させず、必要な条件を提供元に確認する段階を設けるとよいでしょう。
品質評価では、対象言語、アクセント、雑音の程度、英語の混在を反映した通話サンプルを用意する進め方が考えられます。評価項目も平均WERだけに寄せず、製品名、金額、日付など、誤ると業務への影響が大きい箇所を別に確認します。用途に応じた出力モードを選び、keytermsの有無で結果を比べれば、機能が実務で役立つかを具体的に判断できます。
最初の一歩としては、インド向け業務の中から対象言語と用途を一つ選び、正解を確認できる録音で試行するのが現実的です。認識結果、確定までの待ち時間、人が修正する手間を記録し、既存手段と比べてどこが改善するかを確かめます。その結果を基に、対象地域や業務を広げるかを決められます。