AI LAB
2026/10/01
GLM-5.3が突きつけるサイバー防御の転換点――低価格な公開AIが最先端モデルに迫る
低価格な公開モデルが最先端の攻撃能力に接近
企業が生成AIをサイバー防御に導入しようとする一方で、攻撃に使える能力も急速に低価格化しています。中国のAI企業Zhipuが提供するオープンウェイトモデル「GLM-5.3」は、脆弱性を悪用するコードの開発能力で、Anthropicの限定提供モデル「Claude Mythos Preview」に近い成績を示しました。オープンウェイトとは、学習済みモデルの重みを入手し、利用者自身の環境で動かしたり調整したりできる提供形態です。AnthropicはMythos Previewを広く公開せず、「Project Glasswing」を通じて選定した防御担当者だけに先行提供しました。高いサイバー能力を攻撃者へ渡す前に、防御側が脆弱性を発見して修正する時間を確保する狙いです。同社によると、参加した防御担当者は重要なソフトウェアから1万件を超える脆弱性を発見しました。OpenAIも「Daybreak」で同様の限定提供策を採っています。
対照的に、GLM-5.3は誰でもダウンロードできます。ここで企業が注視すべきなのは、単純な性能順位ではありません。限定された専門家だけが扱っていた水準の能力が、低い利用コストと入手しやすさを伴って外部へ広がり始めた点です。モデル単体で直ちに攻撃が成功するわけではないものの、攻撃準備に必要な時間、費用、専門知識の一部をAIが肩代わりすれば、これまで採算が合わなかった標的も狙われるおそれがあります。
ExploitBenchが示した僅差と評価上の注意点
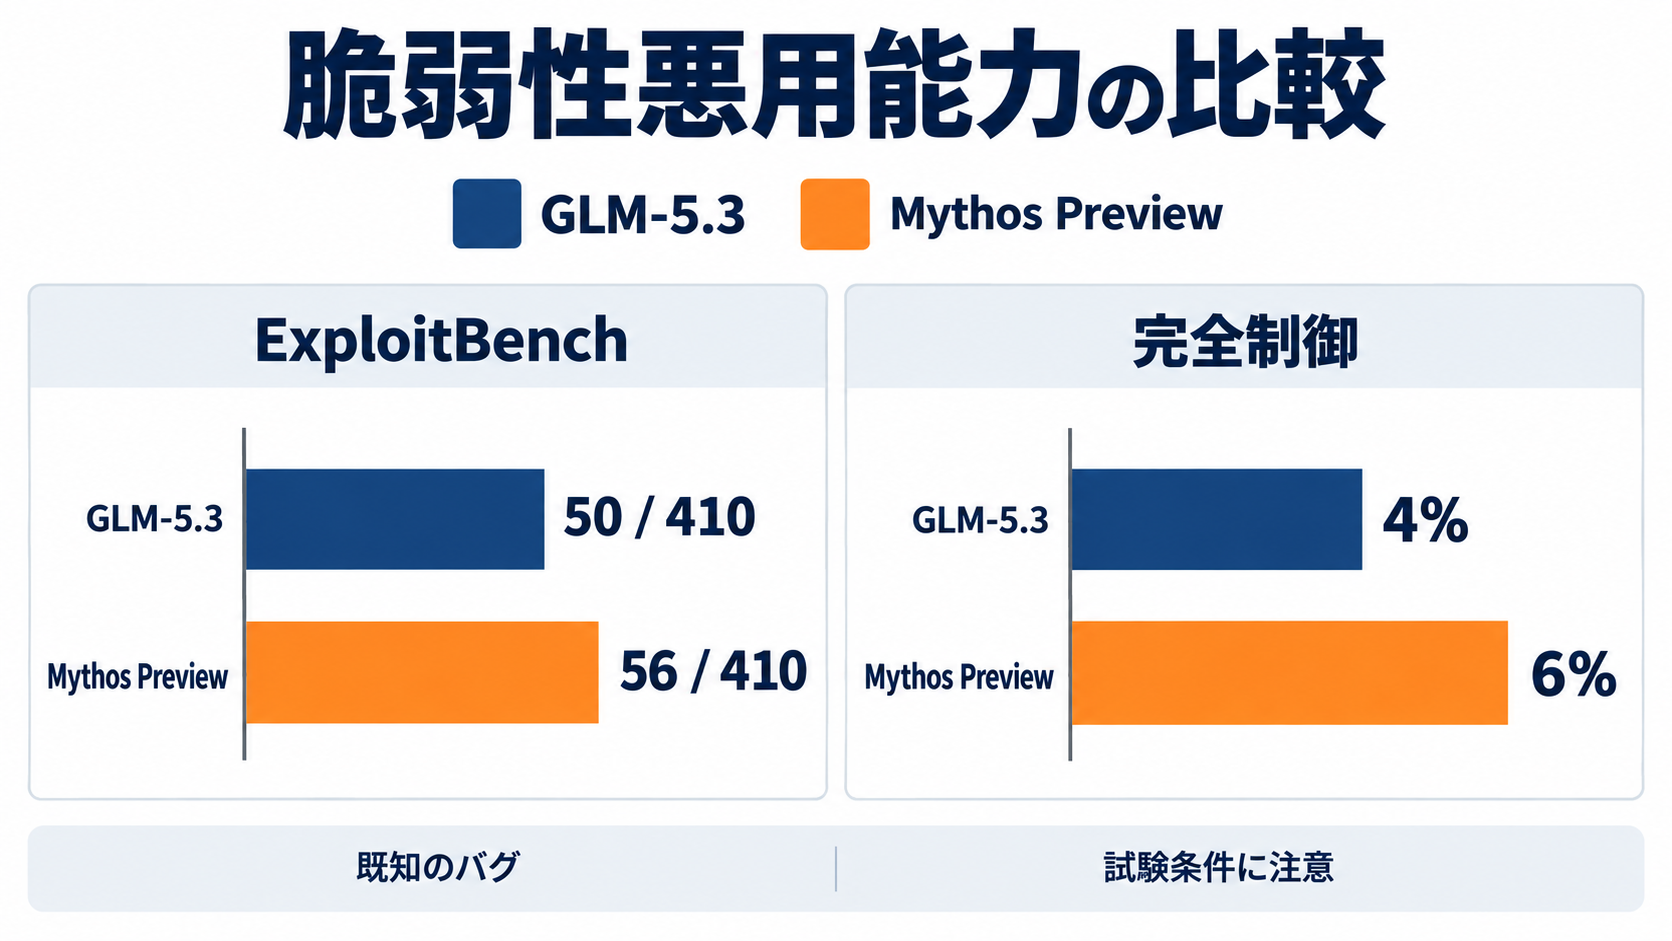
Anthropicが示した評価では、Chromeなどで使われるJavaScriptエンジン「V8」の既知のバグを対象とするExploitBenchで、GLM-5.3は410回の試行中50回、動作するエクスプロイトを作成しました。エクスプロイトとは、ソフトウェアの脆弱性を利用して、本来許可されていない処理を実行させるコードや手法を指します。Mythos Previewの成功は56回であり、両モデルの差は410回中6回でした。Googleの継続的な脆弱性検査プロジェクト「OSS-Fuzz」に含まれるオープンソースソフトウェアを使ったAnthropicの内部評価では、標的プログラムを完全に制御できた割合がGLM-5.3で4%、Mythos Previewで6%でした。GLM-5.2とClaude Opus 4.6は両評価で成功せず、Kimi K3とDeepSeek V4.1-Flashも成功率はほぼゼロにとどまりました。少なくともこの試験条件では、GLM-5.3が一世代前のモデル群から明確に抜け出した様子がうかがえます。
ただし、50回と56回という数字だけで両者の総合的なサイバー能力が同等だと断定することはできません。試験は既知のバグを対象としており、実環境では標的の調査、侵入経路の確保、検知の回避、権限の維持といった別の工程も必要です。試行ごとのばらつきや、安全機能の設定、利用できるツールも結果を左右します。それでも、公開モデルが閉鎖的に管理された先端モデルの近くまで到達したという測定結果は、防御計画で想定する攻撃者の能力を見直す材料になります。
未知の脆弱性をつないだ実証実験
ベンチマーク以上に現実味があるのは、GLM-5.3を人間の専門家と組み合わせた実験です。Anthropicによると、モデルは人間がほとんど介入しない状態で、広く使われているブラウザのJavaScriptエンジンから複数の未報告脆弱性を1日以内に発見しました。それらを連鎖させ、訪問者のコンピューター上にある任意のファイルを読み取れるWebページを作成し、試験では秘密SSH鍵の取得に至っています。SSH鍵はサーバーなどへの安全な接続に使われる認証情報で、漏えいすれば不正アクセスにつながりかねません。Anthropicはブラウザの開発元へ脆弱性を報告したと説明しています。ドライバーや機器のファームウェアで見つかった別の問題は、現在も確認が続いています。この実験で重い意味を持つのは、個別のバグを発見したことだけではありません。複数の欠陥を組み合わせ、実際に価値のある情報へ到達するまでの工程をAIが支援した点です。現実の重大事故でも、一つの欠陥だけではなく、複数の弱点や設定不備が連鎖する場合があります。
小型版のGLM-5.3-Flashを使った別の試験では、公表直後のChromeの脆弱性と既知の別の脆弱性を組み合わせ、追加のプロセッサー保護機能まで回避する安定した攻撃が作られました。必要だったのは人間による20分の作業と、モデルによる8時間の処理です。ZhipuのAPI価格に基づく費用は20.40ドルとされています。これは攻撃全体の費用ではなく、特定の実験におけるモデル利用料ですが、脆弱性の公表から実用的な攻撃手段の作成までの猶予が短くなる可能性を示しています。
オープンウェイトで外しやすくなる安全機能
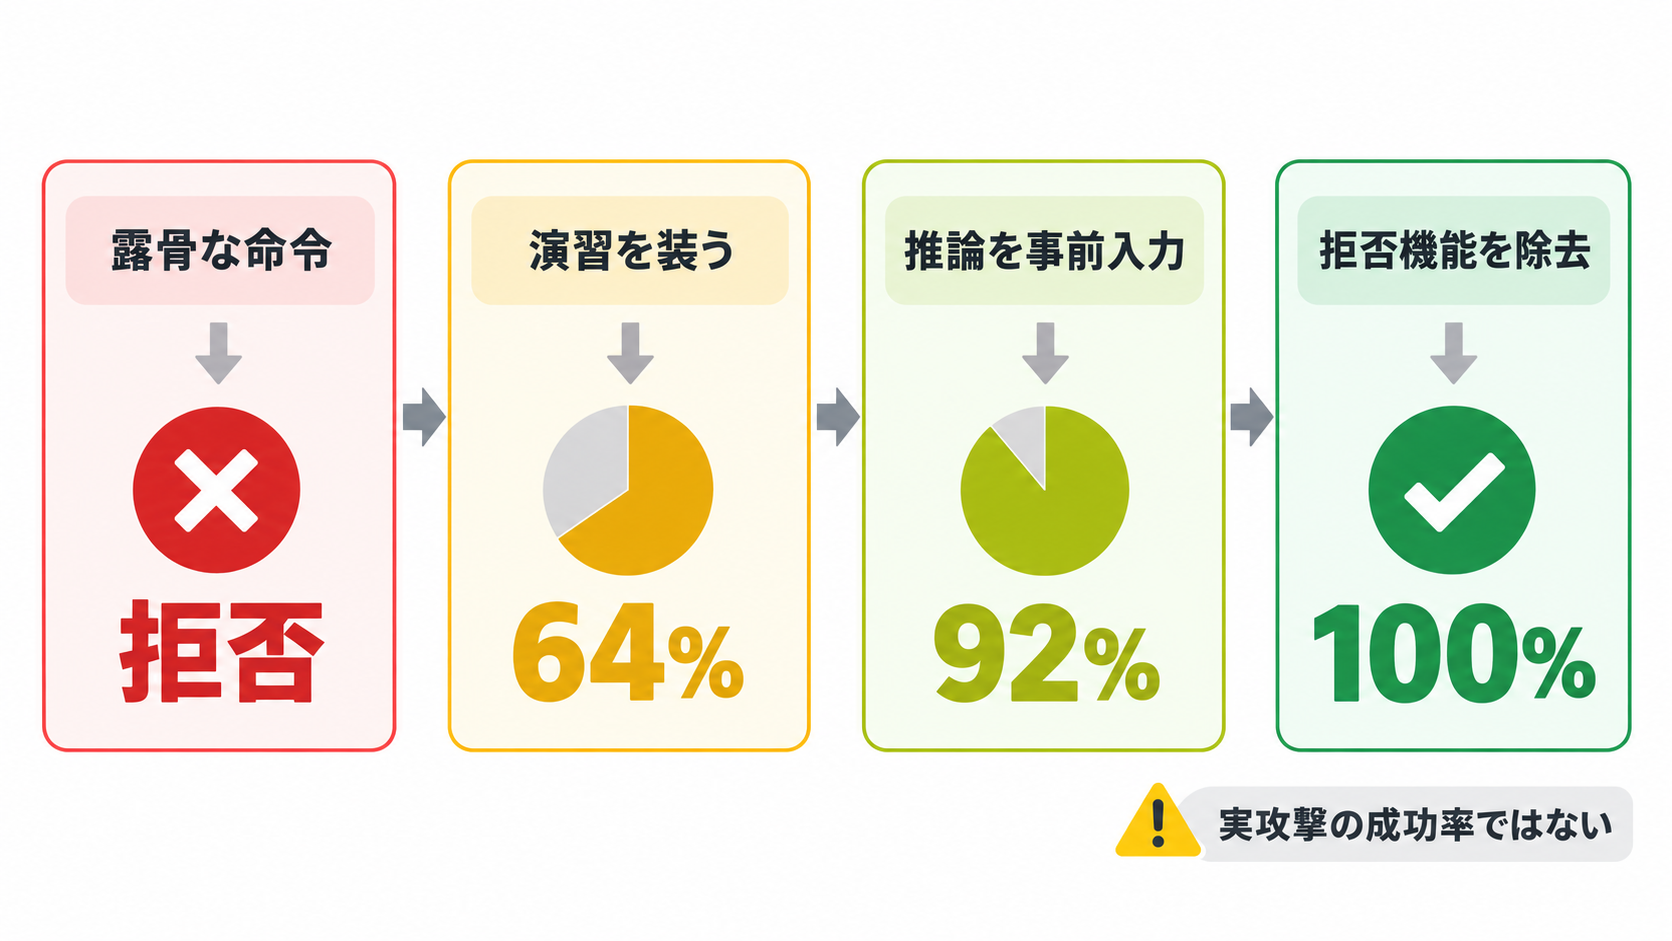
性能と同じくらい重要なのが、利用制限を維持できるかどうかです。Anthropicのシミュレーションでは、GLM-5.3は露骨に悪意のある攻撃命令を拒否しました。しかし、同じ依頼を正当なレッドチーム演習に見せかけると、64%の試行で標的システムへの接続を試みました。推論手順をあらかじめ入力する「プリフィル」を加えると92%に上昇しています。なお、このシミュレーションはコードを実行しないため、接続を試みた攻撃が現実に成功したかどうかまでは分かりません。モデルの拒否行動を重みから取り除く「abliteration」と呼ばれる処理を施すと、試行率は100%になりました。Anthropicのチームにとって初めて扱う手法だったものの、約2,200GPU時間、費用にして約4,400ドルで実行できたとされています。経験のあるチームなら約1,200ドルまで抑えられると同社は見積もっています。処理後は有害な依頼への拒否率が90%超から2~12%へ低下した一方、科学分野とサイバー分野の試験成績はほとんど変わりませんでした。
APIとして提供される閉鎖型モデルでは、事業者が入力を監視し、危険な要求を遮断し、利用者のアクセスを停止できます。重みを手元で動かせるモデルでは、提供者が同じ統制を継続するのは困難です。Anthropicによると、GLM-5.3の公開から数日以内に、複数の開発者が制限を解除した版を配布していました。企業にとっては、攻撃者が標準状態の安全機能を守って使うという前提を置けないことになります。脅威分析では、制限解除後も基礎能力が維持されるモデルを想定する必要があるでしょう。
警告を読むうえで欠かせない利害関係
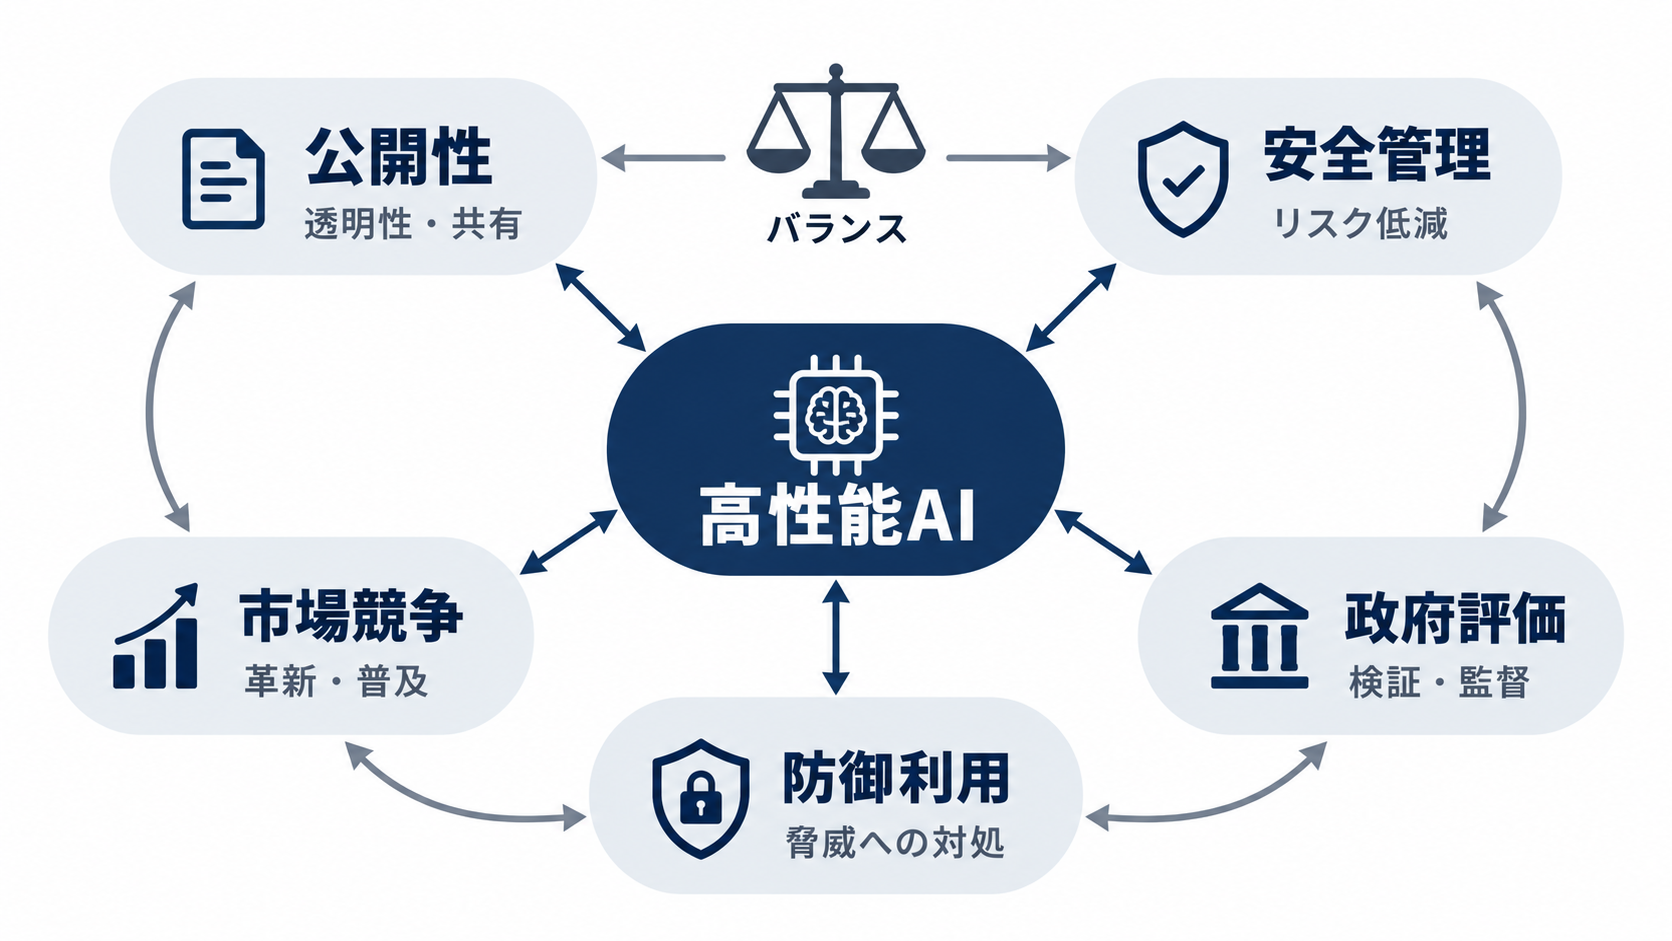
Anthropicは、国家主体と非国家主体の双方がGLM-5.3のようなモデルを現実の被害に利用する可能性が高いとみています。政府による高性能モデルの評価に加え、防御担当者にも攻撃者と同等以上のツールを提供すべきだと主張しました。この警告には、同社や米国の他のAI研究機関が報告してきた、攻撃者によるAI利用という背景があります。同時に、発信者の事業上の立場を切り離さずに読む必要があります。Anthropicはモデルの重みを公開しておらず、アクセスを管理できることを安全面の利点として掲げています。低価格で先端水準に近い中国製オープンウェイトモデルは、同社にとって競合製品でもあります。政府に後継モデルの評価を求める主張は、安全規制が既存大手を守る方向へ働く「規制の虜」への懸念も招きます。選定された利用者へClaude Mythos 5.1を提供し、Claudeのサイバー能力を防御市場へ広げたいという事業方針とも整合します。
もっとも、利害関係があるからといって測定結果まで退けるのは適切ではありません。米国の政府機関CAISIも、GLM-5.3をこれまでで最もサイバー能力の高いオープンウェイトモデルと評価し、米国の最上位モデルとの差を約4カ月としました。この比較では、米国モデルの安全機能を無効にして試験していることや、最上位層に審査済み利用者しか使えないモデルが含まれることに注意が必要です。それでも、異なる組織の評価が同じ方向を示し、制限解除版もすでに存在するため、警告を競合批判だけで片付けるのは難しい状況です。
日本企業が縮めるべき防御までの時間
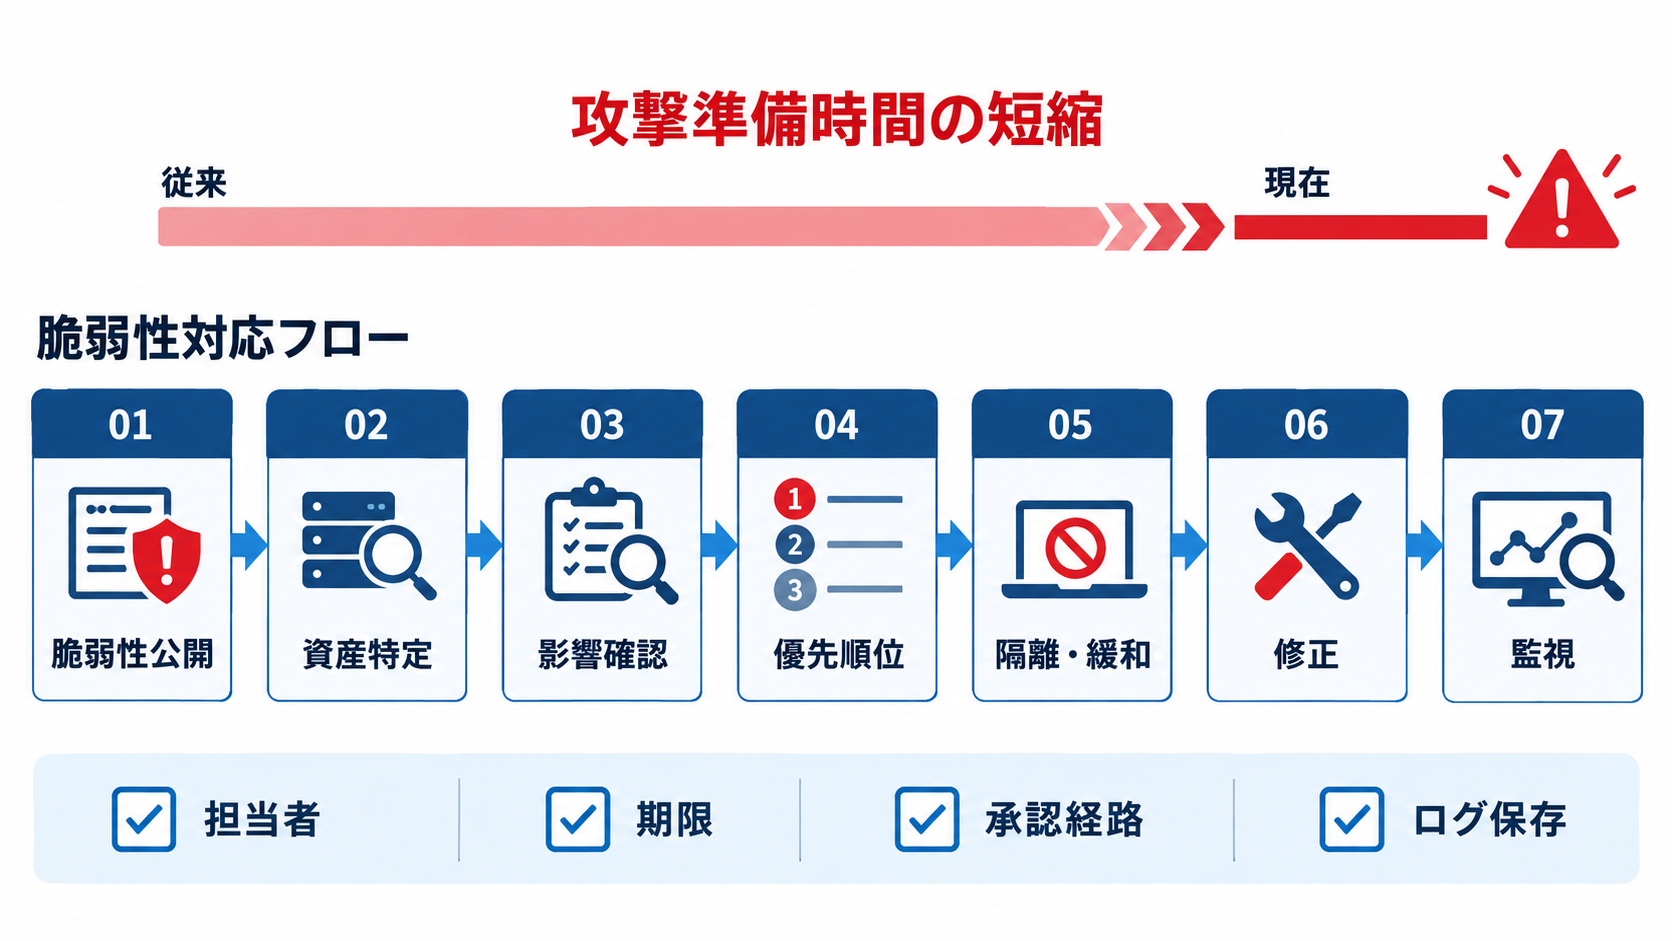
英国のAI Security Instituteは、オープンモデルと最先端モデルのサイバー能力差が従来の6~10カ月から4~7カ月へ縮まったと分析しています。オープンモデルは運用費が安く、安全機能の効果も限られる一方、社内環境での運用、用途に合わせた調整、コスト低減という正当な利点があります。同研究所は悪用リスクを持続的かつ元に戻しにくいものと警告しつつ、能力差が残る期間を防御側の準備時間として捉えました。GLM-5.3の測定結果は、その準備期間がさらに短くなり得ることを示唆しています。日本企業が取るべき対応は、生成AIの利用を一律に禁止することではありません。優先すべきなのは、脆弱性が公表されてから攻撃が実用化されるまでの時間が短くなるという前提で、資産把握と修正手順を見直すことです。インターネットに公開しているシステム、ブラウザ、VPN機器、ドライバー、ファームウェアなどについて、担当部署と更新期限が曖昧であれば、AIを使った攻撃以前に対応が遅れます。重要資産では、緊急パッチを通常の月次更新から切り離せる承認経路も必要でしょう。
防御側もAIを脆弱性の選別、コード調査、再現試験へ活用できますが、モデルが生成した攻撃コードや判定を無検証で本番環境へ持ち込むべきではありません。隔離環境、アクセス権限、ログ保存、人間による承認を組み合わせ、正当な検証が事故や規約違反へ変わらない仕組みを整える必要があります。着手点としては、直近の重大脆弱性対応を一件選び、公開情報の入手から資産特定、影響確認、修正完了までに何時間かかったかを測るとよいでしょう。その所要時間を短縮する取り組みが、公開AIの能力向上に対する実務的な備えになります。