AI LAB
2026/09/16
表データ分析を「学習なし」で刷新、TabPFN-3.5がKaggle優勝スコアを上回る
1分の推論で、熟練者が組んだ36モデルを上回る
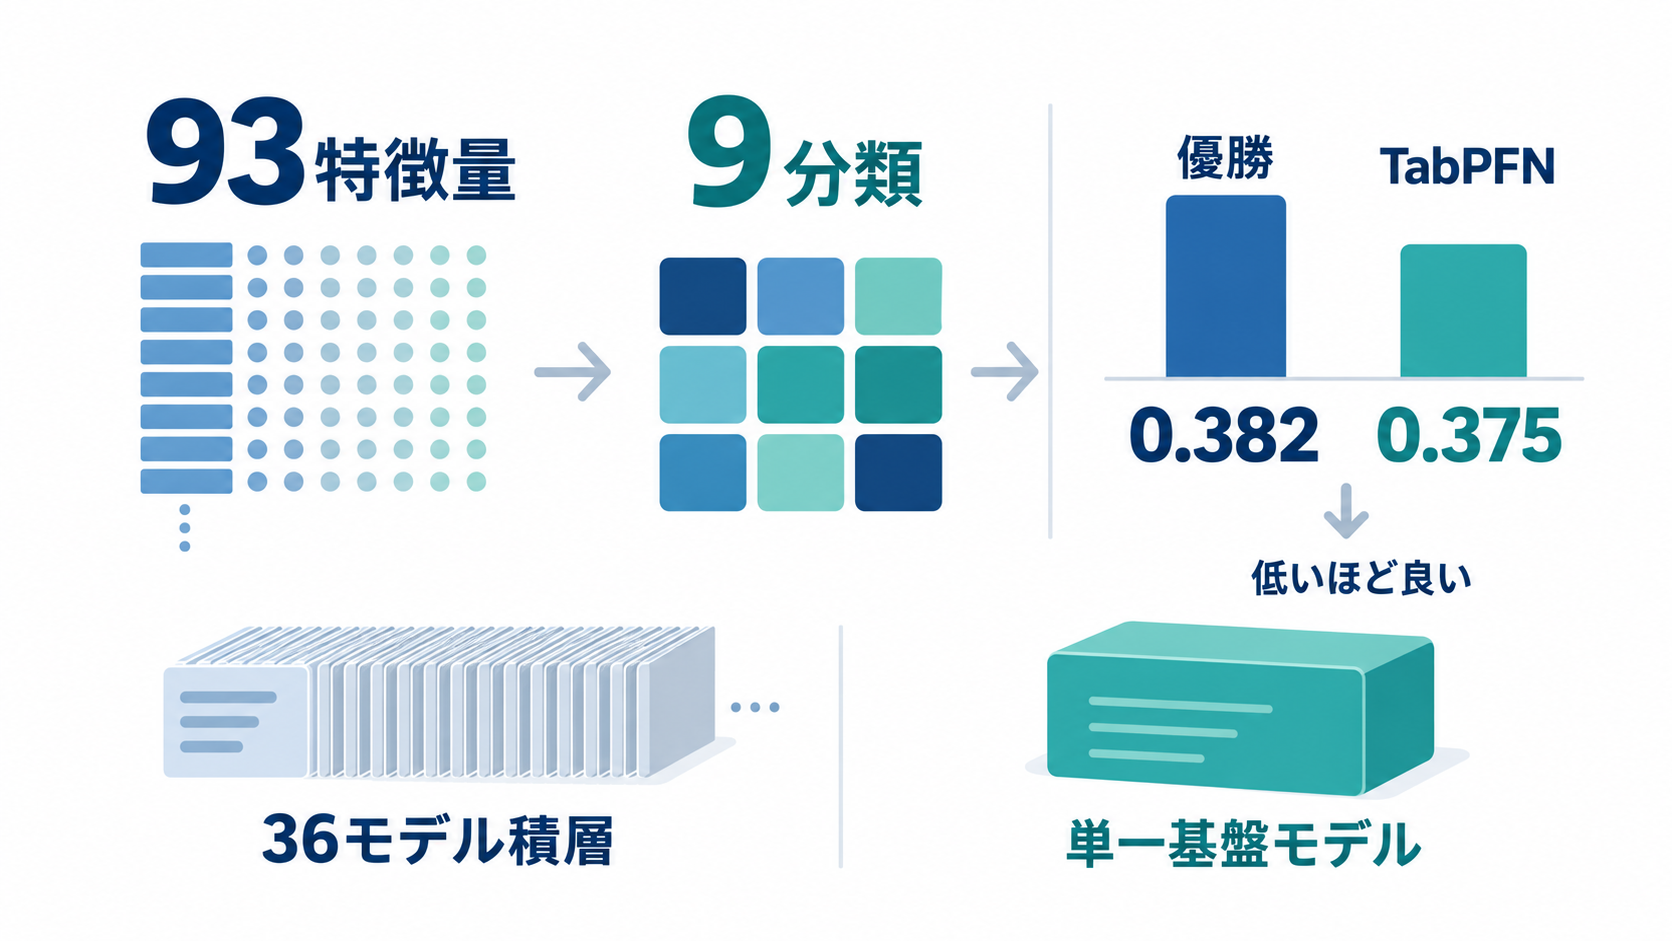
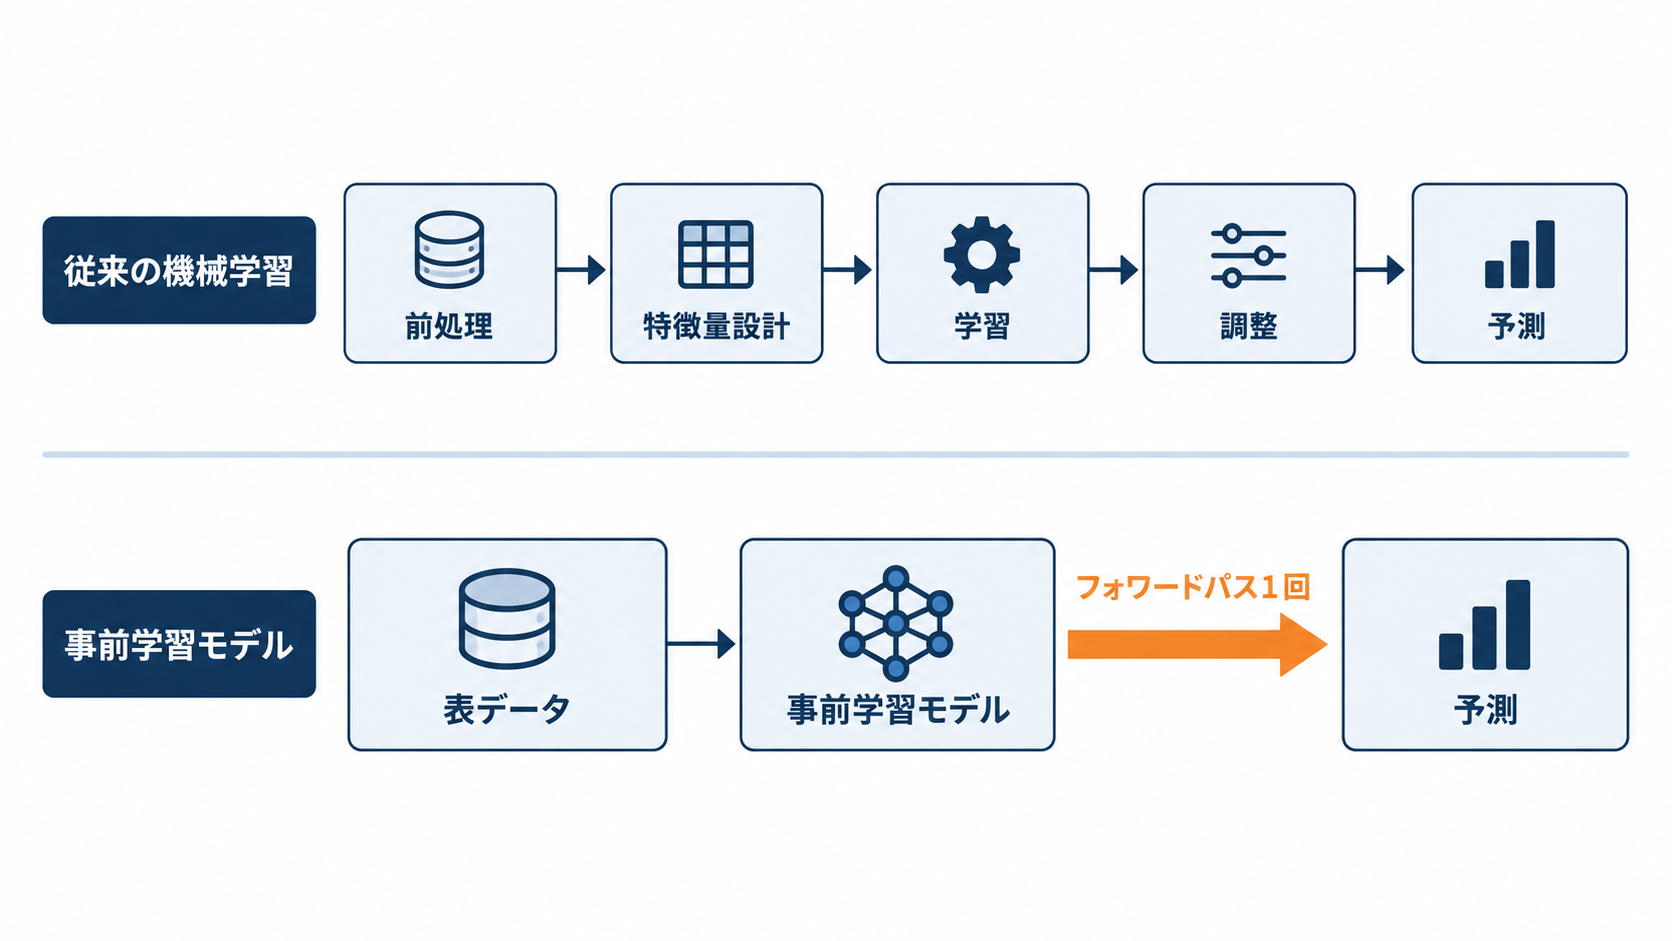
企業の売上予測や顧客分類では、表形式のデータを扱うために、特徴量の加工、モデル選定、ハイパーパラメータ調整を何度も繰り返すのが一般的です。Prior Labsが公開した表データ向け基盤モデル「TabPFN-3.5」は、この工程を大幅に短縮できる可能性を示しました。データセットごとの追加学習や調整を行わず、表を入力して1回のフォワードパスで予測を生成する設計です。象徴的なのが、2015年にデータ分析コンテスト基盤Kaggleで開催された「Otto Group Product Classification Challenge」での結果です。TabPFN-3.5は、生データとデフォルト設定だけを使い、非公開リーダーボードでマルチクラス対数損失0.375を記録しました。この指標は小さいほど良く、当時の優勝スコアである0.382を上回っています。Prior LabsのAI研究者で、機械学習自動化ツールAutoGluonの共同開発者でもあるNick Erickson氏によると、処理時間はRTX PRO 6000 GPUで約1分でした。
注目すべき点は、単に古い記録を更新したことではありません。2015年の優勝チームは、手作業で設計した特徴量と36個のモデルを多層的に組み合わせていました。対するTabPFN-3.5は、個別のコンテストに合わせたチューニングを行っていません。専門家の試行錯誤を大量に積み重ねる従来型のアプローチに対し、事前学習済みモデルをそのまま適用するという異なる方法で競争力を示した点に、企業利用を考えるうえでの意味があります。
Ottoコンペが示す比較の重み
Otto Group Product Classification Challengeには3,505チームが参加し、賞金総額は1万ドルでした。参加者に与えられたのは、内容が分からないよう匿名化された93個のカウント特徴量です。それらを手掛かりとして、各商品を9つのカテゴリーへ分類する課題でした。特徴量の意味を業務知識から推測できないため、データの変換方法や複数モデルの組み合わせが成績を左右する、純粋な表データ分析能力が問われる設定です。優勝したGilberto Titericz氏とStanislav Semenov氏は、いずれもKaggleのGrandmasterとして世界ランキング1位を経験した競技機械学習の専門家です。両氏の解法は36モデルを重ねたスタッキング構成であり、単一モデルを標準設定で動かす方法とは、投入する知識や作業量が大きく異なります。この記録をTabPFN-3.5が上回ったことは、表データ向け基盤モデルが、熟練者による複雑なモデル構築へ近づいた事例として捉えられます。
スコア差の0.007だけを見ると、改善幅は小さく感じられるかもしれません。しかし上位ではわずかな改善ほど難しくなります。Erickson氏の説明では、50位から10位へ上がる際の対数損失の改善は0.41から0.40までの0.01でした。そこから優勝値の0.382へ到達するには、さらに0.018の改善が必要でした。AutoGluonも2020年時点の23位相当から、2023年のバージョン1.0で14位相当、2026年8月のバージョン1.6で9位相当まで段階的に向上しています。この長い改善過程と比べることで、デフォルト設定による0.375の位置づけが分かりやすくなります。
データセットごとの学習を省く仕組み
TabPFNの名称に含まれるPFNは、Prior-Data Fitted Networkを指します。一般的な機械学習では、利用者が手元の訓練データに対して最適化処理を行い、そのデータ専用のモデルを作ります。TabPFN-3.5では、事前学習済みのTransformerが訓練例と予測対象を文脈として受け取り、その場で関係性を読み取って予測します。大規模言語モデルが入力文脈から回答を組み立てる方法に似ていますが、扱う対象は行と列で構成された表データです。事前学習には合成データが使われており、OttoのデータやKaggleの各データセットは含まれていません。特定コンテストの答えを記憶していたのではなく、人工的に生成された多様な表から、変数同士の関係や予測問題の解き方を学んだと説明されています。Ottoでの検証を再現できるKaggle Notebookも公開されているため、設定や処理手順を利用者側で確認できます。
この方式が業務にもたらす利点は、モデル開発時間の短縮だけではありません。案件ごとに異なる調整を減らせれば、担当者による結果のばらつきを抑えやすくなり、初期検証の再現性も高められるでしょう。ただし、データセット固有の学習が不要だからといって、業務上の検証まで不要になるわけではありません。目的変数の定義、データ漏洩の有無、評価指標の選択、時系列に沿った分割などは、引き続き利用者が確認すべき領域です。TabPFN-3.5が自動化するのは予測モデル構築の中核部分であり、課題設定や品質管理そのものではありません。
220Mパラメータを支える設計変更
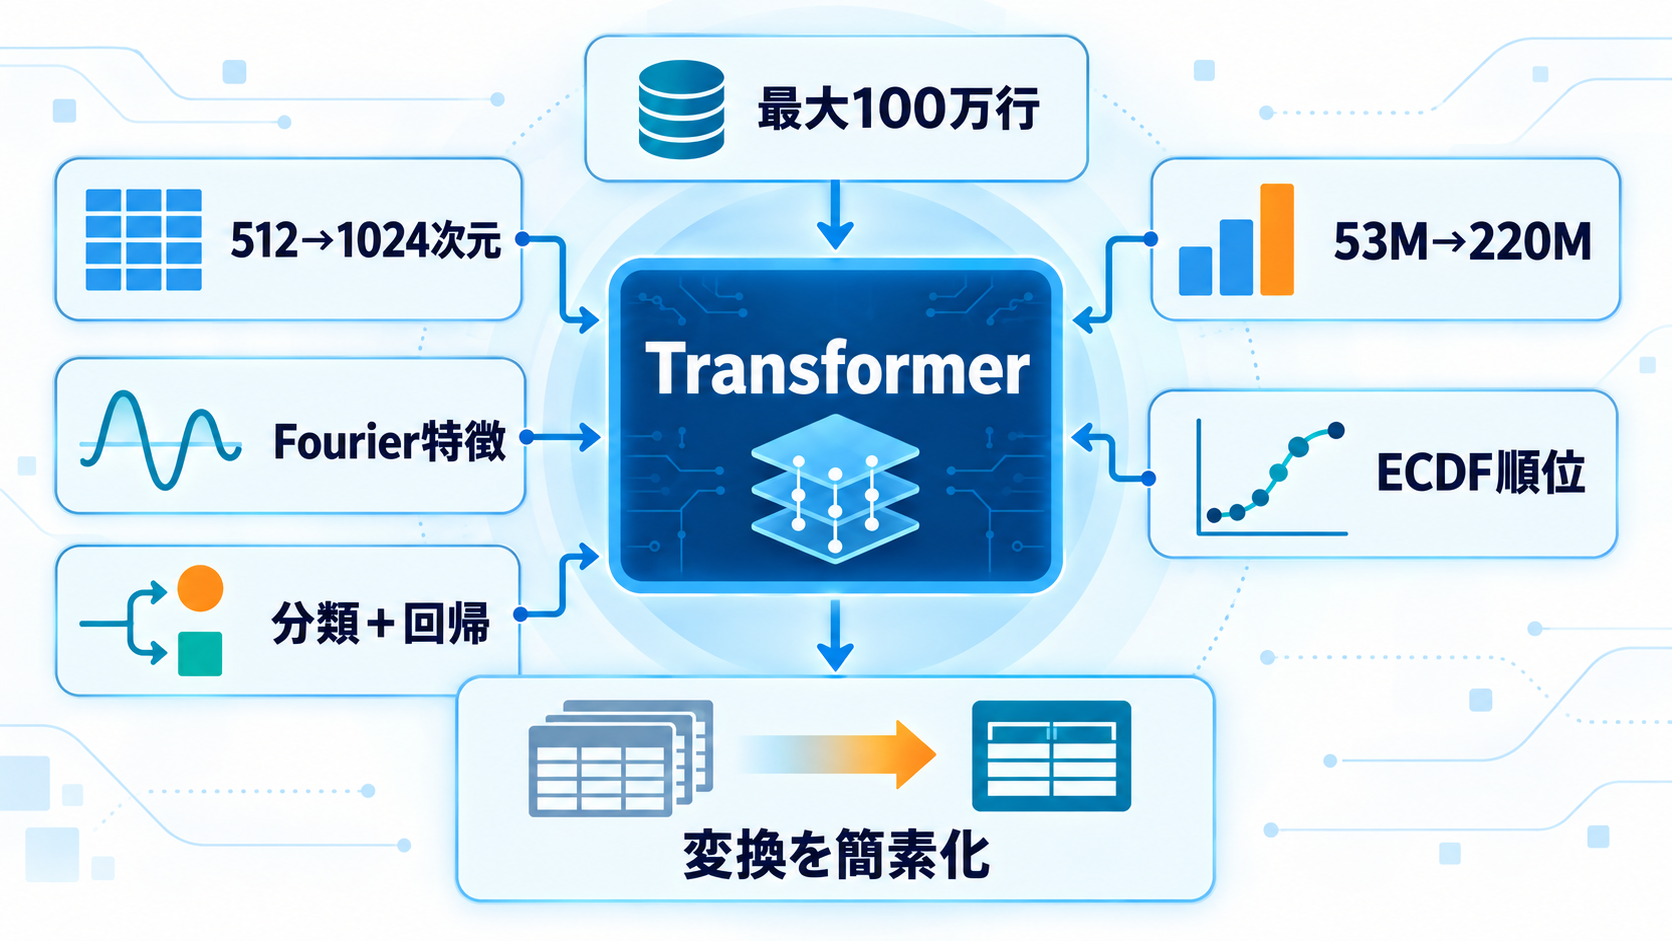
TabPFN-3.5の基本モデルは2億2,000万パラメータを持ち、TabPFN-3の分類モデルが備えていた5,300万パラメータから約4倍へ拡大しました。Transformer内部の次元数も512から1,024へ広げられています。分類用と回帰用に分けていたモデルは、単一のマルチタスク・チェックポイントに統合されました。導入側は、カテゴリーを予測する課題と連続値を予測する課題で、別々のモデル資産を管理する負担を減らせます。数値セルの表現には、学習可能なフーリエ特徴と、入力文脈内で計算する経験累積分布関数の順位情報が採用されています。フーリエ特徴は数値の複雑な変化を捉えるための表現で、順位情報は値を小さい順に見た位置を示します。順位は対数変換のような単調変換を加えても変わらないため、値の尺度や分布が異なるデータに対する頑健性を期待できます。従来用いられていた分位点変換、ロバストスケーリング、特異値分解による特徴量は取り除かれ、前処理は簡素化されました。
合成データを作る事前分布も調整され、高カーディナリティー、列数の多い表、グループ構造を持つ表が重視されています。対応規模は最大100万行で、特徴量は6,000個が推奨され、最大2万個までサポートされます。パラメータ数が増えても、過去の計算結果を再利用するKVキャッシュの大きさはTabPFN-3とほぼ同程度です。キャッシュ利用時の1行予測も従来版と同等の速度ですが、大きな訓練データを入力する場合、基本モデルはTabPFN-3より最大2倍遅くなるとされています。モデルの大型化が、あらゆる条件で無条件に高速化をもたらすわけではない点には注意が必要です。
7ベンチマーク首位をどう読むか
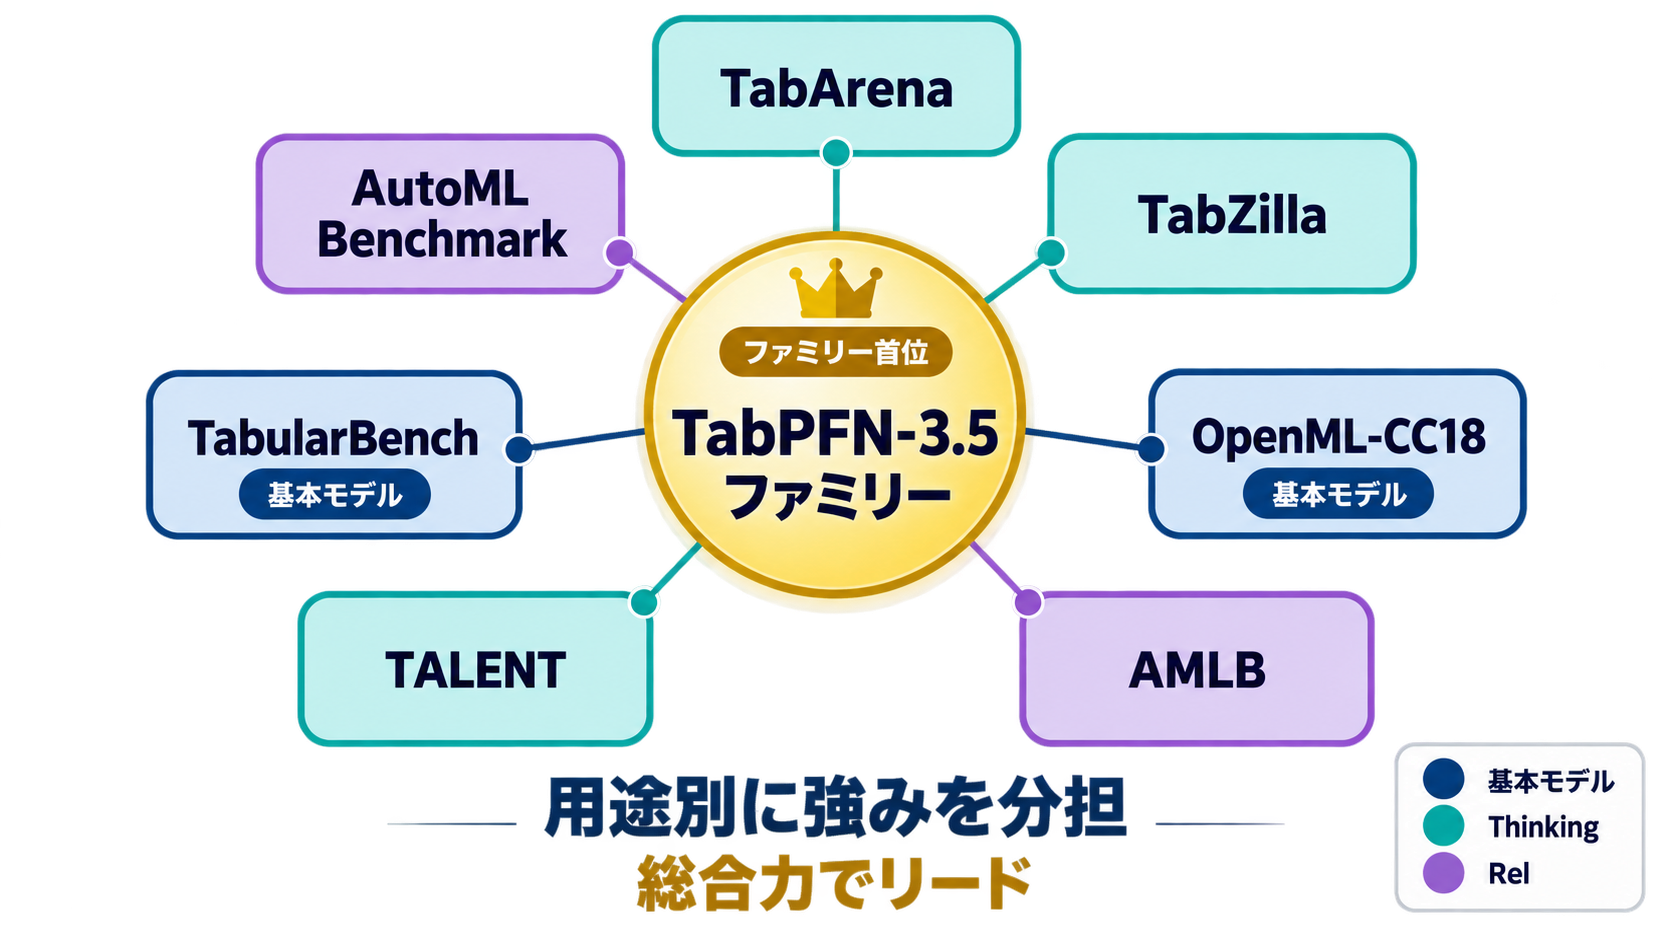
Prior Labsは、TabArena、BeyondArena、STRABLE、MulTaBench、RelArena-α、TALENT、ScoringBenchという7種類の表データベンチマークで首位になったと報告しています。ただし、すべてを同一の基本モデルが制したわけではありません。TabArena、BeyondArena、STRABLE、MulTaBenchでは推論時計算を増やすTabPFN-3.5-Thinkingが首位で、RelArena-αでは社内ハーネスのプレビュー版であるTabPFN-Relが最高成績を収めています。製品比較では「TabPFN-3.5ファミリーの首位」と「基本モデル単体の成績」を分けて見る必要があります。51データセットを継続的に評価するTabArenaでは、Thinking版がElo 1910、基本モデルが1866を記録しました。比較対象のTabFM+は1823です。Prior Labsによれば、基本モデルはAutoGluon 1.6のextreme設定より5分の1の時間で動作し、Eloで130ポイント上回りました。Eloは対戦結果から相対的な強さを表す指標なので、個別企業のデータで同じ差が再現されることを保証する数値ではありません。それでも、多数のデータセットを横断した初期比較としては参考になります。
BeyondArenaは142データセットを含み、グループ化データ、時系列、横に広い表、テキストを多く含む表、高カーディナリティーなど、性質の異なる条件を扱います。TabPFN-3.5は全体で従来の首位より約150 Elo高い結果となりましたが、グループ化、時系列、大規模データの各領域では、調整済みの多層パーセプトロンをアンサンブルした手法が首位を維持しています。したがって、TabPFN-3.5は幅広い課題に強い汎用候補である一方、特定構造を持つデータでは専用に調整した方式が優位になる場合もある、と読むのが妥当でしょう。
速度と用途で分かれる4つのモデル
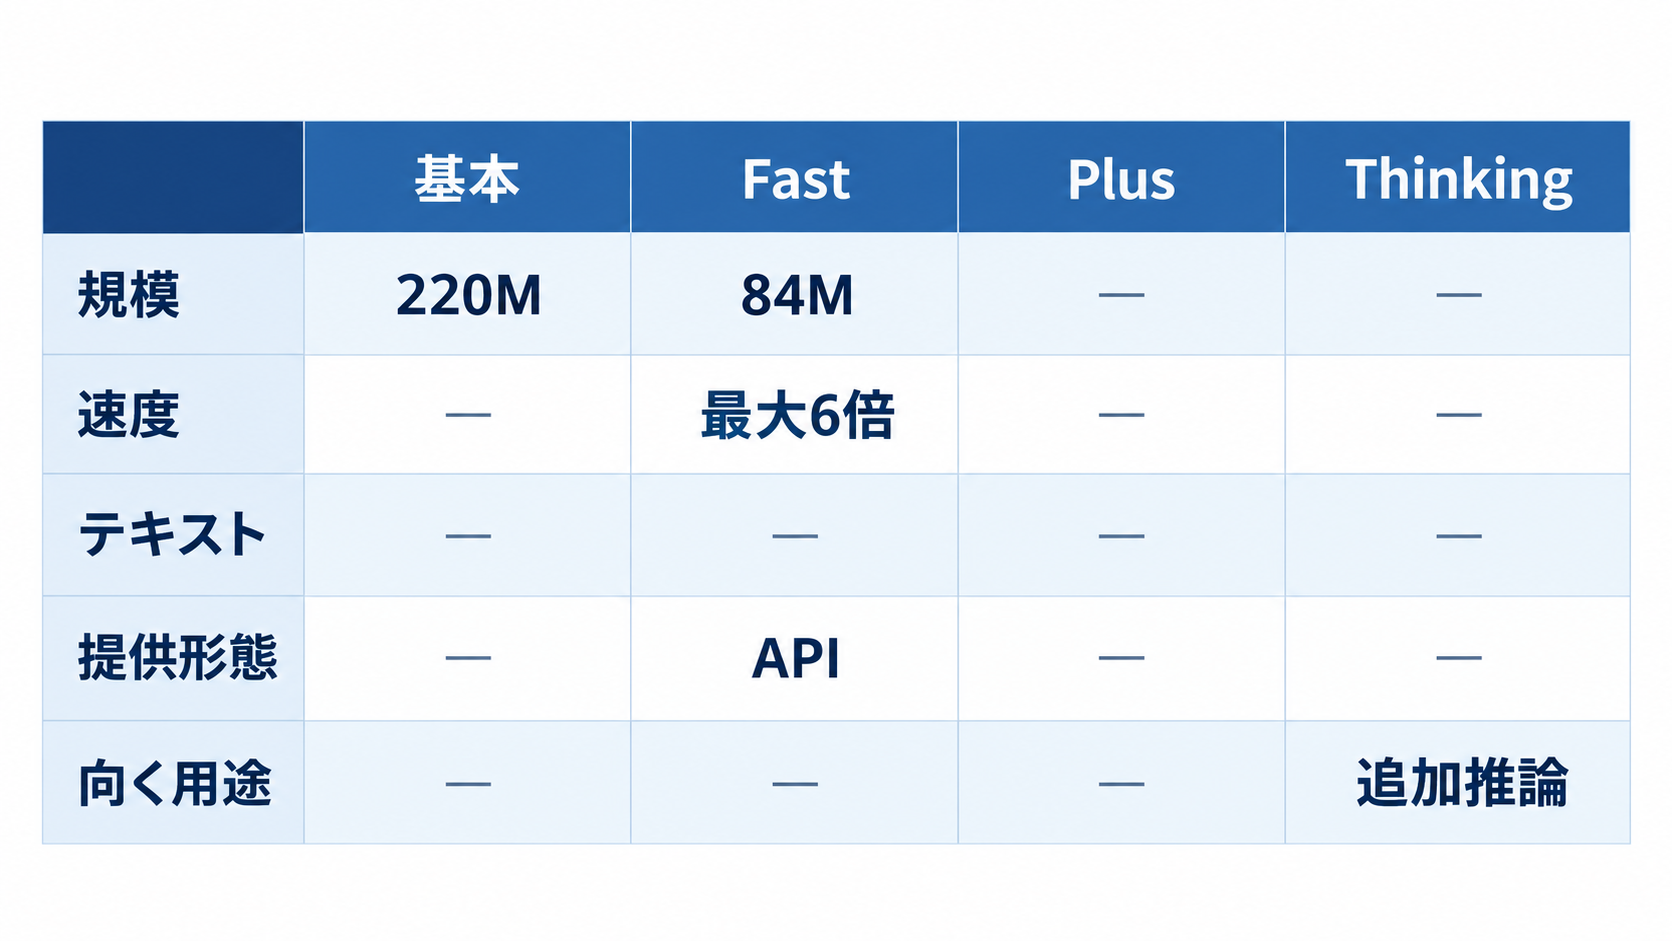
TabPFN-3.5は、計算資源や利用目的に応じた4つのモデルで構成されます。基本モデルは2億2,000万パラメータで、デフォルトでは8つの推定器を利用します。TabPFN-3.5-Fastはアルファ版で、8,400万パラメータに小型化され、基本モデルより最大6倍高速です。精度だけでなく、繰り返し実行する検証や応答時間が重視される用途では、Fast版が比較候補になります。TabPFN-3.5-PlusはAPIおよび企業向けに提供され、テキストのネイティブ処理とFP8 attentionを追加しています。商品説明や問い合わせ内容など、数値列と文字列が混在する業務データを扱う場合に関係するモデルです。TabPFN-3.5-Thinkingは、推論時に追加の計算を行って精度向上を狙います。その処理に大規模言語モデル、実データ、外部検索は使われておらず、TabPFN-3-Thinkingより最大12倍高速とされています。
選定時は最高スコアだけで決めず、データ量、許容遅延、文字列列の有無、実行回数、インフラ費用を並べて考える必要があります。定期的なバッチ予測で精度を優先するなら基本モデルやThinking版が候補となり、対話的な分析や多数の試行ではFast版が扱いやすい可能性があります。テキストを含む企業データではPlus版が検討対象になりますが、APIへ送信できる情報の範囲や社内のデータ管理規程も確認しなければなりません。各モデルの速度表現には「最大」という条件が付くため、自社の行数や列数に近いデータで実測することが欠かせません。
オープンウェイトでも商用利用は別契約
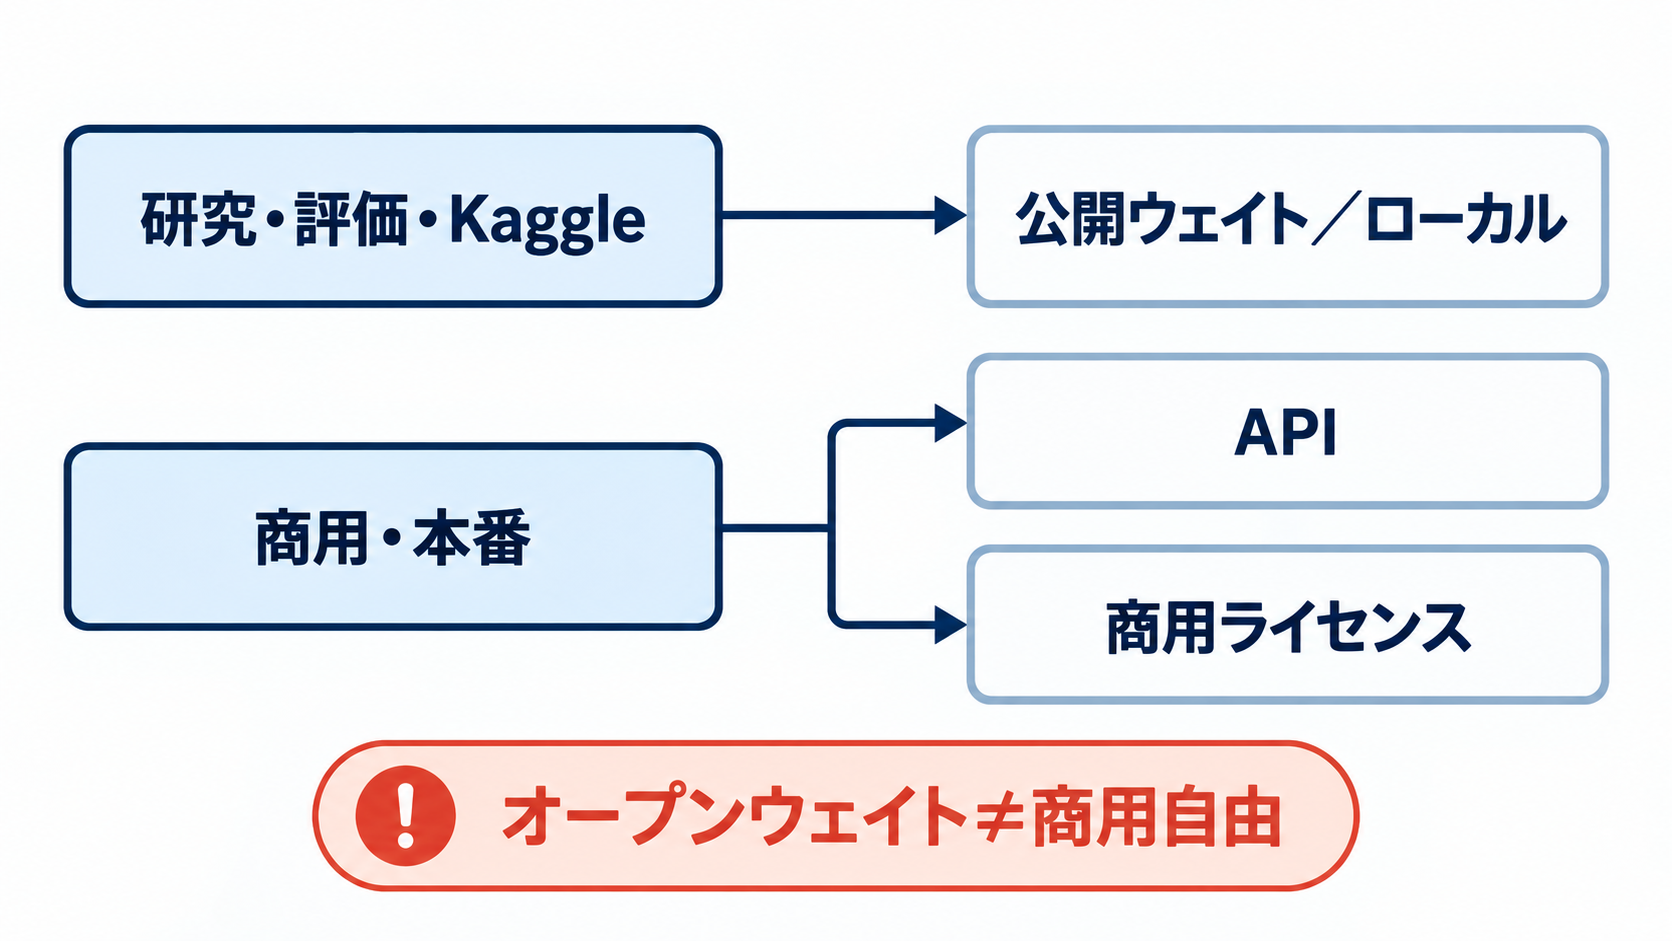
TabPFN-3.5の基本モデルとFast版は、重みを取得してローカル環境で実行できます。ただし、公開されている重みの利用範囲は研究、評価、Kaggleなどの非商用用途です。本番環境で商用利用する場合は、Prior LabsのAPIまたは商用ライセンスが必要になります。「重みが公開されていること」と「用途を問わず自由に使えること」は同義ではありません。企業がPoCを始める際は、評価段階と本番段階を切り分けて計画すると整理しやすくなります。ローカル環境で技術評価を行えることは、機密データを外部へ送信せず、既存モデルとの精度や処理時間を比較するうえで利点になります。しかし、評価結果をそのまま顧客向けサービスや社内業務の本番処理へ移す場合、利用条件が変わる可能性があります。調達部門や法務部門を後から巻き込むのではなく、検証開始時点で想定用途を共有しておくほうが移行時の手戻りを抑えられるでしょう。
APIを選ぶ場合は、データの送信先、保存方針、障害時の扱い、処理量に応じた費用などを確認する必要があります。商用ライセンスでローカル運用する場合も、必要なGPU、更新方法、監視、モデルの再現性を運用設計へ含めなければなりません。現時点で確認できる情報だけでは、個別契約の料金や詳細条件までは明らかではありません。採用判断では、技術ベンチマークとライセンス条件を別々の評価項目にせず、総保有コストとデータガバナンスを含めて比較することが現実的です。
日本企業が試すなら「既存モデルの置き換え」から
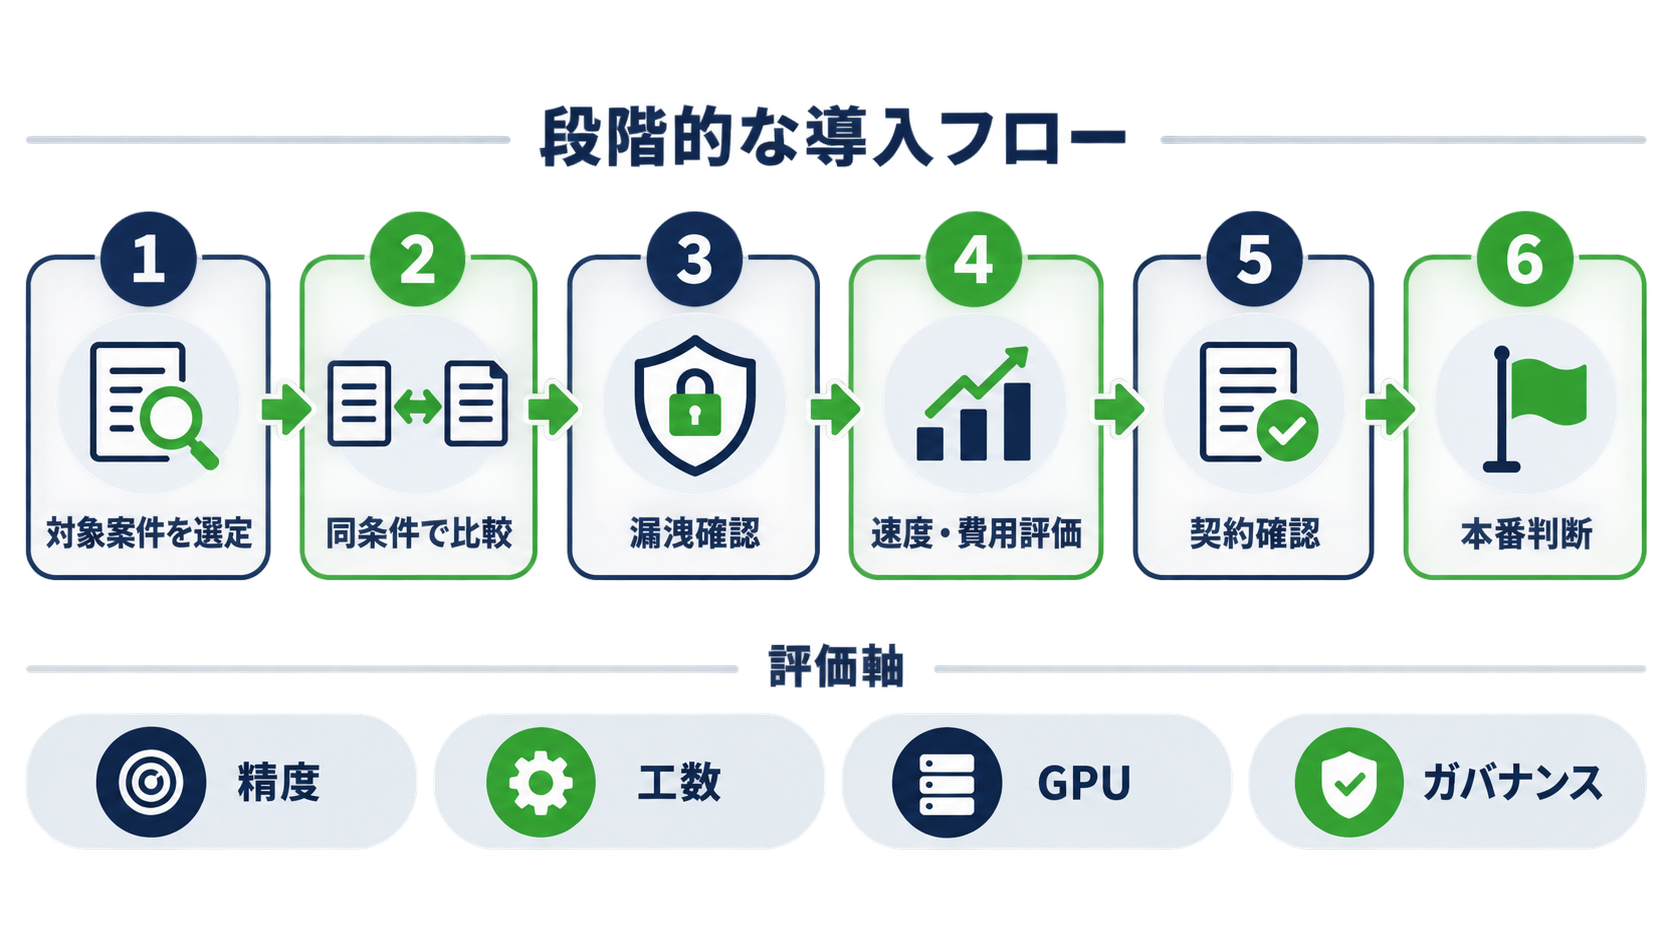
TabPFN-3.5を評価する最初の題材としては、新しいAIサービスを一から設計するより、すでに運用している表データ予測の置き換え候補として試すほうが効果を測りやすいでしょう。顧客の離反予測、案件の成約確率、商品のカテゴリー分類、需要量の回帰など、現在の評価指標と比較対象がそろっている業務であれば、デフォルト設定のままどこまで到達できるかを確認できます。検証では、従来モデルとTabPFN-3.5に同じ訓練期間、検証期間、評価指標を適用する必要があります。精度に加え、前処理や調整に要した担当者の時間、推論時間、必要なGPUメモリー、結果の安定性も記録すると、業務上の差が見えやすくなります。時系列データやグループ構造を持つデータでは専用手法が優位だったベンチマークもあるため、ランダム分割だけで高い精度が出ても採用を急ぐべきではありません。実際の利用時点より未来の情報が特徴量へ混入していないか、部署や顧客をまたいだ漏洩がないかも確認が必要です。
今回の発表から読み取れる中心的な変化は、表データ分析で競争力のある初期モデルを作るまでの負担が小さくなりつつあることです。ただし、最終判断を自動化できるという意味ではありません。まず代表的な1案件を選び、既存の勾配ブースティング、AutoML、社内標準モデルと同条件で比較するのが具体的な一歩になります。TabPFN-3.5が精度だけでなく開発時間も減らせるなら、その時点でAPIまたは商用ライセンスを含む本番構成を検討する価値が生まれます。