
AI LAB
2026/10/25
DNAを英語で読み解く「Carbon-X」登場、機密配列を社内GPUで扱えるオープンモデルの実力と限界
DNA解析を対話型AIへ持ち込むCarbon-X
Hugging Faceの生命科学部門Hugging Face Bioは、DNA配列と英語を同じモデルで扱える「Carbon-X」を公開しました。塩基配列をチャットへ直接入力すると、変異が良性か病原性を持つ可能性があるかを推定し、遺伝子発現に関係する制御領域の識別、 organismの分類、次に続く塩基の予測などに英語で回答します。パラメータ数は148億で、複数の専門モデルを切り替えるのではなく、単一のデコーダー型モデルとして設計されています。企業や研究機関にとって注目すべき点は、対話の目新しさだけではありません。モデルの重みがApache License 2.0で提供され、機密性の高い配列を外部APIへ送らず、自組織が管理するGPU上で処理できることです。ヒト由来のゲノムデータや未公開の研究データは、一般的な業務文書以上に慎重な取り扱いが求められます。オープンウェイトの選択肢が加わることで、データの保存場所やアクセス権限を管理しながら、生成AI型の操作環境を検証しやすくなります。
開発には、中国の研究機関である中関村学院と、イタリアの遺伝医学研究機関TIGEMおよびナポリ・フェデリコ2世大学が参加しました。ただし、Carbon-Xは診断を目的として臨床的に検証された医療機器ではありません。現段階で想定しやすいのは、研究候補の絞り込み、既存解析を補助する仮説生成、専門家が確認する前段階の分類といった用途です。DNAを理解する万能な専門家としてではなく、自然言語と配列解析の間をつなぐ研究支援モデルとして捉える必要があります。
DNAと英語を一つのトークン列で処理する仕組み
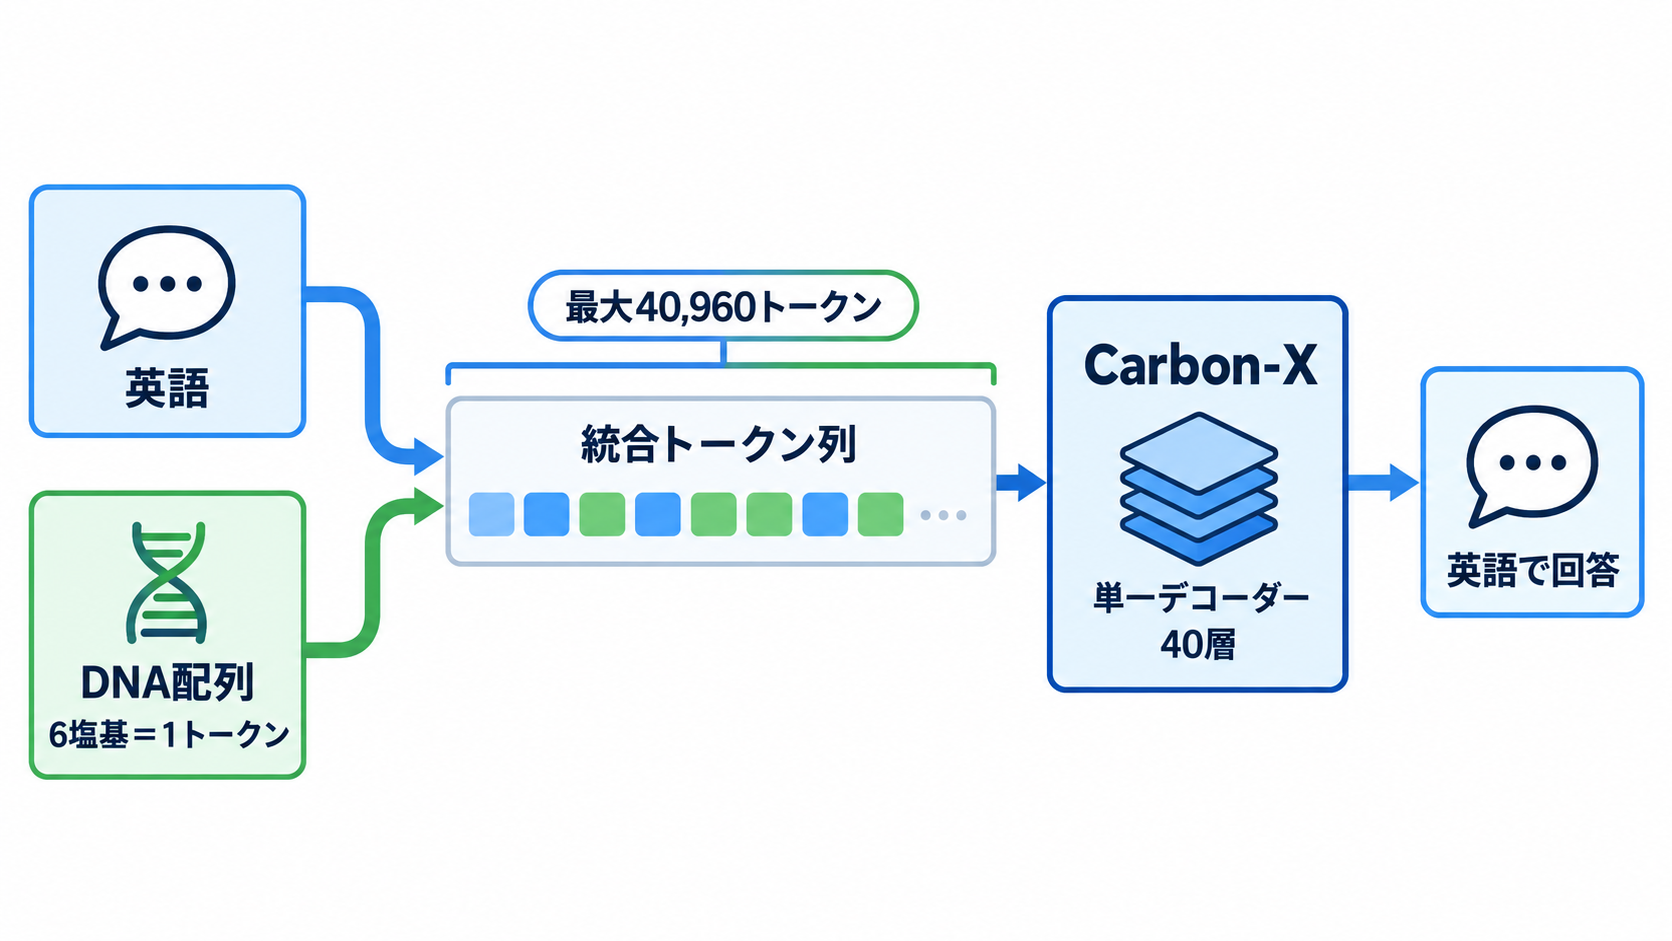
Carbon-Xの基盤には、AlibabaのQwenチームが公開した汎用言語モデル「Qwen3-14B」が使われています。特徴は、DNA専用のエンコーダーを別に置かず、英語とDNAを一つのトークン列として単一のデコーダーへ渡す構成です。過去のDNA言語モデルには配列処理用の独立した機構を備えるものもありましたが、Carbon-Xでは質問文、塩基配列、回答を同じ推論の流れへ収めています。これにより、配列を読んだうえで理由や予測結果を自然言語として返す設計が簡潔になります。両者を橋渡しするのがハイブリッドトークナイザーです。文章にはQwen3のBPE語彙を引き続き使用し、DNA用として5,515個のトークンを追加しました。この内訳には、A、C、G、Tの組み合わせを6塩基単位で表す4,096個の非重複トークン、末尾に残る短い配列を処理する1,364個のトークン、3個の特殊マーカーが含まれます。6文字以上連続するDNA配列は自動で識別され、基本的には6塩基を一つのトークンとして処理します。
モデル本体は40層、隠れ層の次元数5,120というQwen3系の構成で、キーと値を共有して推論時のメモリ負荷を抑えるGQAを採用し、KVヘッド数は8です。最大コンテキスト長は40,960トークンですが、これは必ずしも40,960塩基だけを意味しません。DNA部分では1トークンが最大6塩基を担う一方、質問や回答の英語も同じ枠を消費するためです。実務で投入できる配列長は、指示文や期待する回答量を含めて評価する必要があります。
英語能力を失わずDNAを学ばせた四段階の訓練
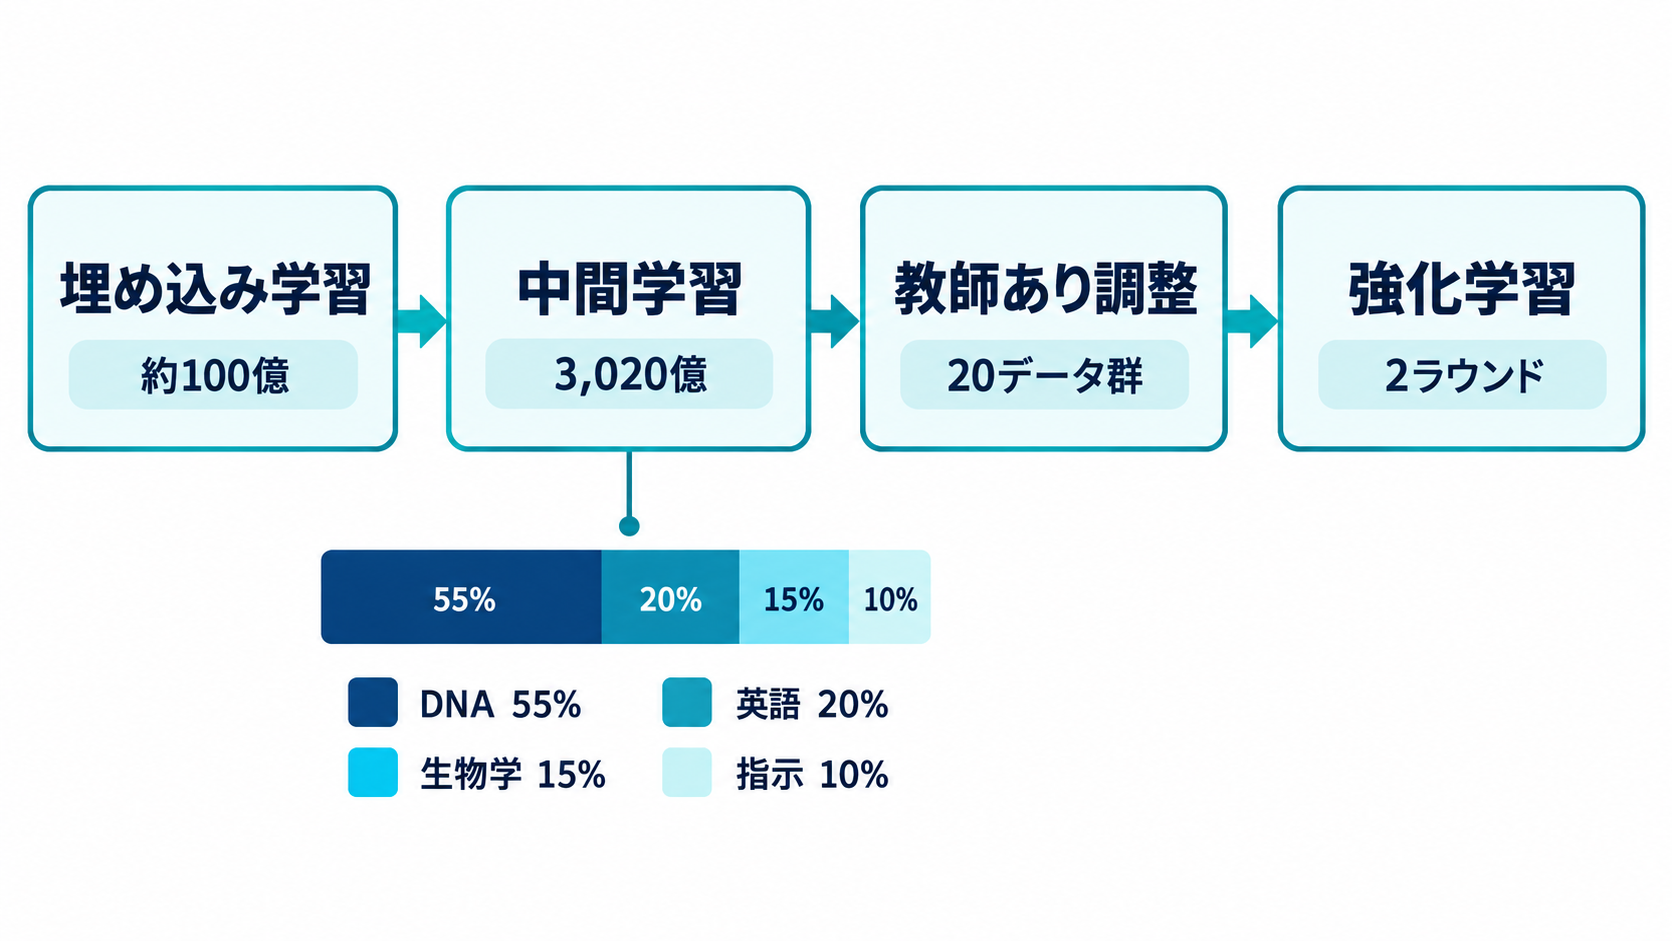
DNAを追加学習させれば、そのまま有用な対話モデルになるわけではありません。Carbon-Xの開発では、DNAパターンの獲得と、Qwen3がもともと備えていた英語能力の維持が主要な調整課題になりました。Hugging Faceの説明では、学習率が高すぎるとDNAの学習は進むものの、英語で適切に応答する能力が損なわれました。より低い学習率、148億パラメータ規模のモデル、長時間の学習を組み合わせることで、この競合を抑えています。訓練は四段階です。埋め込みのウォームアップではTransformer本体を固定し、約100億トークンを使って新設したDNAトークンの埋め込みだけを学習させました。続く中間学習では、シーケンス長8,192で3,020億トークンを処理しています。データ構成は生のDNAが55%、英語が20%、生物学関連の文章が15%、指示データが10%です。DNAだけへ偏らず、質問を理解して説明を返す能力も学習対象に残した配合といえます。
教師あり微調整では20のデータセット群を3エポック学習し、分野の専門家と構築した決定論的な検証器によって回答を確認しました。最後は、検証可能な報酬を使う非同期GRPO方式の強化学習を2ラウンド実施し、TRLと高速推論基盤vLLMを利用しています。基盤のQwen3-14Bへ強化学習だけを直接適用した試みでは、FrontierVEPで偶然と同等の50%基準を超えられませんでした。この結果は、専門モデル化において最終段の調整だけでなく、語彙の追加と大規模な中間学習が効いていることを示唆します。
平均66.7%という成績をどう読むか
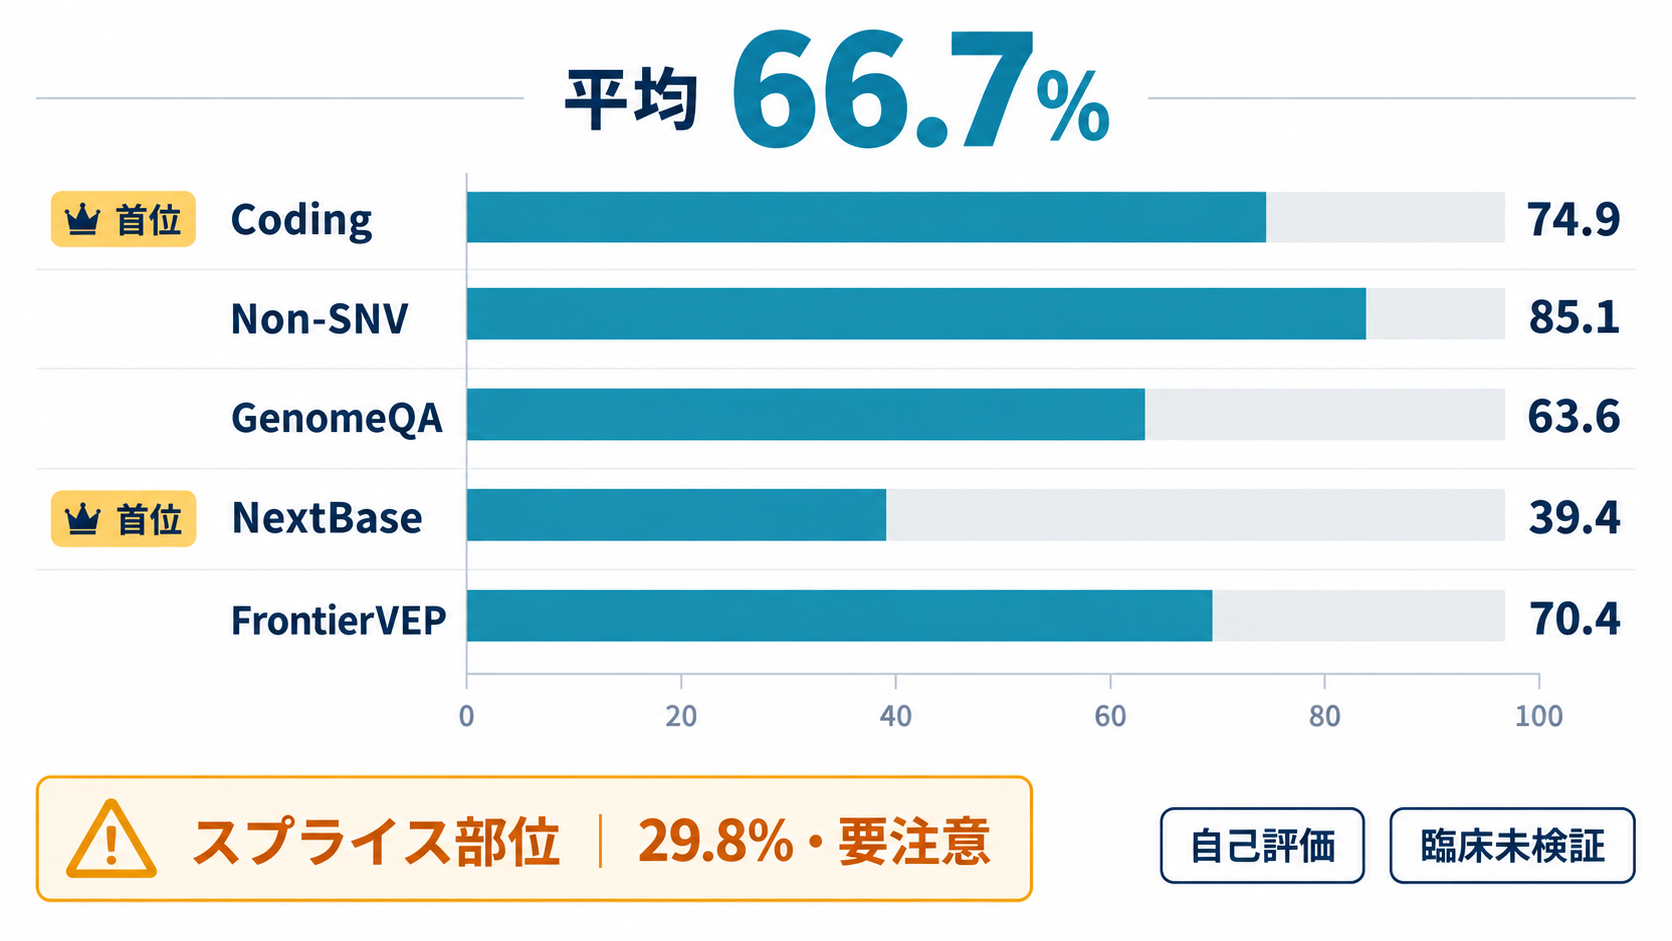
Hugging Faceが報告した5種類のDNAベンチマークにおいて、Carbon-Xの平均スコアは66.7%でした。比較されたオープンモデルの中では最も高く、汎用のフロンティアモデル「GPT-6.1 Sol」の67.5%に0.8ポイント差まで迫っています。基盤モデルのQwen3-14Bに対しては27ポイント高く、DNA向けの学習が専門タスクへ反映された形です。ただし、これらはHugging Faceによる自己評価であり、独立した第三者検証の結果ではありません。得意分野は均一ではありません。コード領域の変異効果を扱うBioReason Codingでは74.9%となり、比較対象となったオープンモデルとクローズドモデルの双方を上回りました。次の塩基を予測するNextBaseでも39.4%で首位です。BioReason Non-SNVは85.1%、GenomeQAは63.6%、複雑な変異を扱うFrontierVEPは70.4%でした。GenomeQAのうちスプライス部位に関する設問は29.8%にとどまっており、領域によって精度差が大きい点を見落とせません。
比較条件にも注意が必要です。Carbon-Xは思考モードを無効にして評価され、競合モデルはそれぞれ最も高い推論努力の設定で実行されました。また、モデルが回答を拒否するとスコアが大きく変わります。NextBaseではOpus 5.5の成績が低推論設定の17.7%から最大設定の1.1%へ下がり、FrontierVEPでもGemini 4 Argonが58%から38%へ低下したと報告されています。拒否の多さ、回答形式、推論設定が異なるため、単純な順位だけで性能を判断するのは適切ではありません。なお、一般的な指示追従能力を測るIFEvalでは、プロンプト単位の厳密精度79.3%を維持しています。
1基のGPUと量子化モデルが変える導入条件
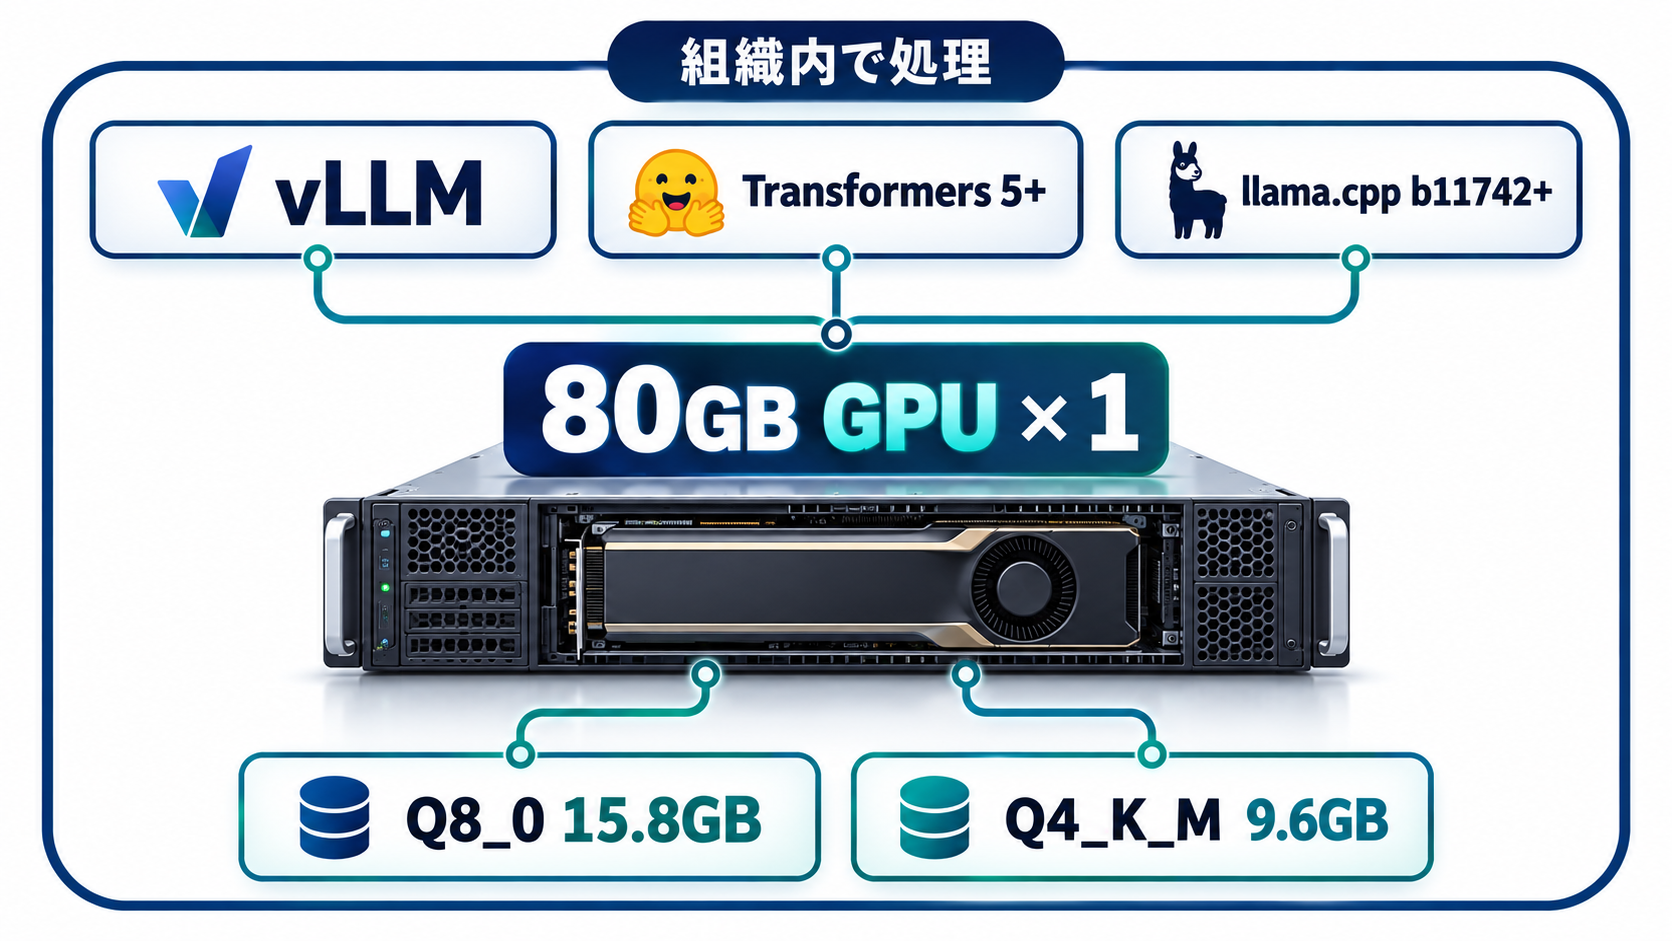
Carbon-Xは、bfloat16形式であれば80GBのメモリを備えたGPU 1基で動作し、vLLMまたはTransformersから利用できます。研究機関がオンプレミス環境や専用クラウドへ配置する際、複数GPUを前提とする巨大モデルより構成を単純化しやすい規模です。公式のGGUF版も用意され、Q8_0量子化は15.8GB、Q4_K_M量子化は9.6GBです。量子化によって必要なメモリ容量を抑えられますが、利用環境ごとの速度や精度への影響は別途検証すべきでしょう。vLLMではモデル名を指定し、リモートコードを許可してサーバーを起動します。Transformersはバージョン5以降が必要で、DNA用トークナイザーを読み込むために `trust_remote_code=True` を設定します。llama.cppを使う場合はb11742以降が要件です。古いビルドではDNAが誤ってトークン化されるため、起動できるかどうかだけでなく、期待した塩基単位へ分割されているかも確認しなければなりません。推論時は、訓練および評価条件に合わせて `enable_thinking=False` を維持します。
Hugging Faceは、H200 GPUの利用料金を1時間5ドルとして実測スループットを計算し、問題当たりの推論費用がGPT-6.1 Solの約1,800分の1になると報告しています。ClinVarに登録された意義不明の変異240万件を採点する想定では約300ドルで、フロンティアモデルの場合は3万2,000ドルから400万ドルと試算しました。これらは特定の料金、処理量、評価手順に基づく比較であり、企業の総保有コストではありません。GPU調達、電力、監視、保守、セキュリティ対策、人による確認まで含めた費用は組織ごとに見積もる必要があります。
単体モデルより専門サブエージェントとしての活用
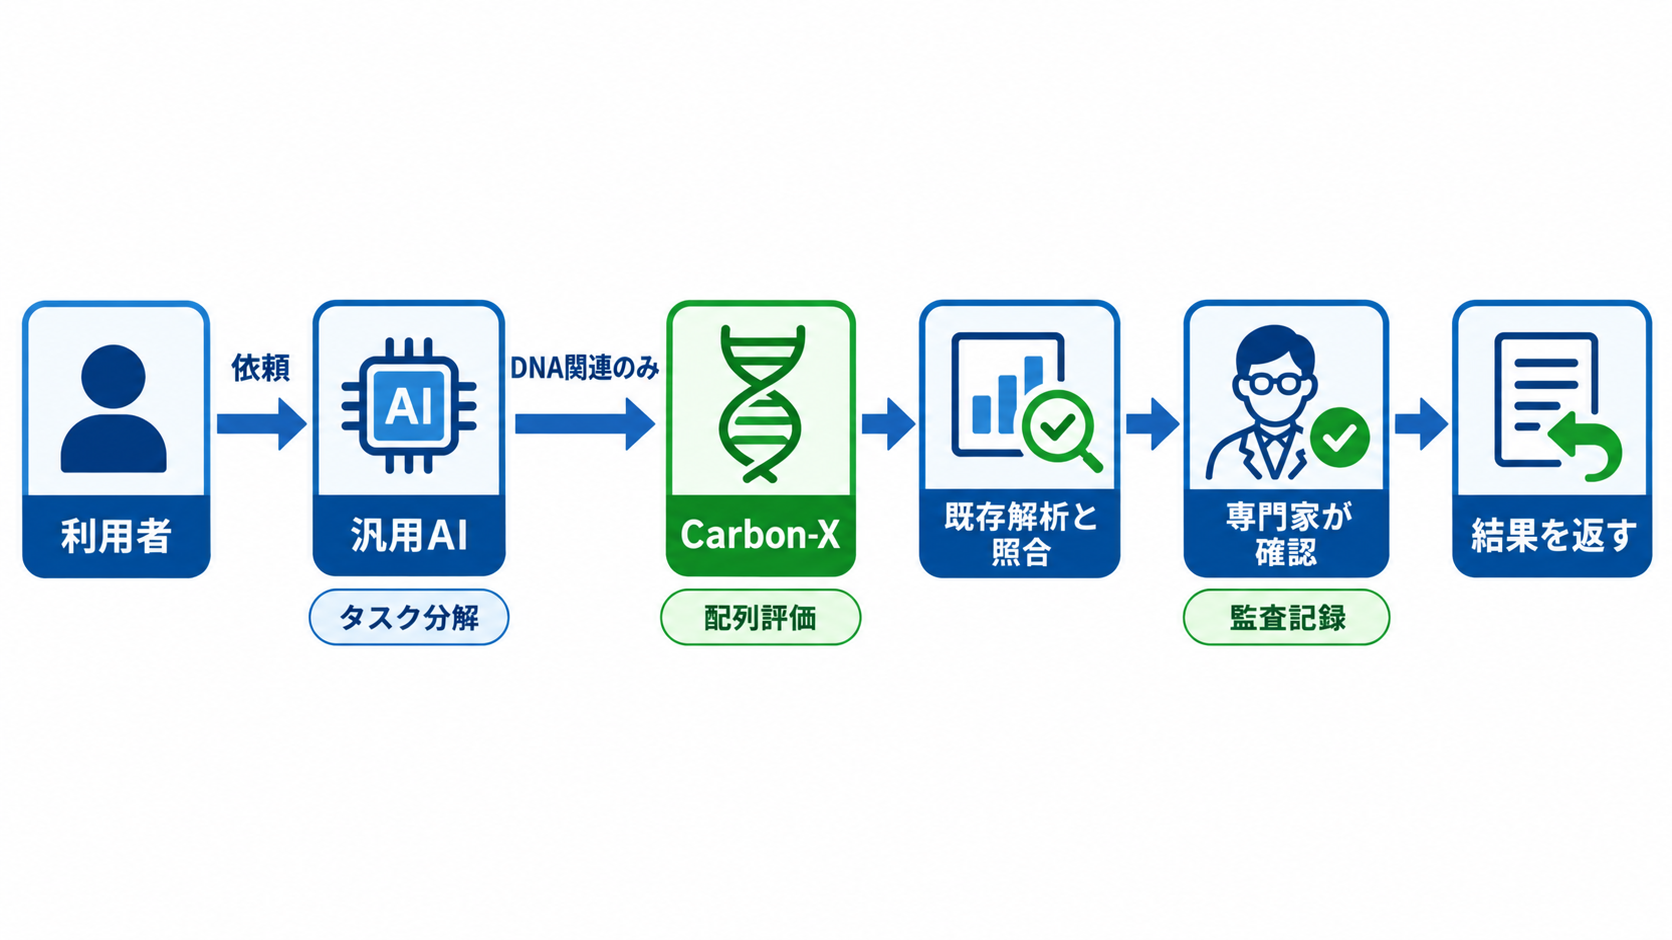
Carbon-Xの企業利用では、すべての問い合わせを一つのモデルへ任せる構成より、DNA関連の処理だけを担当する専門サブエージェントとして組み込む方法が現実的です。公開情報では、汎用モデルKimi K3がCarbon-Xへ問い合わせる構成を取ったところ、DNA指標が49.4%から60.5%へ上昇しました。汎用モデルが利用者との対話やタスク分解を担当し、配列の評価が必要な場面だけCarbon-Xを呼び出す分業の有効性を示す結果です。配布リポジトリにはOpenAI互換形式のツール、評価フレームワークInspect向けのエージェント、コーディングエージェント用のcarbon-dnaスキルが含まれています。既存のAI基盤がOpenAI形式のツール呼び出しに対応していれば、専門モデルを独立した推論サービスとして接続しやすくなります。たとえば、入力形式の検査、Carbon-Xによる候補分類、既存データベースや従来型解析との照合、専門家による承認という流れに分ければ、モデルの出力をそのまま最終判断にしない運用を設計できます。
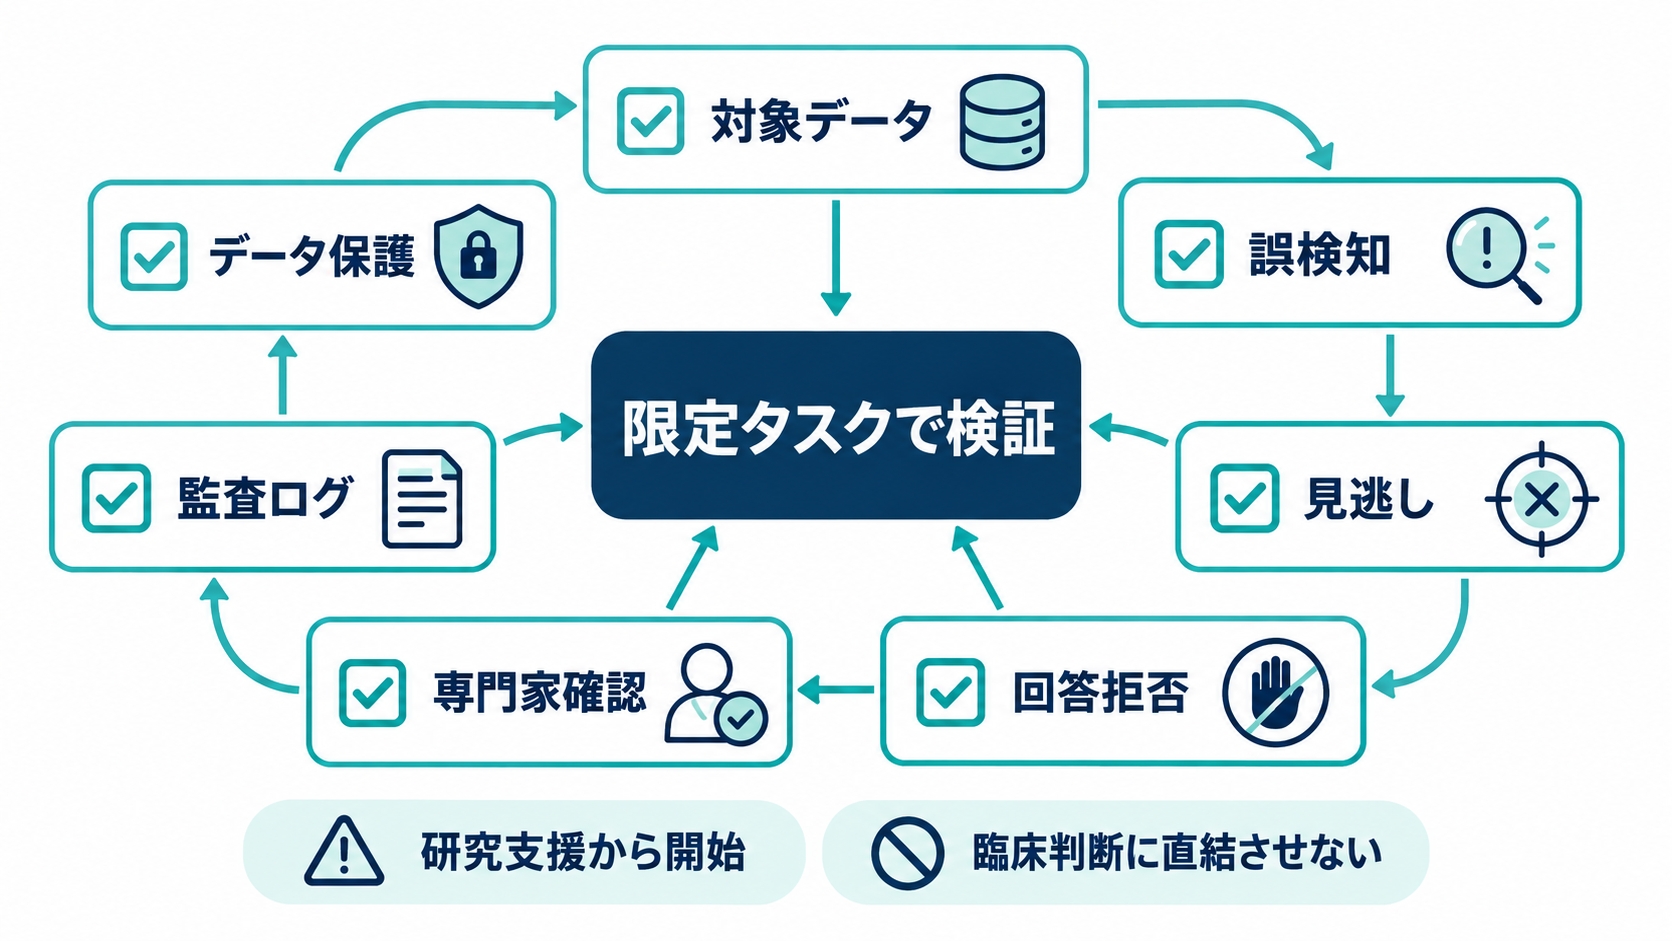
日本企業が試す場合は、モデル精度の比較だけでなく、どの工程を支援させるかを先に限定することが欠かせません。候補変異の優先順位付け、解析結果に対する補足説明、研究者向けの検索支援など、誤りを人が発見できる用途から始めるのが妥当です。入力配列、指示文、モデルの回答、採用・却下の判断を記録すれば、再現性と監査可能性も確保しやすくなります。オープンウェイトであることは自由な利用を意味しますが、出力の品質や運用責任まで提供者が引き受けるわけではありません。
導入判断では精度より先に検証境界を決める
Carbon-Xを評価する際は、「DNAベンチマークで平均66.7%」という一つの数字を導入基準にしないことが重要です。実際の性能は、対象とする生物種、変異の種類、入力配列の長さ、質問形式、期待する回答粒度によって変わると考えられます。特にスプライス部位の設問で29.8%にとどまった点は、平均値が個別領域の弱点を覆い隠す例です。自社が扱うタスクに近いデータを用意し、誤検知と見逃しを分けて評価する必要があります。検証では、機密データを投入する前に公開データや合成データで処理経路を確認します。その後、専門家が正解を確認できる小規模な評価セットを作り、従来手法、Carbon-X単体、汎用モデルとの連携構成を同じ条件で比べると判断しやすくなります。回答拒否を失敗として扱うのか、安全な挙動として扱うのかも、用途に応じて事前に決めておくべきです。ベンチマーク順位だけでは、この業務上の価値を測れません。
臨床判断へつながる利用については、Carbon-Xが臨床的に検証されていないという制約が優先されます。モデルの推定を診断結果として扱わず、承認済みの検査手順や専門家の判断を置き換えない運用が必要です。企業内での最初の一歩としては、判断責任を伴わない研究支援タスクを一つ選び、データを外部へ送らない構成が本当に必要か、既存手法に比べて作業時間や候補抽出の質が改善するかを測るのが適切でしょう。Carbon-Xの価値は、派手な対話画面ではなく、専門家が検証できる範囲でDNA解析の入口を扱いやすくできるかどうかにあります。