
AI LAB
2026/10/24
声を文字にしないAI「Dessa」――Blockが挑む、感情と「間」を失わない音声対話
「大丈夫です」の声色まで受け取る音声AI
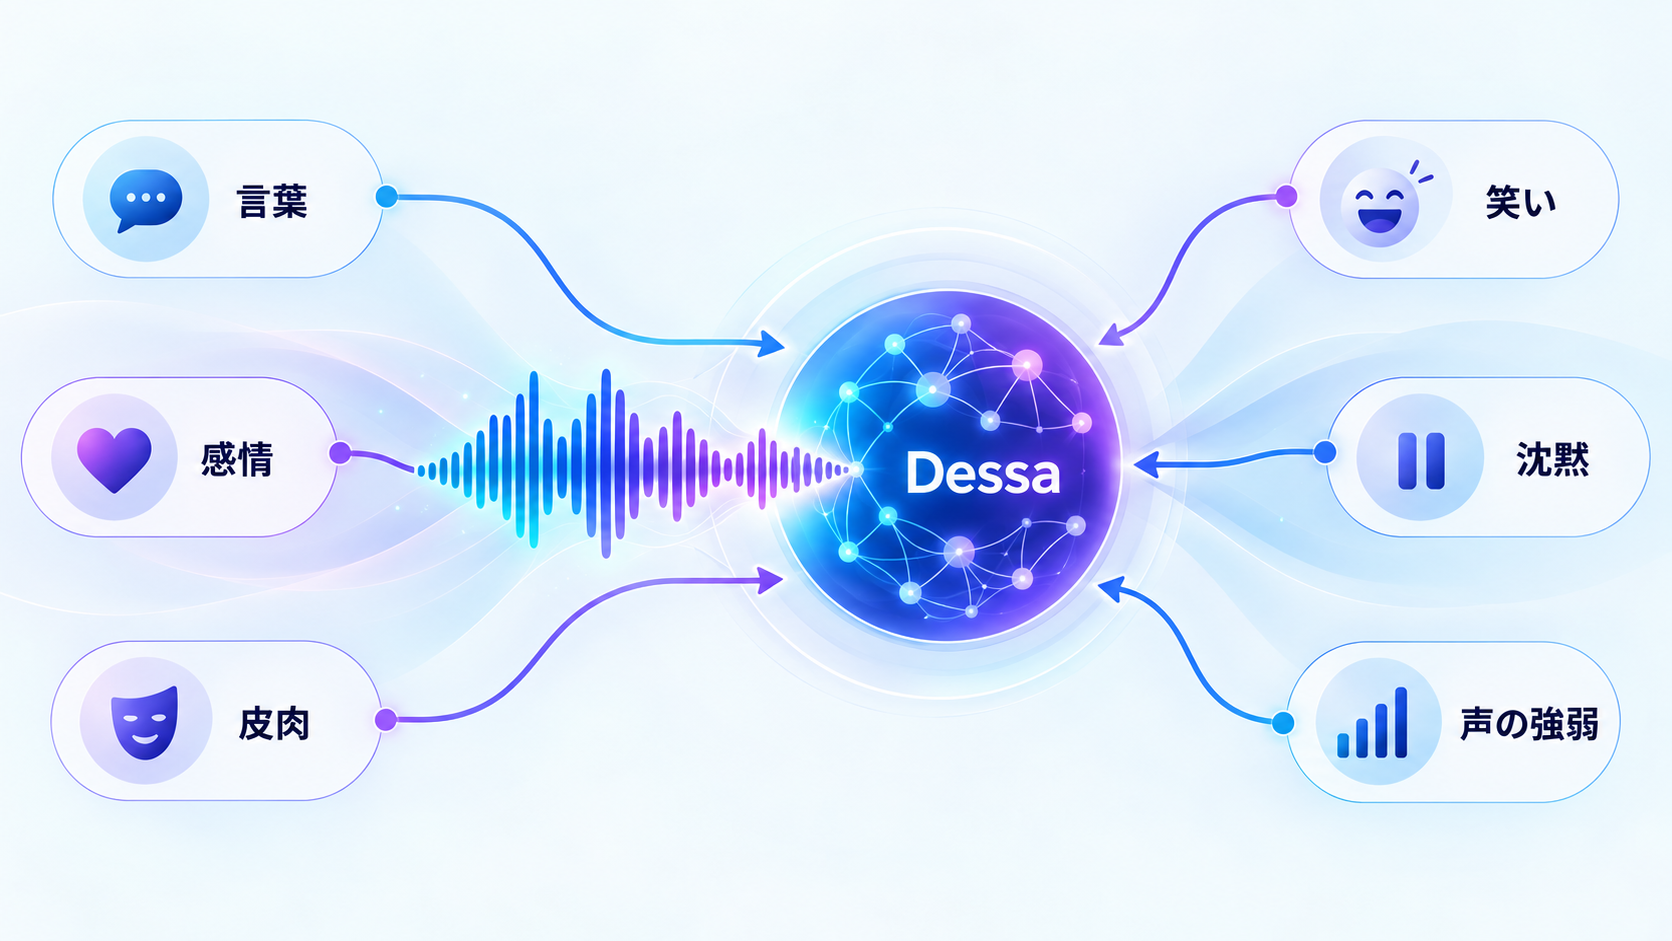
電話の相手が「大丈夫です」と答えても、声が震えていたり、言葉の前に長い沈黙があったりすれば、額面どおりには受け取れません。人間の会話では、何を話したかだけでなく、笑い、ためらい、皮肉、声の強弱といった非言語的な情報が意味を左右します。ところが、多くの音声AIは会話をいったん文字へ変換するため、その過程で重要な手掛かりが薄れてしまいます。SquareやCash Appを展開するBlockが発表した「Dessa」は、この問題に異なる方向から取り組む音声モデルです。同社によれば、Dessaはテキストデータや既存の事前学習済みモデルを使わず、人間の音声だけで一から学習した初のAIモデルです。入力音声を文字起こししてから処理するのではなく、音声を音声のまま扱い、感情、皮肉、笑い声、沈黙などをリアルタイムで捉える設計だと説明されています。
注目すべき点は、単に人間らしい声を合成できることではありません。話者がどのような調子で言葉を発し、いつ言いよどみ、どこで笑ったのかを入力情報として残そうとしている点です。顧客対応を例にすれば、同じ「分かりました」という返答でも、納得した声と不満を押し殺した声では、望ましい応答が変わる可能性があります。
もっとも、Dessaが感情を人間と同じように理解していると確認されたわけではありません。声の特徴を検出し、それに応じた反応を生成することと、内面的な感情を持つことは別の話です。企業が見るべきなのは擬人的な印象ではなく、従来の文字中心の処理で失われていた情報が、応答の正確さや安全性にどこまで寄与するかでしょう。
音声認識・言語モデル・読み上げを一本化する発想
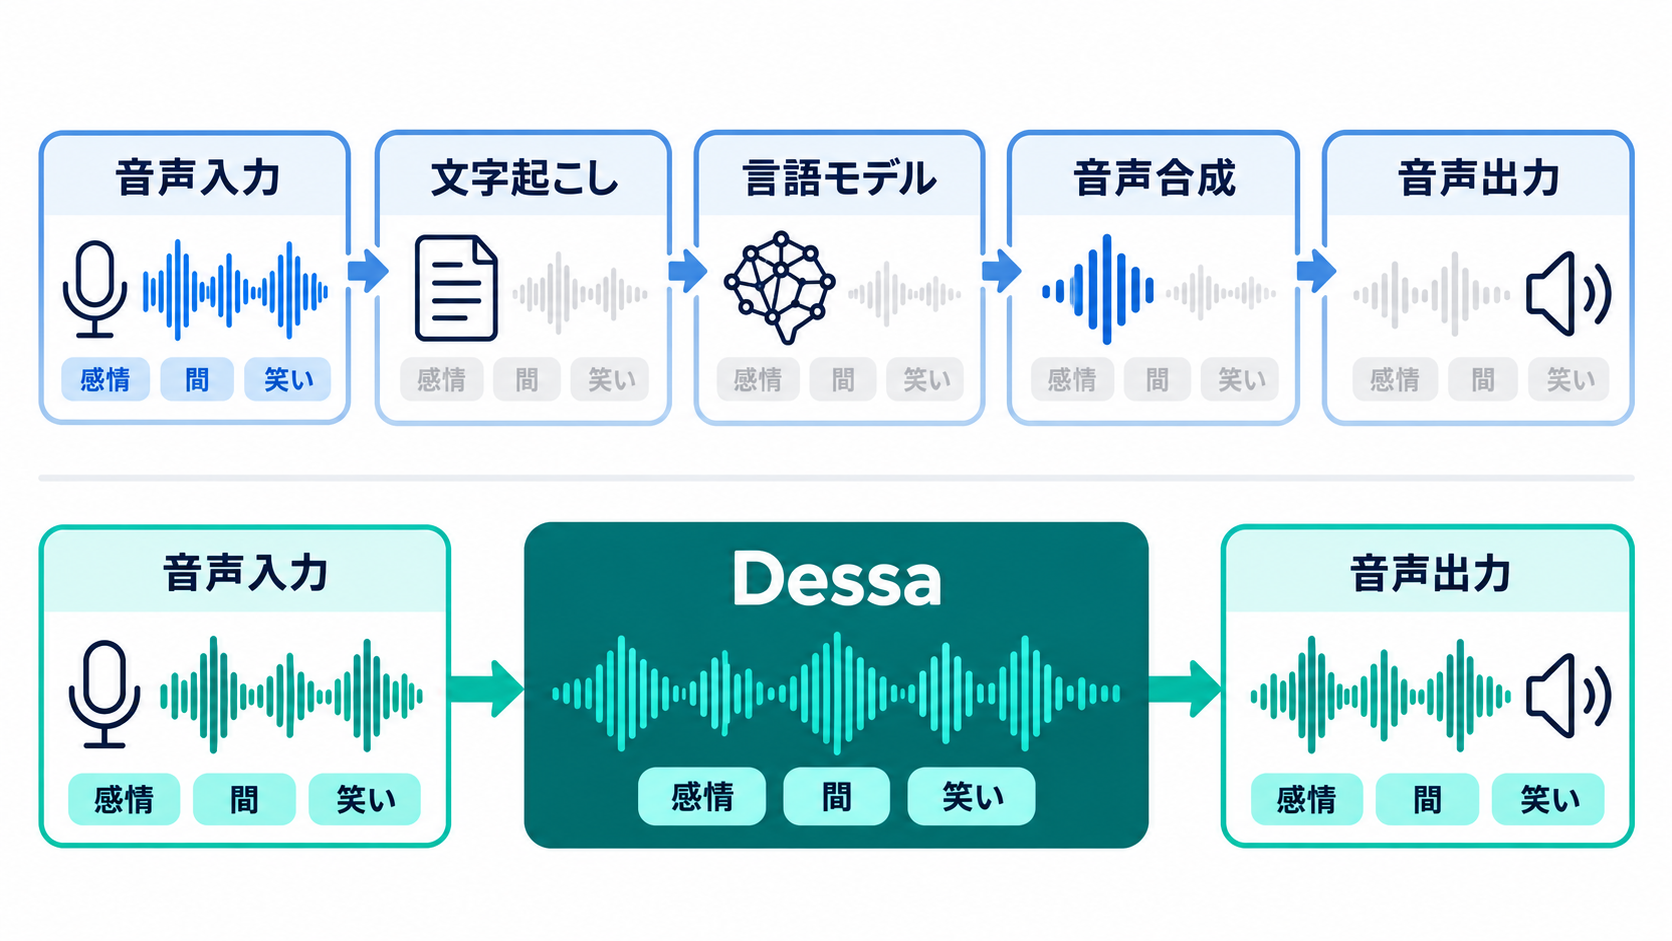
一般的な音声アシスタントは、利用者の発話を音声認識で文字にし、テキストを言語モデルへ渡し、生成された回答を音声合成で読み上げます。この構成は、成熟したテキスト処理技術を活用しやすく、会話内容の記録や検索、外部システムとの連携にも向いています。その半面、文字起こしの段階では、声の高さやテンポ、息遣い、笑い、言葉が重なった瞬間などを完全には表現できません。Dessaは中間のテキスト表現を前提とせず、音声入力から音声出力までを直接扱います。Blockの説明に沿えば、「何を言ったか」と「どのように言ったか」を別々の処理に切り分けず、一つの会話情報として学ぶ発想です。テキストに置き換えにくい皮肉や、返事をためらう沈黙も、処理対象から最初に除外されずに済みます。
ただし、音声から音声へ直接つなげれば、あらゆる用途で優位になるとは限りません。契約内容や商品仕様のように、一語の違いが結果を変える業務では、発話内容を文字で確認できることにも価値があります。社内文書を検索したり、注文システムへ正確な値を渡したりする場面では、構造化されたテキストが扱いやすいでしょう。
Dessaが示すのは、テキスト処理を全面的に置き換えるというより、音声を単なる文字の運搬手段として扱わない選択肢です。将来の業務システムでは、音声のニュアンスを保つ経路と、記録・検索・監査に適したテキスト経路を組み合わせる構成も考えられます。Blockは詳細な内部構造を明らかにしていないため、現段階では特定の実装方式まで推測せず、音声だけで学習したという主張と、公開後に検証できる性能を分けて評価する必要があります。
同時に聞いて話す「フルデュプレックス」が変える会話
Dessaはフルデュプレックス通信に対応し、話しながら相手の声を聞けるとされています。従来の音声UIでは、利用者が話し終えてからAIが応答し、AIの発話中は入力を受け付けない方式も珍しくありません。人間同士の電話とは異なり、交互にボタンを押して話す無線通信に近い体験になりやすい構造です。フルデュプレックスでは、利用者がAIの説明を途中で遮ったり、AIが話している最中に短い相づちを返したりできます。返答を始めるタイミングも会話の一部となるため、長い無音や不自然な割り込みを減らせる可能性があります。人が言葉を探している沈黙と、発話を終えたあとの沈黙を区別できれば、急かさずに待つという振る舞いも設計しやすくなるでしょう。
企業利用では、コールセンター、音声による受付、対話型トレーニングなどが検討対象になり得ます。ただし、自然に割り込めることと、業務上適切なタイミングで割り込めることは同義ではありません。苦情対応で説明を遮れば印象を悪化させかねず、本人確認の途中で相づちを誤認すれば処理の流れも崩れます。会話の滑らかさだけでなく、ターン管理の再現性を測る必要があります。
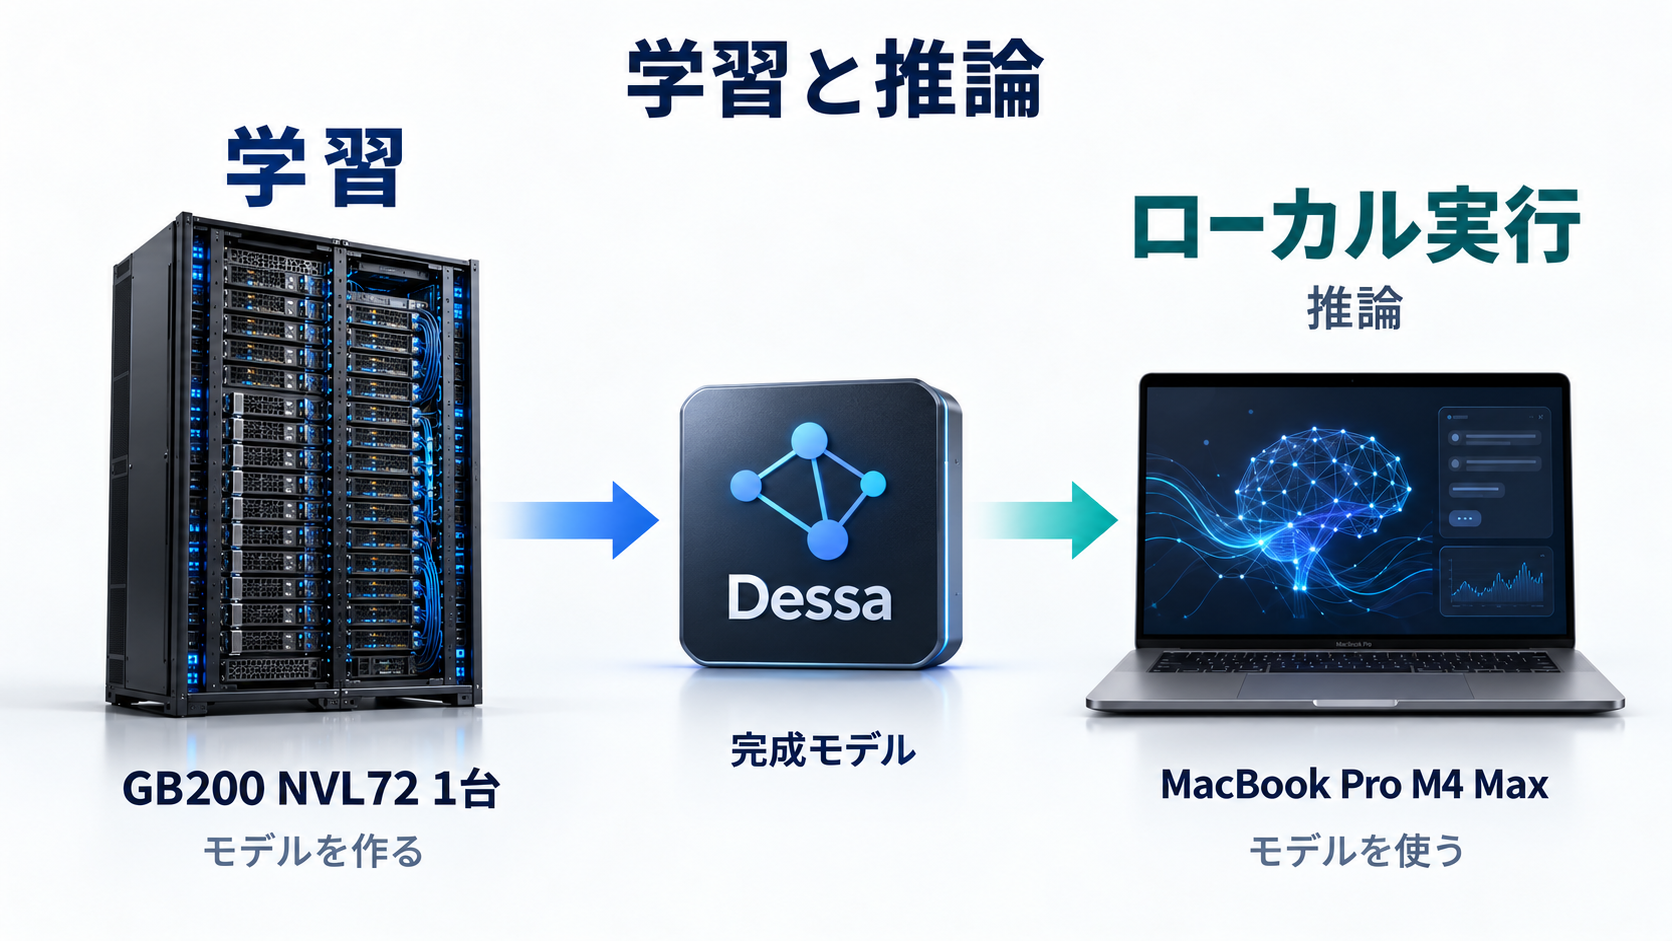
Blockは、DessaがM4 Max搭載のMacBook Pro上でローカル動作するとしています。クラウドとの常時通信を必須としない構成が実現すれば、応答遅延や音声データの取り扱いを検討するうえで興味深い材料になります。ただし、対応言語、実際の遅延、必要なメモリー、長時間運用時の安定性は現時点で詳しく示されていません。日本語の相づちや敬語を含む会話品質についても、公開後の確認が欠かせません。
感情豊かな声だけでは決まらない対話品質
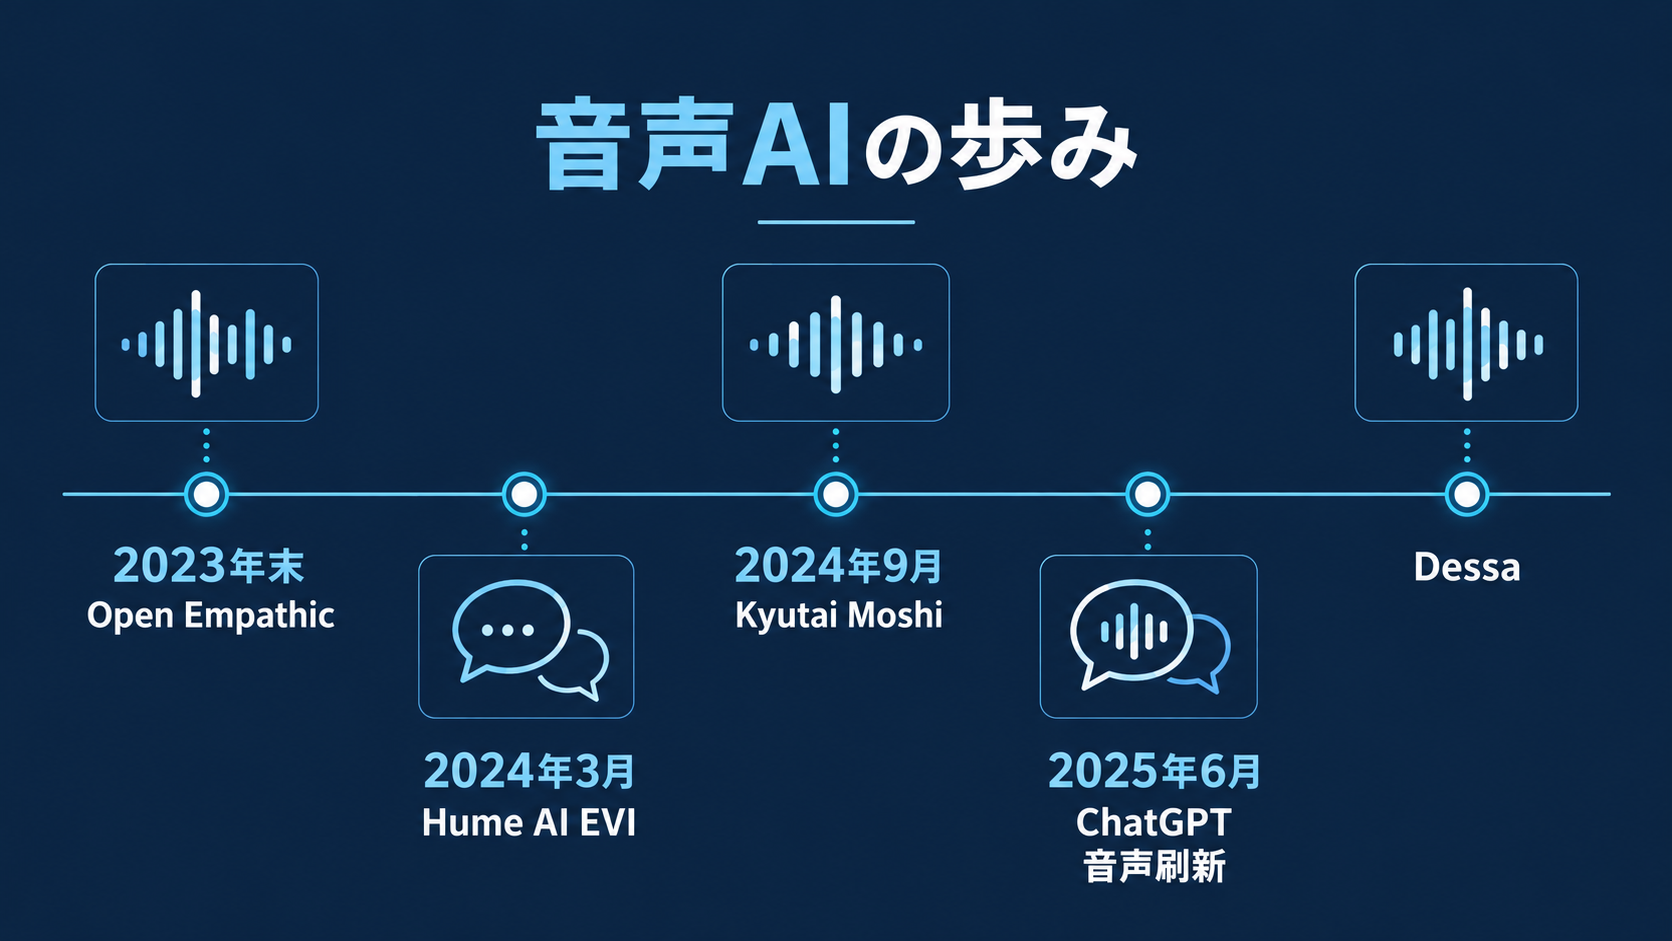
感情表現を扱う音声AIへの挑戦は、Dessaが初めてではありません。Hume AIは2024年3月、「感情知能」を掲げた音声AI「EVI(Empathic Voice Interface)」を発表しました。フランスのAI研究組織Kyutaiは同年9月にリアルタイム音声モデル「Moshi」を公開しています。大規模なオープンデータ開発で知られるLAIONも、2023年末からOpen Empathicプロジェクトを進めてきました。OpenAIは2025年6月にChatGPTのAdvanced Voice Modeを刷新し、その後もイントネーションや間、共感や皮肉の表現を改良しています。各社の方式や公開範囲は異なりますが、機械的な読み上げから、会話のリズムを備えた音声対話へ向かう流れは共通しています。
ここで区別したいのが、「感情的に聞こえること」と「状況を正しく判断できること」です。声に笑いやためらいを織り込めば親しみやすさは増しますが、質問を誤解したまま自然な口調で回答する可能性もあります。説得力のある話し方が、回答内容の妥当性を保証するわけではありません。
高度な音声AIでは、発話しながら推論を続け、利用者の割り込みを受けて回答方針を修正できるかが重要になります。業務で使うなら、自然さを評価するアンケートだけでは不十分でしょう。回答の正確性、指示への追従、矛盾への対処、分からない場合に回答を控える能力なども併せて確認しなければなりません。Dessaの価値も、印象的な声の表現ではなく、音声の手掛かりが実際の判断品質を改善するかどうかで評価されることになります。
1台での学習とMacでの動作をどう読むか
Blockによると、Dessaの学習にはNVIDIAの「GB200 NVL72」1台が使われました。これは72基のBlackwell GPUを統合した大規模なAI計算システムであり、「1台」という表現を一般的なパソコン1台と同じ感覚で受け取るべきではありません。それでも、複数の大規模クラスターではなく単一システムで学習したという説明は、音声モデル開発に必要な計算資源を考えるうえで注目されます。推論については、M4 Maxを搭載したMacBook Proでローカル実行できるとされています。学習に必要な設備と、完成したモデルを動かす設備は異なるため、両者を混同しないことが大切です。端末内で処理できれば、音声を外部サーバーへ送らない運用や、ネットワーク状況に左右されにくい対話を検討できます。ただし、実際の企業環境で必要となる同時接続数や管理機能まで示されたわけではありません。
Dessaはまだ一般公開されておらず、企業がAPIやモデルを入手して導入できる段階ではありません。Blockは先にAIセキュリティ研究者を募り、想定外のリスクを検証する方針です。関心のある研究者は専用フォームから申し込めますが、一般提供の日程や利用条件は明らかにされていません。
公開された範囲では、モデル規模、学習データ量、対応言語、標準ベンチマークの結果なども確認できません。そのため、現時点の情報から運用コストや他モデルに対する優位性を算定するのは困難です。企業の技術担当者にとっては、すぐに採用する製品というより、音声のみの学習と端末内推論がどこまで成立するかを見極める研究事例として捉えるのが妥当でしょう。
感情を拾うAIに必要な安全設計
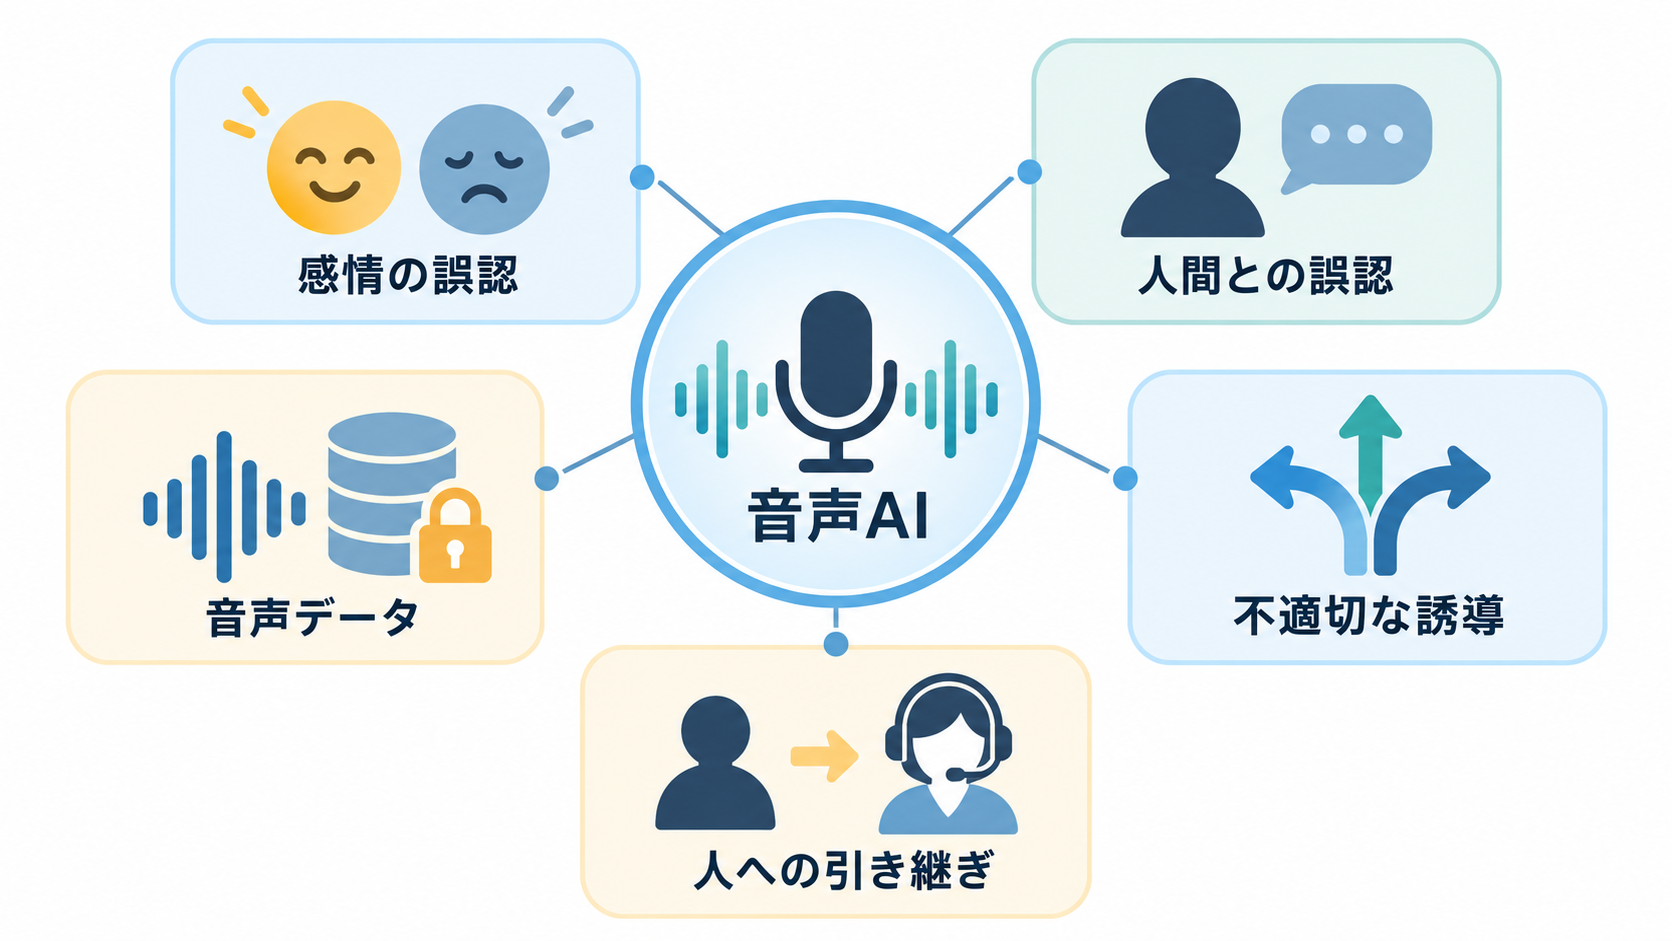
声の震えや沈黙を扱えるAIは、利用者の困惑や緊張に合わせて応答を調整できるかもしれません。同時に、感情を誤って推定する危険も生じます。声が小さいという理由だけで「落ち込んでいる」と決めつけたり、文化や話し方の違いを感情の違いとして処理したりすれば、不適切な対応につながりかねません。自然な笑い声や相づちを生成する機能にも両面があります。会話の負担を減らす一方で、利用者がAIを人間だと誤認したり、実際以上に理解されていると感じたりする可能性があるからです。金融、医療、採用、相談窓口など判断の影響が大きい場面では、音声の自然さが信頼を過度に押し上げないよう、AIであることの明示や、人間へ引き継ぐ条件を設計する必要があります。
Dessaが処理する音声には、話した内容に加えて、話者の特徴や周囲の音も含まれ得ます。企業が将来導入を検討する場合は、録音の同意、保存期間、アクセス権限、学習への再利用、削除手続きといったデータ管理を確認しなければなりません。ローカルで動作するという説明だけで、安全性やプライバシーが自動的に保証されるわけでもありません。
Blockが一般公開より先にAIセキュリティ研究者による検証を求めているのは、こうした未知のリスクを探る段階にあるためです。評価では、禁止された内容への応答だけでなく、声による誘導への耐性、話者の取り違え、感情推定の偏り、会話が重なった際の誤動作なども論点になるでしょう。音声モデルの安全性は、テキスト回答の内容と、声が生む心理的な影響の両方から捉える必要があります。
日本企業は「自然さ」より業務成果から試す
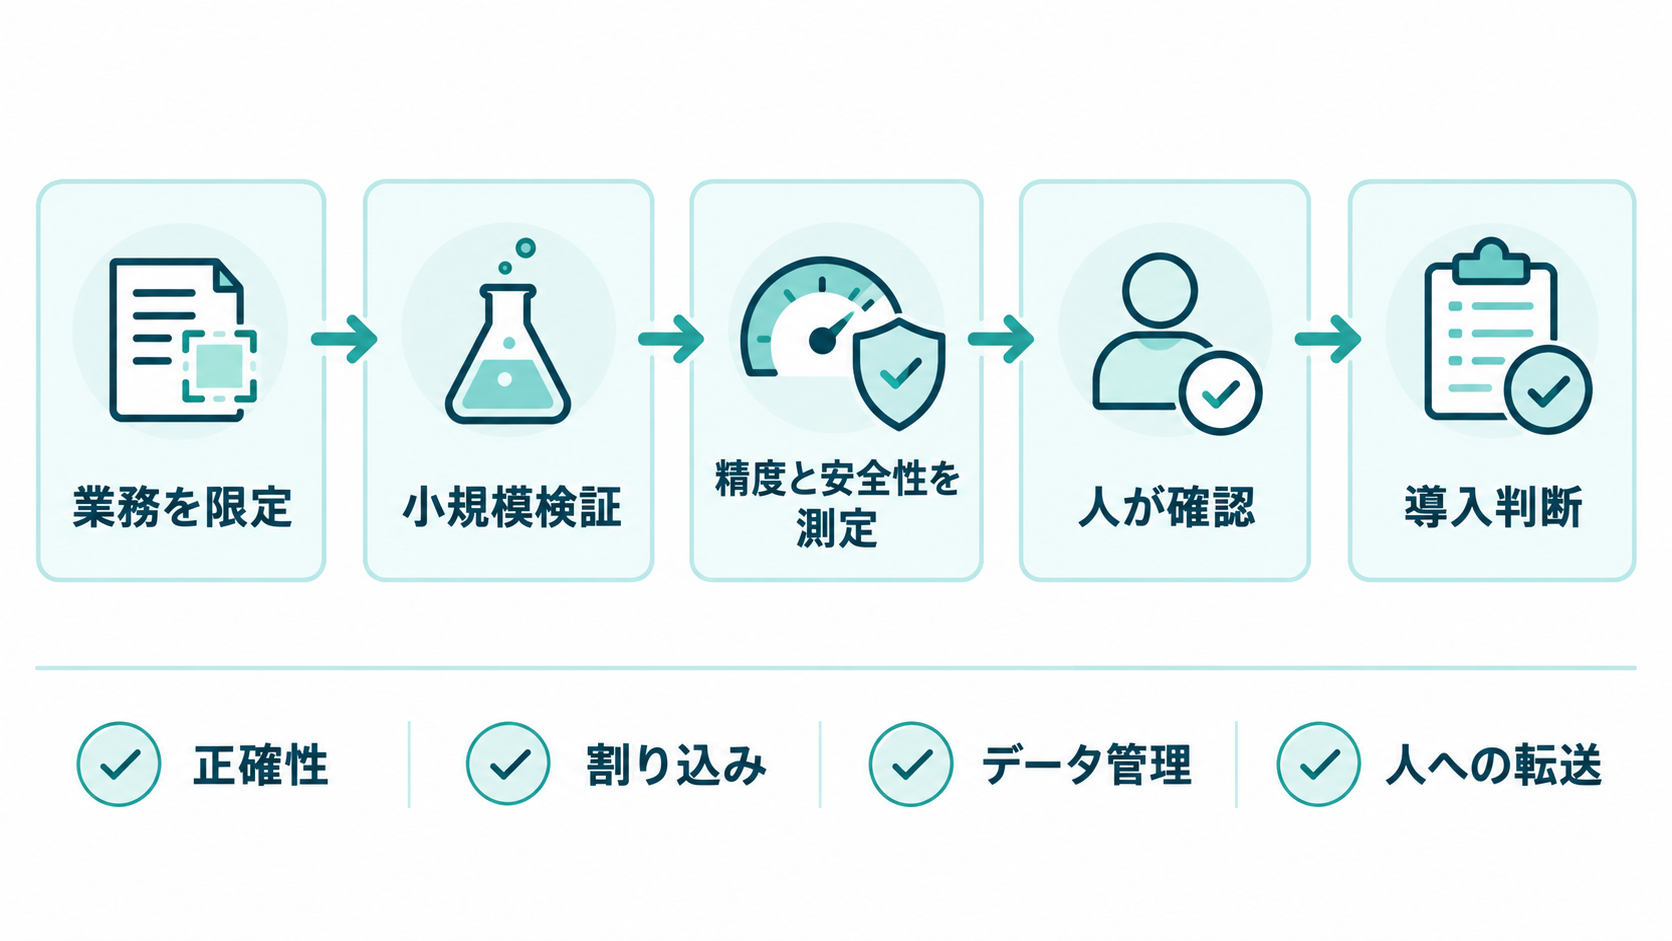
日本企業が音声AIを検討する際、Dessaのデモがどれほど人間らしく聞こえるかだけで採否を判断するのは早計です。日本語の会話では、「はい」「なるほど」といった相づち、敬語の段階、主語を省いた表現、意図を断定しない言い回しが頻繁に使われます。沈黙も、発話の終了だけでなく、考えている時間や遠慮を示す場合があります。音声を直接扱う方式が、こうした特徴をどこまで捉えられるかは個別に検証しなければなりません。試験導入では、感情表現が役立ちそうな広い領域を一度に自動化するより、目的と失敗条件を限定したほうが評価しやすくなります。例えば、社内研修の会話練習、予約受付の聞き返し、有人窓口へ転送する前の用件整理など、誤りを人が確認できる範囲から始める方法が考えられます。これはDessaの採用を直接勧めるものではなく、将来利用可能になった場合を含む音声AI全般の検証手順です。
確認項目は、次の四つに絞ると判断しやすくなります。
- 発話内容の正確性だけでなく、沈黙や割り込みを適切に扱えるか
- 感情の推定を確定事項として扱わず、誤認時に修正できるか
- 会話ログ、音声データ、本人同意を既存の規程に沿って管理できるか
- 自動応答を続ける条件と、人間へ引き継ぐ条件を明確にできるか
評価指標には、利用者が感じた自然さだけでなく、用件の完了率、誤回答、人への転送率、割り込みからの復帰、処理時間などを含めるべきでしょう。Dessaはまだ外部から自由に検証できないため、Blockによる公開情報と第三者による検証結果を待つ姿勢も必要です。企業が今からできる具体的な一歩は、自社の音声業務で文字化の際に失われている情報を洗い出し、その情報が本当に業務結果を変えるのかを確認することです。