
AI LAB
2026/10/25
1,024のAIエージェントは司令塔なしで動けるか――Microsoft Research「Agensh」が示す分散協調の設計
司令塔を外した1,024エージェントの実験
大規模なソフトウェアを短時間で改修したいとき、AIエージェントの数を増やせば、そのまま開発速度も上がるのでしょうか。Microsoft Researchがオープンソース化したAgenshは、この問いを最大1,024体のコーディングエージェントで検証したマルチエージェント基盤です。特徴は、全体の計画や作業配分、成果物の統合を一手に引き受ける中央オーケストレーターを置かない点にあります。一般的なオーケストレーター型の仕組みでは、リーダー役のエージェントが問題を分解し、各担当へ指示を送り、最後に変更をまとめます。チームが小さければ理解しやすい構成ですが、参加するエージェントが増えるほど、リーダーが処理すべき進捗報告や依存関係、競合も増加します。Agenshが狙うのは、この「司令塔そのものが拡張の上限になる」という問題の回避です。
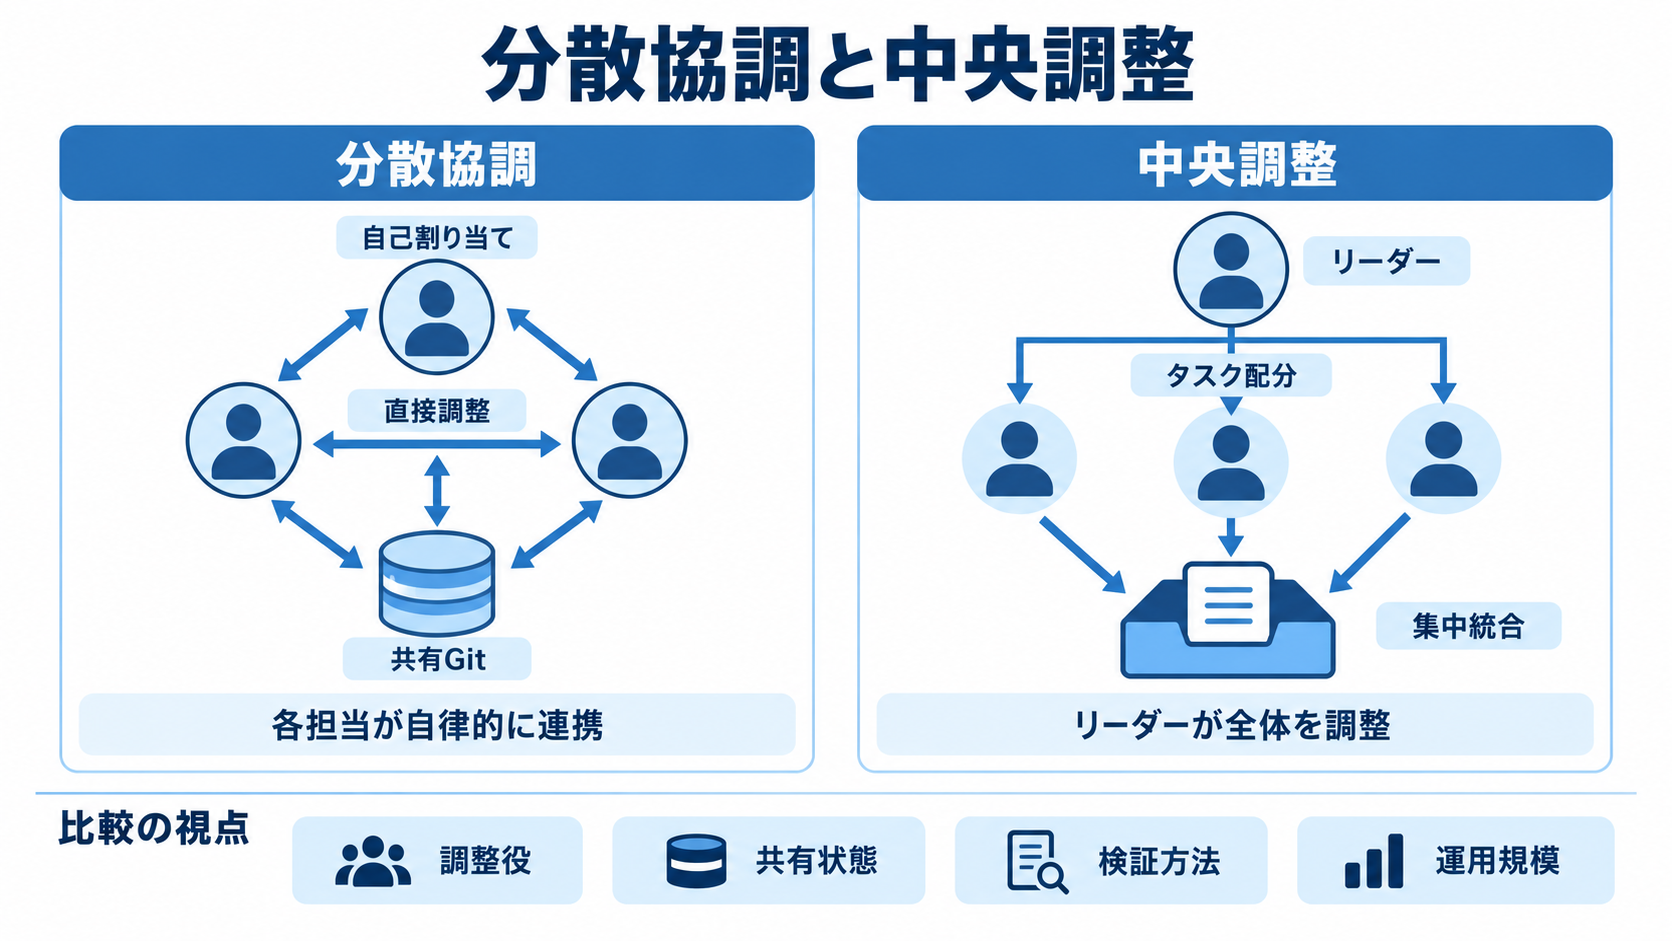
Agenshでは、各ワーカーが周囲の状況を読み、自分でサブタスクを確保し、成果や失敗を仲間と共有します。コードは共通のGitリポジトリへ統合されるため、協調の単位は会話だけではありません。ブランチ、プルリクエスト、テスト結果、マージ競合といった、実際のソフトウェア開発で使われる状態を介して作業が進みます。
ここで注目すべきなのは、単に「AIを大量に並べた」ことではないでしょう。エージェント同士が重複を調整し、レビュー担当や統合担当に近い役割まで自発的に形成した点が、Agenshの中心的な論点です。企業にとっては、万能な管理役を強化し続ける発想だけでなく、現場の参加者が局所的な情報を使って調整できる仕組みを設計する、という別の選択肢が見えてきます。
5段階の協調ループと三つの共有基盤
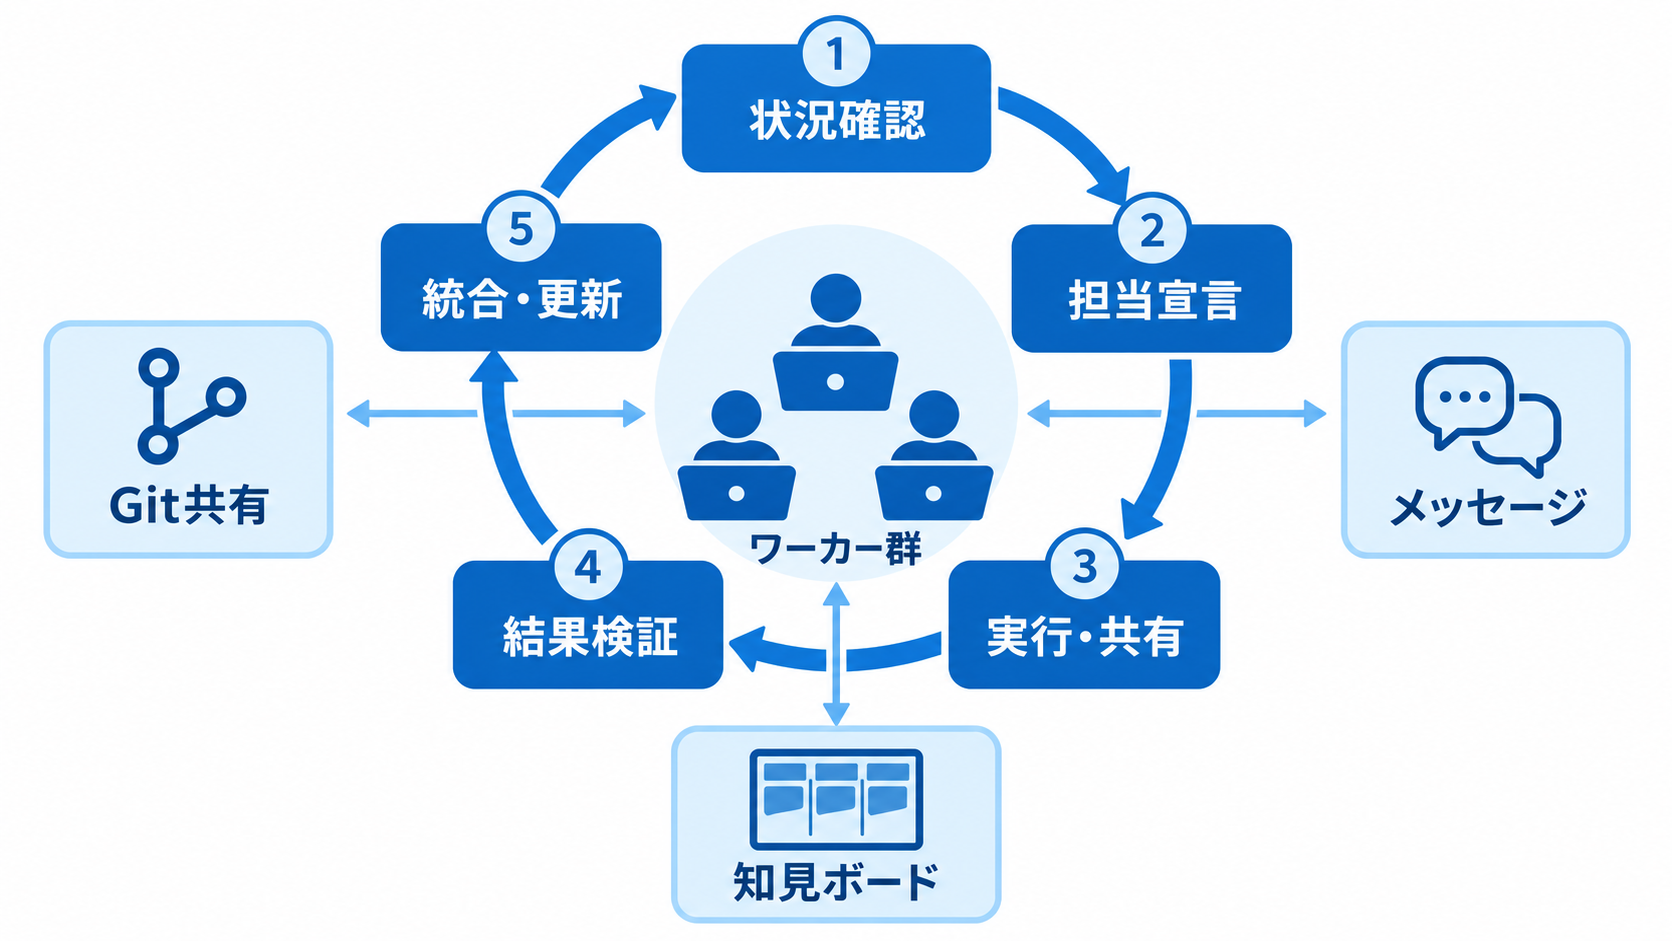
Agenshの各ワーカーは、同じ5段階のループを非同期かつ並行して繰り返します。最初に目標、ほかのワーカーの進捗、メッセージ、共有済みの知見を確認します。そのうえで担当したいサブタスクをCLAIMとして宣言し、作業範囲が重なった場合は当事者間のダイレクトメッセージで調整します。中央の管理役から割り当てを待つのではなく、公開された状態を読んで仕事を選ぶ構造です。担当が定まると、ワーカーはローカル環境でツールを使って実装や調査を進めます。途中で得た有用な情報は、完成を待たずに共有されます。作業後にはサブタスクの受け入れ条件に照らして結果を検証し、共通リポジトリへマージして進捗を投稿します。その後、状況を読み直して新しい仕事を探すため、計画と実行の境界は固定されていません。
この循環を支えるのが、Gitea、Mattermost、共有コンテキストボードの三つです。GiteaはGitリポジトリやブランチ、プルリクエスト、マージ競合を扱います。Mattermostはチーム全体のチャンネルと、緊急の衝突を解決するダイレクトメッセージに使われます。DeLMを基にした共有ボードには、OBSERVED、FACT、FAIL、CLAIM、PATCH_SUMMARYという型付きのメモが蓄積されます。観測、確認済み事実、失敗、担当宣言、変更要約を区別することで、単なる会話ログよりも再利用しやすい状態を作っています。
興味深いのは、このループが専用の実行制御コードではなく、各ワーカーに渡すプロンプトに記述されている点です。ワーカーごとの差はIDだけで、全員が同じ協調規則を受け取ります。Agensh自体は単一エージェント用ハーネスの上に構築され、実験にはGitHub Copilot CLIが使われました。Microsoft Researchは、薄いアダプターを用意すればClaude Codeなど別のハーネスにも接続できると説明しています。協調の規則と個別エージェントの実行環境を分ける設計により、特定モデルへの依存を抑えています。
ベンチマークが示した改善幅と残る限界
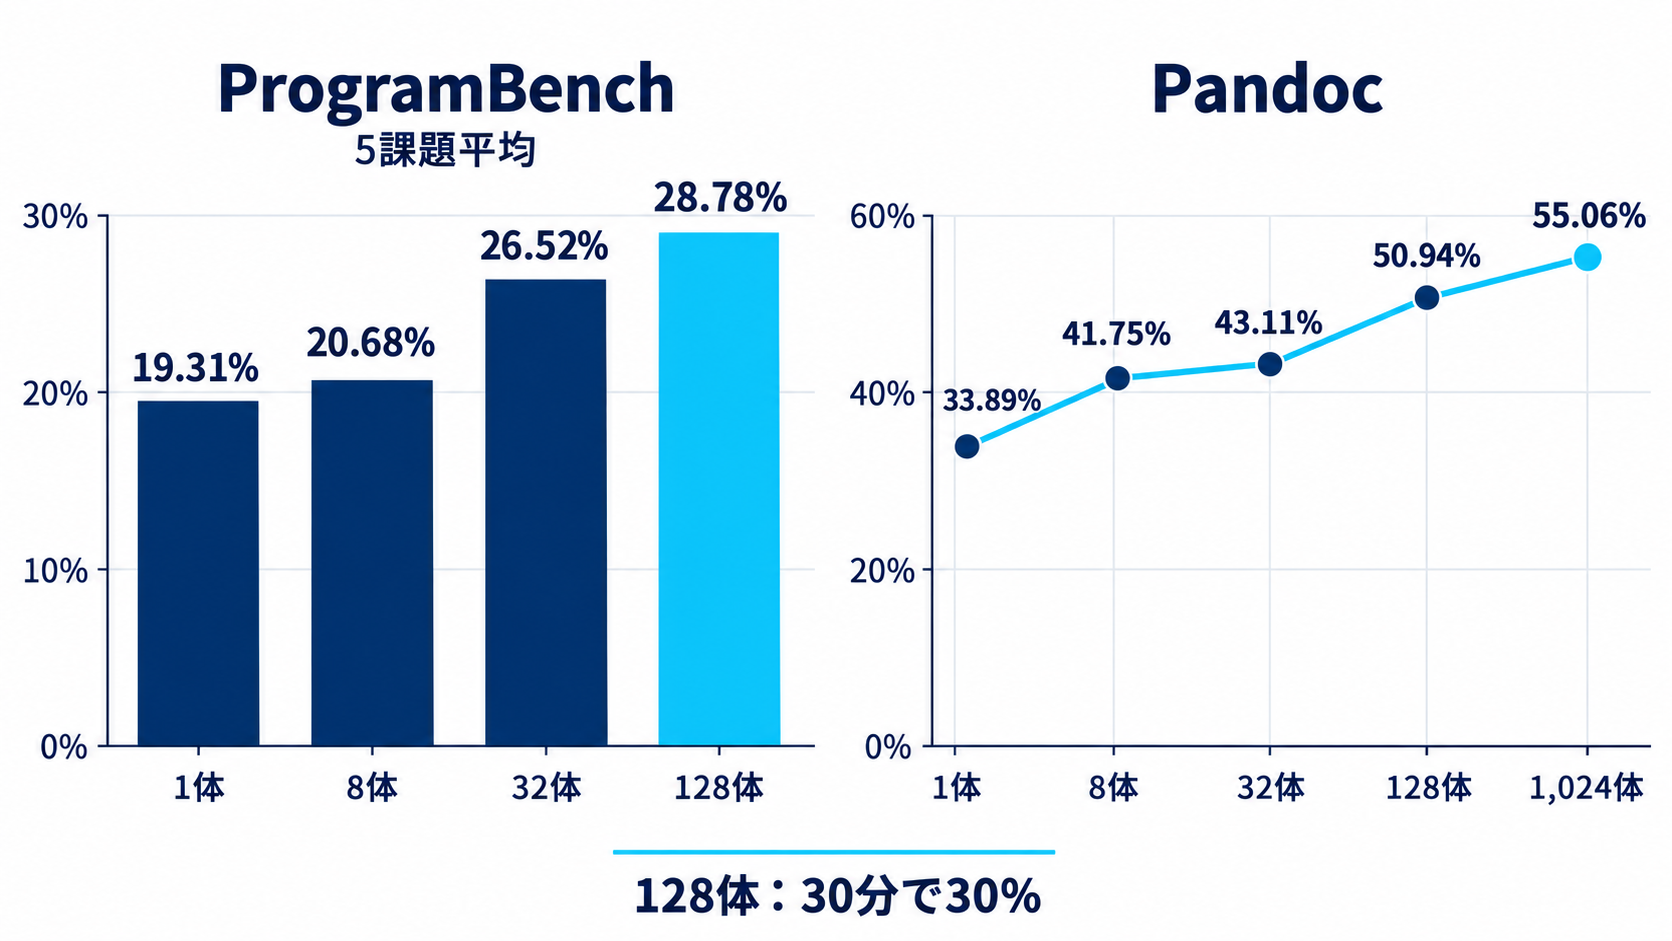
評価にはProgramBenchのうち難度が高い5課題が使われました。対象はFFmpeg、GROMACS、Pandoc、PHP-src、ctagsで、エージェントは完成済みプログラムの観測可能な動作を手掛かりに、その機能をオフライン環境で再構築します。参照対象の規模はPandocの2,767ファイルからPHP-srcの26,266ファイルまで広がり、各実験の作業時間は6時間に制限されています。GPT-5.6-solを高い推論強度で利用した場合、5課題の平均テスト通過率は1エージェントの19.31%から、8エージェントで20.68%、32エージェントで26.52%、128エージェントで28.78%へ上昇しました。1体から128体への増加幅は9.47ポイントで、相対値では約49%です。ただし、1体から8体へ増やした段階の改善は1.37ポイントにとどまります。エージェント数と品質が単純な比例関係にないことは、この数字からも読み取れます。
Pandoc単体では、GPT-5.6-solの通過率が1体の33.89%、8体の41.75%、32体の43.11%、128体の50.94%、1,024体の55.06%となりました。到達速度にも差があり、128体構成は開始30分の時点で30%を通過しています。同じ水準へ達するまでに32体では60分、8体では90分を要しました。多数のワーカーは最終スコアだけでなく、利用可能な結果を得るまでの時間も短縮したことになります。
公開READMEに追加されたGPT-6.1-solの結果では、Pandocの通過率が1体の56.19%から32体の79.59%へ伸び、相対改善率は41.64%でした。この数値は初版の研究論文には含まれていません。また、モデルとエージェント数が同時に異なる結果を横並びにして、増分をすべて協調方式の効果とみなすことはできません。最良値だけでなく、同じモデル、同じ課題、同じ時間条件での増減を見る必要があります。5課題平均の最高値が28.78%だった事実も踏まえると、Agenshは完成品を自動生成する装置というより、困難な課題に対する探索範囲と到達速度を広げる実験基盤として捉えるのが妥当でしょう。
規模の拡大で生まれた自発的な役割分担
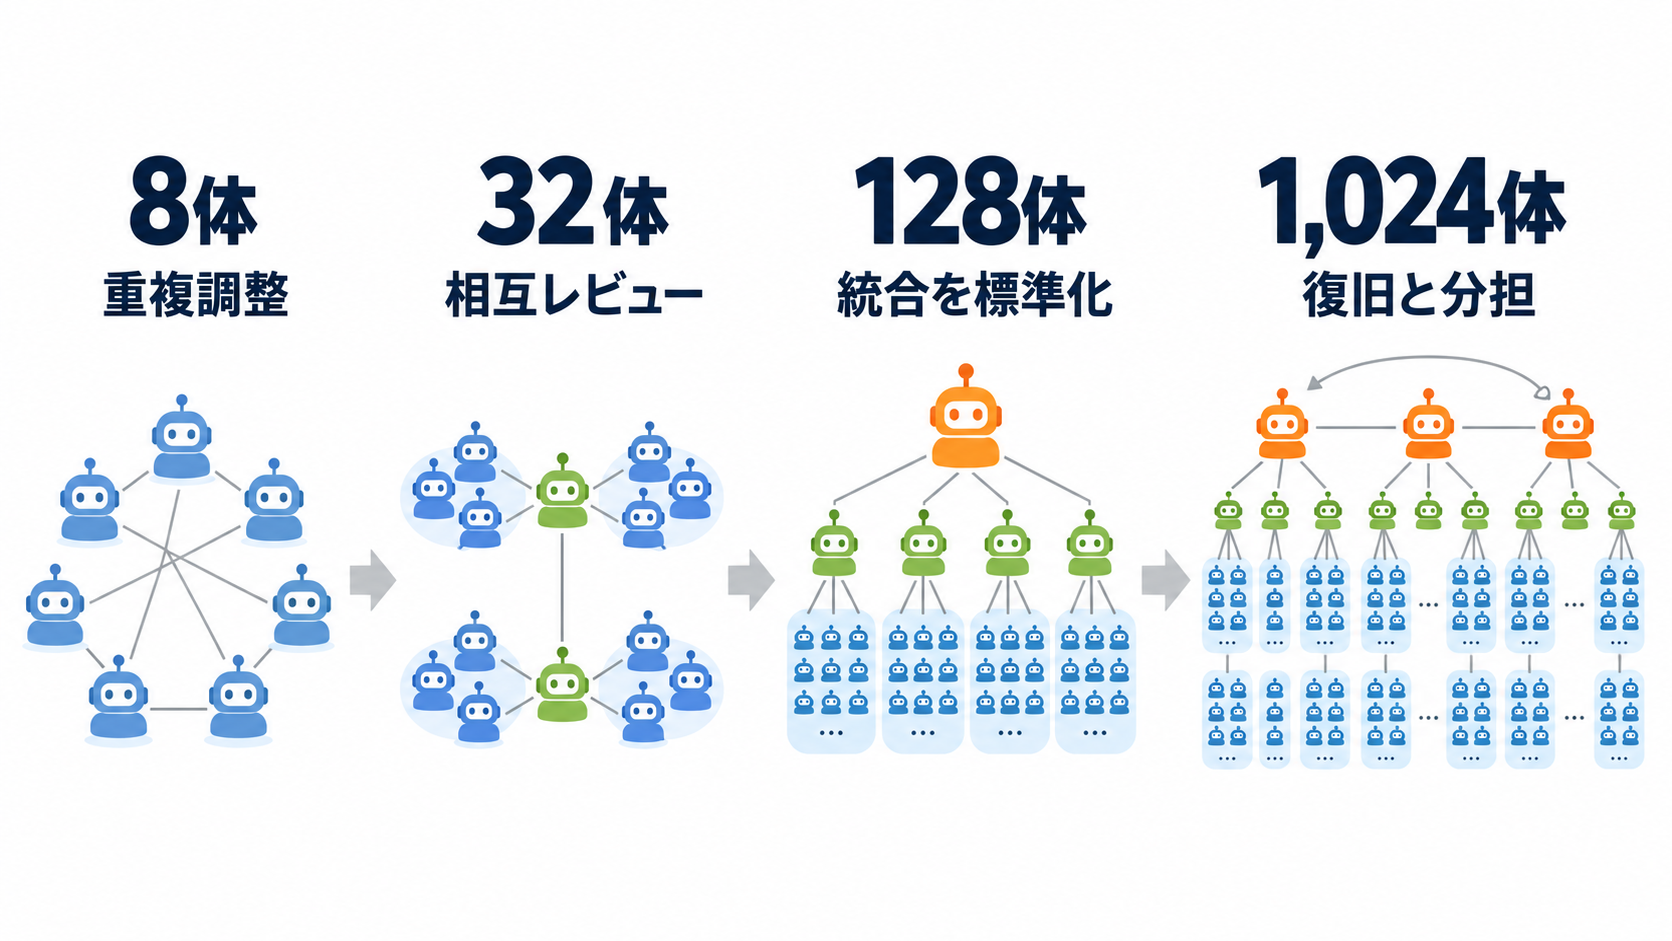
Microsoft Researchは、規模ごとのワーカーの軌跡を調べ、チーム内の振る舞いがどのように変化したかを報告しています。8体の構成では、ワーカー同士がインターフェースについて合意し、重複したCLAIMを自分たちで解消しました。32体になると共有された作業への相互レビューが見られ、いったん出された承認が反例の提示を受けて撤回される場面も確認されています。128体では、信頼されたレビュアーが繰り返し利用され、統合作業の手順も標準化されました。1,024体の実験では、複数のワーカーがインテグレーターとして振る舞い、ほかのワーカーが失敗した作業を仲間が引き継ぐ動きも現れています。レビュー担当、統合担当、復旧担当といった役割は、システム側で固定的に割り当てられたものではありません。共有された作業履歴と局所的なやり取りから、必要な役割が形成されています。
これは、分散型の設計が無秩序と同義ではないことを示す事例です。明確な作業宣言、検証条件、共有リポジトリ、型付きの知見が存在するため、ワーカーは誰が何を進めているかを判断できます。自律性を成立させているのは自由度の高さだけではなく、観測可能な状態と共通の手続きです。人間の組織でいえば、管理者を取り除くだけでは機能せず、課題管理、成果物の形式、レビュー基準を全員が利用できる状態に近いでしょう。
企業利用を考えると、自発的な役割形成には注意も必要です。特定のワーカーが事実上の統合役になったとしても、その判断が常に適切だとは限りません。信頼がどの結果に基づいて形成されたのか、承認を覆せる証拠が残っているか、失敗した変更を安全に戻せるかを確認する必要があります。Agenshの観察結果は役割が自然に生まれることを示していますが、その役割へ責任や権限をどう結び付けるかは、導入組織側の設計課題として残ります。
既存のマルチエージェント方式との設計差
マルチエージェント製品を比較するとき、最大エージェント数だけでは実態を捉えにくくなります。Agenshの違いは、タスク分解と統合の責任をどこに置くかにあります。Anthropicのコーディング支援ツールであるClaude Codeのエージェントチームでは、固定されたリードセッションがチームメイトを調整します。Kimi Agent Swarmはオーケストレーターがタスクを分解し、Copilot CLIのfleet機能でもCopilotが作業をサブエージェントへ割り振ります。Agenshは、各ワーカーが公開状態を読んで担当を宣言する点で異なります。公開情報で示された規模にも差があります。Agenshは1,024体まで実験され、Kimi Agent Swarmは最大100のサブエージェントを掲げています。Claude Codeには明示的な上限がないものの、推奨規模は3~5体です。Copilot CLIのfleet機能については、比較可能な最大数が明らかにされていません。ただし、数字が大きいほど企業システムとして優れているとは限らないでしょう。少数で密に連携する方式と、多数が探索範囲を分担する方式では、向いている課題が異なります。
共有状態の作り方も選定材料になります。AgenshはGiteaのリポジトリ、Mattermostのメッセージ、共有コンテキストボードを組み合わせます。Claude Codeのチーム機能では、共有タスクリスト、ファイルロック、チームメイト間のメールボックス型メッセージが使われます。Kimi Agent SwarmとCopilot fleetについては、同じ粒度の内部構成が公開情報からは確認できません。導入担当者はエージェント数だけでなく、競合の検出方法、途中知識の保存先、レビューの可視性を比べる必要があります。
提供形態にも違いがあり、AgenshはMITライセンスのオープンソースです。Claude Codeのチーム機能は実験的な位置付けで既定では無効、Kimi Agent Swarmは上位契約者向けの研究プレビュー、fleetはCopilot CLI内の機能として示されています。自社の監査要件に合わせて構成を確認・変更したい企業にはオープンソースが扱いやすい場面がありますが、運用や障害対応まで自動的に提供されるわけではありません。比較軸は「何体動くか」から「誰が調整し、何を共有し、どこまで検証できるか」へ移すべきです。
導入前に見積もる計算資源と運用負荷
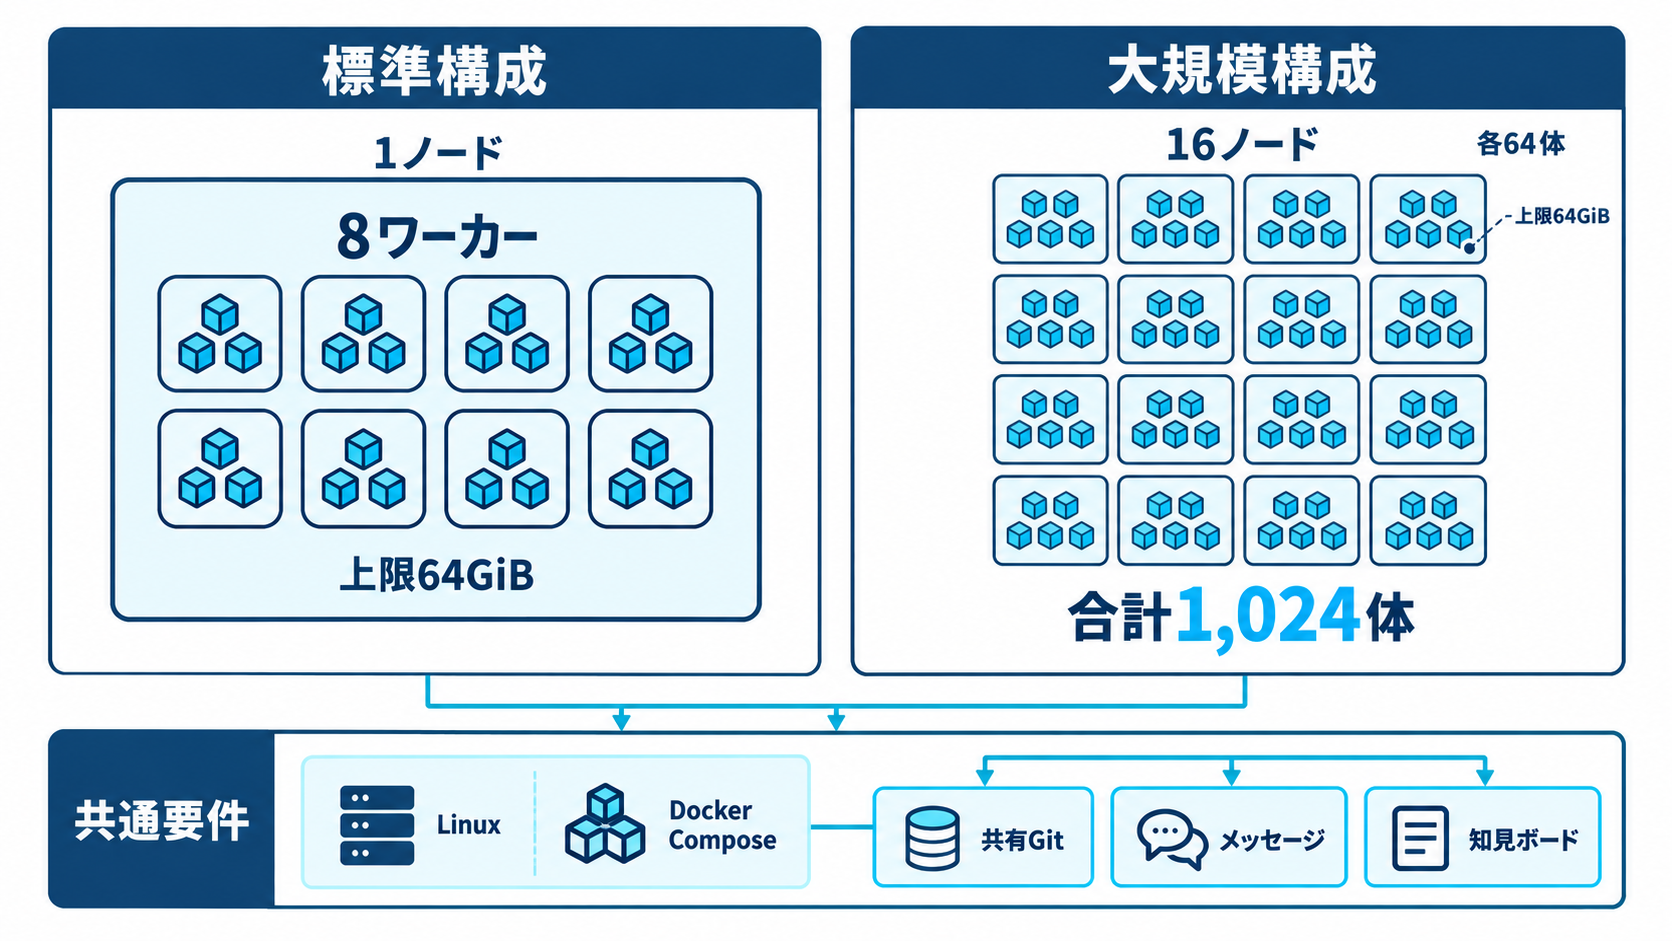
Agenshの公開構成はLinux上で動作し、Docker Engine、Docker Compose v2、systemd、cgroup v2、Python 3.11以降を必要とします。標準の単一ノード構成は8ワーカーで、1タスク当たりの制限時間は6時間、使用モデルは高い推論強度のGPT-5.6-solです。ProgramBenchとモデルAPI用トークンも用意する必要があり、ProgramBenchはバージョン1.2.5で検証されています。1,024体の実験では16ノードを使い、1ノード当たり64体を稼働させました。各ワーカーには64GiBのメモリ上限が設定されています。また、ワーカーごとの上限は入力272,000トークン、出力128,000トークンです。これらは利用可能な上限であり、すべてのワーカーが毎回その量を消費したことを意味しません。それでも、エージェント数を増やす判断には、モデル利用料だけでなく、コンテナ実行基盤、共有サービス、ログ保存、失敗時の再実行を含めた資源計画が欠かせません。
Microsoft Researchが公開した情報では、トークンコストは明らかにされていません。したがって、スコアが何ポイント上がったかだけを見ても、企業としての費用対効果は判断できない状態です。経過時間が短縮されても、同時に動かすワーカーが増えれば総消費量は増える可能性があります。評価時には最終テスト通過率、目標水準への到達時間、API消費量、計算資源、マージ競合数、人間による修正時間を同じ実験で記録する必要があるでしょう。
中央オーケストレーターがないことも、管理基盤が不要という意味ではありません。Gitea、Mattermost、共有ボードは全ワーカーが依存する共通サービスであり、アクセス制御や可用性、保存期間を決める必要があります。社内コードを扱う場合には、シークレットをワーカーへどう渡すか、生成した変更をどの権限でマージできるか、外部モデルへ送信できる情報をどこまで許可するかも確認対象です。分散協調の利点を得るには、エージェントの自律性とインフラ側の統制を別々に設計する必要があります。
日本企業が小規模検証から始めるための判断軸
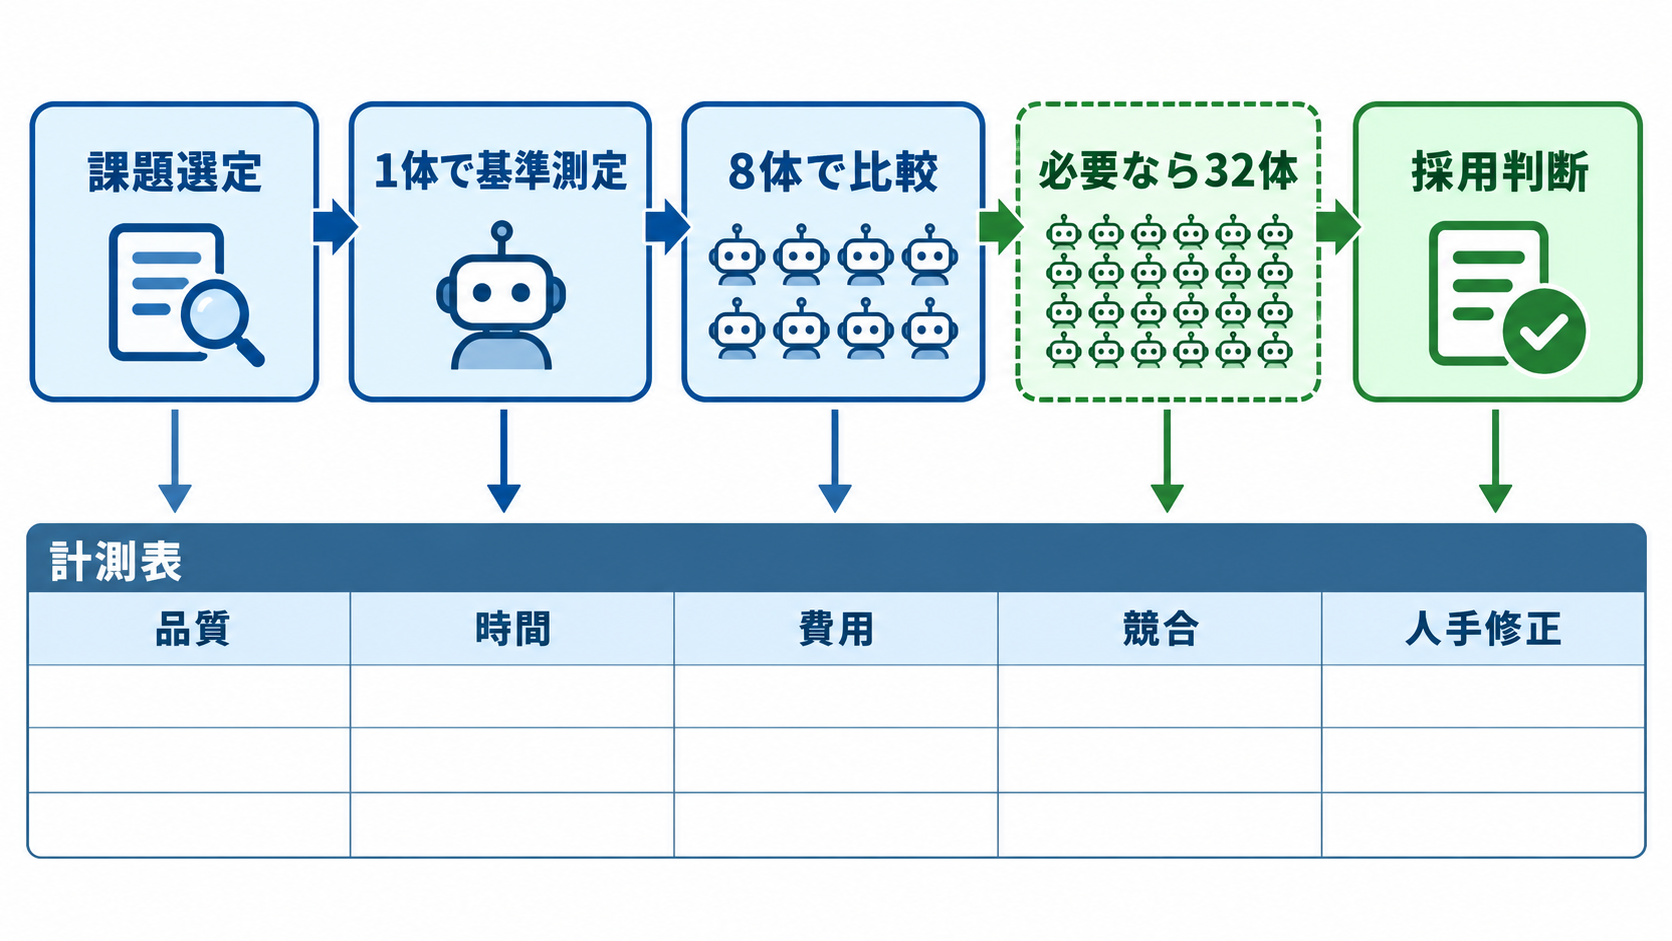
Agenshを試す際、1,024体構成の再現から始める必要はありません。公開設定の標準が8ワーカーであることや、5課題平均では1体から8体への改善が1.37ポイントだったことを考えると、自社課題で規模ごとの費用対効果を測る工程が先になります。テストが整備され、作業を複数の独立領域へ分けやすいリポジトリを一つ選ぶと、協調方式の効果を観察しやすくなるでしょう。検証では、単一エージェントを基準に置き、同じ課題を8体、必要であれば32体で実行します。品質は最終的なテスト通過率だけでなく、最初の有効な成果が得られるまでの時間、重複CLAIMの発生数、マージ競合、再作業、レビューで撤回された変更まで記録します。Agenshの価値は、複数の探索を並行させることと、途中で得た知見をほかのワーカーが再利用できることにあります。一本道の作業や受け入れ条件が曖昧な業務では、ワーカーを増やしても調整負荷が上回るかもしれません。
社内向けの受け入れ条件も、実験開始前に固定しておく必要があります。自動テスト、静的解析、ライセンス確認、セキュリティ検査のうち、どれをマージ条件にするかを定めます。ワーカーが自律的に統合してよいブランチと、人間の承認を必須にする領域も分けたほうが安全です。共有ボードのFACTやPATCH_SUMMARYを監査証跡として利用できるか、Mattermost上の調整をどの期間保存するかも検証項目になります。
採用判断では、最大規模の記録よりも、自社のボトルネックが中央調整にあるかを見極めることが大切です。設計判断が一人の熟練者へ集中しているなら、単にエージェント数を増やす前に、インターフェースやテスト条件を明文化する必要があります。反対に、多数の独立した探索や互換性確認を同時に進めたい場合には、Agenshの自己割り当て方式が検討対象になります。最初の具体的な一歩は、候補リポジトリで1体と8体の比較実験を行い、品質、時間、費用、競合、人手修正の五つを同じ表に記録することです。