AI LAB
2026/09/28
Nvidia、最大8人の発話を区別する音声AIを公開──会議録の実用性を左右する精度と待ち時間
会議録に必要なのは、発言内容と「誰の発言か」の対応
会議の文字起こしを読み返しても、提案した人と承認した人が分からなければ、業務の記録としては使いにくいものです。発言が入り交じる商談や打ち合わせでは、言葉を正しく文字にする処理に加え、発言者が切り替わった位置を捉える処理も必要になります。Nvidiaが公開した「Nemotron 3 Diarization」は、この発話者の区別を担う音声AIモデルです。モデルの規模は約1億パラメータで、学習済みの重みが無料で公開されています。パラメータとは、学習によって調整されるモデル内部の値です。最大8人の話者を区別し、複数人が同時に話す場面も検出できます。録音済みの音声とライブ音声の両方に対応するため、会議後の記録作成にも、進行中の会話を扱う仕組みにも組み込める構成です。
ただし、ここでいう話者の識別は、声から社員の氏名を特定する機能ではありません。付与されるのは「speaker_2」のような匿名のラベルです。「どの発言が同じ話者に属するか」を整理する機能と、「その話者が誰なのか」を実名で確認する機能は、分けて理解する必要があります。
生成AIを使った議事録や会話要約を業務で利用する際も、この違いは見過ごせません。文章が読みやすくまとまっていても、発言者との対応が誤っていれば、担当者や意思決定の経緯を取り違えるおそれがあります。今回の公開で企業が注目すべき点は、モデルの規模だけではなく、会話の帰属関係をどこまで正確に捉えられるかです。要約の前段にある音声処理の品質が、完成した記録の使いやすさを左右します。
エラー率14.72%を、自社の会議の正解率に読み替えない
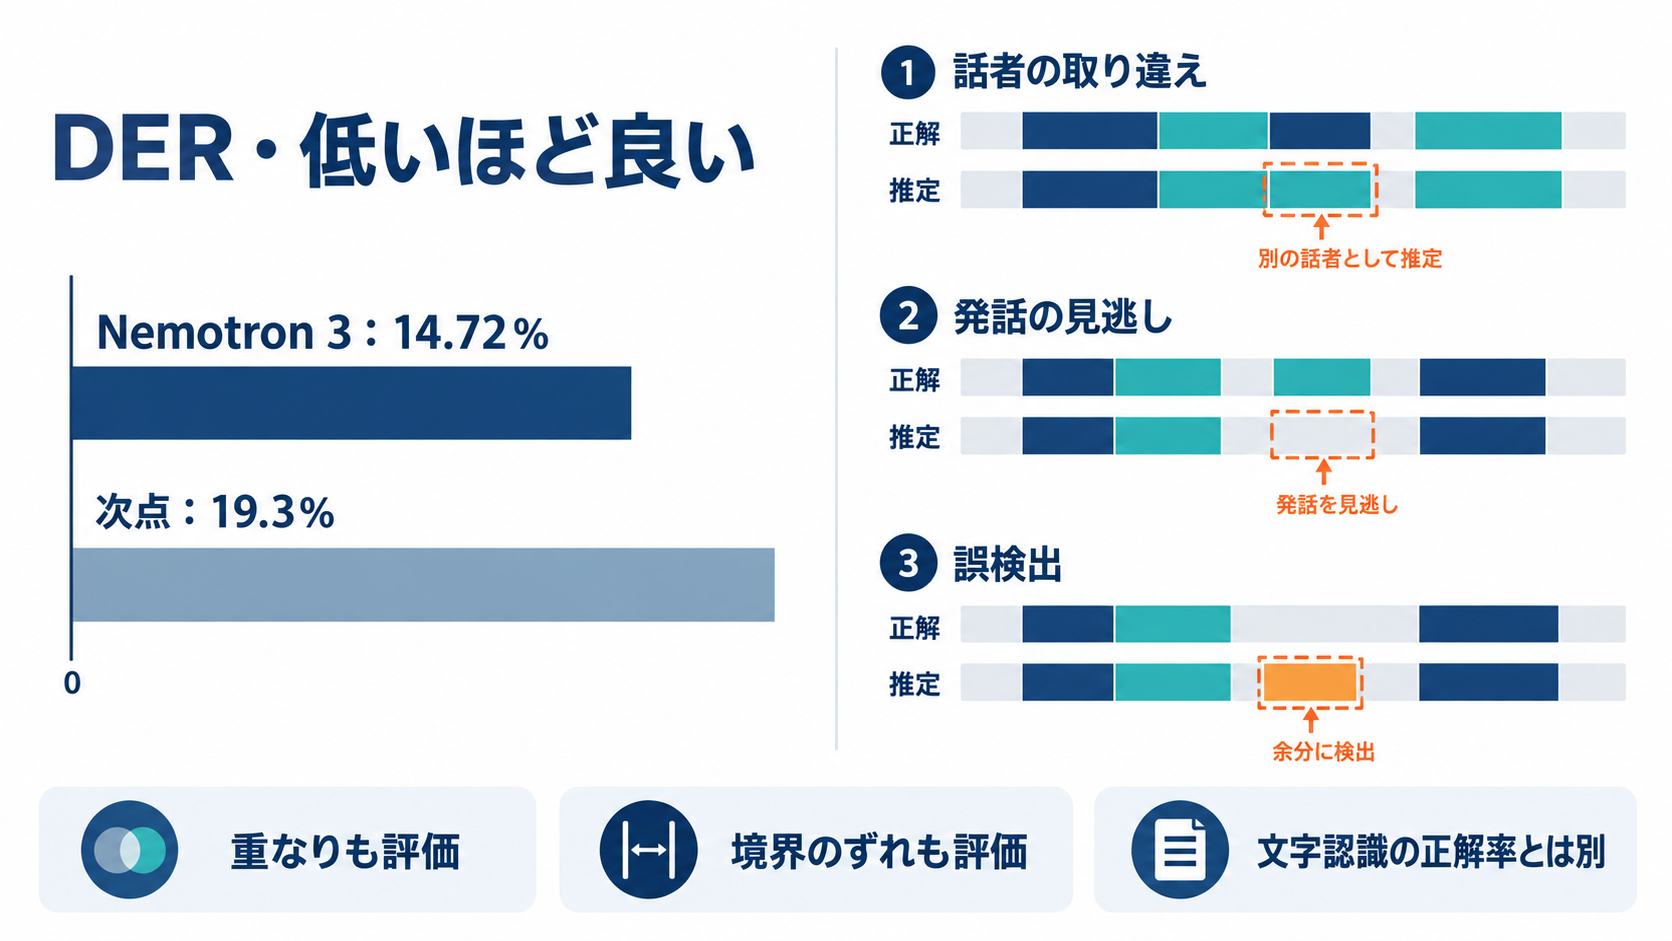
Nemotron 3 Diarizationは、VoiceArenaの「Diarization Benchmark v1」で、話者分離のエラー率を示すDERが14.72%となり、紹介された評価結果では首位に位置しています。次点のシステムは19.3%です。14.7%という表記も使われていますが、これは同じ結果を丸めた値として理解できます。DERは、音声のどの時間帯に誰が話しているかという判定の誤りを評価する指標です。一般に、発話の見逃し、発話していない区間の誤検出、話者の取り違えなどが関係します。文字起こしされた単語の正誤を測る指標とは異なり、14.72%という値から「会議録の文章が約85%正しい」とは判断できません。
このベンチマークは、複数人の発話が重なる部分も採点対象に含めます。話者が切り替わる境界のごく小さな時間のずれも誤りとして扱う、厳しい条件です。数値を見る際は、対象とする音声だけでなく、何を誤りに数える評価なのかも確認する必要があるでしょう。採点条件が違う結果を並べても、同じ基準で性能を比較したことにはなりません。
従来モデルの「Streaming Sortformer」との比較では、1.04秒の音声バッファを使った場合に、8つのテストシナリオでエラー率が平均41%低下しています。これは相対的な改善率であり、エラー率が41ポイント下がったという意味ではありません。また、首位という順位と従来モデル比の改善率は、示している比較の範囲が異なります。
企業にとっては、これらの結果は検証候補を選ぶ材料です。日本語の社内会議、固有名詞が多い商談、遠隔参加者を含む打ち合わせでも同じ値になるとは限りません。公表された順位を採用の結論にせず、実際に処理したい音声で話者の取り違えを確かめることが必要です。
音声バッファの短縮は、応答の速さと精度の交換条件
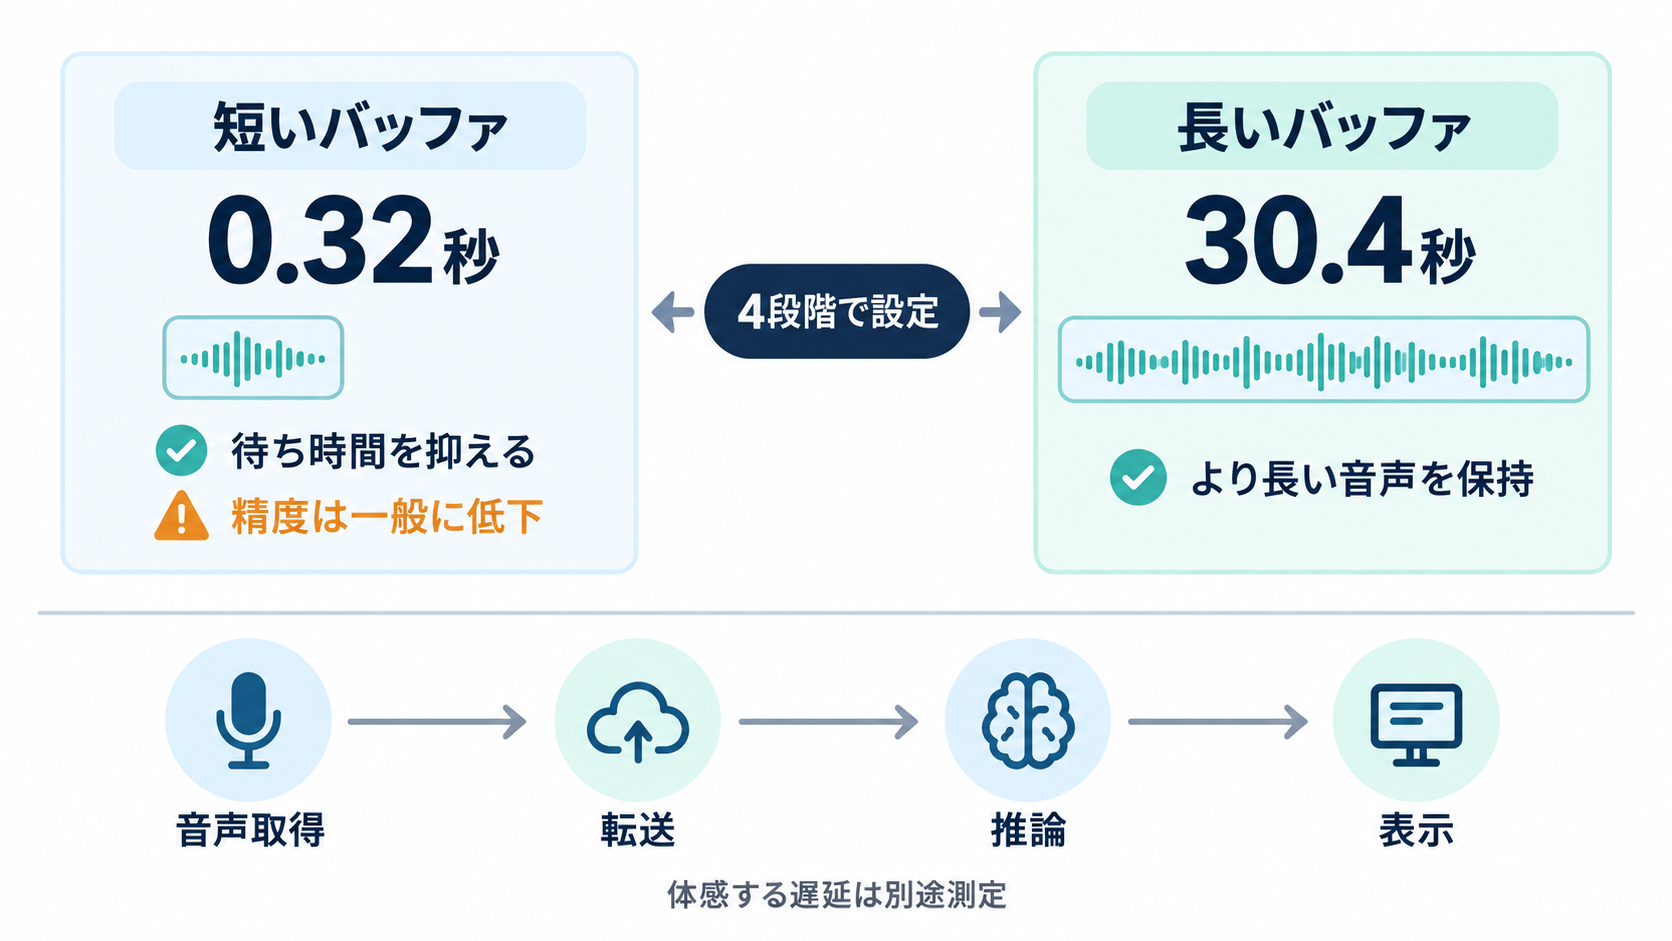
ライブ音声を扱うシステムでは、発言から結果が表示されるまでの待ち時間が使い勝手に直結します。Nemotron 3 Diarizationの音声バッファは4段階に設定でき、長さは30.4秒から0.32秒までの範囲です。短いバッファを選べば処理のために蓄える音声を減らせますが、一般に精度は下がります。音声バッファは、判断に使う音声を一時的に保持する仕組みです。短い音声だけで話者の切り替わりを判定する場合と、より長い前後関係を使える場合では、判断材料の量が変わります。今回の設定幅は、すべての用途に一つの動作条件を当てはめるのではなく、待ち時間と精度のバランスを用途ごとに選ぶためのものと捉えられます。
例えば、進行中の会話に合わせて発言者を画面に表示する用途では、表示の遅れを抑えることに意味があります。会議終了後に記録を整える用途であれば、多少の待ち時間を許容しても、発言者との対応を正確に残したい場合があるでしょう。同じモデルを使っていても、望ましい設定はサービスの目的によって変わるはずです。
注意したいのは、最短の0.32秒が、完成した会議録や字幕の表示までにかかる総時間を保証する値ではないことです。実際のシステムには音声の取得や転送、音声認識、結果の統合、画面への表示といった処理も含まれます。バッファの設定値と、利用者が体感する遅延は別々に測定する必要があります。
導入検証では、許容できる表示の遅れを先に決めると、設定を選びやすくなります。その条件を満たす範囲で、話者の切り替わりや短い相づちをどこまで正しく扱えるかを比較する進め方です。最短設定を一律に採用するよりも、速度が必要な理由を業務の場面に結び付けるほうが、判断基準を明確にできます。
最大8人への対応と、騒がしい会議での安定性は別の条件
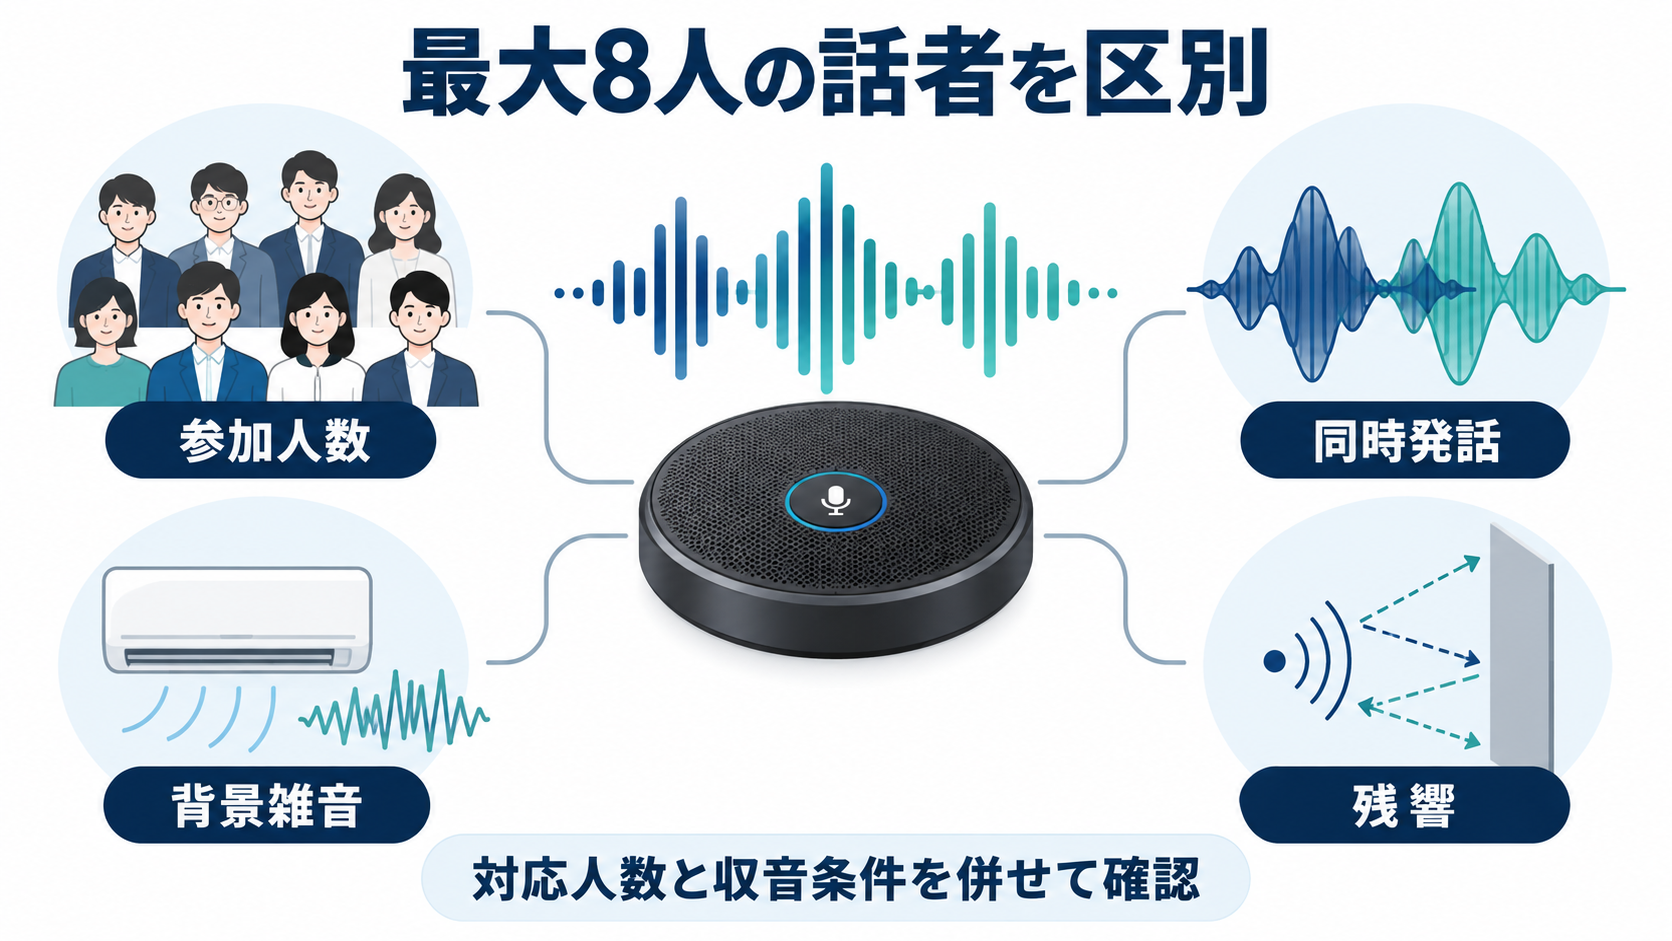
Nemotron 3 Diarizationは最大8人の話者を区別し、同時発話も検出できます。ただし、参加者が増える場合や、強い背景雑音、残響がある場合にはエラー率が高まります。「8人まで対応」という仕様を、8人の会議なら収音条件を問わず安定して動くという意味で受け取るべきではありません。複数人が同時に話す区間では、一人の発言が終わってから次の人が話す場合よりも、音声の対応関係が複雑になります。会議室の残響は、発した声が壁などで反射して遅れて届く現象です。背景雑音と同様に、音声を分析する際の条件を難しくします。こうした要因は、モデルの性能だけを見ていては捉えにくい実運用上の変数です。
検証用の音声を選ぶ際は、静かな環境で一人ずつ話す録音だけでは不十分でしょう。自社で起こりやすい、相づちが重なる場面、議論が活発になって発言が交差する場面、室内の音が響く場面も含めると、使える条件と難しい条件の境界が見えてきます。これは新たな性能を推測する作業ではなく、自社の利用環境で確かめるための方法です。
人数の数え方にも注意が必要です。会議室にいる人数ではなく、処理対象の音声に登場する話者が評価に関係します。遠隔参加者も発言すれば対象となるため、会議の参加形態まで含めて仕様との対応を確認したいところです。
誤りが多い場合には、モデルや設定の変更だけでなく、マイクの位置や収音方法も検討対象になります。ただし、特定の機材でどれだけ改善するかは、今回示された情報からは判断できません。音声条件と誤りが発生した区間を記録し、原因を切り分ける姿勢が、再現性のある導入評価につながります。
話者ラベル付き文字起こしは、音声認識との組み合わせで作る
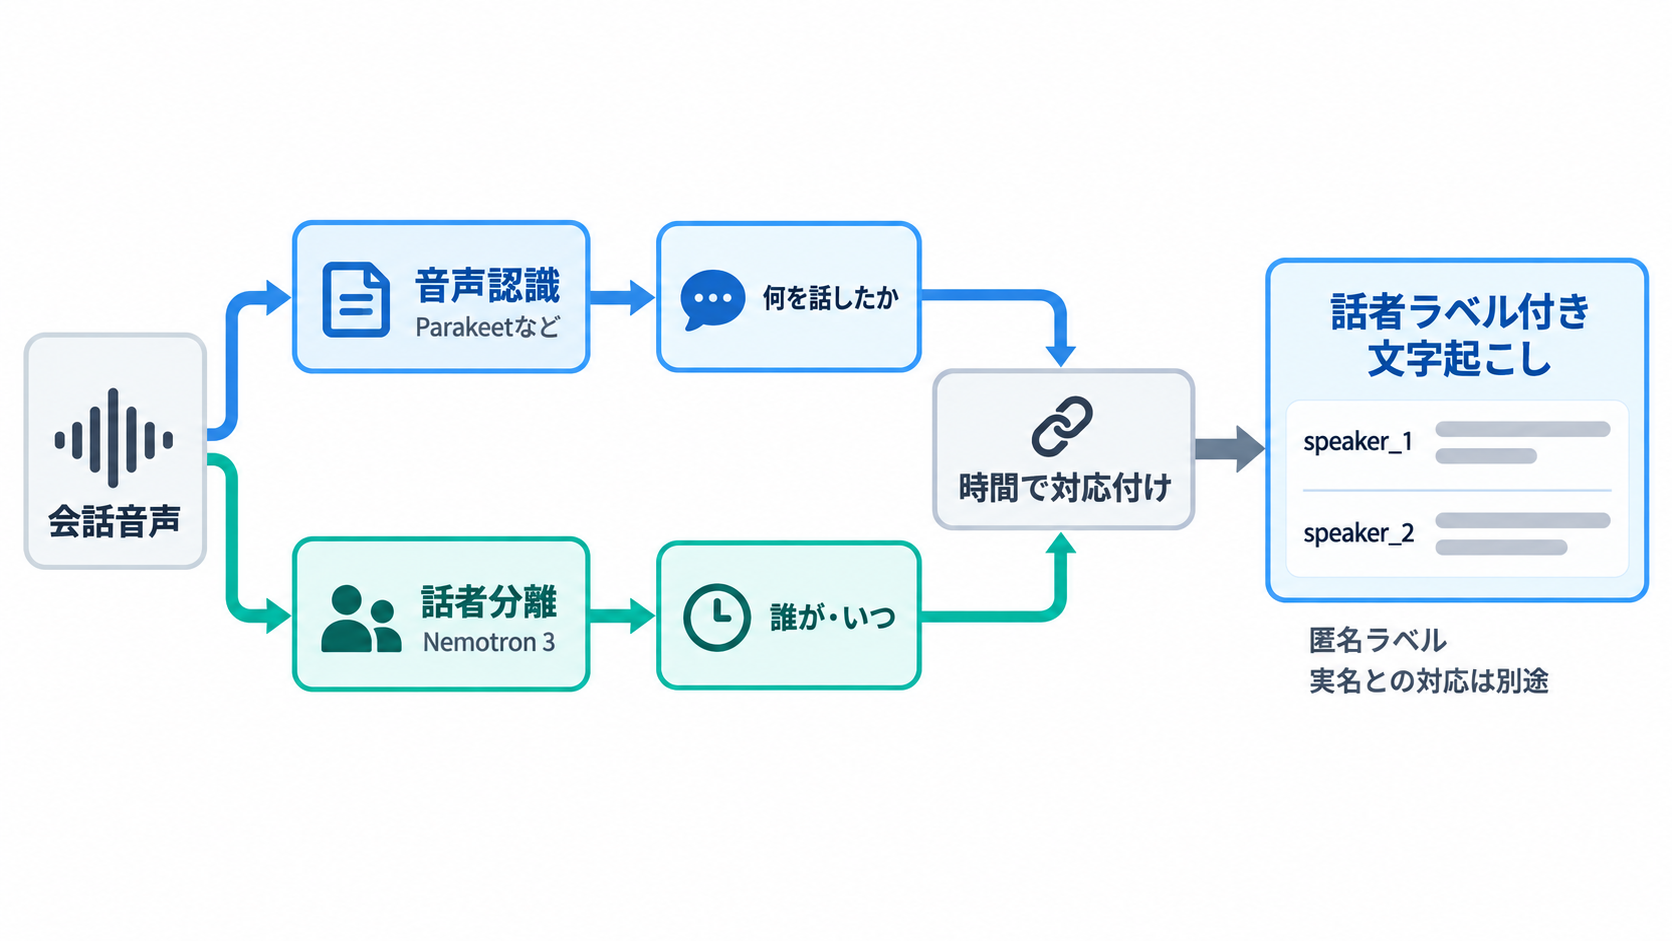
Nemotron 3 Diarizationを、音声を文字に変換する「Parakeet」のような音声認識システムと組み合わせると、話者ラベル付きの文字起こしを作れます。両者は役割が異なります。音声認識が「何を話したか」を扱い、話者分離が「どの話者が、いつ話したか」を扱う構成です。その結果を時間軸に沿って対応付けることで、発言の文章と話者ラベルを一緒に表示できます。ここで得られるラベルは匿名です。業務システムで氏名を表示したい場合には、そのラベルと実際の参加者を対応付ける方法を別途用意する必要があります。モデル単体で実名入りの議事録が完成するわけではありません。
この構成を理解すると、誤りの確認も進めやすくなります。発言の文字自体が間違っているなら音声認識側の問題を、文章は正しくても別の人の発言になっているなら話者分離や結果の対応付けを調べる、という切り分けが可能です。完成した議事録だけを評価すると、どの段階を改善すべきかが分かりにくくなるでしょう。
生成AIによる要約やタスク抽出を後段に置く場合も、発言者の情報は意味を持ちます。例えば、提案と承認が別の人による発言であることを保てれば、会話の流れを確認しやすくなります。ただし、今回示された評価は話者分離の性能に関するものであり、要約の正確さや担当者抽出の品質まで実証したものではありません。
企業向けサービスを設計する際は、文字起こし、話者ラベル、要約をそれぞれ確認できるようにすると、修正の根拠を追いやすくなります。重要な決定事項について、必要に応じて該当する音声区間に戻れる設計も検討できます。こうした運用上の工夫は、公開されたモデルの機能と区別したうえで、自社の記録の使い方に合わせて考えるべき事項です。
無料公開を検証の入口にし、日本語と運用条件を確かめる
学習済みの重みが無料で公開されたことは、企業がモデルを検証する入口になります。ただし、無料で入手できることと、自社サービスに組み込む際の利用条件や運用費用が確定していることは同じではありません。商用利用や再配布に関する条件は、公開元のライセンスで確認する必要があります。約1億パラメータという規模も、導入可否を判断する材料の一つです。それだけで必要なGPU、メモリ量、同時に処理できる会議数までは分かりません。これらは実装や動作環境、音声の扱い方などに左右されるため、モデルの規模から運用コストを直接見積もることは避けたいところです。
日本の企業では、日本語の実際の会話を使った確認が欠かせません。今回示された情報だけでは、日本語の業務会議における個別の精度や条件別の結果までは確認できません。短い相づちが続くやり取りや、複数の参加者が発言をつなぐ場面を含め、自社で多い会話の形を検証対象にするとよいでしょう。
検証では、全体のエラー率に加えて、業務上困る取り違えを記録することが有効です。承認者の発言が提案者に割り当てられる場合と、内容の判断に影響しない相づちがずれる場合では、修正の優先度が異なります。評価指標の数値と、実際に必要な確認作業の量を併せて見ることで、導入後の負担を考えやすくなります。
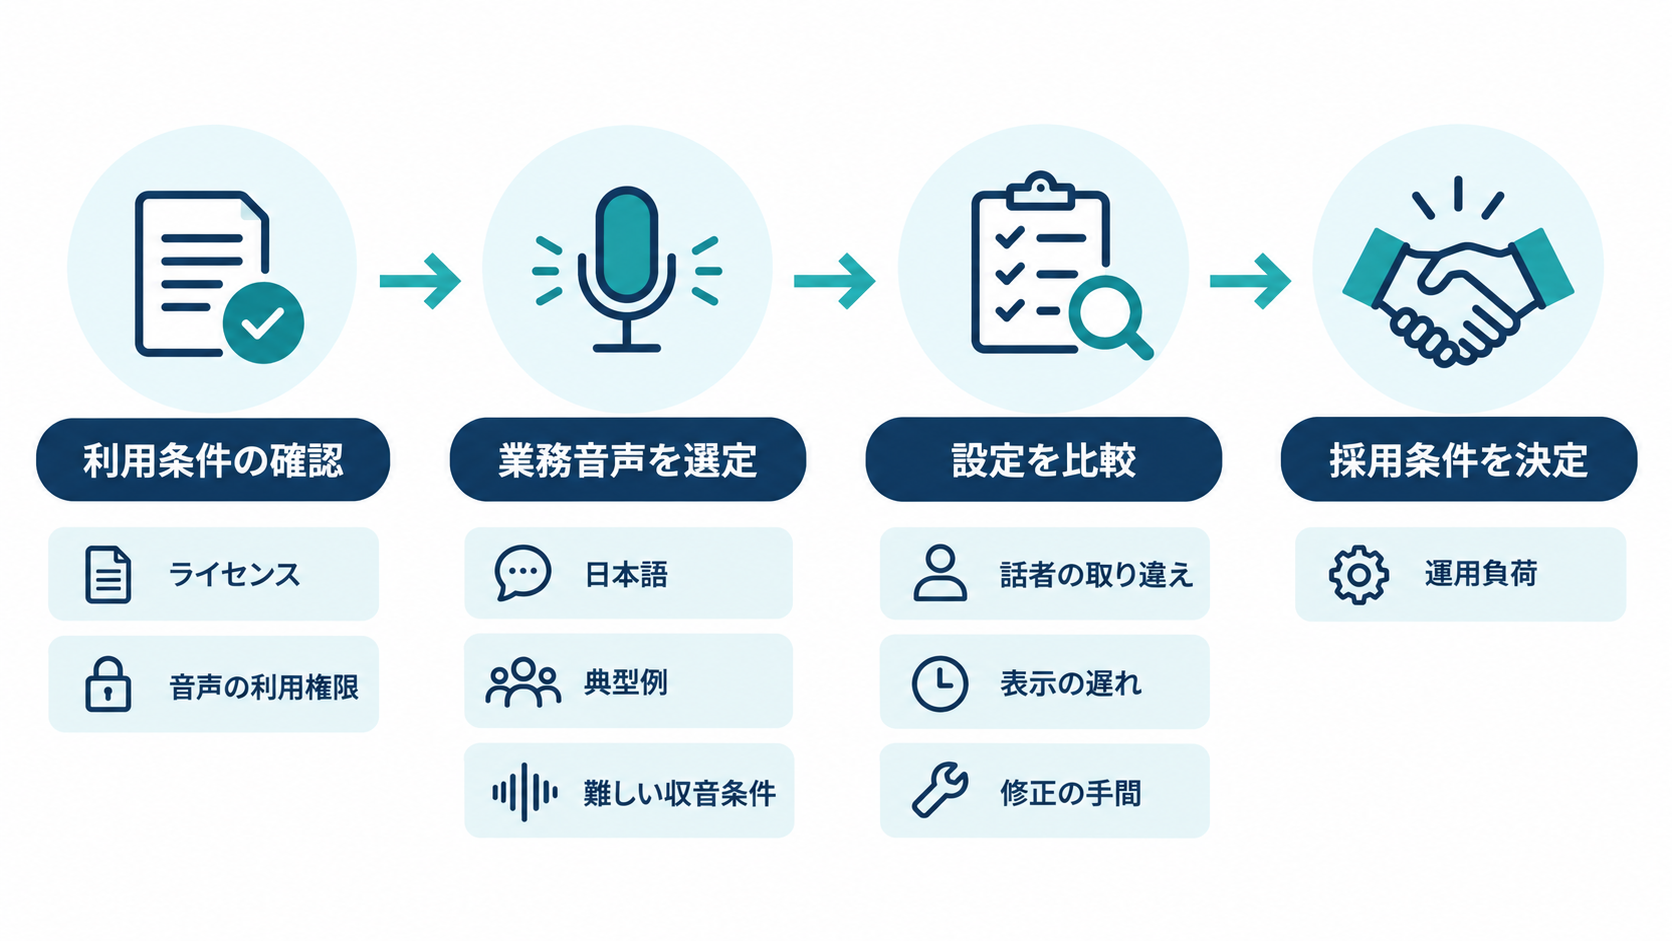
次の一歩は、利用権限を確認した社内音声から、典型的な会議と条件の厳しい会議を選び、同じ音声を複数のバッファ設定で比較することです。話者の取り違え、表示までの待ち時間、人が修正する手間を記録すれば、自社に合う設定を具体的に判断できます。公表された性能を、自社の会議録で使える条件へ落とし込むことが導入検証の目的です。