
AI LAB
2026/10/26
生成AIを「提案役」から「実行者」へ――自律運用を左右する信頼・ネットワーク・統制設計
AIの価値を分ける「答える能力」と「実行する権限」
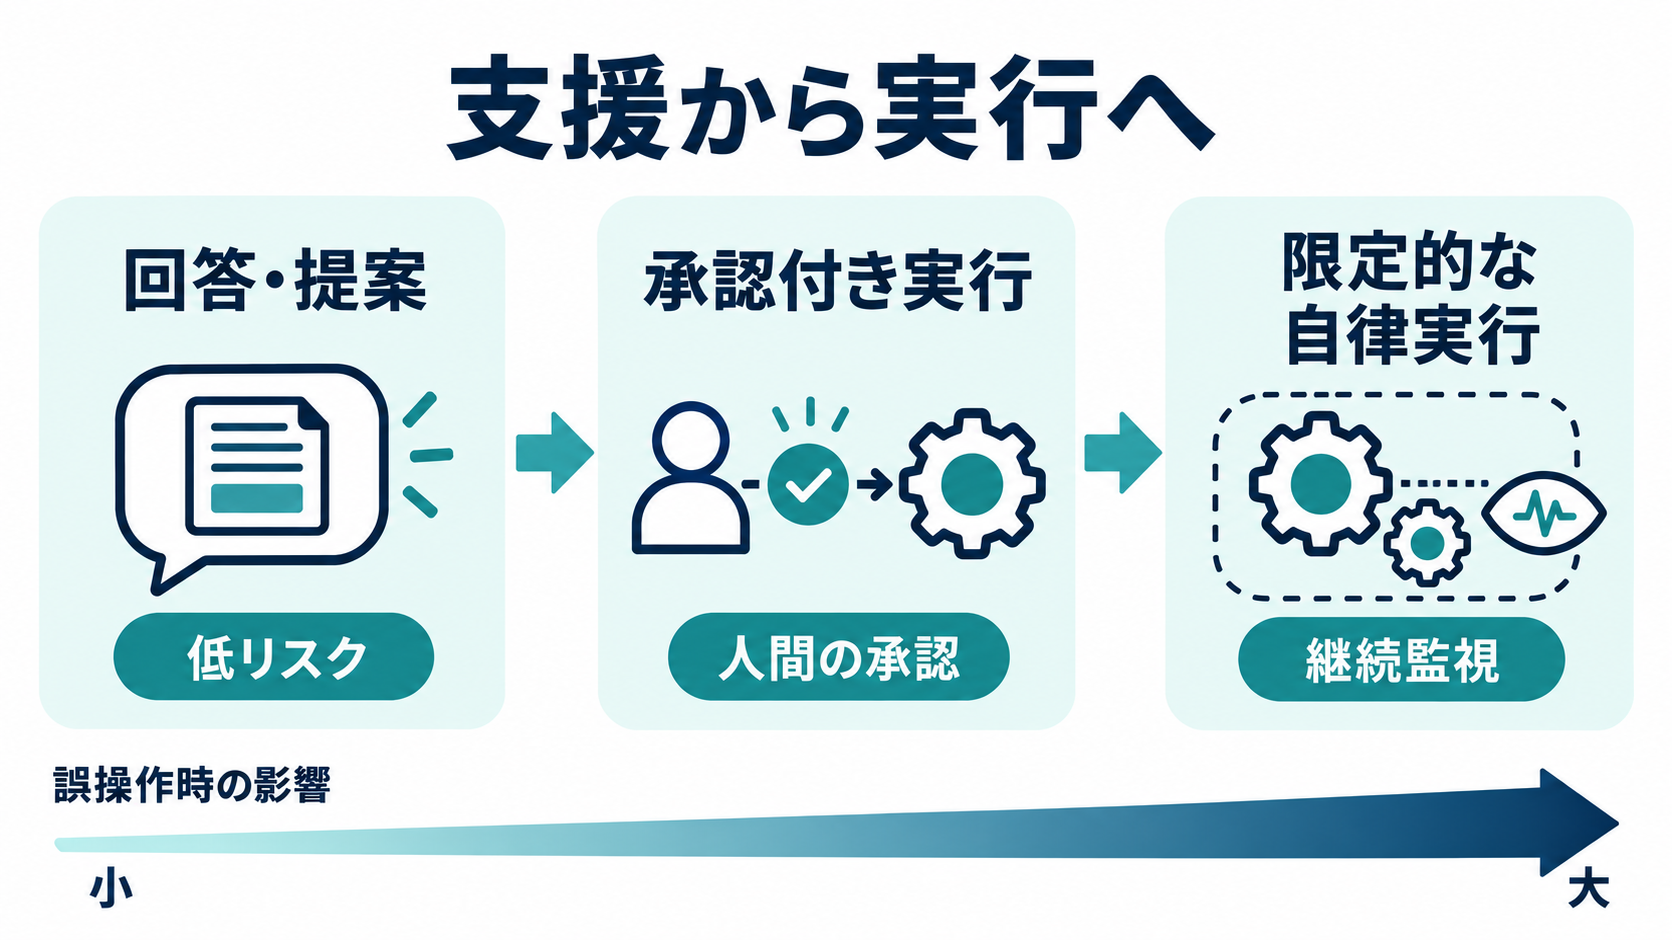
AIがメールの下書きを誤れば、担当者が修正して送信を止められます。しかし、AIエージェントがネットワークポリシーを書き換え、通信経路を変更し、端末を隔離した後で誤りが判明した場合、業務そのものが止まりかねません。企業向け生成AIの焦点は、モデルが何を回答できるかという段階から、システムにどこまで実行を許すかという段階へ移りつつあります。ここで問われるのは、モデルの性能だけではありません。実行対象となるシステムの状態を正しく把握できるか、与えた権限を必要最小限に抑えられるか、判断理由を後から検証できるかといった運用設計が必要です。モデルの回答精度が高くても、古い監視情報や不完全な権限設定を基に動けば、安全な自動化にはなりません。
米ボストンで開催予定の「Bloomberg Tech Event: Building the Agentic Enterprise」には、Hewlett Packard Enterprise(HPE)の関係者だけでなく、Mercedes-Benz North AmericaのCIO、Booking HoldingsやCarnivalのセキュリティ責任者、Estée Lauderのデータ・分析・AI責任者らが登壇予定です。この顔ぶれが示すのは、自律運用の可否を決めるのがAIベンダーだけではないという点です。実際に責任を負うIT、セキュリティ、データ、事業部門が、許容できる失敗の範囲を合意しなければなりません。
企業にとって中心的な論点は「AIを導入するか」ではなく、「どの行為を、どの条件で、誰の監督下に置くか」です。自律運用は新機能の有効化ではなく、権限と責任の境界を組み直す経営課題として扱う必要があります。
自律化を一度に解禁しない段階設計
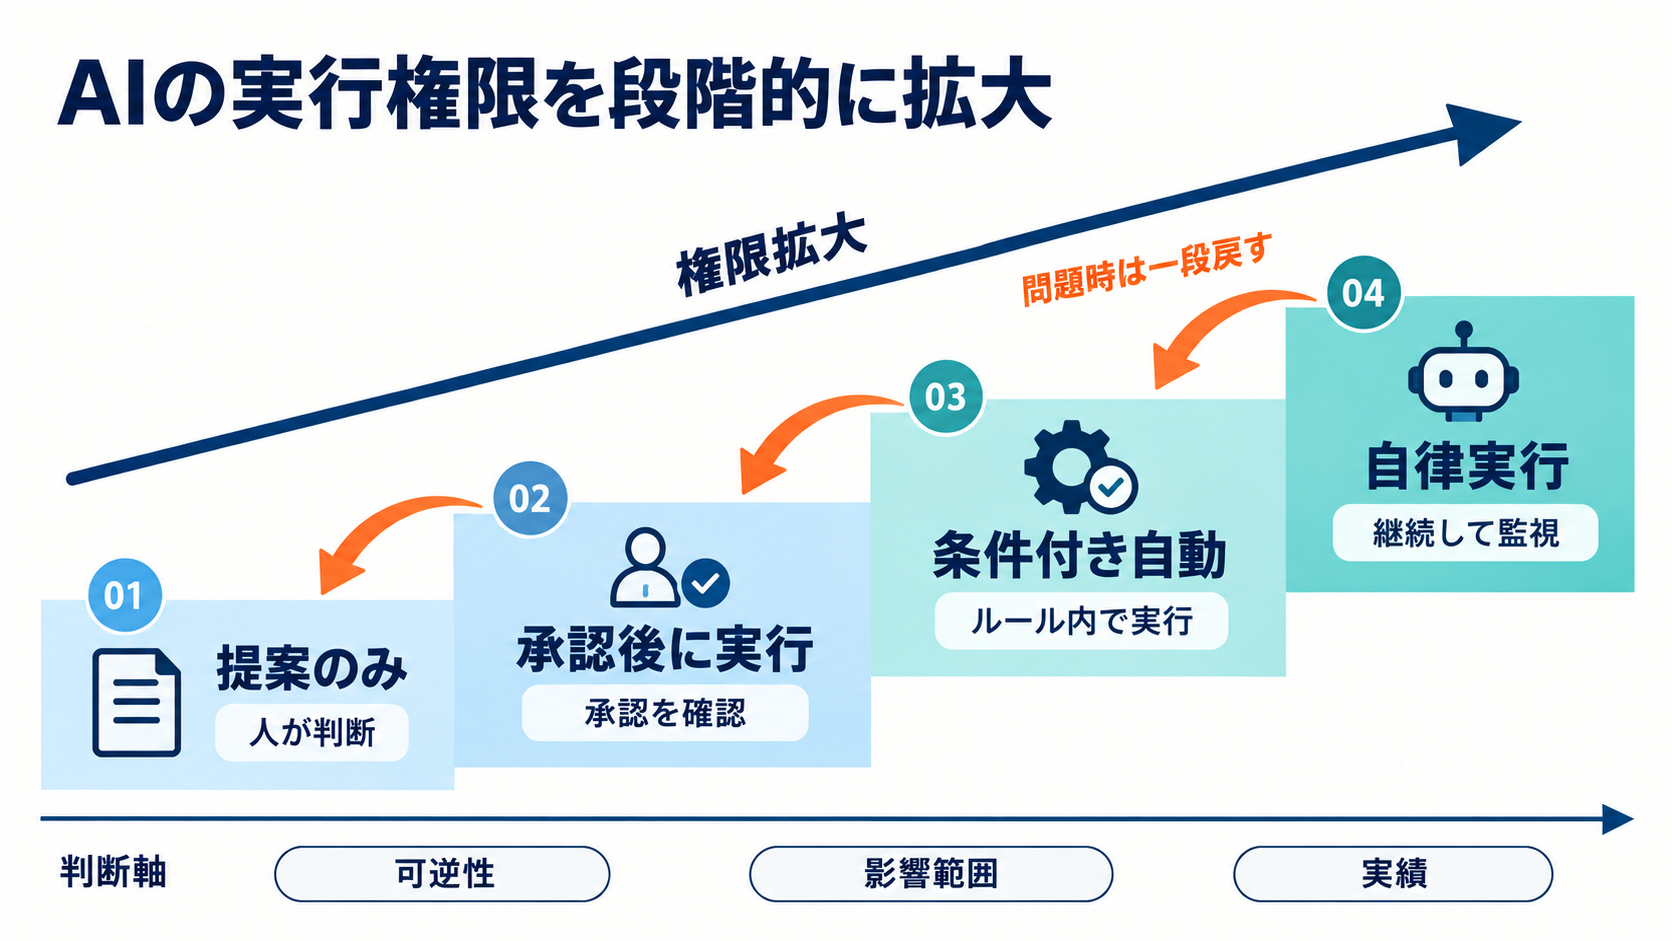
安全な自律運用は、オンとオフを切り替えるようには導入できません。実務では、AIが提案だけを行う段階、人間の承認後に実行する段階、限定された条件下で自動実行する段階へと、行為の種類ごとに移行させる設計が現実的です。障害の兆候を通知することと、本番環境の通信設定を変更することでは、失敗時の影響が大きく異なるためです。自律化の区分を決める際は、処理頻度だけでなく、可逆性、影響範囲、判断の不確実性も確認します。容易に取り消せる変更や、対象を限定できる処理は自動化を進めやすいでしょう。反対に、顧客向けサービス全体へ波及する変更や、復旧に時間を要する操作には、人間の承認や複数者による確認を残すべきです。緊急時だけ自動実行を許すといった条件付きの運用も考えられます。
重要なのは、一度決めた区分を固定しないことです。実行結果、誤検知、承認者による差し戻し、復旧に要した時間などを記録し、定期的に権限を見直します。紹介されている提案では四半期ごとの再評価が推奨されていますが、変更頻度や事業リスクに応じて短い周期を設定してもよいでしょう。良好な実績が積み上がった行為は自動化の範囲を広げ、想定外の結果が増えた行為は承認付きへ戻せる構造が必要です。
この段階設計は、失敗を完全に排除するためだけのものではありません。AIがどの条件なら安定して働けるかを、組織が証拠に基づいて学ぶ仕組みでもあります。自律性を最初から最大化するのではなく、観測可能な小さな範囲で信頼を獲得させることが、運用定着への近道になります。
稼働率だけでは測れない利用者視点の品質
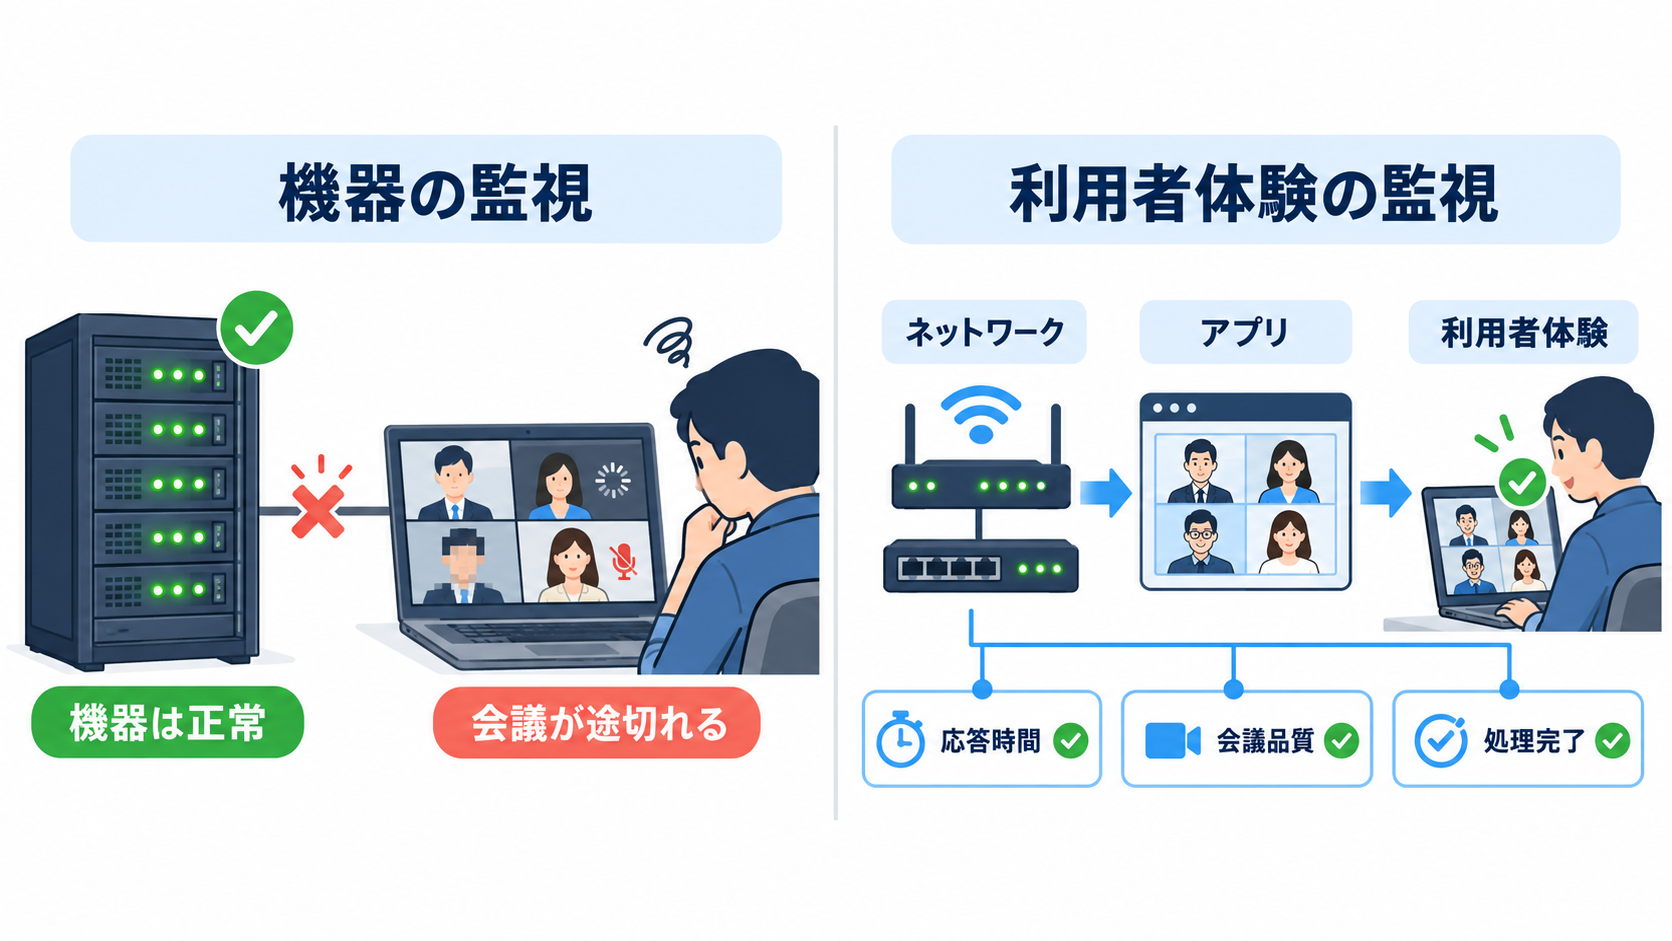
HPEのネットワーク部門幹部Sujai Hajela氏は、同社の投資家向けイベントで「稼働していることと、良好であることは同じではない」という趣旨を示しました。ネットワーク機器が停止していなくても、ビデオ会議の音声が途切れたり、AIの処理が通信待ちで滞ったりすれば、利用者にとってサービスは十分に機能していません。機器単位の正常性だけを見ていると、この差を捉えられないでしょう。AIに復旧や最適化を任せるには、何を問題と見なすかを利用者や事業の視点から定義する必要があります。監視項目はCPU使用率や通信量だけでなく、アプリケーションの応答、会議品質、処理完了までの時間、サービス提供開始までの所要時間などへ広がります。インフラの状態と利用体験を結び付けられなければ、AIは数値上の異常を直しても、現場が困っている原因を解消できません。
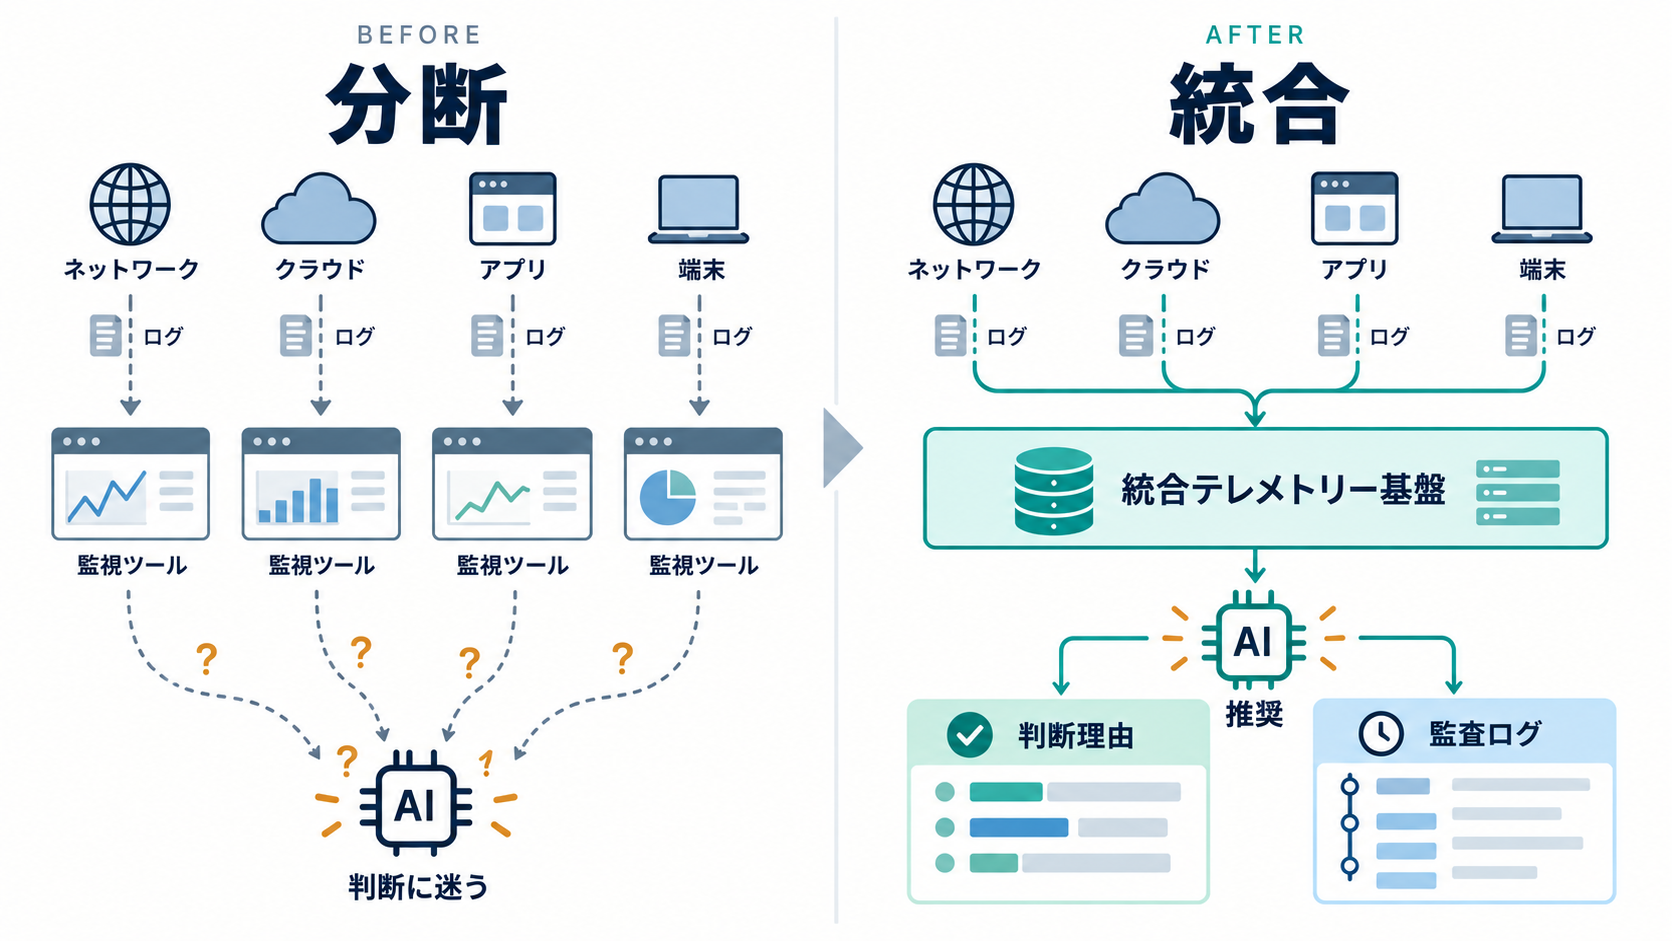
ServiceNowのデジタル基盤担当者Sajeev Nair氏は、個別製品を追加し続けた結果、すでに分断されていたテレメトリーが一層細分化したと説明しています。テレメトリーとは、機器やアプリケーションから継続的に集めるログ、メトリクス、イベントなどの運用データです。同社では統合を進めた結果、年間2,000~3,000時間を要していた手作業が60時間未満になったとされています。
評価指標も、人員削減だけに寄せるべきではありません。技術者へ戻せた作業時間、問い合わせになる前に防げた障害、新サービスが価値を生むまでの期間などを追うと、自律運用の効果を業務成果として把握しやすくなります。AIに操作を許す前に、成功と失敗を利用者の立場で測れる状態を整えることが先決です。
AI時代のネットワークが担う三つの役割
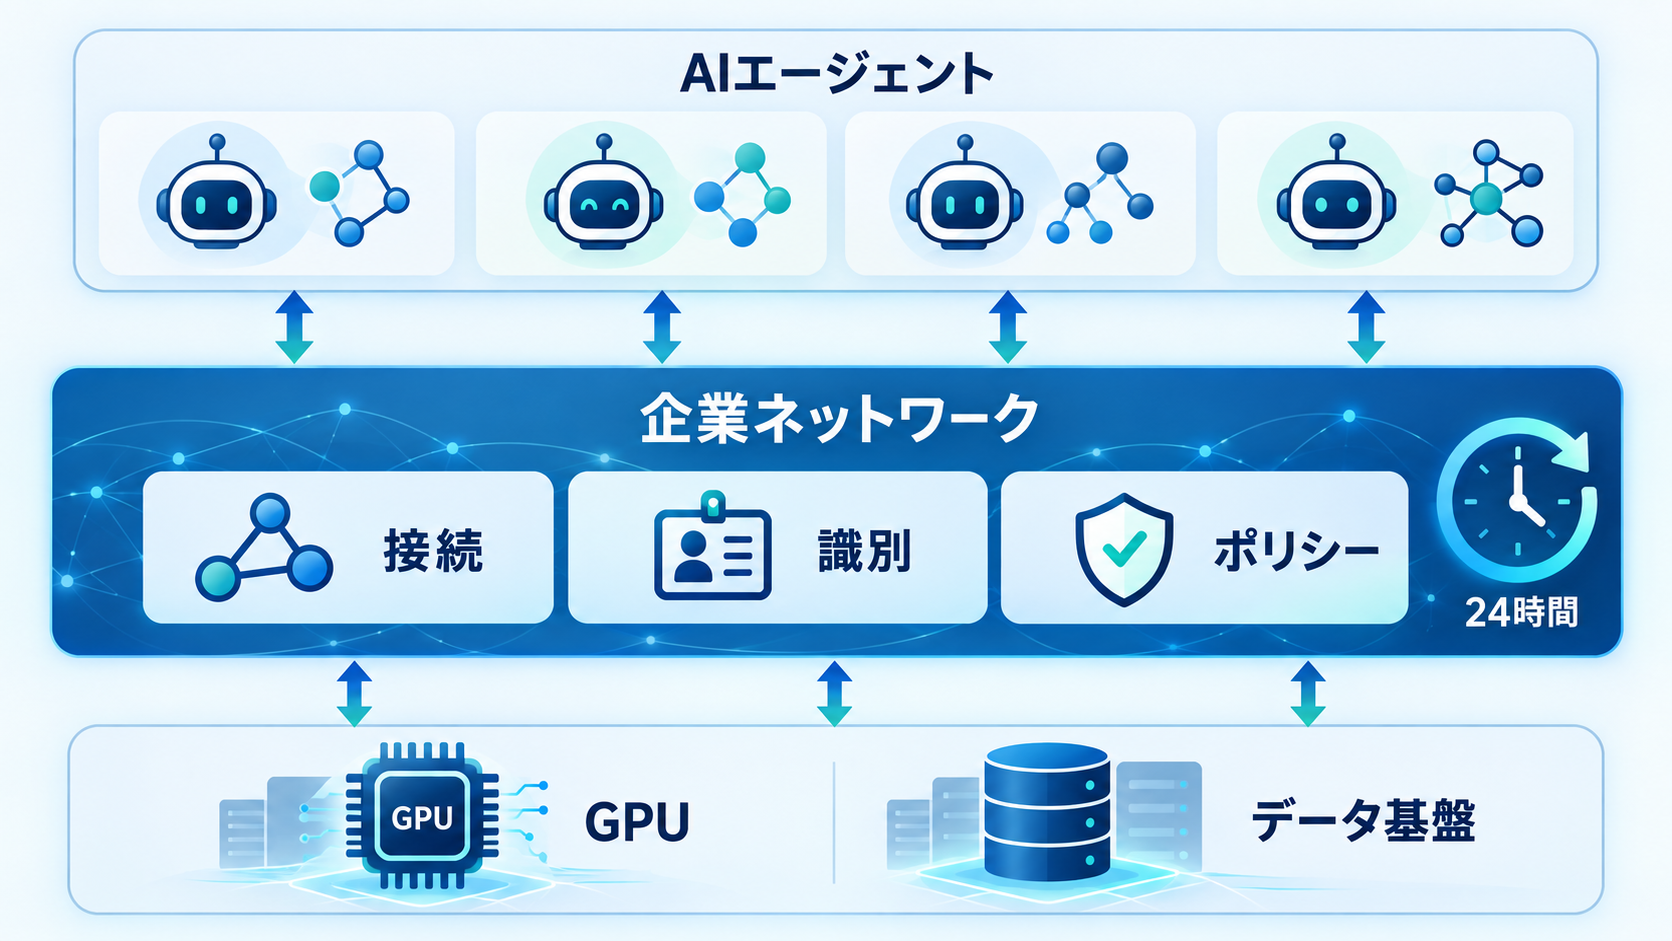
生成AI基盤への投資では、高性能なGPUやモデルが目立ちます。ただしHPE Networkingを率いるRami Rahim氏は、ネットワークが性能要求を満たせなければ、多額を投じたGPUも十分に活用されないと指摘しています。計算資源が高速でも、データの受け渡しが詰まれば処理全体の速度は上がりません。ネットワークは単なる接続手段ではなく、AI基盤の実効性能を決める構成要素になります。AIの通信には、従来の動画配信などとは異なる性質があります。HPEのルーティング事業を率いるAE Natarajan氏によれば、上りと下りの通信が均衡しやすく、動画のようなキャッシュが難しいうえ、エージェントは昼夜を問わず通信します。人間の利用時間を前提にした容量計画や監視ルールでは、継続的に動くAIエージェントの負荷を十分に扱えない可能性があります。
エージェントが新たなネットワーク利用者になると、通信を運ぶだけでは足りません。そのエージェントは何者か、どのデータやシステムへ接続してよいか、通常はどのように振る舞うかを識別し、規則を適用する必要があります。ネットワークには、接続、アイデンティティー確認、ポリシー実施という三つの役割が重なっていきます。
この変化は予算や組織にも影響します。AI基盤、ネットワーク、セキュリティ、ガバナンスを別々に最適化すると、権限の抜けや監視の空白が生じかねません。自律運用を計画する企業は、AIエージェントの通信経路と権限をアプリケーション内部だけで管理せず、ネットワークを含む一貫した統制対象として捉える必要があります。
セキュリティ部門が握る自律化の速度
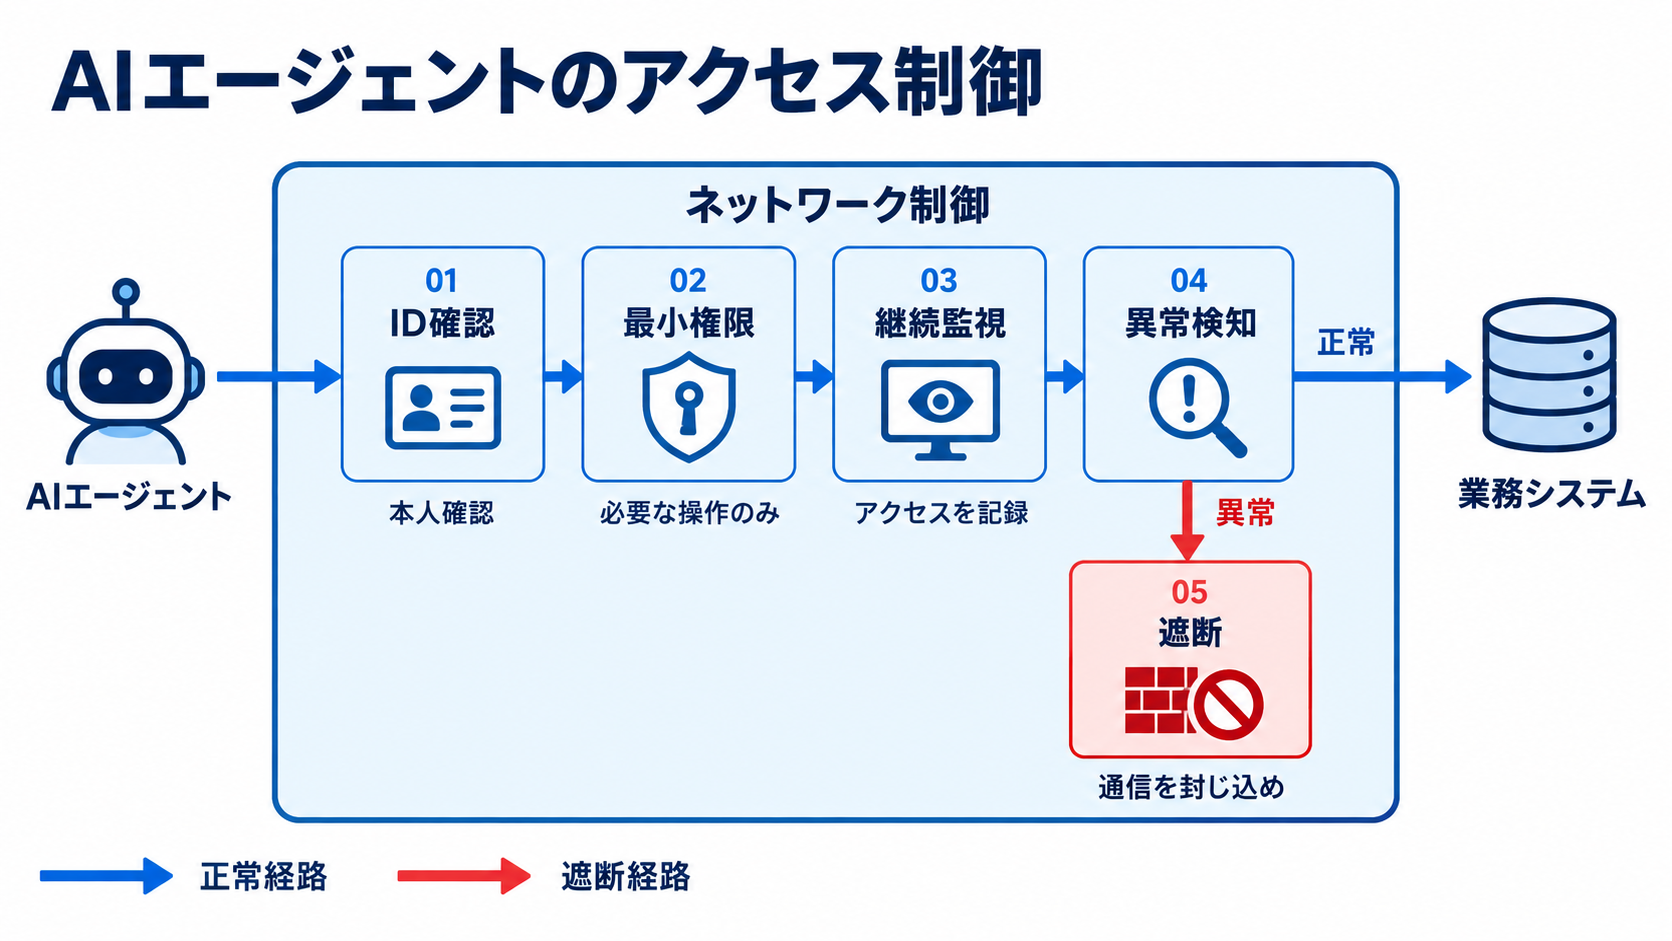
AIエージェントには、業務を実行するためのシステム権限やデータアクセスが必要です。つまり企業は、従業員や端末に加えて、多数の「人間ではないアイデンティティー」を管理することになります。どのエージェントが誰の依頼で動き、何へアクセスし、別のエージェントとどう連携したかを追跡できなければ、便利な自動化が新たな侵入経路にもなり得ます。対策の基礎になるのが、相手を無条件に信頼せず、アクセスのたびに確認するゼロトラストの考え方です。AIエージェントにも固有の識別情報を与え、必要最小限の権限を設定し、行動を継続監視します。異常があれば権限を一時停止し、影響範囲をネットワーク側で封じ込められる設計が求められます。共有アカウントや長期間有効な認証情報へ依存すると、誰の判断で処理が行われたのかが曖昧になります。
脅威側でもAIの利用が進むため、防御速度も課題です。紹介された事例では、Anthropicの「Claude Mythos」が審査済みの組織による1万件超の重大または高深刻度の脆弱性発見を支援したとされています。こうした能力が攻撃者にも広がれば、サポートが終了した古いスイッチやルーターは狙われやすくなります。更新できない機器の棚卸しと置き換えは、AI導入とは別の保守作業ではなく、自律運用の前提条件と考えるべきでしょう。
セキュリティ責任者は、自律化を抑えるだけの存在ではありません。機械速度の攻撃へ人間の判断だけで対応することには限界があるため、検知や封じ込めにも自動化が必要です。自律運用は管理すべきリスクであると同時に、防御力を高める手段でもあります。その両面を評価できるかどうかが、導入速度を左右します。
技術より先に整えるデータと責任分界
エージェント型AIの実運用を妨げる要因として挙がるのは、モデル性能よりも、分断されたデータ、レガシー基盤、不明確な責任、スキル不足、費用、信頼です。AIが正しく状況を判断するには、ネットワーク、クラウド、アプリケーション、端末から得られる情報を一続きに確認できなければなりません。監視ツールごとに時刻、名称、識別子が異なる環境では、同じ障害を別々の事象と誤認するおそれがあります。HPEは、自律型ネットワークへの信頼を証拠に基づいて形成する考え方を示しています。システムが推奨内容と理由を運用担当者へ提示し、結果を確認しながら自動実行へ進む方式です。ただし、その説明が信頼できるためには、判断材料となるテレメトリーが欠落せず、整合している必要があります。AIの説明画面を追加するだけでは、入力データの不備を補えません。
責任分界も明文化が必要です。誤った変更が行われた際に、モデル提供者、システム管理者、承認者、事業責任者の誰が停止や復旧を判断するのかを、導入前に決めておきます。AIの判断理由、使ったデータ、実行した操作、承認履歴を残せば、障害調査だけでなく、権限を拡大してよいか判断する材料にもなります。
ベンダーが「自律型」や「セルフドライビング」と表現していても、実際に自動化される範囲は製品ごとに異なります。提案を表示するだけなのか、承認後に処理するのか、例外時のロールバックまで担うのかを確認しなければなりません。製品名ではなく、入力データ、実行権限、停止条件、監査記録という運用単位で評価する姿勢が求められます。
実証実験を事業価値へつなぐ投資判断
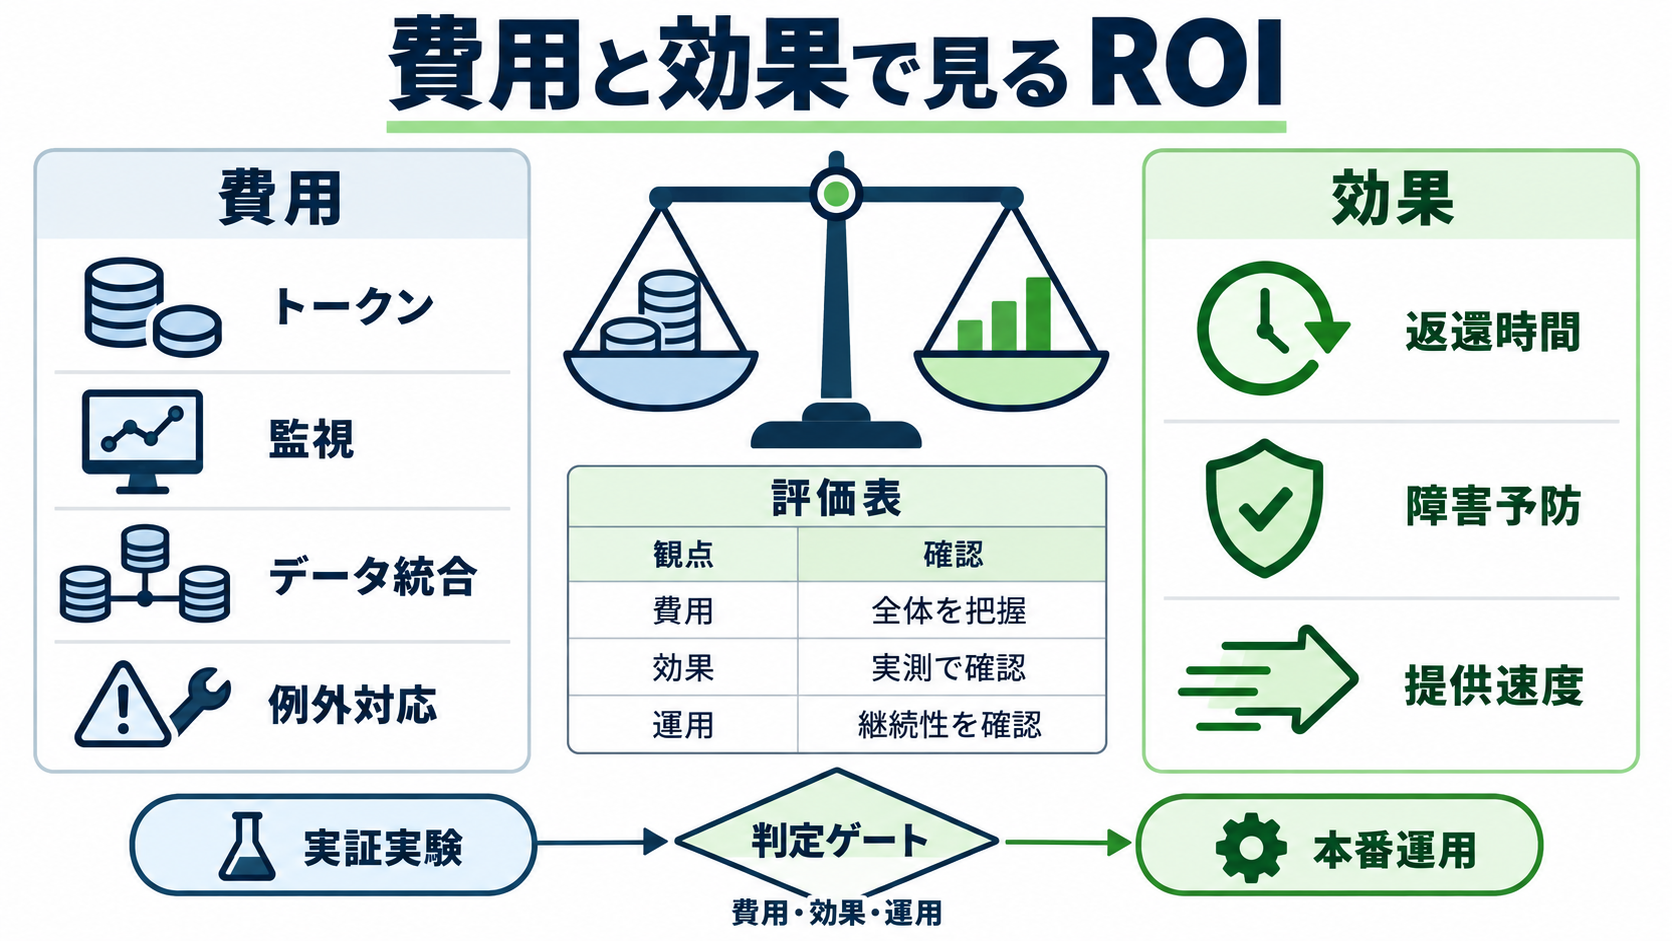
エージェント型AIは、試験環境で動作しただけでは投資判断を通過しません。継続運用ではモデル利用に伴うトークン費用に加え、監視、データ統合、権限管理、ネットワーク更新、例外対応などの負担が発生します。個々の自動処理が安価でも、常時稼働する多数のエージェントが頻繁に推論すれば、全体コストは利用量とともに変化します。費用対効果を示すには、技術的に実行できた回数ではなく、事業上の変化を測る必要があります。技術者が定型作業から解放された時間、障害を未然に防いだ件数、サービス提供までの期間短縮などは、運用改善と結び付けやすい指標です。売上への影響を評価する場合も、自律化だけの効果と断定せず、比較対象や測定期間をそろえる必要があるでしょう。
対象業務の選び方も結果を左右します。発生頻度が高く、判断条件が明確で、結果を測定しやすく、失敗しても元に戻せる処理は初期候補に向いています。反対に、例外が多く、担当者の暗黙知へ依存し、誤りの影響が広範囲に及ぶ業務を最初から完全自動化すると、監督コストが効果を上回るかもしれません。
経営層へ説明する際は、「AIが自律的に動いた」というデモよりも、どの費用を削減し、どの機会損失を防ぎ、どの統制を維持できたかを示す方が有効です。モデルの能力を競う実証実験から、再現可能な運用成果を検証する取り組みへ移れるかどうかが、本番展開の分岐点になります。
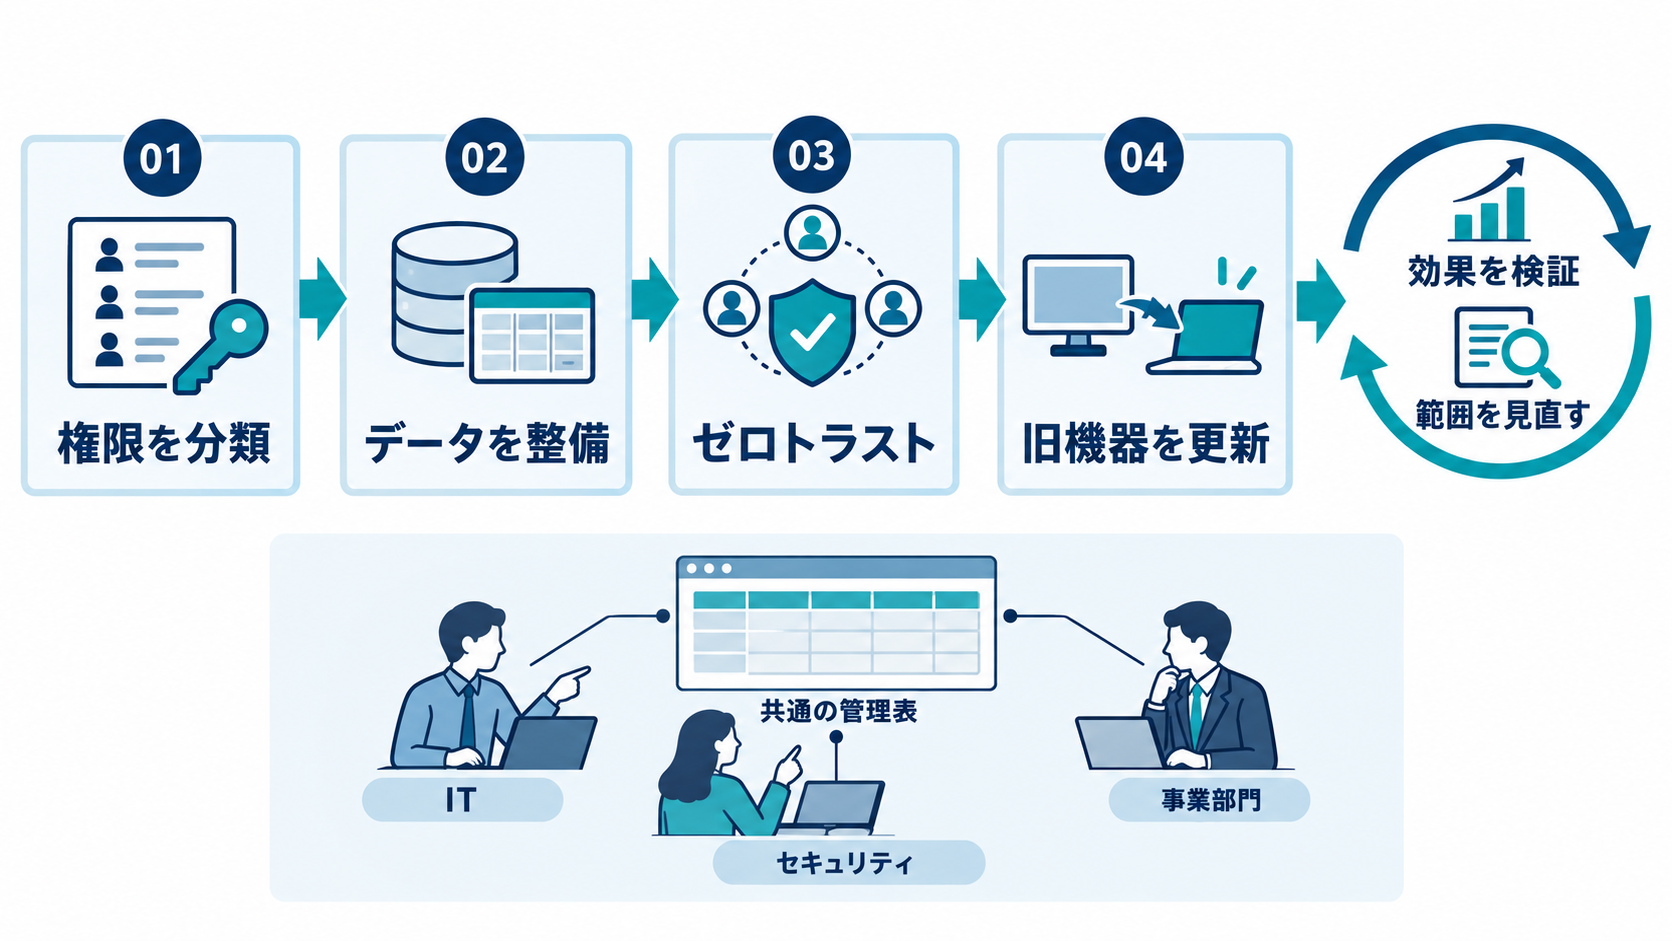
日本企業が着手できる四つの実務
自律運用への移行で最初に作るべきものは、大規模なAI基盤ではなく、AIへ許可する行為の一覧です。対象システムごとに、自動実行、承認付き実行、手動限定の三段階へ分類し、変更を取り消せるか、影響がどこまで及ぶか、停止権限を誰が持つかを記載します。既存の変更管理や稟議の仕組みを全面的に捨てる必要はありません。AI向けの承認条件と証跡を組み込むところから始められます。続いて、監視データの棚卸しを行います。複数ツールが同じ機器やサービスを異なる名前で管理していないか、時刻が同期されているか、利用者体験まで追跡できるかを確認します。すべてを一度に統合するのではなく、最初に自動化する業務の判断に必要なデータへ範囲を絞れば、改善効果を測りやすくなります。
AIエージェントには、人間の従業員と同様に所有者を定め、個別のID、最小権限、有効期限、行動ログを持たせます。エージェント同士の連携も例外にせず、接続先と委任可能な権限を制限します。同時に、サポート終了機器や修正プログラムを適用できない機器を洗い出し、自動化の対象経路から外すか、更新計画へ組み込む必要があります。
小規模な対象で運用を開始した後は、承認率、差し戻し理由、誤動作、復旧時間、削減できた作業時間を定期的に確認します。その記録を基に、自動化の範囲を広げるか、承認付きへ戻すかを判断します。次の一歩としては、ネットワーク運用、セキュリティ、データ管理、事業部門が同じ表を見ながら、一つの業務について自律化レベルを合意する場を設けるとよいでしょう。安全性と投資効果を同じ単位で話し合える状態が、AIを提案役から実行者へ移す土台になります。