
AI LAB
2026/10/26
GPT-6.1 Terra、API料金半減で変わる企業AIのモデル選定
半額のAPI料金が問い直す「高性能モデルほど高コスト」という前提
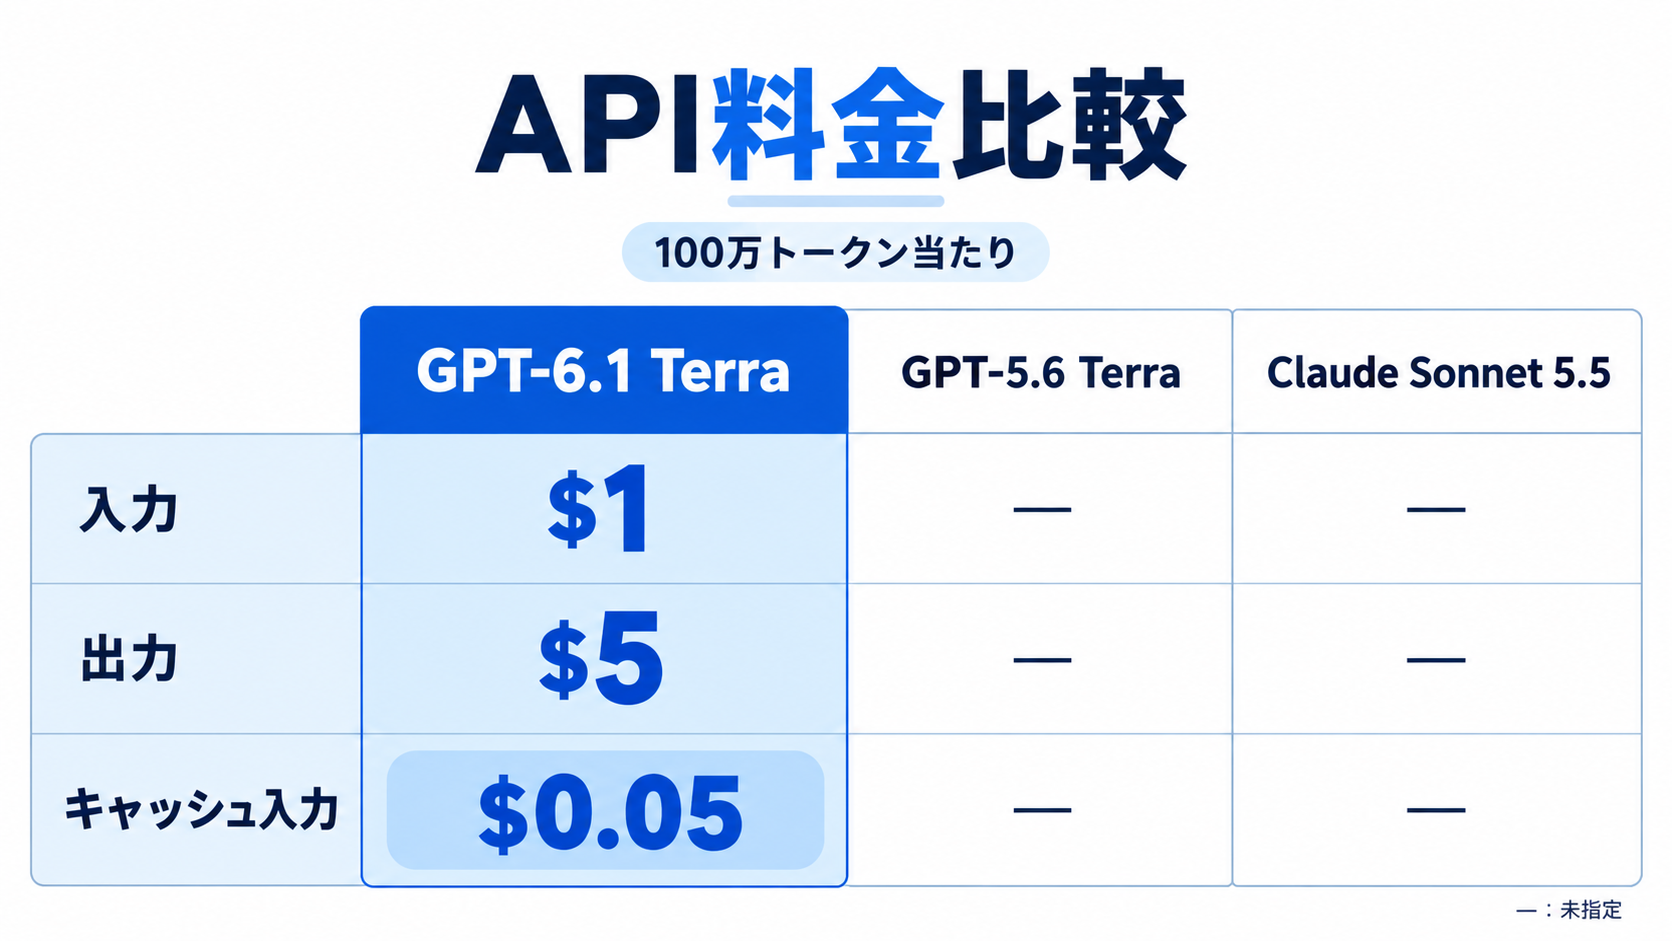
OpenAIが公開したGPT-6.1 Terraは、GPT-5.6 Terraの半額となるAPI料金を打ち出しました。入力は100万トークン当たり1ドル、出力は5ドルです。競合として位置づけられるAnthropicの中位モデルClaude Sonnet 5.5は、それぞれ2ドルと10ドル、GPT-5.6 Terraは2ドルと12ドルとされています。単純な単価比較では、GPT-6.1 Terraは日常業務に使える性能帯を維持しながら、継続利用の負担を下げたモデルと捉えられます。注目したいのは、キャッシュされた入力の料金です。GPT-6.1 Terraでは100万トークン当たり0.05ドルとなり、従来料金の4分の1に下がりました。毎回同じ指示文や資料、業務ルールをモデルに渡すシステムでは、入力内容を再利用できるほどキャッシュ料金の低さが効いてきます。社内規程を参照する文書作成や、共通の商品情報を使う顧客対応など、定型の前提情報が大きい用途ほど検討価値が高まりそうです。
ただし、企業が負担する費用はトークン単価だけでは決まりません。回答の修正回数、処理時間、失敗時の再実行、人による確認といったコストも含めて評価する必要があります。安価なモデルでも、期待する品質に届かず何度も呼び出せば、最終的な業務コストは膨らみます。GPT-6.1 Terraの意味は、単に価格が下がったことではなく、一定の性能を必要とする業務で「1件を完了させるまでの費用」を引き下げられる可能性が示された点にあります。
モデル選定では、最高性能のモデルを全処理に割り当てる方法だけが正解ではありません。大量に発生する日常業務をTerraに任せ、例外的に難しい案件を上位モデルへ振り分ける構成も考えられます。今回の料金設定は、生成AIの調達基準をモデル単体の順位から、実際の仕事量と完了コストへ移すきっかけになるでしょう。
ベンチマークが示す費用対効果と読み方
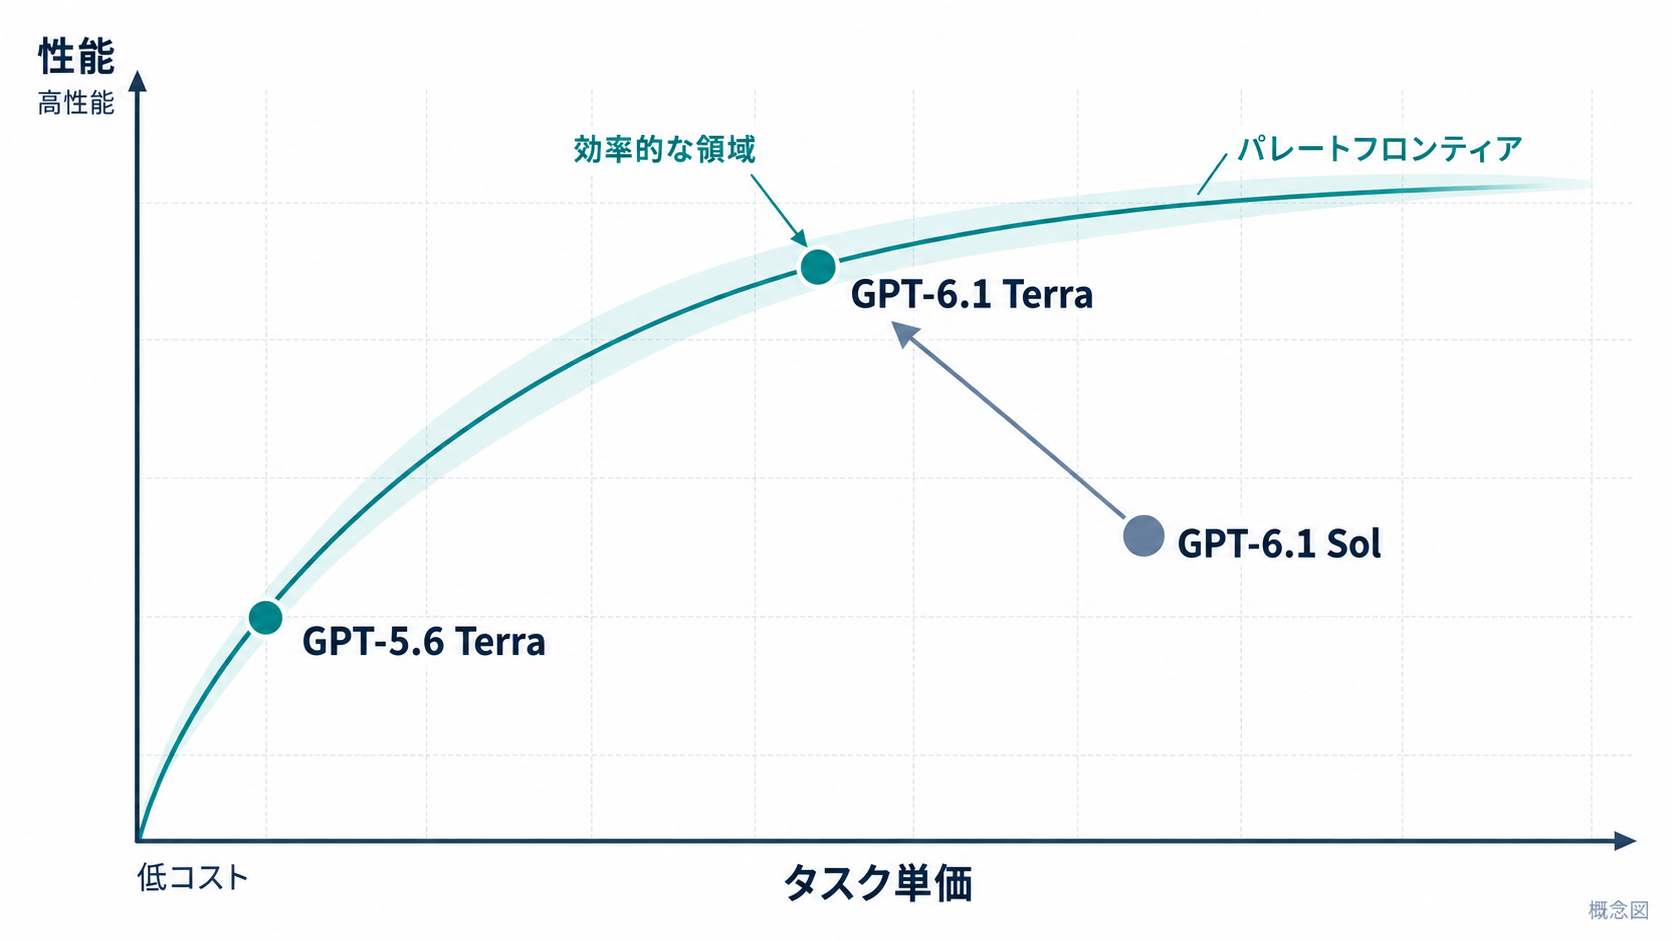
モデル評価サービスのArtificial Analysisは、GPT-6.1 Terraを「1ドル当たりの知能」という観点で新たな基準になるモデルと評価しています。同社のIntelligence Indexでは、最大推論設定のスコアが48となり、GPT-6.1 Solの52には届かないものの、GPT-5.6 Terraの42を上回りました。最上位の性能ではなく、上位モデルに近い能力を低価格で提供する位置づけです。最大推論設定では、GPT-5.6 TerraよりIntelligence Indexが6ポイント高い一方、1タスク当たりの推定コストは1.40ドルから0.40ドルへ低下しました。低い推論設定では差が7~13ポイントに広がり、Artificial AnalysisはTerraをパレートフロンティア上に位置づけています。これは、比較対象の中で、コストを増やさずに性能だけを上げることも、性能を落とさずにコストだけを下げることも難しい効率的な地点を意味します。
この結果は、推論を長く続ければ常に得になるという考え方にも修正を迫ります。見積書のたたき台や定型フォームの入力など、必要な精度を低い推論設定で満たせる仕事では、設定を抑えたTerraの費用対効果が高くなる可能性があります。複雑な判断を伴う仕事だけ推論量を増やす運用にすれば、性能と予算を細かく調整できます。
もっとも、総合指数は複数の試験結果をまとめた指標であり、自社業務の成功率を直接保証するものではありません。ベンチマークの問題形式、採点方法、推論設定が変われば評価も動きます。導入判断では、候補モデルを同じ指示、同じ資料、同じ合格基準で試し、正答率だけでなく処理時間や再作業まで記録することが欠かせません。公開スコアは候補を絞る材料として使い、最後は実務データで確かめるのが妥当です。
PC操作と視覚理解を一つの業務フローへ
OpenAIはGPT-6.1 Terraの特徴として、高速な視覚推論、精密なコンピューター操作、自然な文章表現を挙げています。想定される仕事は、提案書の作成、技術図面の読み取り、フォームへの入力などです。文章を返すだけではなく、画面や図を読み、ソフトウェアを操作して作業を進めるモデルとして設計されていることが分かります。コンピューター操作能力を測るAgents' Last Examでは、GPT-6 Astraと同等の性能を、10分の1のトークン価格で達成したとされています。最大推論設定のClaude Opus 5.5との比較では、トークン効率が3倍以上、トークン価格は4分の1で、1タスク当たりの費用はおよそ9分の1になりました。OpenAIによれば、処理の完了速度もGPT-6 AstraとGPT-6.1 Solの双方より3倍以上速いといいます。
視覚推論のMMMU-Proでは、すべての推論設定でGPT-5.6 Terraを上回り、GPT-6 AstraとGPT-6.1 Solに近い結果を残しました。デスクトップ操作を評価するOSWorld 2.1でも、中程度の推論設定で旧Terraの最高結果を超えながら、費用を抑えています。図面や画面を読み取って次の操作につなげる業務では、速度と単価の両方が導入範囲を左右するため、この組み合わせは実務上の強みになり得ます。
とはいえ、ベンチマーク上の操作成功と、社内システムを安全に扱えることは別問題です。画面構成の変更、権限不足、予期しない確認画面など、実環境には試験に含まれない例外が生じます。初期導入では読み取り専用の作業や、送信直前に人が承認できる工程から始めると評価しやすいでしょう。自動操作を採用する価値は、人のクリック数を減らすことだけでなく、作業の途中経過を追跡できる形で完了までつなげられるかどうかで決まります。
コーディング性能の伸長と上位モデルとの役割分担
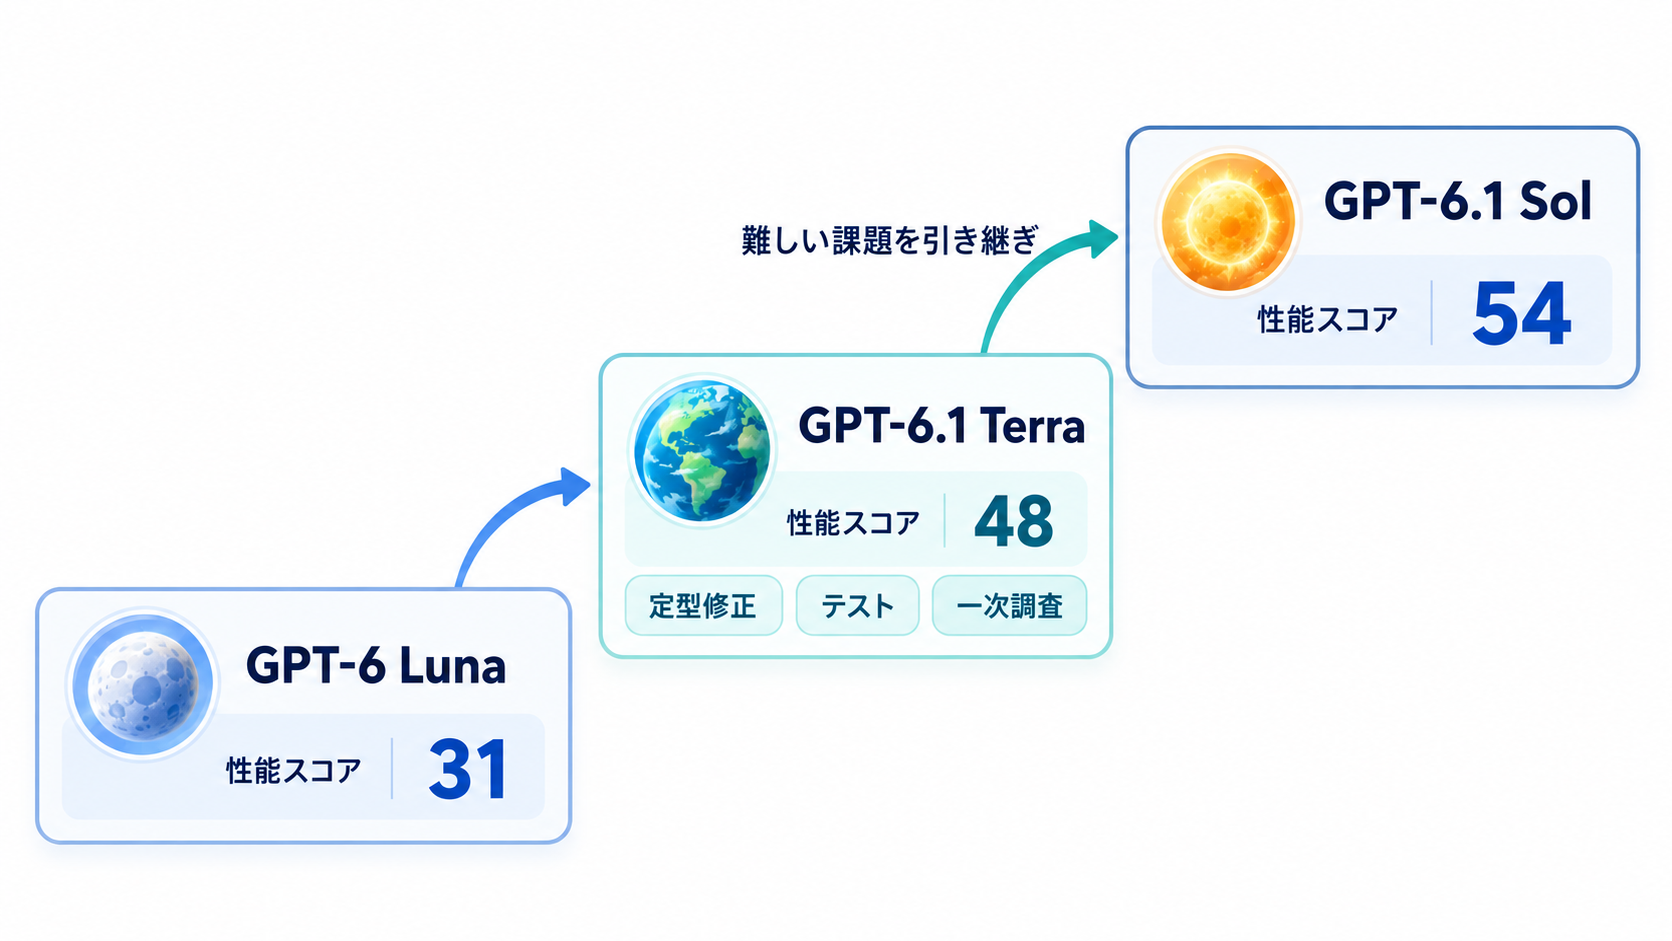
Artificial AnalysisのCoding Agent Index v2.0で、GPT-6.1 Terraは48を記録しました。GPT-6.1 Solの54より6ポイント低いものの、GPT-6 Lunaの31を17ポイント上回っています。価格を抑えたモデルでありながら、コーディングエージェントとしては上位モデルに近い領域へ入ったことを示す結果です。ターミナル上での実務的な課題を扱うTerminal-Bench 4.0では、最大推論設定で50.3%のタスクを解決しました。GPT-5.6 Terraの21.5%から大幅に改善し、Artificial AnalysisはGPT-6.1 Solと同じ性能帯に達したと評価しています。コードの断片を生成するだけでなく、コマンドを実行し、結果を確認しながら問題を解く能力が強化されたと読み取れます。
科学分野のコーディング課題を測るTerminal-Bench-Science 0.1では、GPT-6.1 Solをより低いコストで上回りました。Claude Opus 5.5との差も5ポイント以内で、推定費用は5分の1未満とされています。研究支援やデータ処理のように、試行を重ねるほどAPI利用量が増える用途では、1回当たりの価格差がプロジェクト全体の実行可能性に影響するでしょう。
すべての開発作業をTerraに置き換えられるわけではありません。OpenAIは、特に難度の高いコーディングにはGPT-6.1 SolとGPT-6 Astraを推奨しています。企業での現実的な使い方は、テスト作成、定型的な修正、調査、一次レビューなどをTerraに割り当て、複雑な設計判断や解決できなかった課題を上位モデルへ引き継ぐ形です。単一モデルを選ぶよりも、難易度に応じた経路を設けたほうが、費用を抑えながら必要な品質を守りやすくなります。
「分からないときに推測しない」能力の改善
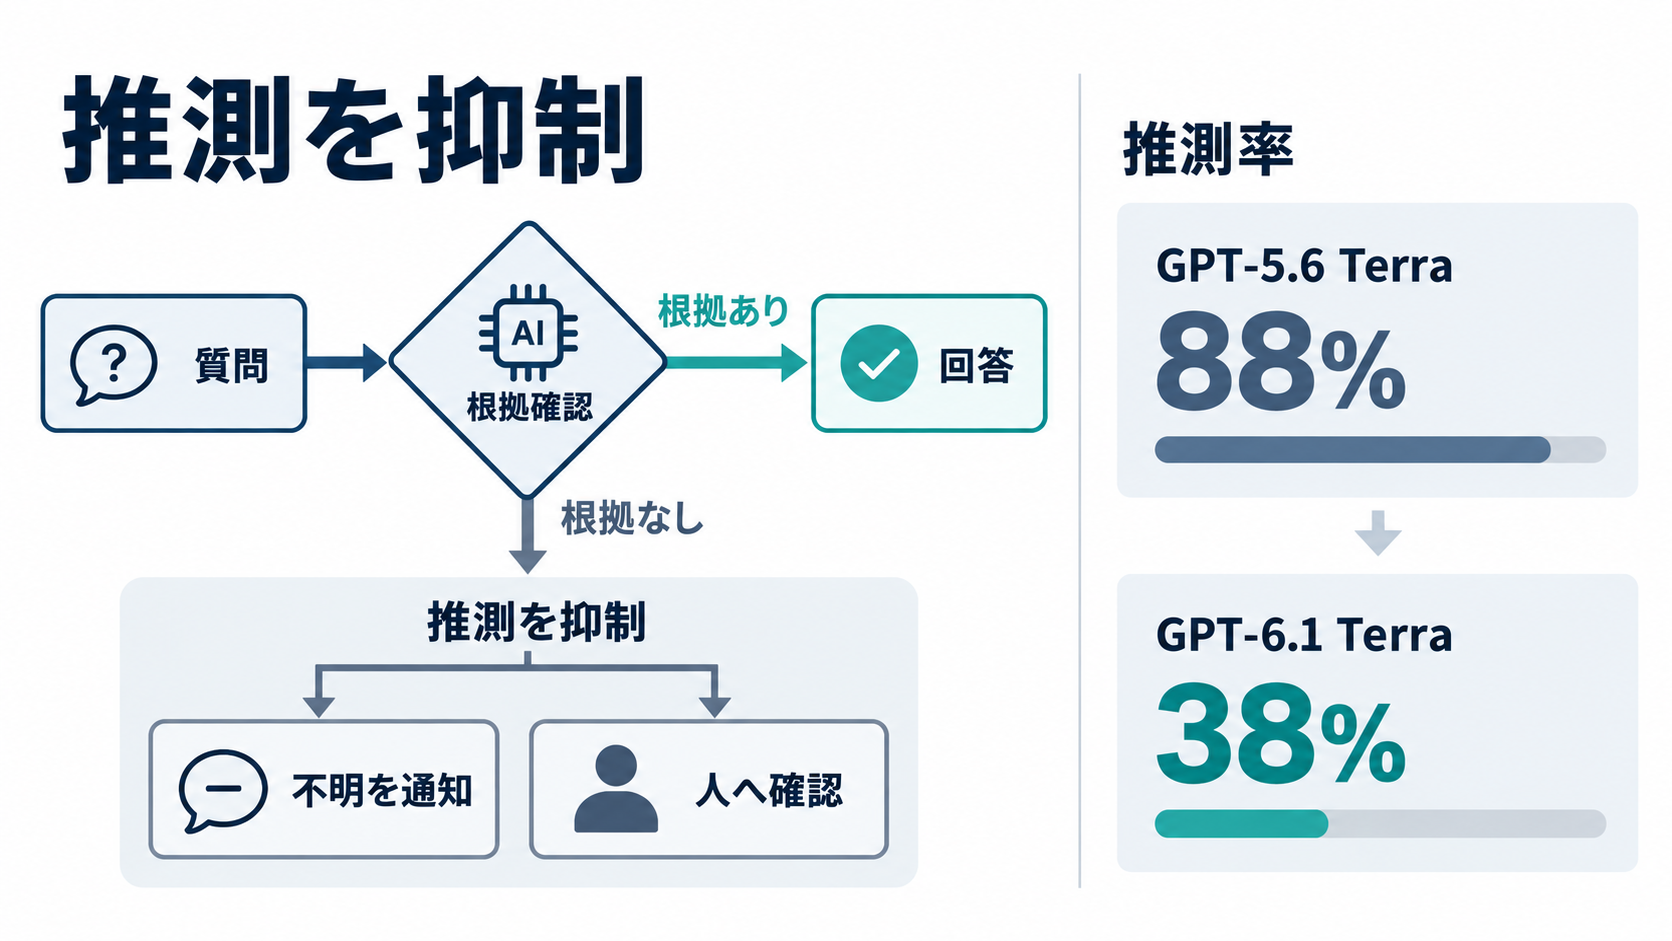
生成AIを業務に組み込む際には、正答できる範囲の広さだけでなく、答えを持たない場面でどう振る舞うかが問題になります。Artificial Analysisの非公開ベンチマークAA-Omniscienceでは、GPT-6.1 Terraが答えを知らない場合に推測へ頼った割合は38%でした。GPT-5.6 Terraの88%から大きく低下し、正確性も2ポイント上昇しています。これは、回答量を増やすことより、不確実な状況で無理に断定しない方向へ改善したことを示します。社内規程、契約情報、製品仕様などを扱う業務では、流暢でも誤った回答が混ざると確認負担が増えます。分からないことを明示し、人や別の情報源へ処理を渡せるモデルであれば、誤りの発見が遅れるリスクを抑えやすくなるでしょう。
ただし、38%という数値は推測がなくなったことを意味しません。また、非公開ベンチマークであるため、問題の分野や採点条件が自社の利用環境と一致するとは限りません。企業側では、出典の提示を求める、回答と参照資料を同時に表示する、不明な場合の定型応答を指示するなど、モデル以外の仕組みも組み合わせる必要があります。重要な決定に使う出力については、人による確認を残すべきです。
検証時には正解率だけでなく、誤答の性質を分類すると運用設計に役立ちます。情報がないのに作り出したのか、資料を読み違えたのか、指示の条件を落としたのかによって対策が変わるためです。GPT-6.1 Terraの改善を生かせるかどうかは、「不明」と答えた後の引き継ぎ先まで業務フローに組み込めるかにかかっています。
「Critical」区分と企業が確認すべき防御範囲
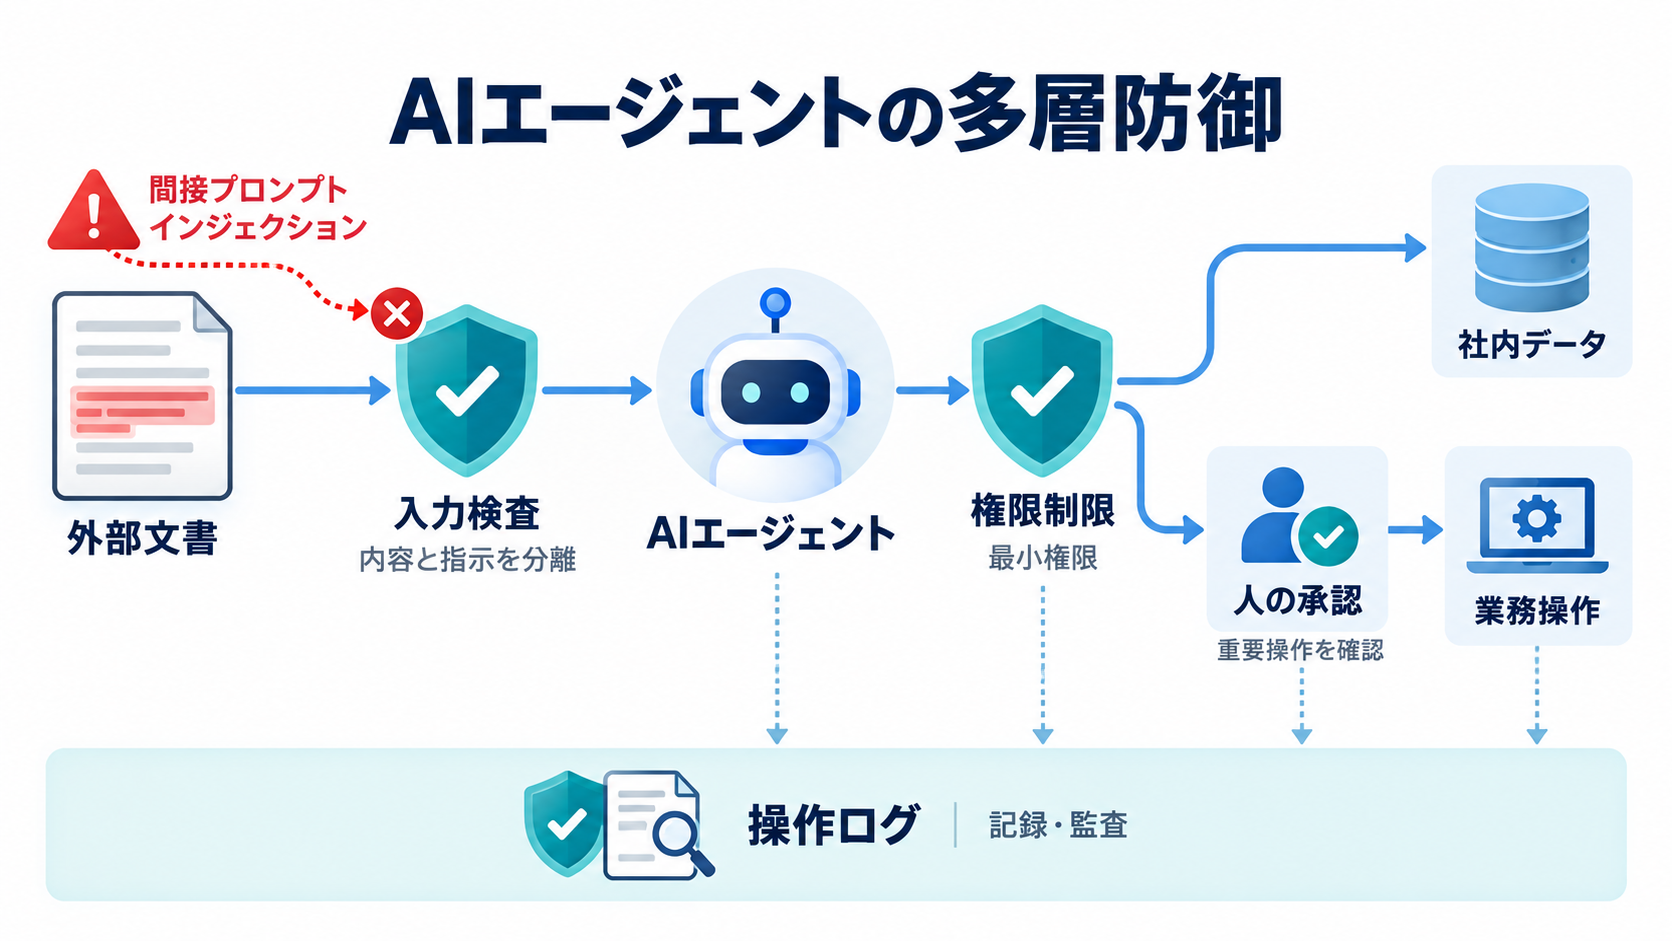
GPT-6.1 Terraは、OpenAIのPreparedness Frameworkで定めるサイバーセキュリティ上の「Critical」しきい値に該当し、GPT-6 Astraの安全対策を引き継いでいます。この表現は、モデルが無条件に安全であるという認証ではありません。高い能力に応じた安全管理が必要になる区分として受け止め、利用者側の統制と併せて評価する必要があります。OpenAIのシステムカードによると、GPT-6.1 Terraは指示階層を直接狙う攻撃に対して、GPT-6 AstraやGPT-6.1 Solと同程度の耐性を示しました。これらのモデルは同種の試験で99.99%に達しています。外部コンテンツに悪意のある指示を紛れ込ませる間接プロンプトインジェクションへの防御率は98.8%で、GPT-5.6 Terraの96.2%から向上しました。
間接プロンプトインジェクションは、AIがWebページ、文書、メールなどを読み取る運用で問題になります。第三者が埋め込んだ命令を正規の業務指示と誤認すると、本来参照するだけの情報によって動作が変えられる恐れがあります。防御率の向上は好材料ですが、98.8%は失敗の可能性が残る数値でもあります。アクセス権を必要最小限にし、外部への送信やデータ更新には確認工程を設ける考え方は変わりません。
旧モデルとの比較では、割り当てられた境界内にとどまり、制限を利用者へ説明する傾向も強まったとされています。企業にとっては、拒否の少なさだけを追うより、拒否が必要な場面で理由を示し、適切に停止できることが重要です。導入前には通常業務のテストに加え、機密情報の要求、権限外操作、外部文書に含まれる命令などを試し、どの地点で人の承認を必須にするか決めておくべきでしょう。
日本企業が小規模検証で確かめるべき採算ライン
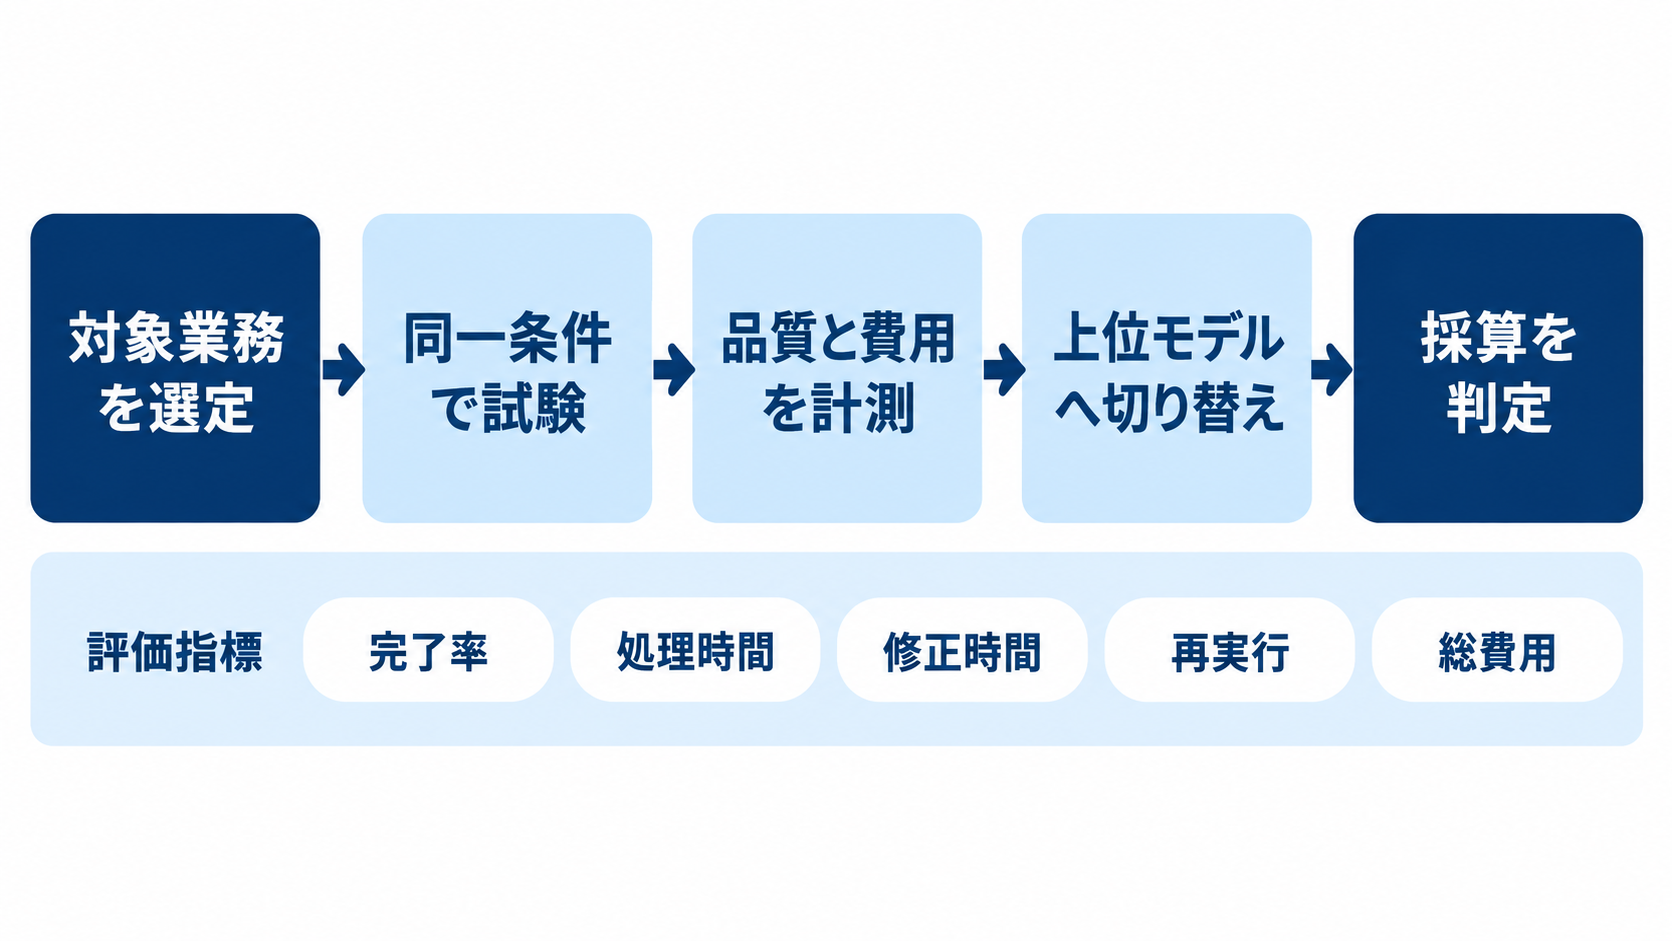
GPT-6.1 Terraは、ChatGPT WorkとCodexではPlus、Pro、Enterprise、Eduの利用者に提供され、APIからも利用できます。企業が検討を始める際は、用途を広く掲げるより、処理件数が多く、合否を判定しやすい一つの業務を選ぶほうが適性を見極めやすくなります。提案書の下書き、図面からの情報抽出、フォーム入力、定型的なコード修正などが、今回示された能力と対応する候補です。検証では、APIのトークン料金だけでなく、タスク完了率、処理時間、人による修正時間、再実行回数を同時に記録します。キャッシュ入力を使える業務なら、共通指示や固定資料を分離し、通常入力との費用差も確認するとよいでしょう。最大推論設定だけを比べず、低・中・最大の各設定で必要品質を満たす最小構成を探すことが、Terraの価格面の強みを引き出します。
運用候補は、すべてを自動化できる仕事に限りません。Terraが下書きや操作案を作り、人が承認して実行する半自動の構成でも、作業時間を減らせる可能性があります。失敗時に上位モデルへ切り替える条件を定めれば、通常案件の単価を抑えながら、難しい案件に必要な能力を確保できます。切り替え条件には、モデル自身の不確実性だけでなく、必須項目の欠落やテスト不合格など、外部から判定できる基準を使うのが現実的です。
安全面では、モデルの防御機能だけに依存せず、閲覧可能な情報、実行可能な操作、出力先を用途ごとに制限します。外部文書を読み込むエージェントには更新権限を与えない、送信操作には承認を求めるといった分離が考えられます。ログを残し、拒否や誤操作も含めて評価すれば、導入後に統制を見直す材料になります。
次の一歩は、最上位モデルとの抽象的な性能比較ではなく、自社の代表的な50件や100件程度の作業を同じ条件で処理し、1件を合格状態まで仕上げる総費用を測ることです。GPT-6.1 Terraが示した半額という数字を、修正時間まで含む自社の採算へ置き換えられれば、採用する業務と上位モデルへ残す業務を具体的に判断できます。