
AI LAB
2026/10/26
IEEEが「速さより検証可能性」を選択、査読文献に基づくAI研究支援ツールを提供
研究用AIに求められる「答えを確かめられる設計」
技術者が生成AIに専門的な質問をすると、整った文章が数秒で返ってきます。しかし、製品設計や研究開発の判断に使う場面では、読みやすさだけでは足りません。回答の根拠となった論文は何か、その論文に本当に同じ内容が書かれているか、引用の文脈は適切かまで確認できなければ、業務上のリスクが残るためです。IEEE(米国電気電子学会)が発表した「IEEE Xplore AI Research Suite」は、この問題に対して「答えを信じてもらうのではなく、根拠を検証できるようにする」という方針を打ち出しています。IEEE Xplore Digital Libraryに収録された数百万件の査読済み文献の全文を基盤とし、検索結果からAIによる概要を作成します。対象にはIEEEの学術誌、雑誌、国際会議論文などが含まれ、デジタルライブラリー自体では標準規格も提供されています。
中心にあるのは、生成AIの回答速度を競う発想ではありません。科学的な情報源へ検索範囲を限定し、回答から参照文献へ戻れる経路を用意することです。IEEE Publication Services and Products担当バイスプレジデントのW・クレム・カール氏は、AIが発見の加速や意思決定、新たな関連性の把握に役立つ半面、もっともらしい誤情報や偏りを持ち込む危険があると説明しています。
この考え方は、企業の研究開発にも直結します。生成AIの文章を最終成果物として扱うのではなく、調査の入口や論点整理として活用し、担当者が根拠まで追跡する運用です。IEEE Xplore AI Research Suiteは、AIの流暢さではなく、確認可能な調査プロセスそのものを製品価値として提示したサービスと捉えられます。なお、利用形態はIEEE Xplore Digital Libraryを契約する機関向けの追加サブスクリプションです。
キーワード検索を対話型の調査へ変える機能
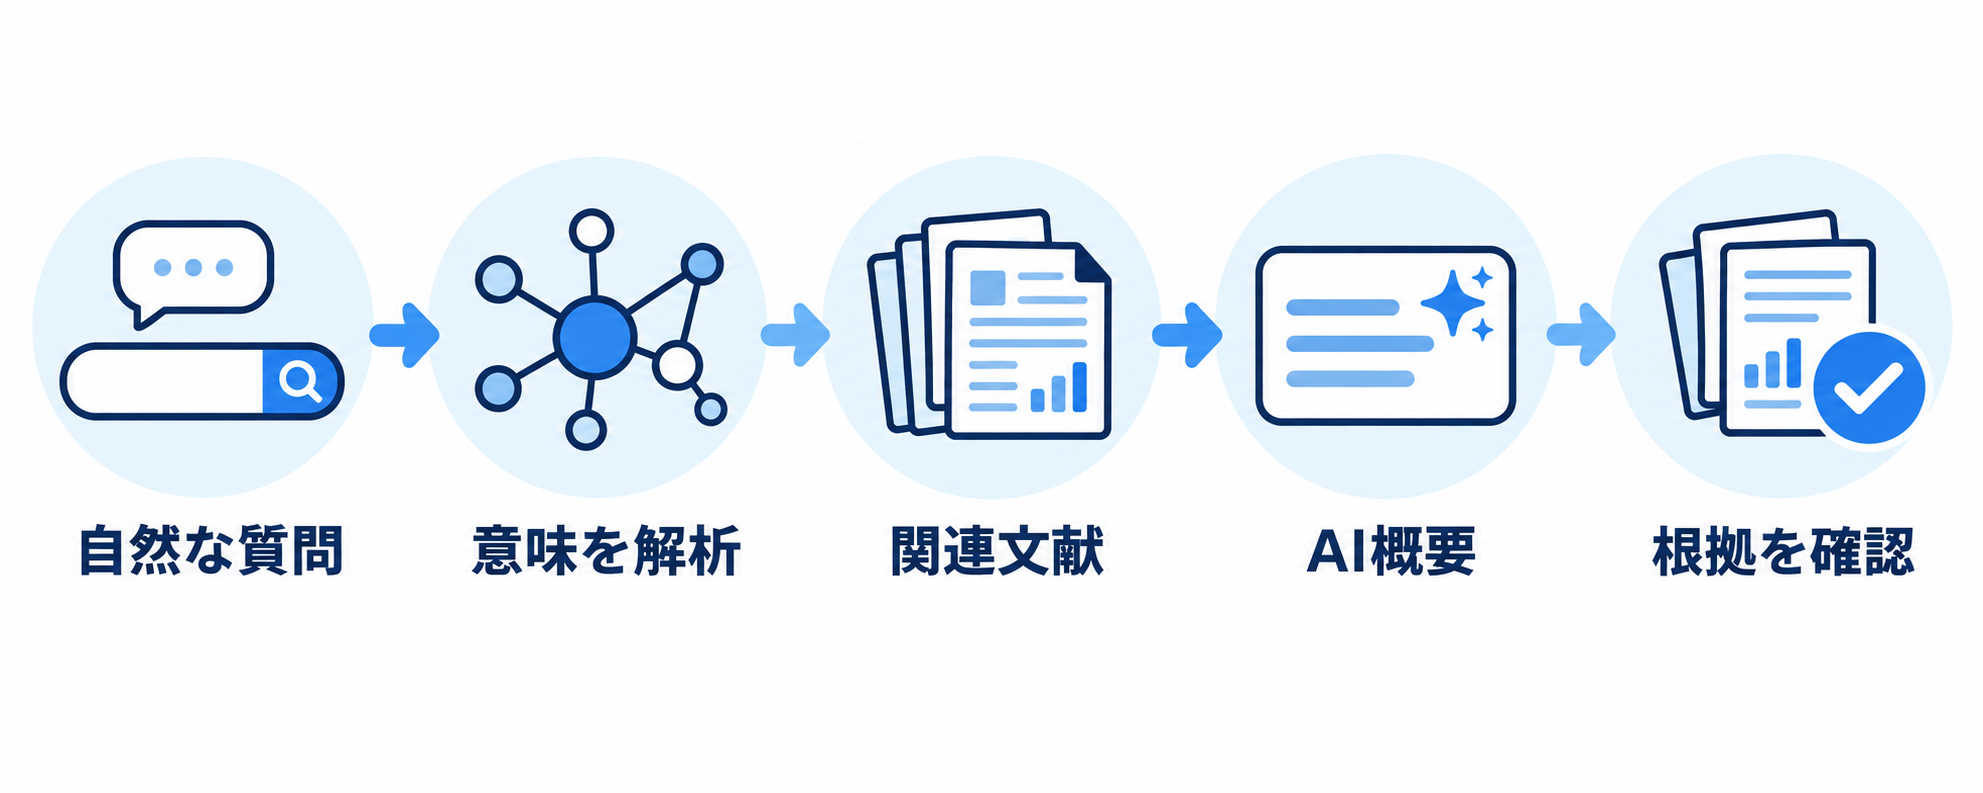
従来の文献検索では、研究者が適切な検索語を予測し、表記揺れや専門分野ごとの用語差を考慮しながら検索式を組み立てる必要があります。検索語が論文で使われている表現とずれていれば、内容が近い文献でも候補から漏れかねません。新しい分野へ調査範囲を広げるときほど、何を検索語にすべきか分からないという矛盾も生じます。IEEE Xplore AI Research Suiteのセマンティック検索では、単語の一致だけでなく、入力された内容の意味を手掛かりに関連文献を探します。利用者は自然な文章で質問できるほか、長い文章を貼り付けて、内容の近い研究や異なる解決策を探索できます。たとえば、開発中の技術課題を文章で記述し、それと意味的に関連する研究を探すといった使い方が想定されます。
検索結果にはAIが生成した概要が表示され、専門用語については文脈に沿った定義も確認できます。未知の領域を調べる際、候補論文を一件ずつ開いて冒頭から読む前に、研究テーマとの関係や主要な概念を把握できる設計です。概要だけで調査を完結させる機能というより、読むべき文献を絞り込み、本文理解までの助走を短くする役割が中心でしょう。
企業での利用を考えると、研究者だけでなく、技術企画、知財、標準化、技術調査を担当する部門にも接点があります。ただし、自然言語で検索できることと、質問が曖昧でも適切な判断が得られることは同じではありません。対象技術、用途、制約条件、比較したい方式などを具体的に入力し、提示された文献を人が確認する運用が欠かせません。操作のハードルは下がっても、問いを設計する力と証拠を読む力は引き続き利用者に求められます。
全文とメタデータを組み合わせる理由
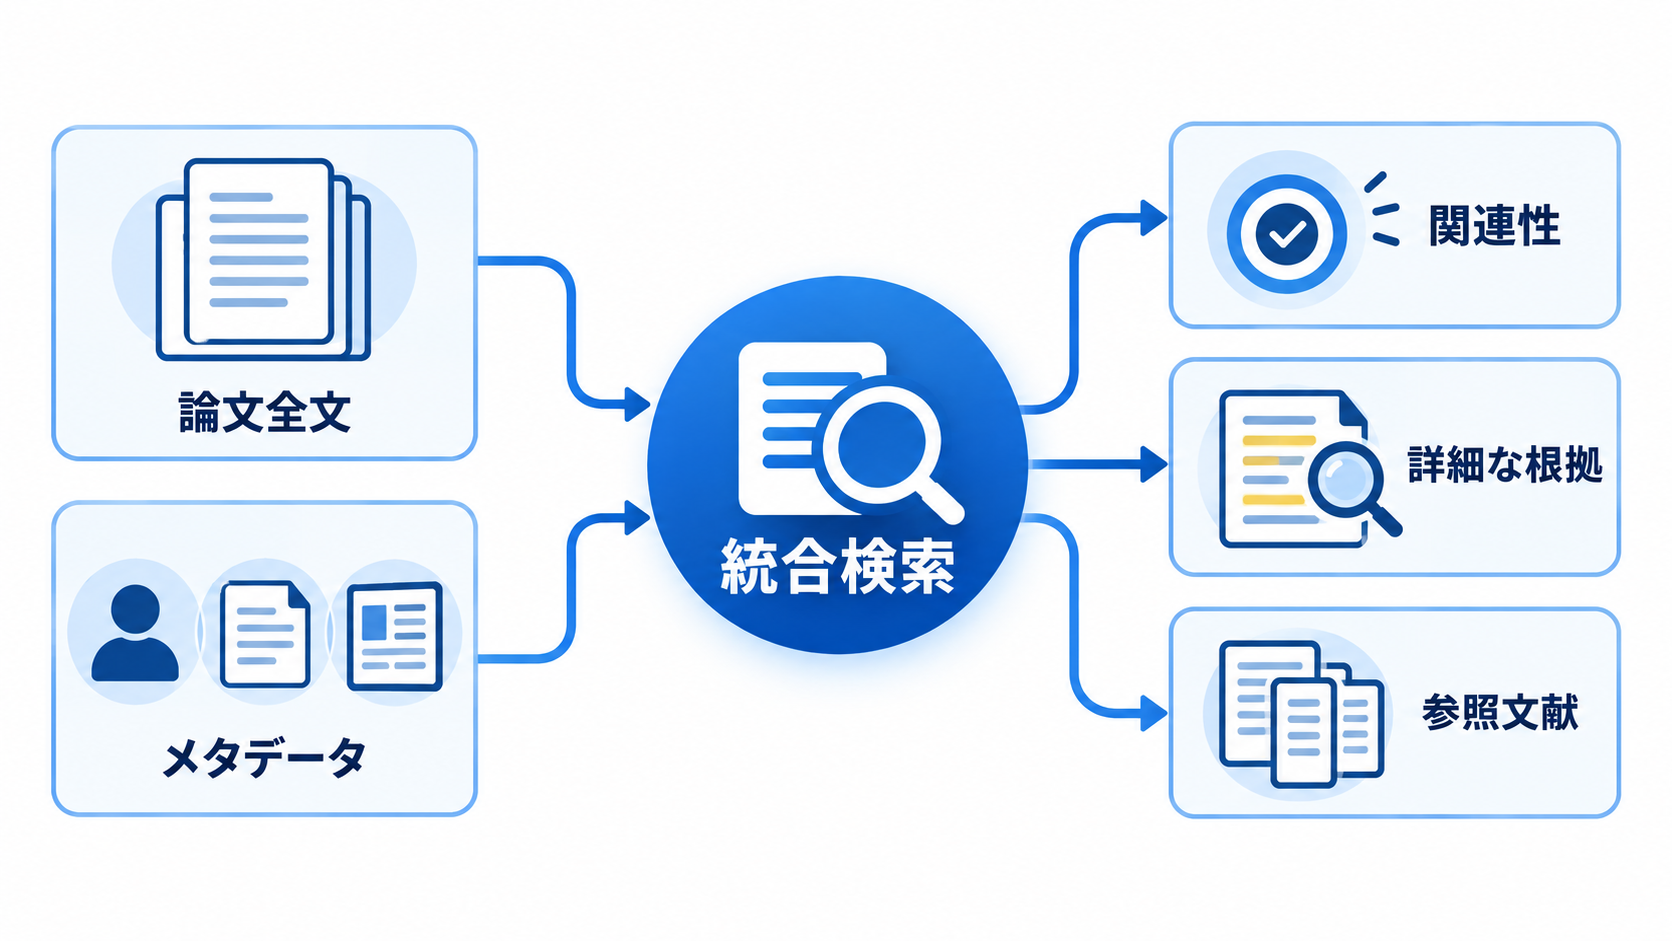
学術情報を扱うAIでは、どの範囲の情報を検索できるかが回答品質を左右します。論文の要旨は研究目的や主な結果を短く把握するには便利ですが、実験条件、手法の限界、比較対象、例外、考察の細部まで収められているとは限りません。要旨だけを根拠にすると、似た研究を探せても、利用者の細かな質問に必要な記述へ届かない場合があります。IEEEは、同スイートが査読済みの学術誌論文と国際会議論文について、要旨だけでなく全文とメタデータの両方を利用する点を特徴に挙げています。メタデータは、題名、著者、掲載媒体など、文献を識別・整理するための情報です。全文が技術内容の詳細を提供し、メタデータが文献同士の整理や検索結果の関連付けを支えるという補完関係になります。
同社内の評価では、主要なすべての評価指標において、結果の品質と正確性が3倍になったと報告されています。ただし、これはIEEEによる内部テストの結果であり、評価データの構成、比較対象、指標ごとの算出方法などは今回公表された情報だけでは判断できません。「3倍」という数値を一般的な生成AIとの絶対的な性能差として受け取るよりも、全文を検索対象に含めることが技術調査に有効だったという説明として読むのが適切です。
IEEEは、全文とメタデータの双方を自社の査読済みコンテンツから利用するAI研究アシスタントは同スイートだけだと説明しています。この主張が示す競争軸は、モデルの規模よりも、アクセスできる資料の質と粒度です。企業が研究支援AIを比較する際にも、画面上の回答だけでなく、全文を参照しているのか、要旨に限られるのか、収録範囲に不要な情報が混在していないかを確認する必要があります。
ハルシネーションを抑える検索範囲と停止条件
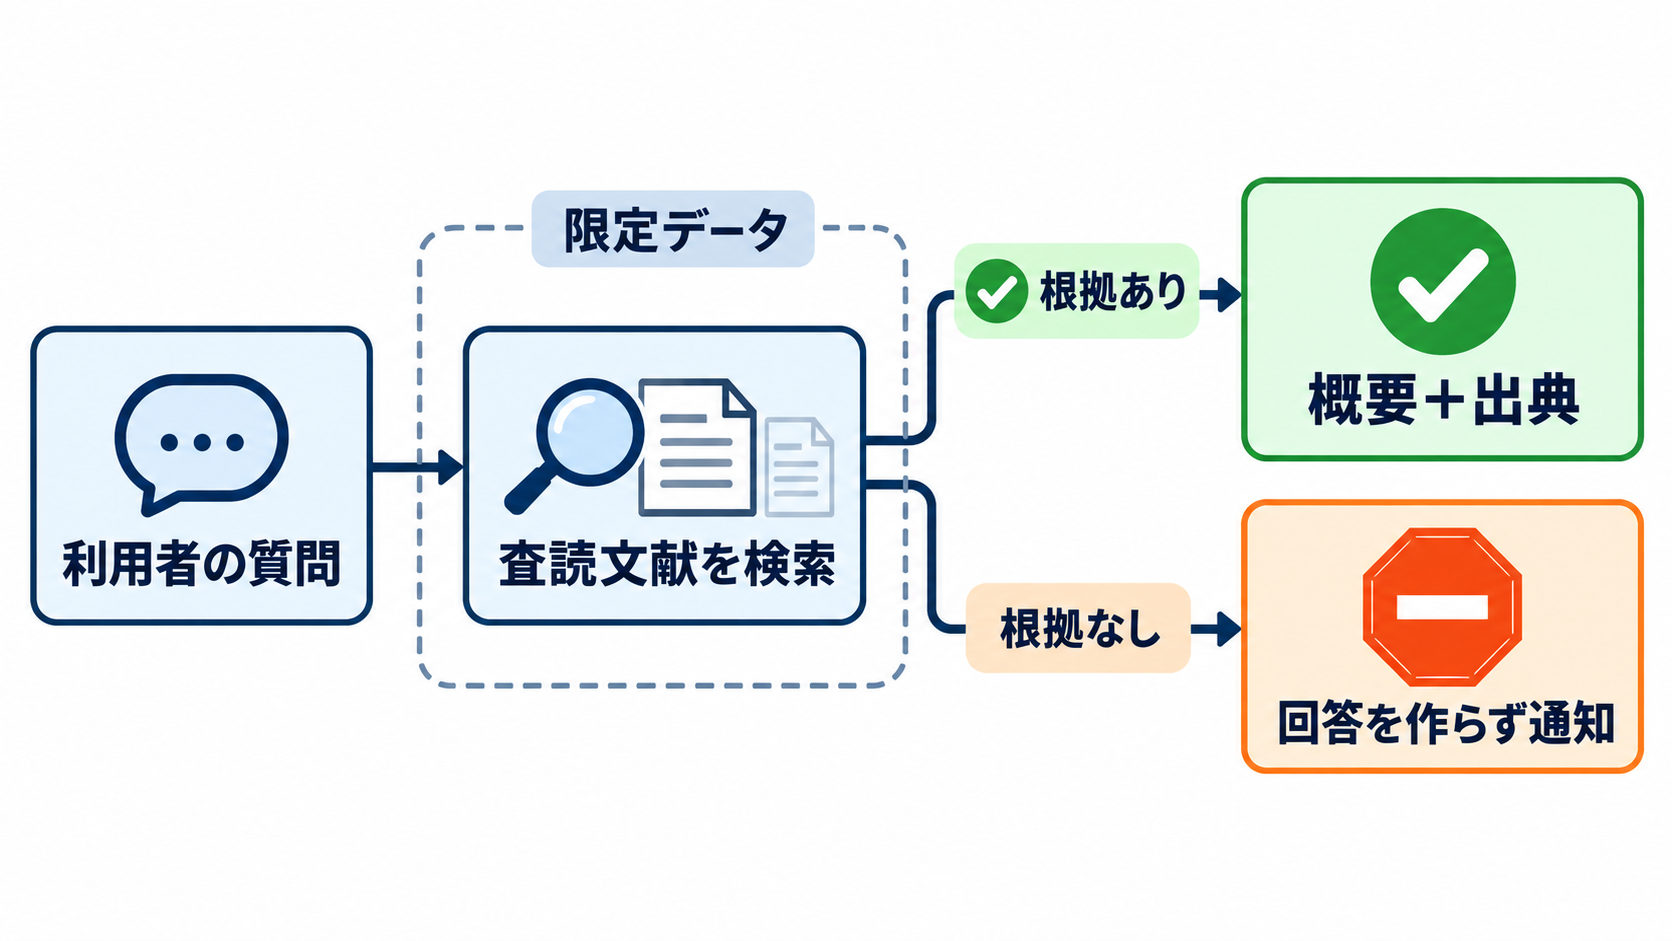
生成AIのハルシネーションとは、根拠がないにもかかわらず、事実らしい文章や存在しない引用を生成する現象です。技術調査では、一つの誤った数値や架空の出典が、実験計画、製品仕様、投資判断に影響する可能性があります。文章が自然であるほど誤りを見抜きにくいため、利用者の注意だけに依存する対策には限界があります。IEEE Xplore AI Research Suiteでは、検索・取得の対象をIEEEが保有する数百万件の査読済み全文文献と、専門家が整理したSTEM分野のメタデータに限定しています。STEMは科学、技術、工学、数学の総称です。公開ウェブ全体から回答材料を集める方式と比べると対象範囲は狭くなりますが、出所が明確な科学技術情報へ集中できるため、業務で検証しやすい結果につながります。
注目すべき点は、関連する科学的情報を定められたデータセット内で見つけられない場合、回答を作り上げず、情報を確認できなかったと利用者へ伝える設計です。一般的な対話サービスでは、何かを答えることが期待されがちですが、研究用途では「分からない」と停止することも品質の一部になります。回答不能を失敗として隠さず、調査範囲の限界として示す考え方です。
AIが生成する概要には参照文献へのリンクが付き、利用者は情報を照合できます。ただし、検索対象を限定しても、誤解や要約時の欠落が完全になくなるわけではありません。また、IEEEの収録範囲外に重要な研究が存在する可能性もあります。企業が導入するなら、引用先の本文確認、他の学術データベースとの横断調査、重要な判断に対する専門家レビューを手順に組み込むべきです。同スイートの安全策は検証を不要にするものではなく、検証可能な状態へ利用者を導く仕組みと考えるのが妥当でしょう。
3,000人超の検証参加者が支えた開発プロセス
研究支援ツールは、検索精度が高いだけでは定着しません。研究者がどの段階で行き詰まり、司書や情報担当者がどのように資料へのアクセスを支え、組織がどの単位で利用状況を管理するかまで理解する必要があります。学術情報には分野ごとの慣習もあるため、一般的な文章生成サービスの操作方法をそのまま持ち込んでも、実務の流れに合わない可能性があります。IEEEは、世界各地の科学者や図書館関係者と協力して同スイートを開発しました。開発は、利用者のニーズと既存のAI研究アシスタントが抱える課題を調べるところから始まり、エンジニア、科学者、図書館情報の専門家など3,000人を超えるテスト参加者がフィードバックを提供しています。その意見は、AIエンジンの改善と研究ワークフローへの対応に使われました。
図書館情報の専門家が参加している点には、企業利用を考えるうえでも意味があります。研究用データベースでは、検索結果の妥当性だけでなく、収録資料の整理、出典の追跡、契約範囲、利用者への調査支援といった要素が関係するためです。AIの導入を研究者個人の効率化だけで捉えず、情報基盤を運用する部門を含めて設計する姿勢が読み取れます。
もっとも、参加者数だけで製品の有効性を判断することはできません。どの分野や地域から参加したのか、フィードバックによって具体的に何が変わったのか、実運用でどの程度の時間短縮につながるのかは、現時点で詳しく示されていません。導入を検討する組織は、デモや試行利用を通じて、自社の研究テーマに関連する文献が十分に見つかるか、概要が専門家の判断に耐えるか、既存の文献管理手順と接続できるかを確かめる必要があります。
企業導入では「便利さ」より検証手順を先に決める
IEEE Xplore AI Research Suiteは、IEEE Xplore Digital Libraryを契約しているすべての機関が追加契約できるオプションとして提供されます。そのため、検討の起点は個人向け生成AIの代替ではなく、組織がすでに利用している学術情報基盤をどう拡張するかです。研究開発部門だけで選定せず、図書館・情報管理、知財、セキュリティ、調達など、文献利用と契約に関係する担当者を交えて評価した方がよいでしょう。導入前には、利用場面を具体的に区切る必要があります。先行研究の探索、未知の専門用語の把握、類似手法の比較候補づくりには適していますが、製品仕様の確定や安全性の証明をAIの概要だけで済ませるべきではありません。回答に参照リンクが付くという長所を生かし、「AIで候補を絞る」「担当者が本文を読む」「重要な判断は別の専門家が確認する」という役割分担を定めることが現実的です。
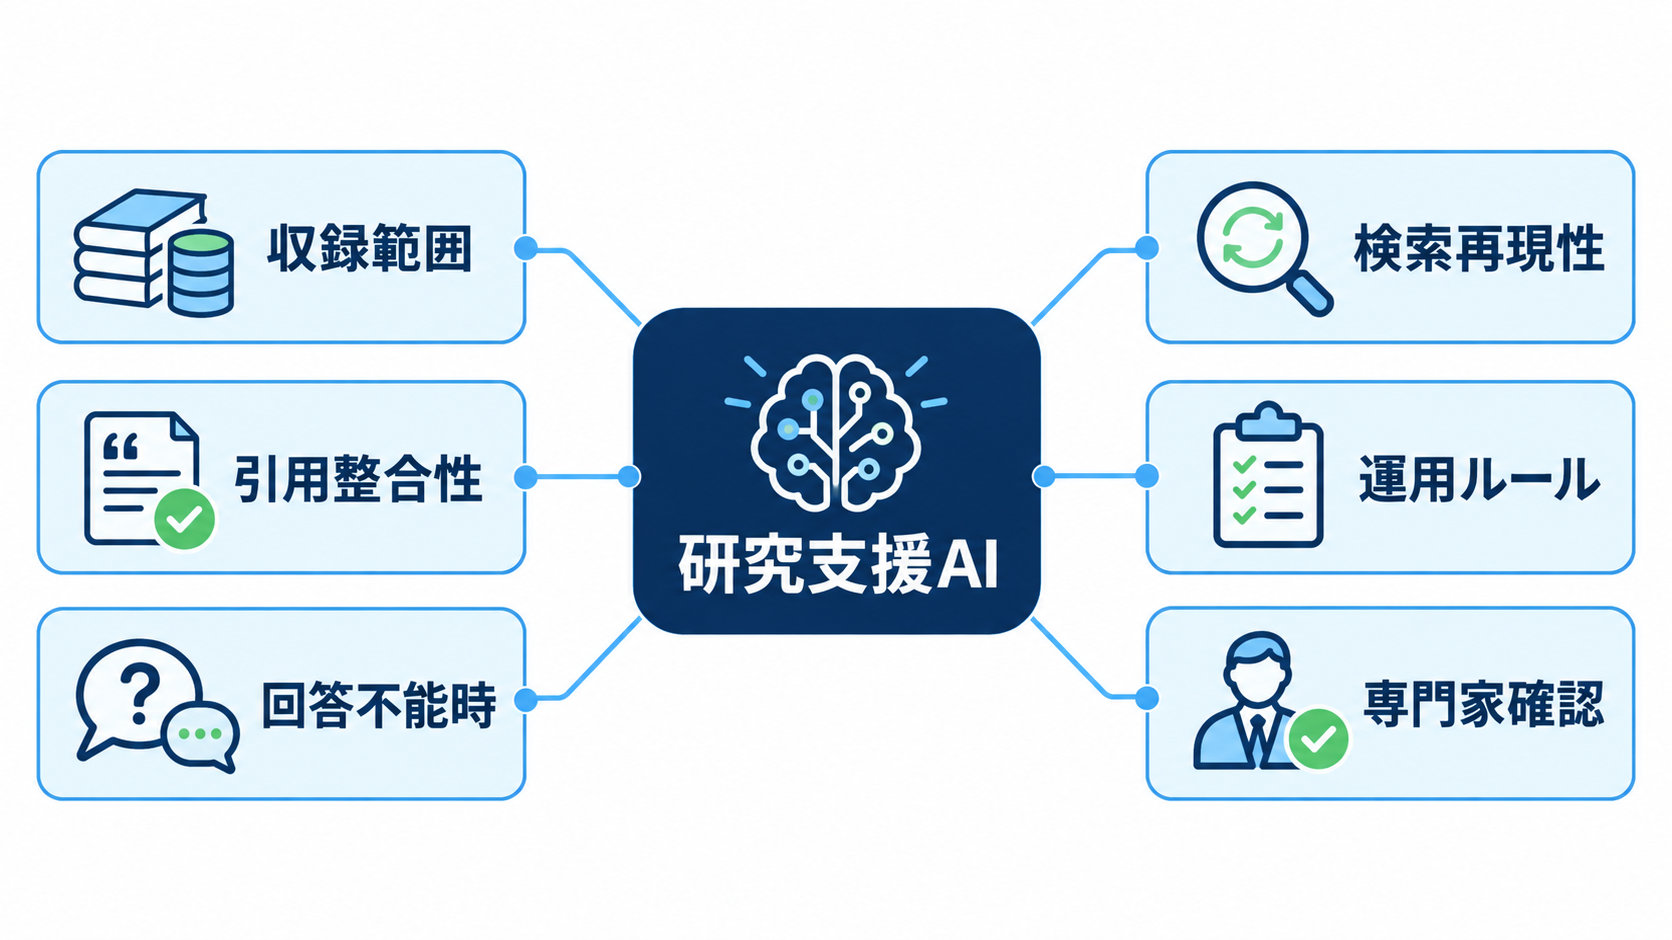
評価時には、少なくとも検索の再現性、引用先との整合性、回答不能時の挙動、対象分野の収録状況を確認したいところです。既知の論文を使って検索できるか試し、どのような質問で適切な候補へ到達するかを記録すれば、利用者向けの質問例も整備できます。AIの回答が誤っていた事例や、必要な文献を見落とした事例を共有する仕組みも、社内展開後の過信を抑える助けになります。
今回の発表が示しているのは、企業向け生成AIの価値が、回答を作る能力だけでは測れなくなっていることです。利用可能な情報の境界、根拠への導線、答えられない場合の動作まで含めて、業務プロセスとして評価する必要があります。IEEEのアプローチは、研究支援AIにおいて「何を知っているか」と同じくらい「何に基づいて答えたか」を重視する設計です。導入を検討する企業は、実際の調査課題を数件選び、従来の検索と同スイートを同じ条件で比較するところから始めると、時間短縮と検証負荷の両方を具体的に判断できるでしょう。