AI LAB
2026/09/15
Nuance Labsが5,000万ドルを調達、「話を聞く表情」まで応えるAIアバターを開発
会話のぎこちなさを「聞いている時間」から変える
画面越しの相手に話しかけても、話し終えるまで表情が変わらなければ、伝わっているのか不安になるものです。AIアバターとの会話では、回答の内容だけでなく、この「聞いている間の反応」が体験を左右します。米シアトルのスタートアップ、Nuance Labsが取り組むのは、発言を待って答えるだけではない、相手の話にその場で反応できるAIの開発です。同社は2026年9月14日、シリーズAで5,000万ドルを調達したと発表しました。シリーズAは一般に、初期の技術開発や事業の立ち上げを進める段階の資金調達です。今回のラウンドは、シード段階から支援してきたベンチャーキャピタルのLightspeed Venture Partnersが主導しました。既存投資家のAccelとSouth Park Commonsに加え、半導体大手のNvidiaと投資会社のDefine Venturesも参加しています。
開発の中心にあるのは、同社が「human foundation model」と呼ぶモデルです。ここでいう基盤モデルは、自然な対人会話を支える土台として位置づけられています。単に人間に似た顔を表示するのではなく、言葉に加えて視線や身ぶり、声の調子を受け取り、声と表情で応じることを目指しています。
企業にとっての注目点は、アバターの見た目の精巧さだけではありません。顧客が説明を続けている最中にも、理解を示す反応を返せるかどうかです。ただし、資金調達時点で製品は未発売です。今回の発表は、完成したサービスの提供開始ではなく、会話の作り方を変えるための開発資金を確保した段階と捉える必要があります。
音声と表情を順番に作る構成が生む待ち時間
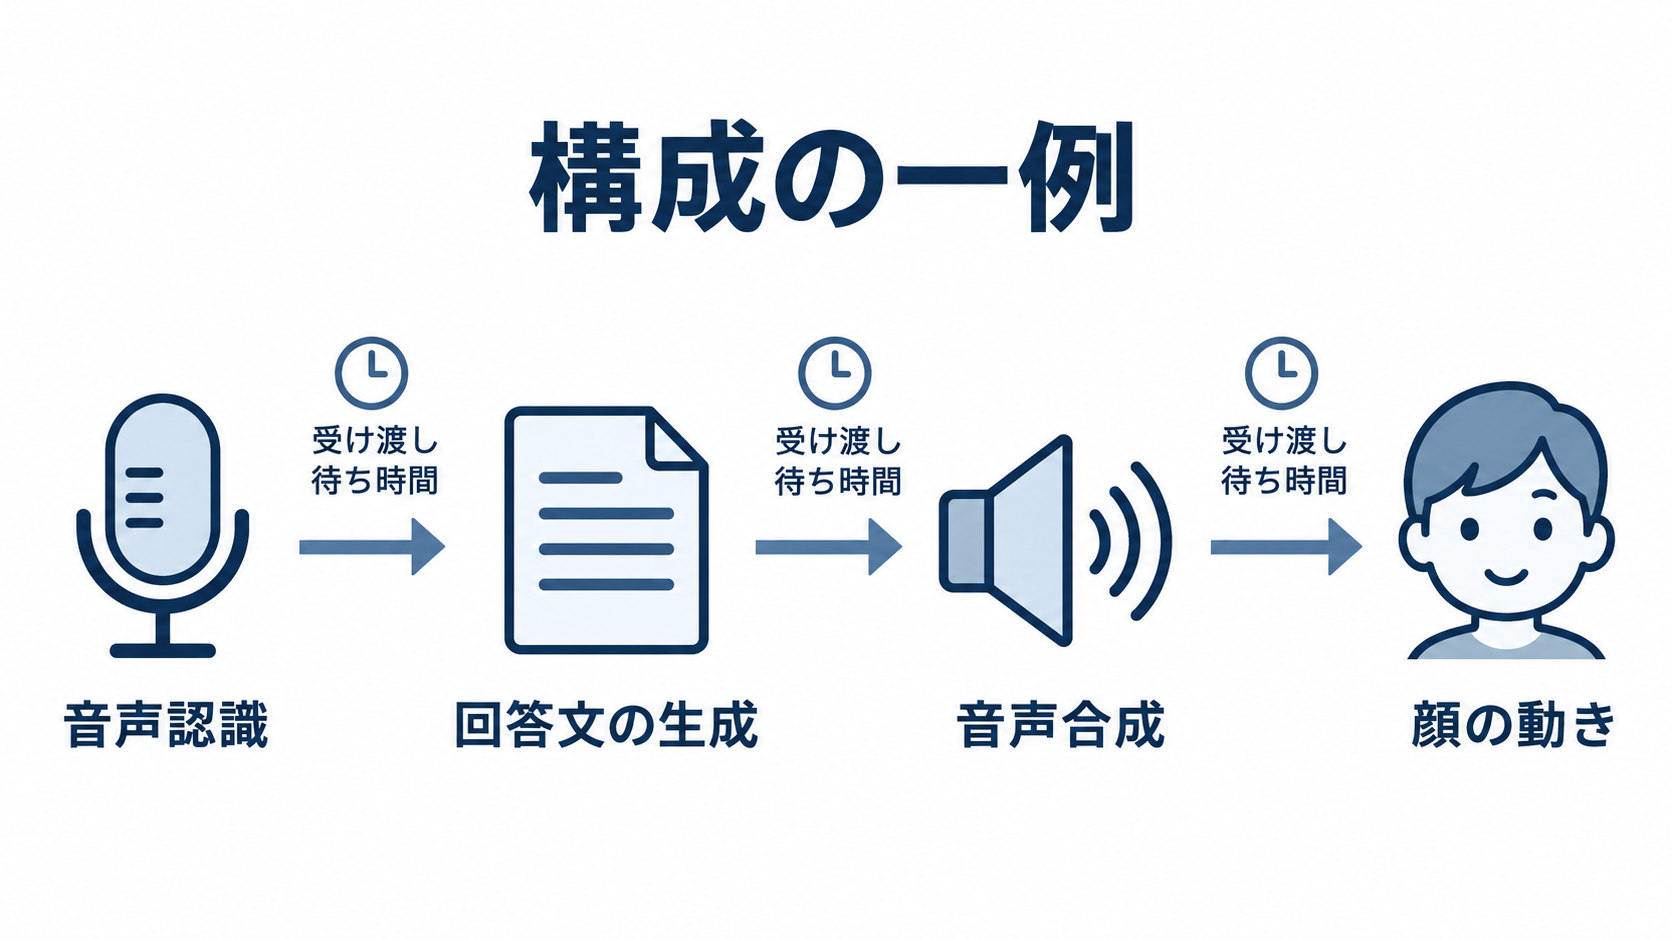
AIとの音声会話は、一つの仕組みで動いているように見えても、内部では複数のモデルが役割を分担している場合があります。Nuance Labsの共同創業者兼最高経営責任者で、かつてAppleでAI研究者を務めたFangchang Ma氏は、この分業と処理の受け渡しが、会話のぎこちなさにつながっていると説明しています。Ma氏が挙げる構成では、音声認識モデルが利用者の声を文字に変換し、大規模言語モデルがその文章への回答を作ります。その回答を音声合成モデルが読み上げることで、音声による応答が成立します。顔のあるAIアバターでは、発話に合わせて顔を動かす処理も必要です。各段階の結果を次の処理へ渡すため、順番に待つ時間が生じるという指摘です。
この説明は、既存のあらゆるシステムが同じ実装だという意味ではありません。Ma氏が問題視しているのは、会話を「入力を受け取り、回答を完成させてから返す」という流れで扱うと、人が聞きながら示す反応を作りにくい点です。同氏によると、既存のアバターには、相手が話している間に反応しないものや、会話の内容とは関係のない動きをするものがあります。
人同士の会話では、聞き手のうなずきや表情も、話し手が説明を続けるための手がかりになります。言葉としての回答を待たなくても、相手の反応を見ながら説明の速さや詳しさを調整できます。こうしたやり取りを再現するには、回答文の生成速度を上げるだけでは十分でないと考えられます。
そのため、企業が会話型AIを比較する際には、質問が終わってから回答が始まるまでの時間に加え、質問中にどのような反応を示すかも確認したいところです。待ち時間の短さと、聞き手としての自然さは、関連しながらも別の評価項目です。
音声と映像を同時に受け取り、同時に返す設計
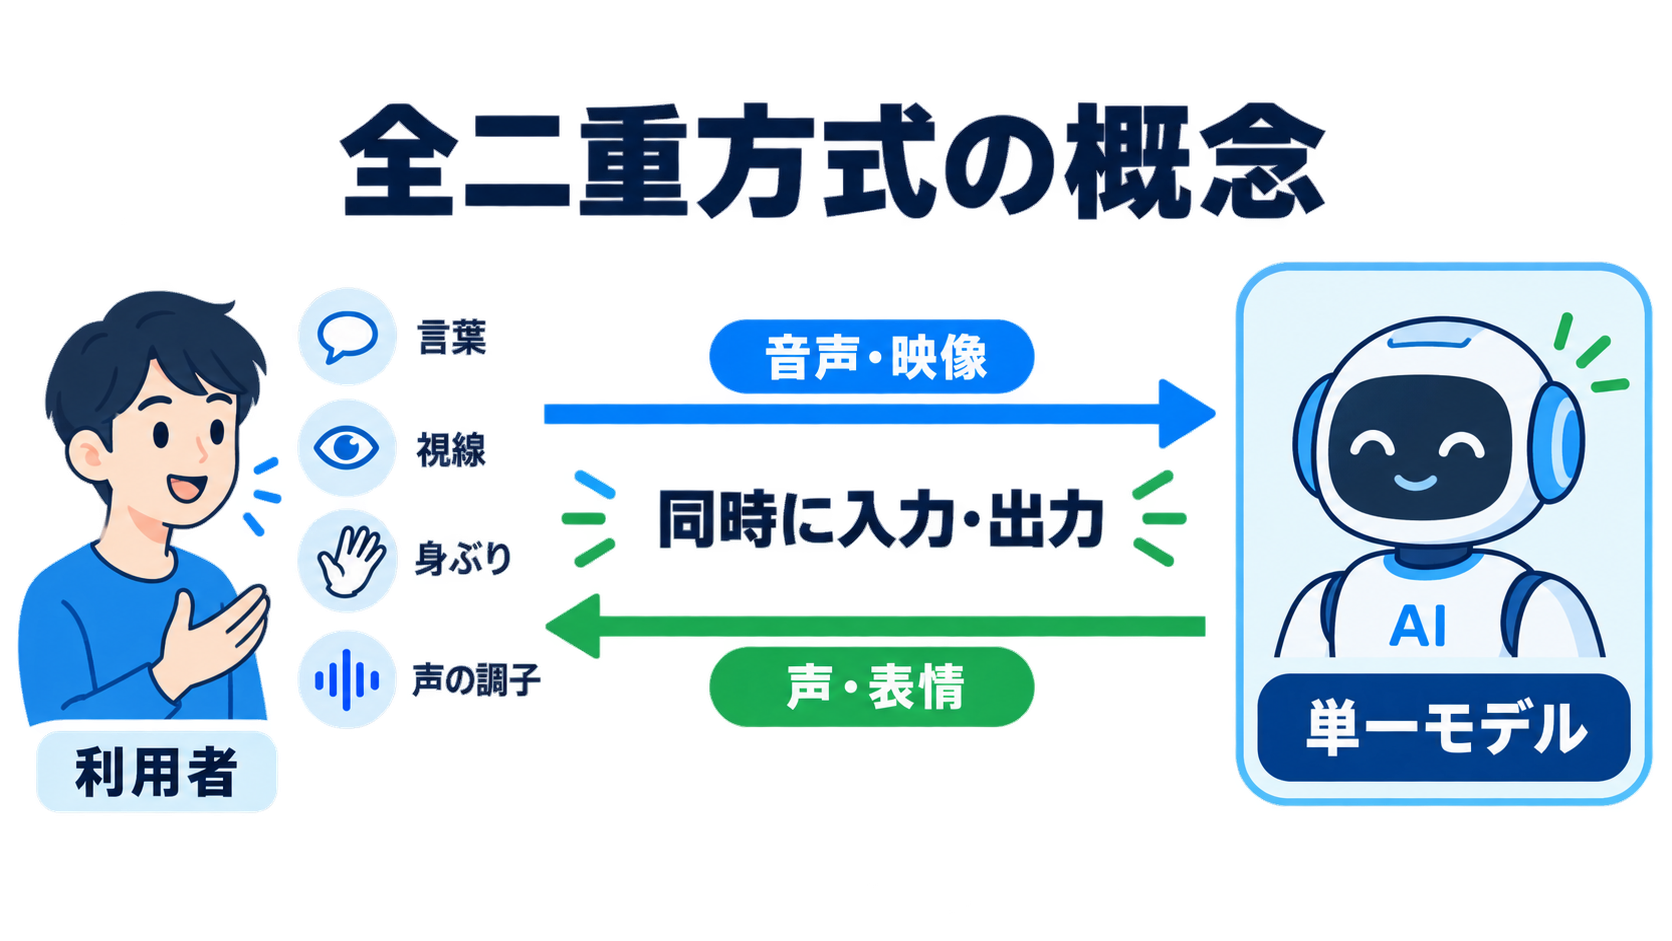
Nuance Labsは、この課題に対して、入力の知覚と応答の生成を一つの全二重システムにまとめる設計を採用しています。全二重とは、入力と出力を同時に行える方式です。相手の話を最後まで受け取ってから返答するだけでなく、話を聞き続けながら反応を返せることが、今回の構想の中心にあります。同社の説明では、モデルは利用者の音声と映像の流れを受け取り、何を話し、どのような動きをしているかを捉えます。それと同時に、音声と映像による応答を逐次送り返します。Ma氏は、複数の処理を継ぎ合わせるのではなく、一つのシステム、一つのモデルにまとめたと説明しています。
入力として扱うのは、発言の内容だけではありません。視線、身ぶり、声の調子、発話のタイミングも含まれます。モデルはこれらを受けて、顔の表情と声の表現でリアルタイムに応じるとされています。相手がまだ話している最中にも、理解していることを示す反応を返す狙いです。Ma氏によると、人が会話中にどう振る舞うかを学ぶことで、こうした能力を改善していきます。
ただし、「感情を理解する」という説明は、人間と同じ内面や感情を持つことを意味しません。企業が評価すべきなのは、観察できる手がかりに対して適切に応じ、その結果として会話が進めやすくなるかどうかでしょう。表情が豊かでも、発言の意味を取り違えていれば、業務上の有用性は限られます。
同社はデモを公開していますが、開発は継続中です。モデルの具体的な性能や、幅広い利用環境での安定性を判断するための情報は、今回の発表だけでは十分ではありません。設計上の狙いと、導入先で確認できる実力を分けて見ることが必要です。
語学練習や接客で問われる、反応の適切さ
Ma氏が想定する用途には、営業、顧客対応、コーチング、職業訓練、教育があります。具体例として挙げているのは、ビデオ通話で外国語を学んだり、面接の練習をしたりする場面です。いずれも正しい答えを提示するだけでなく、相手の話し方や反応に合わせてやり取りを続けることが、体験の質に関わる用途です。語学の会話練習なら、学習者が言葉を探している時間も会話の一部です。これは用途を考えるための例ですが、相手が考え込んでいる途中で回答を始めると、発話の機会を奪ってしまうかもしれません。聞き続けるべき場面と、声をかけるべき場面を扱い分けられれば、練習相手としての使いやすさにつながると考えられます。
接客や営業でも、反応が多ければよいわけではありません。例えば、利用者が不満を伝えている場面で明るい表情を返せば、話を受け止めていない印象を与える可能性があります。表情や声の調子は、回答内容を補強する場合もあれば、逆に損なう場合もあるためです。Nuance Labsの構想を業務に結びつけるには、反応の速さとともに、状況への適合性を見る必要があります。
ここで述べた効果は、想定用途から考えられる可能性であり、導入成果として確認されたものではありません。今回の発表では、売上や顧客満足度、学習成果がどの程度改善するかを示す数値は明らかにされていません。営業向けのデモが自然に見えても、そのまま商談の成果を保証するわけではないでしょう。
導入を検討する企業は、「人らしく見えるか」という印象評価に加えて、説明を最後まで聞けるか、利用者が言い直しやすいか、必要な内容を理解できたかを確認すると、用途との相性を判断しやすくなります。
調達資金は開発と採用へ、公開は研究プレビューから
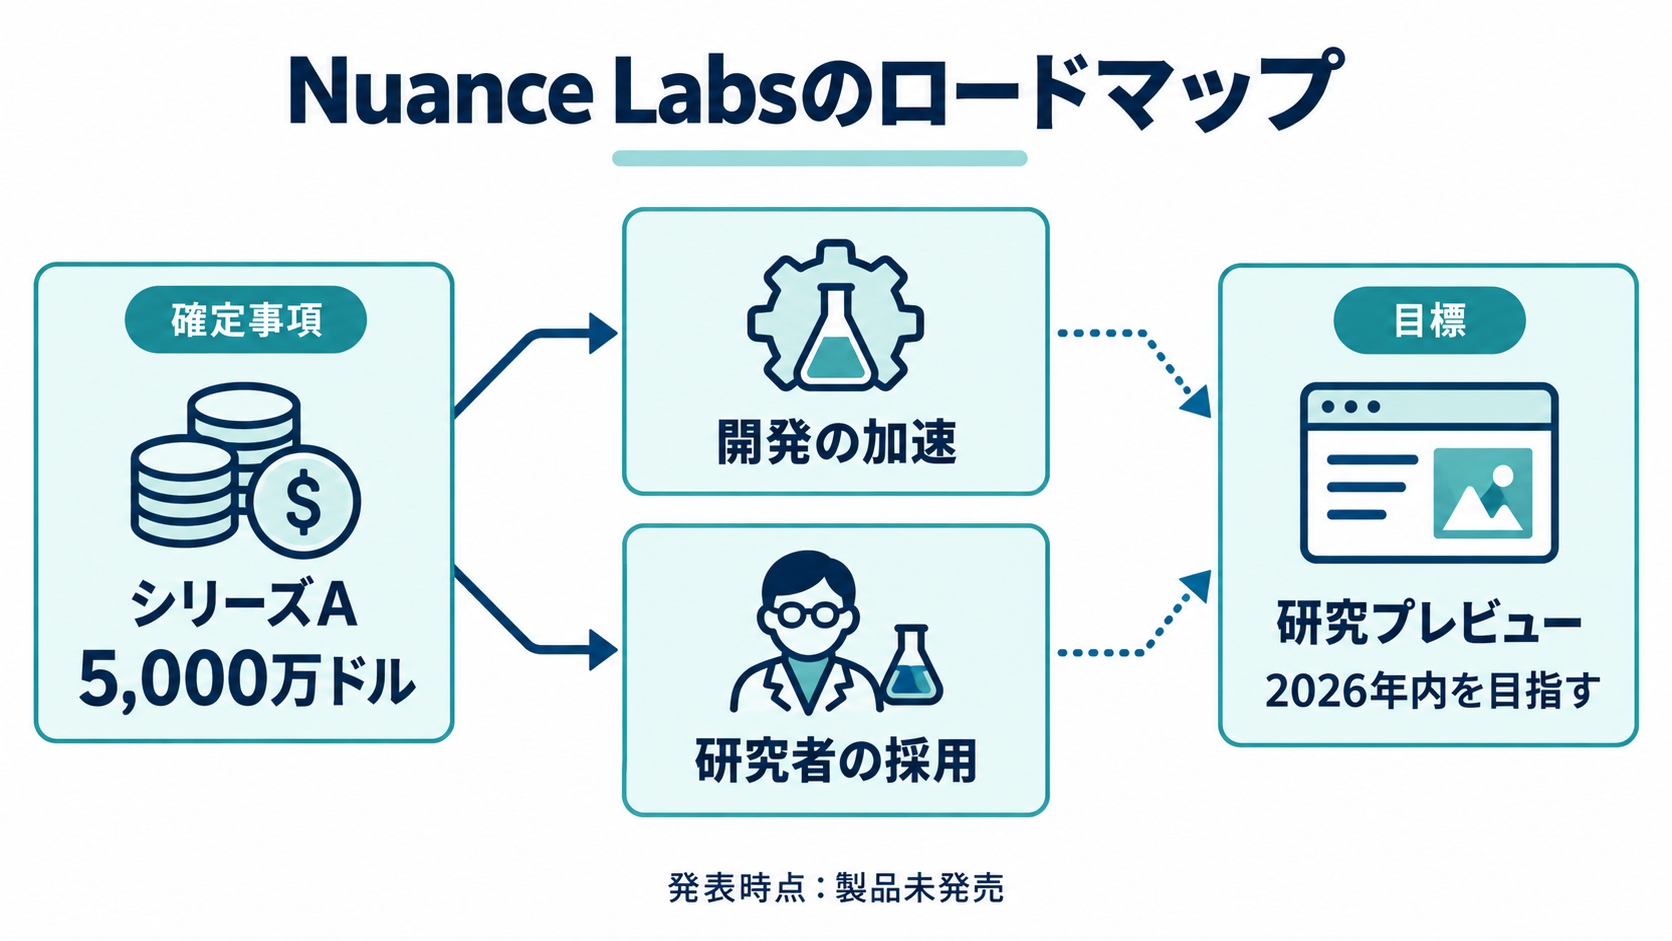
Nuance Labsは、調達した資金を開発の加速に充て、研究者の採用も進める方針です。2026年9月14日の発表時点では製品を発売しておらず、会話をより滑らかにするための調整を続けています。最初の研究プレビューを2026年中に一般公開することを目指していますが、確定した提供開始日が示されたわけではありません。研究プレビューは一般に、開発中の技術を試し、その能力や課題を確かめる機会です。企業が通常業務で使う商用サービスと同じ条件で提供されるとは限りません。公開された際には、試せる機能と、実運用を支える条件をそれぞれ確認する必要があります。今回の発表では、価格や提供形態、業務システムとの接続方法などの詳細は明らかにされていません。
今回の調達を主導したLightspeed Venture PartnersのNnamdi Iregbulem氏は、人とAIのやり取りを改善する領域に大きな事業機会があると評価しています。同氏は創業チームの技術力と事業運営力に期待を寄せ、リアルタイムに相手を追う単一モデルが、さまざまなAI製品の基盤になり得るとの見方を示しています。
これは投資家による将来性の評価です。既に幅広い製品への採用が決まっていることや、収益性が実証されたことを示すものではありません。また、Nvidiaの投資参加は確認できますが、それだけで特定の技術提携や製品統合まで決まったと解釈することはできません。
企業の検討段階としては、すぐに本番導入の計画を立てるよりも、研究プレビューで何を検証するかを準備する時期と考えられます。会話の自然さを改善する技術が、自社のどの業務課題に結びつくのかを先に定めておけば、公開後の評価が見た目の印象だけに流れにくくなるでしょう。
日本企業は「聞く力」を確かめる会話から検証
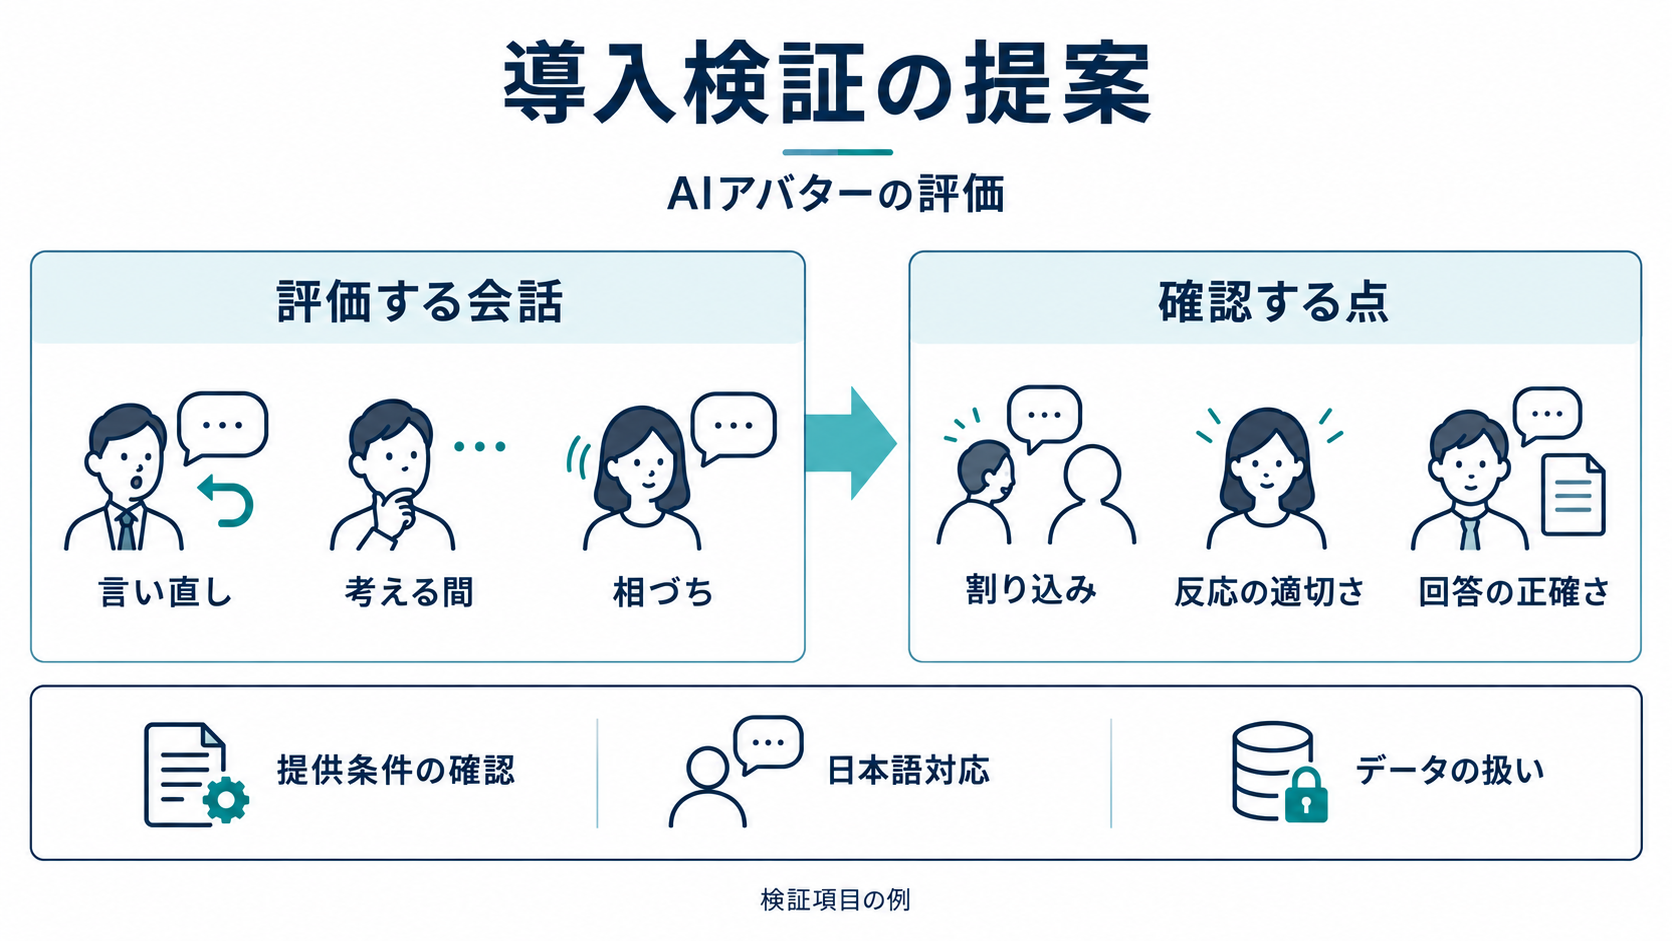
日本の企業がこの技術を評価するなら、日本語を話せるかどうかに加えて、日本語のやり取りの中で反応が適切かを確かめる必要があります。相づちや沈黙、発言を交代するタイミングの受け止め方は、利用者や場面によって異なります。今回の発表では日本語対応の詳細は明らかにされていないため、日本での利用を前提に判断できる段階ではありません。評価用の会話には、短い質問だけでなく、説明の途中で言い直す場面や、考えるために間を置く場面を含めるとよいでしょう。これは導入検証の提案です。利用者が話を続けるつもりなのにAIが割り込まないか、反応がなくて利用者が同じ説明を繰り返さないかを見ることで、全二重方式の狙いが実際の使いやすさにつながっているかを確認できます。
音声と映像を扱う以上、入力データの扱いも検討項目です。保存の有無や期間、学習への利用、利用者への説明方法などは、提供条件が公開された際に確認する必要があります。Ma氏は人の会話中の振る舞いから学ぶと説明していますが、それだけでは、個々の利用者の会話がどの条件で学習に使われるかまでは判断できません。
業務上の評価では、応答の自然さと回答の正確さを別々に確かめることも欠かせません。自然な表情や声によって内容が伝わりやすくなっても、その内容自体が正しいとは限らないためです。顧客対応であれば、案内の正確性や、人の担当者に引き継ぐべき場面も含めて検証する必要があります。
準備の第一歩として、自社の会話業務から「相手の反応が分からず、やり取りが止まりやすい場面」を一つ選んでみてください。その場面を短い評価シナリオにし、適切な反応と困る反応を書き出しておけば、研究プレビューの公開後に、Nuance Labsの技術が解く課題と自社の課題が重なるかを具体的に判断できます。