AI LAB
2026/10/11
AIインフラ競争の焦点は「チップの速さ」から「データを滞らせない設計」へ
高性能チップだけでは解消できないAIの待ち時間
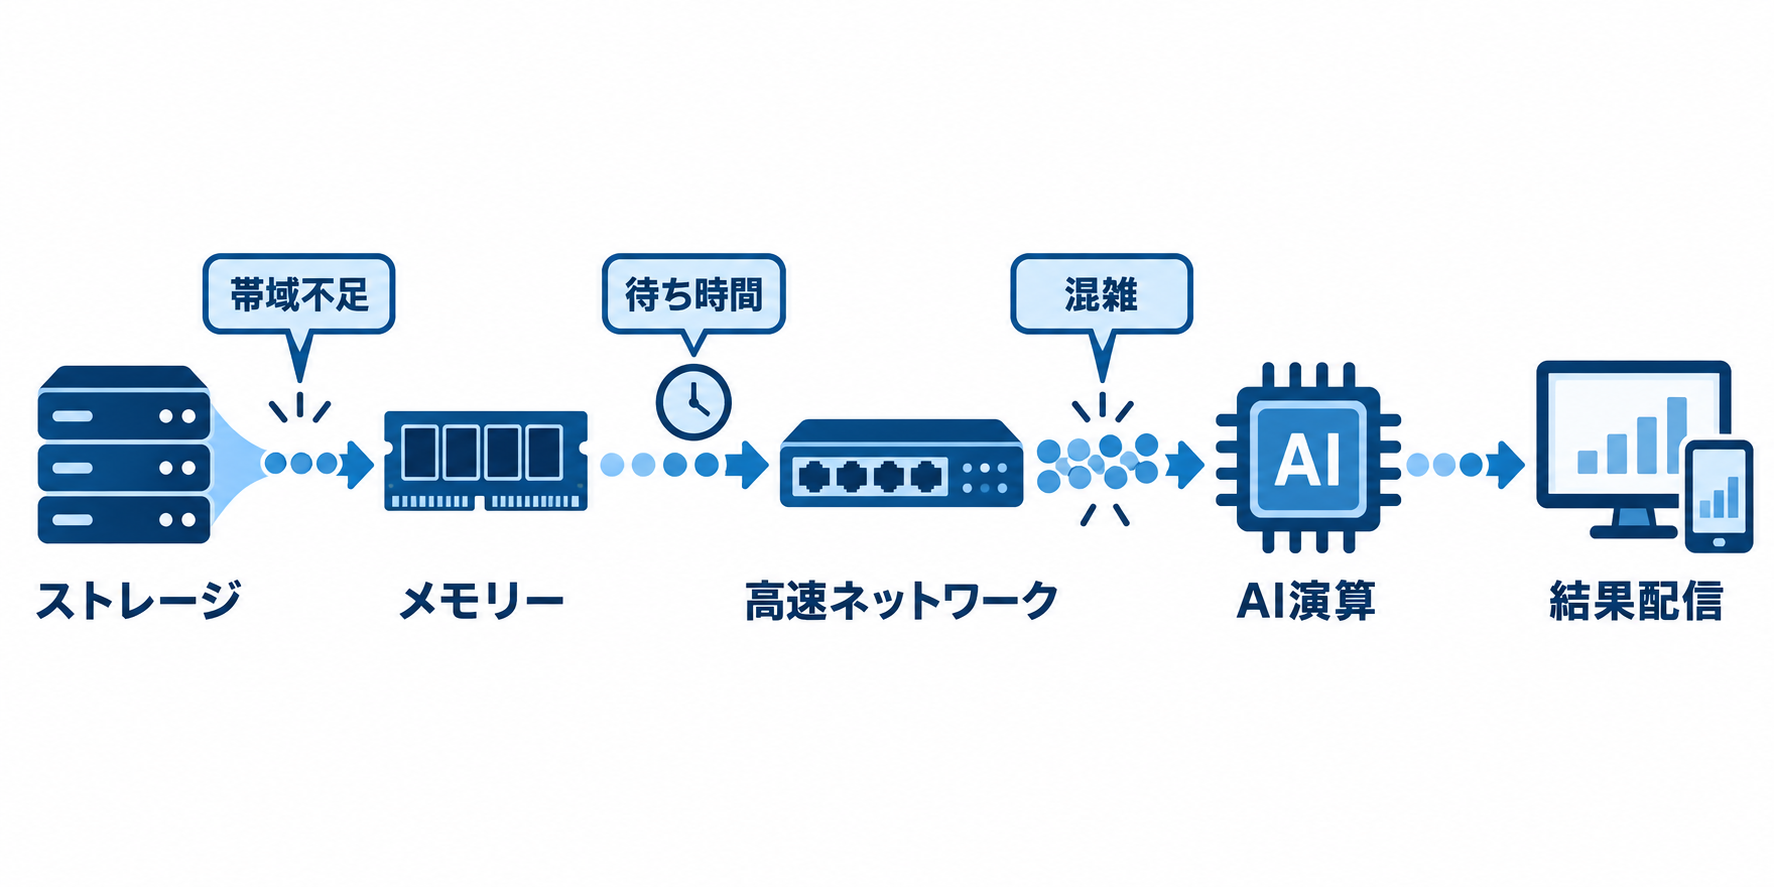
高性能なGPUやアクセラレーターを追加したのに、期待したほどAI処理が速くならない――。その原因は、演算性能そのものではなく、必要なデータを必要なタイミングで届けられないことにあるかもしれません。AIインフラの競争軸は、個々のチップの性能から、コンピュート、ストレージ、メモリー、ネットワークを一体として動かすシステム設計へ移りつつあります。AIモデルの処理では、演算装置が絶えずデータを受け取り、中間結果や生成結果を書き出します。高速なチップを用意しても、ストレージからの読み出し、メモリーへの展開、サーバー間の転送のどこかで遅れれば、演算装置には待ち時間が生じます。設備投資の判断では、単体製品の最高速度だけでなく、システム全体でどれだけ継続的にデータを流せるかを見る必要があるでしょう。
この課題を取り上げるのが、2026年10月に米カリフォルニア州サンノゼで開かれるAI Data Pipeline Forumです。イベントはOCP Global Summitの開催期間中に実施され、密度の高いAIクラスターや分散推論を支えるアーキテクチャーが議論されます。SiliconANGLE Mediaのライブ配信スタジオであるtheCUBEは、10月13日に会場の模様を配信する予定です。
ここでの中心的な問いは、どの部品が最速かではありません。演算、記憶、通信、電力、冷却をどう協調させ、処理の停滞を減らすかが焦点です。AI基盤を調達する企業にとっても、製品カタログの比較だけでは投資効果を判断しにくい段階へ入ったと考えられます。
データパイプラインのどこで処理が詰まるのか
AIにおけるデータパイプラインとは、データを保存場所から読み出し、ネットワークを介してサーバーやアクセラレーターへ運び、処理結果を再び保存・配信するまでの経路を指します。実際の環境では複数の装置とソフトウェアが関わるため、どれか一つを高速化しても、別の場所に待ち行列が移るだけということが起こり得ます。学習済みモデルを業務で利用する推論処理が広がると、要求の到着に応じてデータを素早く取り出し、複数の計算資源へ振り分ける能力が問われます。推論を複数の拠点やシステムに分散させる場合は、装置間の距離やネットワーク経路も性能を左右します。ピーク時だけ速い構成ではなく、負荷が変動しても応答時間と処理量を維持できる構成が必要です。
TheCUBE Researchのチーフアナリスト、デイブ・ヴェランテ氏は、メモリーの制約、非効率なデータ移動、推論処理の経済性を課題として挙げています。ここでいう経済性は、単なる機器価格ではなく、期待する処理量を得るために必要な設備や電力、運用負担を含めて考える視点です。高価な演算装置がデータ待ちで停止する時間が増えれば、導入した計算能力を十分に活用できません。
企業が確認すべき指標も、チップ単体の理論性能だけでは足りなくなります。データの読み書き速度、メモリー容量、ネットワーク遅延、混雑時の性能低下、消費電力などを、実際のワークロードに近い条件で評価することが欠かせないでしょう。ボトルネックを特定するには、部門ごとに分断された監視ではなく、処理経路を横断して状況を追える仕組みも求められます。
ストレージとメモリーに求められる役割の変化
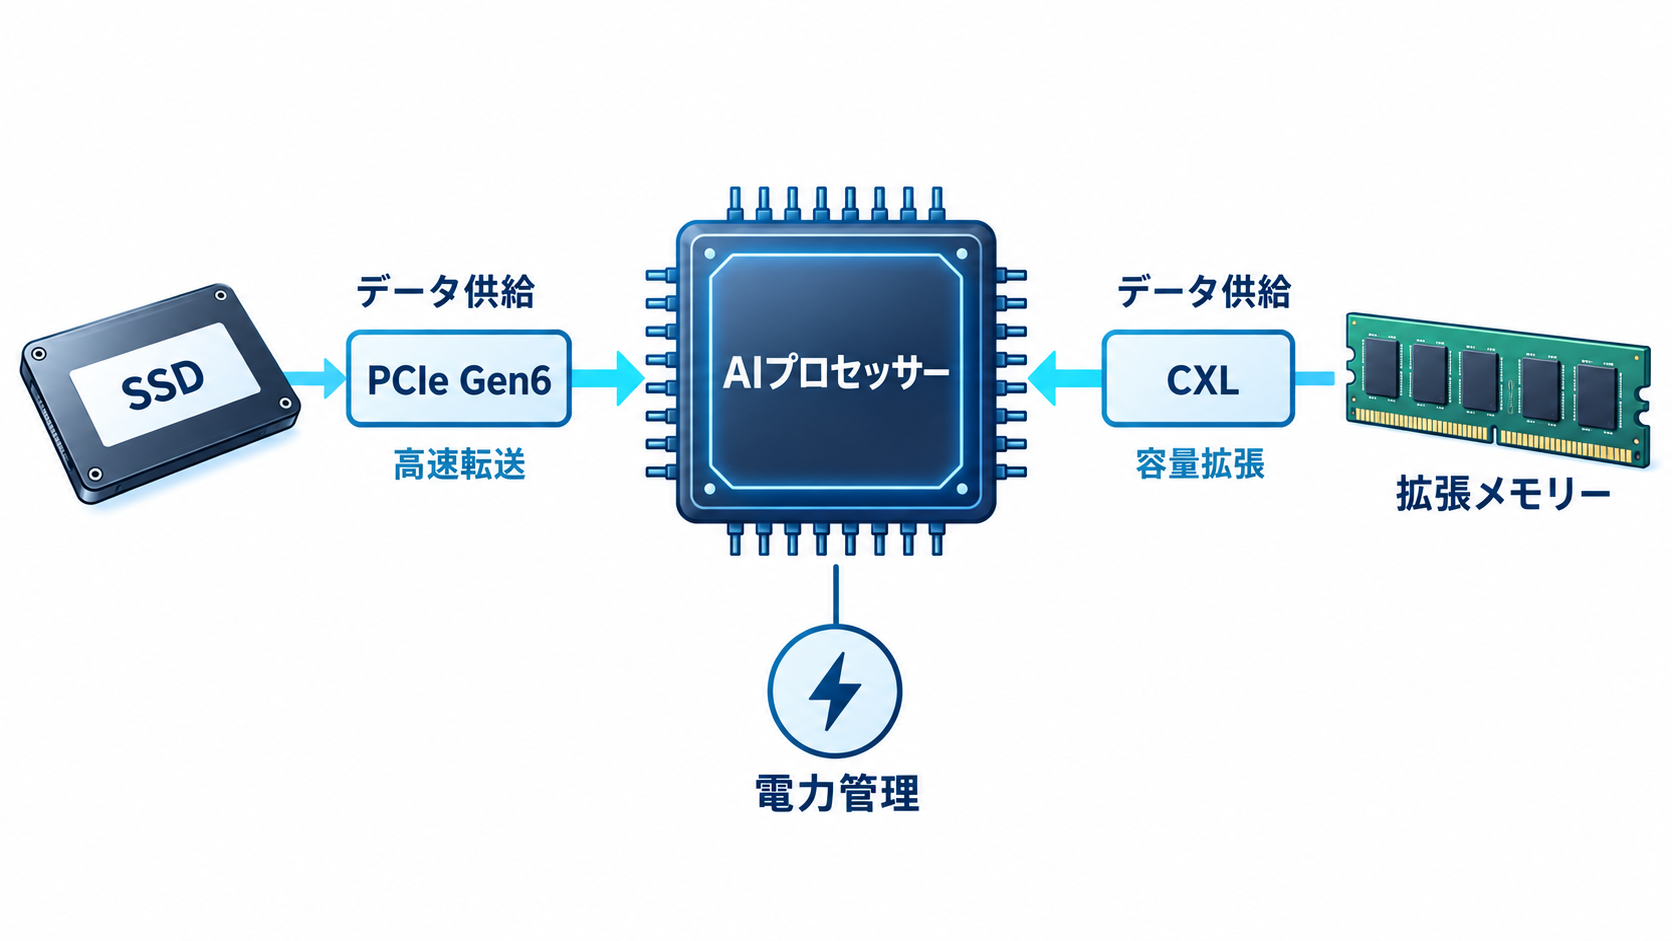
ストレージは、処理前後のデータを置いておく受動的な保管場所と見られがちです。しかし、AIワークロードが扱うデータ量とメモリー需要が増えるにつれ、データをどの速度で供給し、どれだけ効率よく移動させるかを担う構成要素へ変わっています。演算装置の近くへデータを届けるまでの時間が、システム全体の実効性能を決めるためです。ストレージおよびメモリーコントローラーを開発するScaleFluxは、2026年7月にPCIe Gen6対応SSDコントローラーのFC6116と、CXLメモリーコントローラーのMC600を発表しました。同社は、高い帯域幅と大きなメモリー容量を確保しながら、消費電力を管理できる設計部品として位置付けています。PCIeはサーバー内部で高速機器を接続する規格で、世代が進むほど利用可能な転送帯域が広がります。
CXLは、プロセッサーやアクセラレーター、メモリーなどを接続するための技術です。対応する機器と適切なシステム設計を組み合わせれば、メモリー資源をより柔軟に構成するための選択肢になります。ただし、規格への対応だけで実際の処理が自動的に高速化するわけではありません。ソフトウェア、接続構成、データ配置、障害時の運用まで含めた検証が必要です。
ScaleFlux共同創業者兼最高経営責任者のハオ・ジョン氏は、AIインフラが広い帯域幅、大容量メモリー、低消費電力を同時に求めていると説明しています。この三つは単純に両立するとは限らず、設計上の優先順位を明確にしなければなりません。例えば、最大性能を狙う構成と、一定の性能を限られた電力枠で安定運用する構成では、選ぶ部品や評価方法が変わるでしょう。ストレージとメモリーは、調達リストの脇役ではなく、AI基盤の費用対効果を左右する検討対象になっています。
電力と冷却が決めるラックの実装可能性
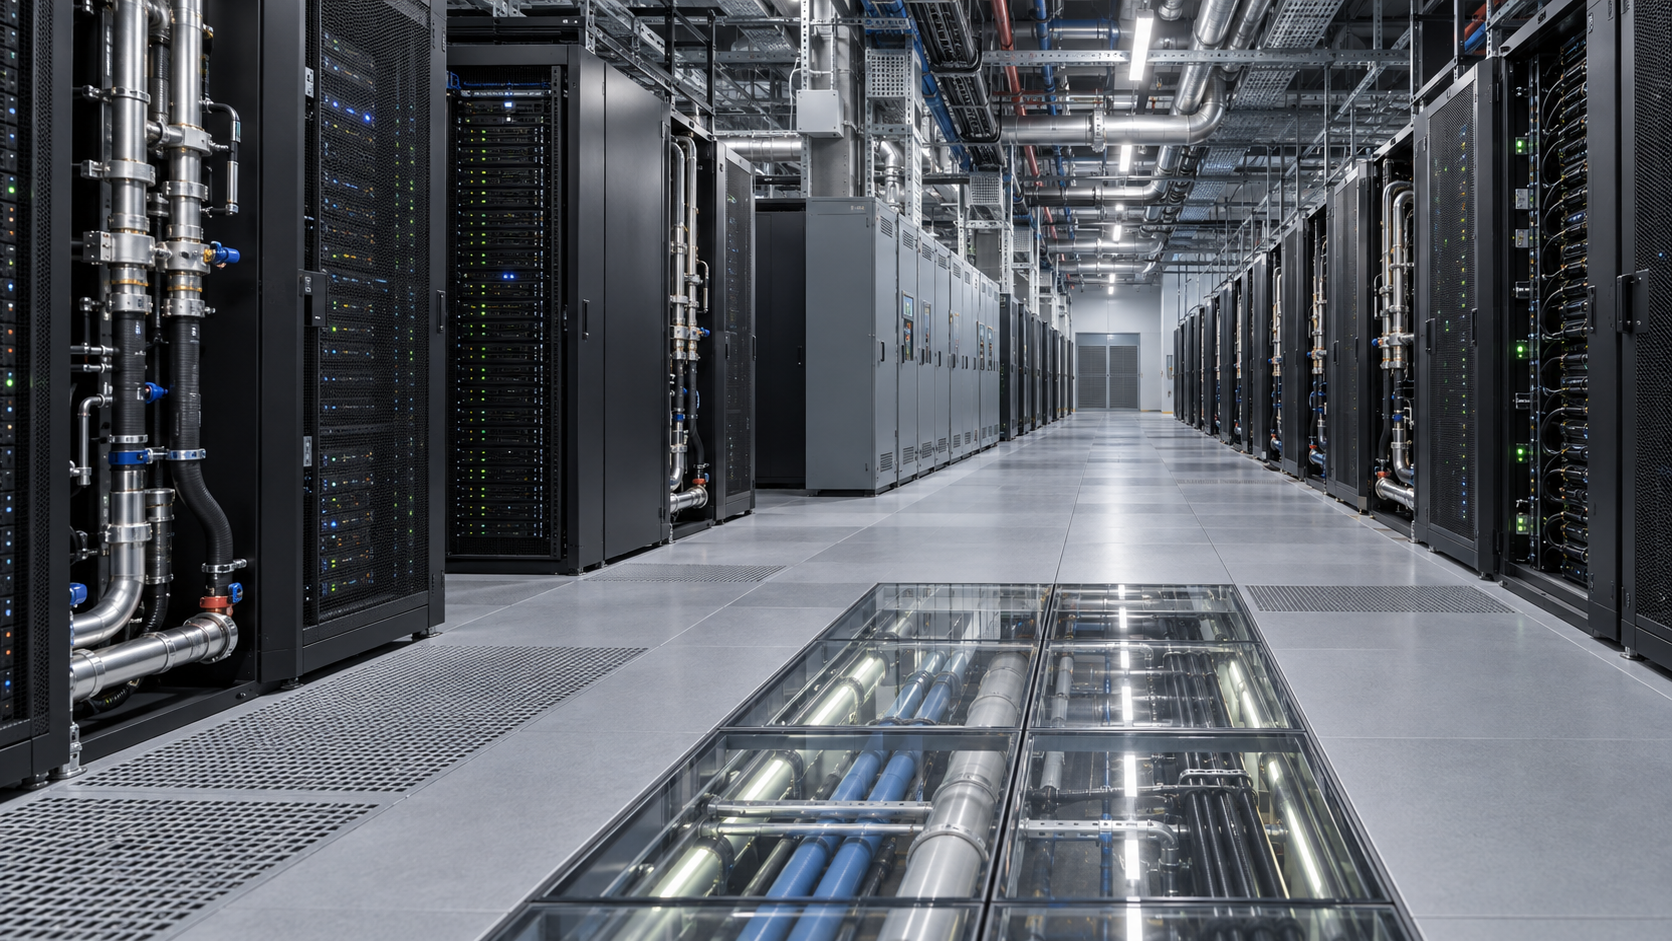
データを高速に動かせる構成を設計しても、必要な電力を供給できず、発生する熱を排出できなければ稼働させられません。AI向けの高密度システムでは、論理的なアーキテクチャーと建物側の設備条件を切り離して考えることが難しくなっています。機器が仕様上はラックに収まっても、既存施設の給電容量や冷却方式に適合するとは限らないためです。Dell TechnologiesでPowerEdge AIのアーキテクチャーとシステム開発を担当するサラット・クリシュナン氏は、冷却を上部から取り込む施設もあれば、下部から取り込む施設もあり、電力供給用ケーブルの構成や寸法にも違いがあると説明しています。こうした環境差に対応するため、Dellは必要に応じて構成を変えやすいモジュール型のラックスケール基盤を構築してきました。
ラックスケール設計では、サーバーを一台ずつ独立して見るのではなく、ラック全体を電力、冷却、通信、保守の単位として扱います。機器密度が高まれば、冷却経路の小さな不整合が局所的な温度上昇につながる可能性があります。電力ケーブルや配管が保守作業を妨げれば、障害対応にも時間がかかるでしょう。性能だけを優先した結果、設置や運用が複雑になっては、業務基盤としての安定性を損ねかねません。
AIサーバーの選定時には、電源容量や冷却能力を導入後に確認するのでは遅すぎます。候補となるラック構成と施設条件を早い段階で照合し、増設時の余地や保守経路も含めて評価する必要があります。IT部門、施設管理部門、電力・冷却設備の担当者が同じ設計情報を共有することが、導入時の手戻りを抑える鍵になるでしょう。
オープン標準とモジュール設計が必要になる理由
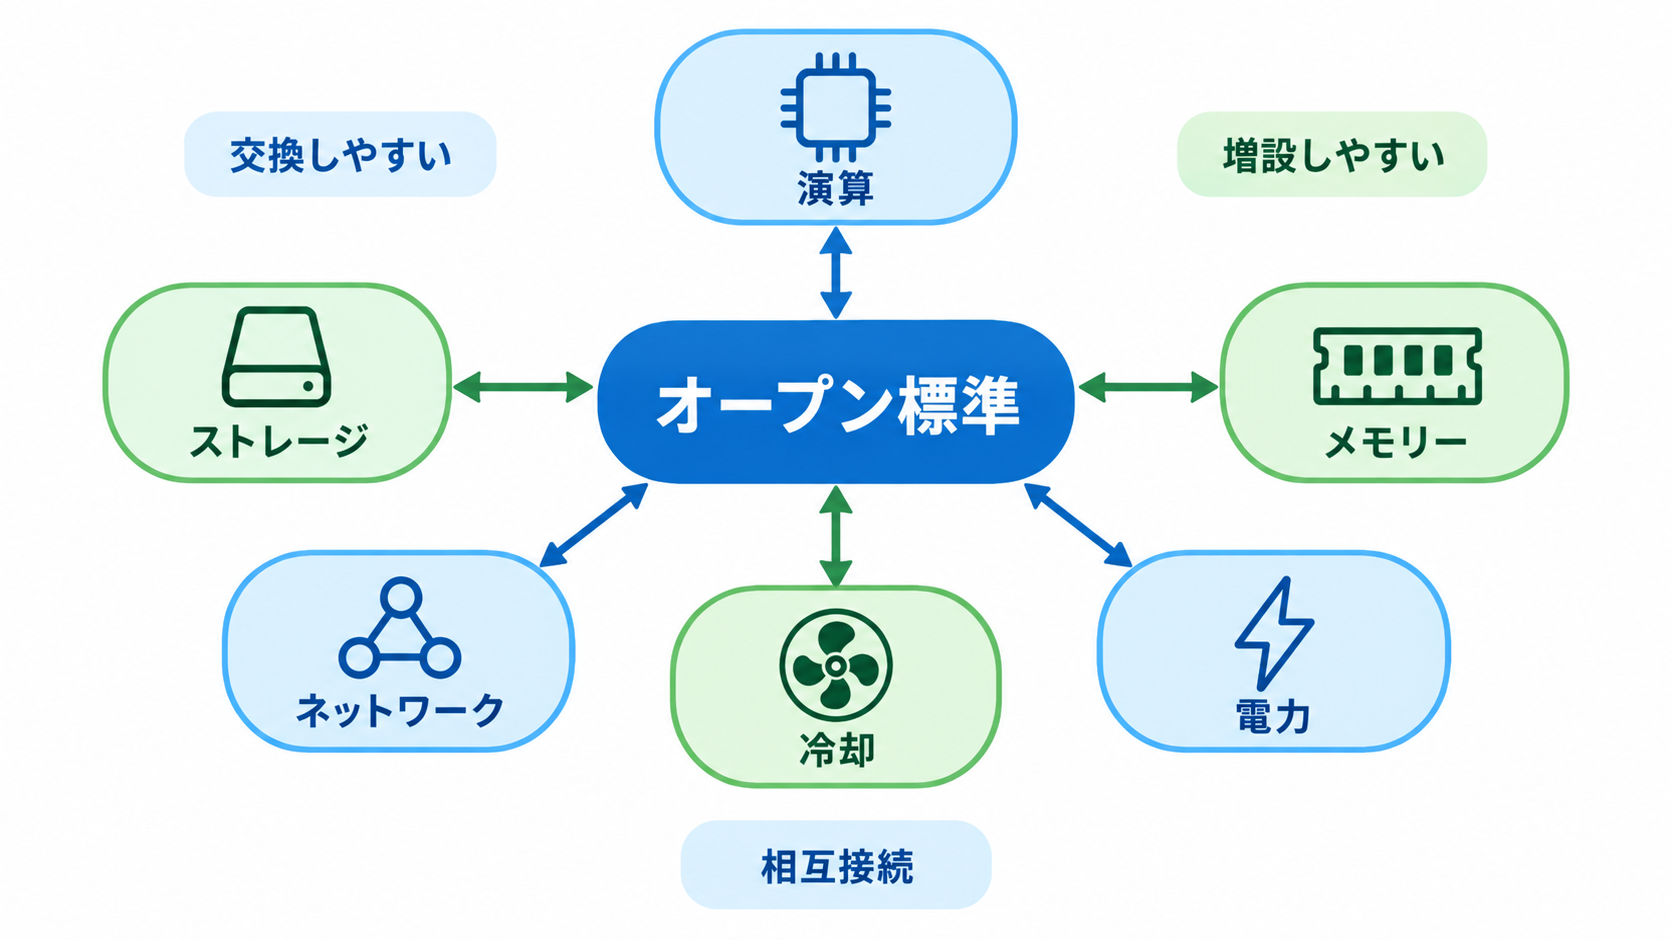
OCP Global SummitのOCPはOpen Compute Projectを指し、データセンター向けハードウェアなどのオープンな設計や仕様を業界で検討する取り組みです。AI Data Pipeline Forumが同サミットの期間中に開かれる背景には、一社の製品だけでは解決しにくい相互接続の課題があります。ストレージ、メモリー、ネットワーク、ラック、電力、冷却を異なる企業が提供する以上、部品間の境界をどう合わせるかが重要です。オープン標準は、各社の製品が受け渡すデータや制御情報、物理的な接続条件をそろえるための共通言語として機能します。インターフェースが明確になれば、企業はすべてを同じベンダーから購入せずに構成を検討しやすくなります。将来の増設や部品交換で選択肢を残せる可能性もあるでしょう。
モジュール設計も同じ考え方に基づきます。設備全体を固定的な一枚岩として構築するのではなく、交換や追加が可能な単位に分けることで、ワークロードや施設条件の変化へ対応しやすくします。Dellが説明するラックスケール基盤は、冷却方式や電力供給の違いへ迅速に適応することを目指した例です。
ただし、オープンという名称だけで相互運用性が保証されるわけではありません。対応する規格の版、必須機能と任意機能、管理ソフトウェアとの組み合わせを確認し、実環境に近い構成で試験する必要があります。標準化は選択肢を増やす一方、複数ベンダーにまたがる障害の切り分けや責任分担を複雑にする場合もあります。調達時には、技術仕様と併せて、問い合わせ窓口や更新方針、検証体制を確認しておくべきでしょう。
AI Data Pipeline Forumで確認したい議論
AI Data Pipeline Forumでは、ScaleFlux、Cerebras、Cisco、Dellなどの幹部が、ストレージ、メモリー、高速ネットワーク、液冷、電力分配の進歩について議論する予定です。司会はtheCUBE Researchのエグゼクティブアナリストであるジョン・ファリアー氏が務めます。個別技術の紹介に加え、密度を増すAIクラスターと分散推論を、オープン標準やモジュール型アーキテクチャーでどう支えるかが焦点になります。企業のインフラ担当者が注目したいのは、新製品の最高性能だけではありません。各社が想定するワークロード、性能測定の範囲、電力制約下での動作、既存設備へ組み込む際の条件を聞き分ける必要があります。ストレージの高速化がネットワークやメモリーの負荷をどう変えるのか、液冷設備がラックの設計や保守手順にどのような影響を与えるのかも、システム全体を見るうえで有効な論点です。
TheCUBEの配信は10月13日に予定され、専用サイトとYouTubeで視聴できます。ライブ終了後にはオンデマンドでも提供される予定です。SiliconANGLEは、Apple Podcasts、Spotify、YouTubeで企業向けテクノロジーを扱う番組も配信しています。時差などでライブを見られない場合でも、後から関心のある対談を確認できるでしょう。
なお、theCUBEはAI Data Pipeline Forumの有料メディアパートナーです。SiliconANGLEは、配信スポンサーがtheCUBEおよびSiliconANGLEの編集内容を管理することはないと開示しています。企業が情報収集に利用する際は、この関係を把握したうえで、登壇企業の説明を自社の検証結果や複数の情報源と照合する姿勢が適切です。
日本企業がAI基盤の計画に落とし込む方法
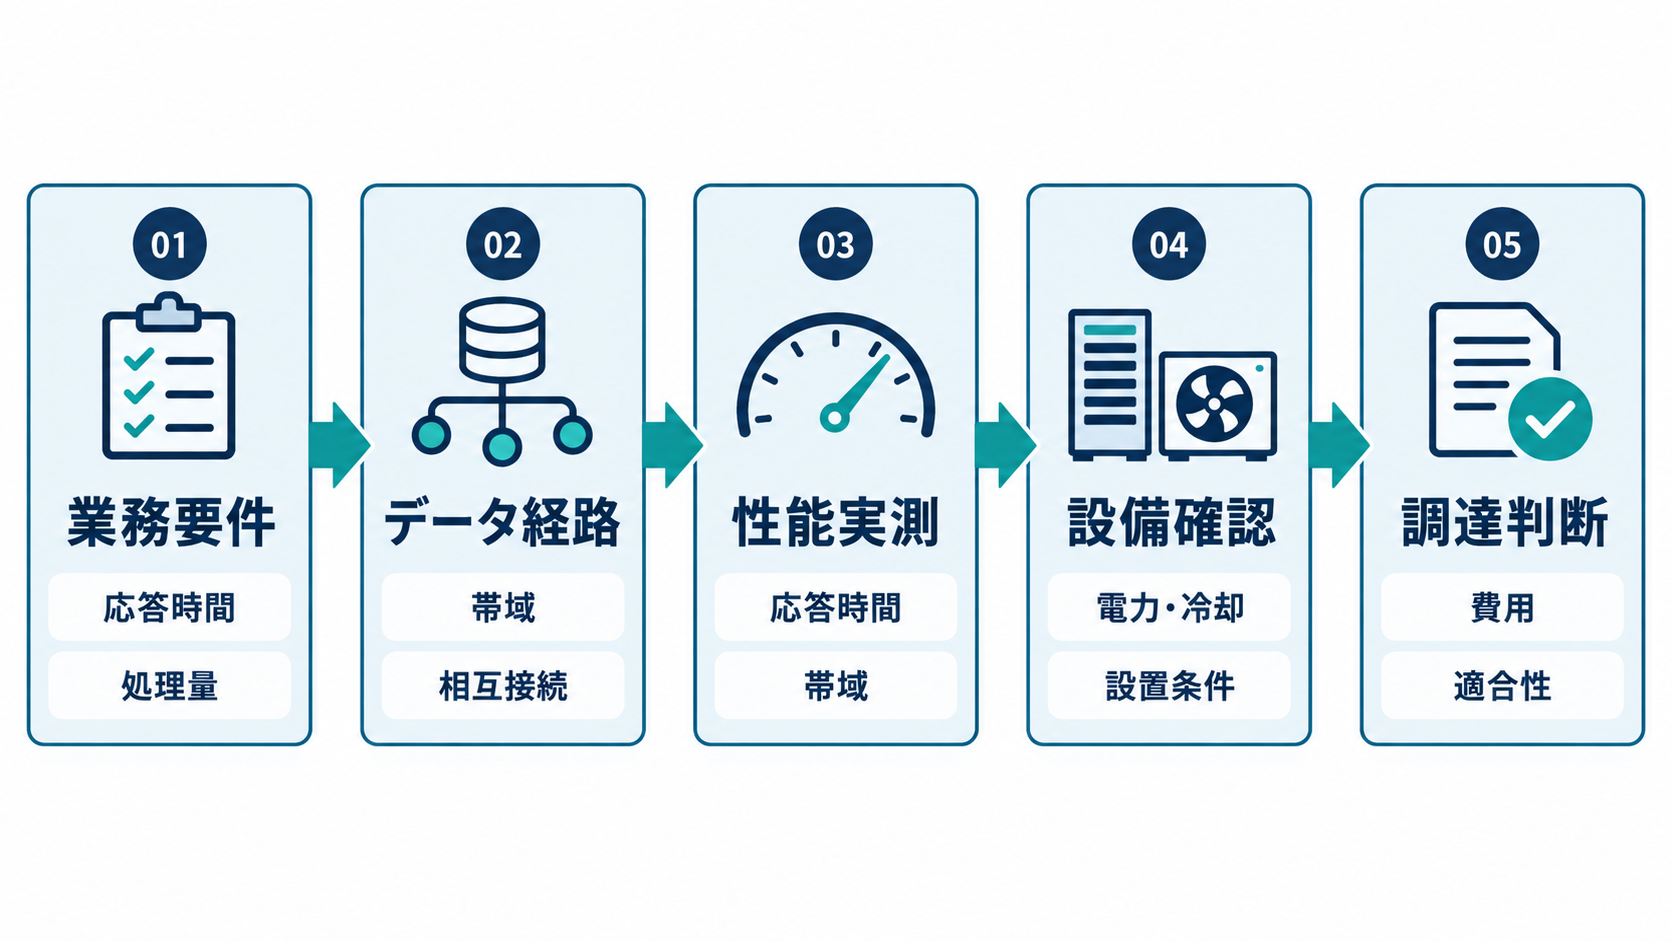
今回の議論から得られる実務上の示唆は、AI基盤を製品の集合ではなく、データが通過する一つのシステムとして評価することです。検討の起点には、導入したいGPUの型番ではなく、業務で扱うデータの量、処理の頻度、許容できる応答時間、利用場所を置くほうがよいでしょう。学習、対話型サービス、社内検索などではデータの流れが異なるため、必要な構成も一律ではありません。現状調査では、データがどこに保存され、どのネットワークを通り、どの装置で処理されるかを図にします。その経路ごとに、転送速度、待ち時間、容量、消費電力を確認すれば、演算装置を増やす前に解消すべき制約が見えやすくなります。平均値だけでなく、利用が集中する時間帯や障害時の挙動を調べることも欠かせません。
調達要件には、単体性能に加えて相互接続と運用の条件を盛り込む必要があります。既存のストレージやネットワークとの接続可否、ラック当たりの給電条件、採用できる冷却方式、将来の増設単位、複数ベンダー間のサポート分担を事前に確認します。オープン標準への対応を評価する場合も、規格名の有無だけでなく、どの機能をどの構成で検証済みなのかを尋ねるべきです。
組織面では、AI開発チームだけで判断を完結させず、インフラ、ネットワーク、ストレージ、施設管理、調達の担当者を早期に参加させることが現実的です。各部門が別々の最適化を進めると、性能は高いものの設置できない構成や、運用費を見落とした計画が生まれかねません。
次の一歩として、自社の代表的なAIワークロードを一つ選び、保存から演算、結果配信までの経路を可視化してみるとよいでしょう。その図に実測値と設備上の上限を書き加えれば、追加投資をチップ、メモリー、ストレージ、ネットワーク、電力、冷却のどこへ振り向けるべきか、具体的な議論を始められます。