
AI LAB
2026/10/25
33Bで業務を動かす「Nanbeige4.3」──512K文脈と高い自己評価をどう検証するか
コードを書くモデルから、作業を完遂するモデルへ
企業がAI開発支援ツールを選ぶ場面では、コード補完の精度だけを比べても十分ではありません。リポジトリを読み、端末を操作し、テスト結果を受けて修正を重ねるところまで任せられるかが、実務での差になります。Nanbeige LLM Labが公開したNanbeige4.3-33Bは、こうした「エージェント型コーディング」と、資料作成や事務処理を含む「cowork」業務を主な対象に据えたモデルです。Nanbeige LLM Labは、中国の求人プラットフォーム「BOSS直聘(BOSS Zhipin)」内の研究組織です。公開されたモデルは330億パラメータのDense型で、利用条件はApache License 2.0です。学習後の調整を施した主力モデルに加え、企業や研究者が独自の追加学習を行うためのNanbeige4.3-33B-Baseも用意されています。
このモデルの位置づけで注目したいのは、単体の製品として完結させるのではなく、能力を小型モデルへ移す「教師モデル」として設計されている点です。研究チームは、強力な33Bモデルを先に構築し、そのエージェント能力をNanbeige4.3-3Bなどへ蒸留する方針を示しています。現段階では大規模な推論環境が必要ですが、将来的な小型化を前提とした開発戦略と捉えられます。
企業にとっての中心的な論点は、ベンチマーク順位そのものではありません。長い文脈、ツール呼び出し、複数ターンの推論を組み合わせたとき、自社の開発工程やバックオフィス業務をどこまで安定して進められるかです。Nanbeige4.3-33Bは、その検証対象になり得る仕様を備えていますが、公開値の読み方と運用コストには注意が必要です。
52層のDense構成と、52万トークンの文脈窓
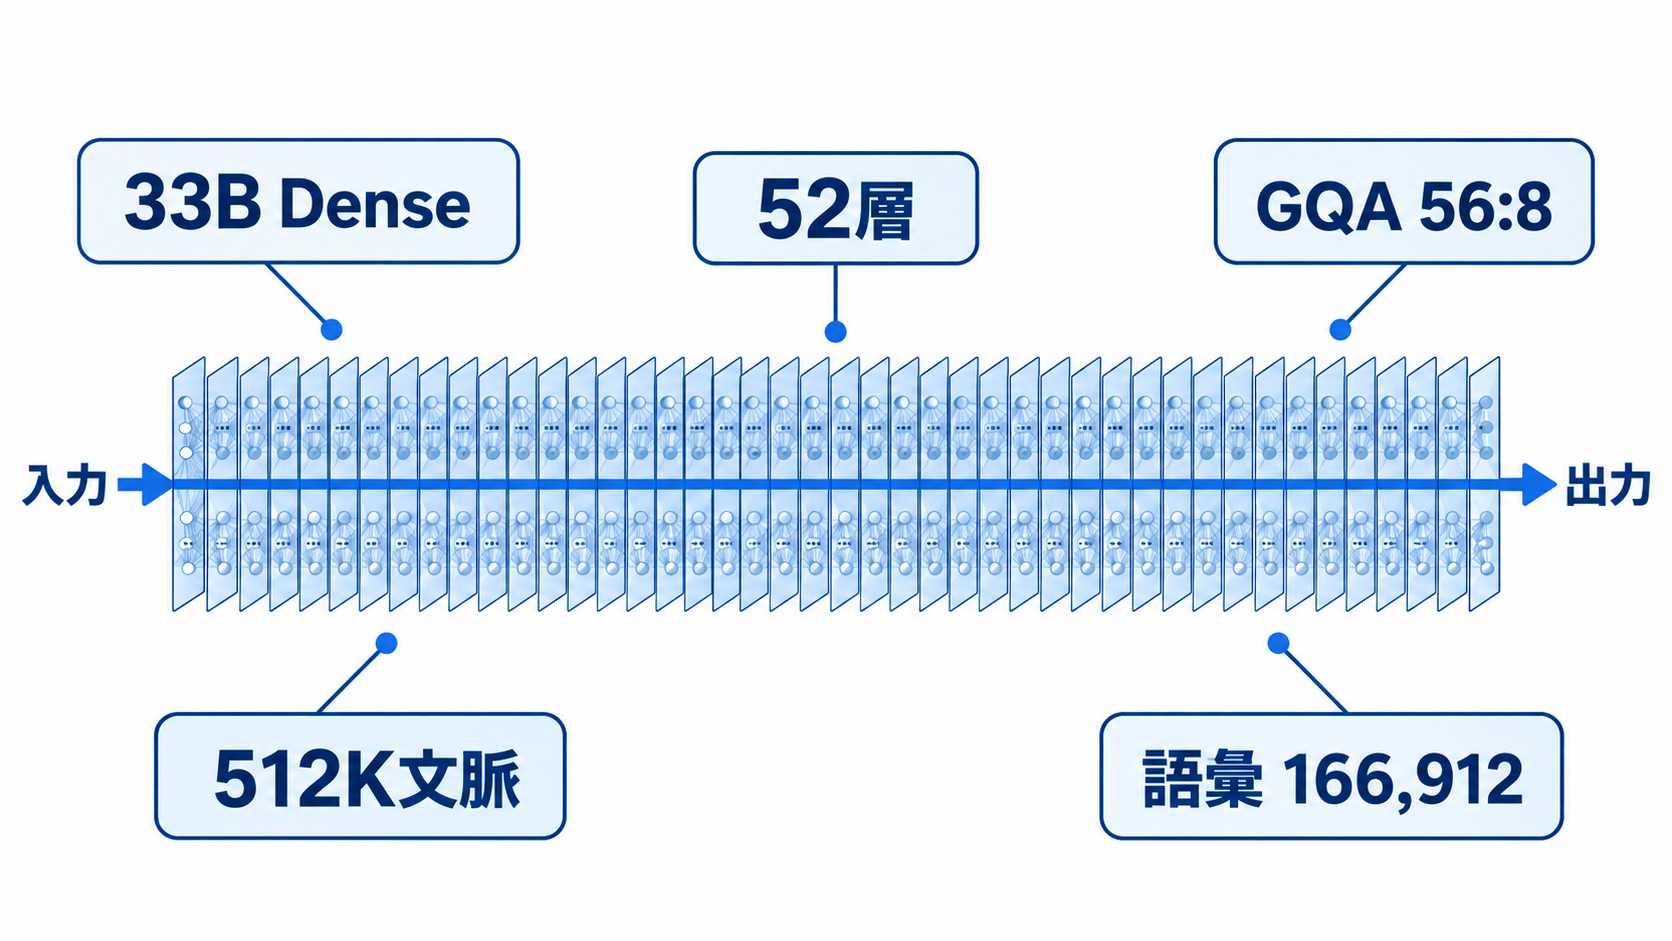
Nanbeige4.3-33Bは、標準的なLlamaForCausalLMアーキテクチャを採用しています。MoE(Mixture of Experts)のように入力ごとに一部の専門ネットワークだけを動かす方式ではなく、すべてのトークンに対して330億のパラメータ全体を使うDense型です。処理量は予測しやすい反面、推論時の計算負荷とメモリ消費を抑えにくい構成でもあります。内部は52層で、隠れ層のサイズは7,168です。Attentionには56個のQuery Headと8個のKey-Value Headを持つGrouped-Query Attentionを採用し、各Headの次元は128です。Feed Forward Networkの中間サイズは22,016、語彙数は166,912トークンとされています。RoPE thetaは120,000,000で、最大位置数は524,288です。
52万4,288トークン、一般に「512K」と表記される文脈窓は、大規模なコードベースや多数の業務文書を一度に扱う用途を想定した仕様です。ただし、文脈窓に収まることと、入力全体を均等な精度で理解できることは同じではありません。長文の中から離れた情報を正確に関連づけられるか、不要な記述に引きずられないかは、実データによる確認が欠かせません。
企業利用では、最大長を常に使う運用よりも、検索やファイル選択によって必要な情報だけを渡す設計が現実的でしょう。長い文脈窓は情報整理を不要にする機能ではなく、複数ファイルや長時間の作業履歴を切り捨てずに保持できる余裕です。入力の選別、権限管理、機密情報の除外と組み合わせてこそ、仕様上の長さが実務上の価値につながります。
思考履歴とツール呼び出しを制御する三つの仕組み
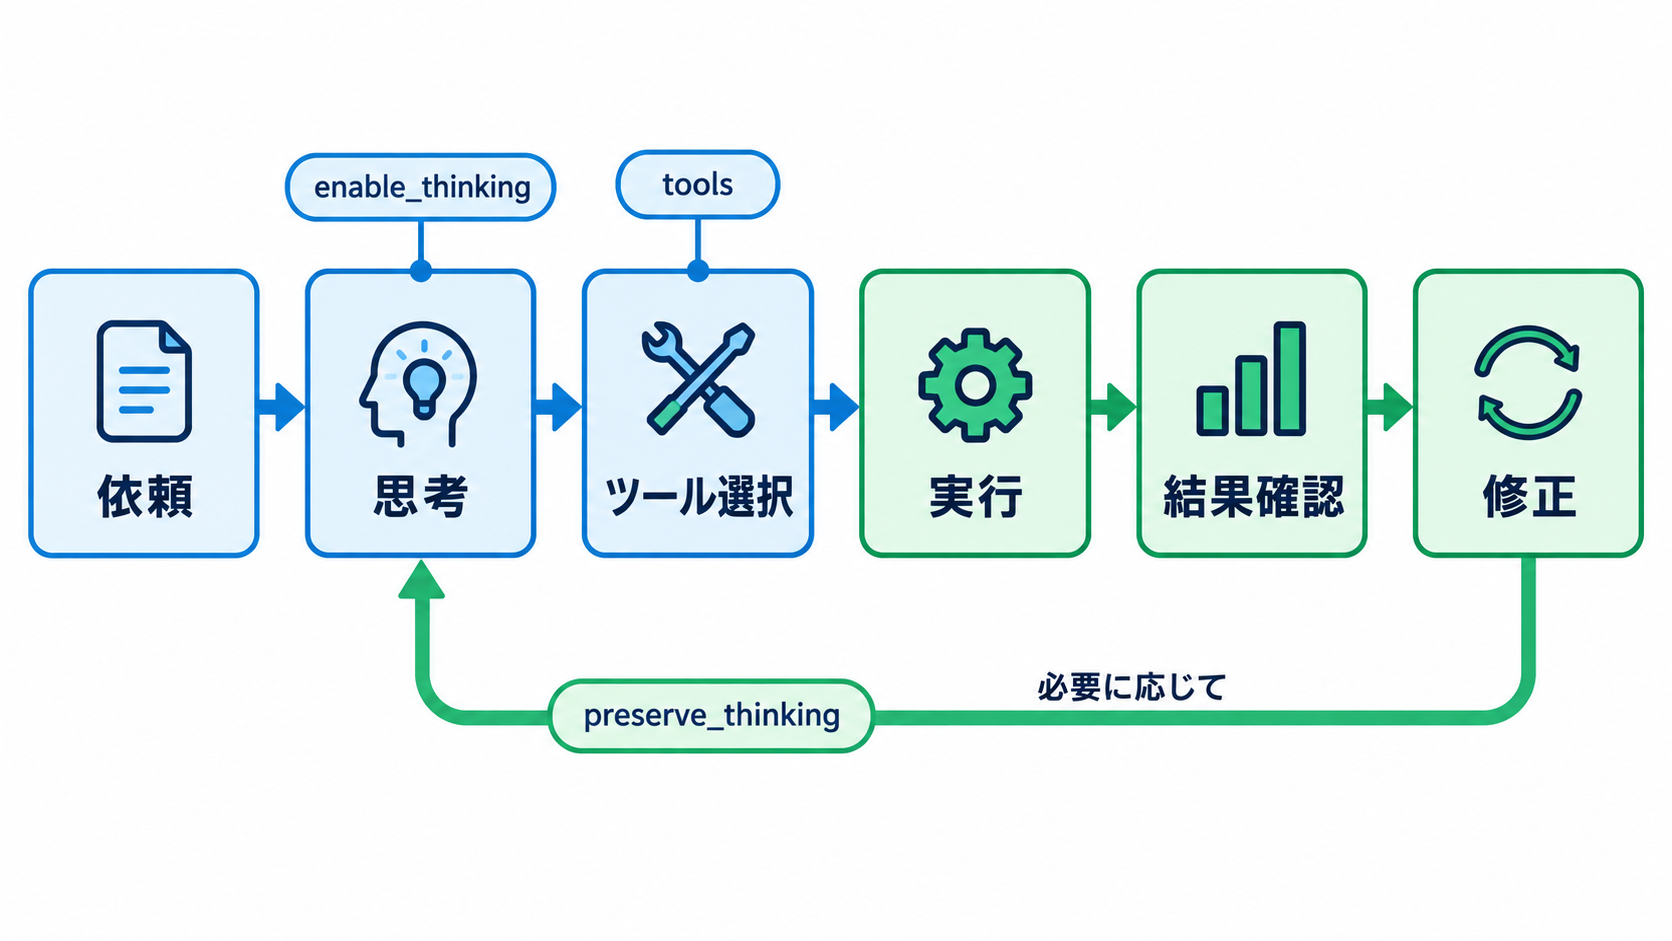
エージェント型AIでは、回答文の巧さよりも、作業をどのような順序で進め、外部ツールの結果を次の判断へつなげるかが問われます。Nanbeige4.3-33Bのチャットテンプレートには、その挙動を調整する三つの制御が用意されています。推論を有効化するenable_thinking、過去ターンの推論を保持するpreserve_thinking、外部ツールを登録するtoolsです。enable_thinkingは初期状態で有効です。単発の質問応答よりも、複数の条件を検討するコード修正や手順設計で利用する想定と考えられます。preserve_thinkingを有効にすると、前のターンで積み上げた推論を後続の会話にも残せます。研究チームは、複数ターンにまたがるツール利用やコードエージェントで、この設定を推奨しています。
toolsを渡すとツール呼び出しが有効になり、呼び出し形式にはXMLが推奨されています。たとえば、モデルがソースコードを確認し、端末でテストを実行し、エラー内容を読んで修正案を作る、といった循環を構成できます。オフィス業務であれば、文書の読み取り、データ処理、成果物の生成という流れへ応用できるでしょう。
ただし、思考履歴を長く保持すれば常に正確になるわけではありません。初期の誤解や不適切な前提まで維持される可能性があるため、工程の節目で状態を要約し、検証済みの事実と仮説を分ける設計が必要です。ツール側にも実行権限、タイムアウト、変更範囲、承認条件を設定しなければなりません。モデルの制御機能は自律性を高める部品ですが、安全な業務フローは利用側が組み立てる必要があります。
17項目で首位とするベンチマーク結果
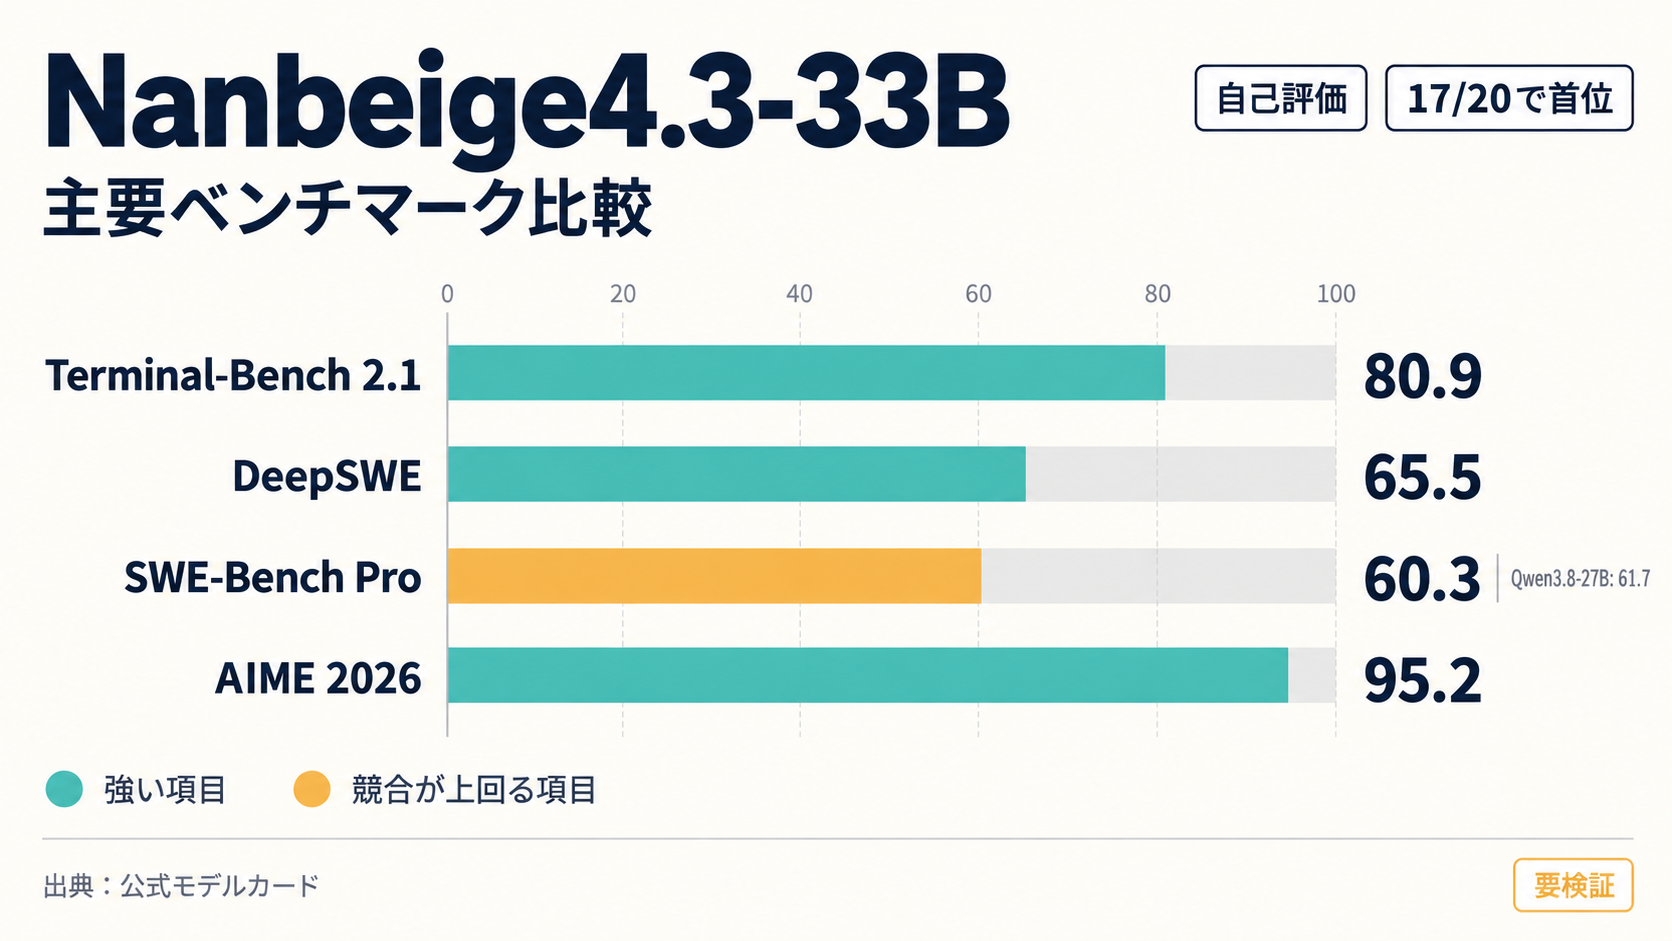
Nanbeige LLM Labは、同規模のオープンモデルであるQwen3.8-27B、Muse-Glimmer-30B、Gemma 4 31Bとの比較を公開しています。合計20項目のうち17項目でNanbeige4.3-33Bが首位になったとしています。各モデルは最大の思考設定を使い、共通のハイパーパラメータと評価環境で測定されたとの説明ですが、数値は研究チームによる自己評価です。エージェント型コーディングでは、Terminal-Bench 2.1が80.9で、Qwen3.8-27Bの73.0を上回りました。DeepSWEでは65.5に達し、比較対象の42.5との差が最も大きくなっています。SWE-Bench Proは60.3で、Qwen3.8-27Bの61.7には届きませんでした。Terminal-Bench 4.0は23.8で、Nanbeige4.3-33B自身の掲載スコアでは最も低い値です。評価セットが変わると成績が大きく変動することも読み取れます。
事務作業を想定した評価では、Automation Benchが54.2、JobBenchが44.8です。比較対象として示されたスコアは、それぞれ38.3と34.5でした。YC-benchでは、シミュレーション上の収益が102万5,437ドルとなり、比較値の64万1,290ドルを上回っています。推論系ではAIME 2026が95.2、AA-LCRが84.0と報告されました。
20項目のうち敗れた残り2項目は、GDPvalの84.8対86.4と、GPQA Diamondの89.5対91.3です。後者はGemma 4 31Bが首位とされています。Baseモデルについても8項目が報告され、Gemma4-31B-Baseをすべて上回ったとの結果です。例として、MMLU-Proは66.9対59.3、GPQAは62.0対41.5でした。
これらの数字は候補モデルを絞る材料にはなりますが、導入判断を直接代替するものではありません。ターミナル操作、実際のソフトウェア修正、数学的推論、模擬業務では、それぞれ測っている能力が異なります。自社が必要とする作業を分解し、近い評価項目を選びながら、失敗時の挙動も含めて確認する必要があります。
競合モデルとの比較で残る数値の不一致
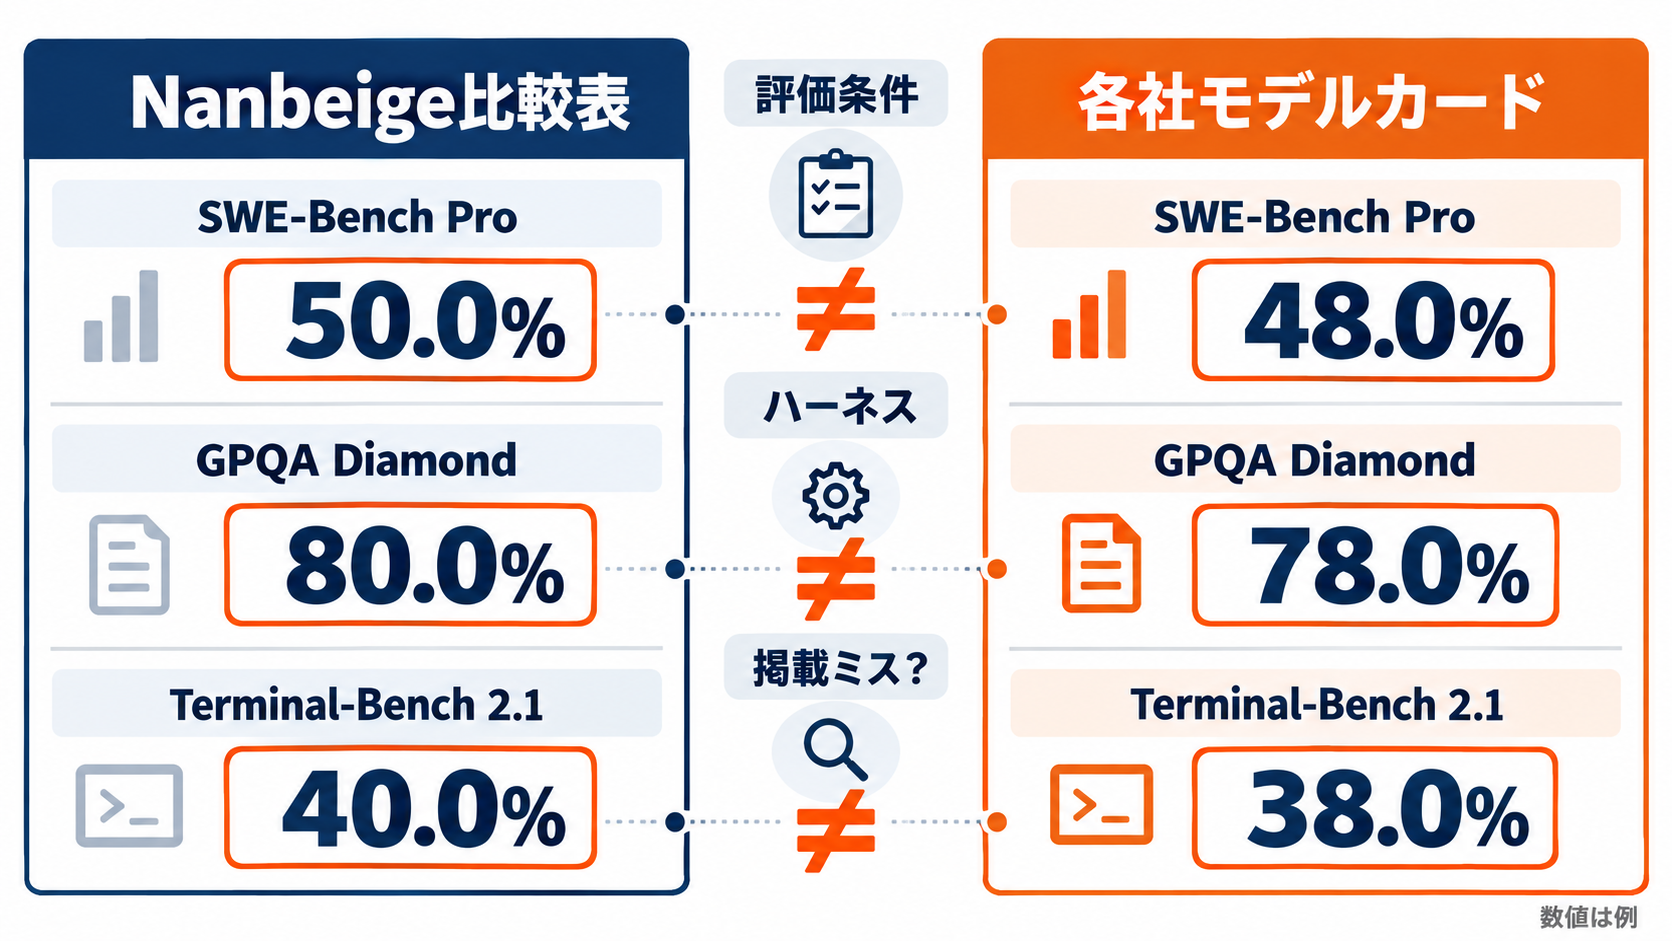
ベンチマーク表を読む際には、同じ名称のテストでも実行条件や集計方法が異なり得る点に注意が必要です。Nanbeige側の比較表と、各競合モデルの開発元が公開するモデルカードを照合すると、複数の数値に食い違いがあります。そのため「17項目で首位」という結果は、統一条件での優位性を示す主張として受け止め、独立した再現結果が出るまでは暫定値として扱うのが妥当です。SWE-Bench Proでは、Meta側の情報がMuse-Glimmer-30Bを51.2、Gemma4-31Bを36.9としていますが、Nanbeigeの表では両者が逆に掲載されています。単なる評価環境の差ではなく、値の対応が入れ替わった可能性を確認すべき箇所です。GPQA Diamondについても、Google側のGemma 4 31Bは84.3ですが、Nanbeigeの比較表では91.3です。
Terminal-Bench 2.1では、MetaがMuse-Glimmer-30Bのスコアを51.7とする一方、Nanbeigeによる測定値は61.8です。こちらは評価ハーネス、推論設定、ツール構成などの違いでも変化し得ます。同名ベンチマークの数字を横並びにする場合は、誰が測定した値か、どの設定を使ったか、再試行回数や集計条件が揃っているかを併記しなければ、精密な比較にはなりません。
性能表にアスタリスクを付けるだけでは、意思決定者が不確実性を把握しにくい場合があります。社内の評価資料では、開発元による自己評価、競合側の公表値、自社で再現した値を別の列に分けると判断しやすくなります。順位が一致しない場合には平均化せず、条件差を調査対象として残すべきです。Nanbeige4.3-33Bの強みを否定する材料ではありませんが、数値の出所を追跡できる状態で比較することがB2B導入の前提になります。
4GPU構成でも見逃せないメモリ負荷
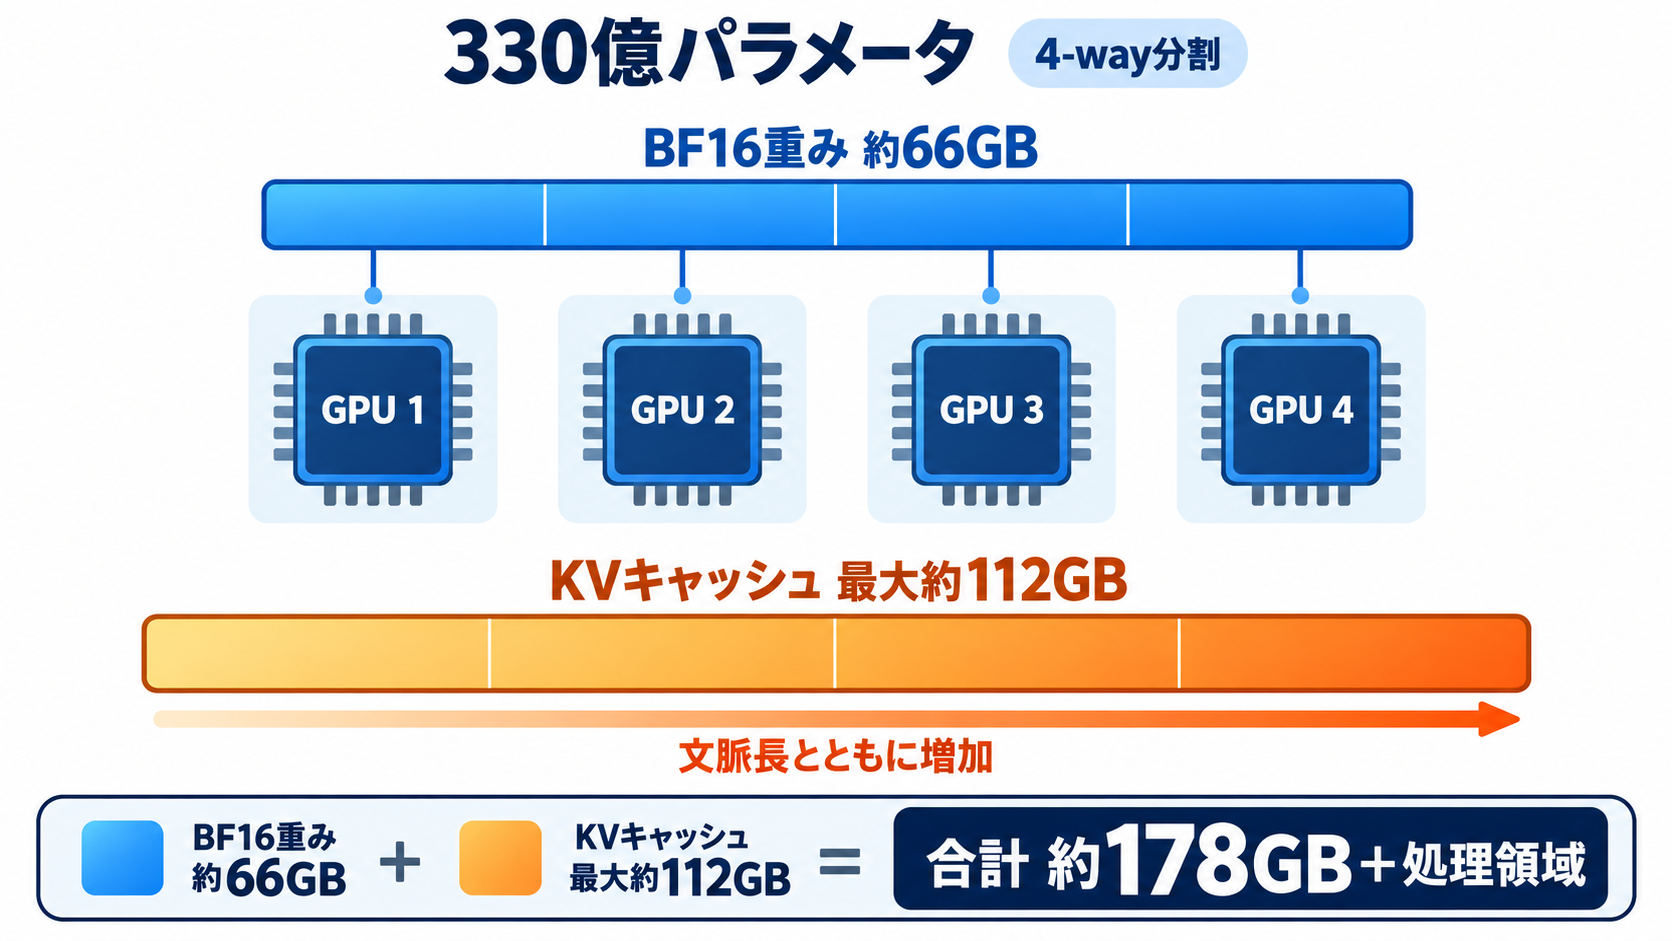
Nanbeige4.3-33Bのモデルカードには、Transformers、SGLang、vLLM向けの実行例が用意されています。SGLangとvLLMのサーバー構成は、モデルを4台のGPUへ分割する4-way Tensor Parallelismを前提としています。Qwen3向けの推論パーサーとツール呼び出しパーサーを使用する例も示されており、単純なテキスト生成よりエージェントサーバーとしての利用が意識されています。330億パラメータをBF16で保持する場合、重みだけで約66GBが必要です。さらに長文生成では、過去のAttention計算に使う情報を保持するKVキャッシュが増えていきます。設定値から算出するとBF16では1トークン当たり約208KiBで、52万4,288トークンをすべて使う場合は約112GBに達します。重みとKVキャッシュだけを単純に合計しても約178GBであり、実際の運用では処理用の領域なども考慮しなければなりません。
推奨されるエージェント設定はtemperature 1.0、top_p 0.95、最大生成長65,536トークンです。推論と通常のチャットについてはtemperature 0.6、最大生成長262,144トークンが示されています。最大値をそのまま本番設定にすると、待ち時間や同時処理数へ影響する可能性があります。用途別に生成上限を設定し、長い出力が本当に必要な工程だけに割り当てる運用が現実的でしょう。
公開時点では、Hugging FaceのInference Providerによるホスティングは提供されていません。コミュニティ作成の量子化版は1件掲載されていますが、精度や対応環境は個別の検証が必要です。4GPUで動かせるという情報だけで設備を決めず、利用する文脈長、同時実行数、量子化の有無、許容応答時間を含めて容量を見積もる必要があります。
日本企業が評価するときの現実的な進め方
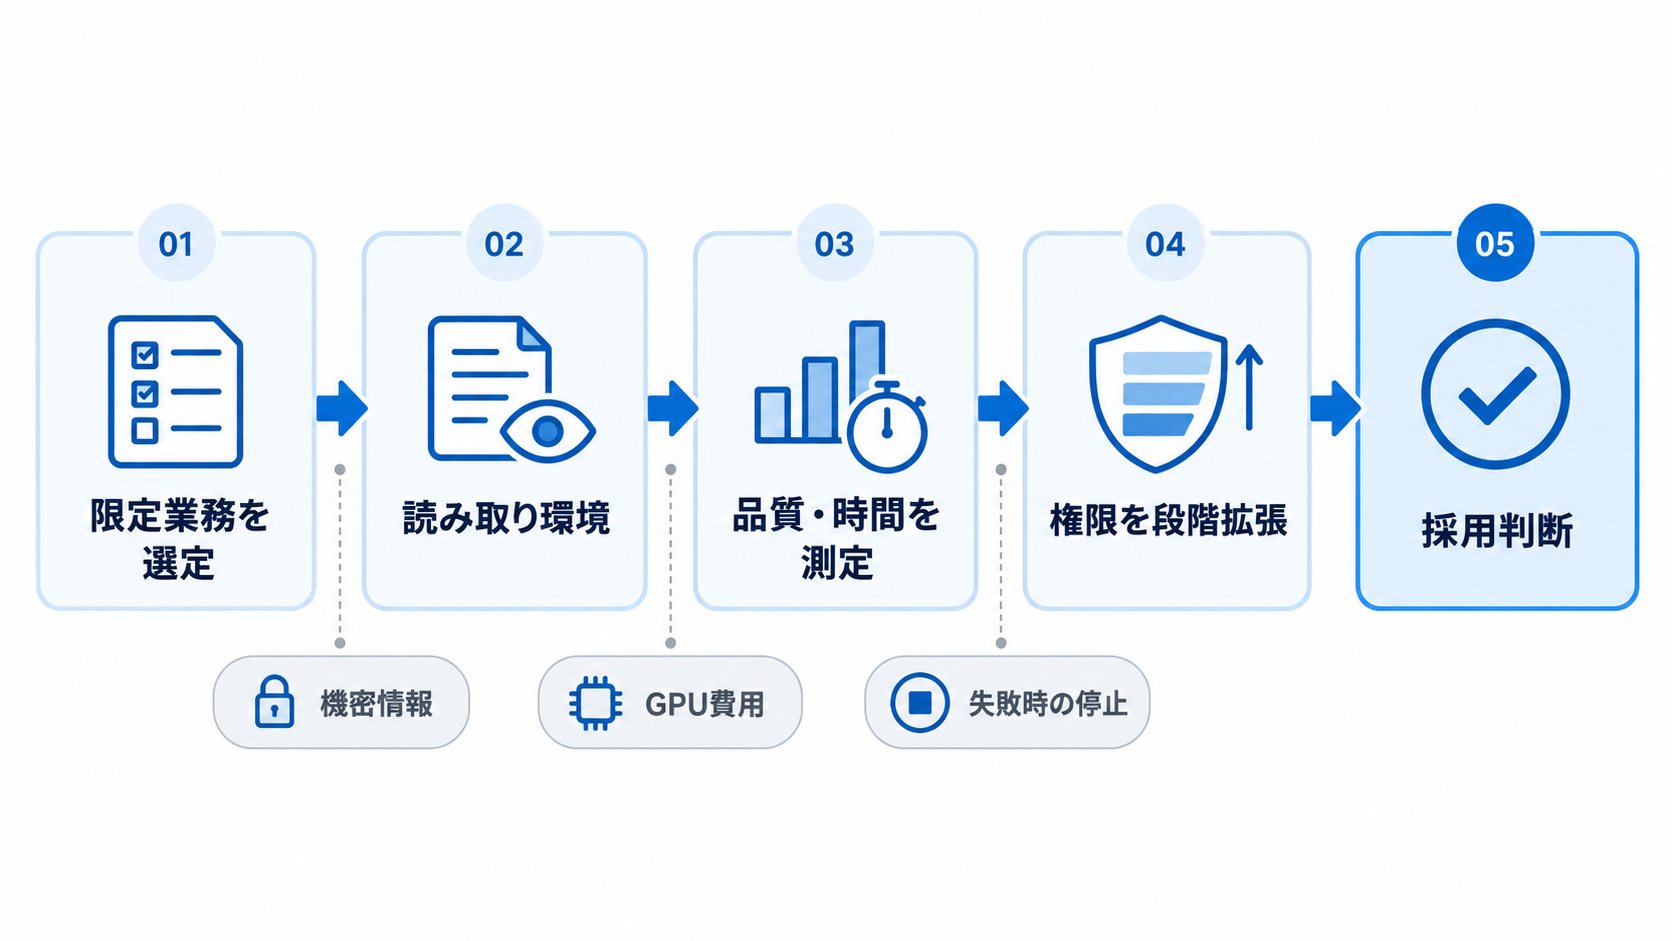
Nanbeige4.3-33Bを企業で試すなら、公開ベンチマークの再現から始めるより、自社業務を小さく切り出した評価が適しています。候補としては、既存コードの調査、限定された不具合修正、テスト生成、複数資料からの報告書作成などが考えられます。いずれも正解や完了条件を明確にしやすく、モデルが途中で誤った場合の原因も追跡しやすい作業です。評価では、最終成果物の正否だけでなく、ツール呼び出しの成功率、不要なファイル変更、処理時間、GPUメモリ使用量、人による修正時間を記録すると比較しやすくなります。長文処理を試す場合も、512Kまで一気に入力する必要はありません。実務で多い長さから段階的に増やし、必要情報の見落としや指示追従がどの時点で不安定になるかを確認します。
Apache 2.0は企業が検討しやすい許諾形態ですが、採用時にはモデル本体だけでなく、量子化物、追加データ、周辺ソフトウェアの条件も確認してください。コード実行や文書操作を許可する場合は、読み取り専用環境から開始し、書き込みや外部通信を個別に開放する設計が安全です。preserve_thinkingを利用するセッションでは、保持される情報の範囲や機密データの混入にも注意が要ります。
現時点で最も確かめる価値があるのは、自己評価で大きな差が出たDeepSWEやTerminal-Bench 2.1に近い作業を、自社のリポジトリで再現できるかです。そこで既存モデルより作業完了率や修正時間が改善し、必要な計算資源を許容できるなら、限定チームでの検証へ進めます。差が小さい場合は、今後予定される小型モデルや独立評価を待つ判断も合理的です。