AI LAB
2026/10/11
Microsoft「Decision-1」が示す生成AIの次の競争軸――文章生成から高速な判断処理へ
Microsoftが参入した「判断」に特化するAIモデル市場
企業で生成AIを運用すると、長い回答を書かせるよりも、「この問い合わせをどこへ回すか」「この出力は基準を満たすか」といった短い判断を何度も求める場面が増えてきます。Microsoftが公開したDecision-1は、まさにこうした処理を担う決定モデルです。分類、評価、ルーティングを主な用途とし、複雑な環境で動くAIエージェントを誘導・制御できる可能性があると同社は説明しています。ここでいう決定モデルは、人間に代わって経営判断を下す巨大なシステムを意味しません。入力された情報を所定の選択肢へ振り分けたり、一定の基準で評価したり、次に実行すべき処理を選んだりするモデルです。自由な文章を生成する汎用モデルと比べて、回答の豊かさより、速さ、一貫性、形式の扱いやすさが重視されます。
Decision-1以前にも、JevやOpenAI、Cloudflareが同種の領域へ進出していました。なかでもJevは9月中旬にこの潮流を先導した新興企業として紹介されています。しかし、Microsoftの参入によって、決定モデルは限られた企業の実験ではなく、主要なAI事業者が競争する製品カテゴリーとして意識されることになりそうです。
企業利用の観点では、Decision-1単体の性能だけが焦点ではありません。文章を作るモデルと、処理の行き先を決めるモデルを分ける設計が現実味を帯びた点に意味があります。高性能な汎用モデルをあらゆる処理に使うのではなく、判断回数が多い部分を小型で高速なモデルへ任せれば、応答時間と費用を抑えられる可能性があります。Decision-1は、生成AIシステムの裏側で動く「交通整理役」をめぐる競争の加速を象徴する製品と考えられます。
分類・評価・ルーティングを分担する仕組み
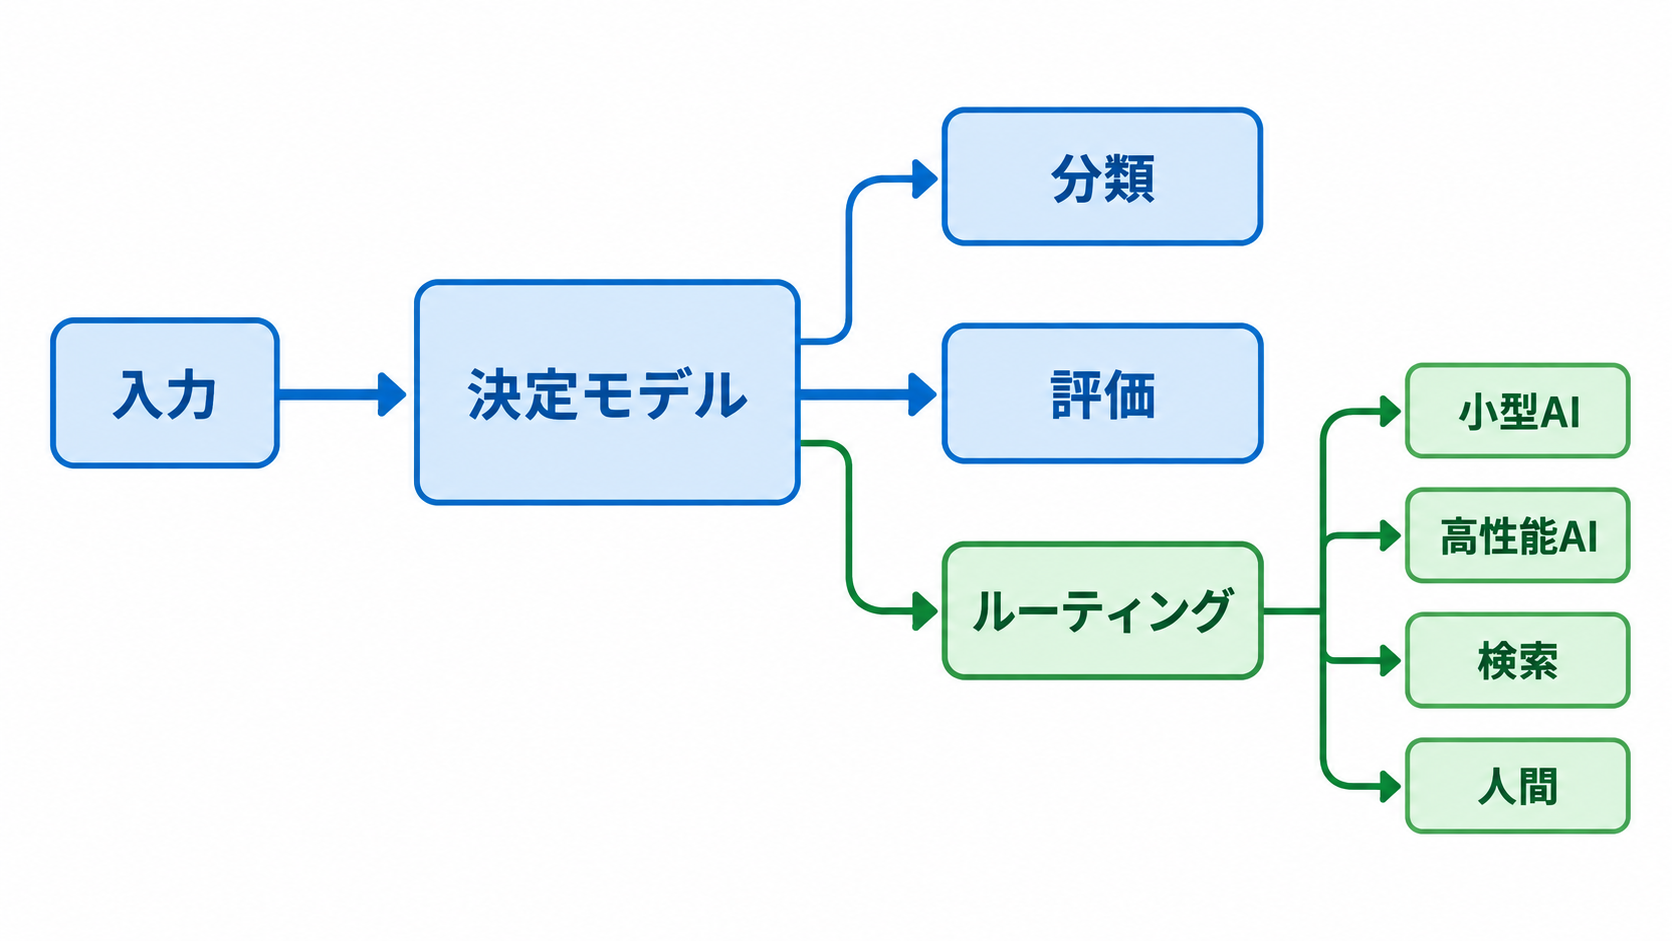
Decision-1が対象とする三つの処理は似ているように見えますが、システム内での役割は異なります。分類は、入力内容をあらかじめ定めたカテゴリーへ割り当てる処理です。たとえば社内窓口へ届いた質問を、人事、経理、情報システムといった担当領域へ分ける用途が考えられます。モデルが回答そのものを作らなくても、正しい処理経路を選べれば業務全体の待ち時間を短縮できます。評価は、別のモデルが生成した回答や処理結果を基準に照らして判定する役割です。内容が質問に対応しているか、指定された形式を守っているか、再処理が必要かといった判断に利用できるでしょう。ただし、Decision-1が個別企業の規則や専門分野をどの程度理解できるかは、導入環境ごとの検証が必要です。
ルーティングは、複数のモデルや外部ツールの中から、次に利用する処理先を選ぶ仕組みです。簡単な質問は低コストのモデルへ送り、難しい質問だけを高性能なモデルへ渡す構成や、入力の種類に応じて検索、計算、データベース照会を切り替える構成が想定できます。判断を小型モデルへ切り出すことで、汎用モデルに毎回すべてを考えさせる必要がなくなります。
Microsoftが言及するAIエージェントとは、指示に答えるだけでなく、目的に応じてツールを選び、複数の処理を順番に実行するソフトウェアを指します。エージェントの選択肢が増えるほど、適切な行動を素早く選ぶ制御層が欠かせません。もっとも、モデルの判定をそのまま実行へ移すと、誤分類が後続処理へ連鎖するおそれがあります。権限を伴う操作では、実行可能な行動を限定し、判断結果を記録し、人間へ戻す経路を用意する設計が求められるでしょう。
83.5%の精度と85ミリ秒をどう読むか
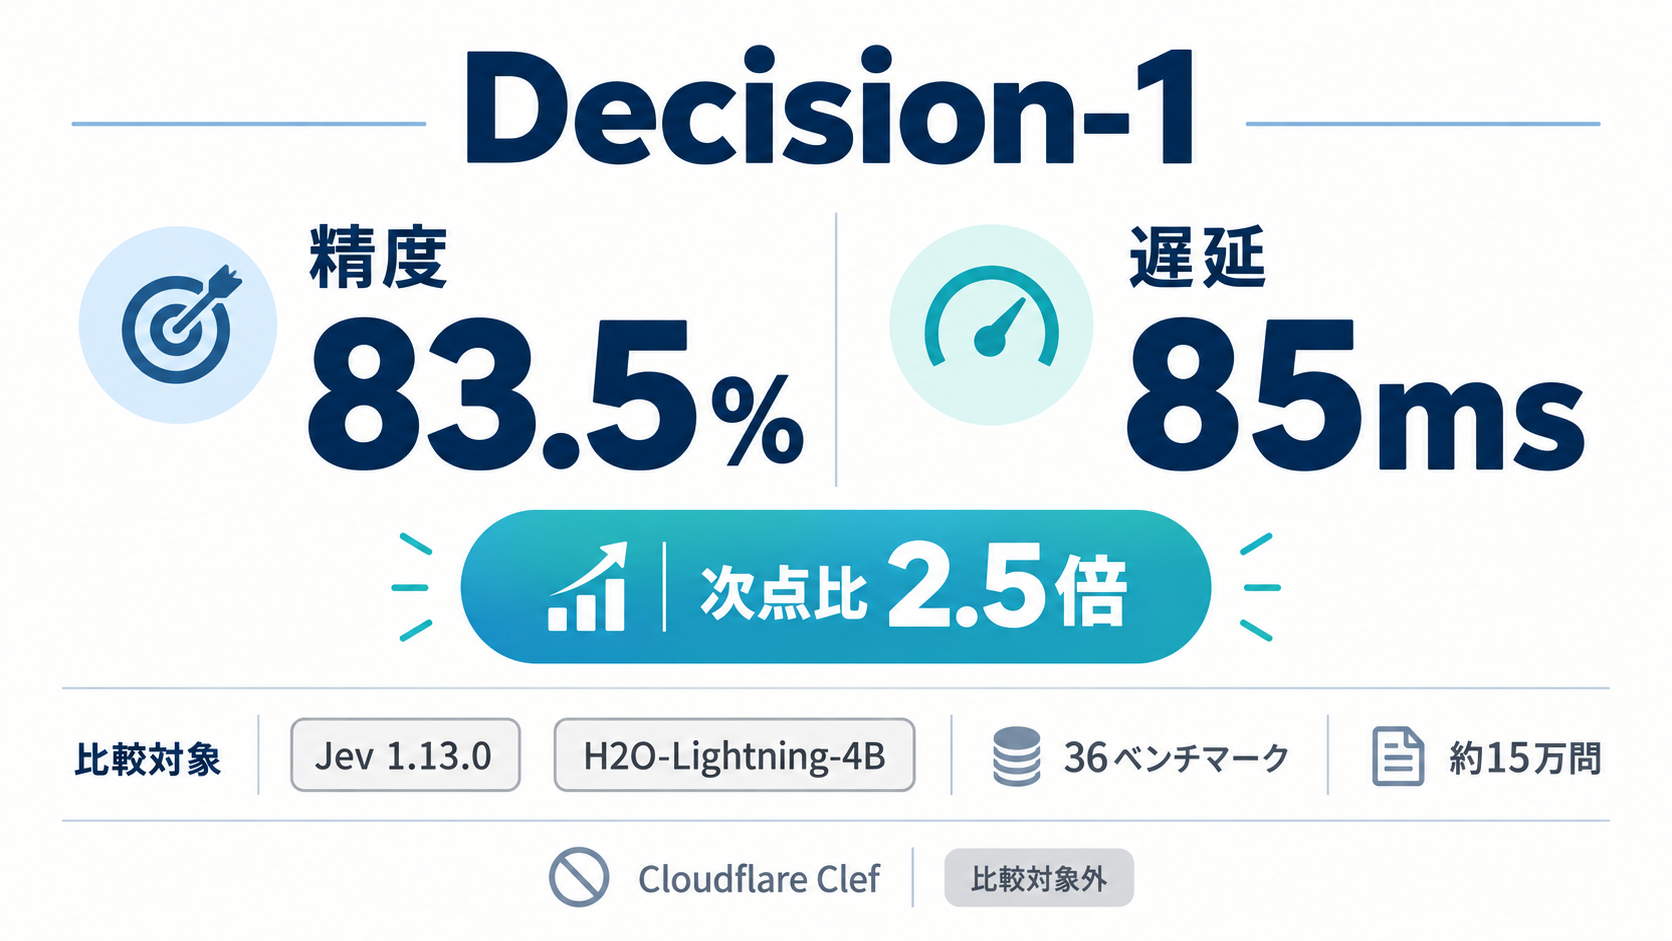
Microsoftの比較によると、Decision-1は36種類のベンチマーク、合計約15万問を対象としたテストで、同社が検証したモデルの中で最も高い精度を記録しました。示された数値は精度83.5%、レイテンシー85ミリ秒です。速度では、次点となったH2O-Lightning-4Bの2.5倍だったとされています。精度と応答速度を同時に求める決定モデルにとって、この組み合わせは製品上の主要な訴求点です。85ミリ秒という短い待ち時間は、単発のチャットよりも、多数の判断を連続して行うシステムで効果を発揮すると考えられます。AIエージェントが一つの作業中に何度も分類や経路選択を行う場合、各判断の遅れは最終的な応答時間へ積み重なるためです。ただし、実際のサービスでは通信時間、混雑状況、前後の処理も加わります。モデル単体のレイテンシーを、利用者が体感する処理時間と同一視することはできません。
精度83.5%についても、数字だけで導入可否を決めるのは早計です。判断項目の難しさや正解の定義、業務上許容できる誤りの種類によって、同じ精度でも価値が変わります。広告の分類ミスと、契約や権限に関する判定ミスでは、企業が負う影響が大きく異なるでしょう。平均精度だけでなく、カテゴリーごとの誤りや、判定が不安定になる入力を確認する必要があります。
比較対象にも注意が要ります。CloudflareのオープンソースモデルClefは、Decision-1と同じくQwen系モデルを基盤としていますが、今回の比較には含まれていません。試験環境、各モデルの設定、言語別の結果なども、確認できる情報だけでは十分に判断できません。公表値は有力な手掛かりですが、自社データを使った再検証を置き換えるものではないという読み方が妥当です。
低価格と二つの提供経路がもたらす導入余地
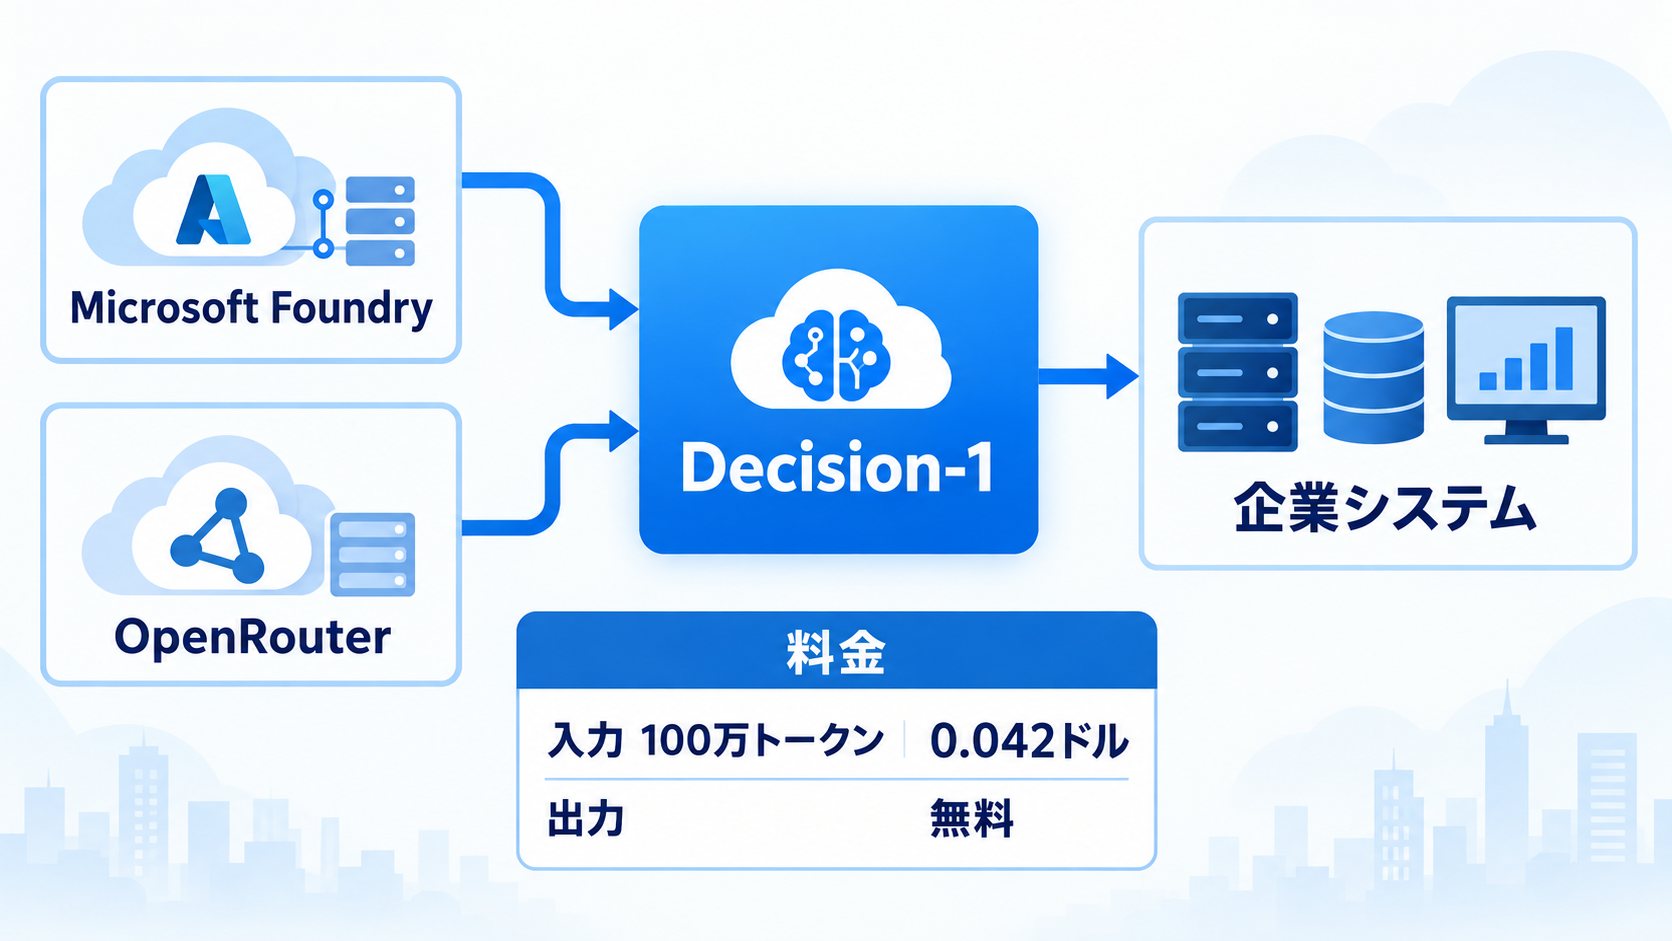
Decision-1はMicrosoft FoundryとOpenRouterを通じて利用できます。Microsoft FoundryはMicrosoftのAI開発・運用環境で、OpenRouterは複数のAIモデルへのアクセスを仲介するサービスです。既存のMicrosoft環境に組み込みたい企業と、複数モデルを比較しながら使いたい開発者の双方に接点が用意された形になります。料金は入力100万トークン当たり0.042ドルで、出力トークンは無料とされています。決定モデルが返す内容は、長い文章ではなく、カテゴリー名や評価値、処理先などの短い結果が中心になると考えられます。そのため、入力側の価格を低く設定し、出力を無料にする料金体系は、モデルの用途と整合しています。ただし、適用条件や周辺サービスの費用まで無条件に無料になるとは限らないため、実装時には利用する提供経路の課金条件を確認すべきでしょう。
低い単価が効いてくるのは、一度の判断ではなく呼び出し回数が増えたときです。問い合わせの振り分け、生成結果の確認、利用モデルの選択を一つの処理で繰り返せば、判断モデルへのアクセスは利用者数以上に増える可能性があります。各処理へ高価な汎用モデルを割り当てる構成と比較すると、専用モデルを挟むことで総費用を抑えられる余地があります。
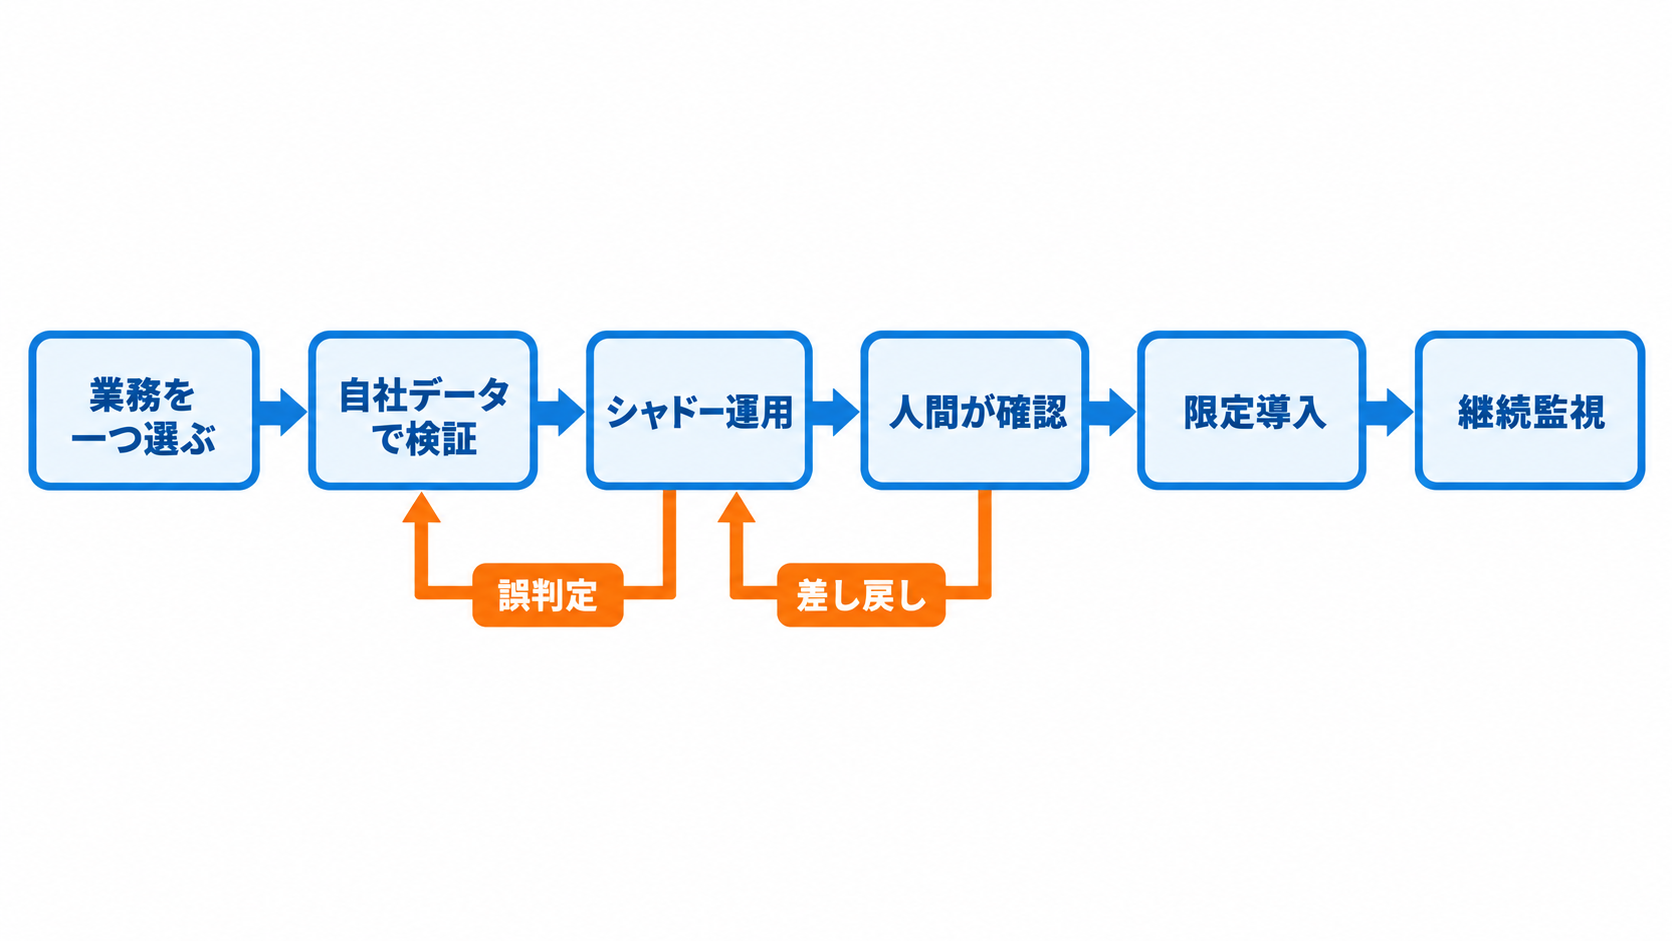
もっとも、APIの価格は運用コストの一部にすぎません。判定基準の設計、テストデータの整備、ログの保存、誤りの監視、障害時の切り替えにも費用がかかります。単価が安いからといって、精度確認を省いたまま重要な業務へ広げるのは適切ではありません。最初は処理を自動実行せず、既存の担当者やシステムと並行して判定結果を記録する「シャドー運用」から始めると、価格上の利点と業務上のリスクを分けて評価しやすくなります。
Qwenベースの小型モデルが変える競争条件
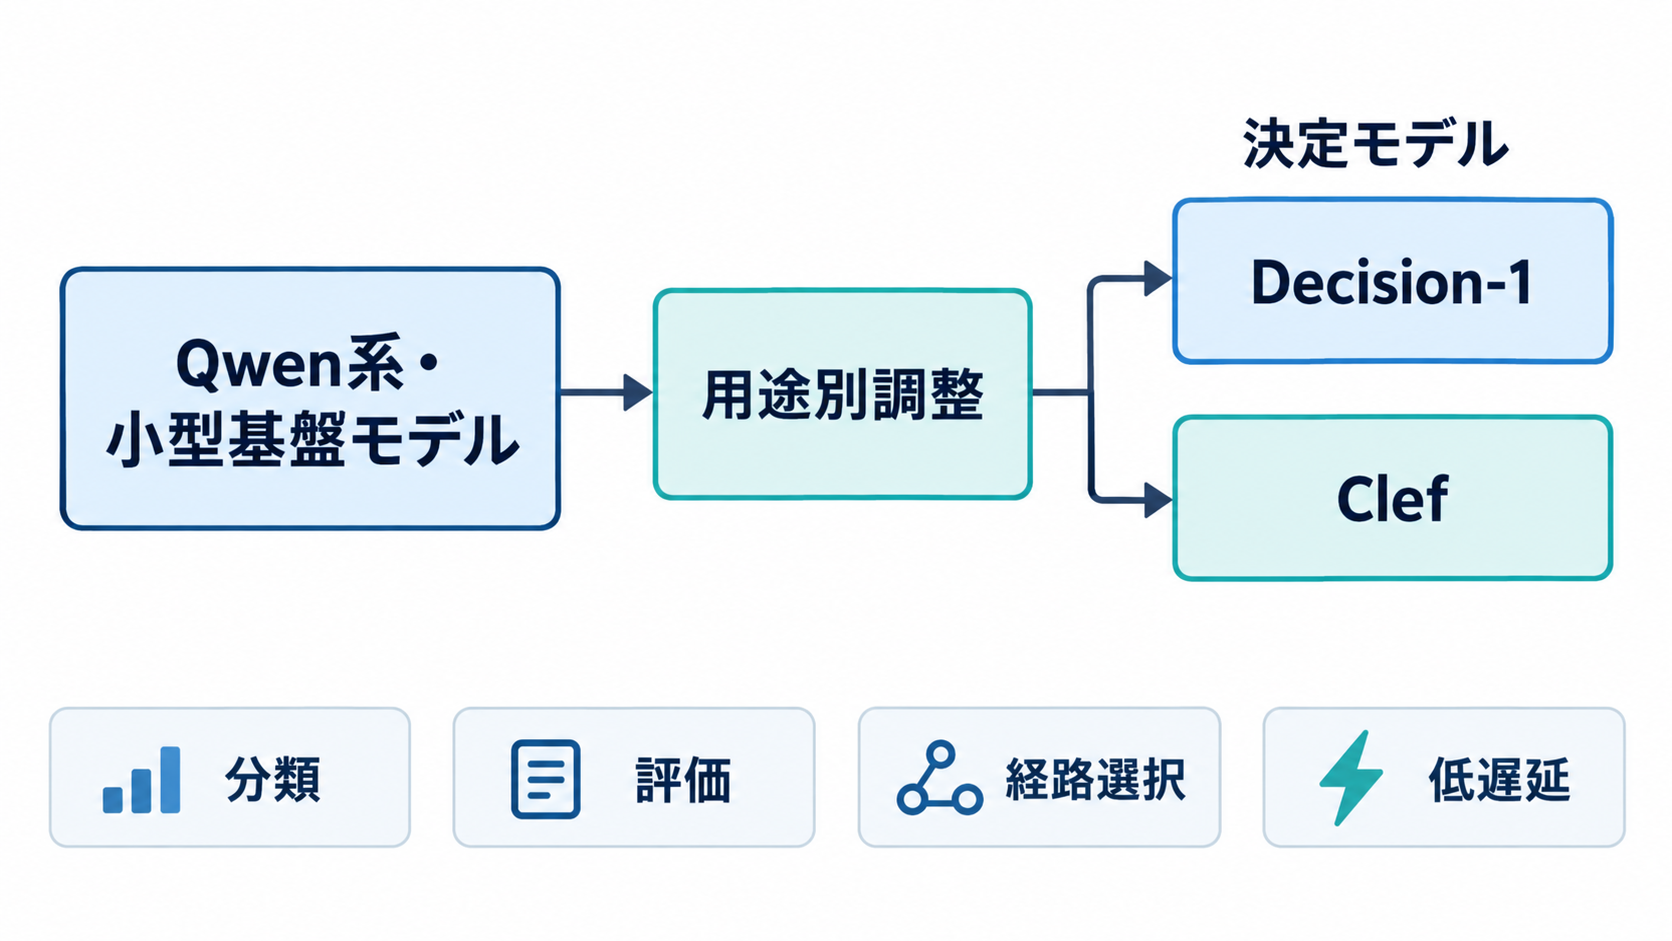
Decision-1はQwen3.5-9Bを基盤としています。Qwenは中国のAlibaba系で開発されてきた言語モデル群として知られ、Decision-1のほか、CloudflareのClefにもQwen系モデルが使われています。Microsoftが完全に新しい基盤モデルを一から作るのではなく、既存の小型モデルを特定用途へ適応させた点は、決定モデル市場の競争を理解するうえで見逃せません。大規模な文章生成では、モデルの知識量や表現力が差になりやすいのに対し、分類やルーティングでは、限られた選択肢から素早く安定した答えを返す能力が優先されます。用途を絞れば、小型モデルでも競争力を持てる可能性があります。必要な計算量や待ち時間を抑えやすいことも、呼び出し頻度の高い制御層には都合がよいでしょう。
Jevは9月中旬に決定モデルの流れを作った新興企業として位置付けられています。しかし、その発想は短期間で他社に取り入れられ、オープンな小型言語モデルを利用した製品によって追随されました。記事の著者は、Jevにとって厳しい数週間になった可能性を指摘しています。これは、発想を最初に示すことと、長期的な優位を維持することが別問題であることを表しています。
企業側から見ると、モデル名だけでなく、独自性がどこにあるかを見極める必要があります。基盤モデルを他社も利用できるなら、差が生まれる場所は学習・調整方法、評価データ、運用基盤、監視機能、既存システムとの接続へ移るでしょう。Decision-1の登場は、小型モデルでも用途を明確にすれば製品化できることを示す一方、同種のサービスが早く増え、性能差が縮まりやすい市場構造も示唆しています。
日本企業が試すなら「戻せる判断」から
Decision-1を試す際は、処理速度の速さだけを理由に全面導入するのではなく、誤った判定を後から修正できる業務を選ぶことが現実的です。候補になりやすいのは、問い合わせの一次振り分け、文書の種類判定、生成結果の形式確認などです。仮にモデルが誤っても、担当者が訂正でき、顧客や基幹システムへ直ちに重大な影響が及ばない領域が適しています。検証では、日常的な入力だけでなく、部門をまたぐ曖昧な問い合わせ、文章が極端に短い入力、複数の意図を含む依頼も混ぜるべきでしょう。全体の正解率に加えて、本来は人間へ回すべき案件を自動処理へ送っていないか、特定カテゴリーだけ誤りが集中していないかを確認します。日本語や社内用語に関する詳細な性能は、公開された数値だけでは判断できないため、自社で実際に使われている表現を含むデータが欠かせません。
運用設計では、モデルが選べる処理先を限定し、判断結果、入力、実行した処理を追跡できる形で残します。信頼度が低い場合や、複数の規則が競合した場合に、人間または既存ルールへ戻す経路も必要です。契約、採用、与信、アクセス権限など、誤判定の影響が大きい領域では、決定モデルを最終承認者にせず、確認材料や一次判定として位置付ける方が安全でしょう。
比較試験では、Decision-1だけを単独評価するより、現在使用している汎用モデル、ルールベース処理、別の小型モデルを同じデータで比べると判断しやすくなります。精度、応答時間、処理単価に加え、理由を追跡できるか、障害時に切り替えられるか、判定基準を更新しやすいかも評価項目になります。専用モデルへ置き換える価値は、ベンチマーク順位ではなく、業務全体の待ち時間と修正作業が実際に減るかどうかで決まります。
Decision-1が示す生成AIシステムの分業化
Decision-1の登場から読み取れる中心的な変化は、生成AIの競争が「最も賢い一つのモデル」を選ぶ段階から、複数のモデルやツールをどう分担させるかという段階へ移りつつあることです。文章作成は汎用モデル、情報取得は検索機能、計算は専用ツール、経路選択は決定モデルという構成なら、それぞれの処理に合った性能と費用を選べます。この分業型の構成では、Decision-1のようなモデルが利用者から見えない場所で重要な役割を担います。判断が正しければ後続処理は効率化されますが、最初の経路選択を誤ると、高性能なモデルやツールを用意していても期待した結果へ届きません。制御層を軽視せず、個々の生成結果と同じように継続的な評価対象とする必要があります。
市場では、先行したJevに続いてMicrosoft、OpenAI、Cloudflareが関連モデルを展開しています。小型の基盤モデルを特定用途へ適応できるため、新規参入や性能改善の速度は今後も速いと考えられます。現時点の首位が長く続くとは限らず、企業が特定モデルの名称だけを前提にシステムを固定すると、より適した選択肢へ切り替えにくくなるでしょう。入出力形式や評価方法を共通化し、モデルを交換できる構成にしておくことが実務上の備えになります。
導入を検討する企業が最初に行うべきなのは、大規模なAIエージェント計画を立てることではありません。現在、人が繰り返している単純な振り分け作業を一つ選び、過去の入力と正しい処理先を小規模な評価データとして整えることです。その同じデータをDecision-1と既存手段へ与え、誤りの内容、待ち時間、費用、修正の手間を比較すれば、自社に専用の決定モデルが必要かを具体的に判断できます。