AI LAB
2026/10/14
会話をクラウドに送らず詐欺を検知、Google DeepMindとシンガポール政府が示すオンデバイスAIの設計
会話で信用させる詐欺に、検知技術が追いつけない理由
銀行や公的機関の担当者を名乗る相手からメッセージが届き、何度か自然なやり取りを重ねた後で送金や認証情報を求められる――。シンガポールで深刻化しているのは、単純な不審リンクだけでは判別しにくい、会話型の詐欺です。Google DeepMindによると、同国では詐欺が報告犯罪の半数を超え、2019年以降の損失額は累計40億シンガポールドルを上回っています。なかでも、相手の心理を誘導するソーシャルエンジニアリング型の手口が、損失全体の最大80%を占めています。従来型のフィルターは、不審なURLや既知のキーワード、送信元などを手掛かりにできます。しかし、詐欺師が時間をかけて信用を築き、もっともらしい事情を説明してから行動を促す場合、個々のメッセージだけを見ても危険性が表れないことがあります。「至急」「本人確認」といった単語を遮断するだけでは、正常な連絡との区別も難しくなるでしょう。
Google DeepMindとシンガポール政府のデジタルサービスを担うGovernment Technology Agency、通称GovTechが共同開発したのは、こうした会話の流れを端末上で評価する詐欺検知モデルです。両者のNational AI Partnershipの一環として、シンガポールで一般的に利用されるスマートフォンで動作するよう最適化されました。焦点は、単に検知精度を高めることではありません。私的な会話を外部に開示せず、被害が発生する前の段階で利用者に注意を促すという、保護とプライバシーの両立にあります。
地域固有のだまし方を学ぶGemmaの役割
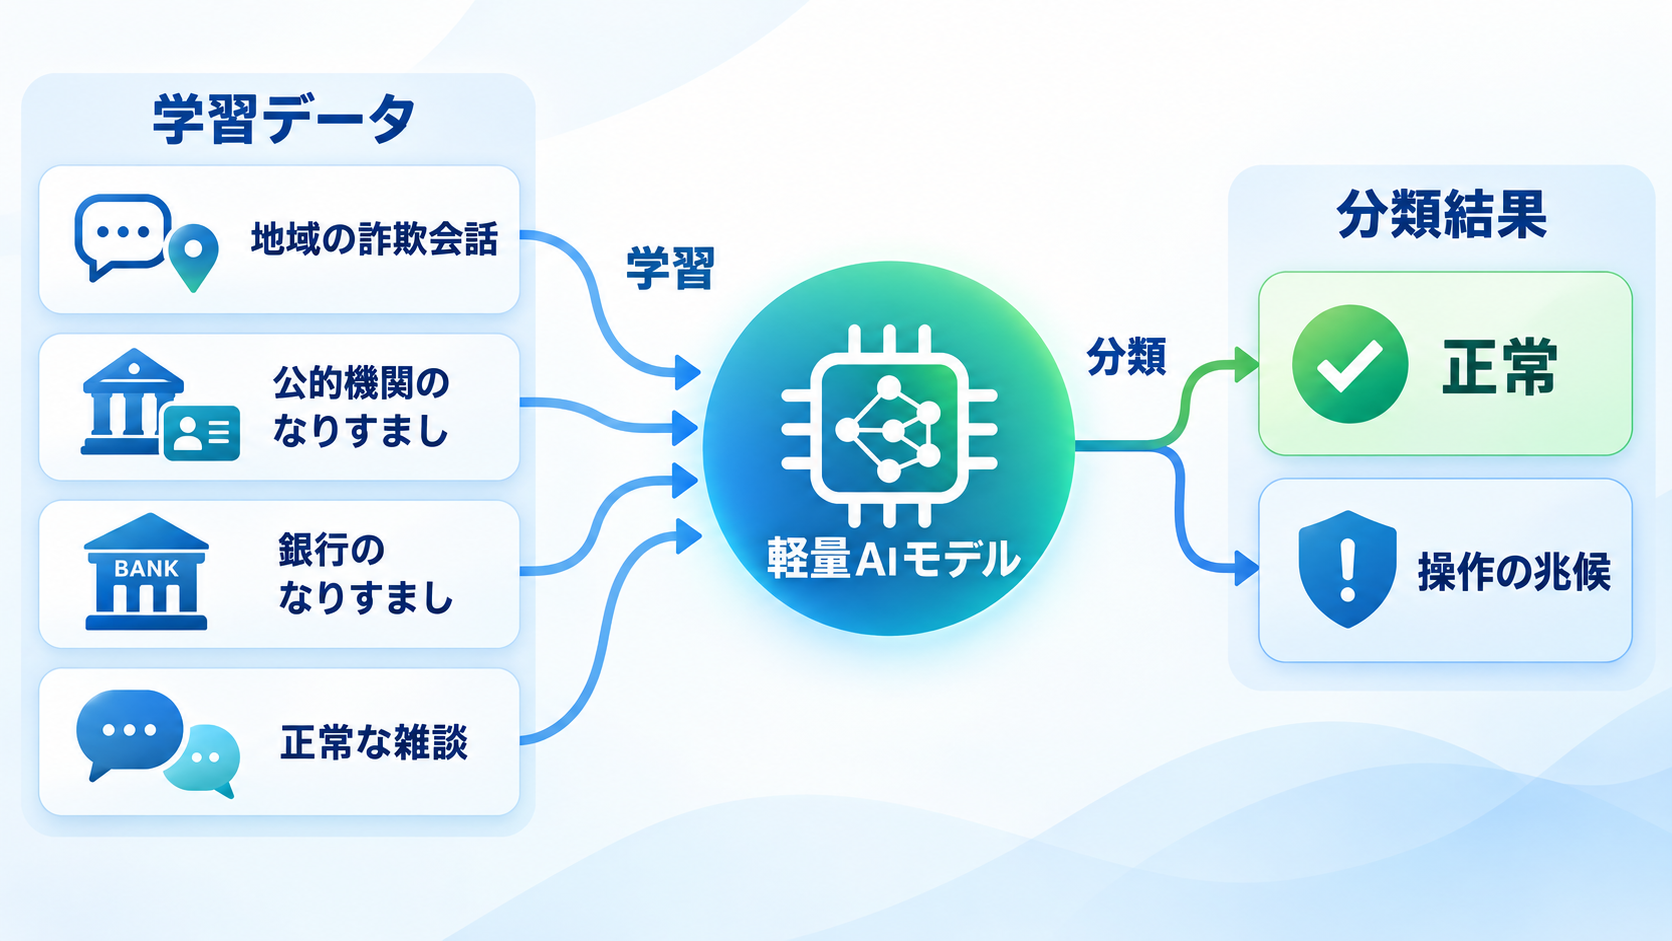
詐欺の会話には、その地域で通用する肩書、組織名、言い回し、社会的な出来事が使われます。ある国で有効な検知モデルを別の国へそのまま持ち込んでも、現地では自然な連絡と不自然な誘導を正確に区別できない場合があります。汎用モデルが抱えるこの弱点に対応するため、共同チームはGoogle DeepMindの軽量なGemmaモデルを、シンガポールの詐欺会話に合わせてファインチューニングしました。学習対象には、公的機関、銀行、地域で知られる人物などへのなりすましに加え、その時々に広がっている域内の詐欺パターンが含まれています。狙いは特定の単語を探すことではなく、雑談や正当な案内と、相手を操作して金銭や情報の提供へ導く会話とを見分けることです。ファインチューニングとは、基礎となるモデルの能力を生かしながら、特定の用途や文脈に合うデータで追加調整する方法を指します。
ここで地域対応は、単なる翻訳とは異なります。同じ依頼でも、誰がどのような順序で伝えたか、現地で信頼されやすい組織をどう名乗ったかによって危険度は変わります。今回の取り組みは、詐欺対策に必要なのが言語への対応だけではなく、地域特有の社会的文脈への適応であることを示しています。ただし、検知精度や誤検知率、対応言語ごとの評価結果といった数値は、現時点で詳しく示されていません。実運用を判断するには、地域別の検証結果を継続的に確認する必要があります。
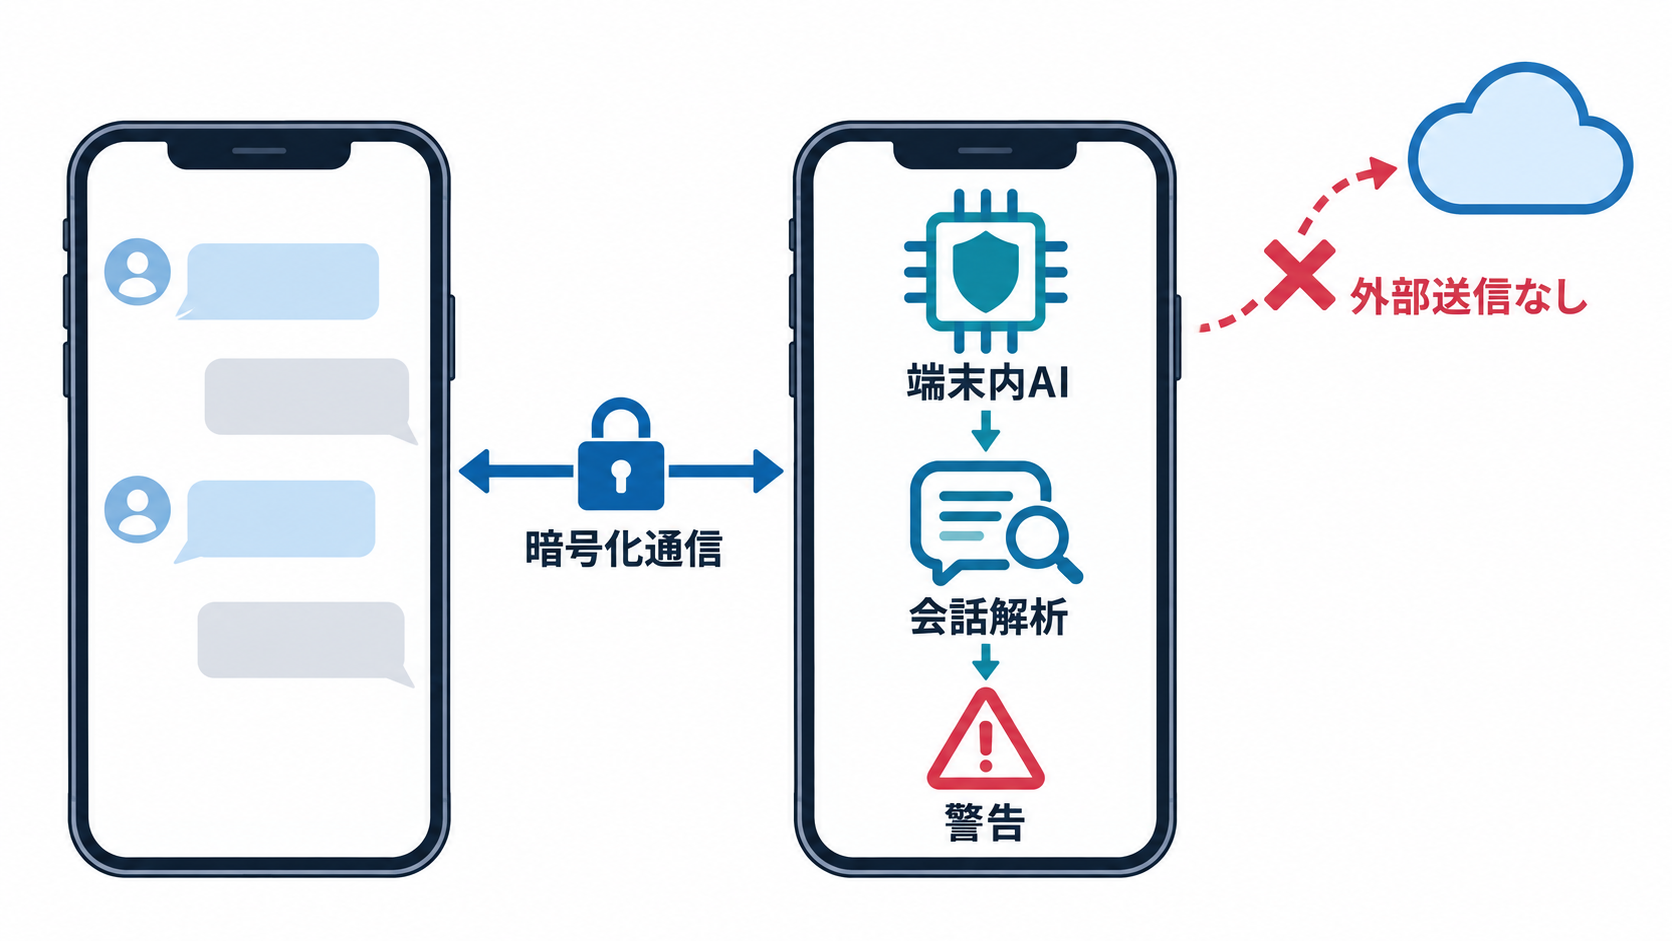
エンドツーエンド暗号化を崩さない端末内解析
メッセージサービスの安全対策には難しい制約があります。サーバー側で会話を解析すれば、不審なパターンを一括して検知しやすくなりますが、通信内容を送信者と受信者以外から読めないようにするエンドツーエンド暗号化とは両立しにくいからです。サービス提供者自身も会話を閲覧できない設計では、クラウド上の検査機能が本文へアクセスすることもできません。共同チームが採用した考え方は、会話を解析基盤へ移すのではなく、解析機能を利用者のスマートフォンへ持ち込むことです。メッセージの文脈を端末内で処理するため、私的な会話を外部へ公開せずに、操作的な意図の兆候を調べられます。クラウドとの往復を前提としないので、危険な会話が進んでいる最中に、より素早く判定できる利点も見込まれます。
オンデバイスAIとは、推論処理の主要部分をクラウドではなく、スマートフォンやパソコンなど利用者の機器で実行する方式です。通信環境への依存を抑えられ、解析対象のデータを手元に残しやすい反面、利用できる計算能力、メモリー、電力には限りがあります。高性能なモデルを用意するだけでは実用にならず、端末の制約に合わせてモデルの規模や処理回数を調整しなければなりません。今回の設計で軽量なGemmaが選ばれた背景にも、会話理解と端末上の実行効率を両立させる必要があります。プライバシー保護を方針として掲げるだけでなく、データが移動する範囲そのものを狭めた点が、この構成の核心です。
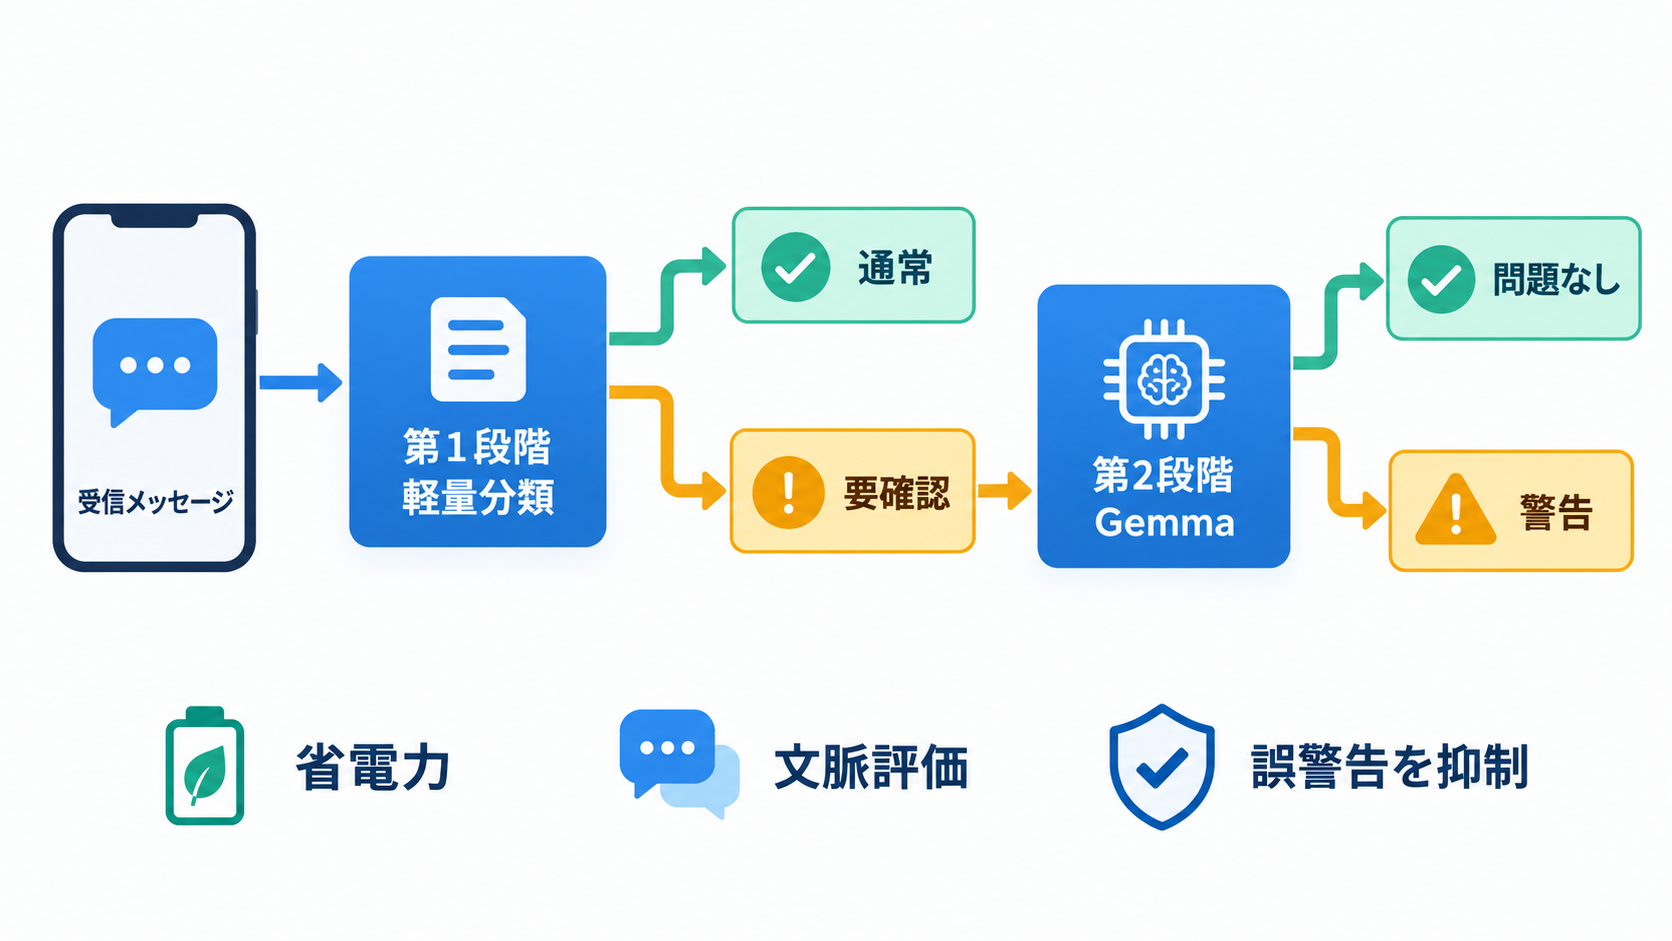
電池消費を抑える二段階の検知パイプライン
すべての受信メッセージに対して、会話全体を読む高度なモデルを常時動かせば、スマートフォンの処理負荷や電池消費が増えます。安全機能であっても、端末が熱くなる、動作が遅くなる、充電が早く減るといった状態が続けば、利用者に無効化されかねません。共同チームはこの問題に対し、軽い一次判定と、文脈を読む二次判定を組み合わせた二段階のパイプラインを採用しています。第1段階では、省電力な軽量分類器が受信メッセージを確認し、潜在的な脅威の候補を絞ります。通常の会話の大半はこの段階で処理できるため、計算量の大きいモデルを毎回起動する必要がありません。疑わしい兆候が見つかった場合に限り、第2段階へ進みます。
第2段階では、シンガポール向けに調整されたGemmaが、より広い範囲の会話を参照します。単独では怪しく見える表現でも、前後関係を踏まえて問題がなければ警告を見送れます。反対に、一つひとつの文章が自然でも、会話全体として送金や機密情報の開示へ誘導していれば、脅威として確かめられる可能性があります。軽量分類器は処理対象を減らす入口、Gemmaは文脈を確認する精査役という分担です。
この構成は、検知能力、誤警告、電力消費の三つを調整するための設計と捉えられます。第1段階を厳しくしすぎれば危険な会話を見逃し、広く拾いすぎれば第2段階の負荷が増えるでしょう。どの境界が適切かは、端末性能や利用環境によっても変わります。対応機種、処理時間、消費電力、モデル容量などの具体値は明らかにされていないため、製品へ組み込む際には実機での測定が欠かせません。
送金直前に立ち止まらせる警告の設計
モデルが操作的な会話パターンを検知すると、利用者の端末上にリアルタイムの警告を表示します。目的は会話を自動的に遮断したり、相手を直ちに犯罪者と断定したりすることではありません。機密情報や金銭を渡す前にいったん手を止め、慎重に確認するよう促す仕組みです。詐欺被害では、相手から急がされ、別の人に相談する時間を奪われることがあります。意思決定の直前に介入することで、その流れを中断できます。この種の機能では、モデルの判定だけでなく、警告をいつ、どの強さで、どのように見せるかが利用体験を左右します。日常会話の途中で頻繁に強い警告が出れば、利用者は表示に慣れ、重大な場面でも無視するようになるかもしれません。逆に、注意喚起が控えめすぎれば、送金や認証情報の入力を止めるきっかけになりません。二段階処理で誤警告を減らそうとする設計は、計算効率だけでなく、この警告疲れを抑えるうえでも意味を持ちます。
企業が同様の機能を採用する場合、検知結果を最終判断として扱わず、利用者が確認行動へ移れる案内と組み合わせるのが現実的でしょう。たとえば、連絡先を別経路で確かめる、公式窓口へ問い合わせる、送金操作をいったん中断するといった選択肢が考えられます。ただし、今回公開された情報では、警告画面の具体的な文言や、その後の確認手順までは示されていません。モデルの性能評価に加えて、警告を見た人が実際に行動を変えられるかという観点も、導入時の評価対象になります。
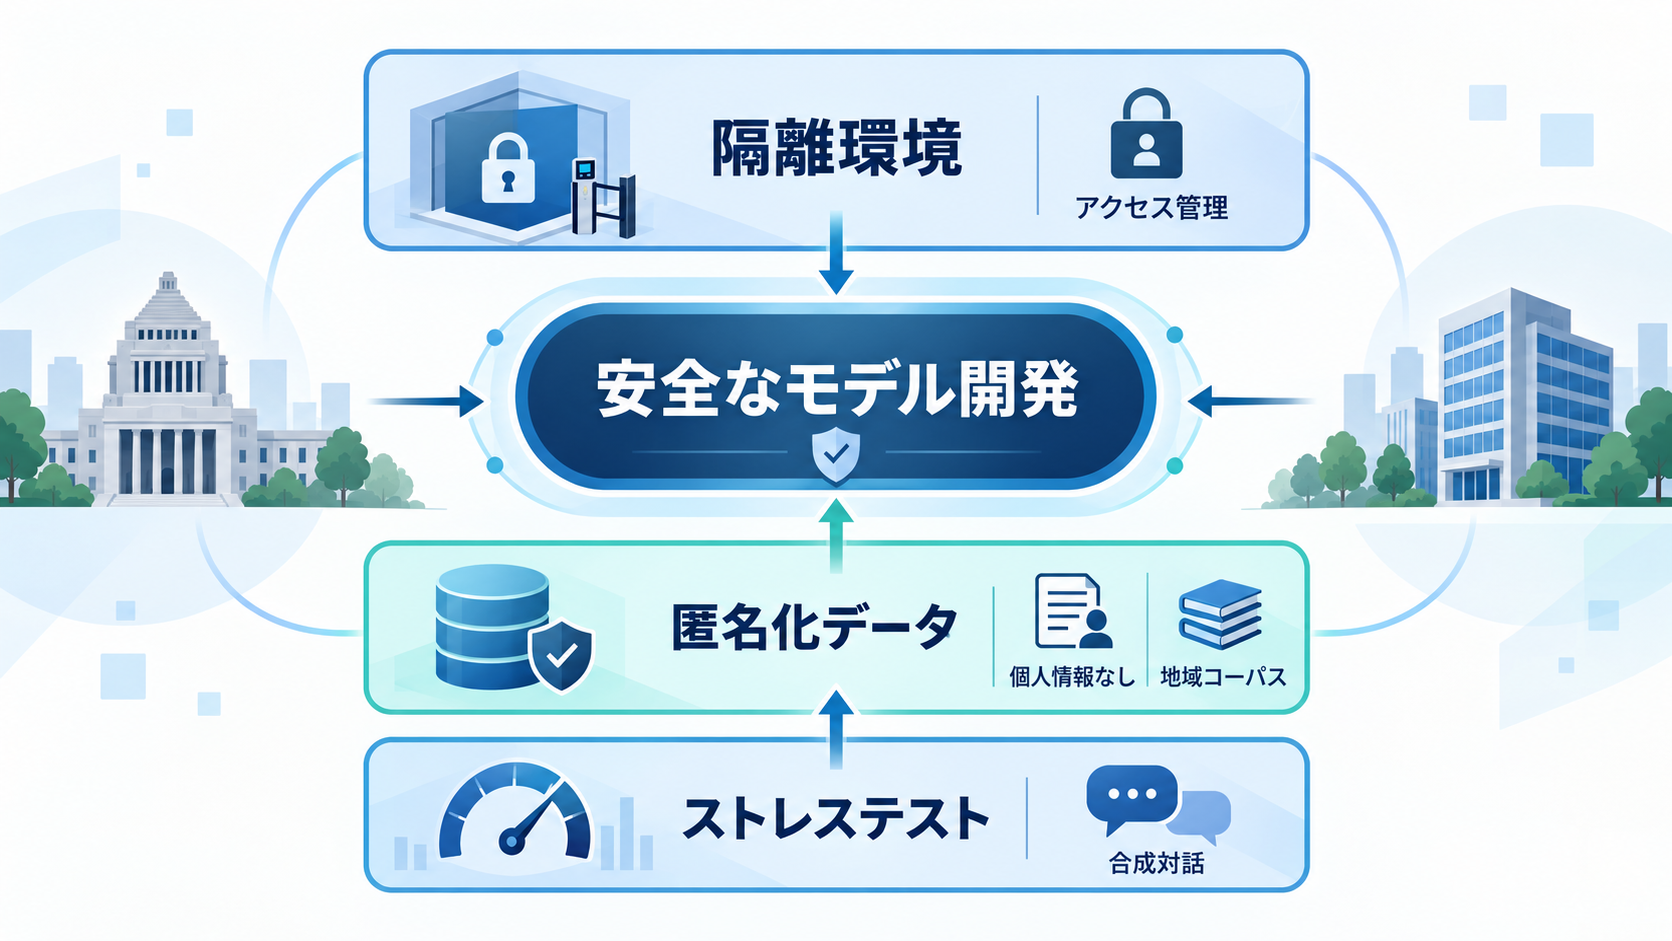
市民データを使わない開発ガバナンス
このプロジェクトはSingapore International Cyber Week 2026で発表されました。技術面と並んで強調されたのが、モデル開発時のデータ管理です。詐欺検知には現実的な会話例が必要ですが、市民の私的なメッセージを収集すれば、保護機能を作る過程そのものがプライバシー上の懸念を生みます。共同チームは、学習環境、使用データ、検証方法を分けて統制しました。ファインチューニングは、GovTechが管理・維持するGoogle Cloud Platform環境内の「Sovereign Sandbox」で実施され、学習データは隔離されました。市民の個人情報や私的なデータは学習から除外され、詐欺の通報とインテリジェンス情報から作成した匿名化データセットが利用されています。モデルの検証には、人工的に作成した対話と地域のコーパスを使い、多様な詐欺カテゴリーや変化するなりすまし手口に対するストレステストが行われました。
ここで注目したいのは、「端末内で動くから安全」という一つの説明だけに依存していない点です。運用時の会話を端末内に保つ仕組みと、開発時に扱う学習データを隔離・匿名化する統制は、別々に設計されています。どちらか一方だけでは、AIのライフサイクル全体を覆えません。
もっとも、匿名化の具体的な方法、データの保存期間、監査手順、ストレステストの合格基準などは詳しく公表されていません。企業がこの考え方を参考にする場合は、「個人データを使わない」という方針に加え、データの出所、アクセス権限、保管場所、評価記録を追跡できる仕組みまで定義する必要があるでしょう。
メッセージ事業者と日本企業が検討すべき導入条件
Google DeepMindとGovTechの取り組みは、メッセージ事業者やOSベンダーが、暗号化された会話をサーバーで読むことなく保護機能を組み込むための設計例を示しています。特定のアプリへの正式導入範囲や一般提供の時期は、現時点で明らかにされていません。そのため、完成したサービスの成功事例というより、地域適応、端末内処理、段階的な推論、データ統制を組み合わせた実装モデルとして見るのが適切です。日本で同種の対策を検討する場合も、海外向けモデルの日本語化だけでは足りないでしょう。公的機関や金融機関を装う表現、敬語を使った誘導、会話の時間的な流れなど、日本の利用環境に即した検証が必要になります。ただし、シンガポール向けモデルが日本の事例に対応できると示されたわけではありません。地域ごとにデータを整備し、正常な会話との境界を評価するという開発方針を参考にすべきです。
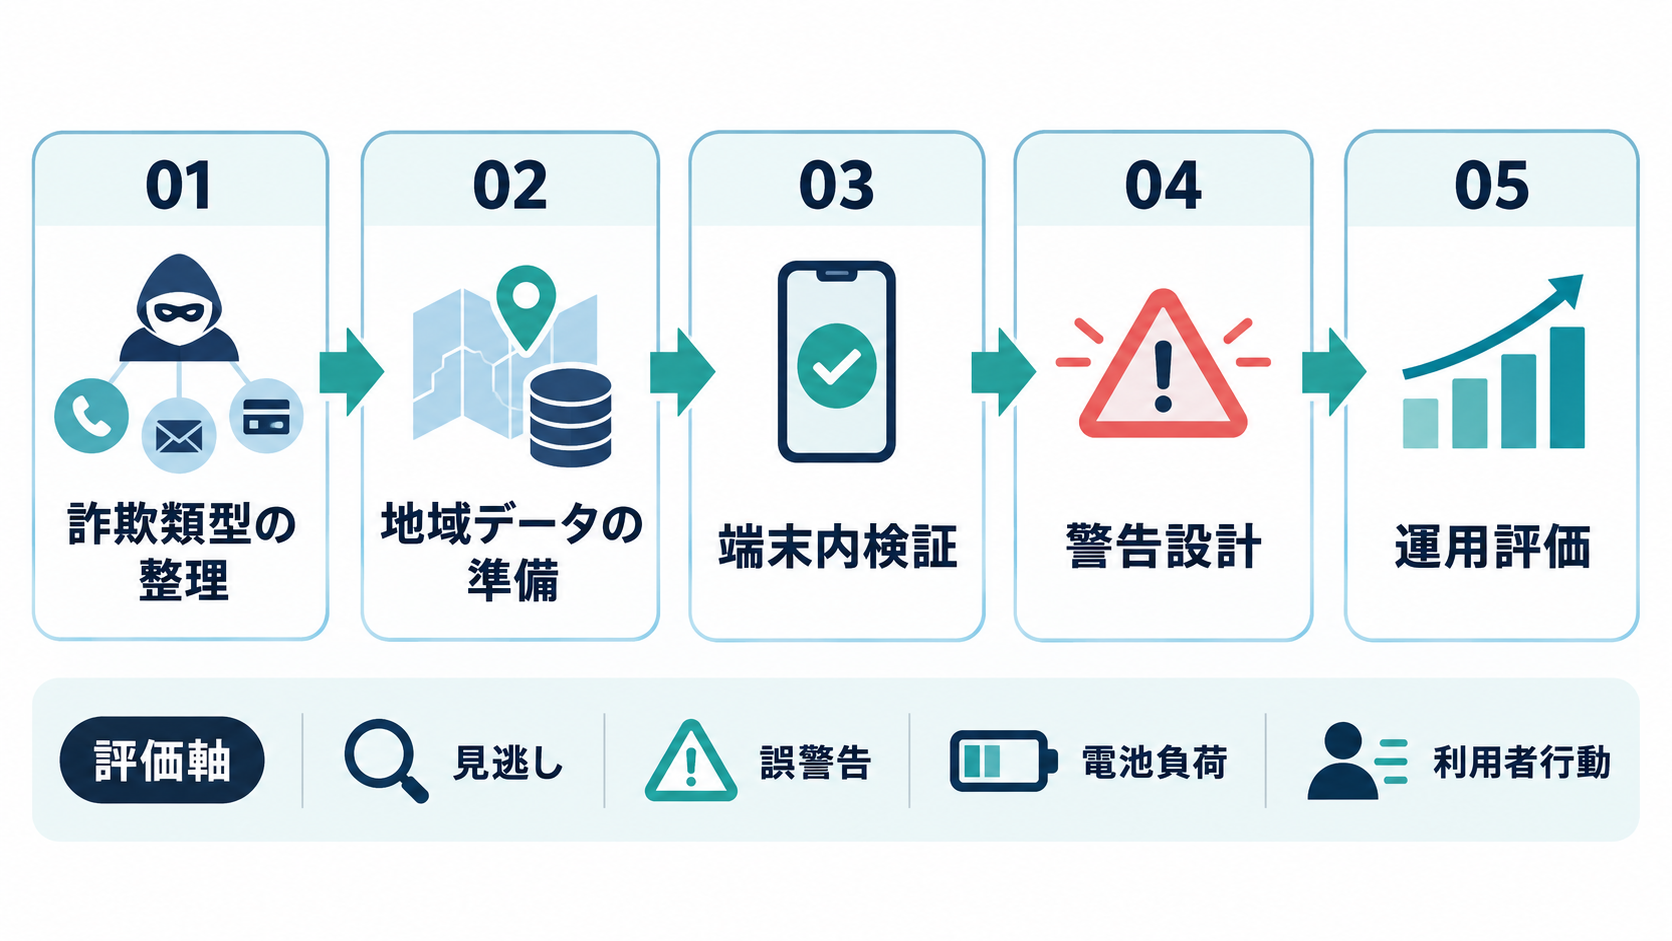
導入検討では、検知率だけを単独の目標にせず、見逃し、誤警告、端末負荷、警告後の利用者行動を同時に測る必要があります。加えて、どの会話範囲を解析するのか、解析結果を保存するのか、モデル更新をどう配信するのかを、利用者に説明できなければなりません。オンデバイスという言葉だけでプライバシーが自動的に保証されるわけではなく、実装と運用の確認が求められます。
着手点としては、自社サービスで想定される詐欺の類型と、警告を出すべき行動の直前点を整理するのが現実的です。そのうえで、個人の会話を収集せずに評価用データを構築できるか、小規模な端末内モデルで候補を絞れるかを検証します。Google DeepMindとGovTechが示したのは、保護かプライバシーかを二者択一にせず、処理場所とデータ管理の設計によって両方を追求する道筋です。