

2026/11/11
AIニュース
Meta FAIRの「e-means」、クラスタリングの反復回数を約10分の1に短縮――FAISSで使える新手法
この記事の要点
Meta FAIRが公開したe-meansは、指数移動平均を使うミニバッチ方式でクラスタリングを高速化します。研究チームは、Lloyd法の25エポック相当の損失に1.4〜2.6エポックで到達し、GPUでは比較対象に対して10〜45倍高速になったと報告しています。FAISSへの実装収録により検証しやすくなる一方、大規模利用では集計用メモリと検索品質の確認が必要です。
目次
ベクトル検索の準備時間を短縮する「e-means」
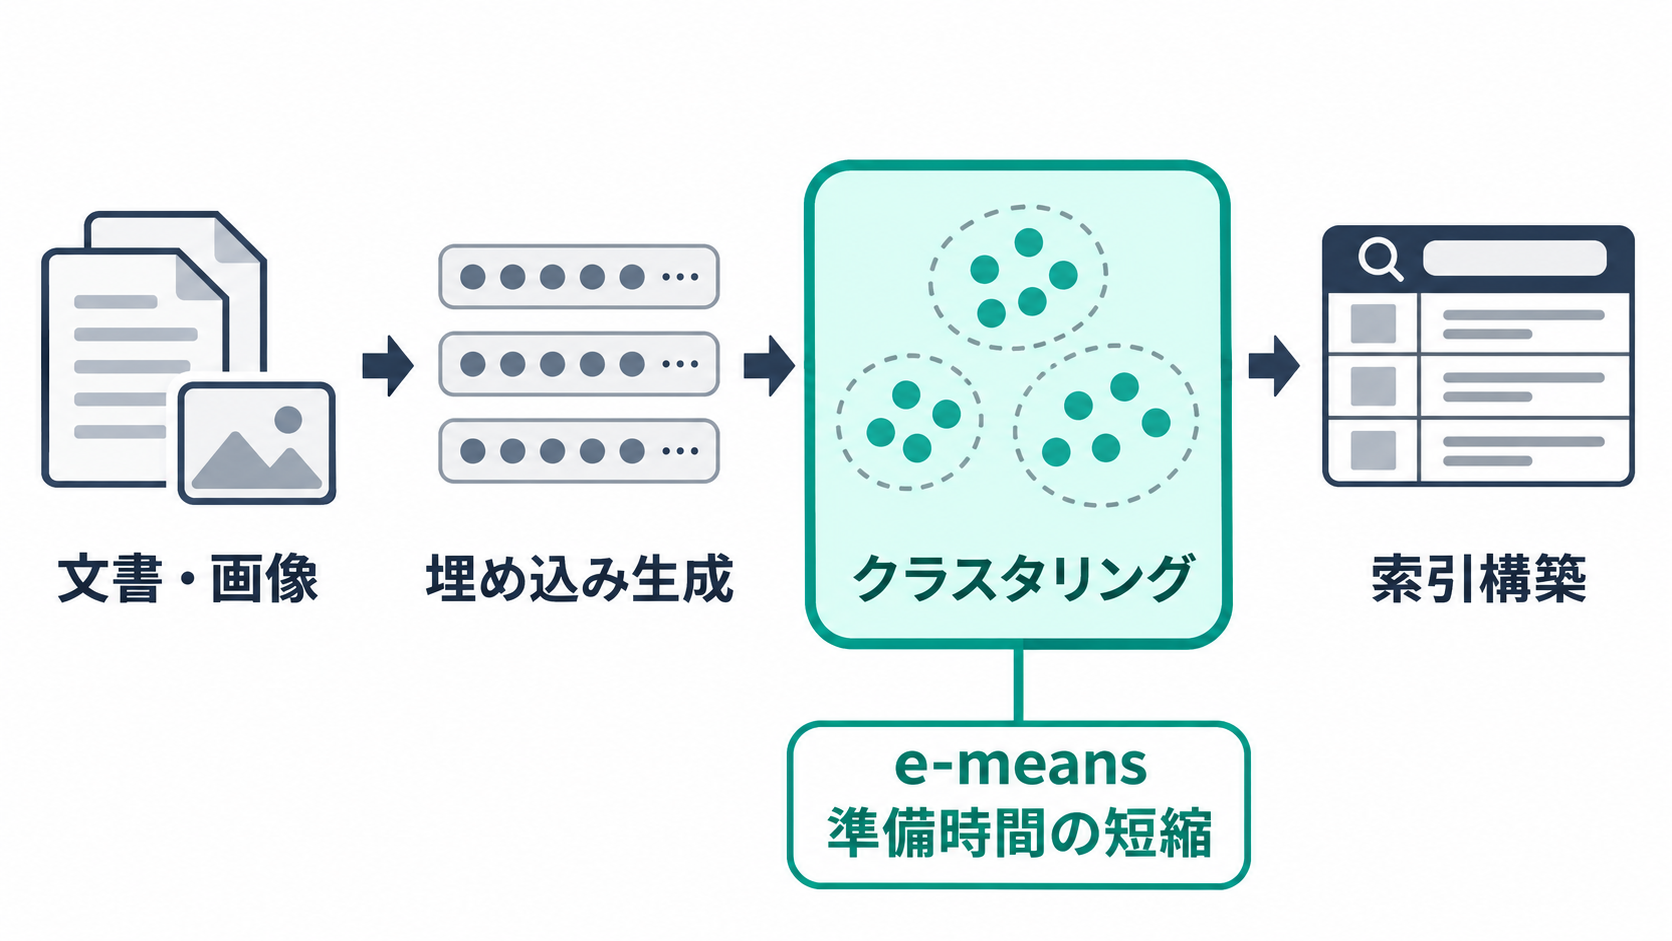
大量の文書や画像をベクトルに変換できても、検索用の索引を準備する工程で処理が滞ることがあります。データを似たもの同士にまとめるクラスタリングは、ベクトル索引の構築やデータ整理を支える処理です。MetaのAI研究組織FAIRが公開した「e-means」は、この準備工程の高速化を狙っています。
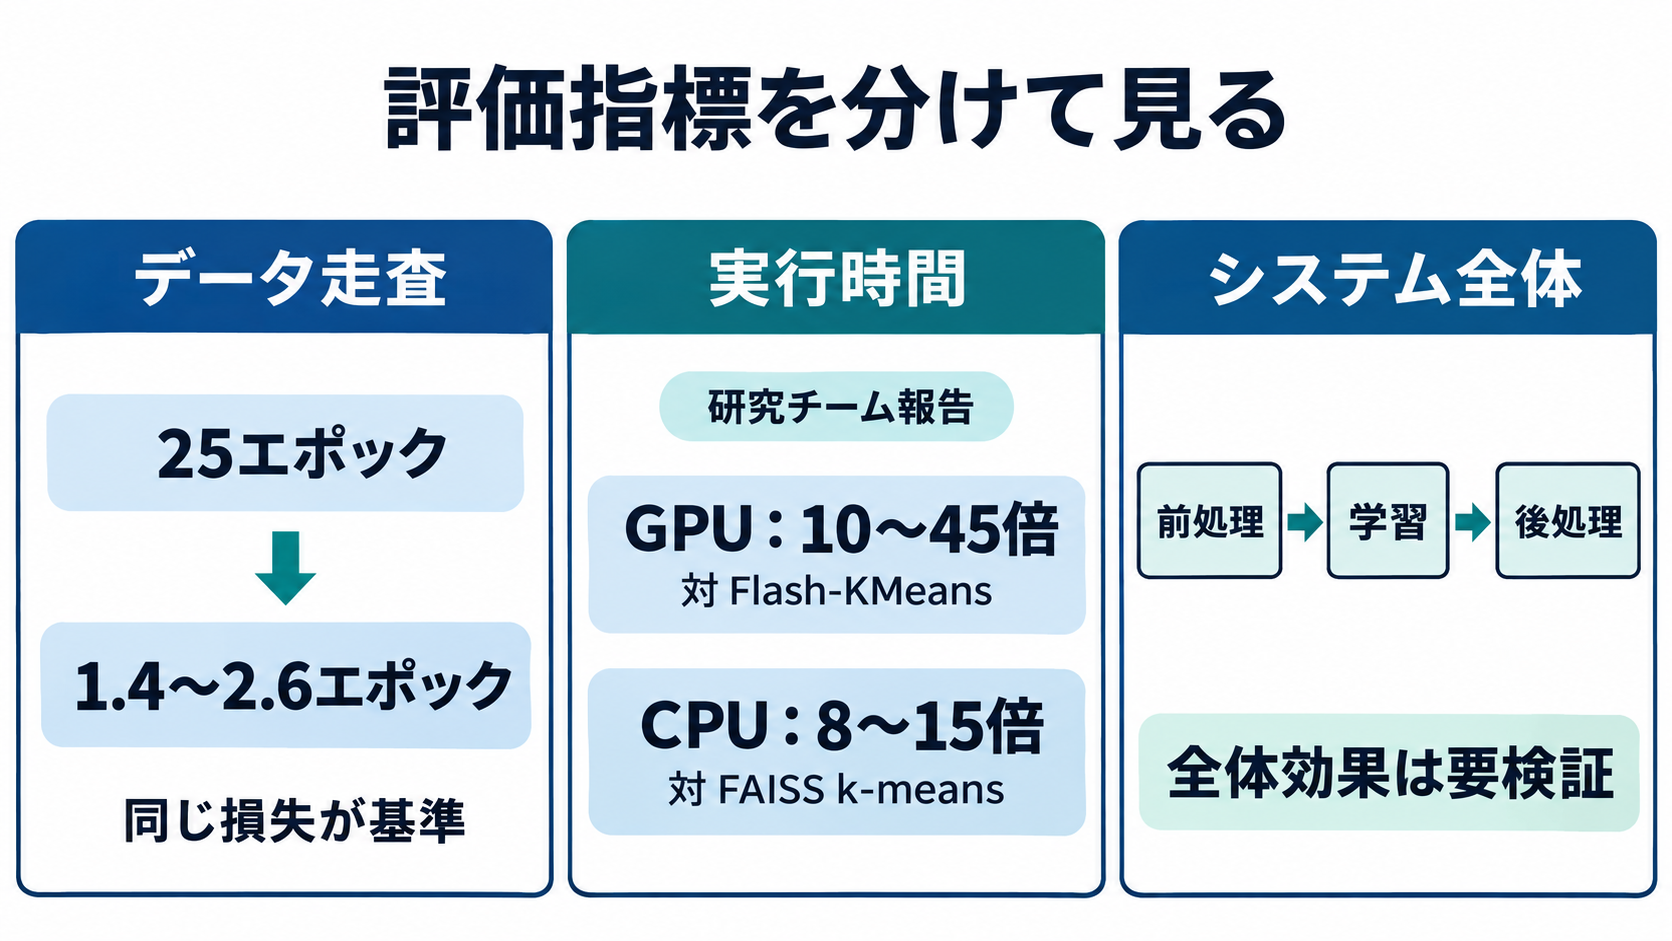
研究チームによると、従来の代表的な手法であるLloyd法のk-meansが25エポックで到達する損失を、e-meansは1.4〜2.6エポックで下回りました。エポックとは、データ全体を一巡する処理量の単位です。同程度のクラスタリング品質に達するまでに、データを何度も読み直す必要を減らせる点が中心的な成果となります。
e-meansは文章や画像を生成するモデルではありません。生成AIを利用した検索システムや、学習用データの整理などを支えるアルゴリズムです。用途として、ベクトル索引、量子化、データキュレーションのパイプラインが挙げられています。量子化はベクトルを少ない情報量で表すための技術で、データキュレーションは利用目的に合わせてデータを選別・整理する作業を指します。
実装は、ベクトル類似度検索ライブラリFAISSのバージョン1.16.0に、faiss.contrib.e_meansとして収録されたと報告されています。企業の開発担当者にとっての論点は、モデルの回答性能そのものではなく、その裏側にあるデータ処理をどこまで短縮できるかです。検索基盤の更新に時間がかかっている場合には、検証する価値のある変更候補でしょう。
全件を集計し直す代わりに、過去の統計を少しずつ減衰
k-meansは、データを指定した数のグループに分け、それぞれの代表点である重心を求める手法です。各データを近い重心へ割り当て、割り当てられたデータに合わせて重心を更新します。ここでいう損失は、データと所属先の重心との距離に基づく指標です。損失が小さいほど、k-meansの目的に沿ってまとまっていると解釈できますが、業務上の分類の正しさを直接保証するものではありません。
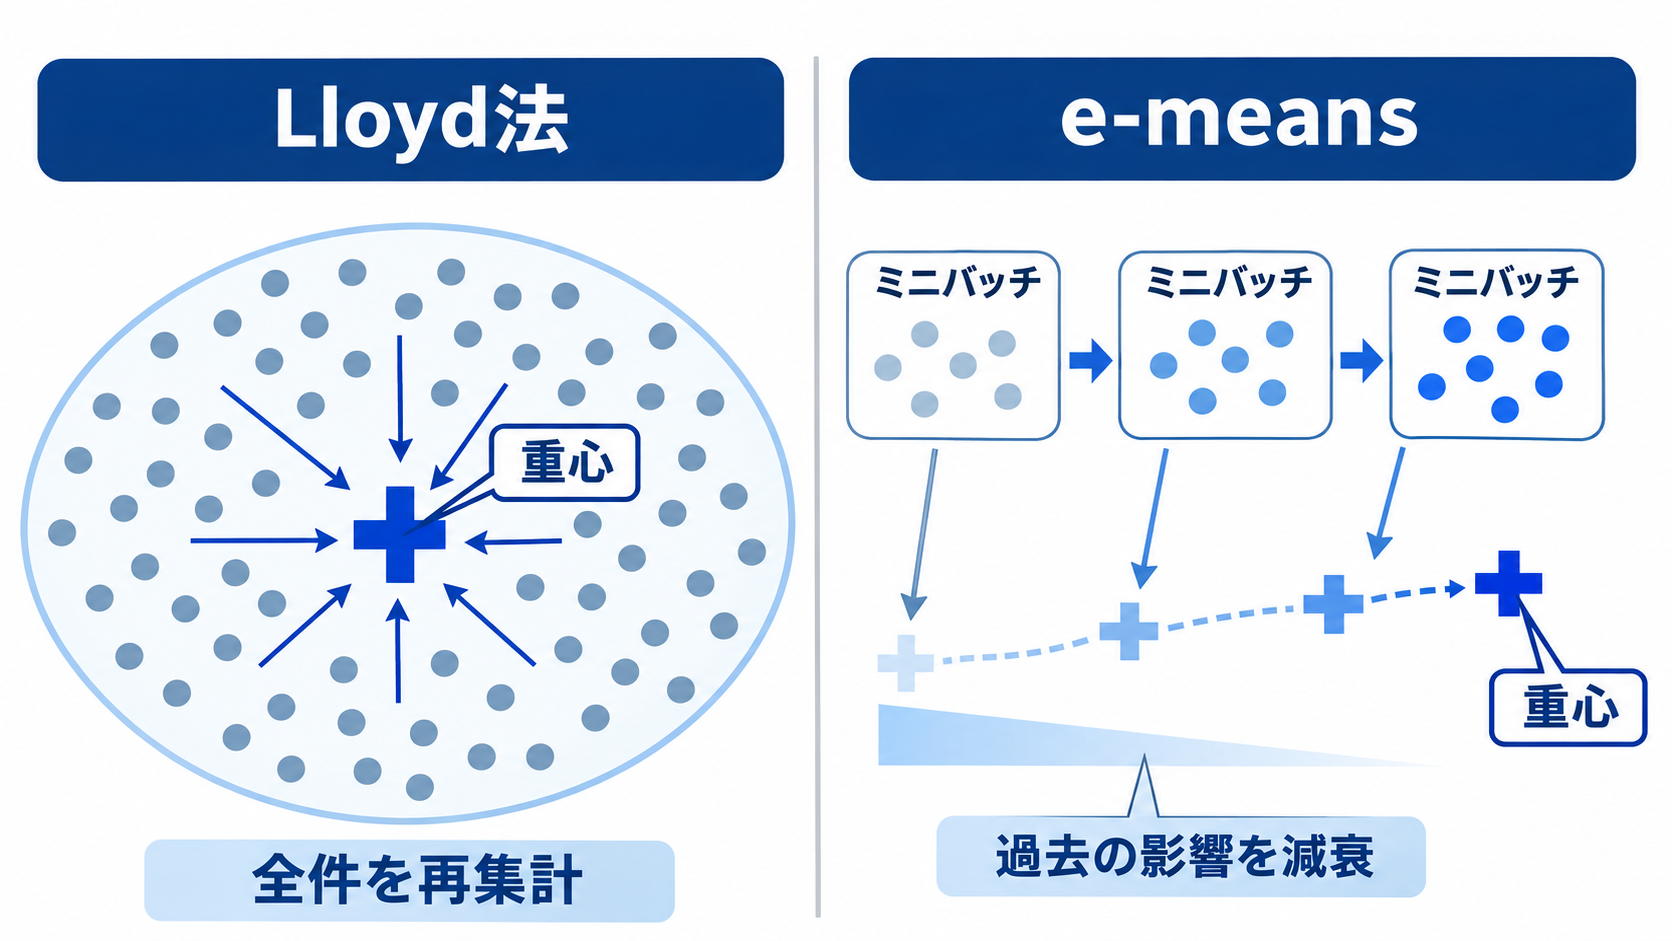
Lloyd法では、反復のたびにデータ全体から各クラスタの合計と件数を計算し直します。これに対してe-meansは、データを小さなまとまりに分けるミニバッチ方式と、指数移動平均であるEMAを組み合わせます。過去の集計を残しつつ、その影響を徐々に弱めながら、新しいバッチの情報を取り込む仕組みです。
各クラスタが保持するベクトルの合計をS、件数をNとすると、重心はSをNで割って求めます。e-meansでは、新しいバッチの合計sに対して、Sを「(1−α)S+αs」で更新し、件数にも同じ更新を適用します。αは新しい情報をどの程度反映するかを決める値です。古い割り当ての影響が減衰するため、過去の集計を加算し続ける方式とは挙動が異なります。
研究チームは、データ全体を一度に処理し、αを1とした場合をLloyd法に相当する特別なケースとして説明しています。つまり、e-meansは単に一回の処理を軽くするだけではなく、集計情報の更新方法を変えることで、少ないデータ走査で重心を改善しようとする設計です。大量のデータを繰り返し扱う場面ほど、この違いが処理時間に表れやすいと考えられます。
自動設定と空クラスタの再生が、実用上の調整を支援
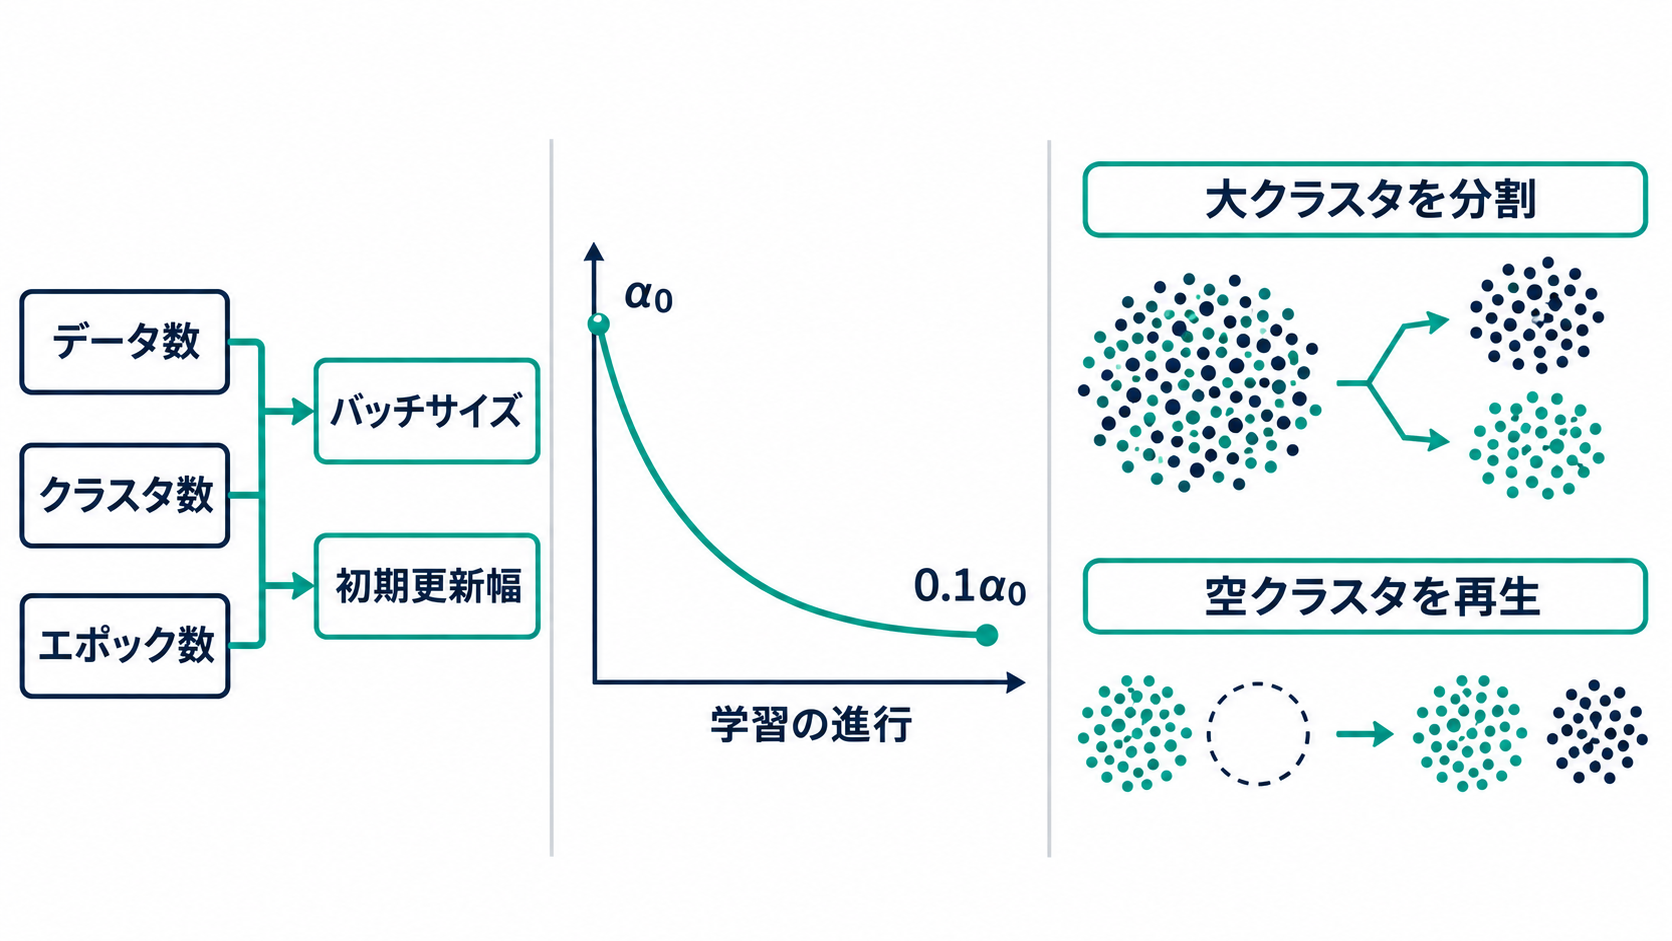
ミニバッチ方式を採用しても、バッチサイズや更新幅の選び方に試行錯誤が必要なら、導入担当者の負担は残ります。e-meansは、データ数n、クラスタ数k、エポック数Tから、バッチサイズBと初期更新幅α0を決める二つの経験的なスケーリング則を用意しています。研究チームは、これにより主要な調整を自動化できると説明しています。
更新幅は固定ではありません。α0から始め、コサイン曲線に沿って最終的に0.1α0まで小さくします。序盤は新しいバッチを比較的強く反映し、終盤は更新を抑える設計と理解すると分かりやすいでしょう。ただし、自動で設定できることと、あらゆる業務データに対して最適であることは別です。クラスタ数や処理予算、結果の評価基準は利用側で決める必要があります。
多数のクラスタを作る場合には、ほとんどデータが割り当てられないクラスタも問題になります。e-meansは、サイズがしきい値を下回ったクラスタを、大きなクラスタの分割によって再生します。DEEPデータセットでクラスタ数を16,384に設定した実験では、再生を無効にすると4,313個、全体の26.3%が機能しない状態になりました。比例的な分割を使う設定では47個、0.3%まで減ったと報告されています。
学習終了時には、各クラスタについて最終エポックの厳密な平均値を使う仕上げ処理も行います。更新途中の統計だけに依存せず、最後に重心を整える設計です。自動設定、空クラスタの再生、終了時の仕上げを合わせて見ると、e-meansの狙いは更新式の変更だけにとどまりません。高速な反復を、実際に使えるクラスタリング結果につなげるための工夫が組み込まれています。
「10〜45倍」の速度差は、同じ損失への到達時間で比較
速度を評価する際には、エポック数と実際の経過時間を分けて読む必要があります。ミニバッチ化でデータ走査が減っても、処理の呼び出しやデータ転送などの負担が増えれば、短縮幅は小さくなりかねません。e-meansはGPU上の最近傍重心への割り当て処理を融合する実装も採用し、反復回数の削減を実行時間の短縮につなげています。
研究チームの自己報告では、同じ損失に達するまでのGPU実行時間はFlash-KMeansとの比較で10〜45倍、CPUではFAISSのk-meansとの比較で8〜15倍高速になりました。Flash-KMeansは比較対象となったGPU向けのk-means実装です。これらは評価条件の下で得られた数値であり、既存の検索システム全体が同じ倍率で速くなるという意味ではありません。
評価は24のデータセット構成に及び、VIBEベンチマークの11種類の埋め込みデータセットでは、いずれも1.6〜2.4エポックを必要としたと報告されています。また、単一CPUスレッドのデモでは、Lloyd法が25エポックに4.39秒を要したのに対し、e-meansは2.2エポックで0.43秒でした。このデモは挙動をつかむ手掛かりになりますが、大規模な本番処理の所要時間をそのまま予測する材料にはできません。
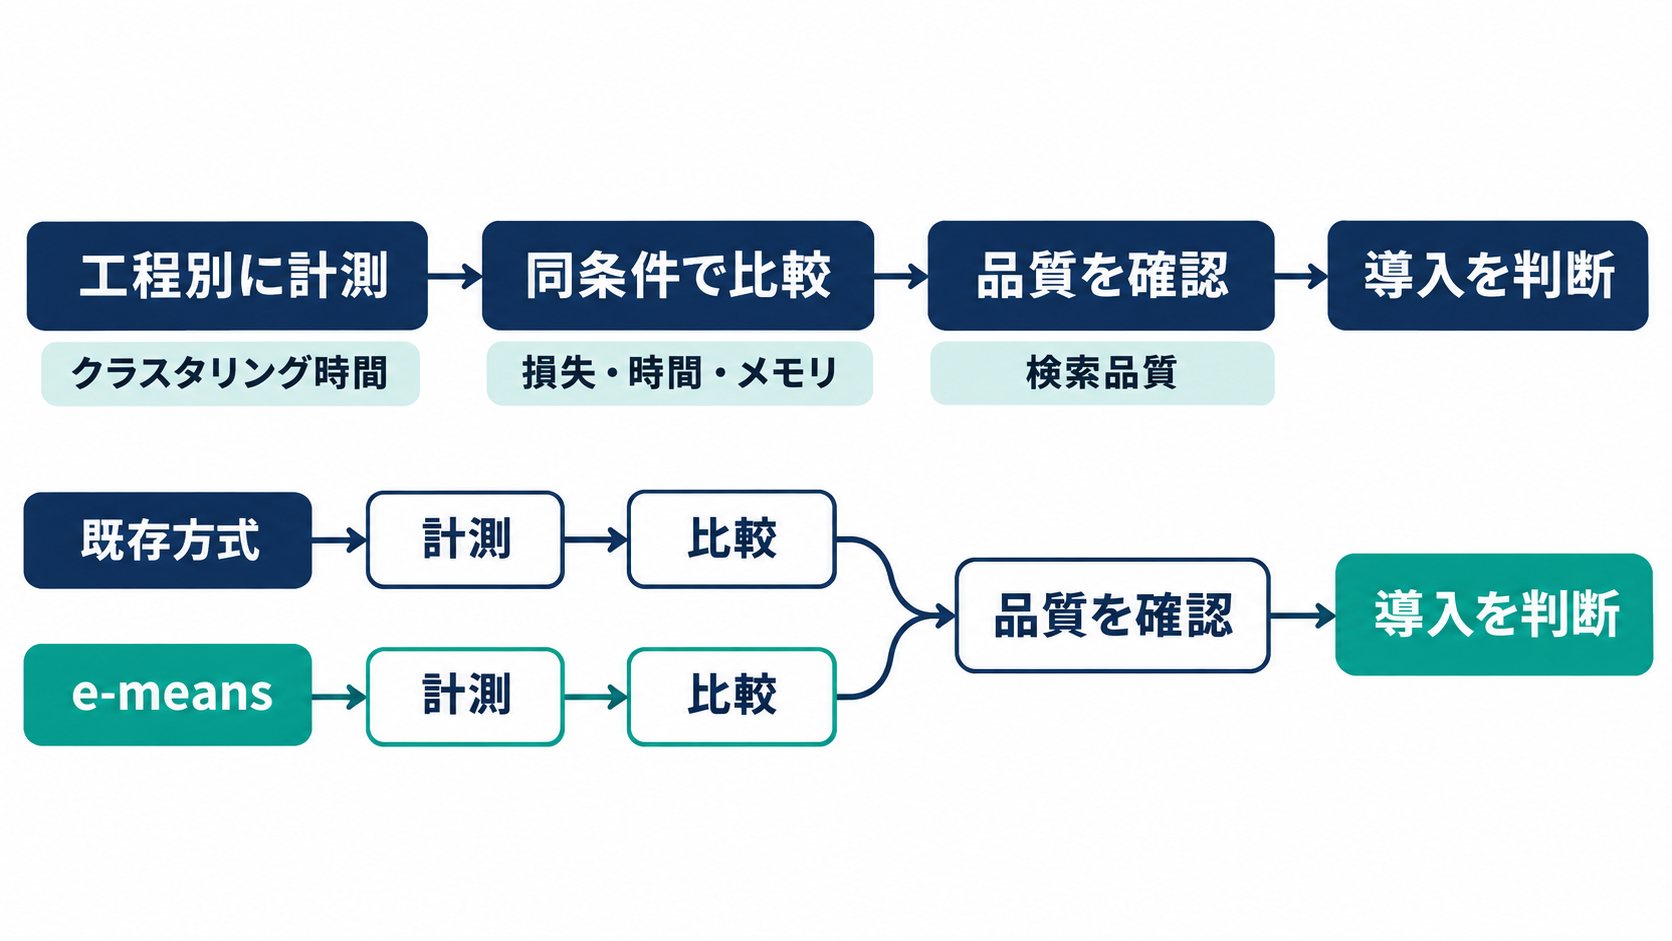
日本企業が検証するなら、既存方式とe-meansで同じクラスタ数を使い、同程度の損失に達するまでの時間を比べるのが出発点です。そのうえで、検索用途なら検索結果の品質、データ整理なら選別結果への影響も確認します。反復回数だけをそろえて比較すると、到達品質の違いを見落とす可能性があります。速度と品質を対にして測ることが、導入判断の前提となります。
100億ベクトルでの検証が示す規模と、残るメモリ制約
e-meansは、10万点から100億点まで、最大約1,670万クラスタを対象に検証されたと報告されています。とくに大規模な例がDINO10Bです。100億個の1,024次元埋め込みベクトルを約1,670万クラスタに分ける処理を、2.5エポックで実行しました。論文のGPU実験にはNVIDIAのH100が使われています。
この規模で結果が示されたことは、大量の埋め込みを扱う基盤への適用を考えるうえで参考になります。ただし、少ないエポックで処理できることは、必要なメモリも小さくなることを意味しません。クラスタごとに合計や件数などの統計を保持するため、クラスタ数を増やせば、その管理に必要な領域も増えていきます。
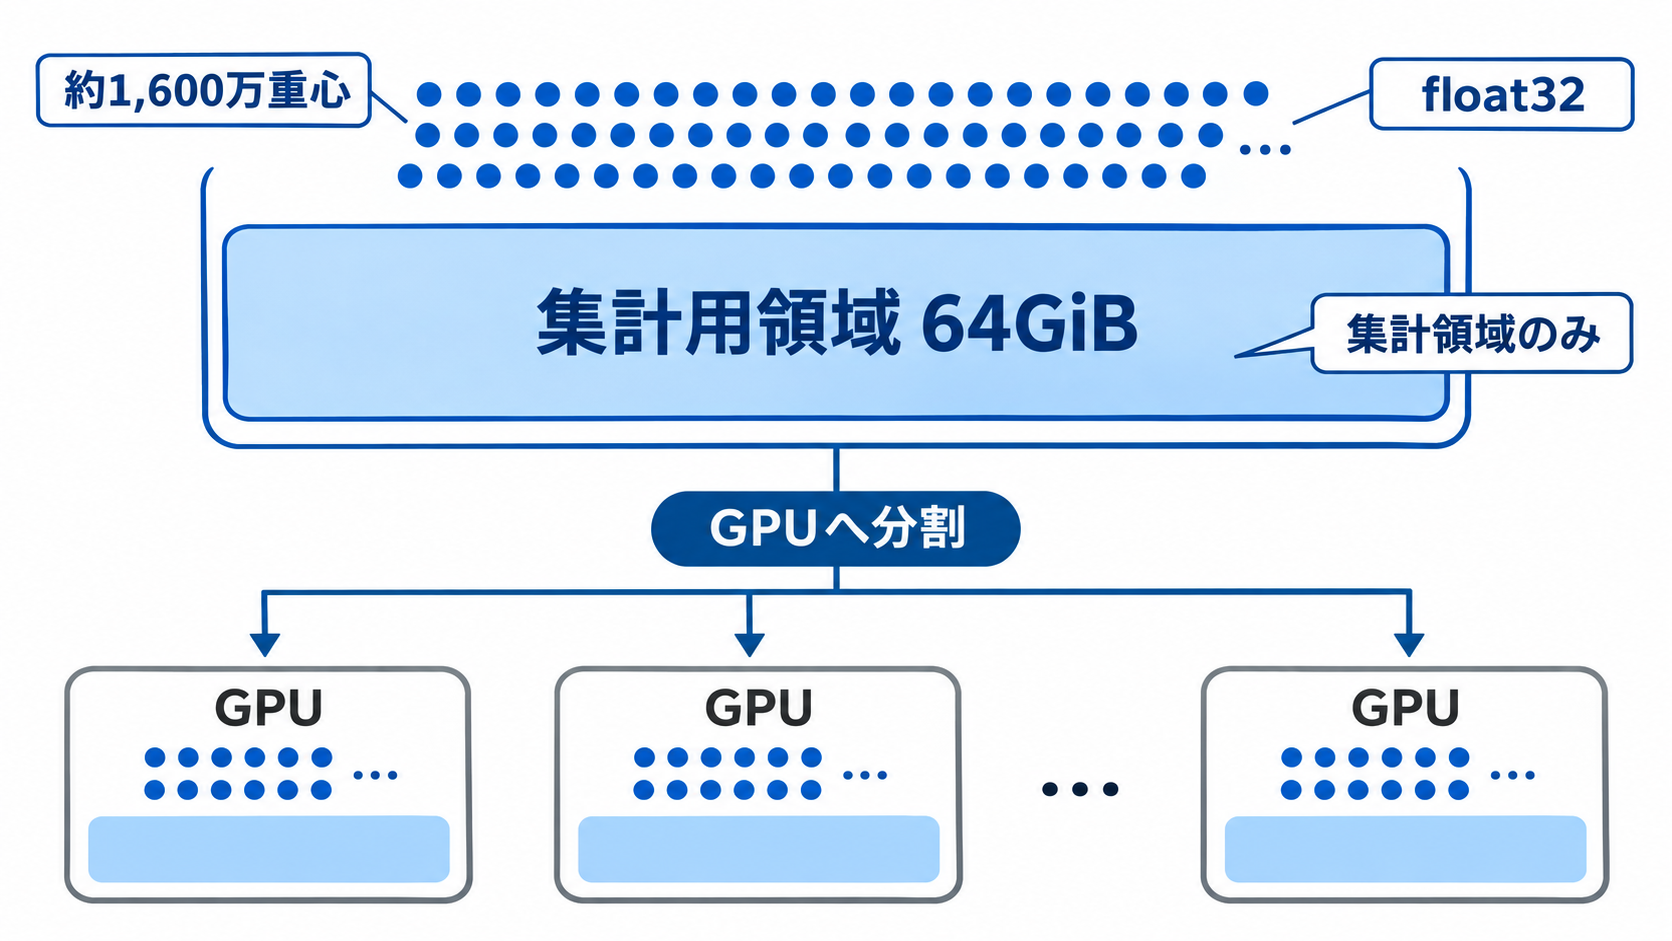
公開された説明では、約1,600万重心を扱う実行において、float32形式の集計用領域だけで64GiBが必要になります。そのため、重心を複数のGPUに分割して保持する必要があるとされています。この64GiBは集計用領域の値であり、データや処理全体に必要なメモリ量と混同しないように読む必要があります。
導入時には、データ数だけでなく、ベクトルの次元数と作成するクラスタ数を合わせて確認するのが妥当です。高速化によって計算時間を短縮できても、利用できるGPUのメモリ容量や分割処理の条件が実行可能な規模を左右します。CPUとGPUの双方に対応し、PyTorchテンソルやNumPyを扱える点は選択肢を広げますが、手元の環境で動かせる範囲は別途測る必要があります。大規模実験の到達点と、自社環境での実行条件を分けて評価しましょう。
導入判断は、索引更新のどこで時間を使っているかから
e-meansの効果を見極める最初の作業は、既存パイプラインの処理時間を分けて測ることです。埋め込みの生成、クラスタリング、索引の構築、保存などのうち、クラスタリングが大きな割合を占めているなら、今回の手法が改善につながる可能性があります。別の工程が所要時間の大半を占めている場合には、クラスタリング単体の高速化が全体へ及ぼす効果は限られるでしょう。
検証では、扱いやすい規模のデータを切り出し、現在の方式を比較基準として残しておくと判断しやすくなります。クラスタ数と評価指標をそろえ、所要時間、到達した損失、最大メモリ使用量を記録します。検索基盤で使うなら、索引の作成が速くなった後も、必要な検索品質を維持できるかを確かめたいところです。
研究チームは、ミニバッチによる揺らぎが、好ましくない局所解から抜け出す助けになるとも説明しています。五つの塊からなる人工データの実験では、200回の初期化のうちLloyd法は46%で局所解から抜け出せず、e-meansでは0%でした。ただし、これは特定の人工データでの結果です。実データでも常に同じ差が出るとは限らず、業務データでの比較を置き換えるものではありません。
今回の発表が示したのは、クラスタリングの更新方法を変えることで、同程度の損失までの計算を減らせるという選択肢です。自社で試す際には、実装が収録されたFAISSのバージョンを確認したうえで、索引更新を一回実行し、そのうちクラスタリングに何分かかっているかを記録してみてください。その時間と必要メモリを比較基準にすれば、e-meansを本番へ組み込むための検証範囲を具体的に決められます。