
2026/10/30
AIニュース
601Mパラメータで23言語対応、Audio8-TTS-Realisticが示す音声AIの実装現実性
小型モデルが変える多言語音声AIの導入条件
顧客ごとに声を調整する音声案内や、複数言語で展開する研修コンテンツを作ろうとすると、音質だけでなく、推論コストや追加学習のしやすさが問題になります。Edge0が公開したAudio8-TTS-Realisticは、この実装上の制約に焦点を当てたオープンウェイトの音声合成モデルです。メインモデルは601Mパラメータで、1本の参照音声と正確な書き起こしから声の特徴を再現する、ゼロショット音声クローンに対応しています。
対応言語は23言語で、前世代のAudio8-TTS-Preview-0.6bから12言語増えました。追加されたのは、アラビア語、フィンランド語、ヒンディー語、インドネシア語、マレー語、ノルウェー語、ポルトガル語、ロシア語、スウェーデン語、タイ語、トルコ語、ベトナム語です。参照する声を指定せず、通常の音声合成モデルとして使うこともできます。チェックポイントだけでなく、44.1kHzのニューラル音声コーデック、トークナイザー、プロセッサー、カスタムコードもまとめて提供されています。
企業利用の観点で注目したいのは、最大規模のモデルと音質だけを競う設計ではないことです。大規模モデルより小さいため、組織固有の発音や用途に合わせた追加学習、複数インスタンスでの配信、検証環境の準備を比較的現実的な予算で検討できます。コードと重みはApache 2.0ライセンスで公開されており、商用サービスへの組み込みも検討しやすい条件です。ただし、小型であることが全言語の品質を保証するわけではありません。Audio8-TTS-Realisticの価値は、最高性能を無条件にうたう点ではなく、音質、言語数、運用コストの折り合いを付けやすい点にあると考えられます。
601Mパラメータを支える二段構えの生成方式
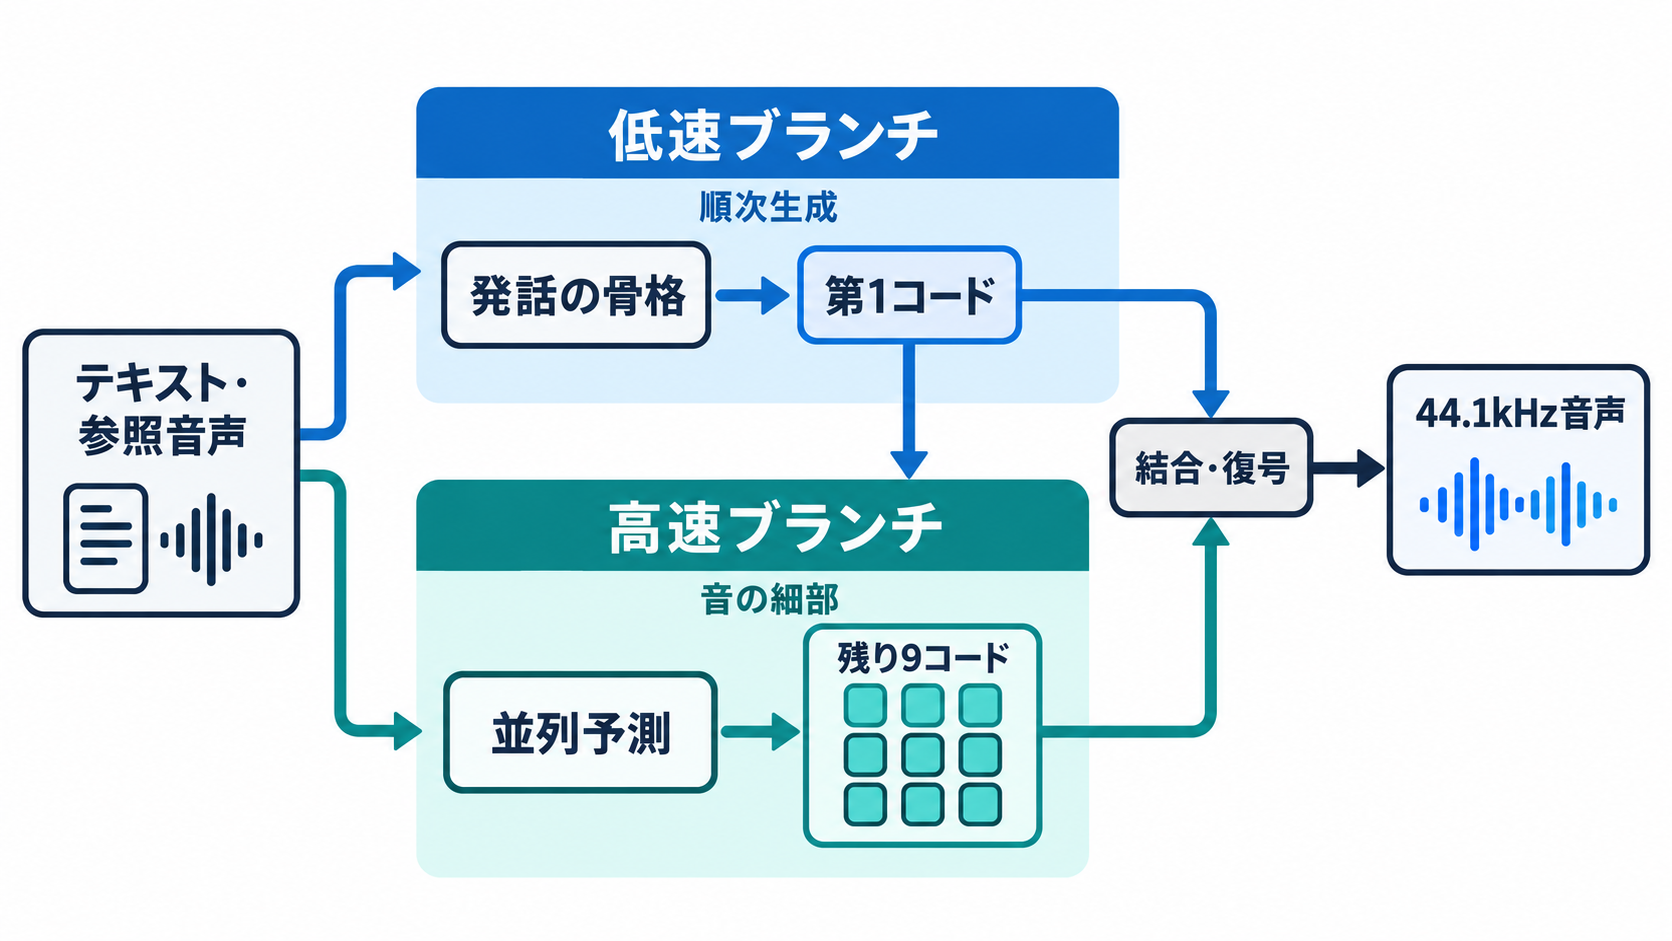
Audio8-TTS-Realisticは、Fish Audio S2 Proから着想を得たDualARと呼ばれる二重自己回帰方式を採用しています。音声を一度に波形として作るのではなく、ニューラル音声コーデックが扱う複数系列のコードへ変換し、役割の異なる二つの処理系で順番に予測する仕組みです。すべてのコードを重いモデルで逐次生成しないため、モデル規模を抑えながら、44.1kHzの音声出力に必要な情報を組み立てられます。
低速側のブランチはQwen2.5 0.5Bを土台とし、24層、隠れ幅896の構成です。約21.5フレーム毎秒で動作し、各ステップでテキストトークンと最初の音声コードブックを予測します。ここでは、発話内容や時間方向の流れといった、後から容易に修正できない骨格を決めていると捉えると分かりやすいでしょう。モデルが扱えるコンテキストは、テキストと音声を合わせて最大2,048ポジションです。
残る9個のコードブックは、4層の浅い高速ブランチが並列に予測します。逐次計算が必要なのはフレーム単位の進行部分に限られるため、すべての音声情報を一系列ずつ生成する構成より計算を整理しやすくなっています。品質に影響しやすい時間軸の判断を低速側へ任せ、細部を高速側で補う分業です。
この設計は、パラメータ数の少なさだけを狙ったものではありません。音声生成では、モデルの重み以外にもコーデックやキャッシュ、入出力処理が必要です。そのため、601Mという数字をそのまま実行時メモリとみなすことはできませんが、追加学習や配信基盤を設計する際の選択肢は広がります。大量の音声を一括生成する業務では、単発の最高音質より、必要な品質を維持しながら同時処理数を確保できるかが判断材料になるでしょう。
聞き取りやすさだけでなく「人らしい間」を学ぶ訓練
音声合成の評価では、単語誤り率を表すWERや、生成音声が参照話者にどれほど似ているかを測るSIMがよく使われます。しかし、言葉を正確に読み、声質が似ていても、息継ぎや間の長さ、話す速さが不自然なら、聞き手は合成音声らしさを感じます。Edge0は、このずれを補うために、数値化しにくいリズムや休止の自然さを学習へ取り込んでいます。
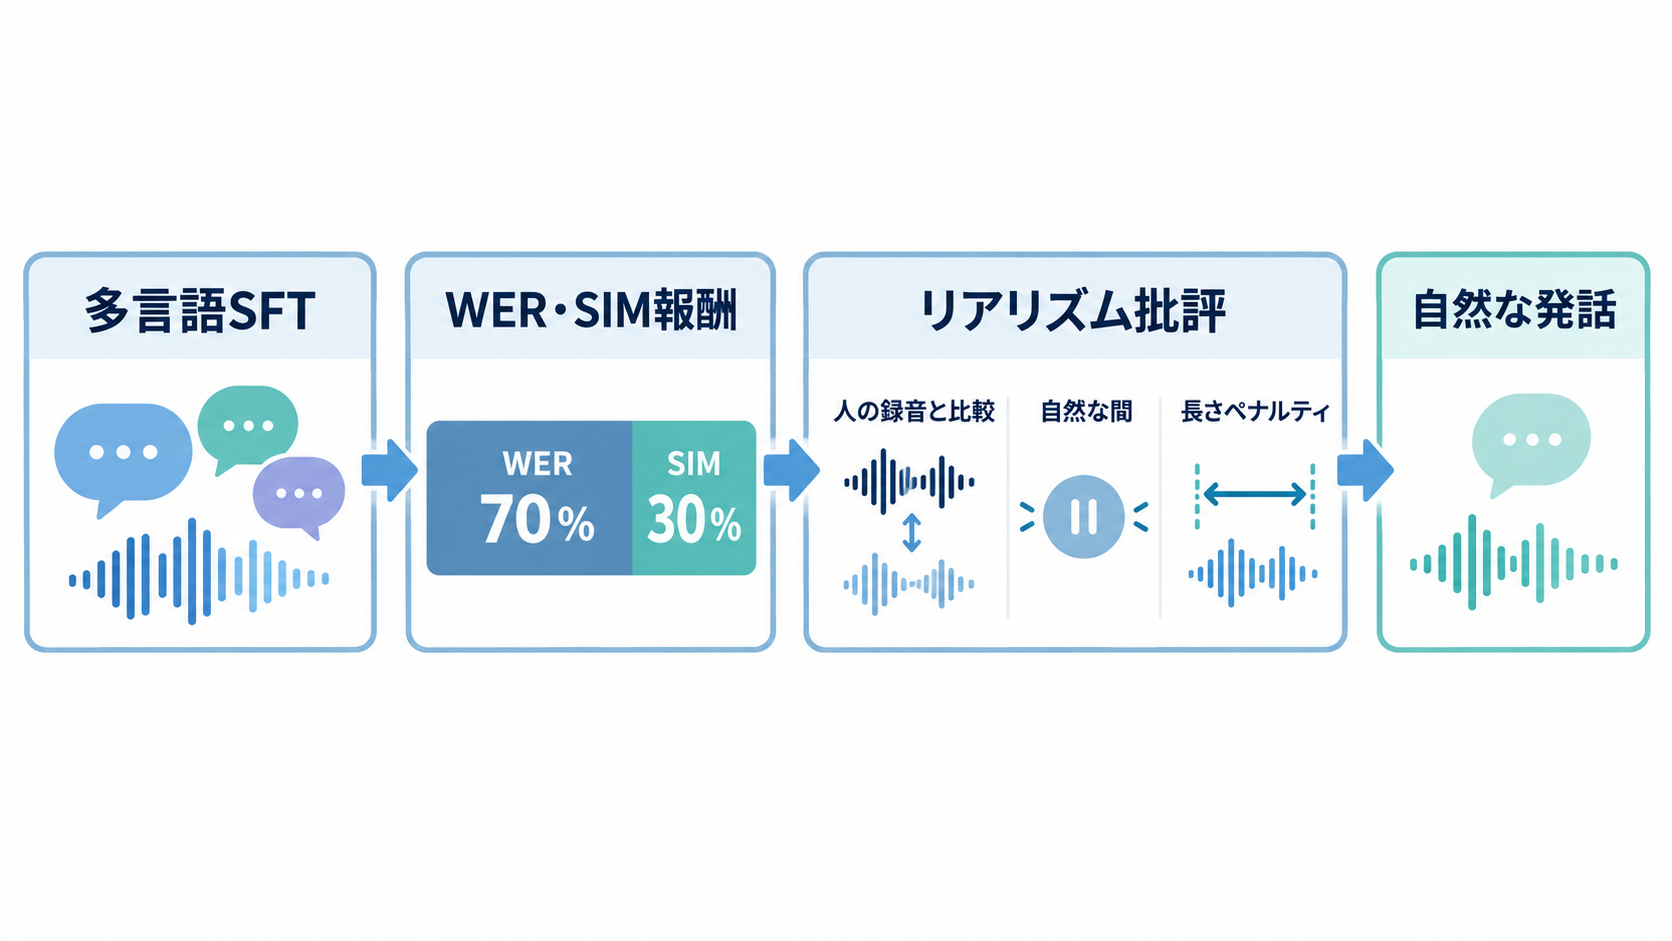
学習は三段階です。最初に多言語データによる教師あり微調整を行い、続くGRPOでは報酬の70%をWER、30%をSIMへ割り当てます。GRPOは、複数の生成結果を比較し、報酬が高くなる方向へモデルを調整する強化学習手法です。最後の段階では、学習済みの「リアリズム批評モデル」を案内役として再びGRPOを実施し、人の発話に近い時間表現を狙います。
批評モデルは、生成された音声と、同じ文を人が読んだ録音を照合して採点します。土台となる品質の序列は、6種類のオープンソース音声合成システムを非公開のブラインド聴取試験で順位付けし、人の録音を最上位に置いて作られました。休止部分を人工的に圧縮した音声も加え、単純な「良い・悪い」より細かな段階を学ばせています。批評部分は、凍結したWavLM-largeエンコーダーの上に約300万パラメータのヘッドを載せた構成です。
評価器を使う強化学習では、生成モデルが評価器固有の癖を見つけ、本来の目的とは異なる方法で点数を稼ぐことがあります。Edge0は、特定の生成器らしさを褒めないようにするidentity-erasure lossを導入しました。生成音声が参照音声の1.35倍を超える長さになると時間ペナルティも加わるため、ゆっくり話して自然さの点数を稼ぐ挙動を抑えます。
最終段階で使われたプロンプトは中国語と英語だけでしたが、13の低リソース言語をまとめた誤り率は22.53%から20.77%へ低下し、SIMは0.637から0.679へ上昇しました。限られた言語で学習した時間表現が、別の言語にも一定程度波及した結果とみられます。ただし、すべての言語へ同じ効果が及ぶとは限らず、言語別の確認は欠かせません。
ベンチマークが示す強みと読み違えやすい数字
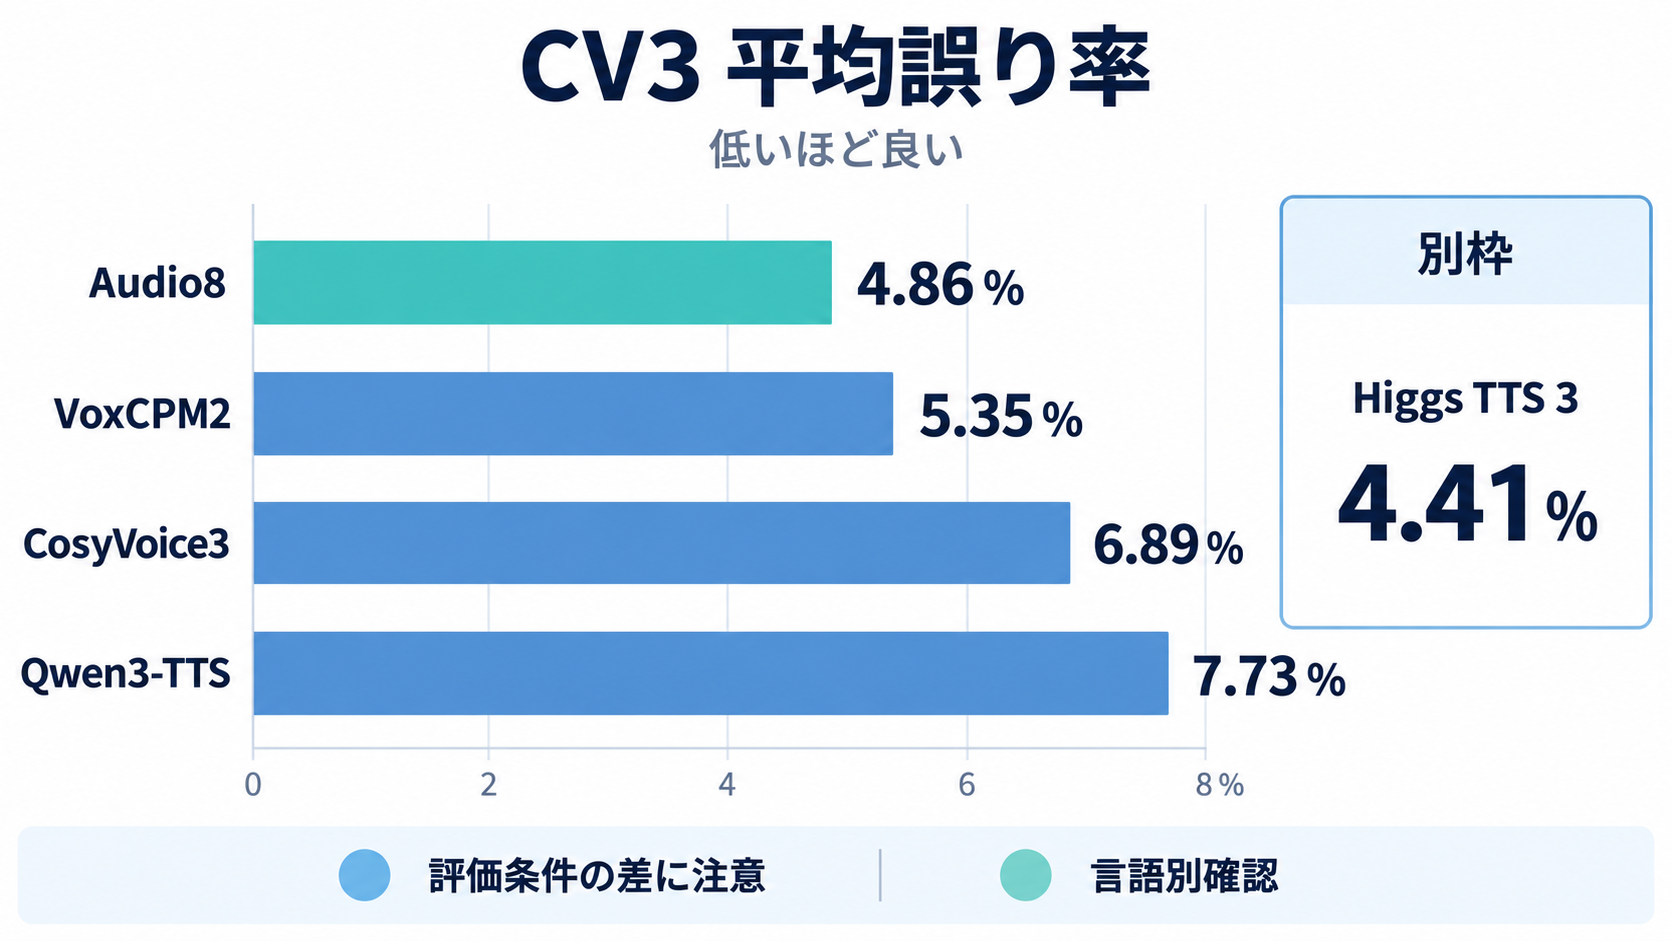
Edge0が報告した平均誤り率は、英語と中国語のSeed-TTSで1.25%、9言語のCV3で4.86%、24言語のMiniMaxで5.89%です。話者類似度を示すSIMは、それぞれ0.704、0.661、0.754となっています。誤り率は低いほど良い指標ですが、SIMは同じ方向では読めません。複数の指標を並べる際には、数値の意味と評価対象を分けて確認する必要があります。
CV3の平均誤り率では、Audio8-TTS-Realisticの4.86%がVoxCPM2の5.35%、CosyVoice3-1.5Bの6.89%、Qwen3-TTS-1.7Bの7.73%を下回りました。601Mパラメータのモデルが、より大きなオープンモデルを上回った点は、小型化と多言語精度が必ずしも単純な交換条件ではないことを示しています。Seed-TTSではQwen3-TTS-1.7Bが平均1.01%で上回っており、Audio8があらゆる評価で優位なわけではありません。
約4B規模のバックボーンを持つHiggs TTS 3は、CV3で4.41%、MiniMaxで2.74%を報告し、いずれもAudio8より低い誤り率です。MiniMaxでQwen3-TTS-1.7Bに示された27.41%という数値も、そのモデルが公式には試験対象24言語のうち10言語だけをサポートしている点を考慮しなければなりません。対応外の言語を含む平均値と、対象言語を絞った性能を同列に扱うと、モデル選定を誤る可能性があります。
Edge0自身も、評価パイプラインやテキスト正規化の方法がモデルごとに異なるため、比較表は参考値だと位置付けています。WERは単語単位、CERは文字単位の誤りを見る指標であり、言語の表記体系によって採用される尺度も変わります。公開値だけで順位を決めるより、自社で実際に読む固有名詞、数字、略語、住所などを含む試験文を用意し、誤読率と聴感の両方を調べる方が実務的です。音声の自然さについては、発話間の間隔や長時間聴いた際の疲れやすさも評価対象になるでしょう。
23言語対応でも残る言語ごとの品質差
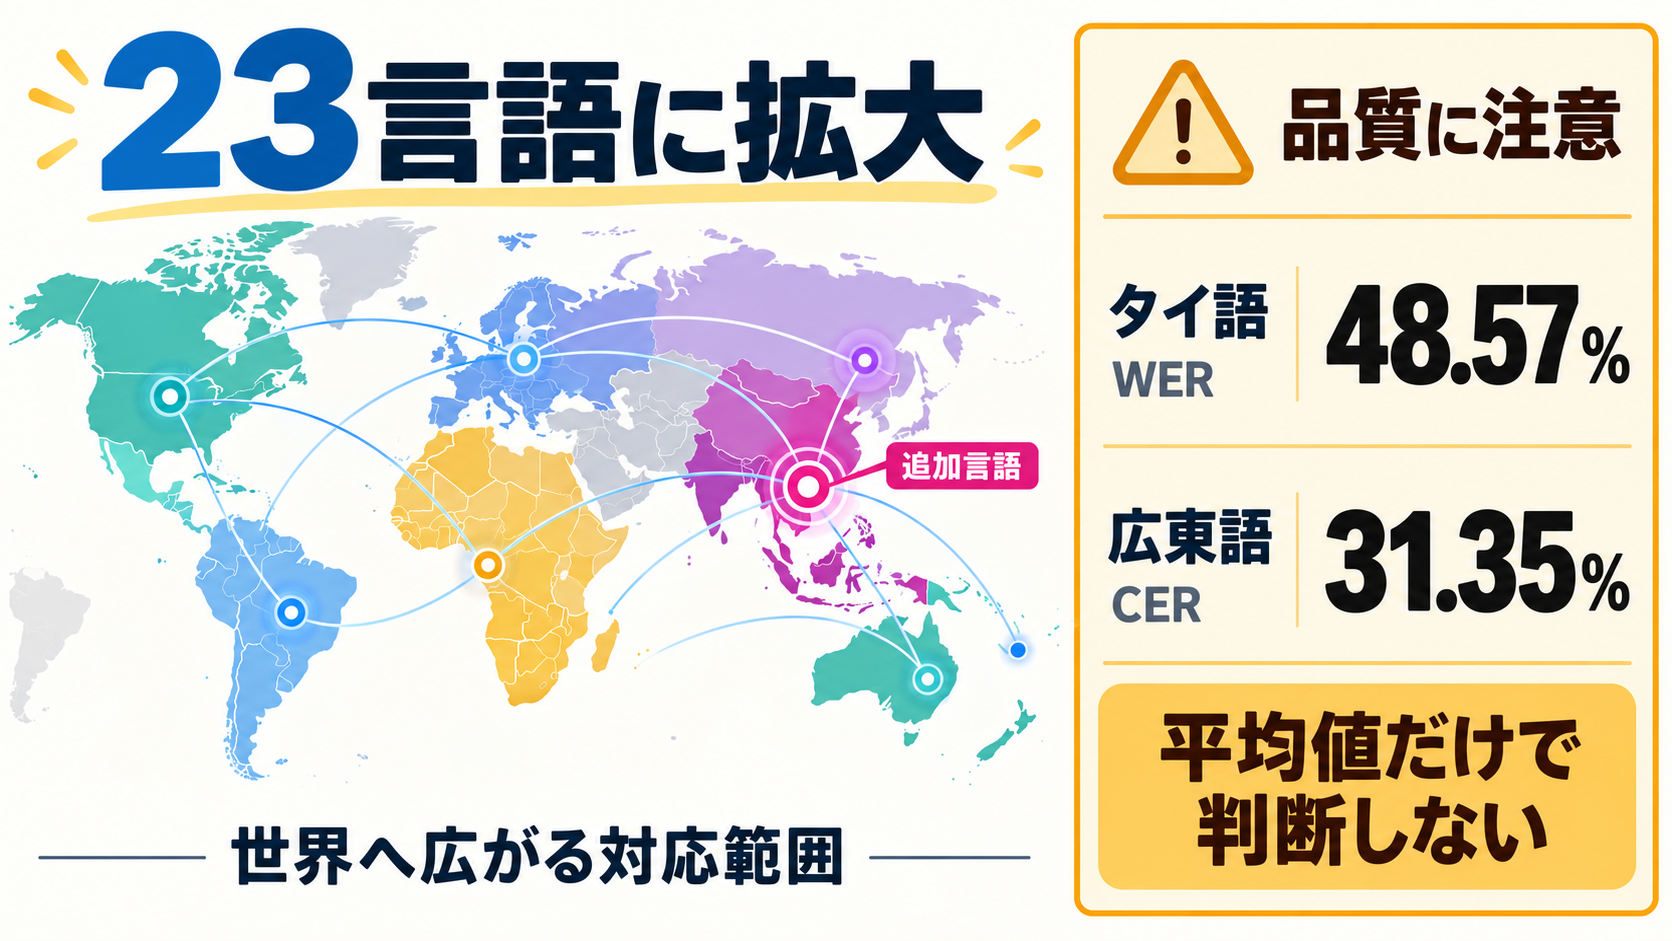
対応言語が前世代より12増えたことで、単一の音声基盤からアジア、欧州、中東の複数市場へ展開できる範囲は広がりました。特に、1本の参照音声とその正確な書き起こしだけで声を再現できる点は、言語ごとに話者データを大量収集しにくい場面と相性があります。同じブランドボイスを複数言語の案内へ展開したい企業にとって、検証候補になり得るでしょう。
ただし、「対応」と「業務で安定して使える品質」は同義ではありません。CV3におけるタイ語のWERは48.57%で、MiniMaxにおける広東語のCERも31.35%でした。平均値が良好でも、特定言語では発話内容の正確さに大きな課題が残っています。コールセンターの回答、契約条件の読み上げ、医療や金融に関わる案内など、言い間違いの影響が大きい用途では、平均スコアではなく対象言語ごとの最悪値を重視すべきです。
言語資源の量だけでなく、文字と発音の関係、声調、分かち書き、数字の読み方なども難易度へ影響します。書き起こしに誤りがあると、音声クローンの品質評価自体が不正確になるため、参照クリップとテキストの一致確認も必要です。雑音が少なく、話者が一人で、発話の開始と終了が明確な素材を用意することが、モデル比較以前の前提になります。
日本語で利用する場合も、23言語対応というラベルだけで採用を決めるべきではありません。人名、企業名、製品コード、英数字の混在、敬語表現など、自社特有の文章を使った試験が求められます。海外拠点へ展開するなら、各地域の母語話者による確認を組み込み、誤読だけでなく、アクセントや話す速度が利用場面に合うかも見なければなりません。多言語対応の広さは入口であり、採用判断は言語別、用途別に行うのが妥当です。
GPU配信から省メモリ実行までの現実的な選択肢
基本的な実行環境として、PyTorch 2.5以降とTransformers 4.57以降が案内されています。モデル固有コードを読み込むため、利用時にはtrust_remote_codeを有効にします。これは導入を簡単にする反面、外部コードを実行する設定でもあるため、企業環境では依存関係を固定し、コードレビューや脆弱性確認を経てから本番へ持ち込むべきでしょう。リポジトリにはCLI、バッチ処理、教師あり微調整用のスクリプトも含まれています。
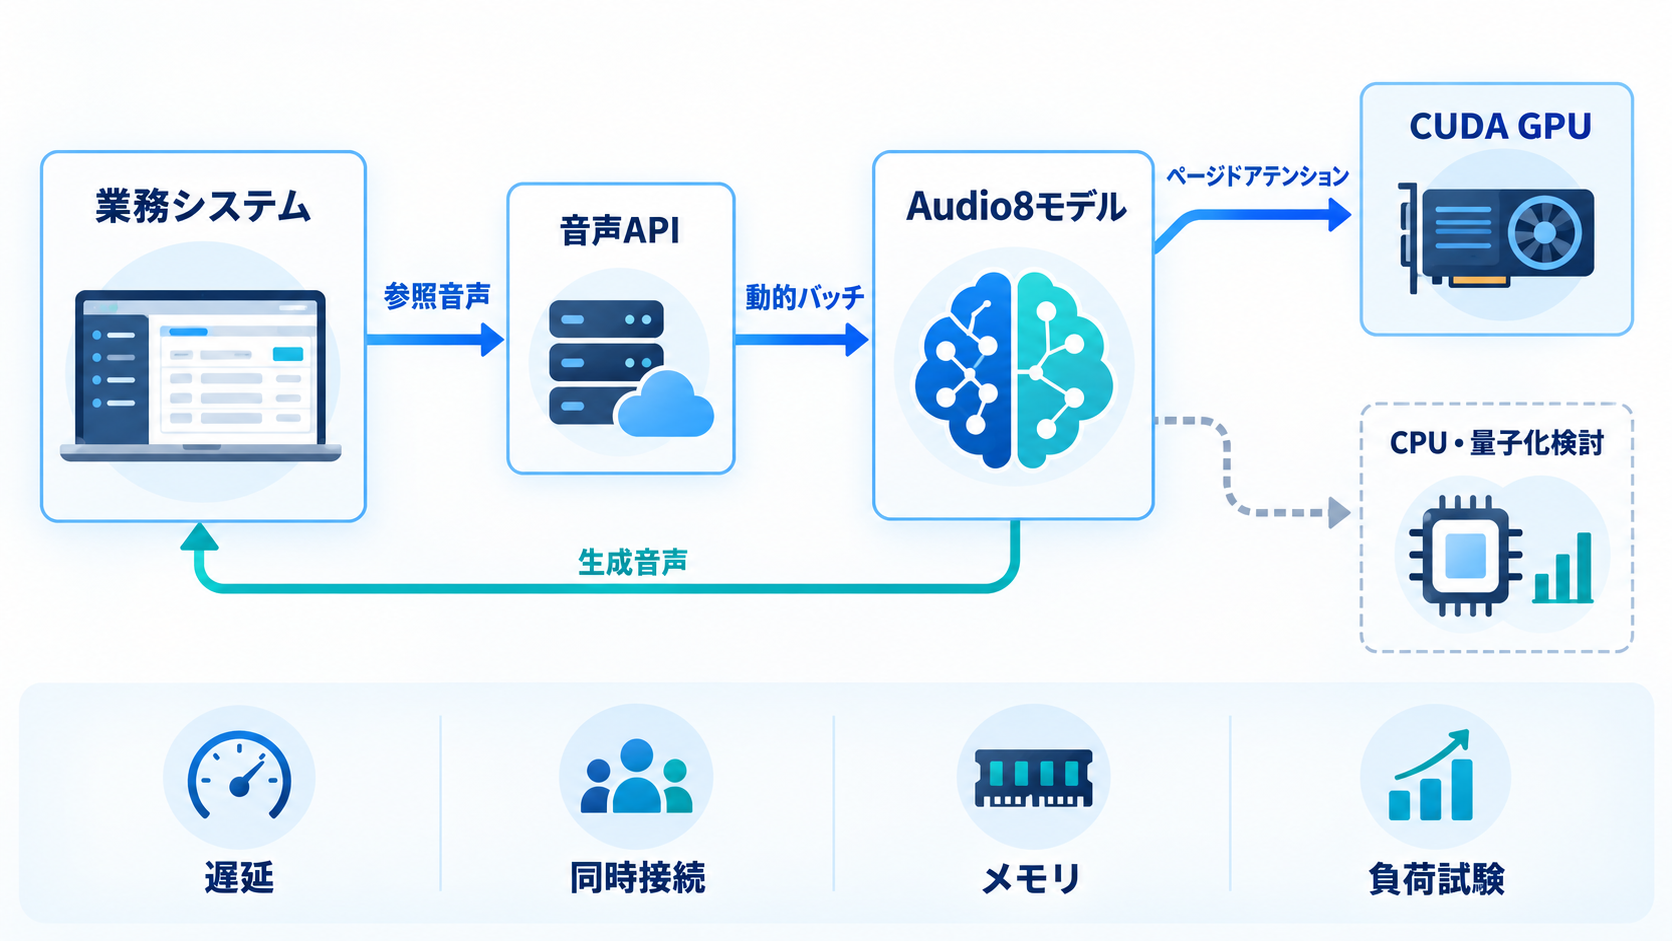
Edge0はCUDA対応GPUを推奨し、NVIDIA H20上のBF16で動作確認しています。技術報告では、Apple M2 CPUでINT4量子化したONNX版を動かした際、ピークメモリが1.1~1.2GiBだったとされています。ただし、Audio8-TTS-Realistic向けのONNXエクスポートは現時点で公開されていません。このメモリ値だけを根拠に、現在の公開物が同じ条件でCPU運用できると判断するのは早計です。
GPU配信向けにはSGLang Omni用アダプターがあり、ページドアテンション、動的バッチ処理、OpenAI互換の「/v1/audio/speech」APIを利用できます。既存システムが同種の音声APIを呼び出している場合、接続部分の設計をそろえやすくなります。Hugging FaceのZeroGPU上では、無料のPlaygroundも提供されています。初期評価では、環境構築に入る前に発音や声質を確認する用途に使えるでしょう。
注意したいのは、スループットとストリーミング性能がベンチマークされていない点です。対話型サービスでは、音声全体の生成時間だけでなく、最初の音が返るまでの遅延が体験を左右します。大量配信では、同時リクエスト数、バッチ化による待ち時間、GPUメモリ使用量、障害時の切り替えも確認が必要です。601Mという規模は運用上の期待材料になりますが、本番の費用と応答性は、実際の文章長や同時接続条件を再現した負荷試験で確かめる必要があります。
企業導入で先に決めたい評価基準と音声ガバナンス
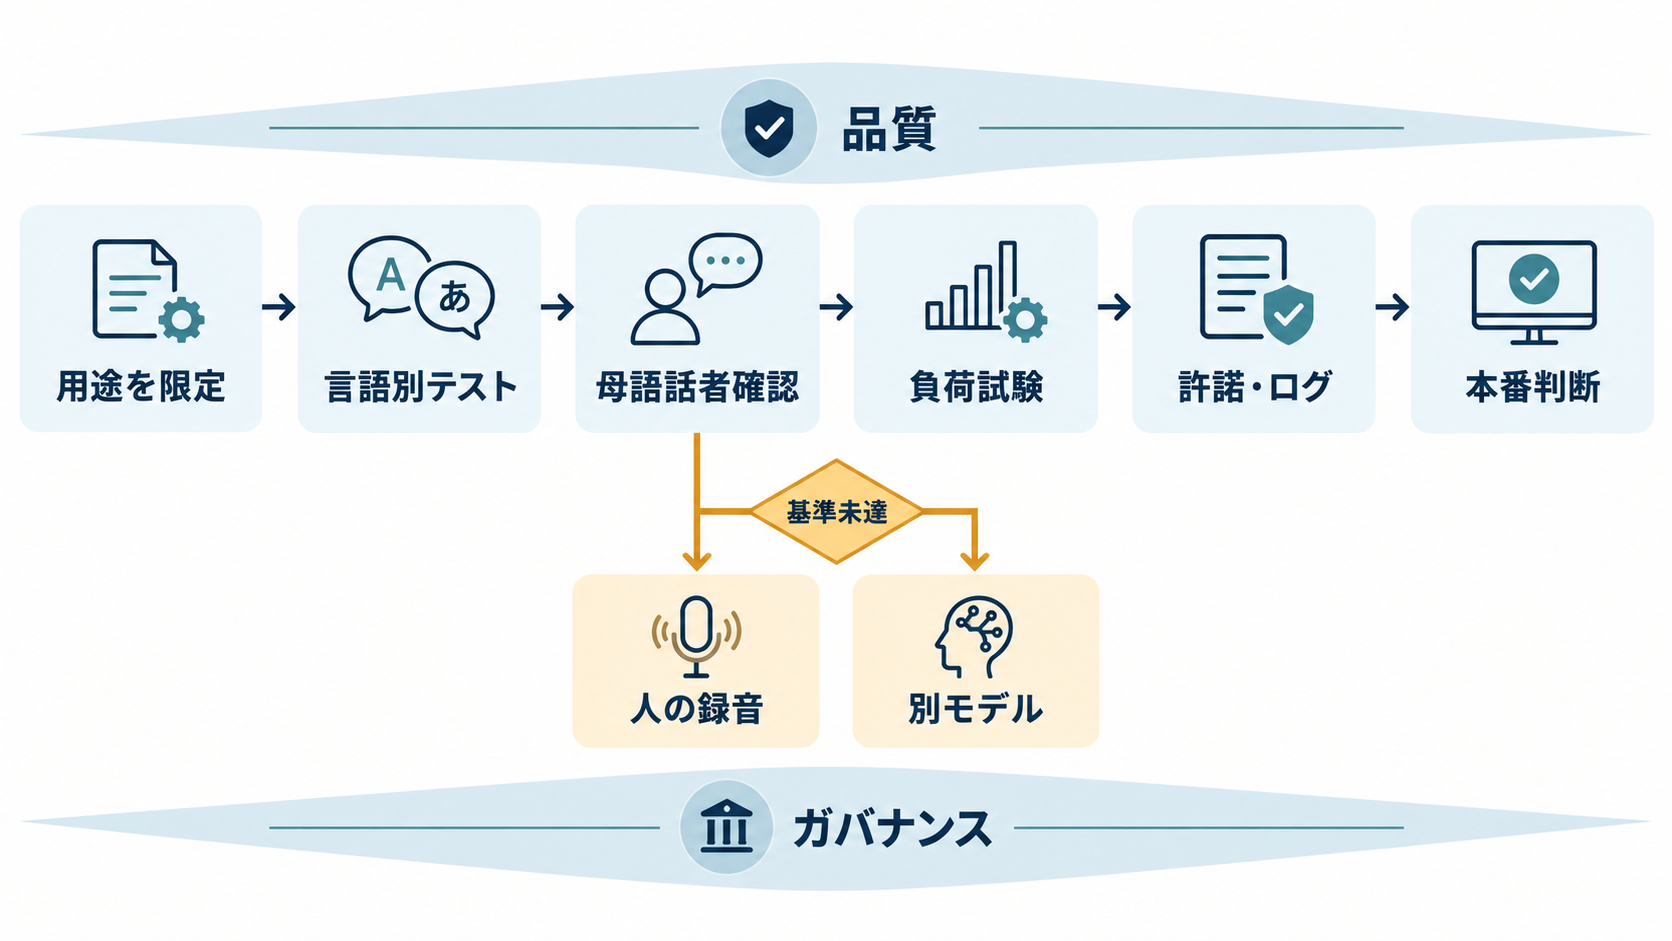
Audio8-TTS-Realisticを評価する際は、「人間らしく聞こえるか」という主観的な問いだけで始めない方が進めやすくなります。用途ごとに許容できる誤読、応答時間、費用、話者類似度を定め、対象言語ごとの試験文を固定すると、モデル更新後も同じ条件で比較できます。自動指標は候補の絞り込みに使い、最終段階では母語話者によるブラインド聴取を組み合わせるのが現実的でしょう。
検証は、短い定型案内、固有名詞を含む文章、長文、数字や単位を含む文章など、失敗の種類が分かるように分けます。参照音声の長さや録音条件もそろえなければ、モデル差と入力品質の差を切り分けられません。タイ語や広東語で示されたような弱点を考えると、サービス全体の平均ではなく、言語別の最低基準を設ける方が安全です。基準に届かない言語だけ人の録音や別モデルへ切り替える構成も検討できます。
音声クローンでは、技術評価と同時に、声の利用許諾を明確にする必要があります。本人の同意、使用目的、利用期間、再利用の範囲、削除手続きなどを記録し、参照音声と生成物へのアクセスを制限します。第三者になりすました音声の生成を防ぐため、利用者認証、操作ログ、出力の持ち出し管理、公開前の確認手順も欠かせません。Apache 2.0で提供されるモデルの利用条件と、声そのものに関する権利や契約は別の論点です。
最初の一歩としては、対応言語数の多さを前提に全社展開するのではなく、誤読時の影響が限定的な社内研修や下書き音声などから試す方法が考えられます。そこで実測した精度、遅延、GPU費用、修正工数を、人による収録と比較します。Audio8-TTS-Realisticが適するかどうかは、ベンチマークの順位だけでなく、自社の文章と運用ルールを通したときに、品質と管理可能性を両立できるかで判断すべきでしょう。