
2026/10/29
AIニュース
NVIDIA「Nemotron 3.5 Transcribe」が音声処理を統合――40言語の文字起こし・話者識別・翻訳を1モデルで
分業型の音声処理を1モデルに集約
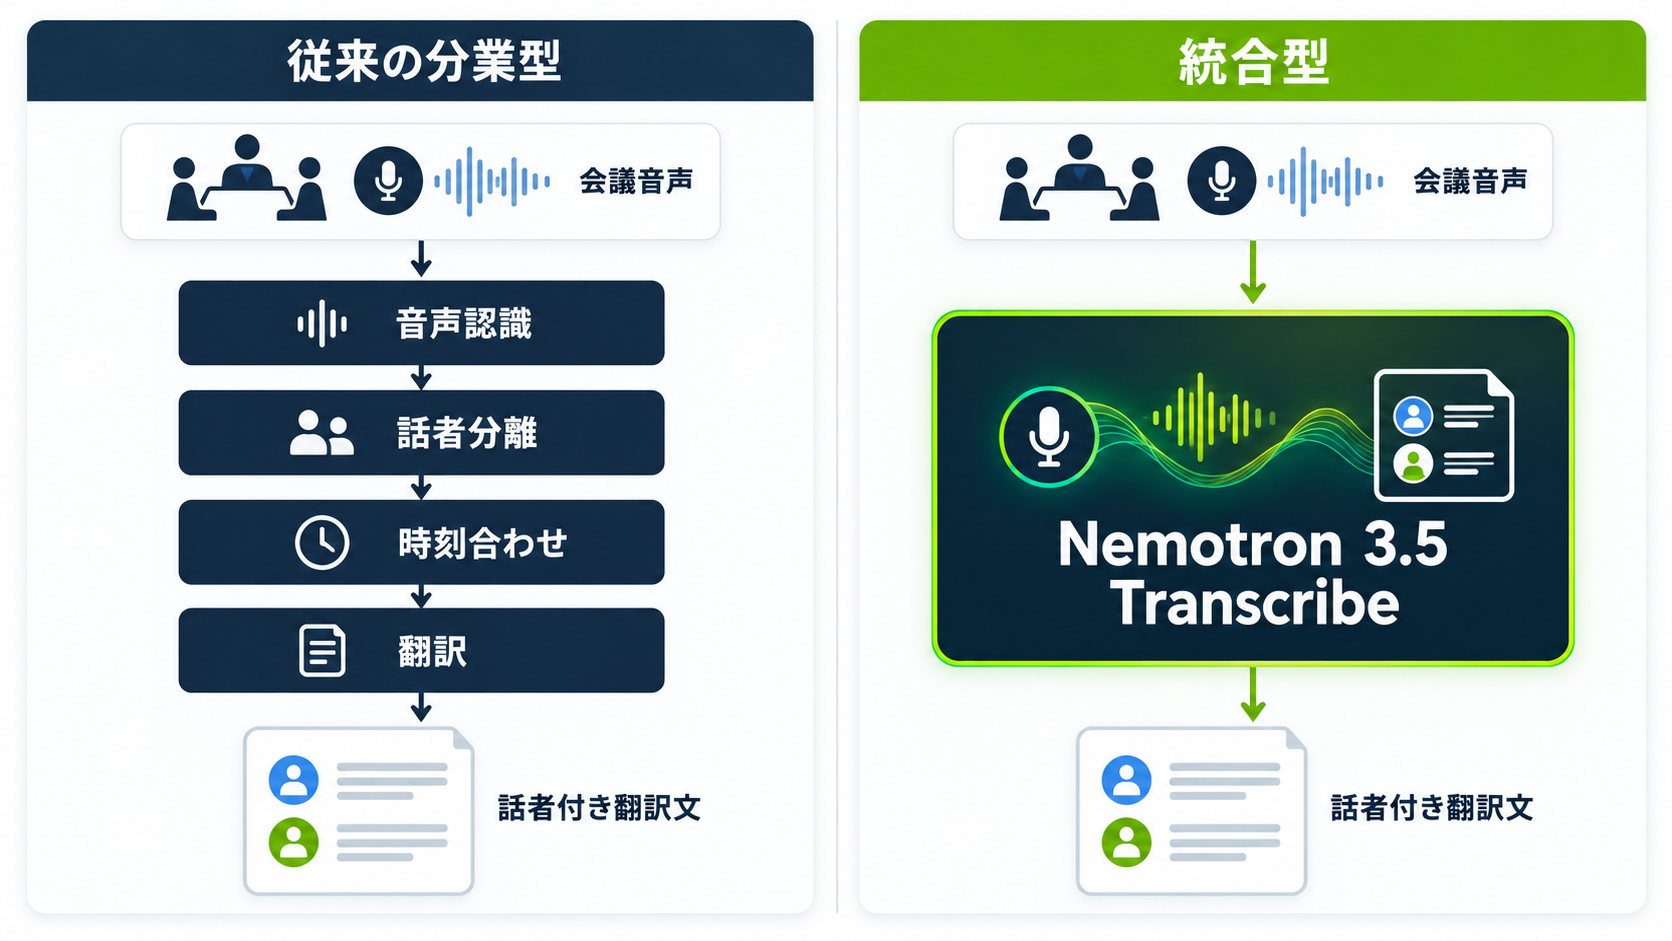
会議の録音から「誰が、いつ、何を話したか」を記録し、必要に応じて翻訳まで行うには、一般に複数の処理を組み合わせます。音声認識で文章を作り、話者分離で発言者を判定し、アラインメント処理で単語と時間を対応させるという構成です。企業システムでは、それぞれのツールが出力するデータ形式や誤差を調整する工程も必要になります。NVIDIAが公開したNemotron 3.5 Transcribeは、こうした役割を単一のオープンウェイトモデルにまとめています。対応言語は40言語で、最長1時間の音声を一度に扱えます。文字起こしだけでなく、最大8人の話者識別、単語単位のタイムスタンプ、翻訳にも対応し、求める出力をテキストの指示で切り替えられる点が特徴です。
企業にとって注目すべき点は、認識精度の数値だけではありません。別々に構築していた音声認識、話者分離、時刻合わせのパイプラインを、共通のモデルと指示形式へ寄せられる可能性があります。構成部品が減れば、データ受け渡しや障害原因の切り分けは単純になります。ただし、すべての処理が同じモデルに依存するため、不得意な言語や録音環境が業務全体へ影響する点には注意が必要です。統合の利便性と、用途別に最適なツールを選ぶ柔軟性を比較することが導入判断の中心になります。
長時間音声を支えるハイブリッド構成
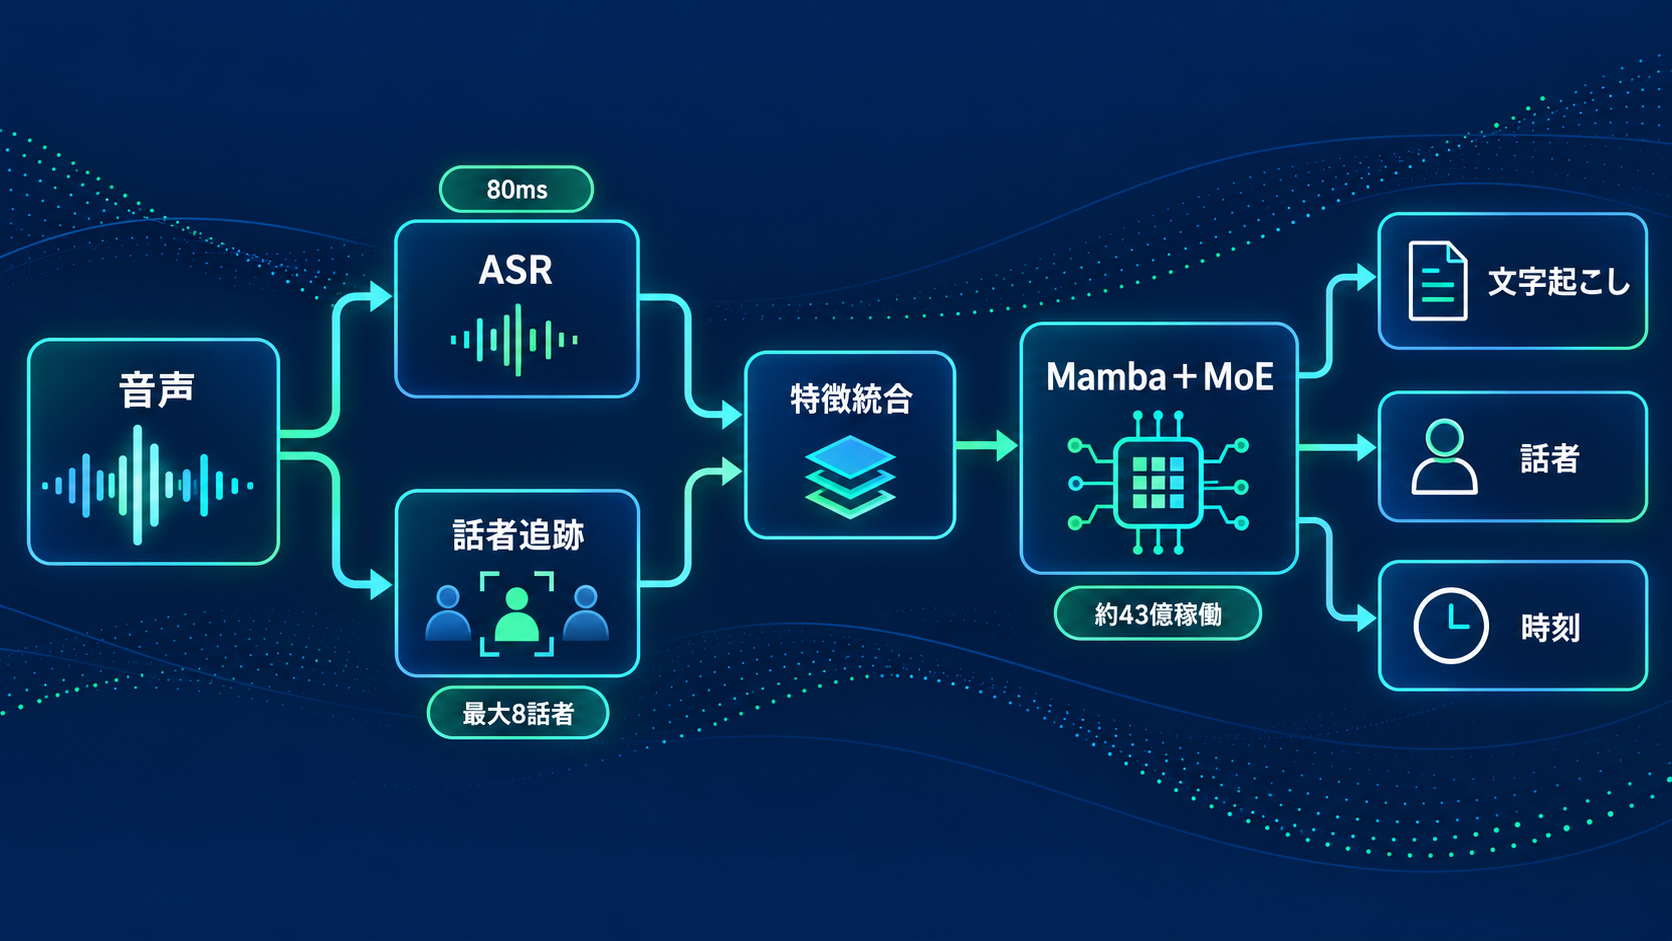
Nemotron 3.5 Transcribeは、音声を理解するエンコーダーと、指示に従って文章を生成するLLMを接続したSpeech-Augmented Language Modelです。音声だけを文字列へ変換する従来型の音声認識とは異なり、音声とテキスト指示の両方を入力として扱います。NVIDIAは汎用アシスタントではなく、文字起こしに特化したモデルとして位置付けています。音声側では、6億パラメーターのASRエンコーダーと、固定されたNemotron 3 Diarizationモデルが並列に動作します。後者は話者の活動を追跡するモデルで、最大8人について「誰が話しているか」という情報を80ミリ秒ごとにASRの特徴へ加えます。これにより、LLM本体の構造を変更せず、音声内容と話者情報を同時に参照できる仕組みです。
LLMにはNemotron 3.5 Lightning 30B-A3Bが使われています。Mamba-2、Transformerの注意機構、専門家を選択して動かすMixture of Experts(MoE)を組み合わせた52層の構成です。MoE層では128の専門家のうち6つと、1つの共有専門家が選ばれます。モデル全体は約340億パラメーターですが、推論時に動作するのは約43億パラメーターに抑えられています。
注意機構の層を6層に限定しているのも、1時間規模の音声を扱うための工夫です。生成済み情報を保持するKVキャッシュの増大を抑え、65,536トークンのコンテキストを利用しやすくしています。生成後には5,000万パラメーターのCTCアダプターが文章と音声を対応付け、単語単位のタイムスタンプを付与します。投機的デコーディング向けのMTP層も備え、出力品質だけでなく処理速度まで含めて設計されています。
指示文で変えられる文字起こしの形
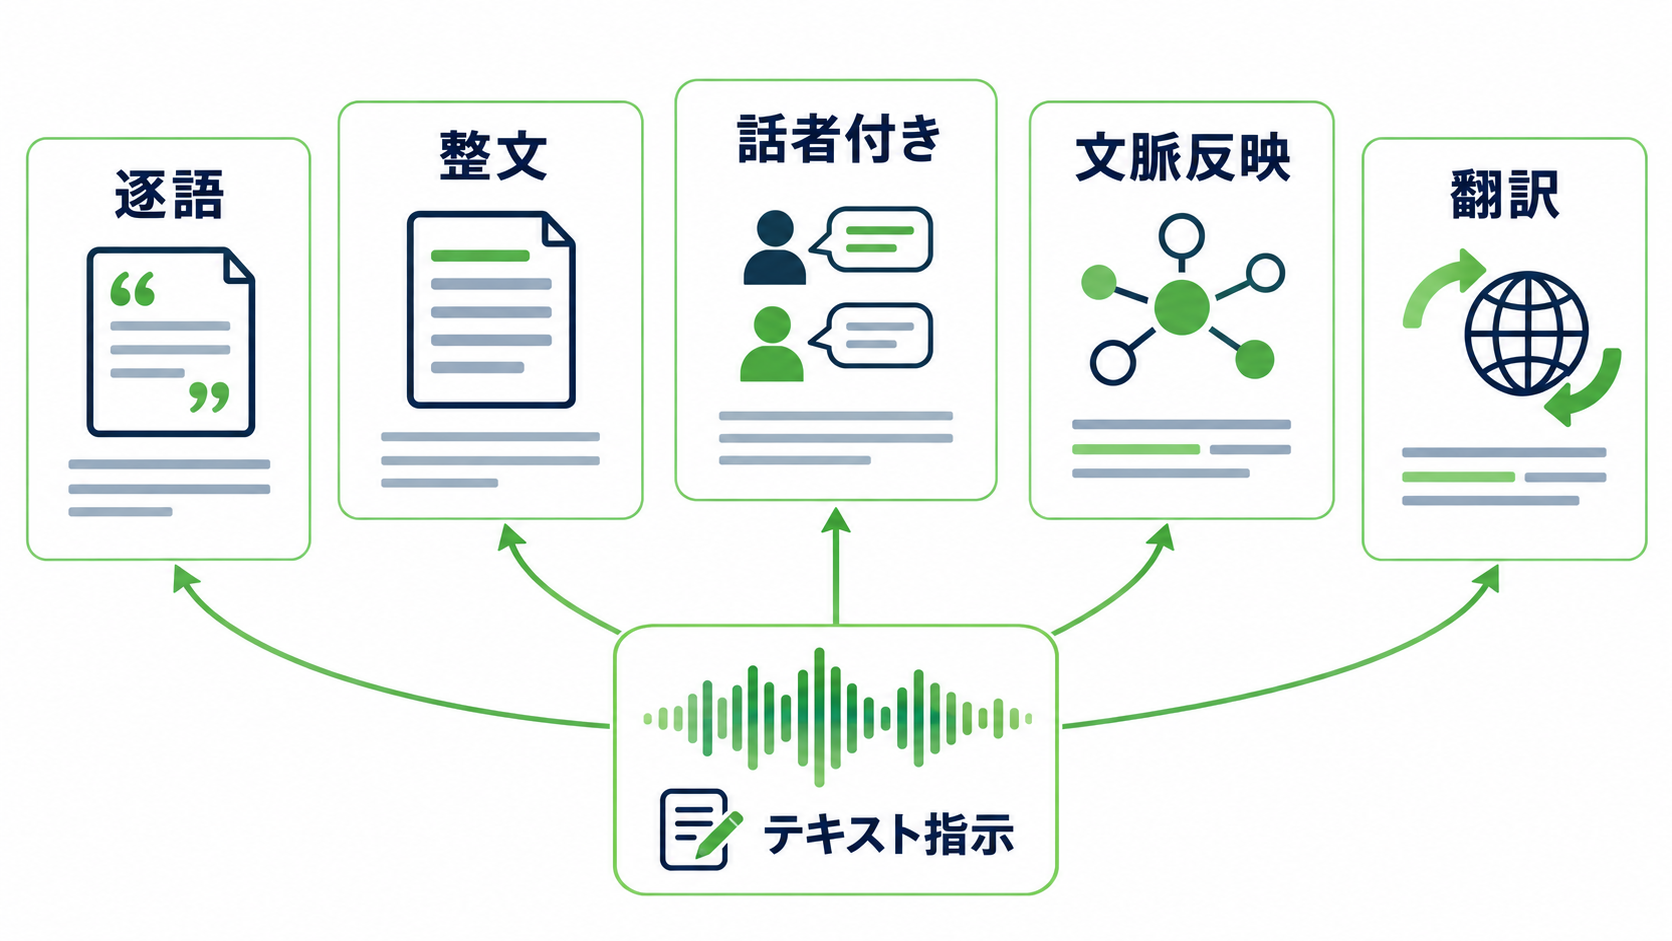
同じ会話でも、議事録、字幕、監査記録では必要な文章が異なります。言いよどみやフィラーを残した逐語記録が必要な場面もあれば、読みやすい書き言葉へ整えたほうがよい場面もあります。Nemotron 3.5 Transcribeでは、この違いを別モデルや後処理プログラムで吸収するのではなく、リクエストごとのテキスト指示で指定します。選択できる出力には、発話をそのまま残す逐語形式、文章として整える書き言葉形式、話者名を付けた形式、与えた文脈を反映する形式、別言語への翻訳が含まれます。NVIDIAが示している考え方は、「正しい文字起こし」が常に一つに決まるわけではないというものです。数字の表記、不要語の扱い、専門用語の選択は、記録を読む人と利用目的によって変わります。
文脈を指示できる機能は、製品名、人物名、業界用語を多く含む業務で特に検証価値があります。ContextASR-Benchでは、候補となる固有表現の一覧を与えることで、固有表現に関するWERが12.21%から2.20%へ低下したとNVIDIAは報告しています。ただし、これは指定されたベンチマーク上の結果であり、あらゆる社内用語が同じ割合で改善することを意味しません。
実務では、用途別に長い指示を毎回作るより、「会議議事録」「コンタクトセンター記録」「字幕」といったテンプレートを用意する運用が考えられます。モデル更新後も同じ録音と指示で出力を比較できるため、品質評価の再現性も確保しやすくなるでしょう。自由度の高い指示機能を、管理可能な業務仕様へ落とし込めるかが活用の鍵になります。
ベンチマークが示す強みと弱点
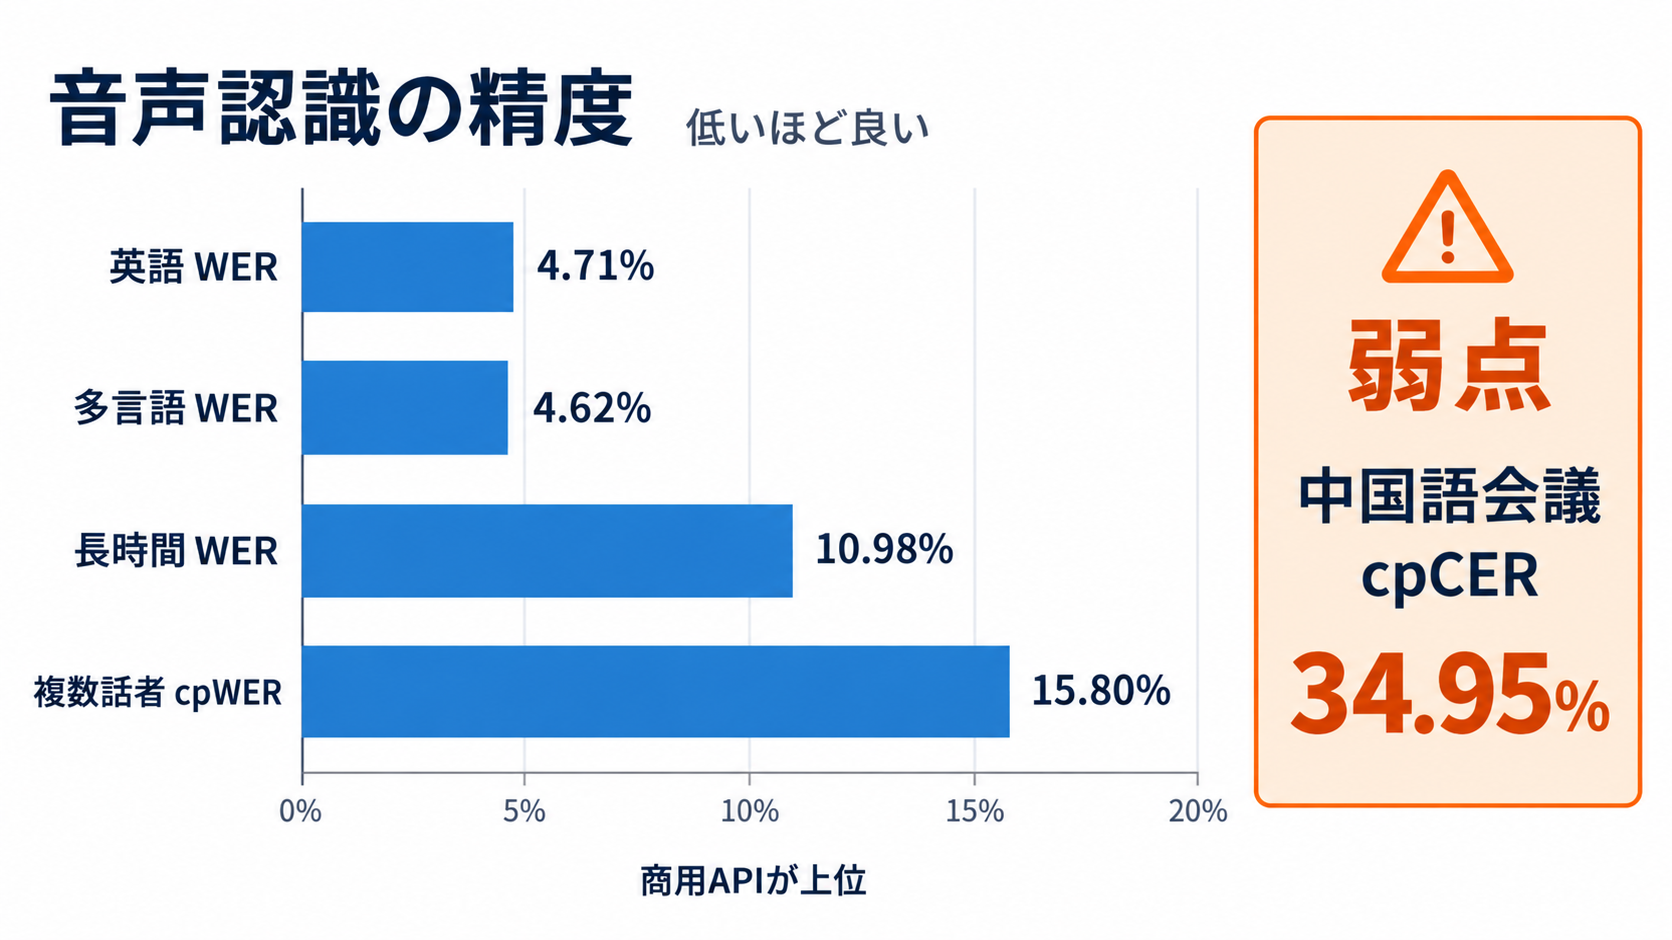
NVIDIAの技術報告によると、英語のOpen ASR Leaderboardで使われる9つの公開データセットにおける平均WERは4.71%です。比較対象となったオープンウェイトモデルでは最良で、Qwen3-ASR-1.7Bの4.94%を上回りました。ただし、商用サービスを含めると7つのシステムがNemotronより上位に位置し、首位のOtterAI speech-v3.1は3.88%でした。WERは、正解文に対して単語の置換、削除、挿入がどれほど発生したかを示す指標で、値が低いほど良好です。7言語を対象とする多言語評価では平均4.62%となり、Qwen3-ASR-1.7Bの6.49%を下回りましたが、商用のElevenLabs Scribe v2は3.56%でした。長時間音声では平均WERが10.98%で、比較されたParakeet-TDT-0.6B-v3の13.37%より低い結果です。
複数話者のセッション全体を評価するcpWERは15.80%で、DiCoW v3.3とDiariZenを組み合わせた構成の16.83%を上回りました。NVIDIAは、話者情報を内部に取り込むSALMが、処理を順番につなぐカスケード型システムをこの評価で上回った初の例だと説明しています。統合モデルの価値を示す結果ですが、数値はいずれもNVIDIAによる自己報告であるため、導入側での再検証が欠かせません。
弱点も明確です。中国語の遠距離会議音声を扱うAliMeetingでは、文字単位かつ話者対応を考慮したcpCERが34.95%でした。コードスイッチング、つまり会話中に複数言語が切り替わる状況も課題として挙げられています。公開ランキングの評価セットは時期によって変更されており、競合各社のモデルカードに掲載された過去のWERと、NVIDIAが2026年10月時点のランキングから引用した値は直接比較できません。順位だけを見るのではなく、自社に近い言語、話者数、マイク距離、音質の評価結果を重視すべきです。
H100からRTX 5090までの展開方法
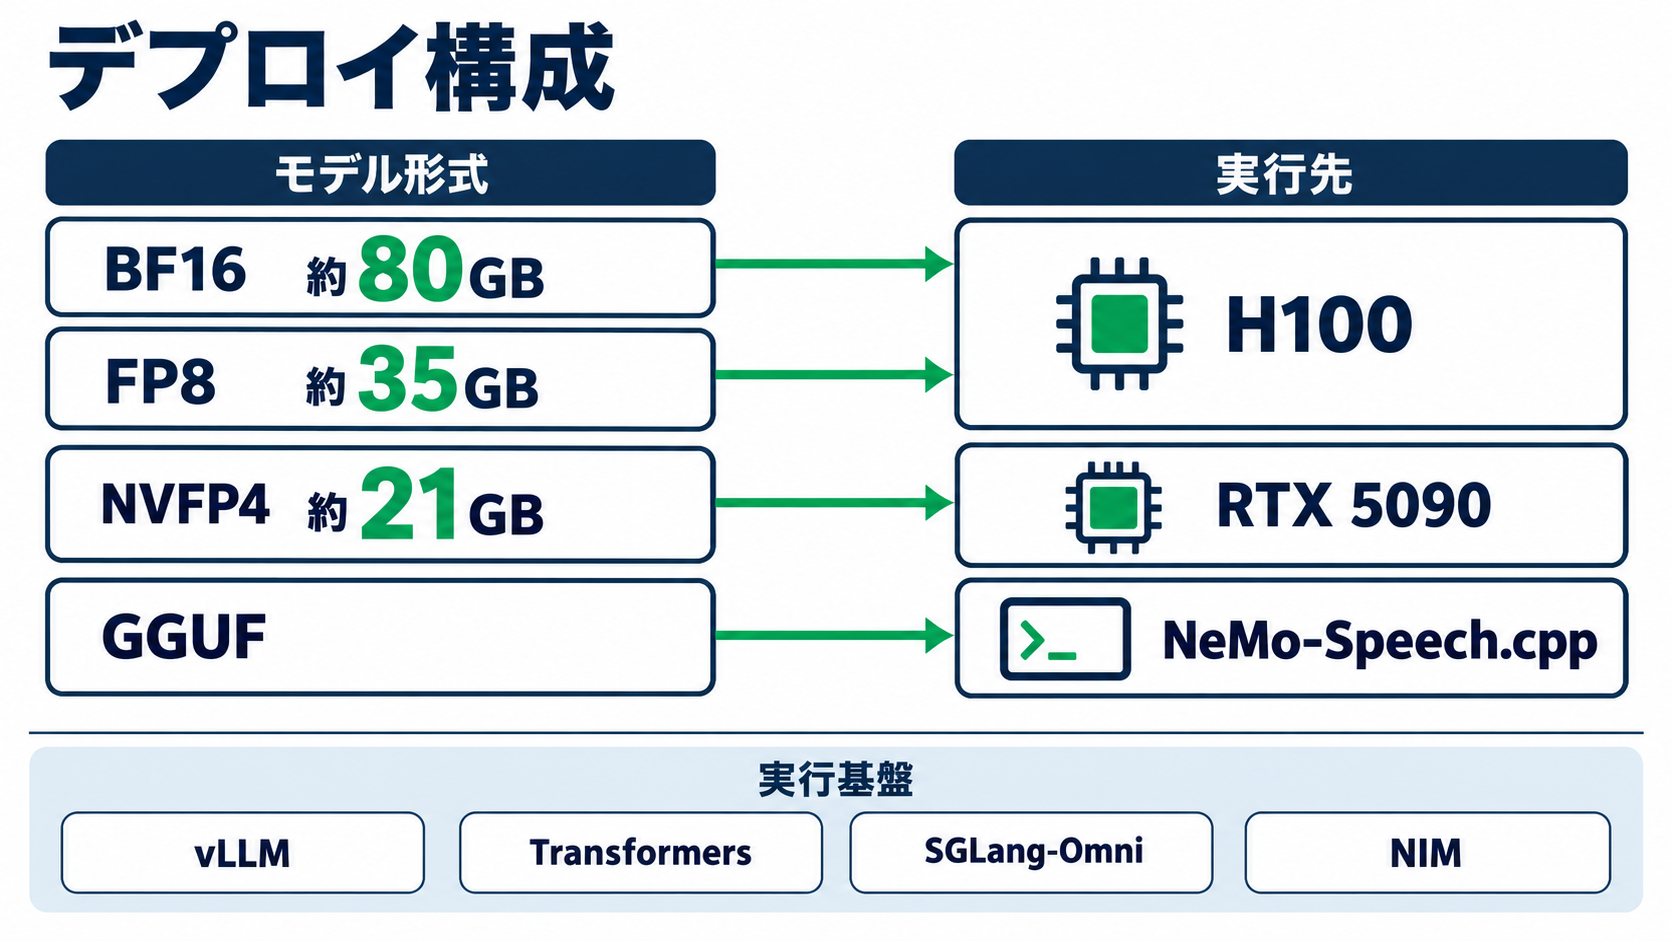
配布されるチェックポイントにはBF16、FP8、NVFP4、GGUFがあります。BF16版は80GBメモリーを備えたNVIDIA H100 GPU 1基で動作します。約35GBのFP8版と約21GBのNVFP4版も用意され、NVFP4はコンシューマー向け上位GPUのRTX 5090で実行可能とされています。GGUF版は、ローカル推論向けのNeMo-Speech.cppを対象としています。対応ランタイムには、LLM推論基盤のvLLM 0.32.0とNeMo Speechプラグイン、Transformers、SGLang-Omni 0.2.0があります。vLLMはOpenAI互換APIを提供するため、同形式のAPIを利用する既存アプリケーションから接続しやすい構成です。ライセンスはOpenMDW-1.1で、商用利用が認められていますが、実際の製品組み込みでは利用条件を個別に確認する必要があります。
NVIDIAが示した最高速度は、Nemotron Transcribe NIM、NVFP4、DFlash2を組み合わせた場合のものです。RTX PRO 6000 Blackwell Server Edition 1基で、1秒当たり2,238秒分の音声を処理し、30秒のクリップを0.13秒で返したとされています。ただし、この速度を実現する配信最適化は現時点でオープンソース化されていません。公開時点のvLLM経路は、おおむね2倍遅くなるとNVIDIAは見積もっています。H100上のBF16とMTP2の組み合わせでは、実時間の約410倍の処理速度が推定されています。
モデルの重みが公開されていることと、最速の配信環境をそのまま再現できることは別問題です。企業が費用を見積もる際は、モデル容量だけでなく、利用可能なランタイム、量子化による品質変化、同時リクエスト数、音声の平均時間まで確認する必要があります。NVIDIAは17種類のファインチューニング課題について、GB300 GPU 1基で各0.5~2.3 GPU時間を要したと報告していますが、自社データで必要になる学習量や効果は別途測定すべきでしょう。
競合モデルとの比較で見える選択基準
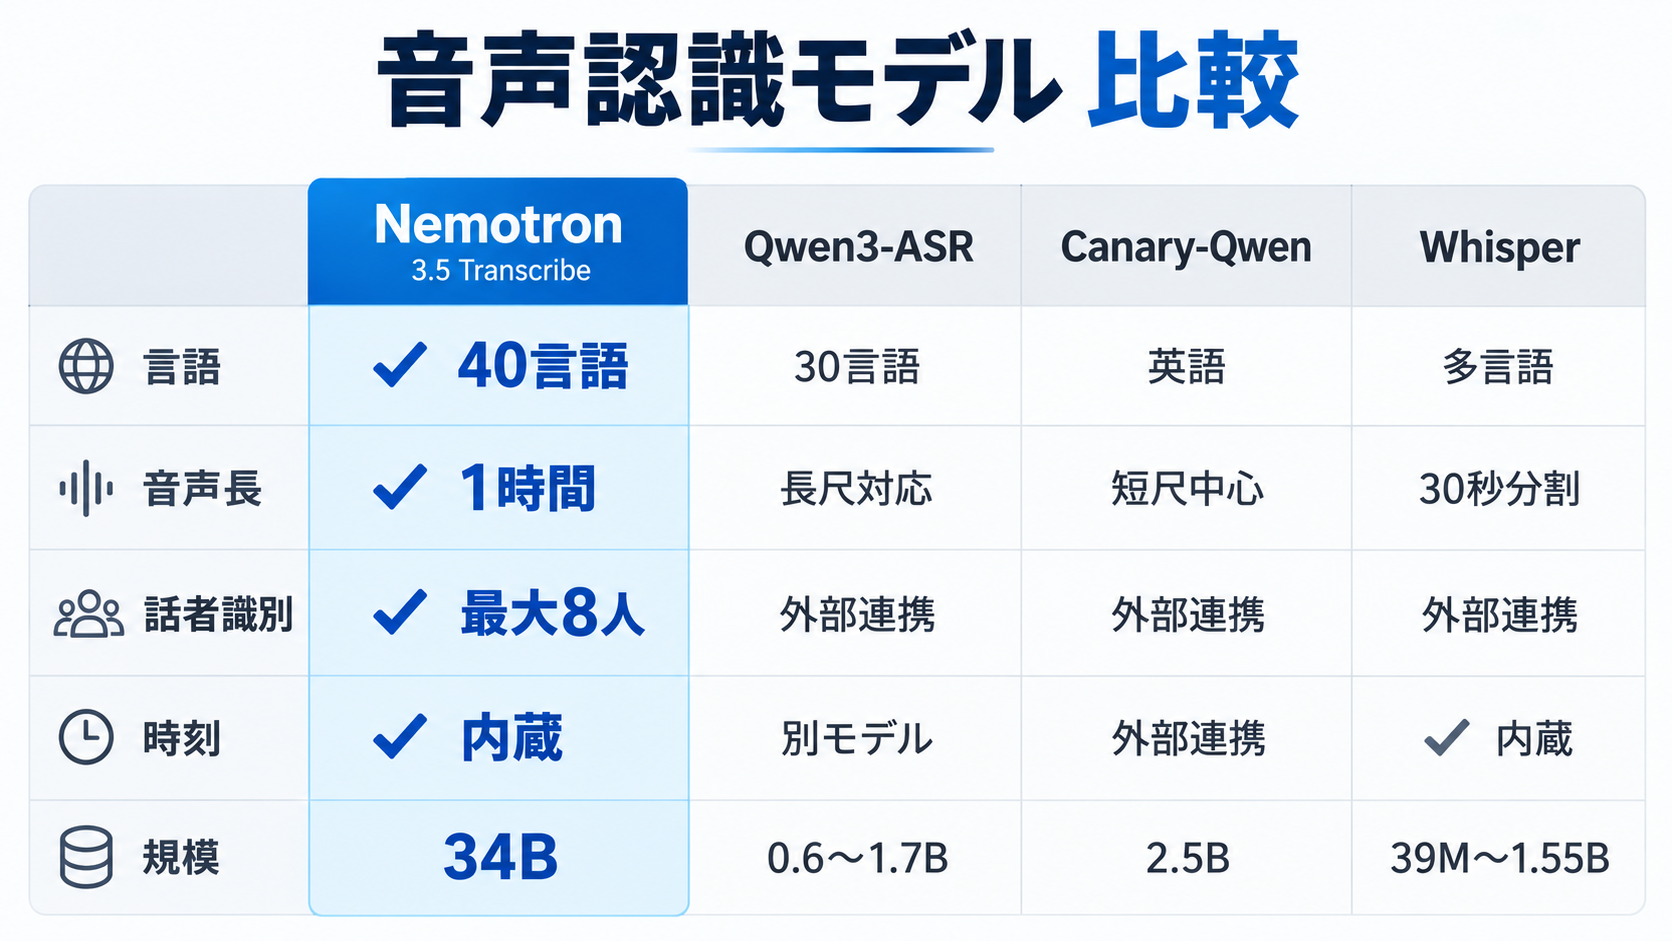
Nemotron 3.5 Transcribeの約340億という総パラメーター数は、Qwen3-ASR-1.7Bの17億、Canary-Qwen-2.5Bの25億、Whisper-large-v3の15.5億より大きな規模です。ただし、MoE構成によって実際に動作するのは約43億パラメーターです。総容量は保存や読み込みに影響し、アクティブパラメーター数は推論時の計算量を考える手掛かりになるため、両方を分けて見る必要があります。機能面では、Nemotronが40言語、最長1時間、最大8人の話者識別、単語タイムスタンプ、翻訳を1モデルで扱える点が際立ちます。Qwen3-ASR-1.7Bは30言語と22の中国語方言に対応しますが、比較情報では話者識別が示されておらず、単語タイムスタンプには別のForcedAligner-0.6Bを利用します。Canary-Qwen-2.5Bは英語専用で、学習時の音声長は40秒です。Whisper-large-v3は99言語がHugging Face上のタグで示され、30秒単位の窓を連結して長時間音声を処理します。
ライセンスにも違いがあります。NemotronはOpenMDW-1.1、Qwen3-ASR-1.7BとWhisper-large-v3はApache-2.0、Canary-Qwen-2.5BはCC-BY-4.0です。オープンウェイトという分類が同じでも、再配布、表示義務、商用サービスへの組み込み条件まで同一とは限りません。技術評価と法務確認を切り離さず、採用候補ごとに利用形態を照合する必要があります。
小さなモデルは限られた計算資源で扱いやすく、個別ツールを選べる構成には交換のしやすさがあります。Nemotronの優位性は、単純にモデルサイズが大きいことではなく、文字起こし後に必要となる複数の処理を共通の指示と出力へ統合できる点です。話者情報や翻訳が不要な用途なら、より小さなモデルが合理的な場合もあります。必要な機能の組み合わせと運用コストを起点に比較するのが適切です。
日本企業が検証すべき実務上の条件
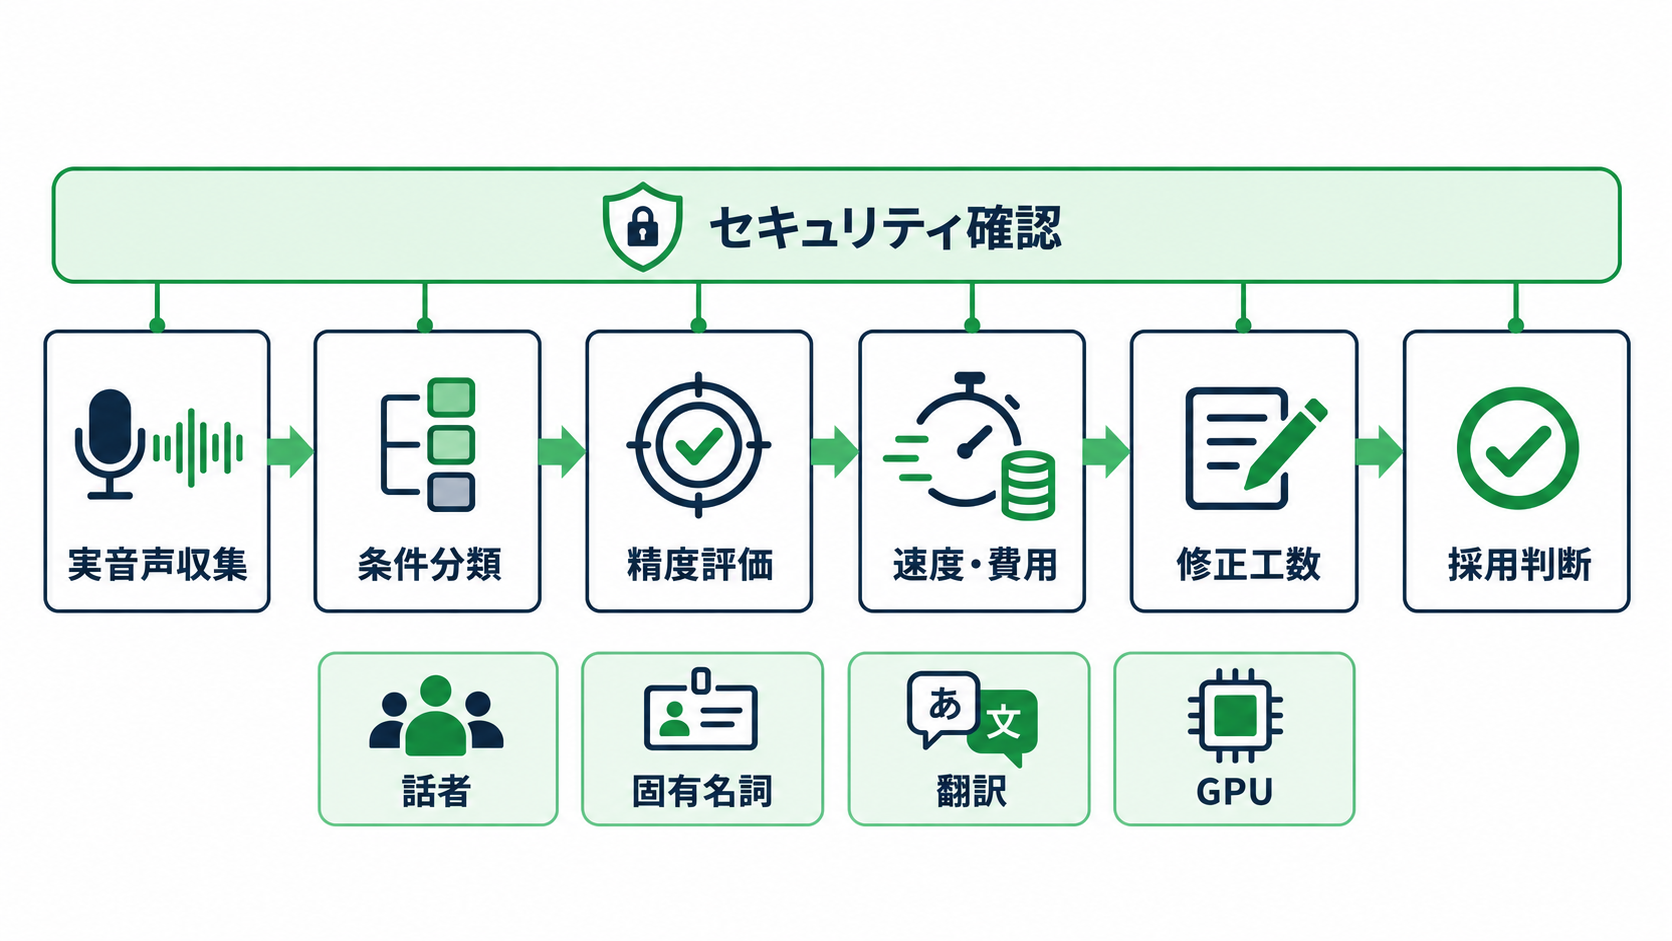
企業導入では、公開ベンチマークの音声と実際の録音環境の差が問題になります。会議室の反響、複数人の同時発話、オンライン会議の圧縮音声、社内略語などは、平均WERだけでは把握できません。Nemotron 3.5 Transcribeはオフライン処理のみとされているため、リアルタイム字幕や通話中の応答を求めるシステムでは要件との適合を慎重に確認する必要があります。検証では、次の項目を同じ音声セットで確認すると比較しやすくなります。
- 実際に利用する言語が対応対象に含まれるかを確認します。公開情報では40言語とされていますが、言語別の一覧や精度は導入前に照合します。
- 通常の会議、遠距離マイク、雑音、発話の重なりを含む録音を分けて評価します。
- WERだけでなく、話者の取り違え、固有名詞、数字、タイムスタンプ、翻訳品質を用途別に測定します。
- BF16、FP8、NVFP4の各構成で、精度、速度、GPUメモリー、同時処理数を比較します。
- 自動出力を人が修正する時間を記録し、既存の文字起こし手段と総作業時間で比べます。
音声には個人情報や機密情報が含まれる場合があります。自社管理の環境で重みを動かせることはデータ管理上の選択肢になりますが、それだけで安全性が確保されるわけではありません。音声の保存期間、アクセス権、ログ、生成された文章の保管先まで含めた設計が必要です。モデルへの入力指示や固有表現リストも、業務データとして管理するのが適切でしょう。
最初の一歩は、大規模な置き換えではなく、代表的な録音を集めた小規模な評価セットを作ることです。話者数や録音条件を分類し、Nemotron単体の結果と既存パイプラインを同じ基準で比べます。認識率の差だけでなく、連携処理の削減、修正工数、必要なGPU費用まで測れば、統合モデルを採用する意味を具体的に判断できます。