
AI LAB
2026/10/24
4GB級VRAMで動くNVIDIA Nemotron 3.5 Bolt、端末内AIエージェントの実用性を検証
4GB級VRAMが変えるローカルAIエージェントの設計
音声アシスタントやゲーム内キャラクターに生成AIを組み込むとき、モデルの賢さだけでは製品になりません。ユーザーの発話を認識する音声モデル、周囲を捉える視覚モデル、会話を組み立てる言語モデルを、限られた計算資源の中で同時に動かす必要があります。NVIDIAが公開したNemotron 3.5 Bolt E4B 4GBは、この制約を強く意識した小規模言語モデルです。GeForce RTX、Jetson、RTX Spark、DGX Sparkでのローカル実行を想定し、音声アシスタント、ゲームのNPC、ロボットの対話インターフェースを主な用途に挙げています。名称にある「4GB」は、モデルファイルの容量ではなく、量子化版を動かす際のVRAM使用量の目安です。NVIDIAの測定では、Q4_K_M量子化版がRTX環境で約3.1~4.3GBのVRAMを使用しました。言語モデルがGPUメモリを占有しすぎなければ、同じ端末に音声認識や画像認識などを載せる余地が生まれます。Boltの中心的な価値は、単体の最高性能ではなく、複数のAI機能を一つの端末に収めやすい点にあります。
ローカル処理には、クラウドとの通信を減らしやすく、ネットワーク状況に左右されにくいという設計上の利点もあります。ただし、端末内で動くことだけで遅延やプライバシーの問題が自動的に解決するわけではありません。音声処理を含むパイプライン全体の速度、ログの保存先、外部ツールへ送る情報、端末の消費電力まで含めて評価する必要があります。Boltは、その検討を4GB級のメモリ枠から始められる選択肢として位置づけられます。
8B総パラメーターと4B実効規模の意味
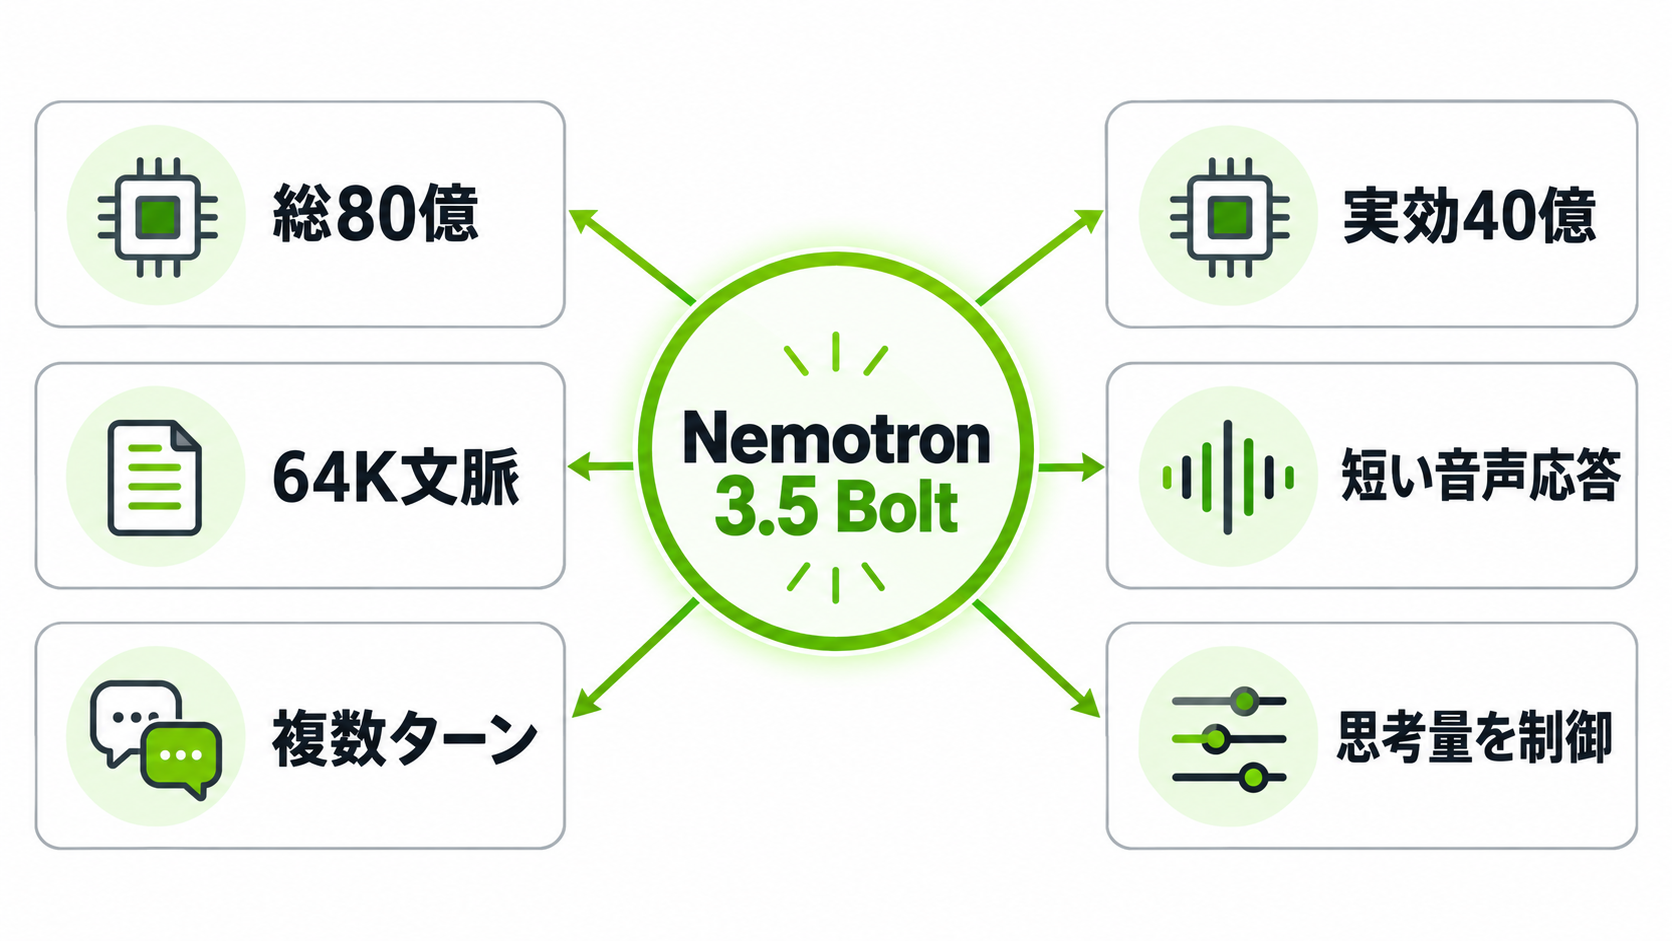
Nemotron 3.5 Bolt E4Bは、総パラメーター数が80億、推論時に実質的に使われる規模が40億とされています。小規模モデルとして扱われるのは、この実効パラメーター数と量子化時のメモリ効率によるものです。ベースにはGoogleのGemma 4 E4Bが使われ、NVIDIAがエージェント用途に向けた追加学習を施しました。64Kトークンのコンテキストを持ち、会話履歴だけでなく、ツール定義やアプリケーションの状態も同じ入力範囲に収められます。機能面では、複数ターンにまたがるツール利用と、非同期ツール呼び出しを扱うためのガイダンスが用意されています。たとえば、ユーザーの依頼を受けて機器の状態を確認し、その結果を待って返答するような処理を想定できます。`conversational_mode`を有効にすると、音声で聞き取りやすい短い応答を生成しやすくなります。長い説明よりも応答のテンポが求められる受付端末やキャラクター会話では、こうした出力制御が実装上の意味を持つでしょう。
推論の深さは設定可能で、実行時には思考量の上限を指定できます。複雑な依頼には一定の推論時間を与え、単純なあいさつには短く応答させるといった使い分けが可能です。ただし、64Kという入力長は、競合モデルが掲げる128Kや262Kより短く、長大な文書を丸ごと扱う用途では制約になり得ます。会話エージェントに必要な履歴をどこまで保持し、古い情報をいつ要約または破棄するかは、アプリケーション側で設計しなければなりません。
モデルカード上の入力はテキストですが、NVIDIA NIMでは画像や音声も受け付ける構成が示されています。これはBolt単体があらゆる形式を直接理解するという意味ではなく、周辺モデルや実行基盤と組み合わせた提供形態として捉えるのが安全です。導入時には、モデル本体の能力とシステム全体の入出力機能を分けて確認する必要があります。
教師あり微調整を使わなかった学習方針
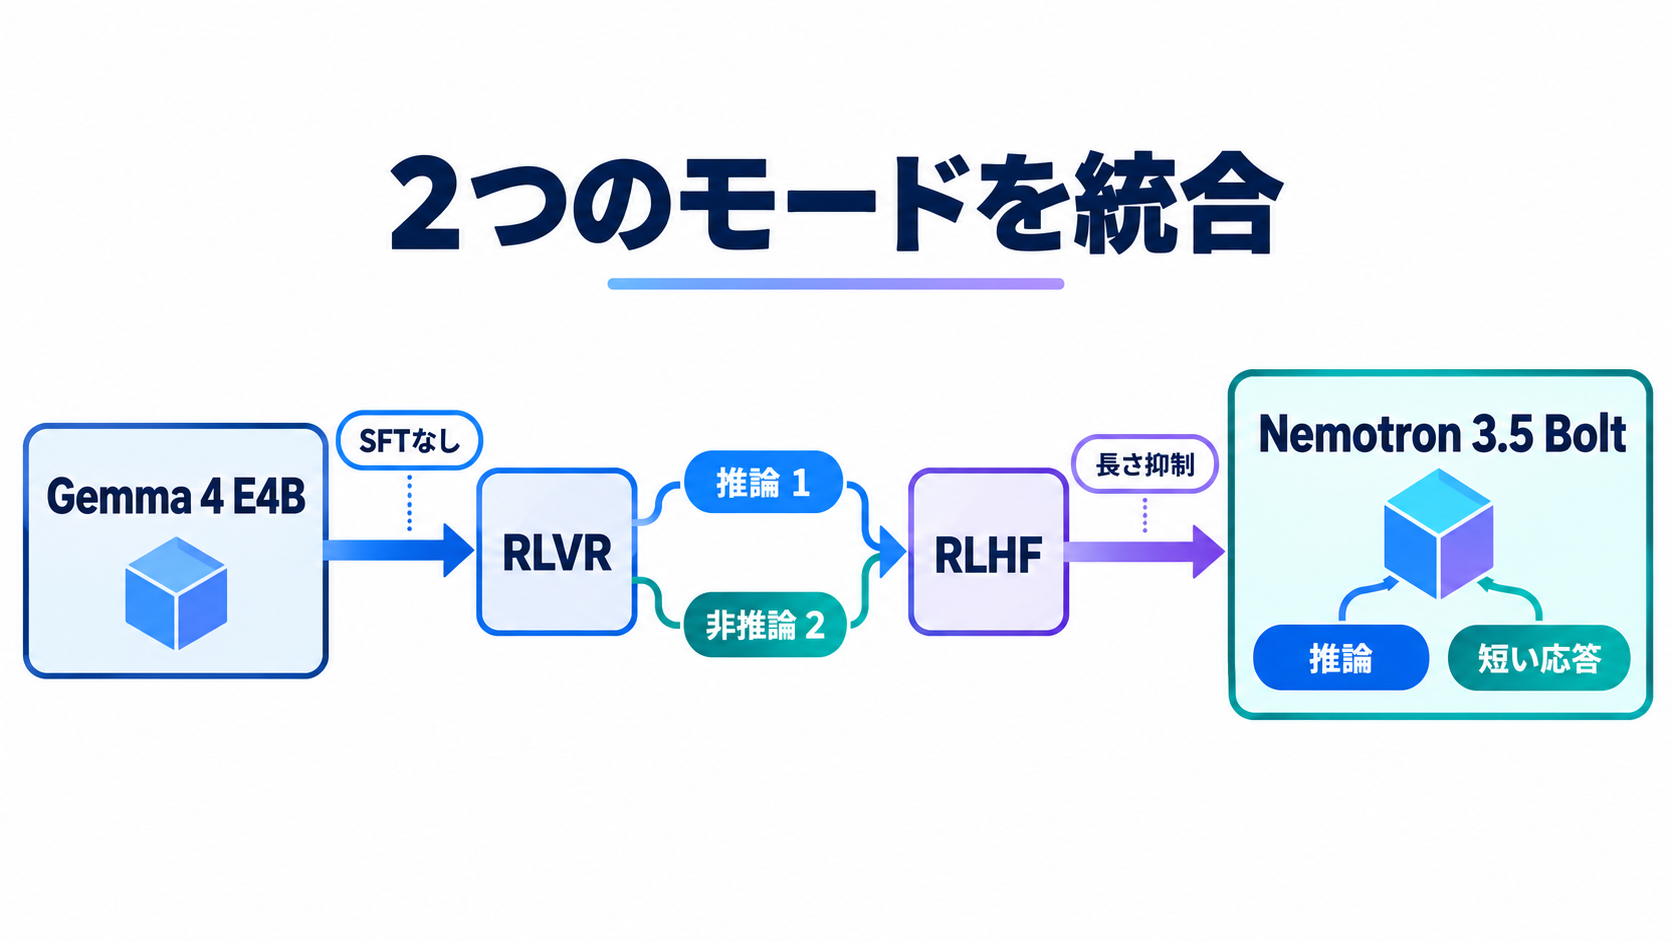
Boltの追加学習で特徴的なのは、教師あり微調整、いわゆるSFTを使わず、強化学習だけで仕上げた点です。NVIDIAの研究チームによると、SFTはツール呼び出しの性能を高めたものの、Gemmaが持っていた会話品質や回答の簡潔さを損なう傾向がありました。そこで、検証可能な報酬を使うRLVRと、人間の選好を反映するRLHFを、NeMo-RLおよびNeMo-Gym上で実施しています。すべての学習サンプルは、推論過程を使うモードと使わないモードの両方で処理されました。各バッチでは、非推論モードと推論モードを2対1の割合にしています。常に深く考えさせるのではなく、短い応答と複雑な問題への対応を一つのモデルに共存させる狙いが読み取れます。GenRM環境では長さに対するペナルティも加え、強化学習を重ねるにつれて回答が不必要に長くなる現象を抑えました。
この方針は、音声対話の使い勝手と関係します。画面上の文章なら多少長くても読み返せますが、音声で数十秒にわたる説明が返ると、ユーザーは割り込みにくくなります。推論能力を高めながら出力トークンを抑えることは、処理コストだけでなく、会話の自然さにも影響するでしょう。NVIDIAは、推論を有効にした比較で、出力トークン数を最大80%削減できたと報告しています。ただし、「最大」という数値は条件によって差が出るため、自社の対話シナリオで再測定するのが妥当です。
学習データと学習手順は公開されています。完成済みモデルを利用するだけでなく、どのような報酬設計やデータ配分で挙動が調整されたのかを確認できる点は、企業の技術評価に役立ちます。再学習を行う場合も、ツール呼び出しの正確さだけを追うと会話が冗長になる可能性があるため、回答時間、長さ、口調を含む複数の評価軸が必要です。
21ベンチマークが示す強みと弱点
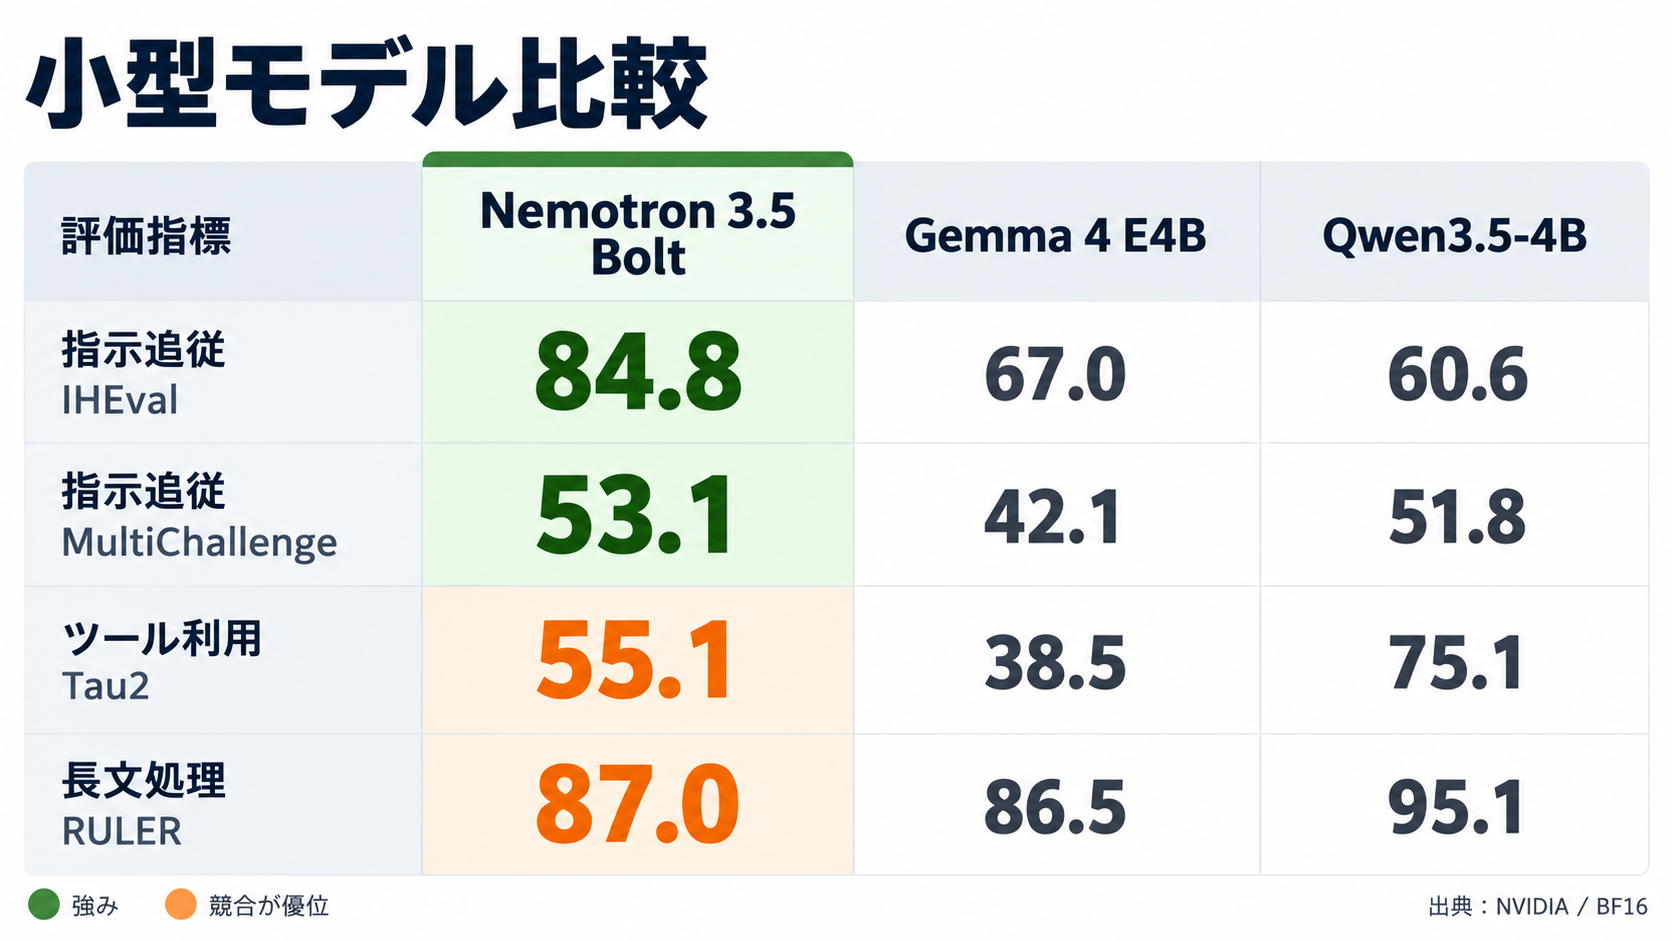
NVIDIAは、推論、会話、ツール利用、長文処理など5つの能力領域にまたがる21種類のベンチマークでBoltを評価しました。BF16精度を使った同社のNeMo-Gym環境では、推論モードのBoltが21項目中15項目で首位を獲得しています。特に指示階層への対応を見るIHEvalは84.8で、Gemma 4 E4Bの67.0、Qwen3.5-4Bの60.6を上回りました。複数ターンの指示を適切に扱うMultiChallengeでも、Boltは53.1を記録しています。すべての領域で優位だったわけではありません。実用的なツール利用を測るTau2-Benchでは55.1にとどまり、Qwen3.5-4Bの75.1を約20ポイント下回りました。長文処理に関係するRULER 64Kも、Boltの87.0に対してQwen3.5-4Bは95.1です。LongBench v2では50.5対59.9、BFCL-v3では68.5対70.9となり、いずれもQwen側が上回っています。感情的な知性や会話品質を測るEQ-Bench v3では、Gemma 4 E4Bが41.1、Boltが39.4でした。
この結果から、Boltは「小さいため何でも劣る」モデルではありませんが、あらゆるエージェント用途に無条件で適するとも判断できません。階層化された指示への追従が中心ならIHEvalの強さは参考になります。外部サービスを何段階も操作する業務では、Tau2-Benchの弱さを踏まえ、ツール選択や引数生成を個別に検証すべきでしょう。長い会議記録や大量の運用ログをそのまま投入する場合には、コンテキスト長だけでなく、長文中の必要情報を取り出せるかも確認が必要です。
比較値はNVIDIA自身がBF16モデルを測定したもので、量子化版の実運用性能を直接示すものではありません。同社はNemotron 3 Nano 4Bより平均スコアが約40%高いとも報告していますが、評価環境やプロンプトが変われば順位も動きます。Scale LabsがMultiChallengeで小規模モデル首位の56.03%と評価した情報も示されていますが、これはXへの投稿に基づく報告です。企業が採用を決める際には、公表スコアを候補選定に使い、最終判断は自社データによる再現試験に委ねるのが現実的です。
4GB表記と実機性能の読み方
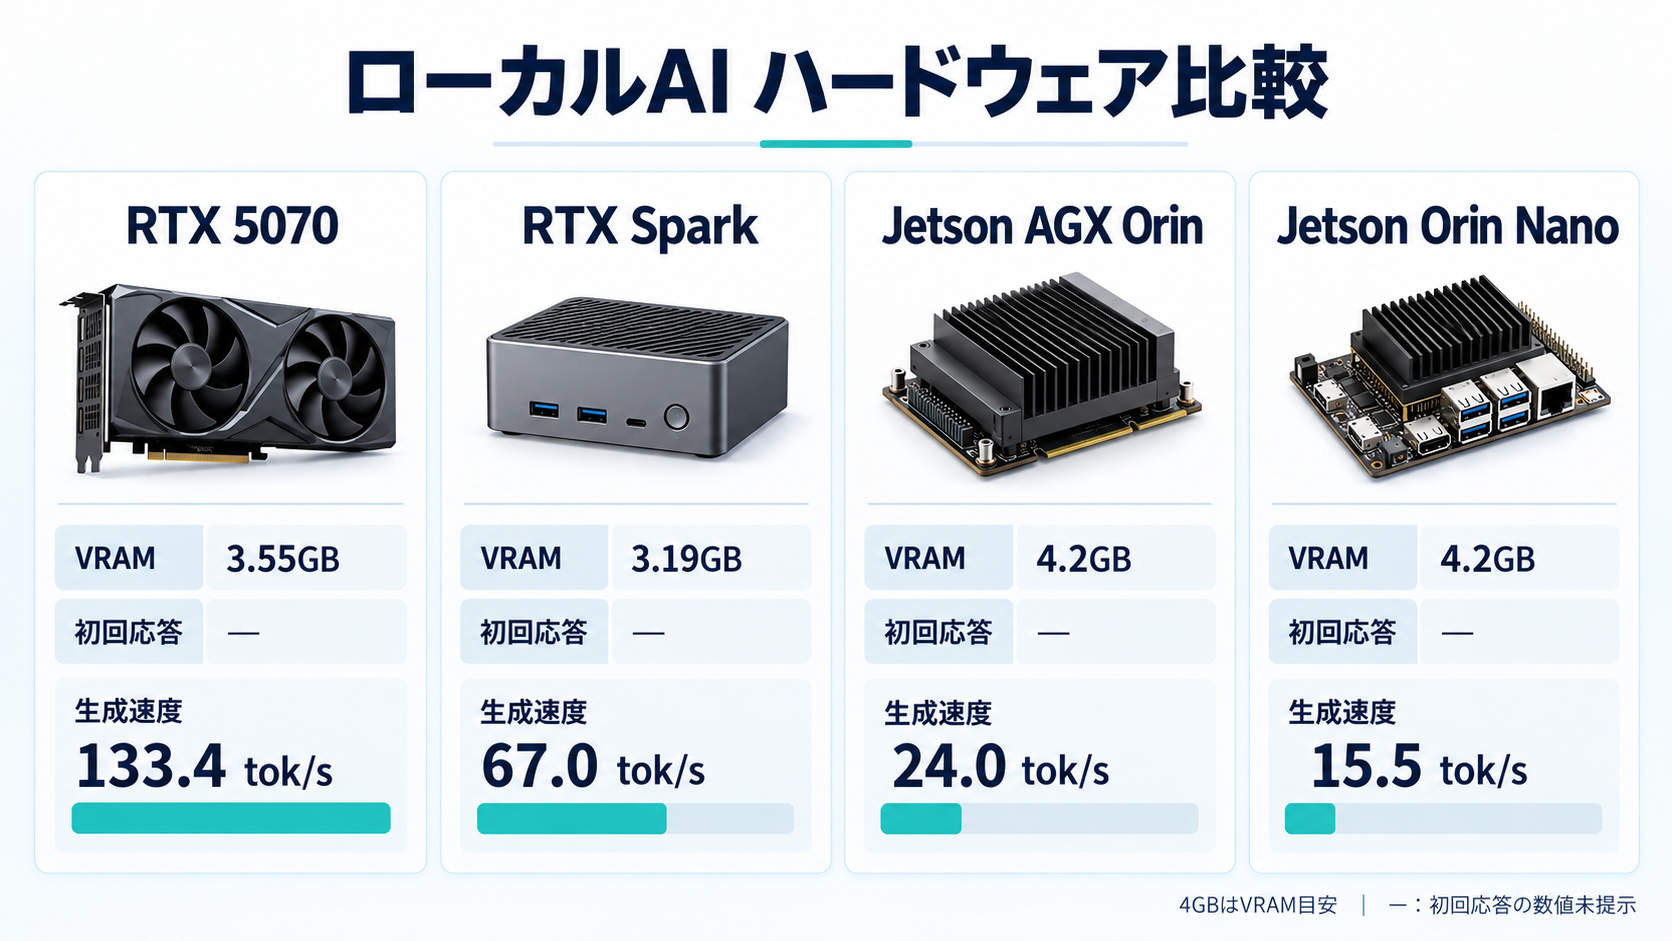
配布されているQ4_K_M形式のGGUFファイルは6.18GBありますが、NVIDIAが示す「4GB」はファイルサイズではありません。量子化モデルを推論時に展開した際のVRAM使用量を指す目安です。llama.cppを使い、バッチサイズ1、入力3,000トークン、出力50トークンという条件で測定したところ、RTX 5070では3.55GB、RTX Sparkでは3.19GB、Jetson AGX OrinとJetson Orin Nanoではいずれも約4.2GBを使用しました。応答開始までの時間と生成速度には、機器ごとに明確な差があります。RTX 5070では最初のトークンが出るまで548ミリ秒で、生成速度は毎秒133.4トークンでした。RTX Sparkは930ミリ秒、毎秒67.0トークンです。Jetson AGX Orinは3,687ミリ秒、毎秒24.0トークン、Jetson Orin Nanoは5,785ミリ秒、毎秒15.5トークンとなっています。組み込み機器でも動作する一方、会話の開始まで数秒かかる構成では、音声UI側で待ち時間をどう伝えるかが課題になります。
NVIDIAは、推測デコーディングを利用するDFlash drafterも提供しています。RTX 5070でBoltとDFlashを組み合わせた測定では毎秒272.6トークンに達し、Gemma 4 E4BとMTP drafterの毎秒225.9トークンに対して1.21倍でした。これは特定の機器と構成による結果であり、アプリケーション全体の応答時間とは区別して読む必要があります。音声認識、プロンプト構築、ツール実行、音声合成の時間は、この生成速度に含まれていません。
実際のVRAM使用量も、コンテキスト長、キャッシュ、同時実行数、周辺モデルによって増減します。4GBの空きがあるGPUなら必ず安定稼働する、という保証ではありません。検証機では最大会話長と同時接続数を再現し、メモリのピーク値を測る必要があります。端末選定では、平均速度よりも、最も遅い場面でユーザーが何秒待つのかを見るべきでしょう。
音声・視覚モデルと組み合わせるシステム構成
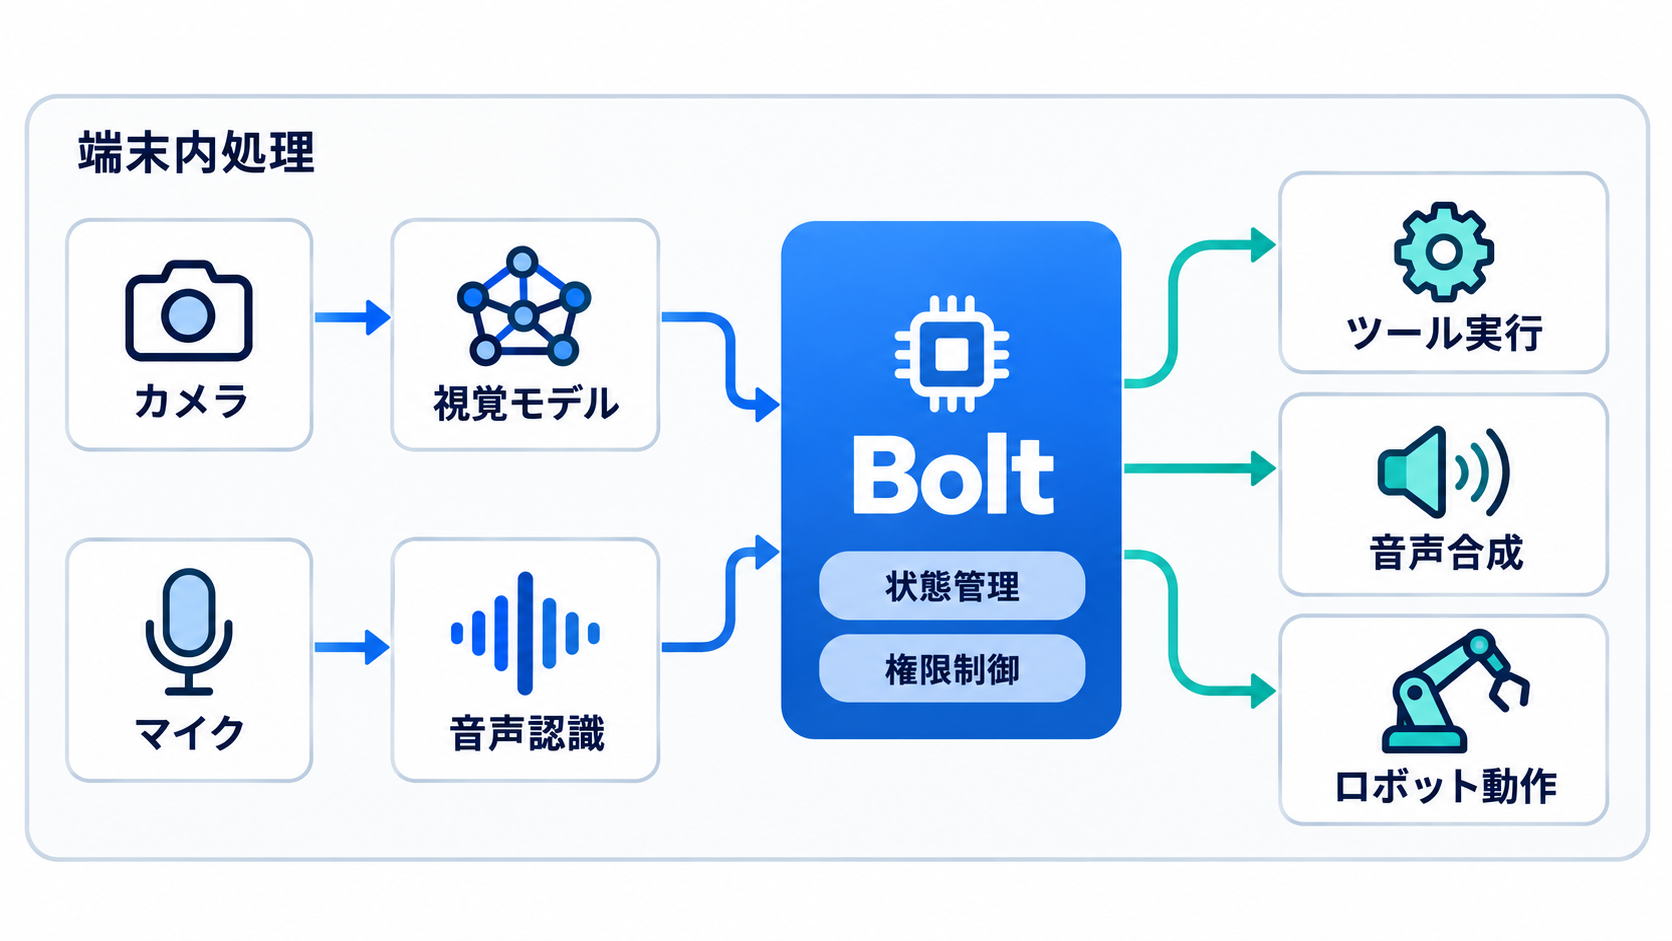
NVIDIAが示したデモでは、小型ロボットのReachy MiniがJetson Orin Nano 8GB上で動作しています。視覚処理はCosmos 3 Edgeが担当し、Boltは音声応答とツール呼び出しを受け持ちます。一つの巨大なモデルですべてを処理するのではなく、画像、会話、外部操作を別々のコンポーネントに分ける構成です。Boltの小さなメモリ占有量は、このような役割分担で効果を発揮します。音声アシスタントでは、マイク入力を文字へ変換し、Boltが意図を判断して回答またはツール呼び出しを生成し、その結果を音声へ戻す流れが考えられます。ゲームのNPCなら、プレイヤーの発言、キャラクター設定、直前の出来事、ゲーム内で許可された操作をコンテキストへ渡す構成になるでしょう。産業用端末では、センサーや設備管理システムから得た状態を参照し、作業者への案内を返す形が想定されます。いずれも、モデルに直接あらゆる権限を与えるのではなく、実行可能な操作をアプリケーション側で制限する設計が欠かせません。
非同期ツール呼び出しへの対応は、結果が即座に返らない処理で役立ちます。ロボットの移動、データベース検索、ゲーム内イベントの実行には待ち時間が生じることがあります。その間に「確認しています」と短く返すのか、別の会話を続けるのかは、モデルだけでなく状態管理層が判断しなければなりません。64Kのコンテキストも、履歴を無制限に保存する仕組みではないため、重要な状態を構造化して保持する設計が必要です。
BoltはHugging Face、Ollama、LM Studio、Unsloth、Jetson AI Labで提供され、NVIDIA NIMやIn-Game Inferencing SDKからも利用できます。選択肢が多い分、試作と本番で実行環境を変える場合には、量子化方式、プロンプト形式、ツール呼び出しの互換性を確かめるべきです。NVIDIA ACE向けでは第3世代の小規模モデルとして扱われており、ゲームキャラクターへの組み込みも主要な利用場面に含まれています。
企業導入で確認すべき評価項目
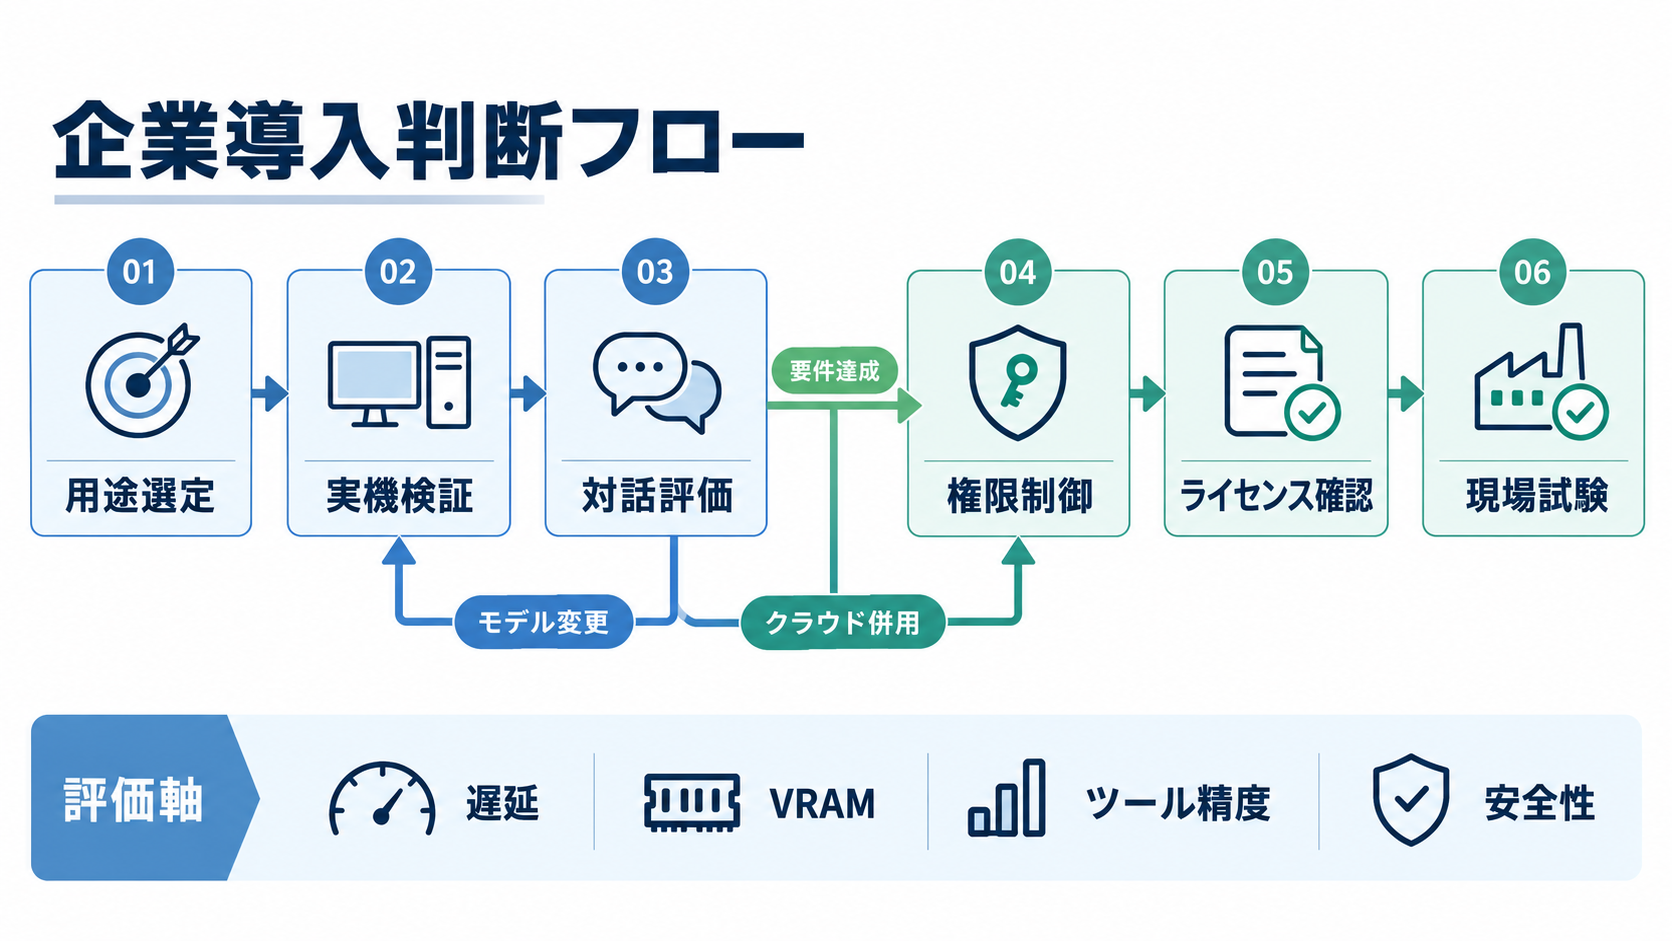
企業がBoltを検討する際は、「4GBで動く」という一点だけで採用を決めないほうがよいでしょう。価値が出やすいのは、クラウド接続に依存せず、限られたGPU上で短い対話とツール操作を行いたい場面です。反対に、長大な文書の分析、高度なツール連携、複雑な推論を一度に求める業務では、より大きなモデルや別の小規模モデルが適する可能性があります。公開ベンチマーク上でも、指示追従の強さとツール利用の弱さが同時に表れています。検証では、実際の利用場面から20~50件程度の代表的な対話を抽出し、回答の正しさだけでなく、最初の応答までの時間、会話全体の所要時間、出力の長さ、ツール選択、失敗時の挙動を確認すると判断しやすくなります。音声用途なら、聞き返しや割り込みを含む会話も必要です。ロボットや設備を操作する場合は、曖昧な指示を受けたときに実行を止められるか、許可されていない引数を拒否できるかを重点的に試すべきでしょう。
ライセンスはOpenMDW-1.1で、重み、データ、学習手順が公開されています。競合するGemma 4 E4BやQwen3.5-4BはApache 2.0とされており、同じ「オープンウェイト」でも利用条件は同一ではありません。法務部門は、再配布、改変、組み込み製品での利用条件を実際の用途に照らして確認する必要があります。公開されていることと、無条件で利用できることは分けて考えるべきです。
導入の出発点としては、候補となる実機にQ4_K_M版を載せ、音声や視覚を含む最小構成を一台で動かす方法が現実的です。そこでVRAMの余裕と待ち時間を測り、Tau2-Benchが示したツール利用上の弱点が自社シナリオで現れるかを確認します。要求を満たせれば小規模な現場試験へ進み、満たせなければモデルの変更やクラウド併用を検討できます。公開スコアの順位ではなく、端末上での体験と操作の安全性を採否の基準に据えることが、Boltを正しく評価する一歩になります。