
2026/10/30
AIニュース
話すガレージが示した、ローカル生成AIを「待たせない体験」に変える設計
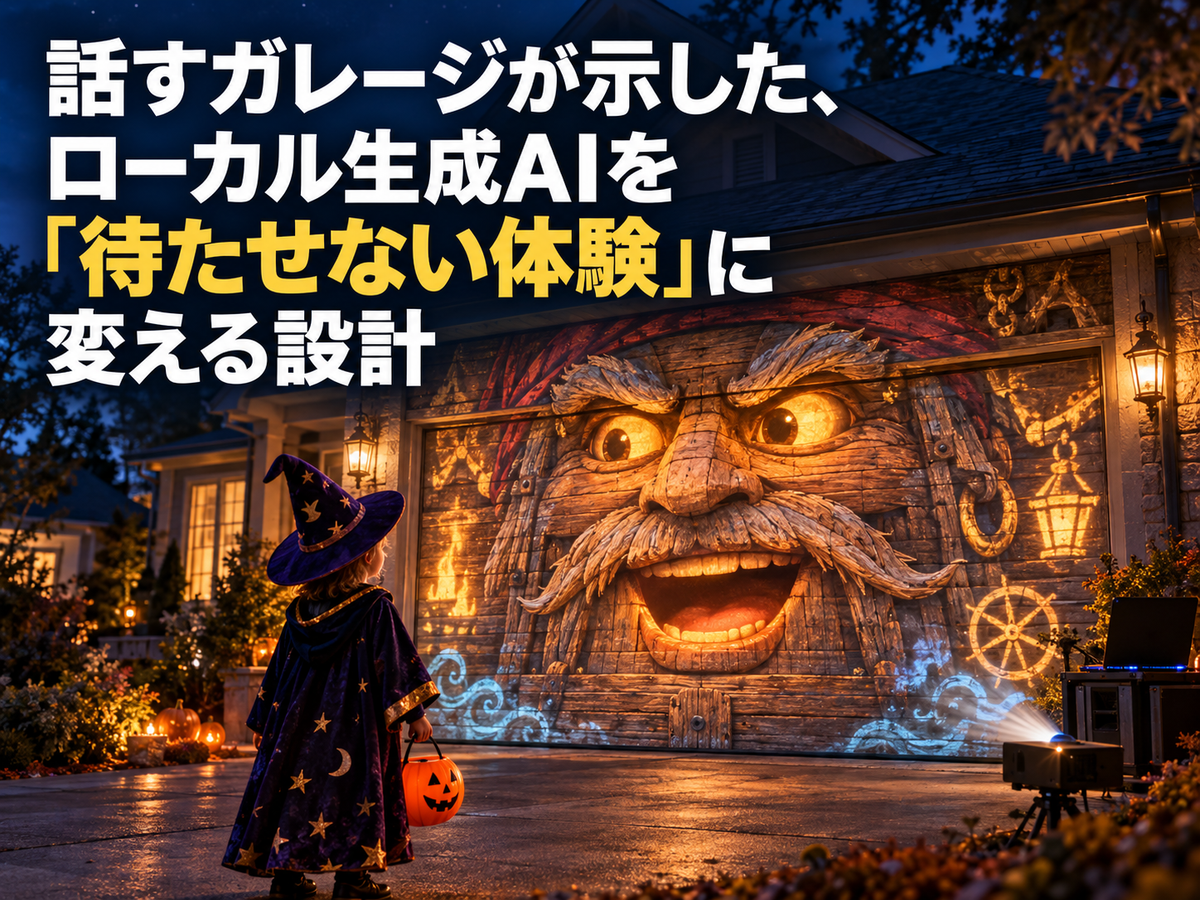
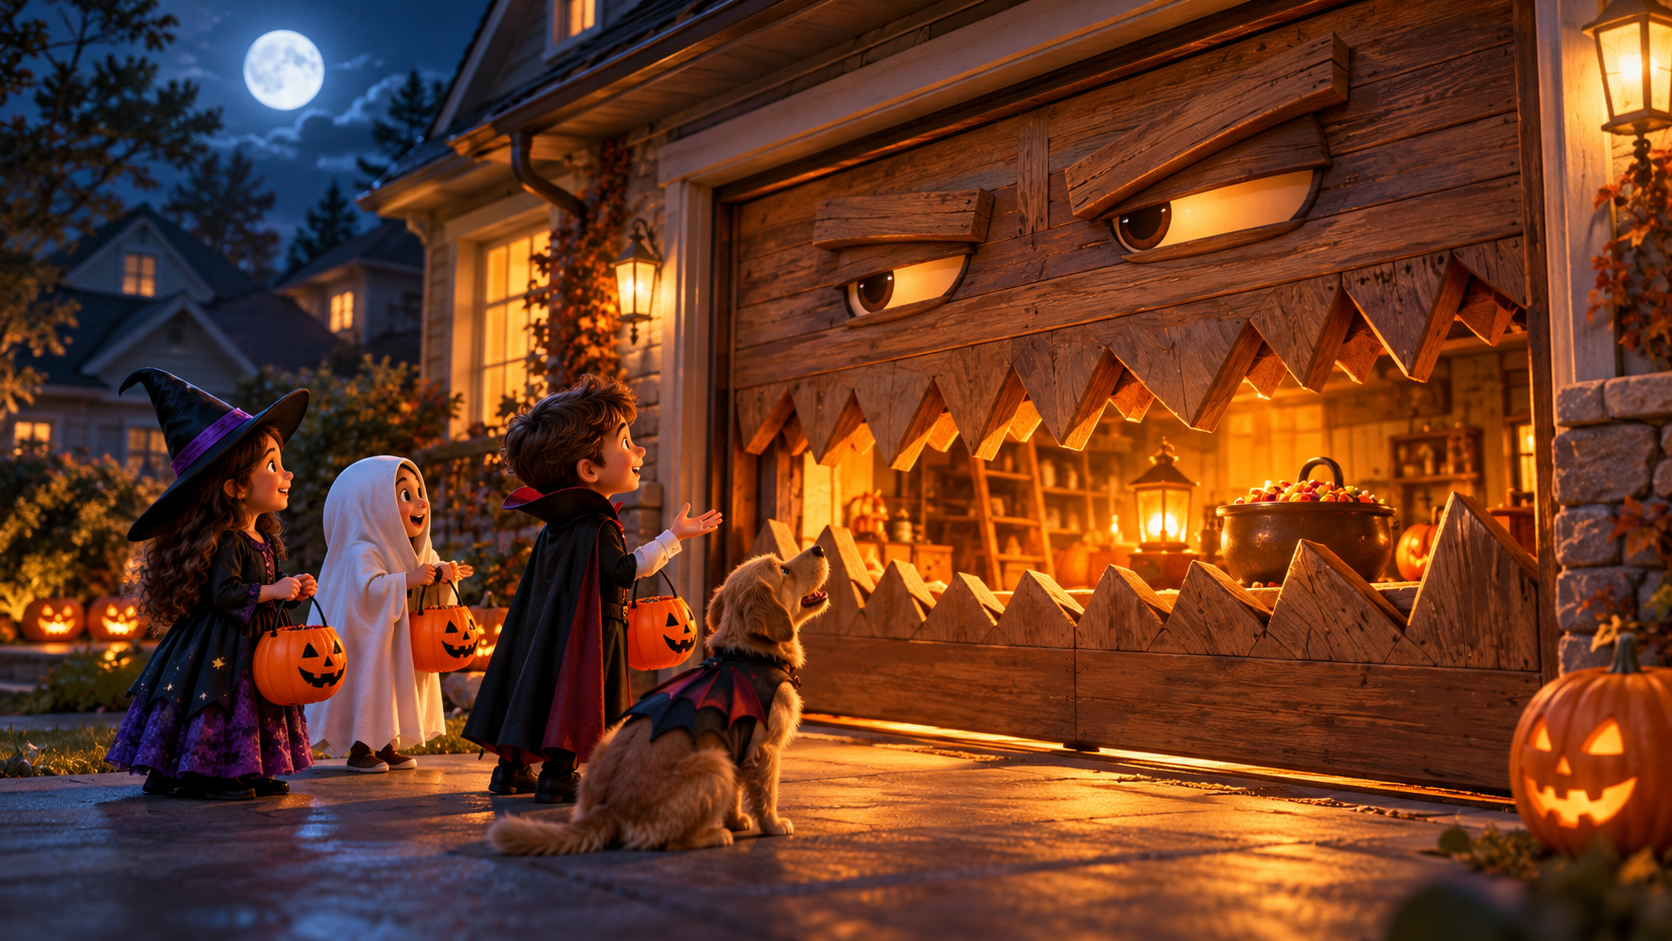
不機嫌な家が来訪者を迎えるハロウィーン
ハロウィーンの夜、子どもがガレージの前で話しかけると、木の板でできた大きな口が動き、気難しい老海賊のような声が返ってきます。礼儀正しく「お願いします」と伝えれば態度が軟化し、「ありがとう」には温かな別れの言葉で応じます。NVIDIAの開発者が制作したMonsterHouseは、住宅のガレージドアを対話型キャラクターへ変えるインタラクティブ投影システムです。
狙いは、恐怖で驚かせることより、家そのものと交渉する体験をつくることにあります。設定上、この家は沈没した海賊船の木材から建てられ、嵐の記憶を引きずっています。そのため、航海にまつわる愚痴や不機嫌な受け答えにも理由が生まれます。単に音声アシスタントへ怖い声を付けただけではなく、背景設定、会話の進行、表情、炎の演出を一つの人格としてまとめている点が特徴です。
会話の基盤にはNVIDIA Nemotron Voice Agentが使われています。音声認識、言語モデル、音声合成、口のアニメーション、カメラ映像の理解を組み合わせ、1台のワークステーション上で動作させています。来訪者の発話を受け取ってから、返答を考え、感情を付けて読み上げ、木製の口を同期させるまでが一つの処理です。
企業向けの観点では、採用された個々のモデル以上に、体験全体をどのように組み立てたかが参考になります。現場で利用者が接するのはモデルの精度指標ではなく、反応の速さ、会話の自然さ、演出の一貫性だからです。MonsterHouseは娯楽作品ですが、受付端末、展示案内、ブランドキャラクター、研修用アバターなどにも共通する設計課題を、分かりやすい形で映し出しています。
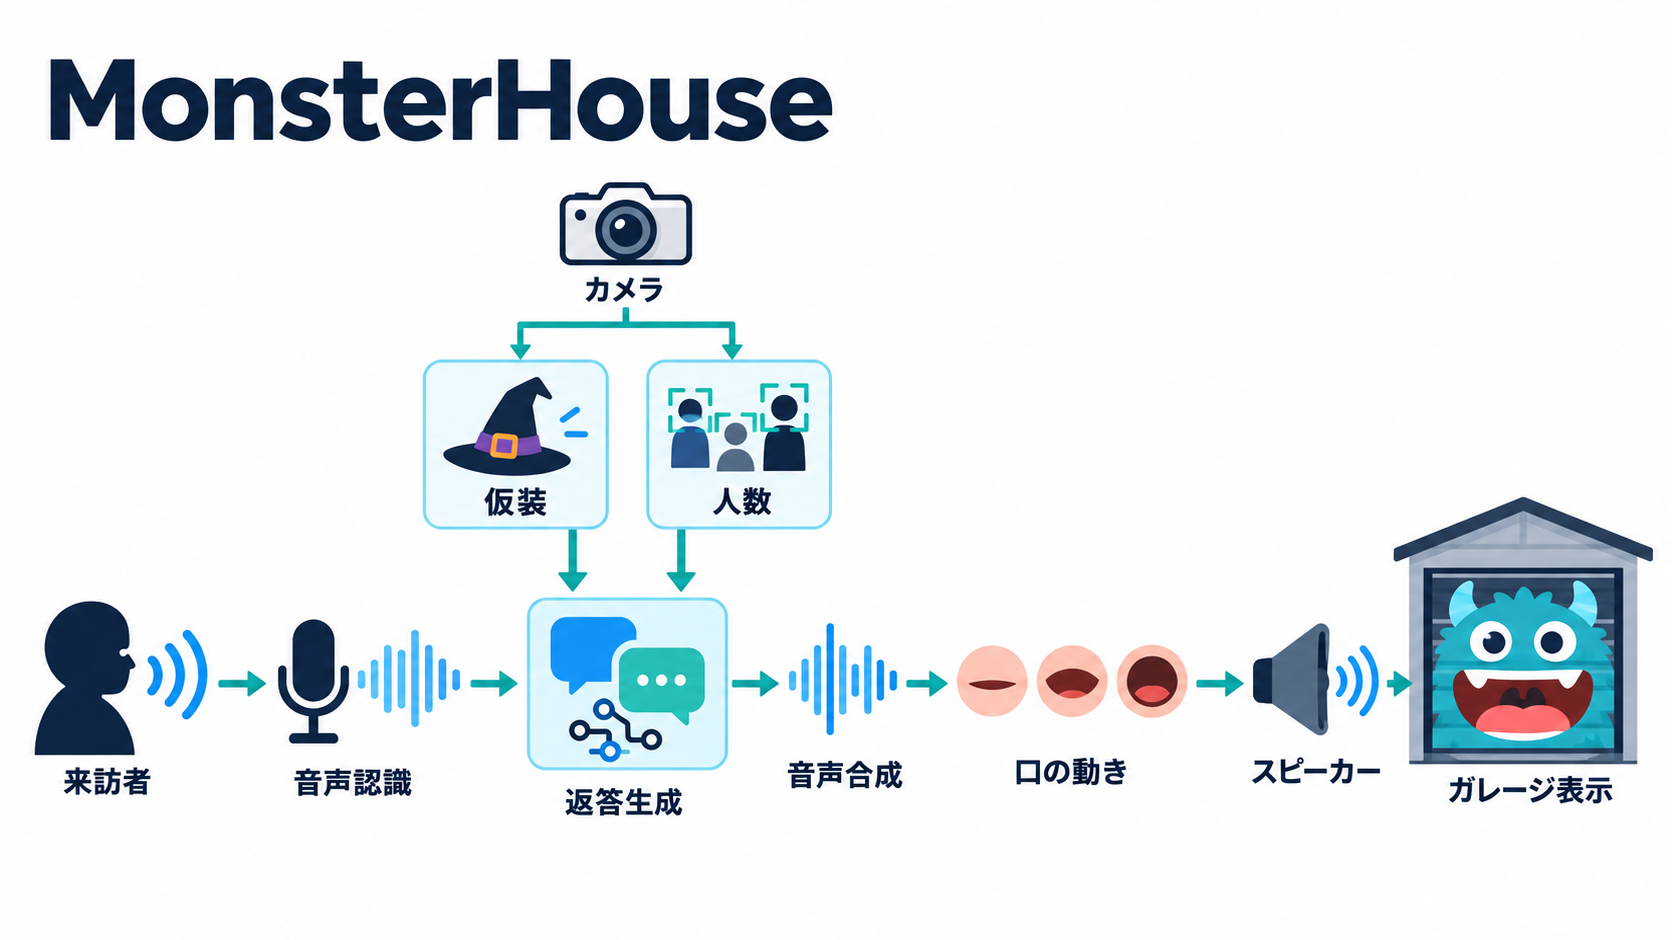
音声認識から口の動きまでをつなぐ構成
MonsterHouseの処理は、役割の異なる複数のモデルを直列につなぐカスケード型です。来訪者の声はNemotron Speech ASRによってテキストへ変換され、その内容を小規模言語モデルのNemotron 3.5 Bolt E4Bが受け取ります。生成された返答はMagpie TTS Zeroshotによって音声化され、Audio2Face-3Dが音声から口の動きを生成します。Unreal Engine 5は、木製の口、炎、発光などの視覚表現を担当します。
視覚情報にはNemotron 3 Nano Omniが使われています。これは画像と言語を扱えるVLMで、カメラに映った仮装を説明し、キャラクターが来訪者に合わせた話題を選ぶための文脈を提供します。人数の検出と追跡は、物体検出モデルのYOLOと追跡手法のByteTrackへ分離されています。VLMに毎フレームの人数確認まで任せず、軽量な専用処理と組み合わせることで、役割を整理しています。
処理の流れをまとめると、音声認識が「何を言ったか」、言語モデルが「どう返すか」、音声合成が「どのように話すか」、アニメーションが「どう見せるか」を担当します。映像理解は「目の前に誰がいるか」という追加情報を渡します。一つの巨大なモデルにすべてを任せる構成ではないため、個別の機能を交換しやすく、問題が起きた箇所も切り分けやすくなります。
実行環境には2基のGPUが搭載されています。言語モデルと音声処理はNVIDIA RTX PRO 6000 Blackwell Max-Q、Unreal Engineの描画とAudio2Face-3DはRTX PRO 4000 Blackwellが受け持ちます。分割の理由はメモリー不足ではなく、AI処理の負荷が上がってもアニメーションのフレームレートを安定させるためです。モデルを動かせるかどうかだけでなく、利用者から見える動きを止めないという判断が優先されています。
B2Bシステムでも同じ考え方が使えます。音声認識、回答生成、合成音声、画面描画を別々の処理として計測できれば、遅延や品質低下の原因を特定しやすくなります。モデル選定から始めるより、利用者へ届くまでの処理経路を描き、それぞれに許容時間と代替手段を設定するほうが、運用可能な設計に近づくでしょう。
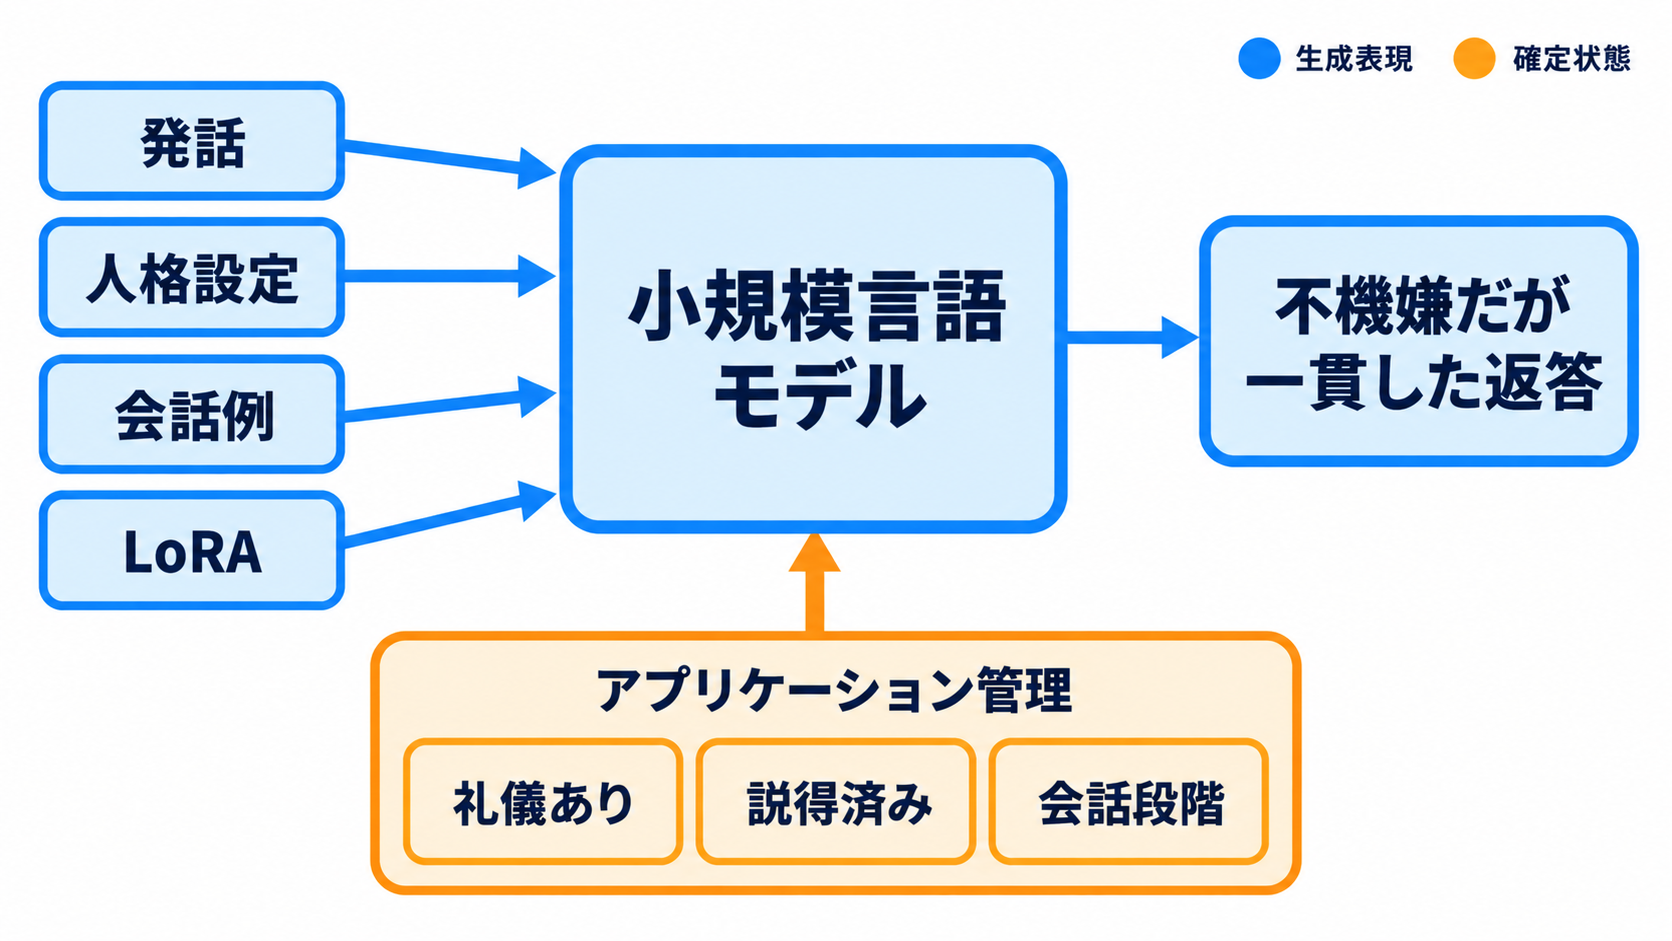
「不機嫌だが最後は折れる」を守る会話設計
キャラクターへ「不機嫌に振る舞ってください」と指示するだけでは、長い会話の一貫性を保てません。MonsterHouseには、最初は来訪者を追い返そうとし、粘り強く頼まれると態度を変え、礼儀正しい言葉には早めに折れるという会話の筋道があります。一度説得された相手には、その後も協力的でなければなりません。毎回同じ交渉をやり直す家では、人格よりシステム上の不具合が目立ってしまいます。
返答を生成するBolt E4Bは、ローカルの会話エージェントやインタラクティブキャラクター向けのオープンな小規模言語モデルです。標準では4ビット量子化された約4GBのモデルが使われ、比較用としてBF16版も用意されています。制作者は十数種類のモデルを試し、限られた計算資源の中で会話品質と応答速度のバランスを確認しています。なお、制作者はNVIDIAの従業員であり、Bolt E4Bを公開前から試せる立場だったことも明示しています。
人格の調整には、システムプロンプトやアプリケーション側のロジックに加え、LoRAアダプターが用いられています。LoRAは、モデル全体を再学習する代わりに、比較的小さな追加パラメーターを学習させる手法です。5,000件を超える複数ターンの会話データを用意し、候補モデルごとにアダプターを学習させています。返答の連続性、速度、口調、同じ表現の反復などを評価し、不機嫌さが魅力として残る範囲を探っています。
重要なのは、来訪者がすでに礼儀正しい言葉を使ったか、家が説得されたかといった状態を、言語モデルの記憶だけに任せていないことです。確実に維持したい情報はアプリケーション側で管理し、その状態を返答生成へ渡します。モデルは自然な文章をつくる役割に集中でき、会話上のルールはコードで検証できます。
顧客対応へ応用する場合も、契約確認済み、本人確認済み、担当者への転送が必要といった業務状態は、会話履歴からモデルに推測させるべきではありません。人格や表現の柔軟性は生成AIに任せ、業務上の確定事項と遷移条件はアプリケーションで保持する必要があります。MonsterHouseの魅力を支えているのは派手な口調だけではなく、自由に生成する領域と、決められた流れを守る領域の分離です。
1.70秒の応答を支える先読みとキャッシュ
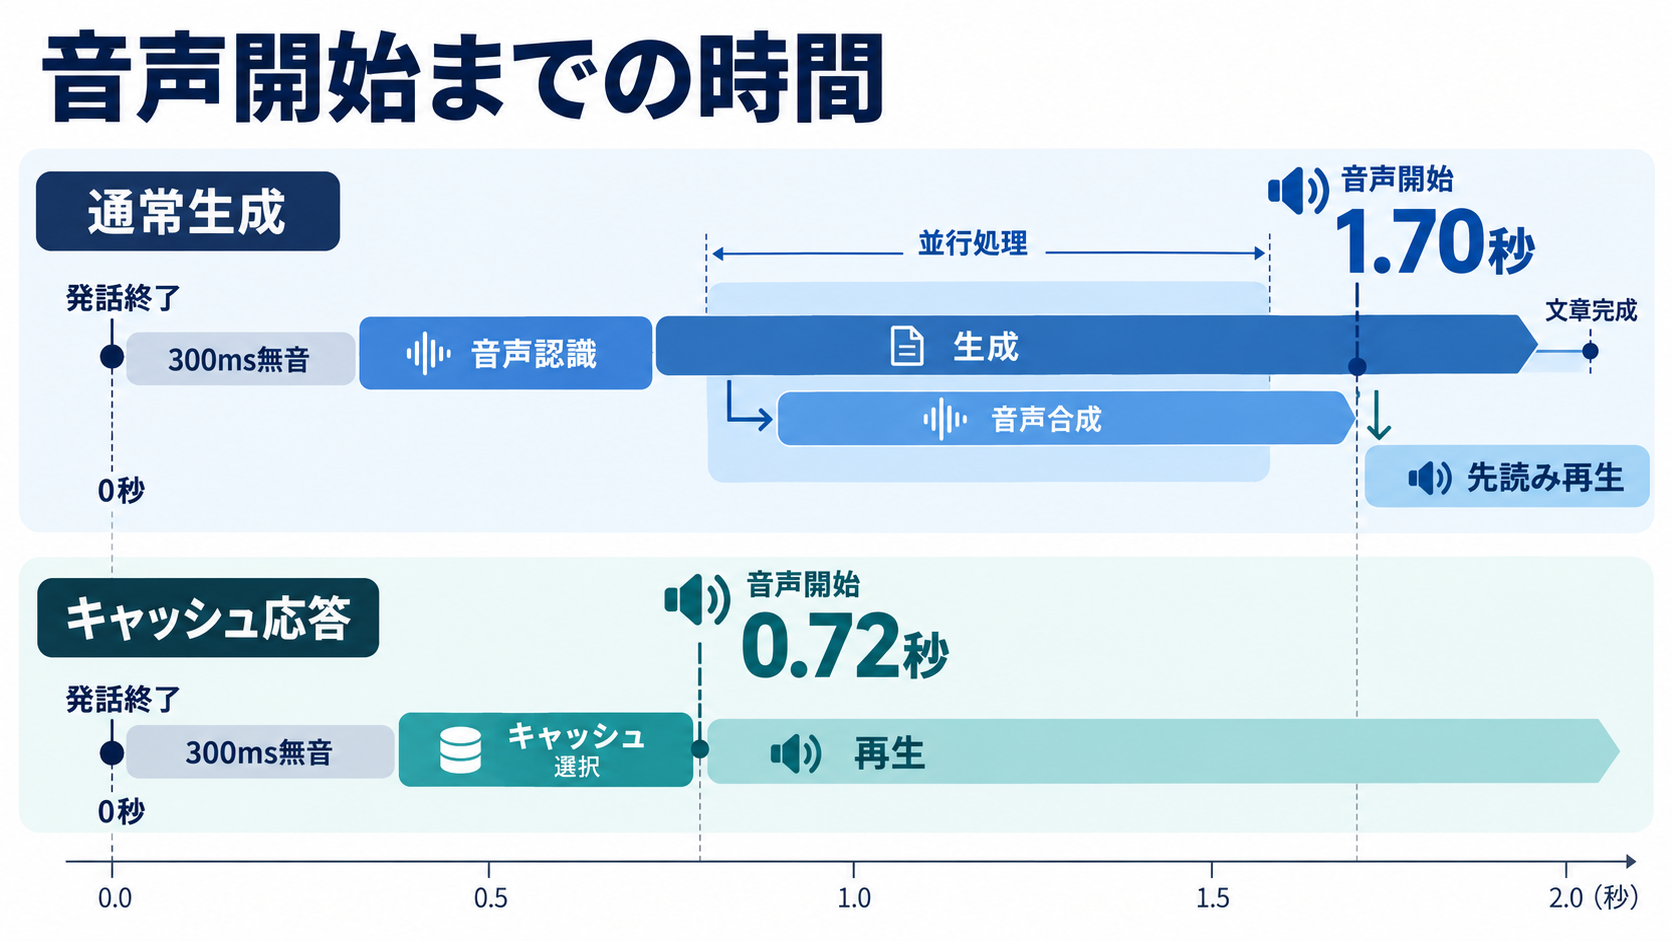
会話型キャラクターは、返答内容が優れていても、話し始めるまでの沈黙が長ければ存在感を失います。MonsterHouseでは、来訪者が話し終えてから通常の生成音声が出るまでの中央値が1.70秒でした。あらかじめ録音した応答を使う場合は0.72秒です。この測定には、発話終了を判定するために待つ300ミリ秒の無音時間も含まれています。
待ち時間を抑えるため、言語モデルが返答全体を書き終える前に、読み上げ可能な部分から音声合成へ渡しています。人間同士の会話でも、相手は頭の中で発言全体を完成させてから話し始めるわけではありません。文章の生成と読み上げを重ねることで、総処理時間を短くするだけでなく、利用者が感じる空白を減らしています。
すべての発言をリアルタイム生成するのではなく、頻出する挨拶や菓子に関する冗談には、準備済みのテキストと録音音声も使われます。準備済みテキストなら言語モデルの処理を省け、録音音声なら音声合成も省略できます。動的な会話を残しながら、予測可能な場面だけを短い経路へ切り替える設計です。生成AIを導入したからといって、全応答をその場で生成する必要はありません。
計算資源が限られる環境では、音声認識と会話ルーターだけをリアルタイムで動かし、返答には事前生成した大量の音声を使う構成も提案されています。Bolt E4BとMagpie TTSで数百種類の応答を事前に作り、イベント当日は条件に合うものを選ぶ方式です。表現の自由度は下がりますが、負荷と遅延を予測しやすく、通信に依存しない運用にも向いています。
企業が確認すべき指標も、モデル単体の生成速度だけではありません。発話終了検出、認識、回答生成、音声合成、再生開始までを分け、利用者が「返事が始まった」と感じる時点を測る必要があります。頻出質問のキャッシュ率や、生成経路から定型経路へ切り替えられる割合も、費用と体感速度を左右します。1.70秒という数字の背後には、モデルの高速化だけではない経路設計があります。
声、口、炎を一つの演技として合わせる方法
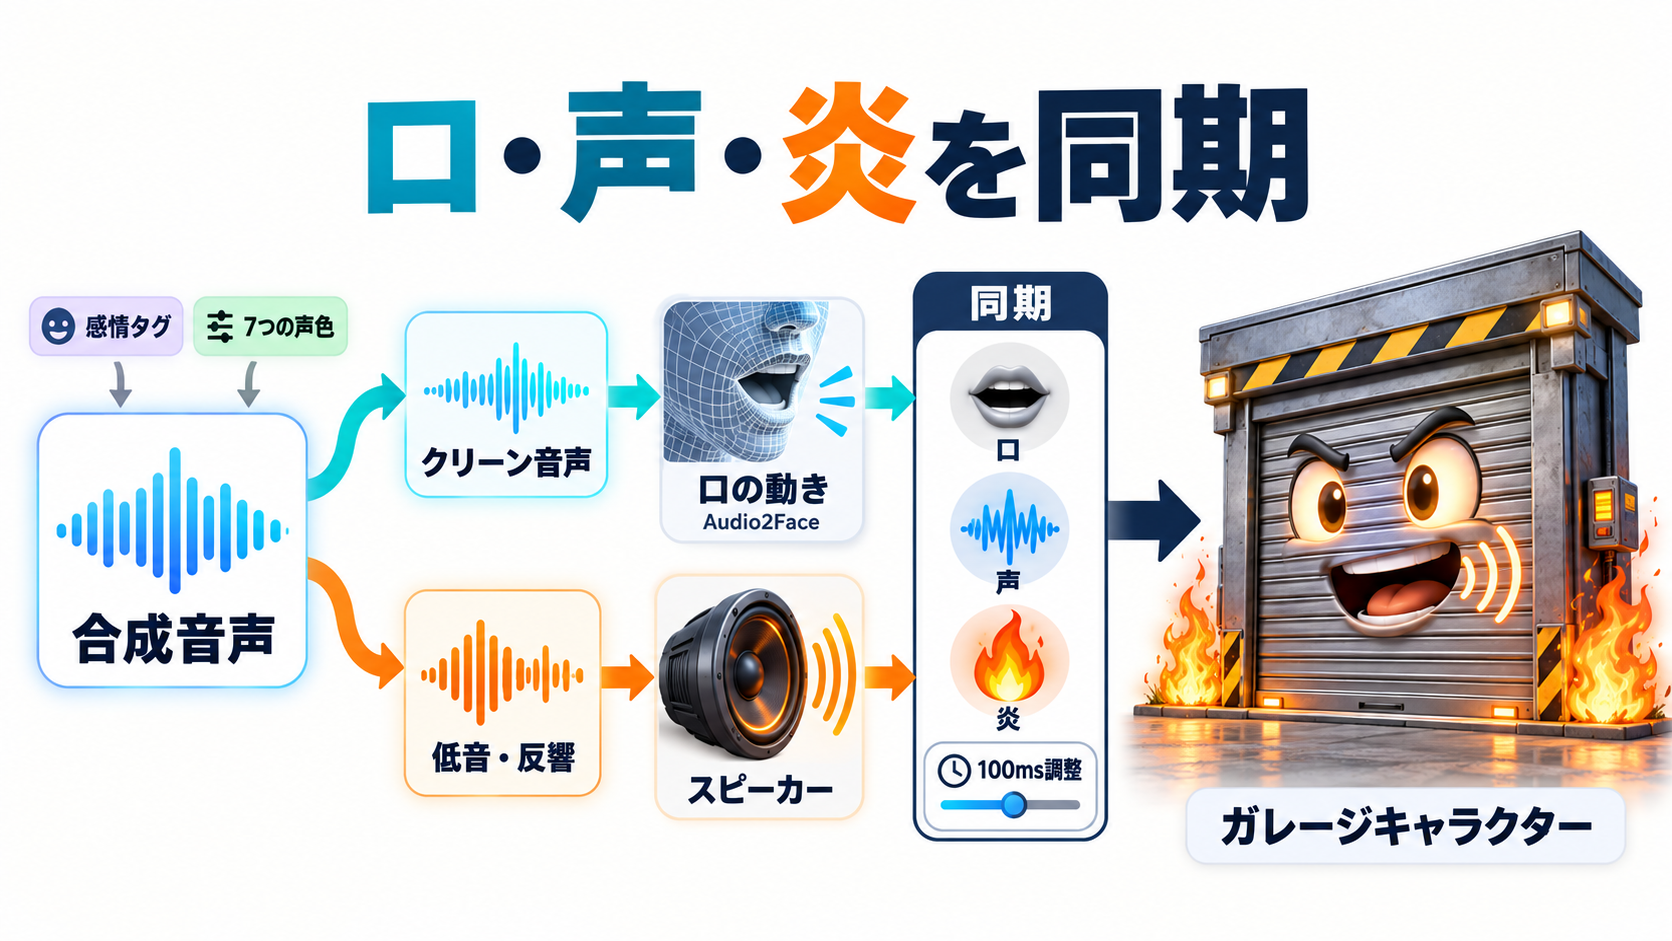
MonsterHouseの声は、Magpie TTS Zeroshotが短い参照音声を基に生成します。特定の声を長時間学習させるのではなく、3秒から10秒ほどのサンプルを与えて声の特徴を反映させる方式です。制作者は、怒り、喜び、面白がる様子など7種類の感情に対応するサンプルを録音し、言語モデルが返す感情タグに応じて読み分けています。声の利用にあたっては、本人の許可を得た音声だけを使うことも明記されています。
音声は二つの経路へ分かれます。Audio2Face-3Dには効果を加えていない明瞭な音声を渡し、観客が聞く側には低音、反響、空間的な響きなどをリアルタイムで加えます。Audio2Face-3Dの標準モデルは極端に低すぎない中立的な声で動かしやすいため、演出用の加工音声をそのまま入力するより、口の動きに使う信号を分離したほうが安定します。
口の造形はAutodesk Mayaで作られ、表情の形状を出力したうえでUnreal Engineへ取り込まれています。目も眉もまばたきもないキャラクターですが、木の板が裂けたような唇と、口の奥で燃える炎によって感情を表現します。造形の情報量を増やすのではなく、声と口の同期、光の変化、開閉のタイミングへ注力しています。
音声再生、口のアニメーション、炎の演出がずれると、利用者は内容より違和感へ注意を向けます。システムではAudio2Face-3Dのバッファリングを補うため、100ミリ秒の同期調整が使われています。数値としてはわずかな差ですが、発話主体が本当に建物の中にいるように感じられるかを左右します。
デジタルヒューマンや店舗キャラクターでも、音声の自然さだけを個別に評価しては不十分です。口の動き、表情、字幕、効果音、画面切り替えを含め、利用者が受け取る一つの演技として検証する必要があります。生成モデルの品質が同じでも、同期と演出の設計によって完成度は大きく変わると考えられます。
カメラ認識と操作卓が支える現場運用
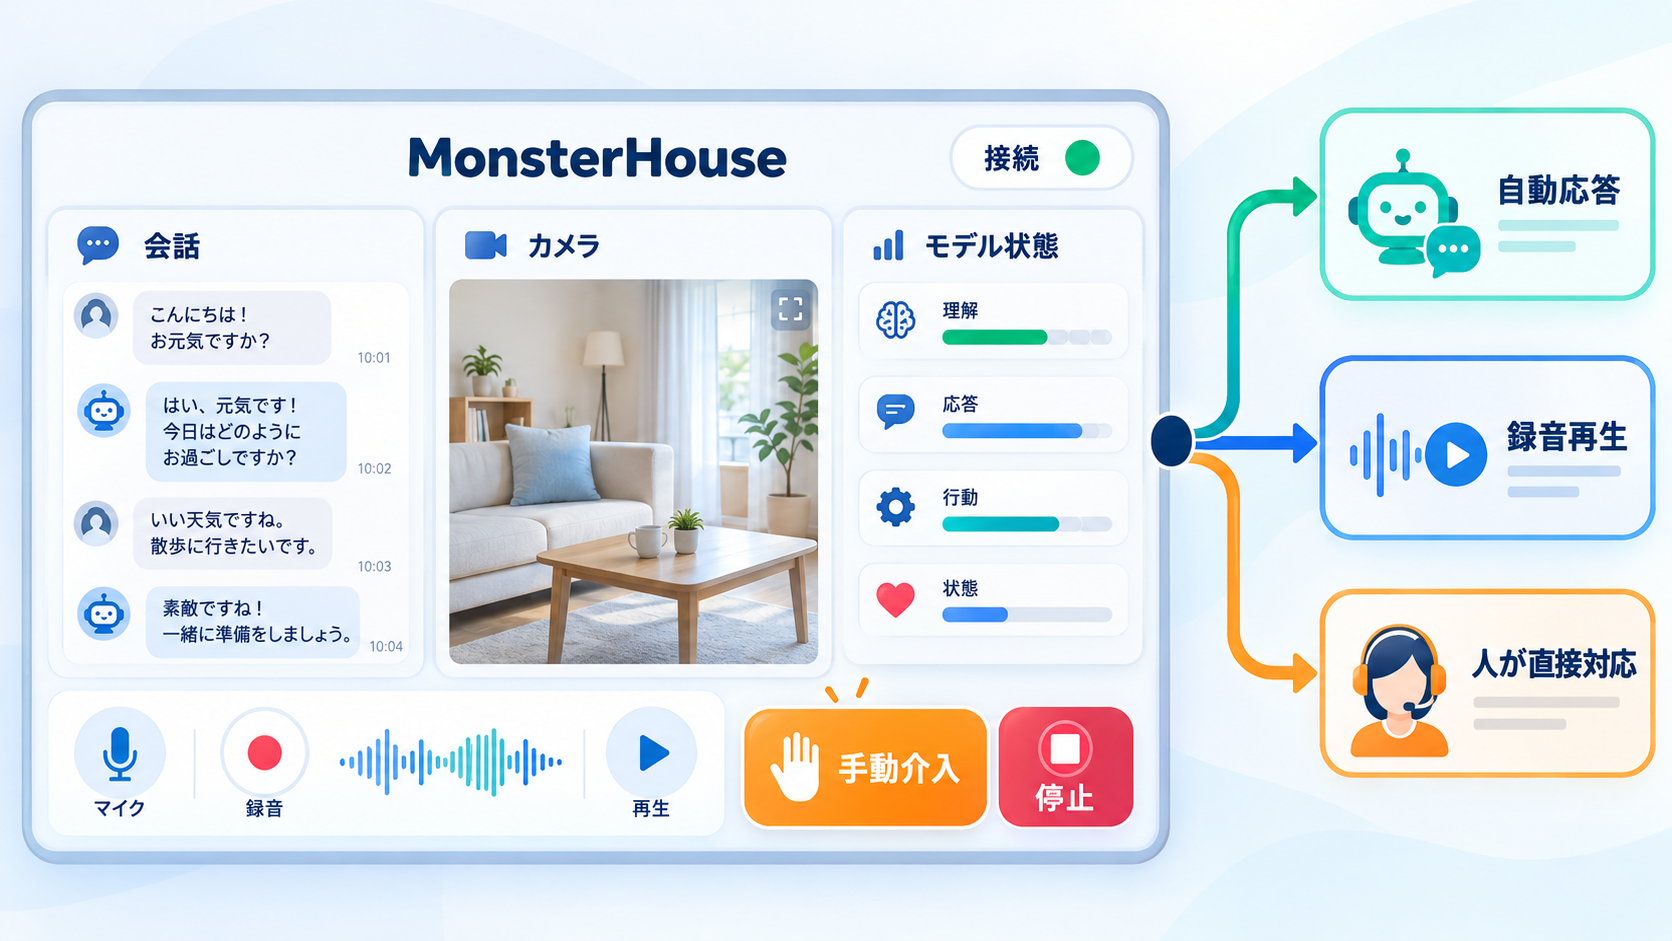
MonsterHouseには、会話を眺め、モデルを選び、録音を管理し、プロンプトや口の動きを調整する操作卓があります。カメラ映像、処理性能、Unreal Engineとの接続状況も確認できます。サウンドボードから録音済みの台詞を再生したり、任意の文章を入力して話させたりすることも可能です。自律的に動くAIキャラクターでありながら、必要な場面では人がすぐ介入できる構成です。
運用モードも一つではありません。ライブモードでは来訪者との会話を自動処理し、デモモードでは家自身に仕組みを説明させます。マイクモードは音声認識、言語モデル、音声合成を迂回し、制作者の生声で口を動かす代替経路です。観客には加工済みの声が届くため、キャラクターの雰囲気を保ったまま、人が直接対応できます。
カメラから得る情報についても、自動化の範囲を限定しています。Nemotron 3 Nano Omniは仮装の種類を説明し、YOLOとByteTrackは画面内の人物を数えて追跡します。テストでは、海賊、吸血鬼、魔女、カボチャ、幽霊に扮した5頭の羊の映像が使われ、それぞれの衣装を識別できました。ただし、これは合成テストの再生であり、夜間の私道に集まる実際の来訪者で性能を確認した結果ではありません。
企業の現場では、モデルが動いていることと、サービスが運用できることは別の条件です。接続断、認識失敗、不適切な返答、混雑時の遅延が起きた際に、担当者が状態を把握して安全な経路へ切り替えられなければなりません。操作卓は開発者向けの付属機能ではなく、自律処理を現場へ置くための管理面と捉えられます。
視覚認識を使う場合は、撮影範囲、保存の有無、利用目的、通知方法も事前に決める必要があります。MonsterHouseは技術構成を示す作品であり、企業利用に必要なプライバシー要件まで定義しているわけではありません。実導入では、便利な視覚情報をどこまで取得するかを、技術的に可能な範囲ではなく、利用目的に必要な最小範囲から判断すべきでしょう。
企業向け対話キャラクターへ応用する実装順序
MonsterHouseそのもののコードは配布用にまとめられていませんが、利用しているNVIDIAの各モデルとVoice Agentは公開されています。独自キャラクターを試す場合は、完成形を一度に構築するより、音声で一往復できる最小構成から始めるほうが現実的です。Generic Assistantの例では、音声認識、言語モデル、Magpie TTSに加え、音声区間の検出と発話終了の処理まで確認できます。
初期検証では、短く読み上げやすい返答を生成する会話モードを選び、単純な応対では推論過程を使わない設定が候補になります。その後、システムプロンプトと少数の連続した会話例で口調を整えます。利用者の状態や業務フローはアプリケーションに保持し、プロンプトだけで再現できない人格差が必要になった段階でLoRAを検討します。
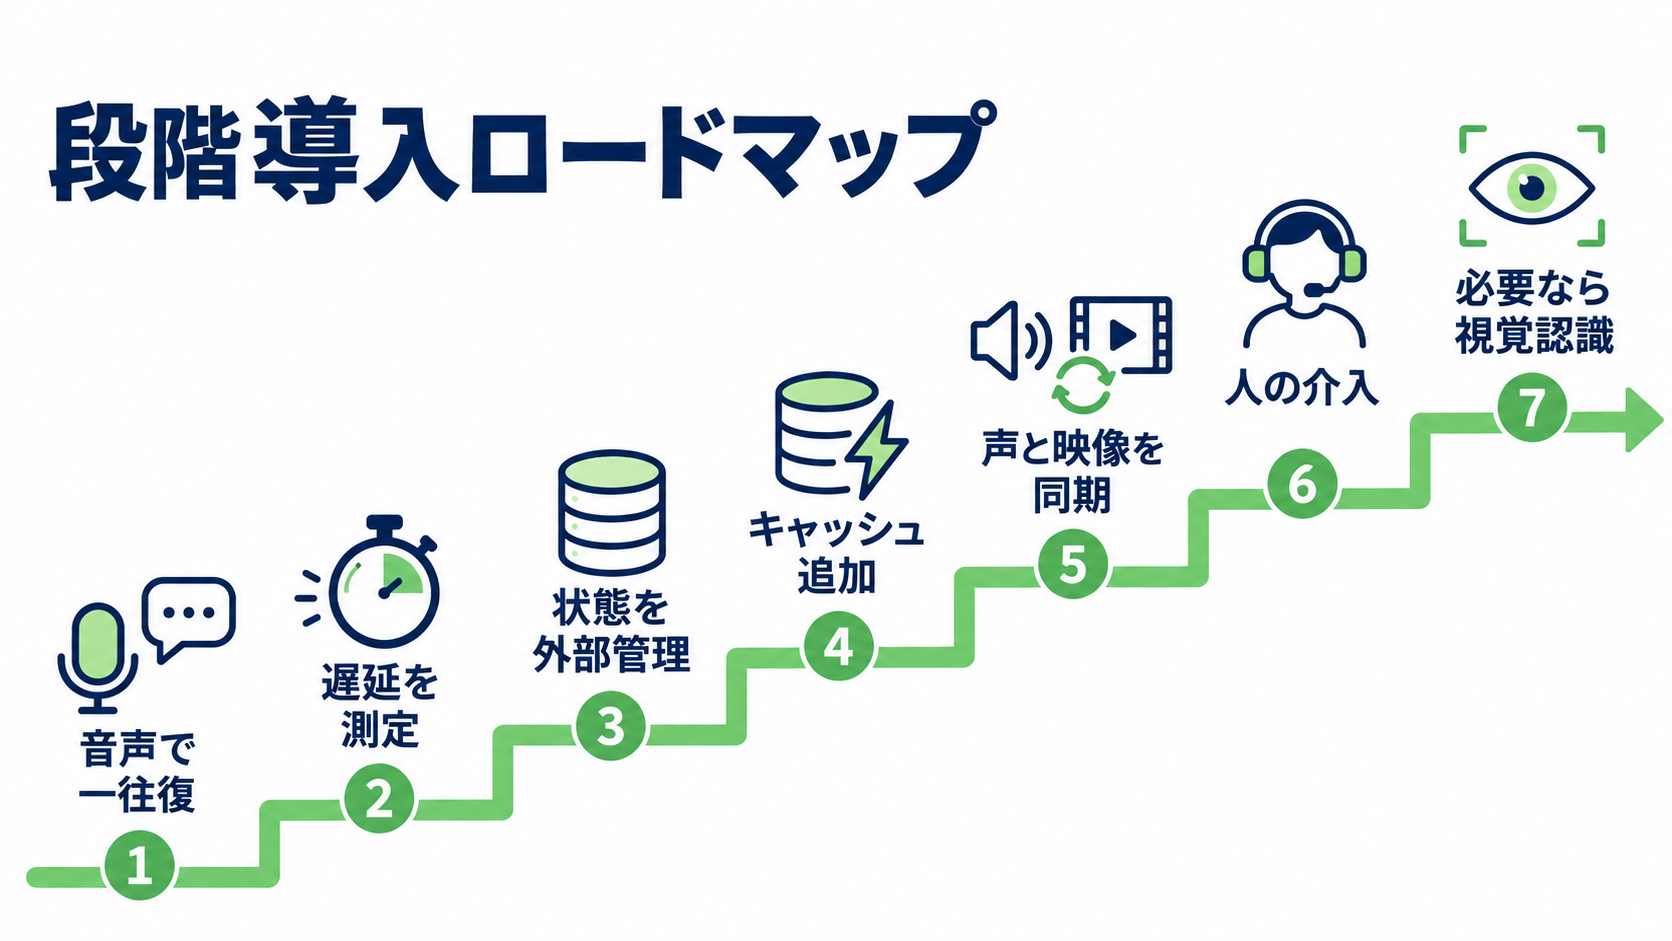
導入の順序は、次のように整理できます。
- 音声認識、回答生成、音声合成だけで、一往復の待ち時間と認識品質を測ります。
- 頻出する発話を抽出し、定型テキストまたは録音音声へ置き換えます。
- 会話状態をアプリケーションで管理し、モデルが変更されても業務ルールが崩れないようにします。
- 許可を得た音声でキャラクターの声を作り、口の動きや画面演出との同期を検証します。
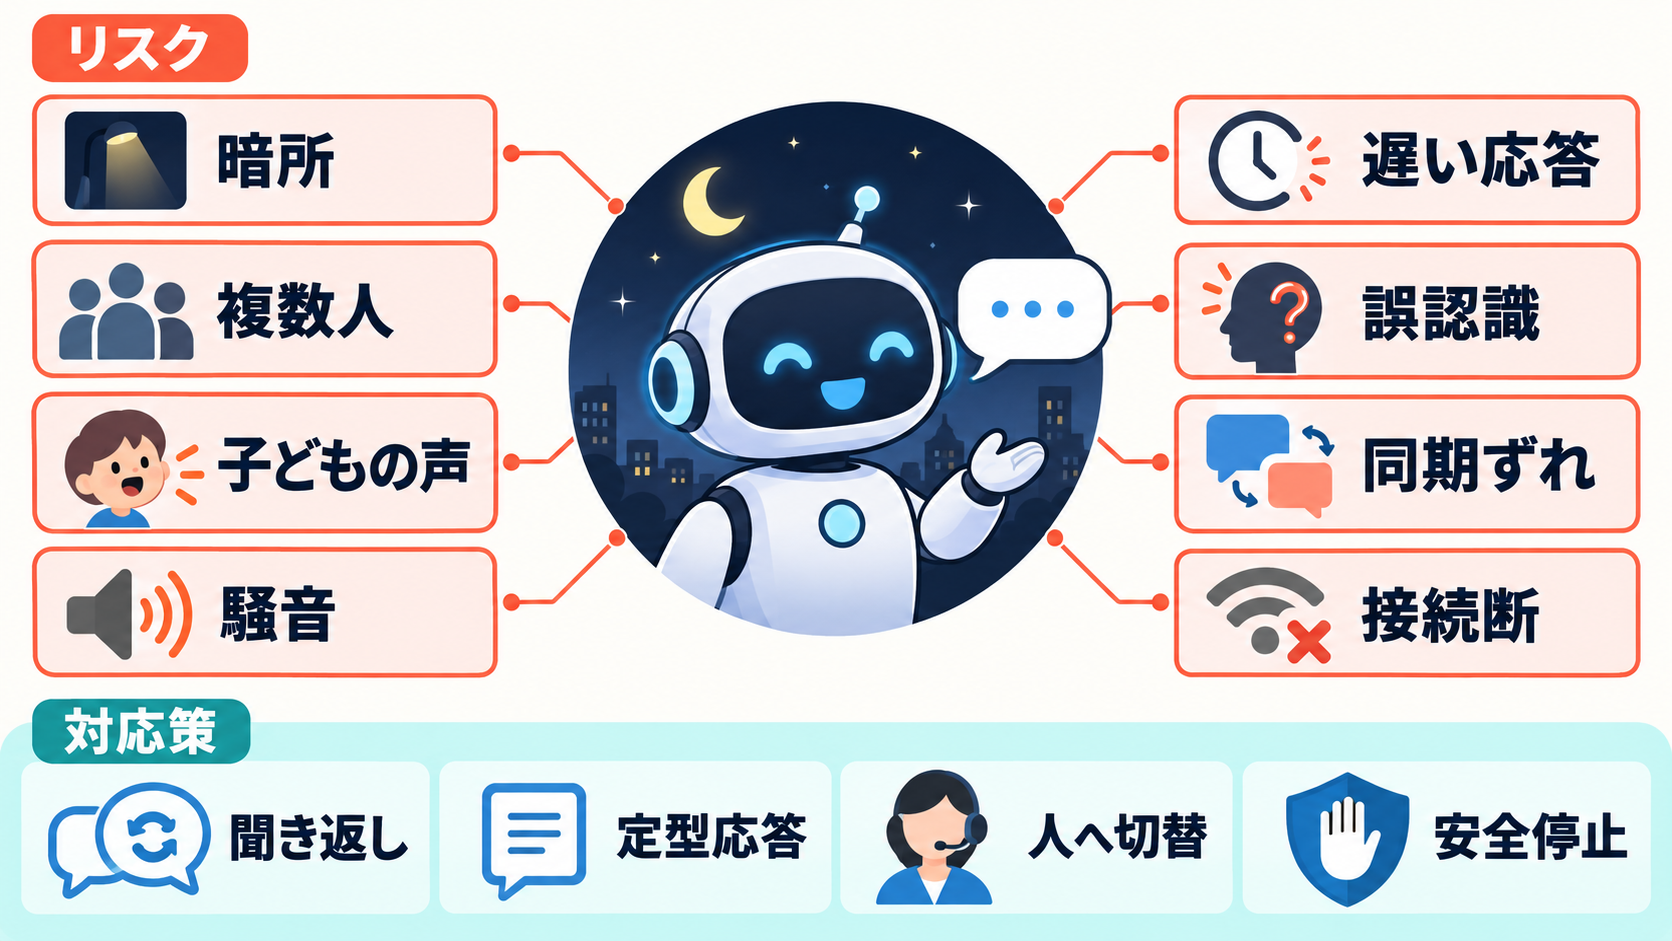
- 自動応答が失敗した際の定型応答、人による介入、機能停止の経路を用意します。
- 視覚情報が本当に必要な場合に限り、VLMや人物追跡を追加します。
この順序なら、途中の段階でも検証可能な成果物が残ります。映像認識や精巧な3Dキャラクターを先に作り込んだ後で、会話の遅延が用途に合わないと判明する事態も避けやすくなります。モデルの置き換えが前提となる生成AIでは、各機能の入出力を明確にし、特定モデルへの依存を小さくすることも大切です。
社内で最初に決めるべきなのは、キャラクター設定より、利用者に何をしてもらうシステムなのかという一点です。案内、教育、受付、販売支援では、許容される待ち時間も、必要な記憶も、誤回答時の影響も異なります。目的を一つの会話場面へ絞り、その場面で必要な音声経路とフォールバックを紙上に描くことが、実装へ進むための具体的な第一歩になります。
実証段階に残る課題と評価の視点
MonsterHouseは完成済みの無人運用システムではありません。実際の私道に集まる子どもや保護者、さまざまな仮装、夜間照明を使った総合試験は今後の課題です。映像から人物を検出すると自動で挨拶できますが、流行中の衣装を正しく識別し、それに合った気の利いた返答を返すには追加調整が必要になる可能性も示されています。菓子の自動配布もまだ実装されていません。
テスト映像で成功した認識が、実環境でも同じように機能するとは限りません。複数人が同時に話す場面、子どもの声、周囲の音楽、暗所、顔や衣装の重なりは、音声認識と映像認識の両方へ影響します。認識精度だけでなく、間違えた際にキャラクターらしく聞き返せるか、応答を安全に打ち切れるかも確認対象になります。
評価では、平均値だけでなく遅い応答の分布を見る必要があります。通常は1秒台で話し始めても、モデルの読み込みや同時処理によって一部の応答だけが長く止まれば、現場では不安定な印象を与えます。返答の反復、会話状態の脱落、感情タグと発話内容の不一致、音声と口のずれなども、個別のモデル評価では見落としやすい項目です。
安全面では、来訪者が想定外の質問や不適切な言葉を入力する可能性もあります。MonsterHouseでは会話の進行、プロンプト、LoRA、操作卓を組み合わせていますが、企業利用では禁止領域、ログの扱い、人への引き継ぎ条件を用途ごとに定義する必要があります。自由な対話を増やすほど、監視と介入の仕組みも求められます。
この事例から得られる現実的な示唆は、小規模モデルをローカルで動かせば自動的に優れた体験になる、ということではありません。会話状態、キャッシュ、同期、負荷分散、操作画面、代替経路を一緒に設計して初めて、利用者がキャラクターとして受け入れられる応答になります。導入を検討する企業は、最初の実証でモデル精度だけを競わせず、失敗を含む一連の利用体験を観察するとよいでしょう。