
2026/10/30
今更聞けないAI知識
「基盤モデル」は生成AIの共通部品 アプリとの違いから万能ではない理由まで
同じ生成AIに見えても、土台と仕上げは別物
文章を要約するサービス、画像を作るサービス、質問に答えるチャット。どれも「AI」と呼ばれるため、別々の仕組みが一から作られているように感じるかもしれません。実際には、大規模に事前学習されたモデルを土台にし、その上へ用途別の調整や画面、機能を組み合わせている場合があります。その土台に当たるものが「基盤モデル」です。
一言で答えるなら、基盤モデルとは「多くの用途へ展開できる、事前学習済みの大きなモデル」です。Googleの機械学習用語集では、巨大で多様な訓練データを使って事前学習され、幅広い要求へ対応できるモデルであり、追加の調整やカスタマイズの出発点にもなると説明されています(出典: Google for Developers)。IBMも、生成AIが基盤モデルから始まり、文章向けの大規模言語モデルだけでなく、画像、映像、音声、音楽、複数形式を扱うモデルがあると説明しています(出典: IBM)。
ただし、「共通の土台」は「すべてのサービスが同じモデルを使う」という意味ではありません。基盤モデルには複数の種類があり、同じモデルを利用する場合でも、調整方法や与える情報、利用できる道具、画面設計によって使い勝手は変わり得ます。住宅にたとえるなら、基盤モデルは建物の骨組みや基本設備に近い存在です。同じ骨組みを出発点にしても、店舗、事務所、住居では内装も運用ルールも異なるでしょう。
この区別を知っておくと、「このAIは賢いか」という漠然とした見方から離れられます。確認したいのは、土台となるモデルだけではありません。何のために調整されたサービスなのか、どの情報を参照できるのか、出力を誰が確かめるのかまで分けて考える必要があります。基盤モデルという言葉は、生成AIを一枚岩として捉えないための入口なのです。
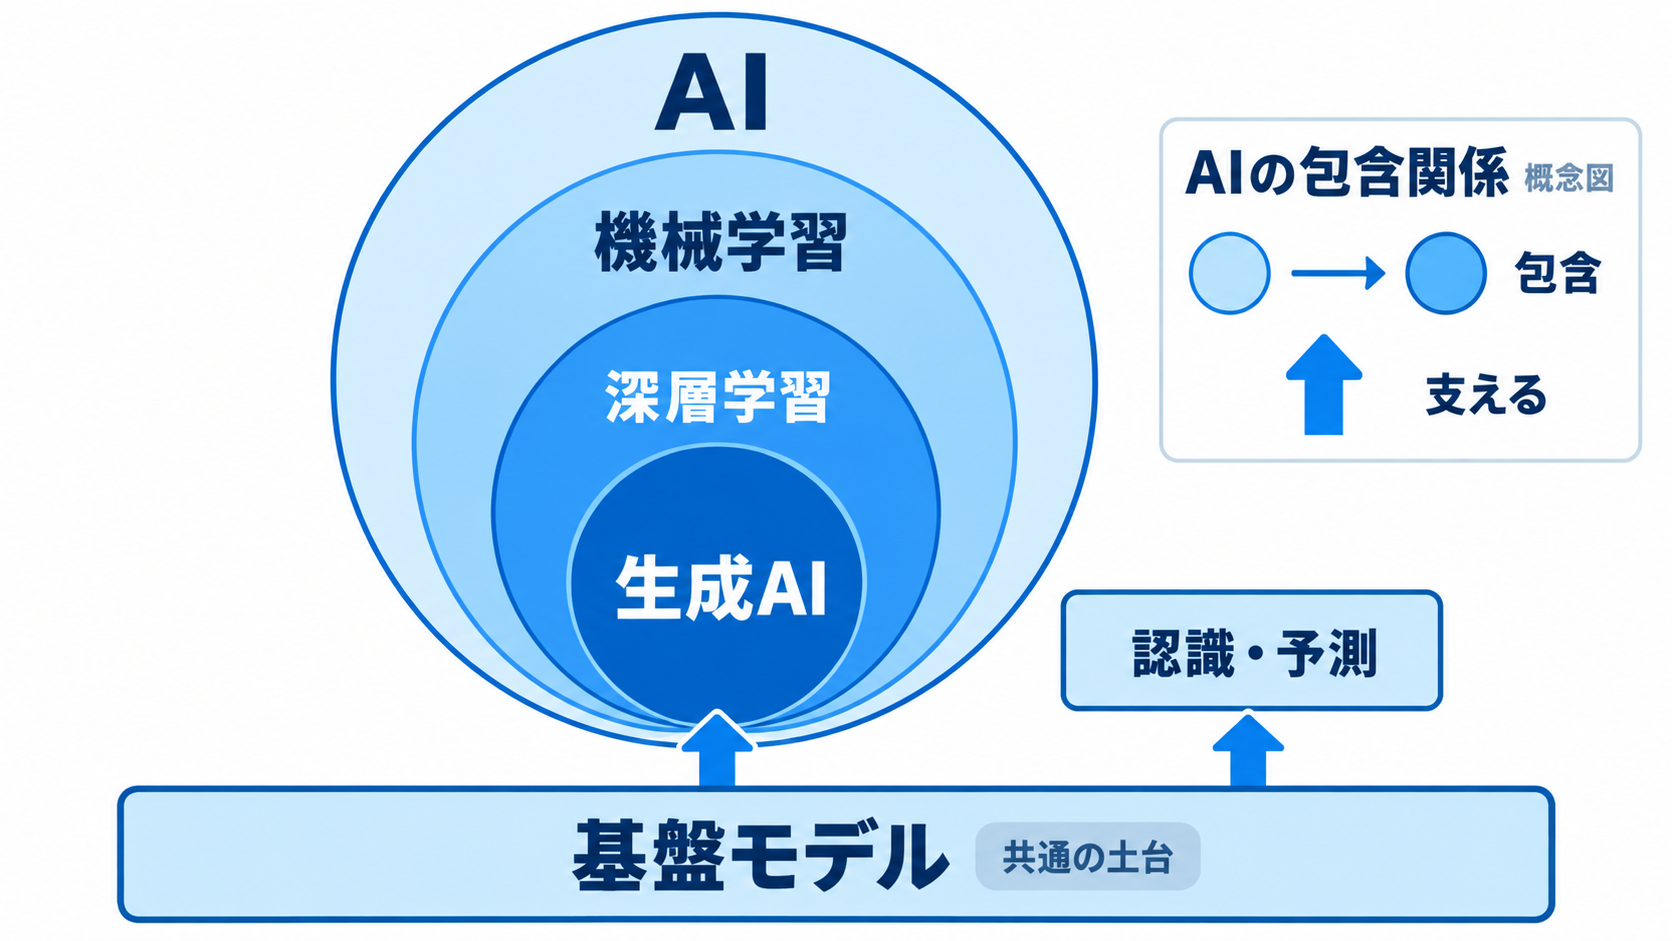
AIから生成AIまでを入れ子で捉える位置関係
「AI」「機械学習」「深層学習」「生成AI」は、同じ意味の言い換えではありません。IBMは、AIを人間の学習、理解、問題解決、意思決定などを模した働きを機械に持たせる技術として説明しています。その内側に、データから予測や判断のためのモデルを作る機械学習があります。機械学習の一部として、多層のニューラルネットワークを使う深層学習があり、その技術を使って文章や画像などを生成するモデルが生成AIを支えています(出典: IBM)。
大きな傘を思い浮かべると整理しやすいでしょう。最も大きな傘がAIで、その下に機械学習があります。深層学習は機械学習に含まれ、現在の多くの生成AIを支える方法の一つです。Google Cloudも、AIを幅広い概念、機械学習をデータから知識を取り出して学ぶAIの一分野として位置付けています(出典: Google Cloud)。
基盤モデルは、この並びに単純な五段目として加わるものではありません。生成AIなどに利用される「モデルの作られ方と役割」を表す言葉だからです。たとえば、文章生成向けの大規模言語モデルは基盤モデルになり得ますが、基盤モデルは文章専用とは限りません。画像や音声を扱うものもあり、複数種類の入力や出力に対応するものはマルチモーダルモデルと呼ばれます(出典: IBM)。
ここでいう「モデル」は、入力から出力を導くために、学習データ中のパターンや関係を数値として保持した仕組みです。チャット画面や製品名そのものを指すとは限りません。利用者が触れるサービスには、モデルに加えて入力画面、会話履歴の扱い、安全対策、外部機能などが組み合わされることがあります。店頭の商品だけを見て工場の生産設備まで同じものだと思わないように、AIでもサービスとモデルを分けると混乱が減るでしょう。
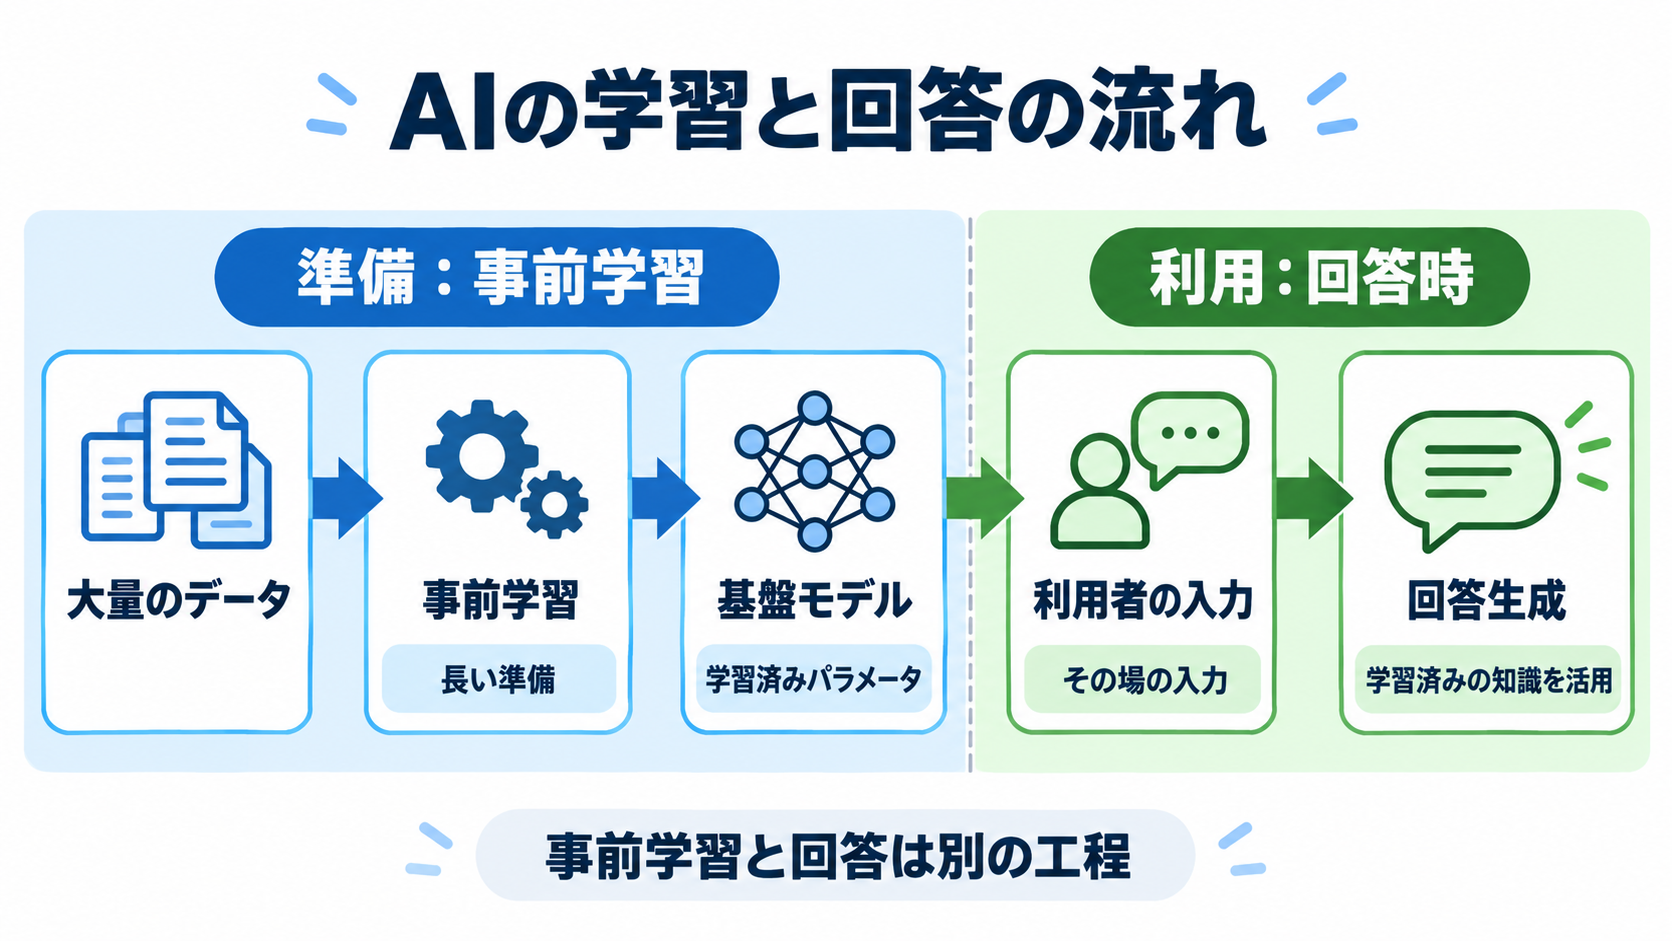
大量の資料を読む事前学習と、回答を作る瞬間の違い
基盤モデルを作る中心的な工程が「事前学習」です。これは、特定の利用者から質問を受ける前に、大量のデータを使ってモデルを訓練する工程を指します。IBMの説明では、文章や画像、映像などの大量の生データから、対象同士のパターンや関係を表す多数のパラメータが形成されます。パラメータとは、モデルが入力を処理して出力を決める際に使う、学習済みの数値の集まりだと考えるとよいでしょう(出典: IBM)。
料理にたとえるなら、事前学習は多くの食材や調理例に触れ、組み合わせの傾向を身につける長い準備期間です。利用者が注文してから、厨房で料理人が料理学校へ入り直すわけではありません。同じように、質問への回答を生成する処理と、基盤モデルを事前学習する処理は分けて考える必要があります。質問した直後に回答が変わったとしても、それだけで基盤モデル全体が再学習されたとは判断できません。
チャットでは、同じ会話の前半に書かれた内容が後半の「文脈」として使われる場合があります。Googleの用語集も、会話では利用者の入力とモデルの過去の応答が、その後のやり取りの文脈になると説明しています(出典: Google for Developers)。これは、会話中のメモを見ながら話を続けるような働きです。長期間をかけてモデルのパラメータを変える学習とは別物になります。
たとえば、架空の出張計画について「目的地は札幌です」と先に伝え、後から「現地の持ち物を整理してください」と頼めば、先の目的地が回答に反映される可能性があります。これは文脈の利用例であり、「札幌に関する内容を基盤モデルが新しく学習した」とは限りません。なお、会話データの保存や製品改善への利用条件はサービスごとに確認すべき事項です。基盤モデルという一般概念だけから、個別サービスのデータ取扱方針を推測しないことが大切です。
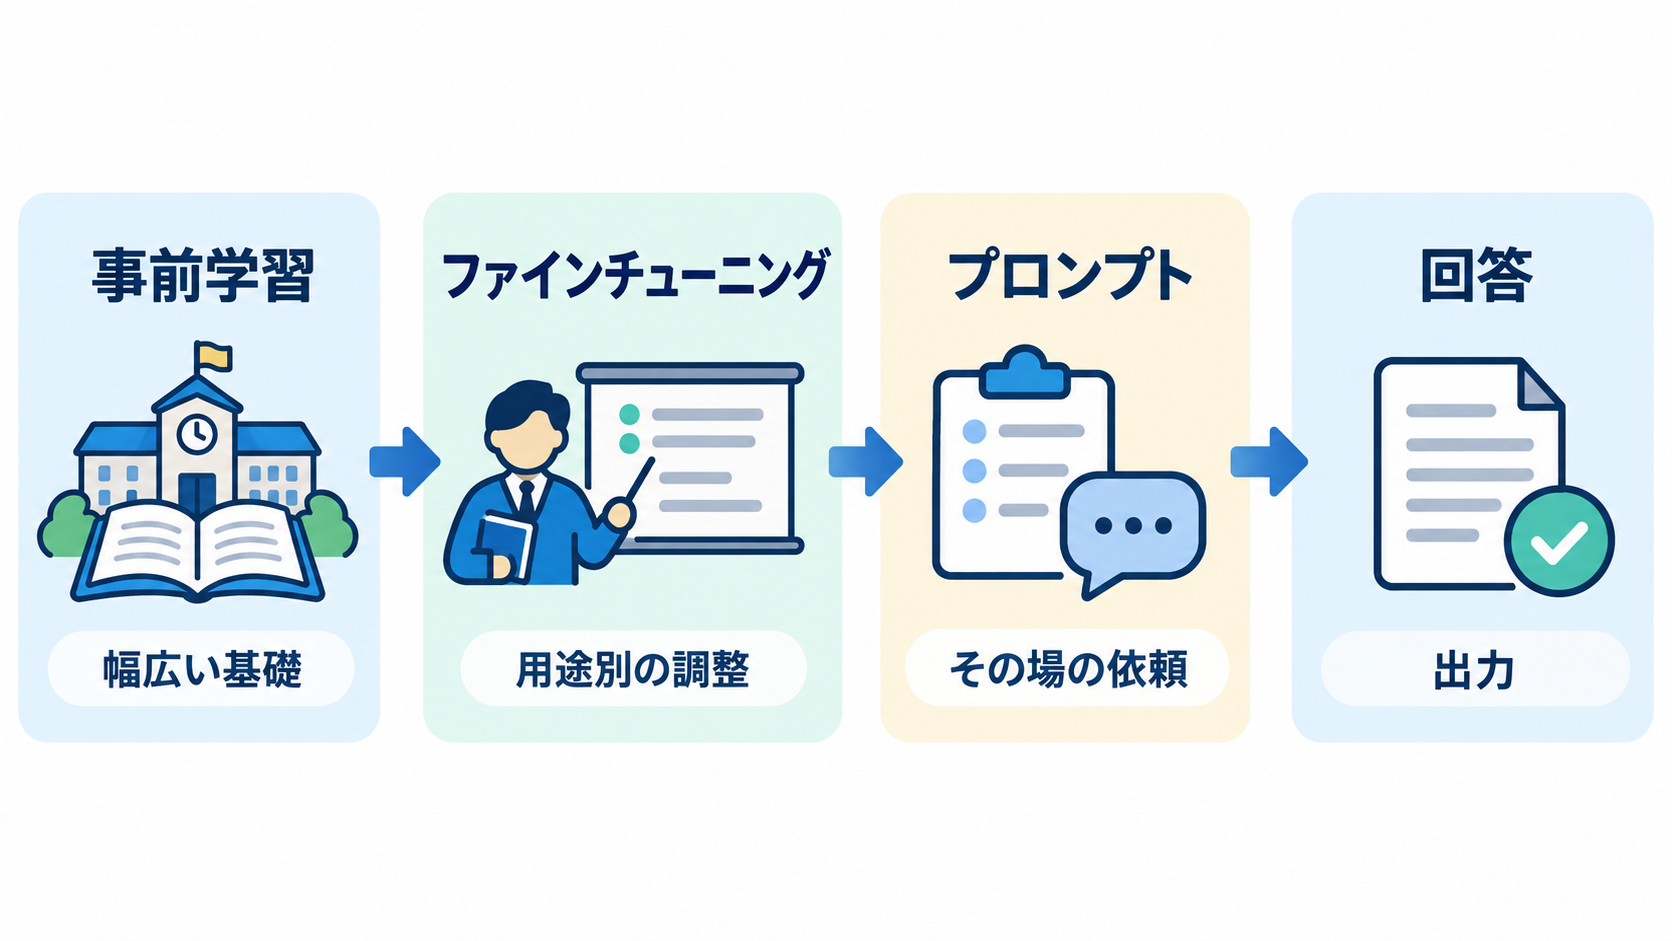
事前学習・ファインチューニング・プロンプトの役割分担
基盤モデルを用途へ合わせる方法として「ファインチューニング」があります。日本語では追加学習や微調整と表現されることもあり、事前学習済みモデルに対して、特定の仕事に関係するデータを使った二段階目の訓練を行う方法です。Googleの用語集では、医療の問い合わせへ答える文章モデルや、シャチの画像を生成する画像モデルなどが説明用の例として挙げられています(出典: Google for Developers)。
似た言葉を役割で分けると、次のようになります。
| 言葉 | 何をするものか | 身近なたとえ |
| --- | --- | --- |
| 事前学習 | 大量で幅広いデータから基礎となるパターンを学ぶ | 幅広い教科を長期間学ぶ |
| ファインチューニング | 事前学習済みモデルを特定の用途へ追加調整する | 配属後に専門研修を受ける |
| プロンプト | 利用時に目的や条件をモデルへ入力する | その場で依頼内容を伝える |
| 回答生成 | 入力とモデルの学習済みパターンから出力を作る | 依頼に応じて成果物を作る |
利用者がチャット欄へ書くプロンプトは、通常、ファインチューニングそのものではありません。プロンプトはその場の依頼であり、ファインチューニングはモデルのパラメータを用途に合わせて調整する訓練工程です。IBMも、基盤モデルの作成後に、用途固有のラベル付きデータや質問と望ましい回答を用いて調整する流れを示しています(出典: IBM)。
初心者が日常的に意識しやすいのはプロンプトのほうです。たとえば架空の社内案内文を作るなら、「案内文を書いてください」だけでなく、「新入社員向けに、専門用語を避け、確認事項を三つに整理してください」と条件を添える方法が考えられます。これは入力例の提案であり、どのサービスでも同じ結果になることを保証するものではありません。モデル、製品側の設定、入力した資料なども出力に関係するからです。
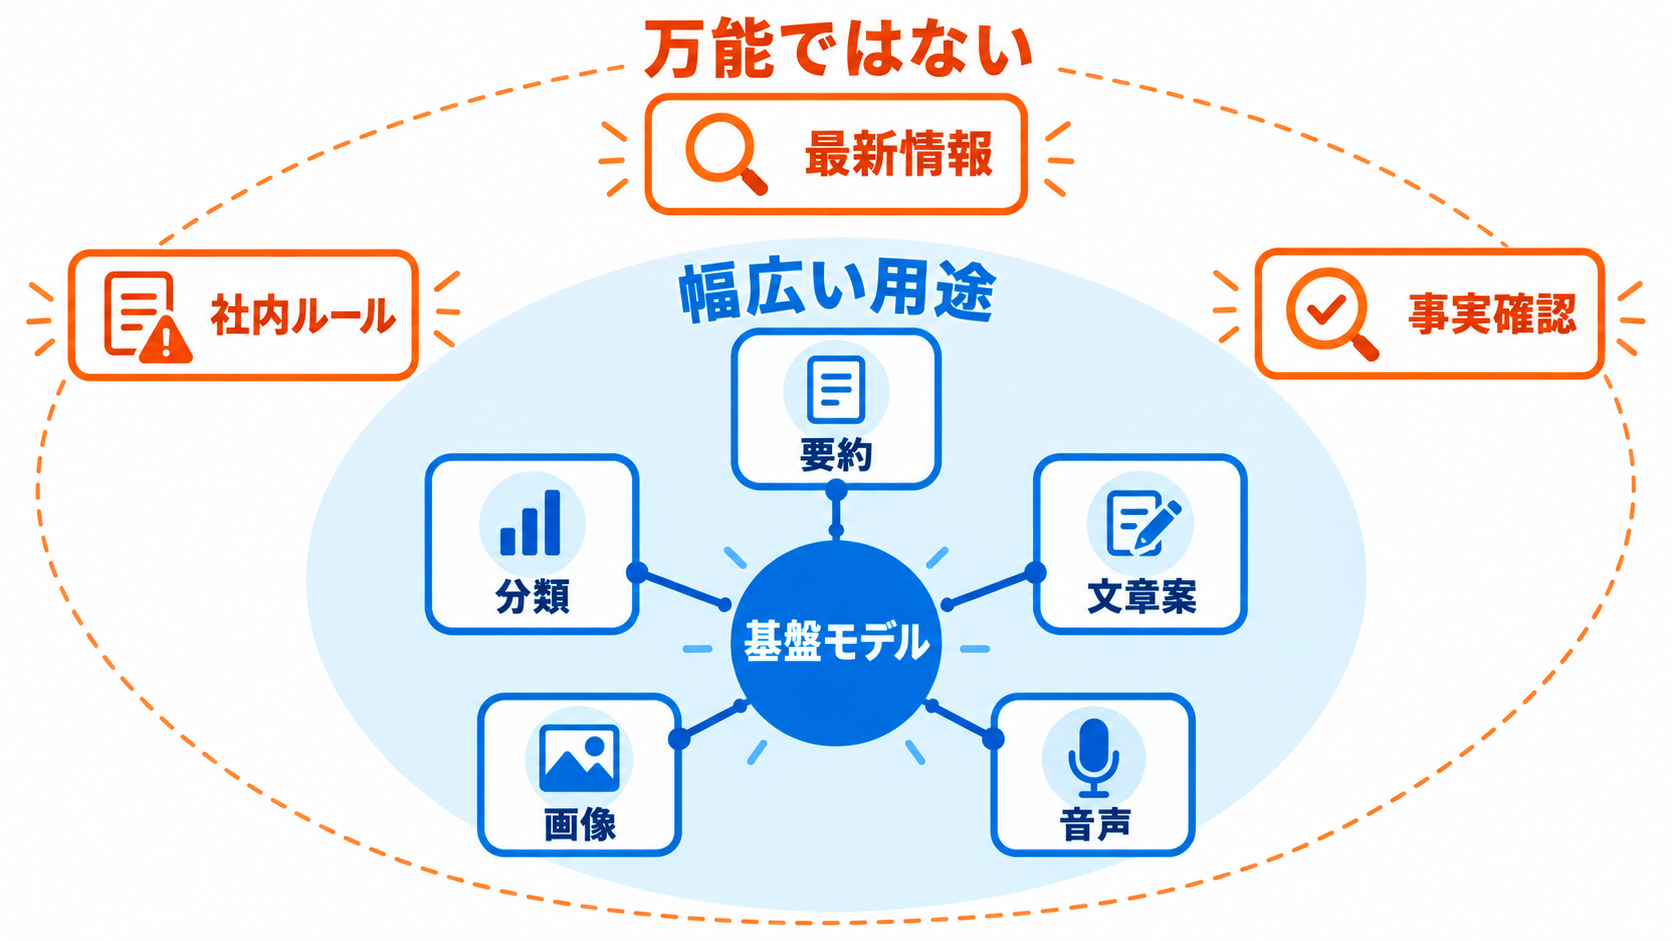
幅広く使えることと、万能であることの隔たり
基盤モデルの特徴は、単一の仕事だけに閉じず、多様な用途の出発点になれることです。文章向けモデルなら、要約、分類、質問への回答、文章案の作成などへ展開できる場合があります。画像や音声向けの基盤モデルも存在し、複数の形式を扱うモデルもあります(出典: IBM)。一つの土台を複数用途へ応用できるため、「基盤」という名前が付いています。
しかし、幅広さは正確さや適性を自動的に保証しません。生成モデルは、学習データの簡略化された表現を作り、その表現から元データと似ていても同一ではない内容を生成するとIBMは説明しています(出典: IBM)。つまり、保管された正解文を毎回そのまま取り出す仕組みとして捉えるのは適切ではありません。依頼に沿った自然な文章を作れても、固有名詞、日付、社内規則などの確認が必要な情報まで正しいとは限らないでしょう。
身近な例として、幅広い教養を持つ人に、初めて見る会社の経費規程について質問する場面を考えてみてください。その人は一般的な出張精算の説明はできても、会社独自の上限額や承認経路までは資料なしに確定できません。基盤モデルにも似た境界があります。広いパターンを学んでいることと、利用者固有の最新資料を参照できることは別です。この例は仕組みをつかむためのたとえであり、AIが人と同じように理解したり意識を持ったりするという意味ではありません。
用途別にファインチューニングされていても、万能になるわけではありません。特定の形式や仕事に合いやすくする調整は、あらゆる事実を最新にしたり、すべての誤りをなくしたりする処理とは異なります。利用時には「文章を整える仕事なのか」「事実を確定する仕事なのか」「組織独自の資料が必要なのか」を切り分けると、基盤モデルの幅広さを過信せずに使えるでしょう。
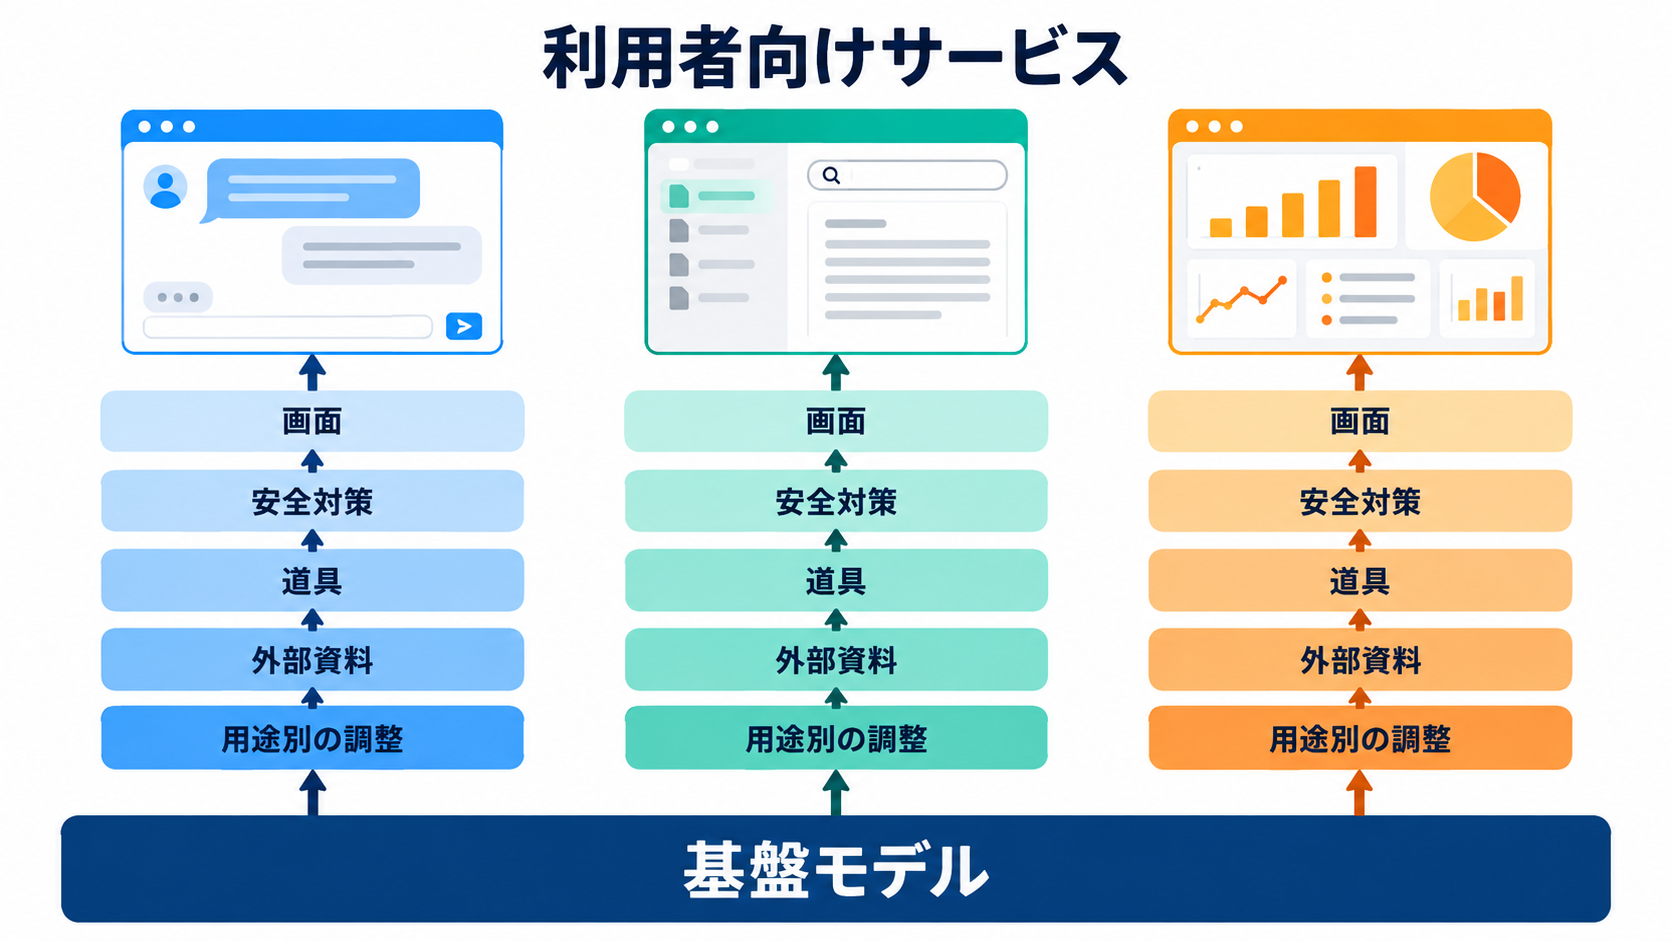
同じ基盤モデルでもサービスごとに体験が変わる理由
利用者が普段触れるのは、多くの場合、基盤モデル単体ではなくアプリケーションやサービスです。Googleの用語集は、モデル、対話型の画面、開発者向けの接続手段、モデルを利用した業務製品を別の構成要素として説明しています(出典: Google for Developers)。特定製品に限らず、「モデル」と「モデルを組み込んだサービス」を区別する考え方は、生成AIを比較するときに役立ちます。
たとえるなら、基盤モデルはエンジン、サービスは完成した乗り物です。同じ系統のエンジンを使っていても、車体、操作装置、積載量、安全機能が違えば、適した用途も運転感覚も変わります。生成AIでも、入力できる情報の種類、会話の文脈、外部資料の参照、利用できる道具などが組み合わさり、利用者が目にする体験になります。IBMは、生成AIのモデルが内容を作るのに対し、AIエージェントはモデルの出力と外部の道具を利用して判断や作業を進めるものとして区別しています(出典: IBM)。
この違いを知らないと、一つのサービスでうまくいかなかった経験から「基盤モデルは全部できない」と考えたり、反対に一つの成功例から「同じモデル名なら別サービスでも同じことができる」と期待したりしがちです。実際に確認すべき対象は、モデル名だけではありません。サービスが何を入力として受け取り、どの資料や機能へ接続され、どこまで利用者の確認を前提としているのかを見る必要があります。
たとえば、架空の議事録作成サービスと一般的な対話サービスが似た基盤モデルを使っていたとしても、前者には発言者の区別や議題ごとの整理を支える仕組みが追加されているかもしれません。これは理解のための仮定例であり、特定製品の仕様を示すものではありません。製品を選ぶときは、「有名なモデルだから」だけで決めず、実際に必要な入力、出力形式、確認方法が提供条件に合うかを見るのが現実的です。
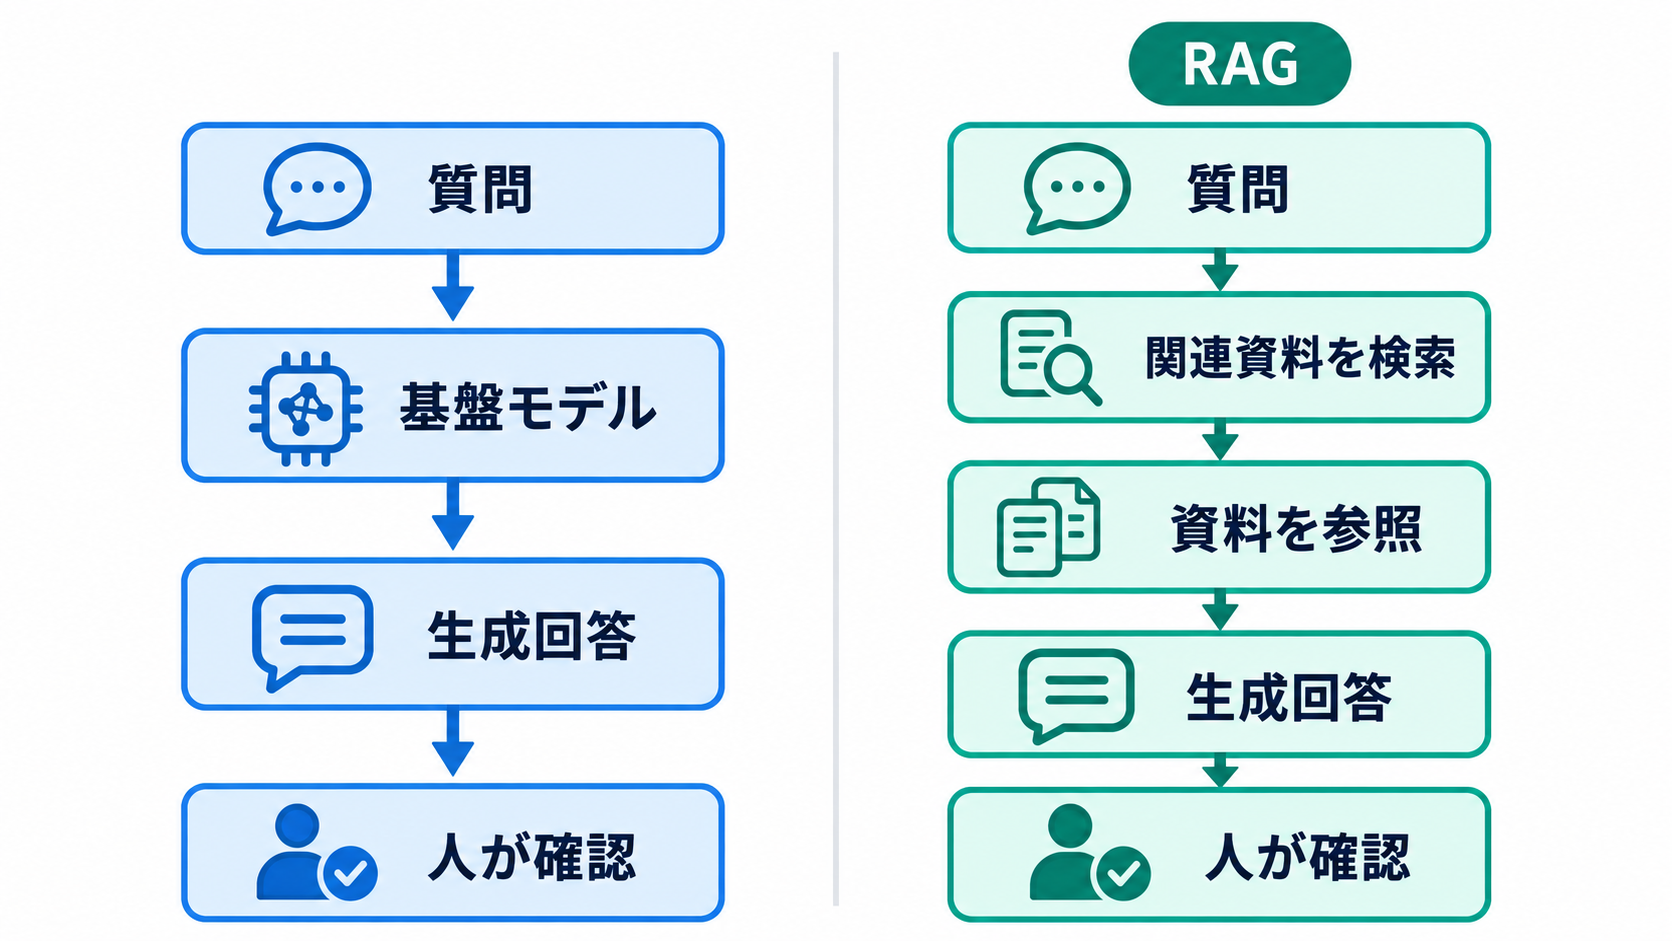
検索や外部資料の参照と混同しない確認方法
生成AIの回答に具体的な日付や制度名が含まれると、その場でインターネットを検索して見つけた情報のように見えることがあります。しかし、基盤モデルが学習済みの表現から内容を生成する動作と、外部の資料を参照する動作は区別すべきです。IBMは、学習データの外にある関連情報を利用する方法として、検索拡張生成、略してRAGを紹介しています(出典: IBM)。RAGは、関連資料を取り出して生成に利用する考え方です。
だからといって、RAGを使えば回答が必ず正しくなるわけではありません。参照する資料が目的に合っているか、古くないか、生成された文章が資料の内容と一致するかという確認は残ります。Googleの用語集でも、事実に基づく出力を重視する「事実性」と、創作性を重視する依頼は目的が異なると説明されています(出典: Google for Developers)。社内規程の確認と、架空の物語の作成を同じ基準で評価する必要はありません。
日常で使う際は、回答内容を三つに分けると扱いやすくなります。文章の言い換えやアイデア候補は、目的に合うかを人が選びます。日付、金額、制度、引用などの検証可能な事実は、元資料と照らします。健康、法律、契約、重要な意思決定に関わる内容は、AIの文章だけで確定せず、適切な公式情報や専門家へ確認する必要があるでしょう。この確認方法は、基盤モデルを避けるためではなく、得意な文章生成と事実確認を混ぜないためのものです。
サービスの画面に出典やリンクが表示される場合も、「リンクがある」という事実だけで終わらせず、該当箇所まで開いて確認します。反対に、出典が示されない回答を検索結果と同じものとして扱うのも避けたいところです。入力時に「不明な点は不明と分け、確認が必要な固有名詞を列挙してください」と頼む方法は、確認作業を整理するための提案例になります。ただし、この指示によって誤りが完全になくなるとは限りません。
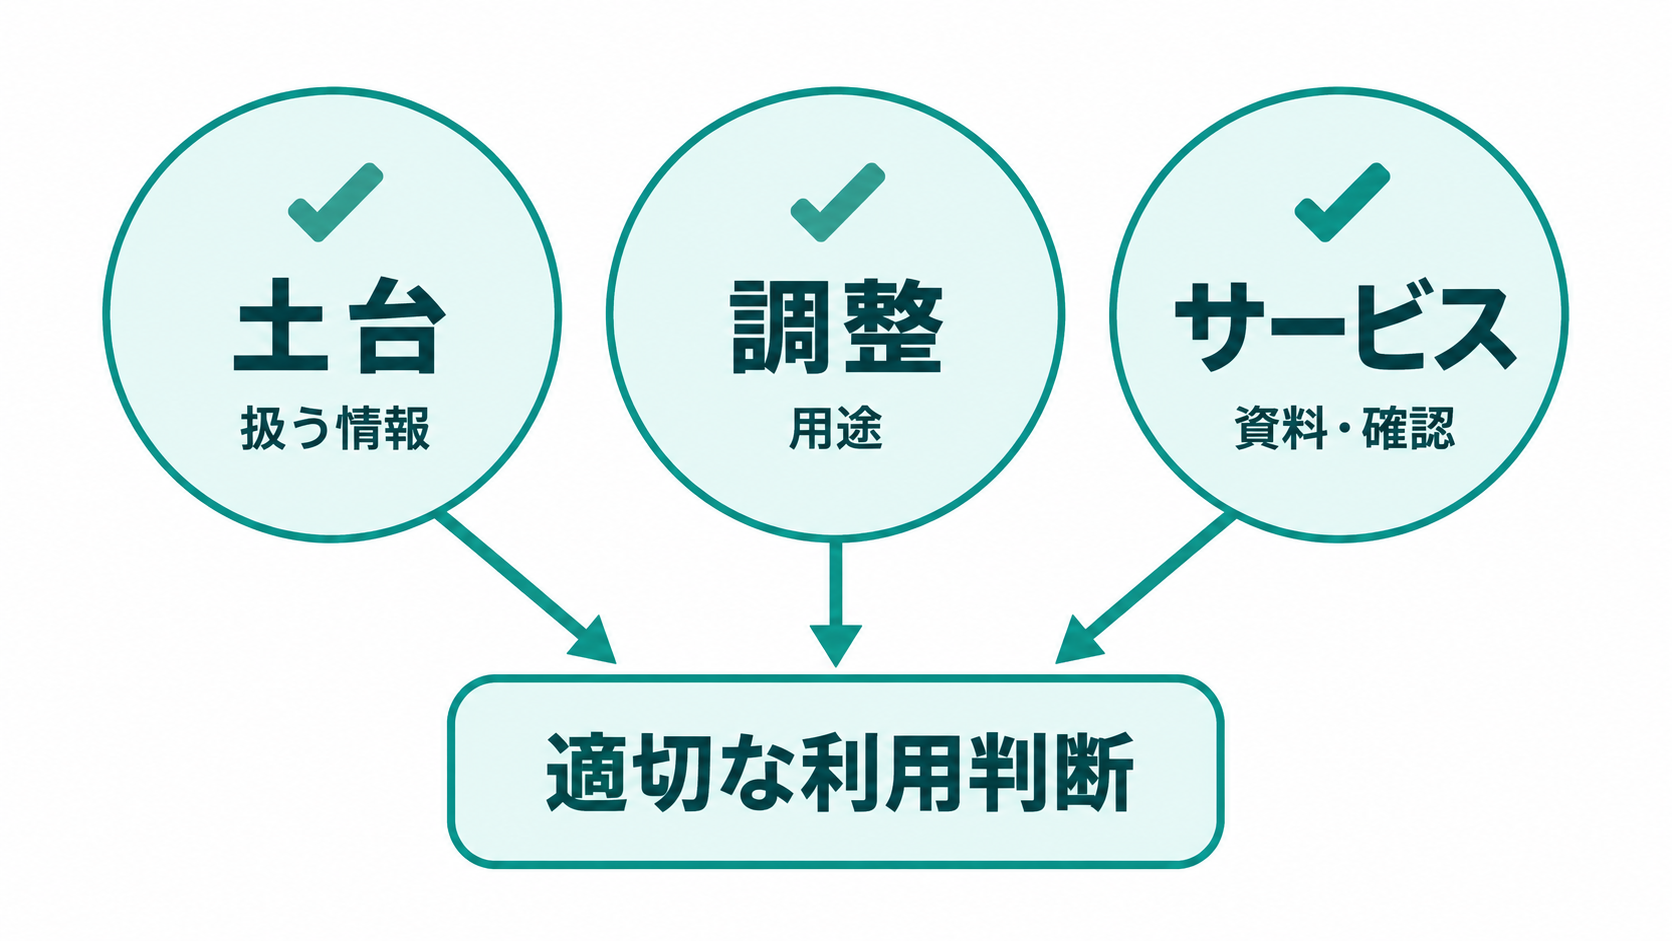
明日から使える「土台・調整・サービス」の三点確認
基盤モデルという言葉を覚える目的は、専門用語を増やすことではありません。生成AIを使う前に、どこまでを期待し、どこからを確かめるか判断しやすくすることにあります。明日、AIを使う場面があれば、画面の奥を「土台」「調整」「サービス」の三つに分けて眺めてみてください。
土台については、「文章、画像、音声など、何を扱うモデルなのか」を見ます。調整については、「どんな用途に合わせた製品なのか」を確認します。サービスについては、「外部資料を参照できるのか、出典を確認できるのか、最終判断を誰が行うのか」を考えます。名称や宣伝文句だけでは分からない場合、提供元の説明や利用条件を読むのが確実です。
試す題材は、正解を自分で判断できる小さなものが向いています。たとえば、自分で書いた架空の案内文を短くする、箇条書きから見出し案を出す、同じ内容を対象読者別に言い換える、といった使い方が考えられます。出力を見たら、読みやすさだけでなく、入力にない固有名詞や数字が加わっていないかも確認します。これは効果を保証する手順ではなく、モデルの出力傾向と確認点をつかむための提案です。
基盤モデルは、多くの生成AIを支える共通部品になり得ますが、利用者が触れる完成品そのものではありません。事前学習で作られた土台へ、用途別の調整や外部資料、画面、道具が重なってサービスになります。この構造が見えれば、「AIなら知っているはず」「同じモデルなら同じ結果になるはず」という期待をいったん分解できます。
次に生成AIの回答を読むときは、内容の良し悪しを判断する前に、「これは土台に由来する生成なのか、入力した資料に基づくのか、外部情報を参照したのか」と問い直してみてください。その一手間が、便利な下書きと確認が必要な事実を見分ける出発点になります。
参考情報
- What Is Artificial Intelligence (AI)? | IBM(2024年8月9日公開、2026年10月2日更新、2026年10月30日取得)
- AI vs. Machine Learning: How Do They Differ? | Google Cloud(2026年10月30日取得)
- مسرد مصطلحات التعلم الآلي: الذكاء الاصطناعي التوليدي(2026年10月30日取得)