
2026/10/30
今更聞けないAI知識
ディープラーニングは何が「深い」のか?機械学習との親子関係を身近な例で理解する
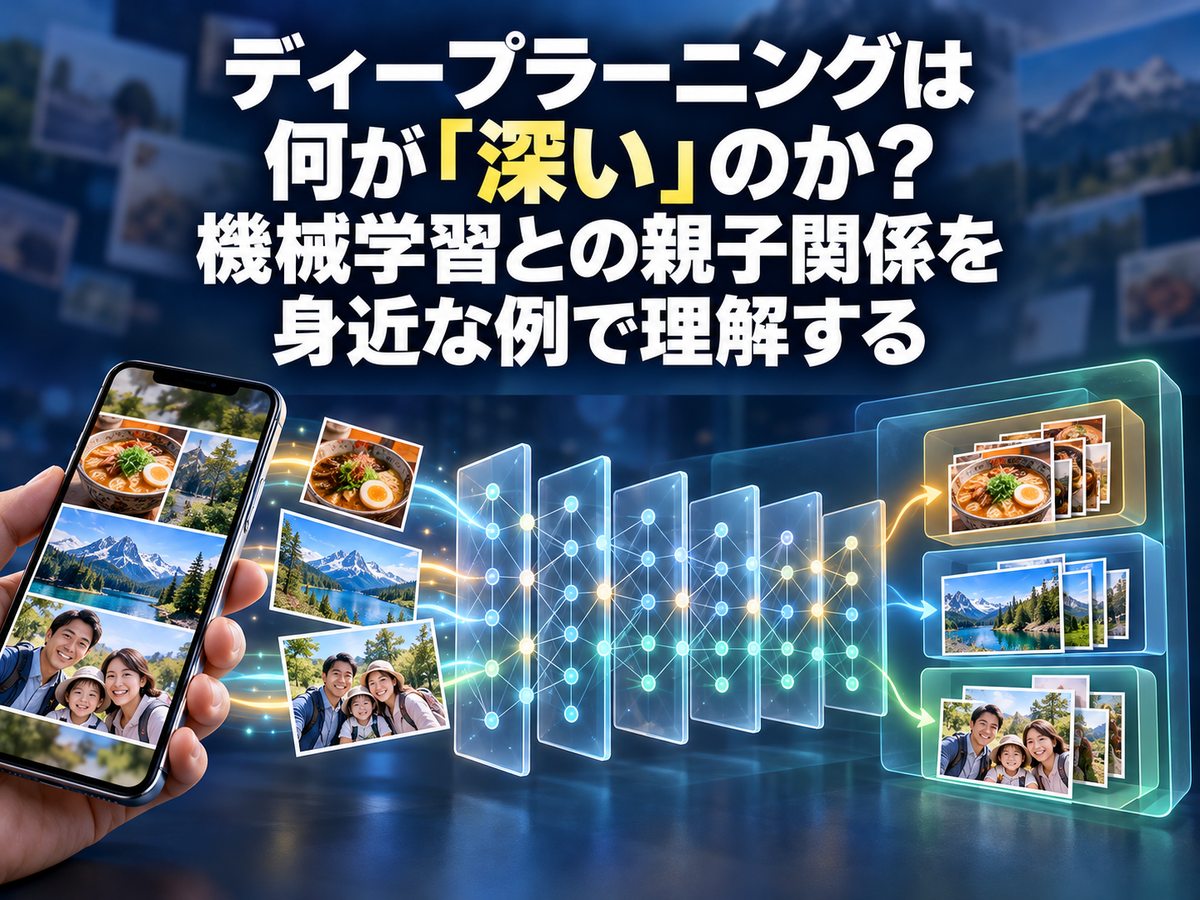
写真の自動分類と文章生成を支える「深い学習」
スマートフォンが写真に写った物を見分けたり、生成AIが質問に合わせて文章を作ったりするとき、その裏側では何が起きているのでしょうか。説明の中でよく登場するのが「ディープラーニング」です。ただし、AIとは別の独立した技術なのか、機械学習の新しい呼び名なのかが分からず、そこで話についていけなくなる人も少なくありません。
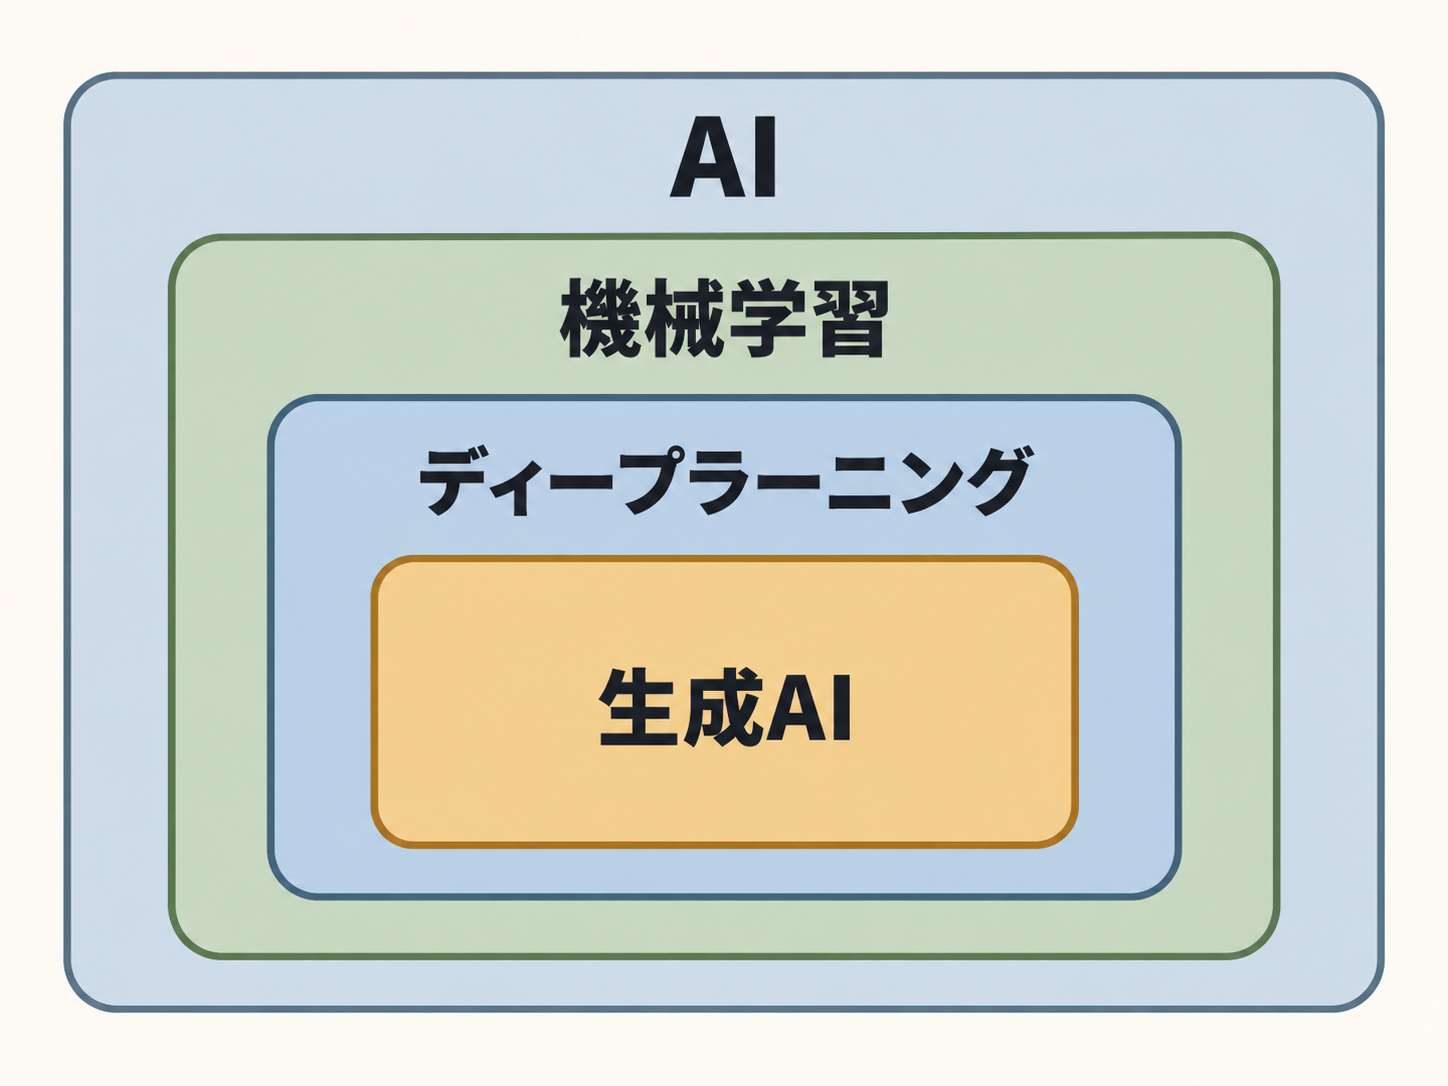
一言でまとめると、ディープラーニングとは、機械学習のうち、何層も重ねたニューラルネットワークを使ってデータの複雑なパターンを捉える方法です。AIという広い分野の中に機械学習があり、その内側にディープラーニングがあります。IBMの資料でも、AI、機械学習、ディープラーニング、生成AIは、互いに無関係な言葉ではなく、入れ子に近い関係として説明されています(出典: IBM)。
たとえば、家族旅行の写真を「食べ物」「風景」「人物」に整理する場面を考えてみましょう。人が一枚ずつ確認して分類する代わりに、過去の画像に含まれる特徴や関係をデータから捉え、新しい画像を分類する仕組みを作る方法の一つが機械学習です。その学習に多層のニューラルネットワークを使う場合、ディープラーニングと呼ばれます。
ここで大切なのは、ディープラーニングがAI全体の言い換えではないことです。AIには幅広い技術や考え方が含まれ、機械学習にも決定木や回帰など複数の方法があります。ディープラーニングは有力な選択肢ですが、あらゆるAIが必ずこの方法を使うわけではありません。ニュースや製品説明で「AI搭載」と見かけたときも、すぐにディープラーニングだと決めつけず、何をどう処理している技術なのかを見ると理解しやすくなるでしょう。
AI・機械学習・ディープラーニングの親子関係
用語の関係は、会社の部署よりも、大きな箱の中に小さな箱が入っている様子で考えると分かりやすくなります。最も外側にあるAIは、人の学習、理解、問題解決、意思決定などに関連する働きをコンピューターや機械で実現するための広い分野です。機械学習はその中にあり、データを使って予測や判断を行うモデルを作る方法を指します(出典: IBM)。
Google Cloudの資料では、AIは機械が知覚、推論、行動、適応するための広い概念であり、機械学習はデータから知識を取り出して特定の課題に利用するAIの一分野だと説明されています(出典: Google Cloud)。ここでいう「モデル」とは、学習用データにアルゴリズムを適用した結果として得られる、予測や出力に使う仕組みです。アルゴリズムが学び方の手順なら、モデルはその手順で学んだ結果に近いと考えるとよいでしょう。
| 用語 | 範囲 | 身近な捉え方 |
| --- | --- | --- |
| AI | 人に関連する知的な働きを機械で実現する広い分野 | 全体を覆う大きな箱 |
| 機械学習 | データからパターンを学び予測や判断に使う方法 | AIの箱に入る一つの方法 |
| ディープラーニング | 多層のニューラルネットワークを使う機械学習 | 機械学習の中の一分野 |
| 生成AI | 学んだ表現を基に文章や画像などを生成するモデル | ディープラーニングを土台にした応用 |
この親子関係が分かると、「AIと機械学習のどちらが優れているか」という問いが少し不自然だと気づけます。機械学習はAIと競争する別製品ではなく、AIを実現するために使われる方法の一つだからです。同じように、機械学習とディープラーニングも完全な対立関係ではありません。解きたい課題や扱うデータに応じて、機械学習の中から適した方法が選ばれます。
なお、生成AIもAI全体と同じ意味ではありません。IBMの資料では、生成AIは利用者の依頼で文章、画像、動画、音声などを作るディープラーニングモデルとして整理されています(出典: IBM)。「生成AIを使ったことがあるから、すべてのAIの仕組みを知っている」と考える必要も、「生成AIを使ったことがないから、AIがまったく分からない」と感じる必要もないのです。
「深い」が示すニューラルネットワークの層
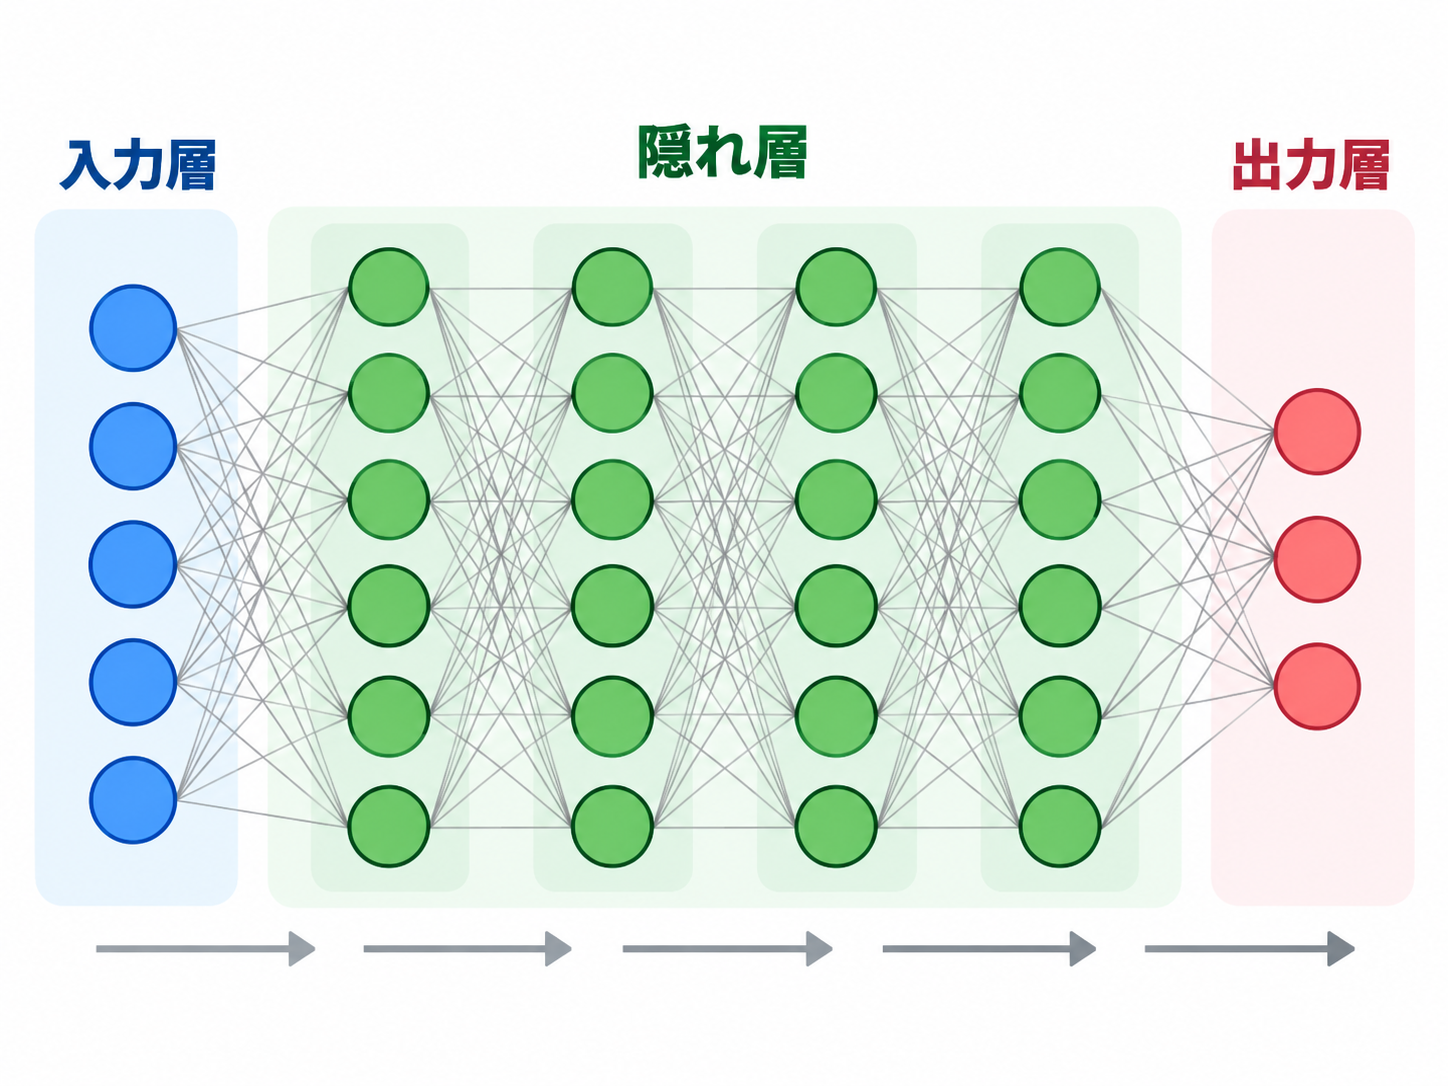
ディープラーニングの「ディープ」は、考えが深い、知識が豊富といった評価を表す言葉ではありません。ニューラルネットワークの層が多いことを指しています。ニューラルネットワークとは、ノードと呼ばれる計算単位を層状につなぎ、入力されたデータを順番に処理する機械学習の方法です。
基本的な構造には、データを受け取る入力層、途中の計算を担う隠れ層、結果を出す出力層があります。IBMの資料では、古典的な機械学習で使われるニューラルネットワークは通常一つか二つの隠れ層を持つのに対し、深層ニューラルネットワークは少なくとも三つ、通常は数百の隠れ層を含むと説明されています(出典: IBM)。層の数は製品や課題によって異なるため、「数百層なら必ず高性能」と単純に判断できる指標ではありません。
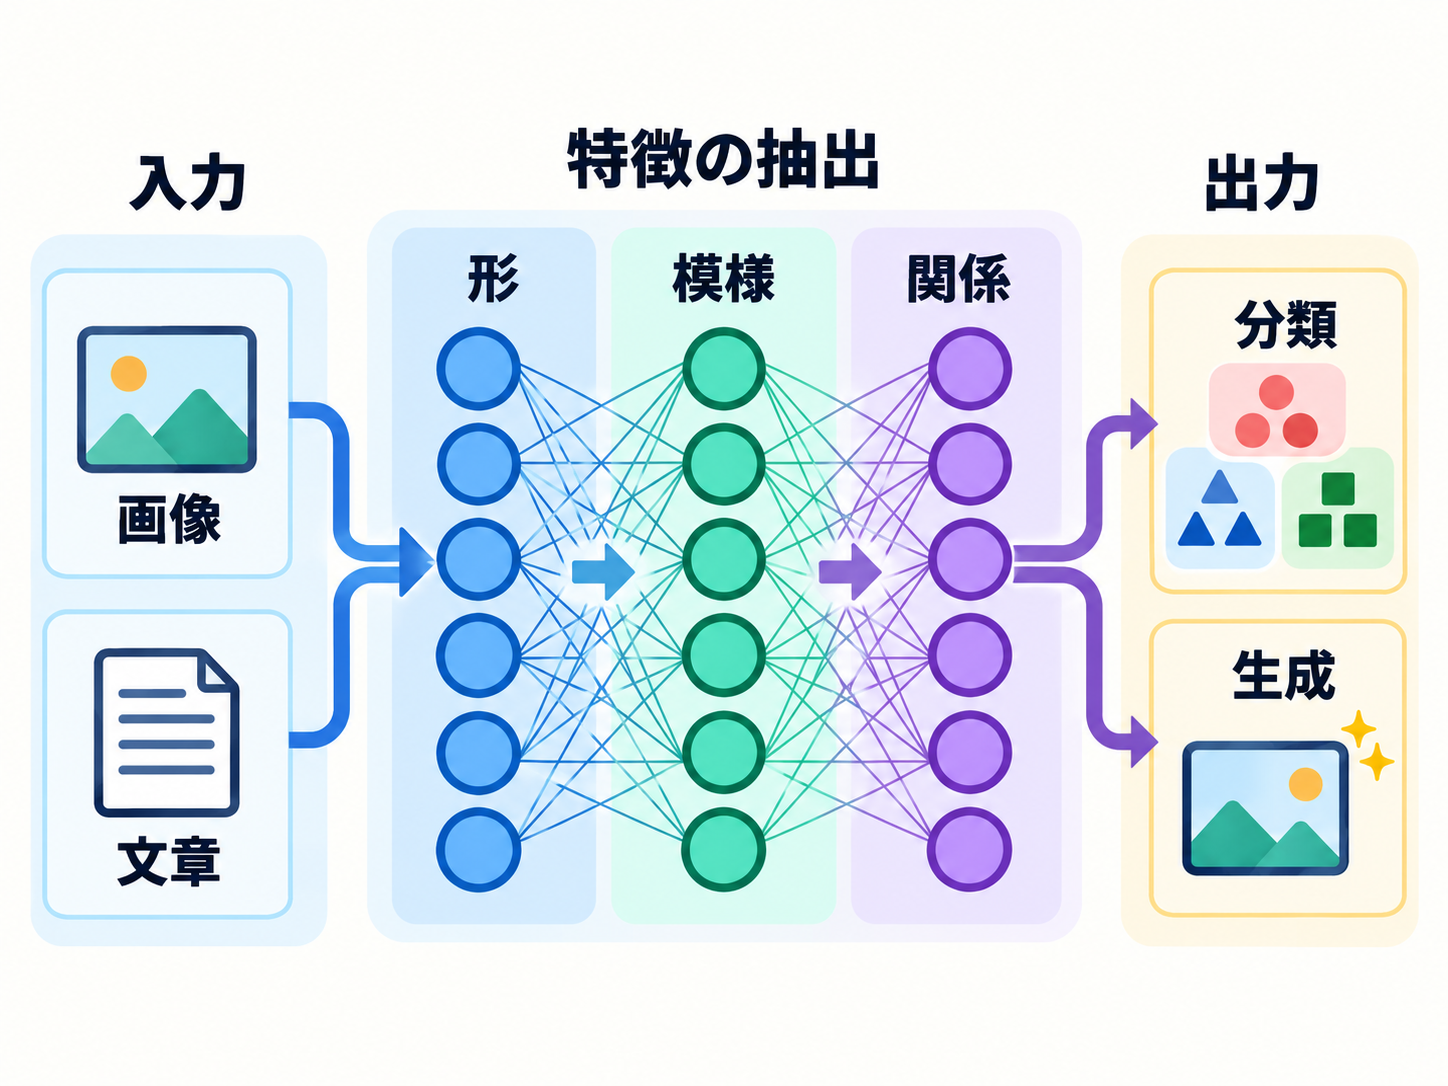
架空の例として、写真が猫か犬かを分類する仕組みを考えてみます。入力層には画像のデータが入り、中間にある複数の層で形、輪郭、模様などに関係する複雑なパターンが段階的に処理され、出力層から分類結果が示される、という流れで捉えられます。ただし、各層が必ず「耳」「目」「尻尾」のように、人が付けた分かりやすい名前を持っているわけではありません。
文章を扱う場合も、層の中に辞書の項目がそのまま保存されている、と考えると実態から離れてしまいます。ディープラーニングは、大量のデータに含まれる要素の関係やパターンを数値的に表現して処理する仕組みです。そのため、出力だけを見て「人と同じ意味で写真を見た」「文章の意味を体験として理解した」と受け取るのは適切ではありません。
深い層は、複雑な関係を扱うための構造です。知識の深さ、人格、意識の程度を示す言葉ではないと覚えておけば、「ディープ」という名前から生じる過大な期待を避けられるでしょう。
人が特徴をすべて書かなくてもパターンを探せる理由
従来型の仕組みを想像すると、「赤色が多ければ夕焼け」「丸い輪郭があればボール」のように、人が判定条件を一つずつ書く姿が浮かぶかもしれません。しかし、現実の画像や文章には多くの例外があります。夕焼けには紫や灰色が混ざることがあり、ボールも見る角度や光の当たり方で形が違って見えます。文章では、同じ言葉でも前後の文脈によって役割が変わるでしょう。
ディープラーニングの特徴は、大量のデータに含まれる複雑な特徴や関係を、多層のニューラルネットワークを通して抽出できる点にあります。IBMの資料では、多層構造によって、大規模でラベルのない非構造化データから特徴を自動的に抽出できると説明されています(出典: IBM)。非構造化データとは、表計算の行と列のように形がそろっていない文章、画像、動画などのデータです。
たとえば、架空の衣料品店が商品写真を種類別に整理するとします。人がすべての服について襟の形、袖の長さ、柄、色の組み合わせを細かな規則に書き起こすのは簡単ではありません。多数の例から関係を捉えられる方法なら、人が特徴を一項目ずつ決める作業を減らせる可能性があります。これは応用のイメージであり、写真を用意すれば必ず正確に分類できるという意味ではありません。
「特徴を自動で抽出できる」という説明も、「人の関与が一切不要」という意味にはしないほうが安全です。IBMの資料には、生成AIの開発者や利用者が出力を評価し、その結果に応じて調整を重ねる工程も示されています(出典: IBM)。何を目的にするか、どのようなデータを使うか、出力をどう評価するかには、人による判断が残ります。
ディープラーニングが得意なのは、規則を手作業で書き切りにくい複雑なパターンを扱うことです。裏返せば、単純な条件だけで処理できる課題に、いつでも大規模な深層ニューラルネットワークが必要とは限りません。「深い技術だから上位」と見るのではなく、課題の複雑さに合っているかを考えることが大切です。
画像認識と文章生成に同じ技術名が登場する背景
写真の分類と文章の生成は、まったく別の作業に見えます。それでも両方の説明にディープラーニングが登場するのは、多層のニューラルネットワークが、大量のデータに含まれる複雑なパターンや関係を扱うのに適しているためです。IBMの資料でも、ディープラーニングは自然言語処理やコンピュータービジョンなどの用途に向くと説明されています(出典: IBM)。自然言語処理は人が使う文章や言葉をコンピューターで扱う技術、コンピュータービジョンは画像や映像を処理する技術です。
生成AIでは、学習データをそのまま一冊の巨大な資料集として保存し、質問のたびに該当箇所をコピーする、と考えると誤解につながります。IBMの資料によると、生成モデルは学習データを簡略化した表現として取り込み、その表現を基に、元のデータと似た特徴を持ちながら同一ではない内容を作ります(出典: IBM)。ここで作られるものは、文章だけでなく、画像、動画、音声などにも及びます。
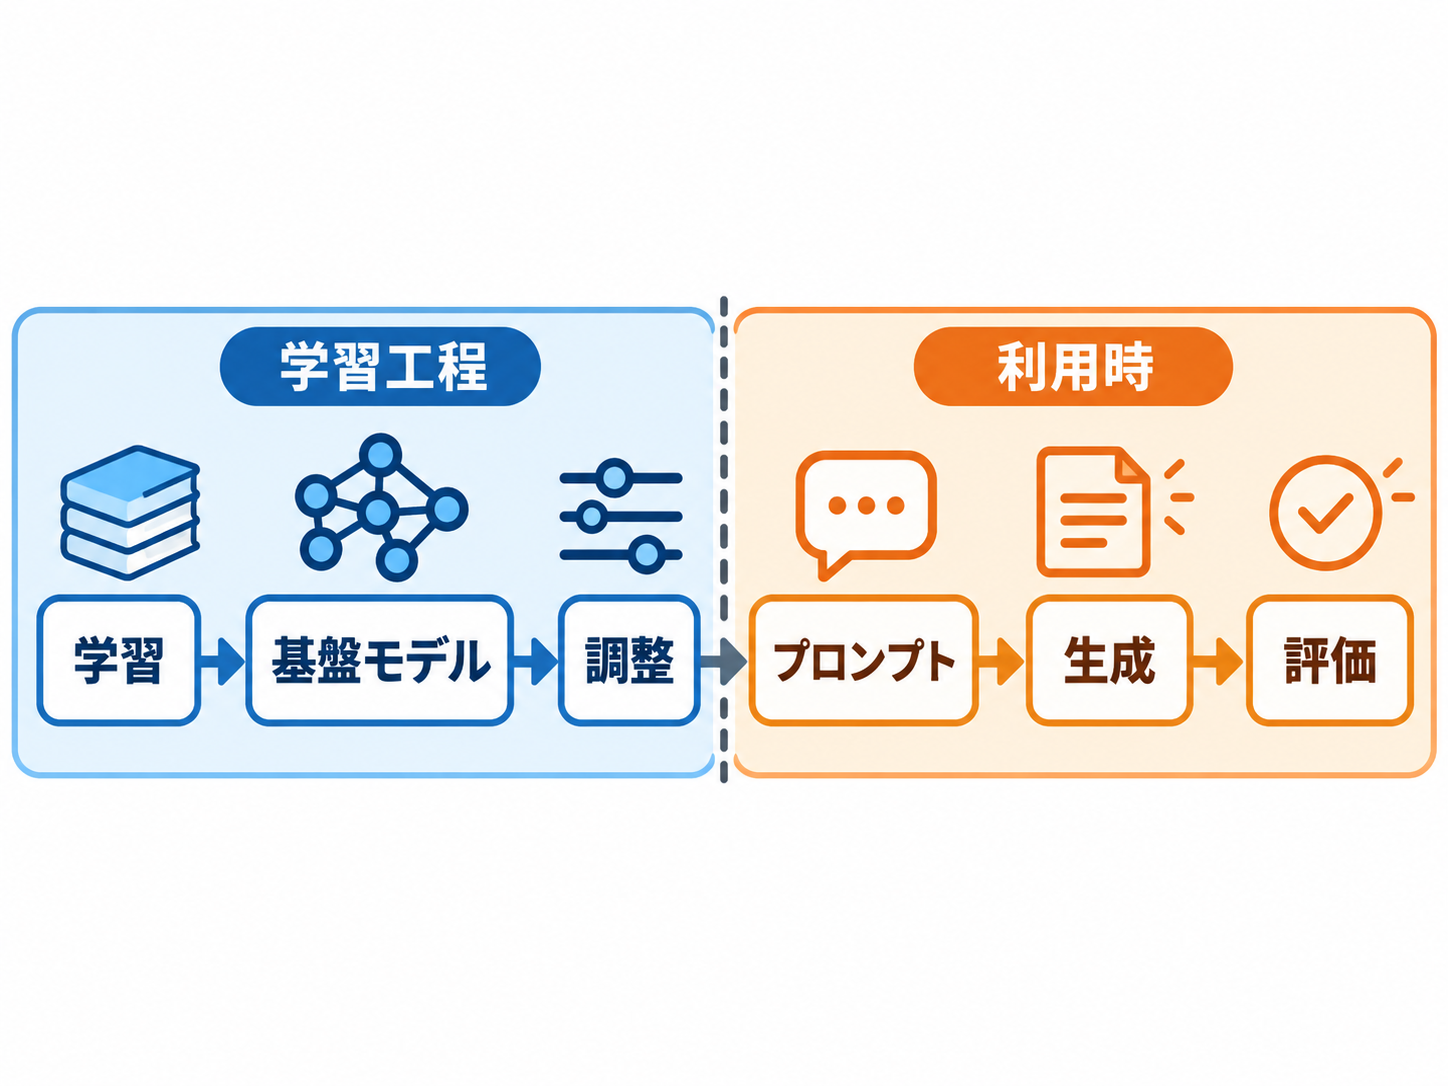
生成AIの基本的な流れは、学習、特定用途への調整、生成と評価という段階に分けて説明されています。最初の学習では、大量のデータから基盤モデルが作られます。基盤モデルとは、さまざまな用途の出発点になる事前学習済みモデルです。その後、特定の目的に合わせた調整を行い、利用時には入力されたプロンプト、つまりAIへの依頼文に応じて内容を生成します(出典: IBM)。
この区別から分かるのは、「AIが回答した瞬間」と「モデルを学習させた工程」は同じではないことです。少なくとも資料で説明されている基本構成は、質問を受けるたびに基盤モデルを一から訓練し直す流れではありません。利用者の依頼は生成の条件になりますが、それだけで大規模な事前学習そのものを再現するわけではないのです。
たとえば、仕組みを確認するためのプロンプトとして、次のような依頼が考えられます。これは利用方法の提案であり、特定製品での動作や回答品質を保証するものではありません。
ディープラーニングと機械学習の関係を、料理教室にたとえて説明してください。たとえと実際の仕組みの違いも最後に示してください。
プロンプトを詳しくすれば説明の形式を指定できますが、生成された内容が自動的に事実になるわけではありません。重要な判断に使う場合は、公式資料などと照らして確認する必要があります。
ニューラルネットワークは人間の脳そのものではない
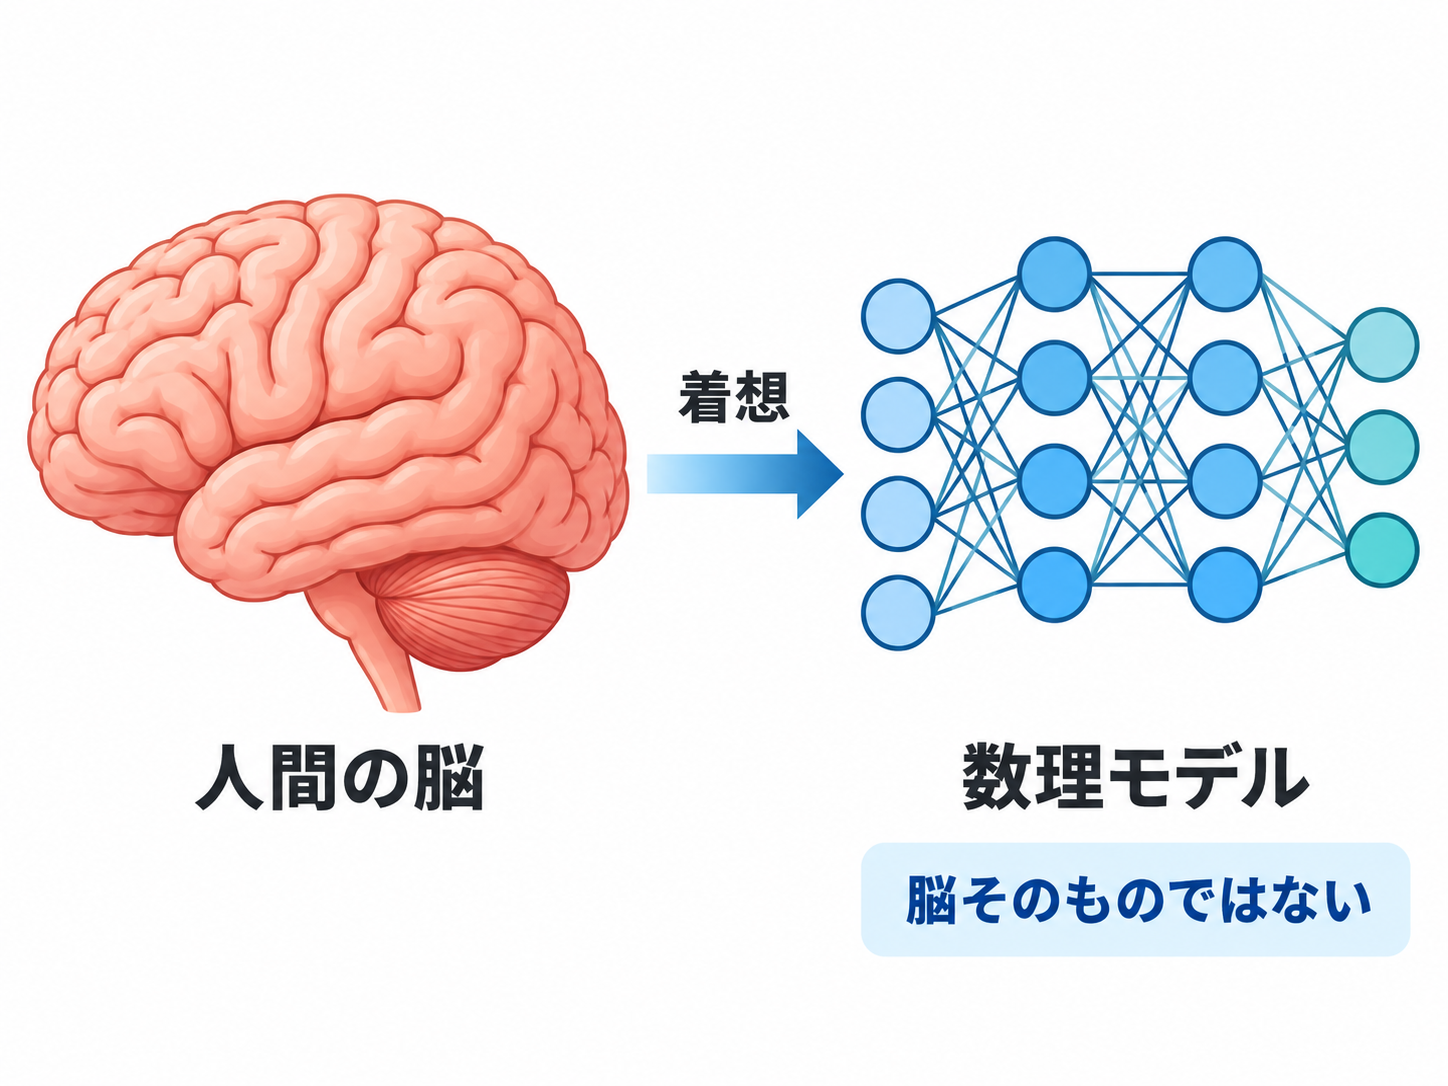
「ニューラル」は神経に関係する言葉なので、コンピューターの中に小さな脳が作られているように感じるかもしれません。IBMの資料では、ニューラルネットワークは人間の脳の構造や機能を参考にモデル化され、相互につながったノードの層でデータを処理するものと説明されています(出典: IBM)。ただし、「参考にした構造」と「人間の脳そのもの」は同じではありません。
飛行機が鳥の飛行から着想を得ていても、羽ばたき方や身体の仕組みまで鳥と同じではないのと似ています。ニューラルネットワークで使われるノードも、生物の神経細胞をそのままコンピューター内に再現したものではなく、計算を行う構成要素として説明されています。脳との比較は仕組みを理解する入口にはなりますが、比較をそのまま実物だと思わないことが大切です。
この違いは、AIの出力を読むときにも役立ちます。自然な文章が返ってくると、AIが内容を人間と同じように理解し、信念を持って話しているように感じることがあります。しかし、参考資料から確認できるのは、多層のネットワークがデータの表現や関係を処理し、入力に応じた出力を作るという技術的な仕組みです。そこから意識や感情の存在まで結論づけることはできません。
また、層が多いことも、人間らしさの尺度ではありません。層の深さは複雑なパターンを処理する構造に関係しますが、出力が必ず正しい、偏りがない、目的に合っているという保証にはならないからです。IBMの資料で生成後の評価や追加調整が独立した工程として扱われていることからも、モデルを作れば確認作業が不要になるわけではないと分かります(出典: IBM)。
AIを擬人化せずに見ることは、冷たく扱うことではありません。できることと確認が必要なことを分け、道具として適切に利用するための見方です。「脳に似た発想を一部に持つ、多層の計算モデル」と捉えると、過小評価にも過大評価にも寄りにくくなるでしょう。
「ディープラーニング採用」を判断材料に変える見方
製品紹介やニュースで「ディープラーニングを採用」と書かれていても、その言葉だけでは利用者にとっての価値は判断できません。技術名は、何を入力し、どのような課題を処理し、何を出力するのかと組み合わせて初めて意味を持ちます。画像を分類する仕組みと文章を生成する仕組みでは、同じディープラーニングを使っていても、目的も確認方法も異なるでしょう。
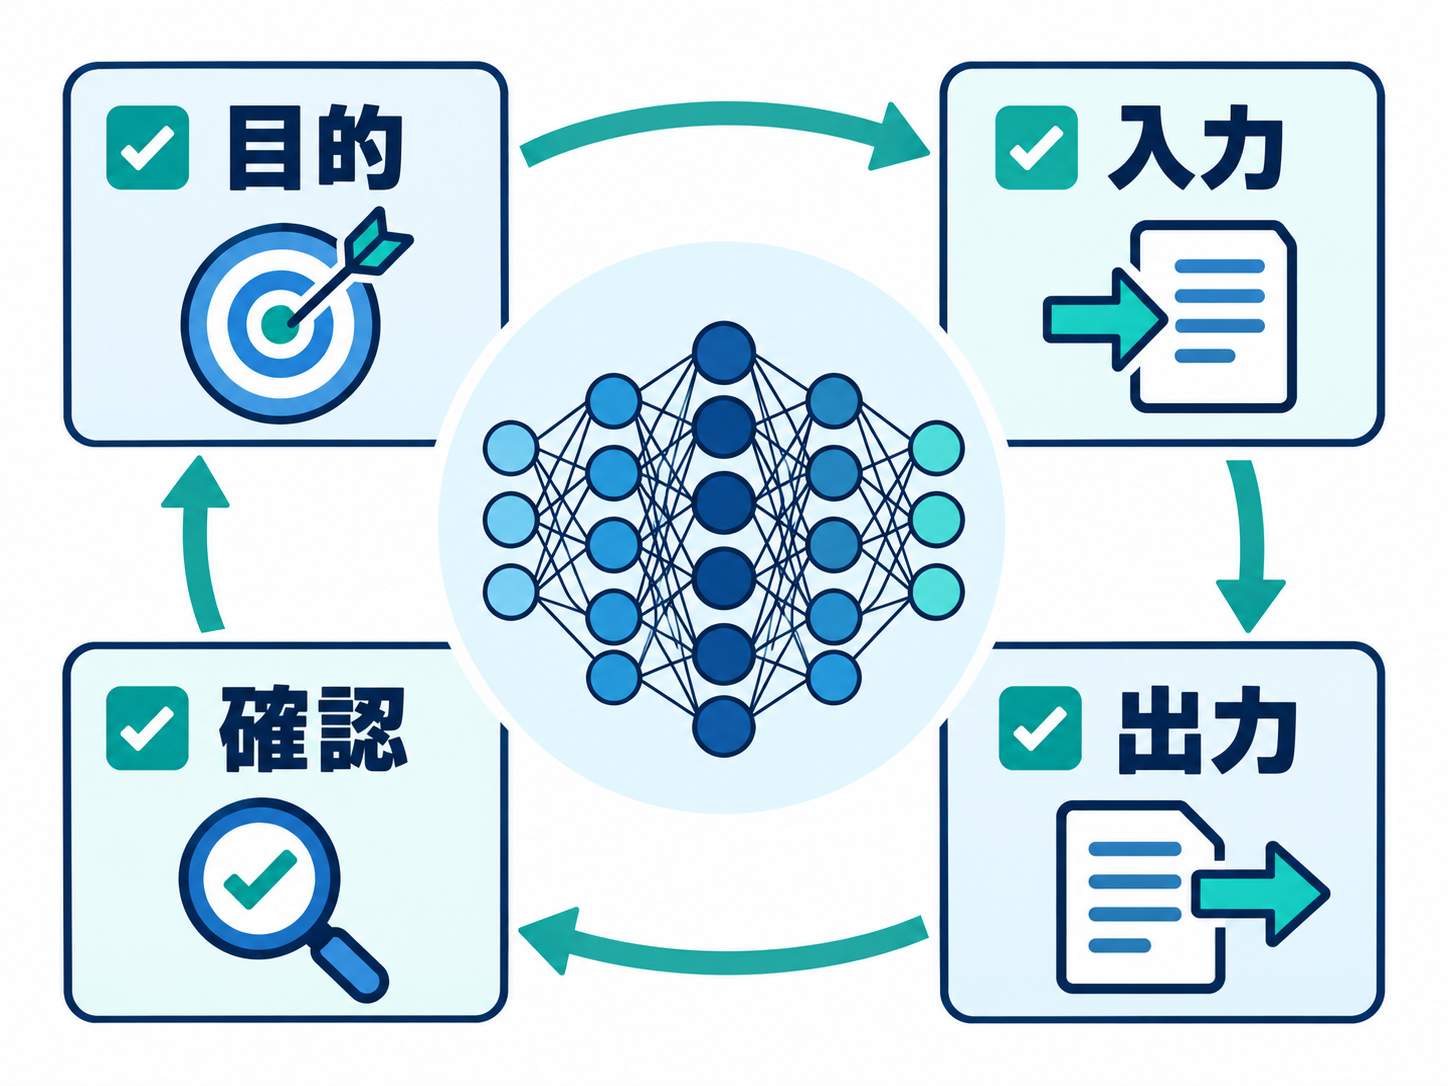
説明を読むときは、次の四点を確認する方法が考えられます。これは特定サービスの仕様ではなく、技術説明を整理するための提案です。
- 何を解決する仕組みなのか
- 文章、画像、数値など、何を入力するのか
- 分類、予測、生成など、何を出力するのか
- 出力の正しさや目的への適合を、誰がどのように確認するのか
たとえば、架空の経費処理サービスが領収書画像を分類するとします。「AIを使用」という説明だけでは、画像から何を読み取り、どの項目を分類し、間違いをどう確認するのかが分かりません。「ディープラーニングを使用」と追加されても同様です。入力、出力、評価方法まで確認できれば、自分の仕事でどこを任せ、どこを人が確認するべきかを具体的に考えられます。
文章生成でも、流ちょうな出力と事実の正しさは分けて扱う必要があります。生成モデルは学習した表現を基に新しい内容を作るため、重要な日付、数値、固有名詞、社内ルールなどは一次資料との照合が欠かせません。これはディープラーニングを避ける理由ではなく、出力の性質に合った使い方を選ぶための手順です。
明日からできる一歩は、普段目にするAIサービスを一つ選び、「AI、機械学習、ディープラーニング、生成AI」のどこに位置するのかを四重の箱で描いてみることです。分からない部分は無理に推測せず、提供元の公式説明を探します。そのうえで入力、出力、確認方法を書き足せば、技術名に圧倒されず、自分に必要な仕組みかどうかを判断しやすくなるでしょう。
参考情報
- What Is Artificial Intelligence (AI)?(IBM、2024年8月9日公開、2026年10月2日更新、2026年10月30日取得)
- AI vs. Machine Learning: How Do They Differ?(Google Cloud、公開日記載なし、2026年10月30日取得)