
2026/10/30
今更聞けないAI知識
AIの「モデル」とは何か――アプリとの違いをエンジンのたとえでつかむ
同じAIアプリでも「モデル」が違うとはどういうことか
AIを使っていると、サービス名とは別に「モデル」という言葉を見かけることがあります。アプリの名前だけでも覚えにくいのに、別の名前が出てくれば、「いったい何が違うのですか」と戸惑うのは自然なことです。
一言で答えると、AIのモデルとは、学習によって作られた、入力から予測や回答を生み出す仕組みです。対してアプリは、その仕組みを利用者が使える形に整えたサービス全体を指します。Google Cloudは、人工知能を機械やコンピューターに認識、推論、行動などの能力を持たせる広い分野として説明しており、モデルはその分野で使われる構成要素の一つと捉えられます(出典: Google Cloud)。
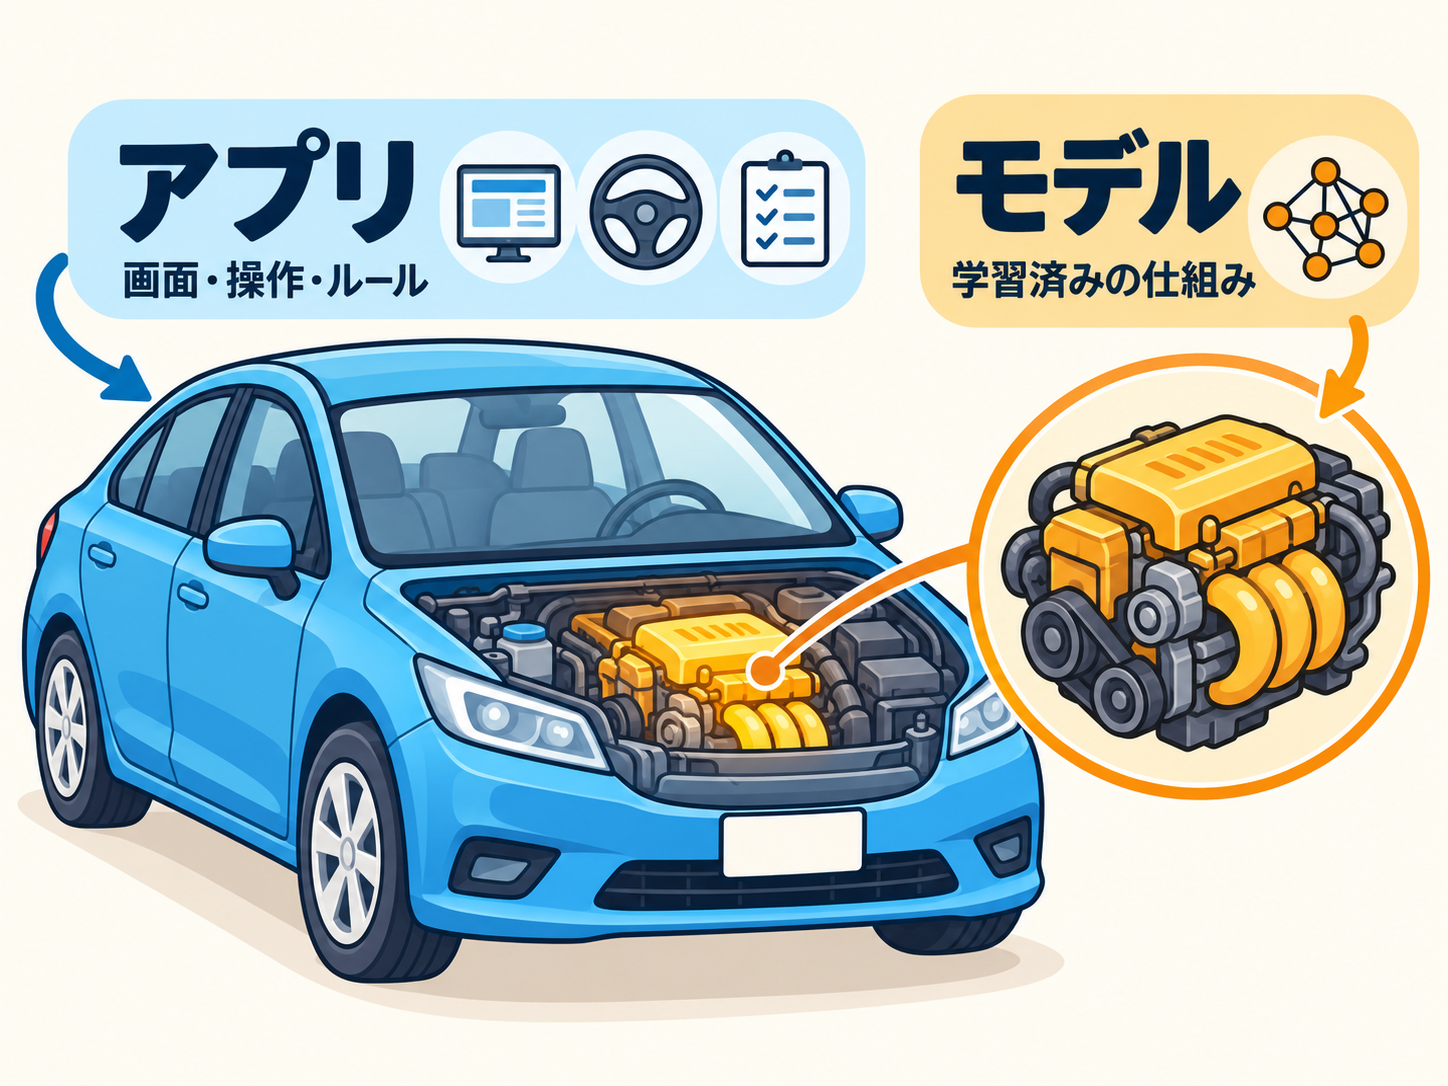
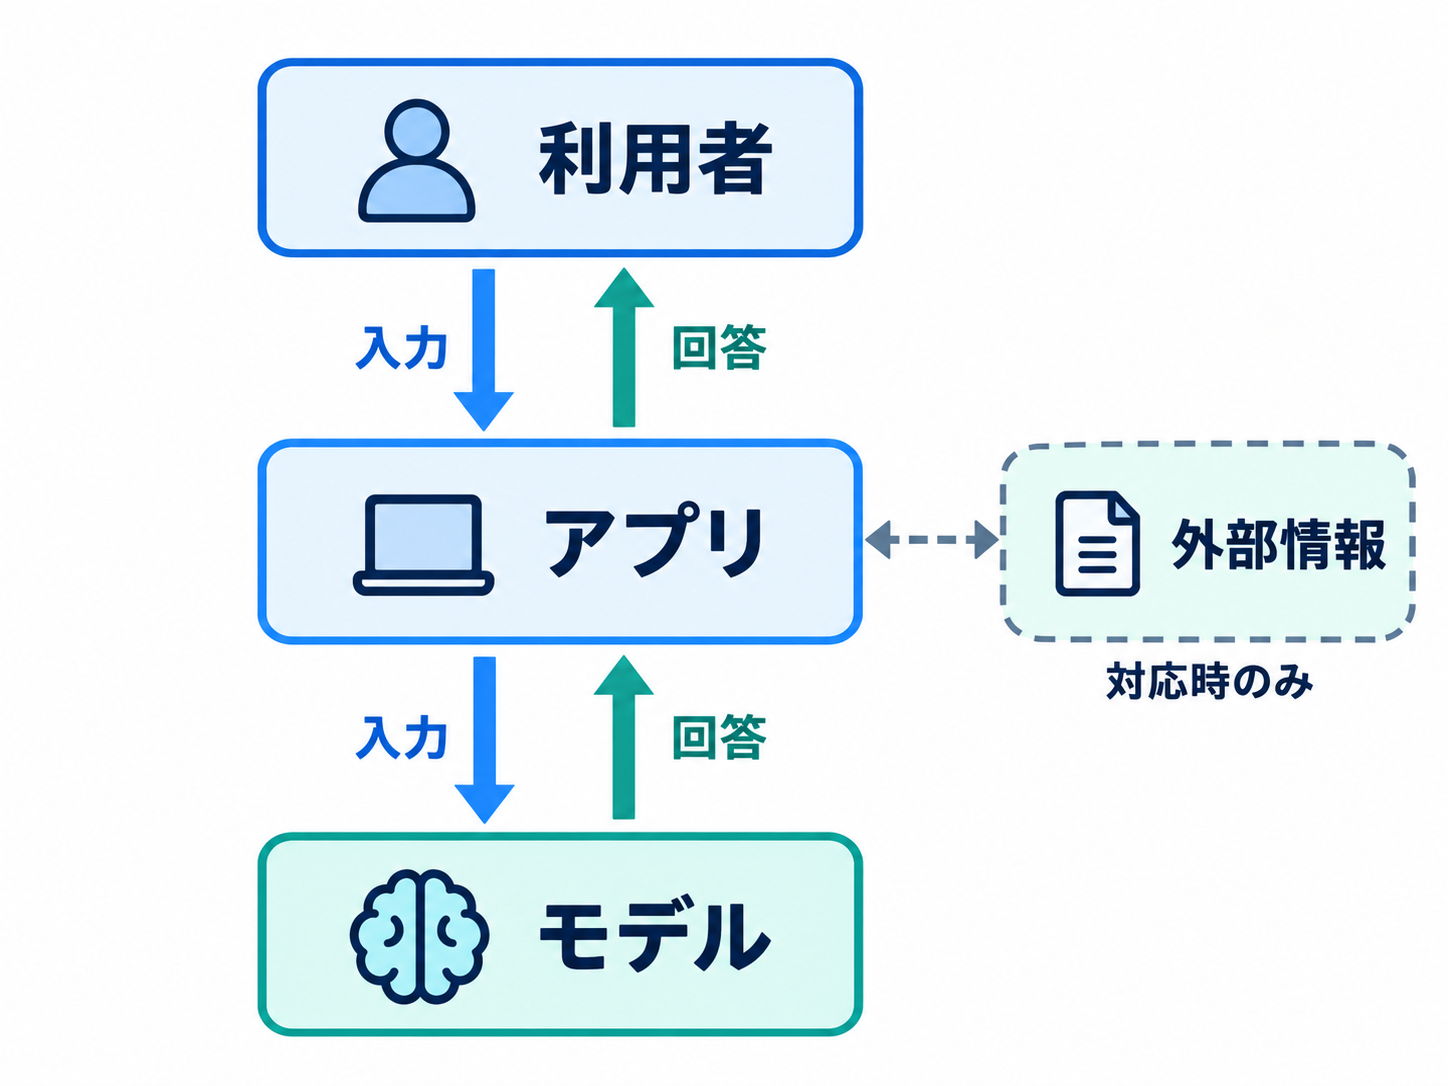
身近なたとえなら、アプリは車全体、モデルはエンジンに近い存在です。運転席、ハンドル、ブレーキ、座席などを含めて一台の車が成り立つように、AIアプリも入力画面、回答の表示方法、利用上のルール、必要に応じた外部情報との連携などを組み合わせて作られます。エンジンだけでは車として利用できず、車体の見た目だけでは走り方を判断できません。同じように、モデル名だけを見ても、実際の使いやすさや提供機能のすべては分からないのです。
この区別を知っておくと、「有名なモデルだから、このアプリも必ず自分に合うはずです」と早合点しにくくなります。反対に、アプリの回答が期待と違ったときも、原因をモデルだけに決めつけず、入力の仕方、アプリ側の設定、参照している情報、目的との相性を分けて考えられるでしょう。モデルはAIサービスの中核になり得ますが、サービス全体と同じものではありません。
モデルが「学習で作られた仕組み」と呼ばれる理由
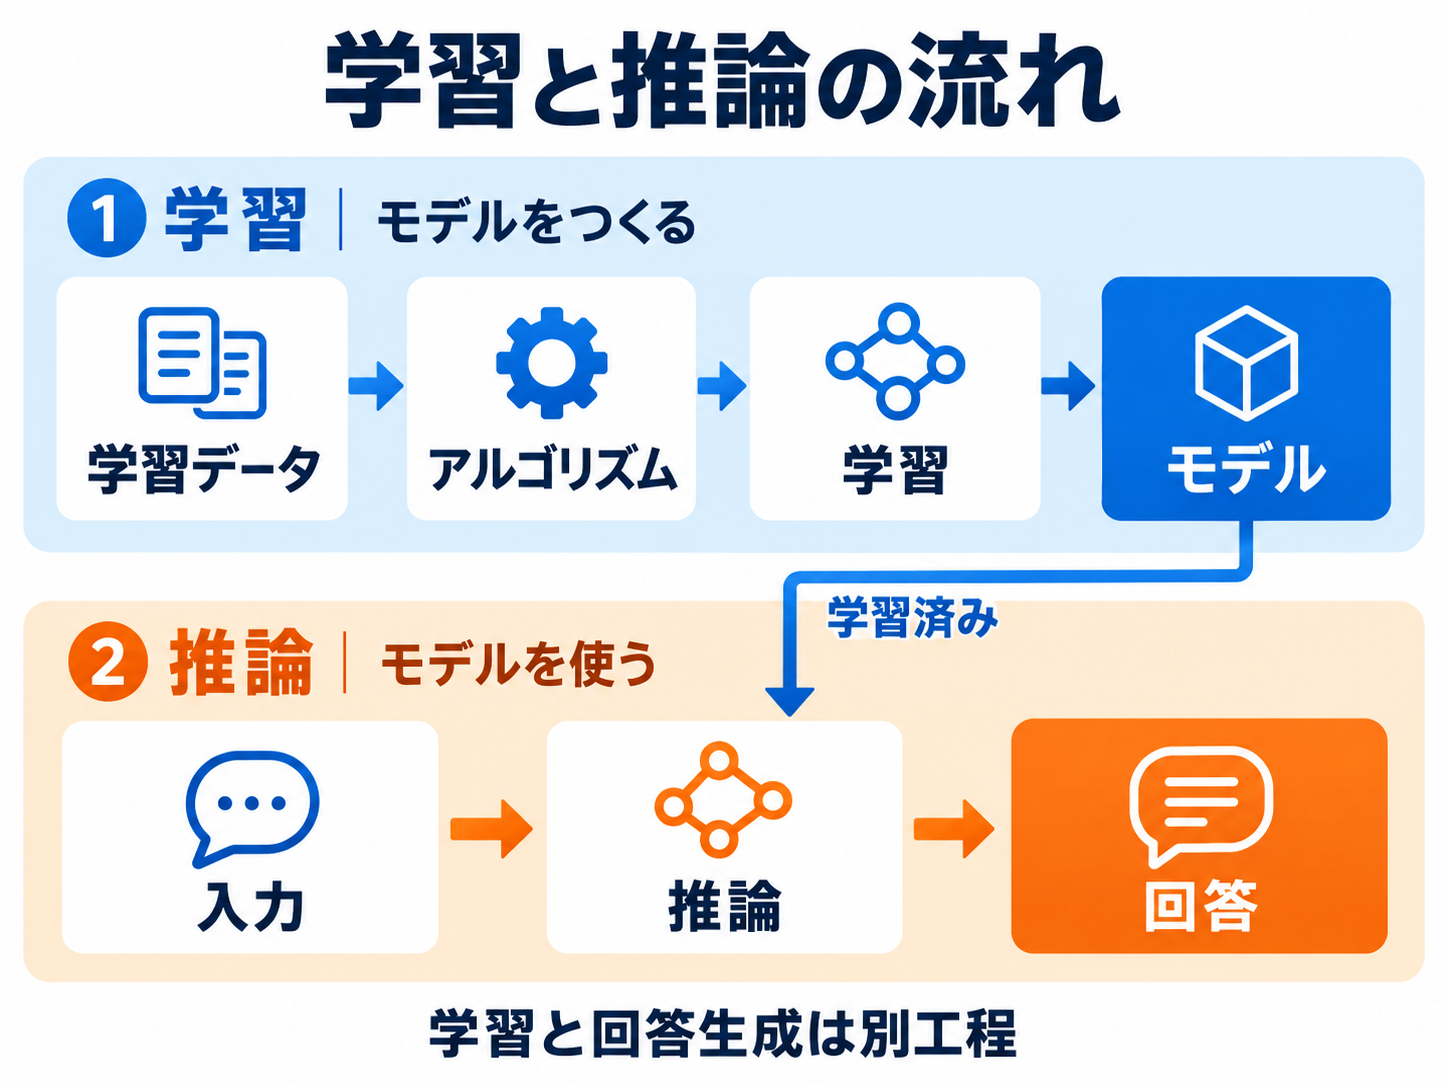
機械学習は、人工知能の中に含まれる方法の一つです。大量のデータを分析するアルゴリズム、つまり処理の手順を学習用データに適用し、そこから得られた結果が機械学習モデルになります。Google Cloudも、機械学習モデルを、訓練データに対してアルゴリズムを動かした結果としてプログラムが学んだものと説明しています(出典: Google Cloud)。
ここでいう学習は、人が教科書を読み、意味を理解して成長する過程と同じではありません。入力と出力の間にあるパターンや関係を、数値の調整としてモデルに反映する処理です。その調整値は「パラメータ」と呼ばれます。たとえば、過去のデータから分類を行うモデルなら、どの特徴がどの分類結果と結び付きやすいかを学習時に調整します。文章を生成するモデルでは、文章などのデータに含まれるパターンや関係を表現し、入力された指示に応じて出力を組み立てます。
学習済みのモデルに新しい入力を渡し、予測や回答を生成させる段階は「推論」と呼ばれます。Google for Developersでは、大規模言語モデルにおける推論を、訓練済みモデルが入力されたプロンプトに対して回答を生成する過程と定義しています(出典: Google for Developers)。「学習」はモデルを作ったり調整したりする工程であり、「回答」は完成したモデルを使う工程です。この二つを分けると、AIが質問のたびにゼロから勉強し直しているわけではないことが見えてきます。
会話中に前の発言を踏まえた回答が返る場合も、直ちにモデルそのものが再学習されたとは限りません。会話の履歴が後続の回答に使われる文脈になることは、Google for Developersの用語集でも説明されています(出典: Google for Developers)。会話内の情報を一時的な文脈として使うことと、モデルのパラメータを訓練によって更新することは別の処理です。利用した内容が将来の学習に扱われるかどうかは、個別サービスの説明や利用条件を確認する必要があります。
モデルとアプリを分けると回答の違いが見えてくる
一つのモデルが複数のアプリで使われる場合もあれば、一つのアプリが用途に応じて異なるモデルを使い分ける場合もあります。そのため、モデルとアプリを一対一の関係だと思い込むと、回答の違いを説明しにくくなります。違いを整理すると、次のようになります。
| 見る対象 | モデル | アプリ |
| --- | --- | --- |
| 主な役割 | 入力から予測や回答を生み出す | 利用者とモデルをつなぎサービスとして提供する |
| 車のたとえ | 学習済みのエンジン | 操作部分や安全装備を含む車全体 |
| 違いが表れやすい点 | 対応する入力や得意な処理 | 画面、利用ルール、情報の渡し方、提供機能 |
| 確認するときの視点 | 目的の作業に合うか | 必要な使い方を安全に行えるか |
同じモデルを使うアプリ同士でも、結果が完全に同じになるとは限りません。モデルに渡される指示、会話の文脈、特定用途への調整、外部情報を利用する仕組みなどが異なる可能性があるためです。IBMは、生成AIのモデルを特定用途に適応させる方法として微調整を挙げています。また、学習データの外にある関連情報を使う方法として、検索拡張生成を紹介しています(出典: IBM)。ただし、すべてのアプリがこうした仕組みを備えているという意味ではありません。実際の提供条件は、それぞれの公式説明で確かめる必要があります。
一つのアプリ内でモデルを使い分ける考え方もあります。Google for Developersの用語集では、要求の複雑さに応じて適切なモデルを選ぶ「モデルカスケード」と、その選択を行う「モデルルーター」が説明されています(出典: Google for Developers)。利用者が手動で選ぶとは限らず、システム側が処理を振り分ける場合もあるという考え方です。
回答に不満があるときは、「モデルの能力が低い」と即断する前に、どこで違いが生じたのかを切り分けるとよいでしょう。モデルが扱える内容の問題なのか、アプリが渡した情報の不足なのか、それとも質問の条件が曖昧だったのかで、見直す場所は変わります。この視点は、特定の製品名を覚えるよりも長く使える判断材料になります。
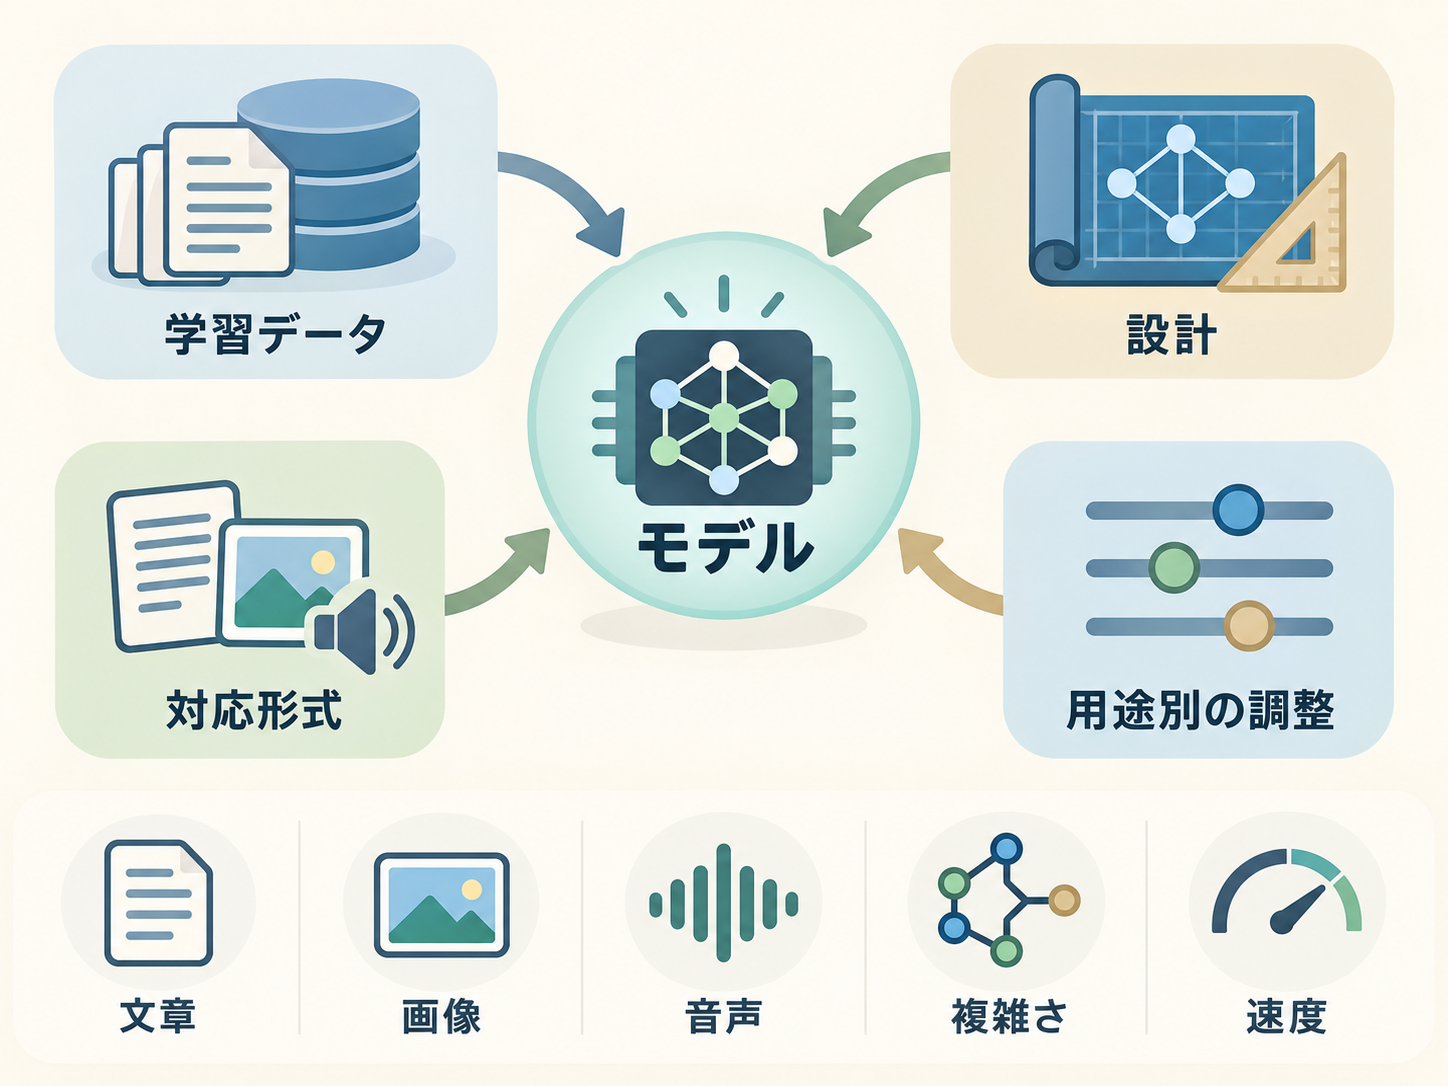
モデルごとに得意分野が異なる仕組み
モデルの得意分野は、単なる性格の違いではありません。学習に使われたデータ、モデルの設計、対応するデータの種類、学習後に行われた調整などが関係します。IBMによれば、生成AIには文章を扱う大規模言語モデルだけでなく、画像、動画、音声、音楽を対象とする基盤モデルや、複数種類の内容を扱うマルチモーダルな基盤モデルもあります(出典: IBM)。文章向けのモデルに画像の内容を尋ねても、画像入力に対応していなければ目的を果たせません。
「基盤モデル」は、多様なデータで事前訓練され、さまざまな用途の土台になる大規模なモデルです。そこから特定の仕事に合わせて微調整することで、用途に応じたモデルが作られます。IBMは生成AIの大まかな工程を、基盤モデルを作る訓練、用途に適応させる調整、生成結果の評価と追加調整という段階で説明しています(出典: IBM)。土台が同じでも、その後の調整やアプリでの使われ方が違えば、得意な作業や回答の形式が変わり得るわけです。
大きなモデルほど、あらゆる場面で無条件に優れているとも限りません。Google for Developersでは、大規模なモデルは小規模なモデルより多くの計算資源を使う一方、より複雑な要求を扱える傾向があるとして、簡単な要求には小さなモデル、複雑な要求には大きなモデルを割り当てる考え方を説明しています(出典: Google for Developers)。また、回答までの待ち時間には、入力と出力の長さ、モデルの複雑さ、実行基盤などが影響するとされています(出典: Google for Developers)。大きさだけでは、正確さ、速度、用途への適合性を一度に判断できません。
たとえば、架空の選定例として、短い案内文を整える作業と、複数の条件を照合して長い下書きを作る作業では、重視する点が異なります。前者なら応答の手軽さや指示した形式への合わせやすさ、後者なら条件の読み落としや根拠の扱いを確認したくなるでしょう。画像を含む作業なら、その入力形式に対応しているかも確認対象です。「どのモデルが一番ですか」ではなく、「この仕事では何を失敗してほしくないですか」と問い直すと、得意分野を実用的に見極められます。
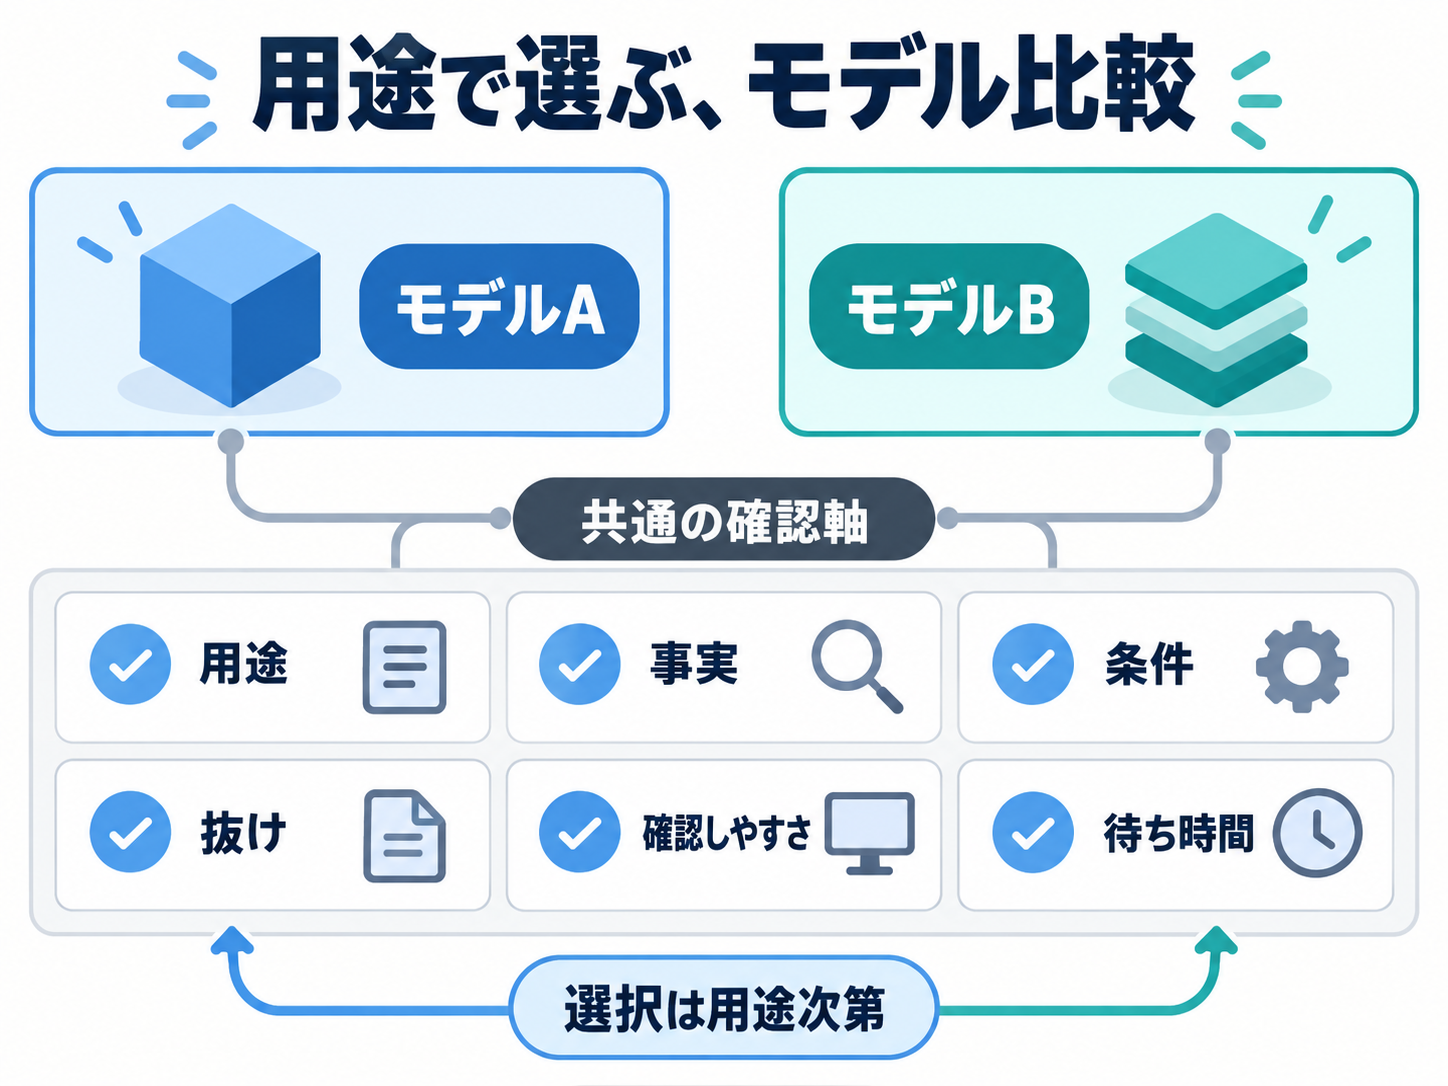
名前や大きさに頼らずモデルを比べる方法
モデル名には、製品群、世代、用途、提供側の位置付けなどを示す語が含まれる場合があります。しかし、名前の印象だけで、自分の仕事における使いやすさまでは判断できません。大きい、小さい、新しいといった一つの軸で順位を決めるより、実際に行いたい作業を基準に比べるほうが現実的です。
比較では、正解が一つの課題と、複数の妥当な回答がある課題を分ける必要があります。Google for Developersの用語集では、正しい回答が一つだけの問いと、複数の正しい回答があり得る問いが区別されています。また、モデルの品質を比べる評価には、正確さだけでなく品質や安全性を含む広い確認が必要だと説明されています(出典: Google for Developers)。計算問題と文章の要約を、同じ物差しだけで採点できないのと似ています。
初心者が試せる方法として、自分用の小さな「確認問題集」を作る案があります。これは特定モデルの性能を保証する試験ではなく、用途との相性を見るための提案です。個人情報や機密情報を含めず、普段行いそうな作業を三つほど選びます。架空の例なら、「箇条書きから丁寧な案内文を作る」「短い文章の要点を三つに整理する」「示した資料だけを根拠に質問へ答える」といった課題です。各モデルやアプリへ、同じ条件と同じ入力を渡します。
見る項目は、事実の誤り、条件の読み落とし、不要な付け足し、文章の分かりやすさ、回答を確認しやすいかどうかです。待ち時間が業務上重要なら、それも観察項目にできますが、一度の結果だけで一般的な速度を断定しないほうがよいでしょう。入力の長さや実行環境などでも変化し得るからです。モデルを評価するとは、世間の順位をそのまま受け入れることではなく、自分の用途に合う基準を先に決め、その基準で結果を見ることです。
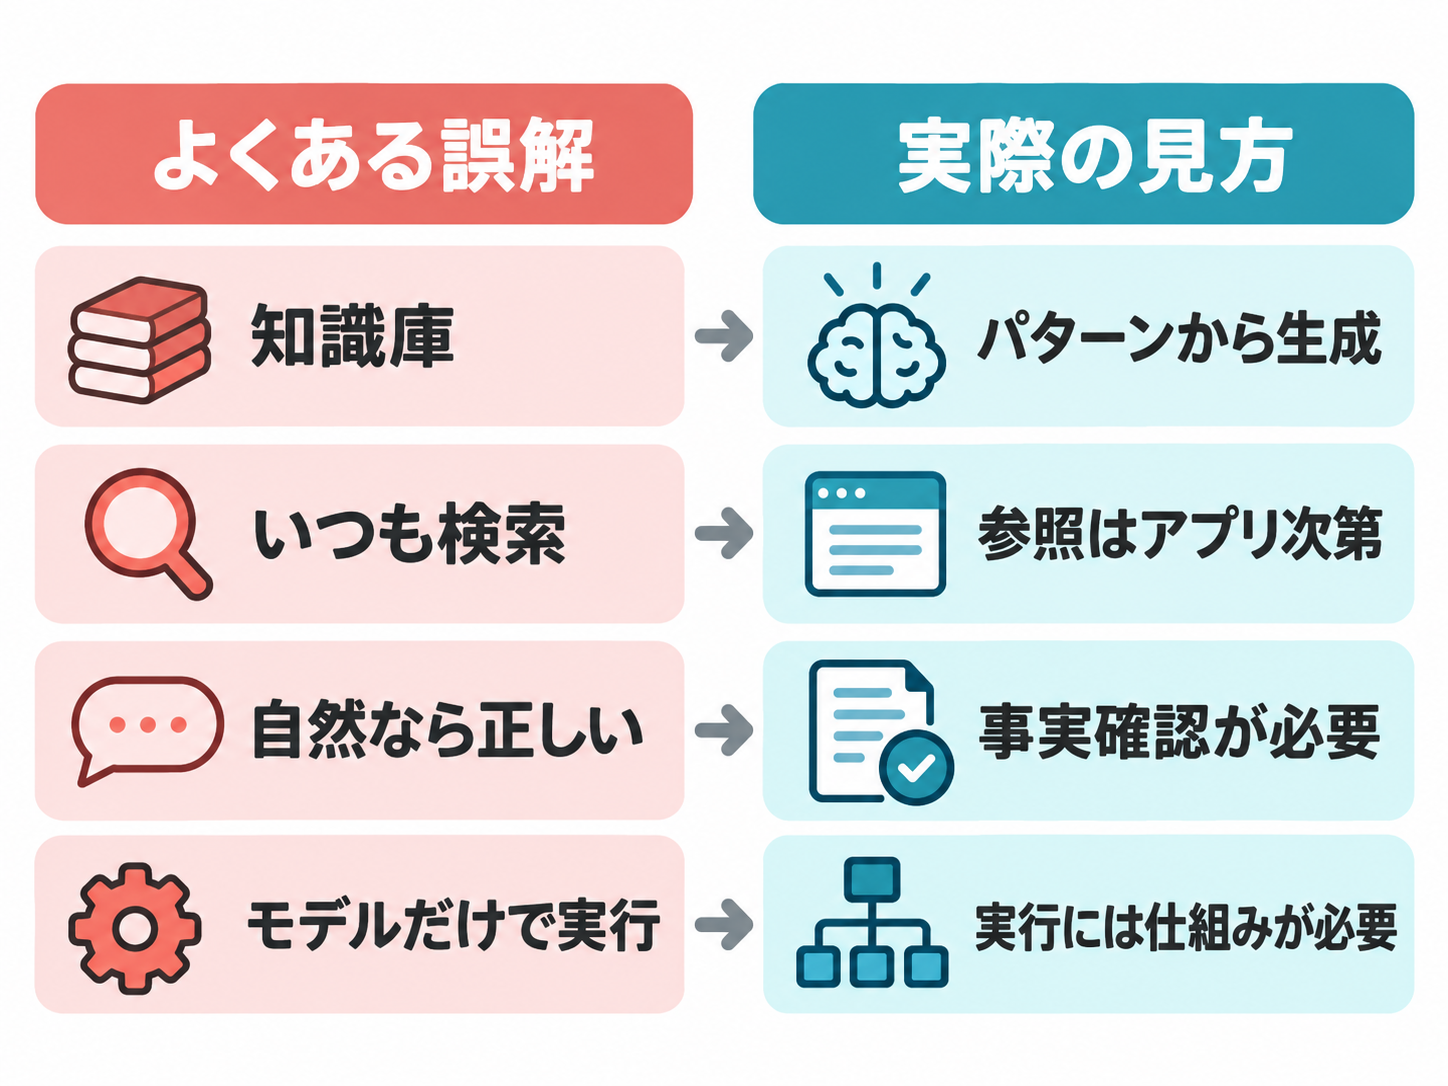
「モデルなら何でも知っている」という誤解
生成AIのモデルは、学習資料をそのまま収めた検索用の書庫とは限りません。IBMは、生成モデルが訓練データの簡略化された表現を符号化し、その表現から元と似ているものの同一ではない新しい内容を作ると説明しています(出典: IBM)。したがって、回答中に具体的な名称や数字が滑らかに書かれていても、元資料の該当箇所を取り出して見せているとは限りません。
検索との違いもここにあります。検索は関連する情報源を探すことが中心ですが、生成モデルは入力に応じた文章などを生成します。アプリによっては、外部の関連資料を取り込み、回答に利用する検索拡張生成のような仕組みを組み合わせる場合があります(出典: IBM)。ただし、「AIに聞きました」という事実だけでは、外部情報を検索したのか、どの資料を参照したのかは分かりません。出典表示や参照範囲の有無を、アプリごとに確認する必要があります。
文章が自然なら正しいという見方にも注意が必要です。Google for Developersは「ハルシネーション」を、生成AIモデルがもっともらしいものの事実に反する内容を、現実についての記述として出力することと定義しています(出典: Google for Developers)。言葉遣いの滑らかさと、事実の裏付けは別の評価項目です。日付、金額、人物名、規則、引用など、間違いの影響が大きい情報は、元資料で確認する姿勢が欠かせません。
モデルとAIエージェントも同じではありません。Google for Developersでは、エージェントを、利用者の入力を基に推論し、利用者に代わって行動を計画・実行するソフトウェアと説明しています(出典: Google for Developers)。IBMも、生成AIモデルが内容を作ることに重点を置くのに対し、エージェントは生成内容や外部ツールを使って作業を進めるものとして区別しています(出典: IBM)。モデルは回答を生み出す中核になり得ますが、それだけで外部サービスを操作したり、仕事の完了を保証したりするわけではありません。
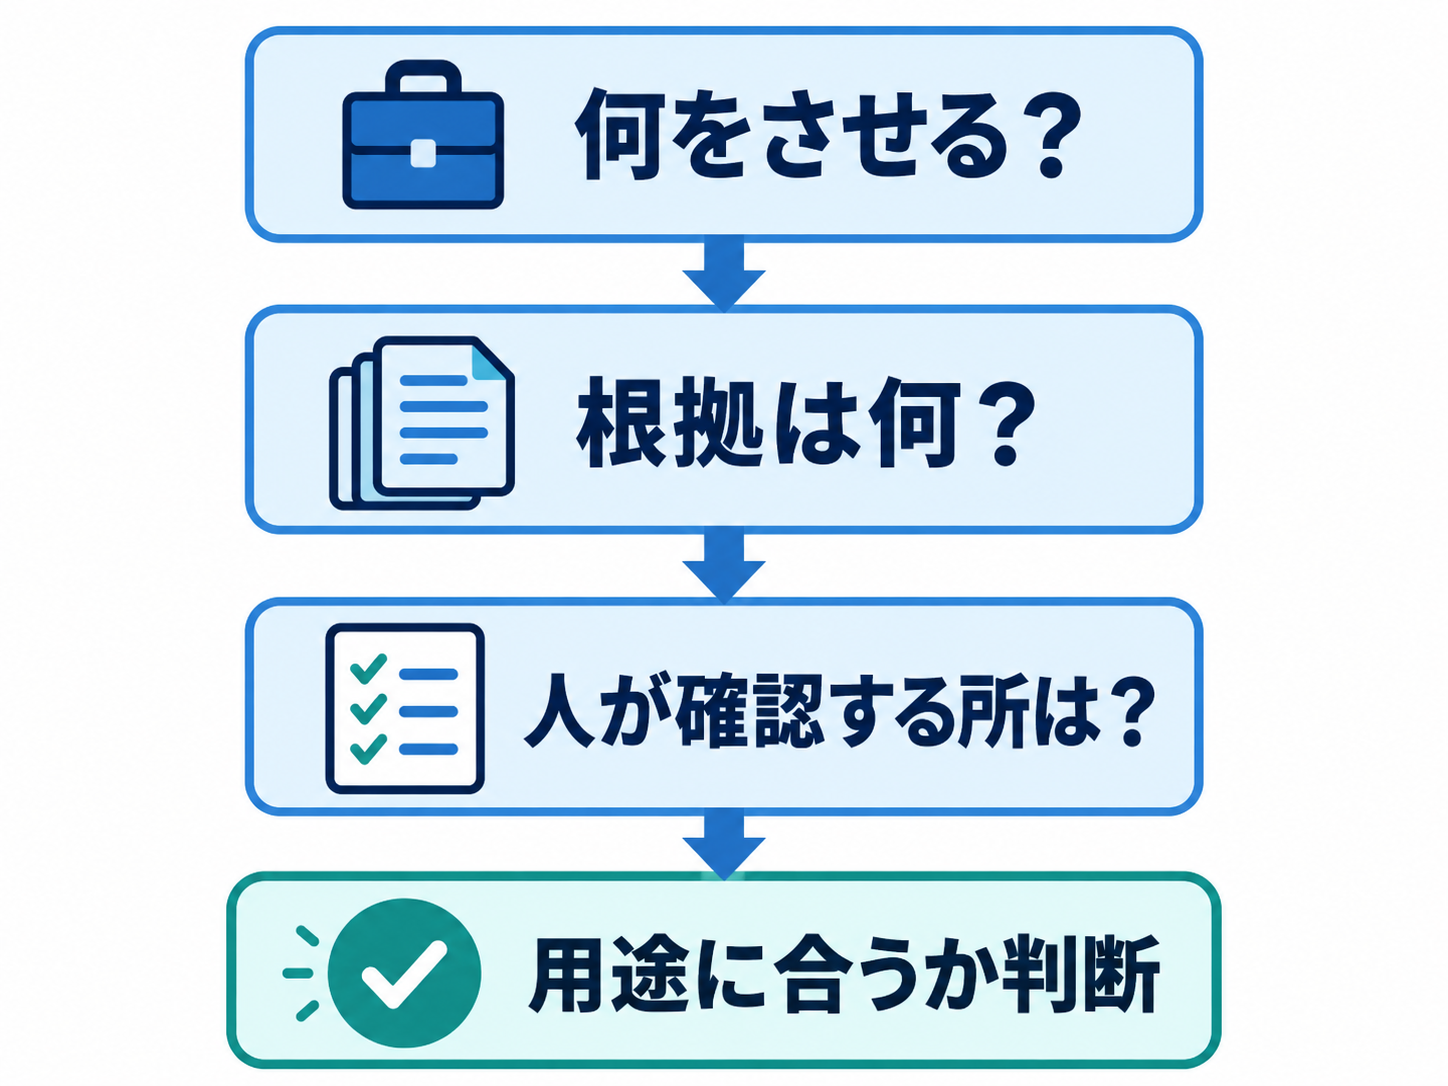
明日から使える「モデルを見る三つの問い」
モデルという言葉を見たときは、名称を暗記する代わりに、「何をさせたいですか」「何を根拠に答えますか」「どの部分を人が確認しますか」という三つの問いを置いてみてください。この順番なら、知名度やモデルの大きさより先に、自分の目的と失敗時の影響を考えられます。
「何をさせたいですか」では、文章作成、分類、要約、画像の扱いなど、作業を具体的にします。「何を根拠に答えますか」では、入力した資料だけを使うのか、外部情報を参照できるのか、根拠を確認できるのかを見ます。「どの部分を人が確認しますか」では、固有名詞、数値、公開前の文章、重要な判断など、誤りをそのまま通せない箇所を決めておくとよいでしょう。
小さく試すなら、明日行う予定の作業から、機密情報を含まない一件を選ぶ方法があります。これは活用案であり、特定の効果を保証するものではありません。たとえば、架空の会議メモを用意し、「決定事項と未決事項を分け、書かれていない内容は補わないでください」と依頼します。結果を読み、条件どおりに分けられたか、メモにない情報を加えていないか、元の文と照合しやすいかを確認します。複数モデルを選べる環境なら同じ入力で比較し、選べない場合でも、回答を評価する練習にはなります。
AIのモデルとは、簡潔に言えば、学習によって作られた入力と出力の仕組みです。アプリそのものでも、検索結果の一覧でも、必ず正しい答えを持つ知識庫でもありません。この前提があれば、モデル名が増えても慌てず、用途、根拠、確認方法の順に判断できます。次にAIを使うときは、回答を出させる前に「この作業で最も困る間違いは何ですか」を一つ書き出してみてください。その答えが、モデルやアプリを見るための最初の評価基準になります。
参考情報
- What Is Artificial Intelligence (AI)? — IBM、2024年8月9日公開、2026年10月2日更新、2026年10月30日取得
- AI vs. Machine Learning: How Do They Differ? — Google Cloud、2026年10月30日取得
- 機器學習詞彙表:生成式 AI — Google for Developers、2026年10月30日取得