
2026/10/27
GPT-6.1 Terraで見えた、企業向け生成AIモデル選定の新しい基準
「最も賢いモデル」を選ぶだけでは決まらない理由
生成AIの導入担当者がモデル一覧を前にしたとき、最初に知りたくなるのは「結局、どれが最も高性能なのか」という答えです。ところが、OpenAIのテッド・サンダース氏によれば、モデルの性能は一つの順位にまとめられるものではありません。数学に強いモデルが、必ずしもユーモアのある文章を上手に作れるとは限らないからです。企業での利用に置き換えると、プログラム生成で優れた結果を出すモデルが、顧客向けメールや画像解析でも同じように優秀とは限りません。それでも、多くの性能差を説明するうえで、モデルの「大きさ」は有力な目安になります。一般に大規模なモデルほど幅広い課題へ対応しやすく、高い品質を期待できます。ただし、大きさだけで判断すると、用途に対して過剰な費用を支払ったり、特定業務に強い小型モデルを見落としたりする可能性があります。
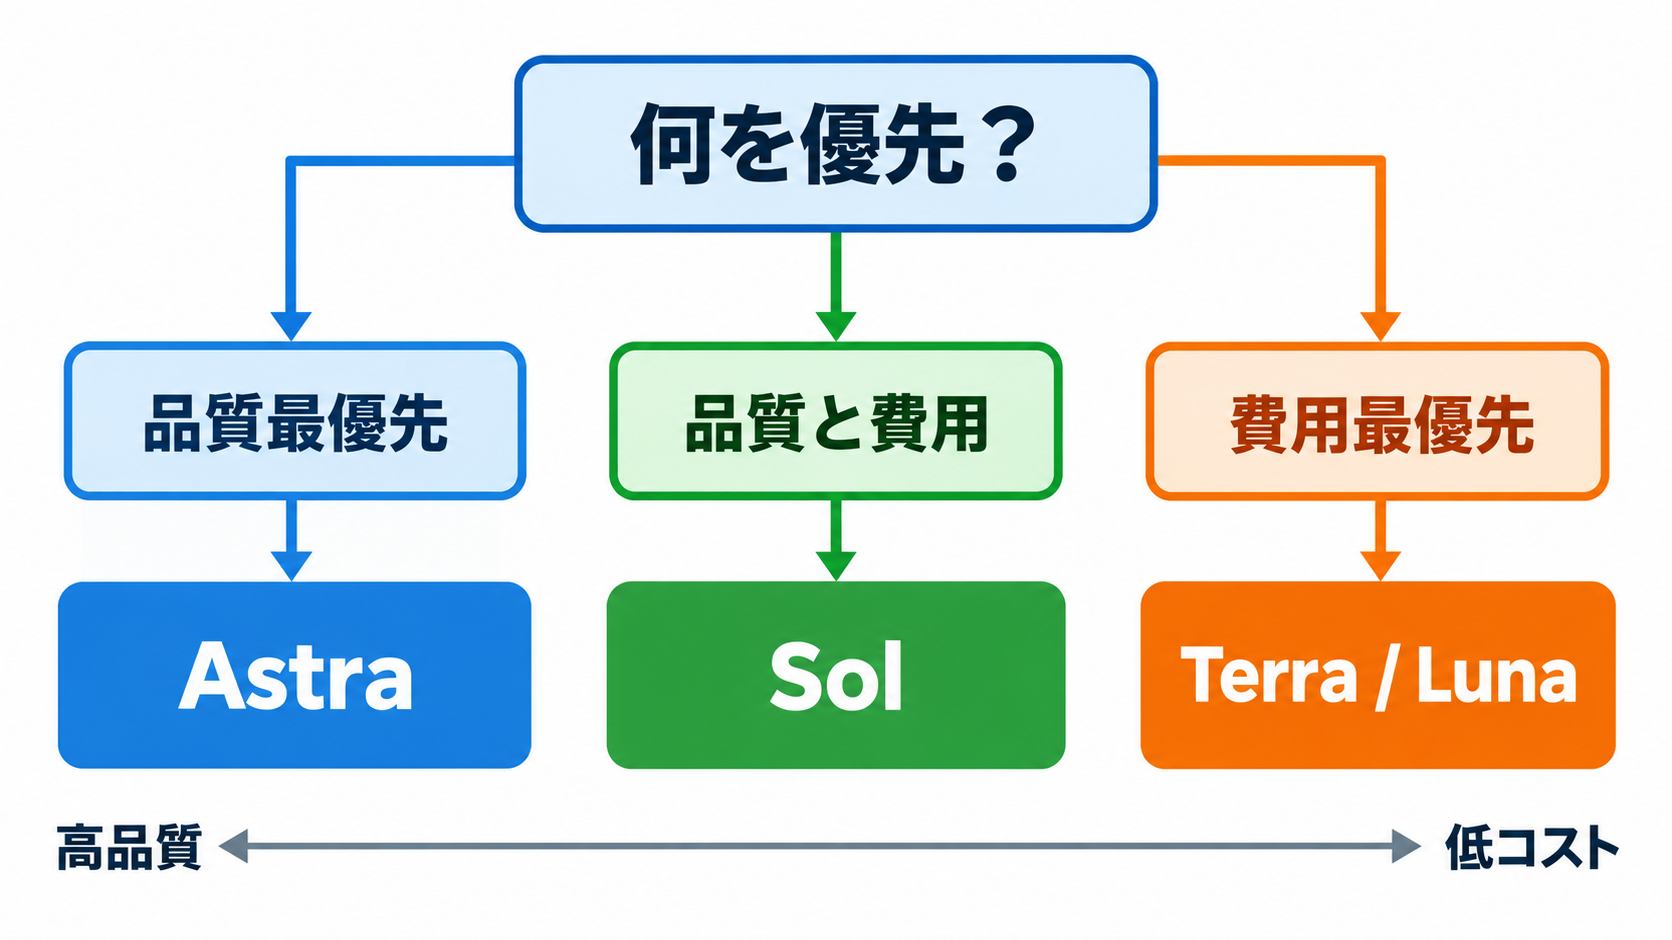
サンダース氏が示した選び方の中心にあるのは、絶対的な順位ではなく、求める品質と価格感度の組み合わせです。品質だけを重視するならAstra、ある程度コストも意識するならSol、価格を強く抑えたいならTerraまたはLunaという整理になります。これは全モデルを同じ尺度で競わせるランキングではなく、自社がどの程度の品質を必要とし、どこまで費用を許容できるかを明確にするための判断軸です。
モデル選定を製品名の比較から始めると、議論は「上位か下位か」に偏りがちです。実務では、処理させる業務、その業務で許容できない失敗、必要な品質、利用量に応じた費用を先に定義するほうが合理的でしょう。GPT-6.1 Terraの位置づけは、生成AIの調達が単純な最高性能競争ではなくなっていることを示しています。
モデル名だけでは読み取れない三つの性能軸
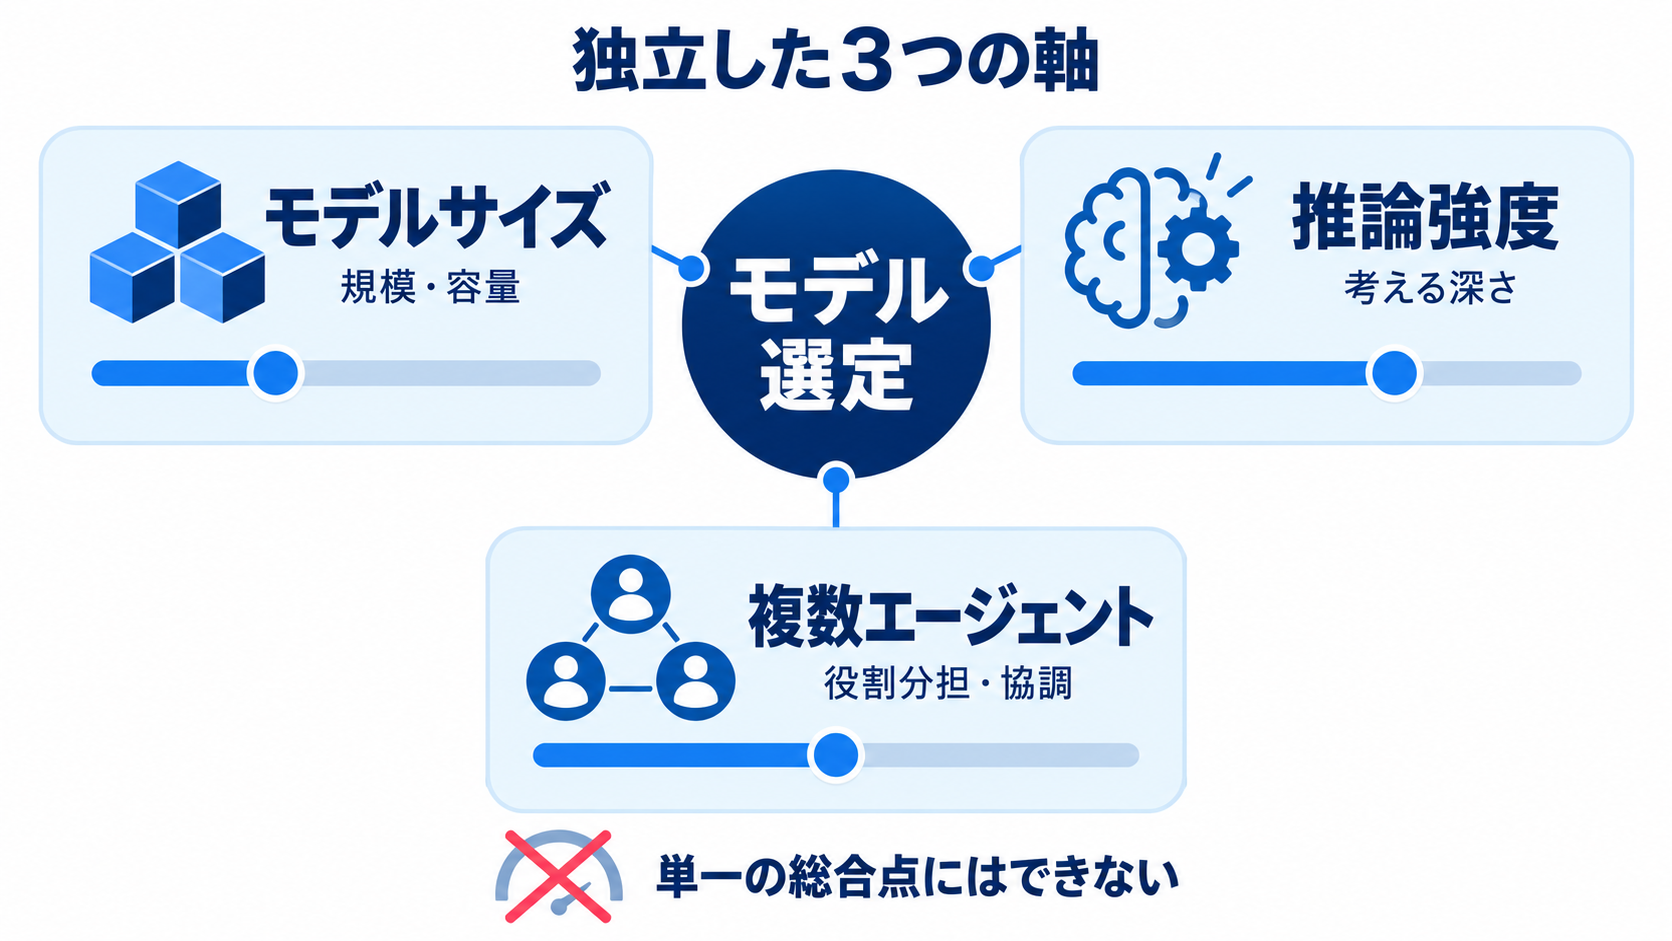
OpenAIのモデル体系を分かりにくくしている理由として、サンダース氏はモデルサイズ、推論の強度、マルチエージェントシステムを別々の次元として挙げています。これらを一つの「IQスコア」のような数字へまとめれば比較は簡単に見えますが、どこに強みがあり、どの条件で費用が増えるのかが見えなくなってしまいます。モデルサイズは、幅広い知識や複雑なパターンを扱う能力と関係する大まかな尺度です。ただし、公開されている名称から内部構成を正確に推測できるとは限りません。企業の担当者にとって重要なのは、サイズが性能差を説明する有力な要素であっても、個々の業務結果を保証する指標ではないという点です。
推論の強度は、回答を作る際にどの程度の計算や検討を行わせるかという軸として理解できます。同じモデルでも、単純な分類と複雑な分析では必要な処理が異なります。品質を上げるために推論を厚くすれば、費用や応答時間とのバランスを考える必要も出てくるでしょう。
マルチエージェントシステムは、役割を分けた複数のAIエージェントを連携させ、調査、作成、検証などを進める構成です。単体モデルの能力と、複数のモデルやエージェントを組み合わせた仕組みの能力は同じではありません。たとえば、一度の回答品質だけを比べる評価では、相互確認による精度向上や、処理回数の増加によるコストを適切に表現できません。
モデル名を一本の序列として読むのではなく、この三つの軸を分けて捉える必要があります。名称は選定の入口にはなりますが、業務適合性を示す仕様書そのものではありません。企業側には、各軸が自社のワークフローにどう影響するかを確認する作業が求められます。
小型の新モデルが大型の旧モデルを上回る仕組み
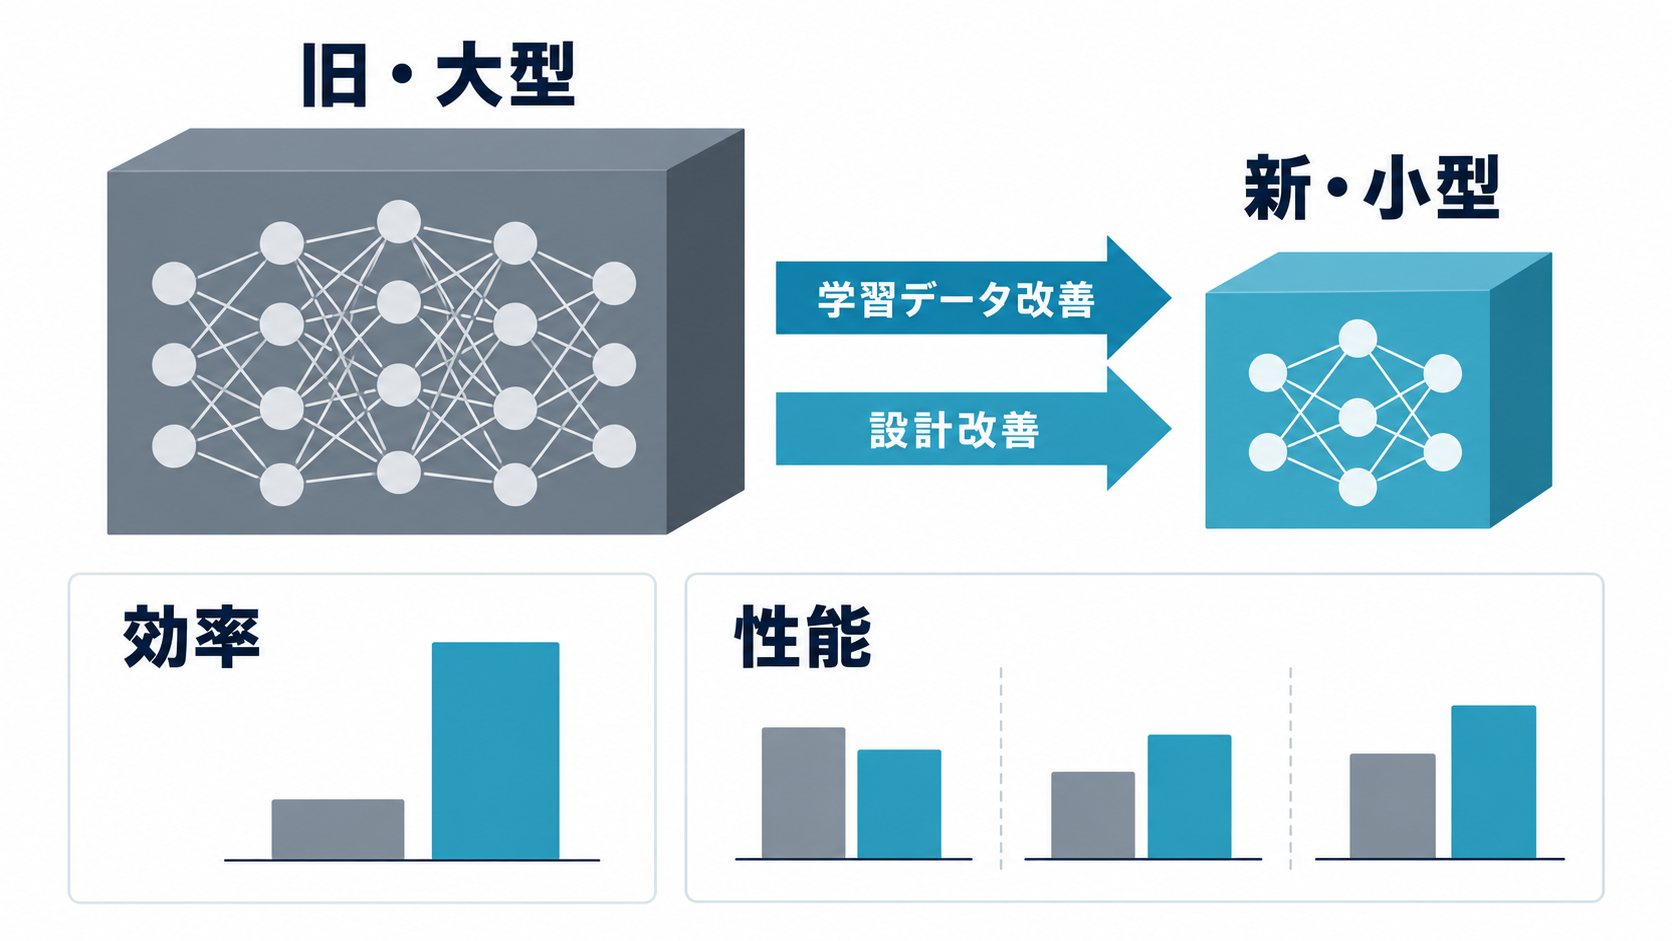
モデルが大きいほど常に優れている、という理解にも注意が必要です。サンダース氏は、学習データの改善やアーキテクチャの進歩によって、新しい小型モデルが古い大型モデルを上回る場合があると説明しています。ここでいうアーキテクチャとは、AIが情報を処理し、学習結果を回答へ反映するための設計を指します。自動車の性能を排気量だけで比べられないのと同じように、生成AIも規模だけでは実際の効率や得意分野を判断できません。学習に使う情報の質、学習方法、モデル内部の設計が改善されれば、より小さな構成でも特定の課題を効率よく処理できます。その結果、世代の異なるモデルを単純にサイズ順へ並べても、実務上の優劣と一致しないケースが生まれます。
この性質は、企業の調達サイクルにも影響します。一度選んだ大型モデルを長期間の標準として固定すると、新しい小型モデルが提供する費用対効果を取り逃がすかもしれません。反対に、新製品であることだけを理由に全面移行すれば、既存業務で必要としていた能力が不足するおそれがあります。新旧と大小を別々の観点として評価し、同じ業務データと採点基準で比較することが欠かせません。
小型モデルの強みは、単に安価であることではありません。限定された目的に十分な品質を保ちながら、利用量を拡大しやすい点にあります。社内文書の分類、定型的な情報抽出、下書き作成など、最高水準の汎用能力を毎回必要としない処理もあるでしょう。そのような業務では、高価なモデルを一律に使うより、必要な品質を満たす小型モデルへ振り分ける設計が現実的です。
大切なのは、「小型だから低性能」「大型だから高品質」という固定観念を避けることです。モデルの世代、対象業務、必要な推論、運用コストを合わせて見ることで、サイズという分かりやすい指標を適切な位置づけで利用できます。
GPT-6.1 Terraが示す得意分野と限界
GPT-6.1 Terraは、価格を抑えながら一部の技術的な用途で高い能力を狙うモデルとして位置づけられています。サンダース氏の見立てでは、Terraはより大きなAstraよりも技術コミュニケーションに優れる可能性があります。技術コミュニケーションとは、技術的な内容を整理し、開発者や利用者が理解できる形で説明する用途などを含む概念です。画像処理とコンピューター操作についても、TerraはAstraとおおむね同程度の水準に達するとされています。コンピューター操作は、画面や操作対象を認識しながら、ソフトウェア上の作業を進める能力を指します。画像の理解や画面操作を含む業務を検討している企業にとって、より低い価格帯で上位モデルに近い結果が得られるなら、比較対象に含める理由になります。
ただし、TerraがAstraの全面的な代替になるわけではありません。サンダース氏は、その他の多くの領域ではTerraがAstraに及ばないとしています。どの領域でどの程度の差があるかについては、今回確認できる情報だけでは細部まで示されていません。そのため、「技術用途に強い」という説明を、あらゆる専門業務でAstraを上回るという意味に広げるべきではありません。
企業で検証する際は、技術文書の要約、コードに関する説明、画像を含む問い合わせ、画面操作など、Terraの強みが期待される業務を独立した試験項目にするとよいでしょう。それとは別に、判断の難しい文章作成、幅広い知識を要する分析、失敗時の影響が大きい処理も評価し、弱点が業務上の問題になるかを確かめる必要があります。
Terraの価値は、Astraとの勝敗だけでは測れません。限定された業務で必要な品質を満たし、費用を抑えられるなら、その役割には適しています。適用範囲を明確にしないまま全社共通モデルとして採用すると、得意分野の価格優位と、不得意分野の品質低下が混ざり、正しい評価が難しくなるでしょう。
Astra・Sol・Terra・Lunaを選び分ける判断基準
サンダース氏の目安は簡潔です。品質だけを重視する場合はAstra、価格もある程度考慮する場合はSol、価格への感度が高い場合はTerraまたはLunaを選ぶというものです。この分類は、細かなベンチマークを読む前に候補を絞るための出発点として利用できます。選択の目安を企業利用に置き換えると、次のように整理できます。
- Astraは、品質低下による損失が大きく、モデル利用料より回答品質を優先する業務の候補になります。
- Solは、十分な品質を確保しながら費用も管理したい業務の候補になります。
- Terraは、価格を強く意識しつつ、技術コミュニケーション、画像処理、コンピューター操作との適合性を検証したい場合の候補になります。
- Lunaは、価格感度が特に高い処理で、必要水準を満たせるか試す候補になります。
この目安だけで採用モデルを確定するのは早計です。同じ企業内でも、経営判断の補助、顧客向け文章、社内検索、データ整理では、誤りが生じたときの影響が異なります。全社で一つのモデルを選ぶ発想よりも、業務のリスクと品質要件に応じて複数モデルを使い分ける設計が適する場合もあります。
費用を比べる際には、単価だけでなく、期待した結果を得るまでの再実行や人による修正も考慮する必要があります。低価格のモデルで回答の作り直しが増えれば、表面的な利用料が安くても、業務全体では効率が落ちるかもしれません。反対に、定型処理へ最高品質のモデルを投入しても、品質差が業務成果へ反映されなければ過剰投資になります。
モデル選定の問いは「どれが最強か」ではなく、「この処理に必要な品質を、どの費用で安定して得られるか」です。Astra、Sol、Terra、Lunaという選択肢は、その問いに対して品質優先度と価格感度を明文化するための共通言語として使えるでしょう。
日本企業が導入前に行いたい業務別評価
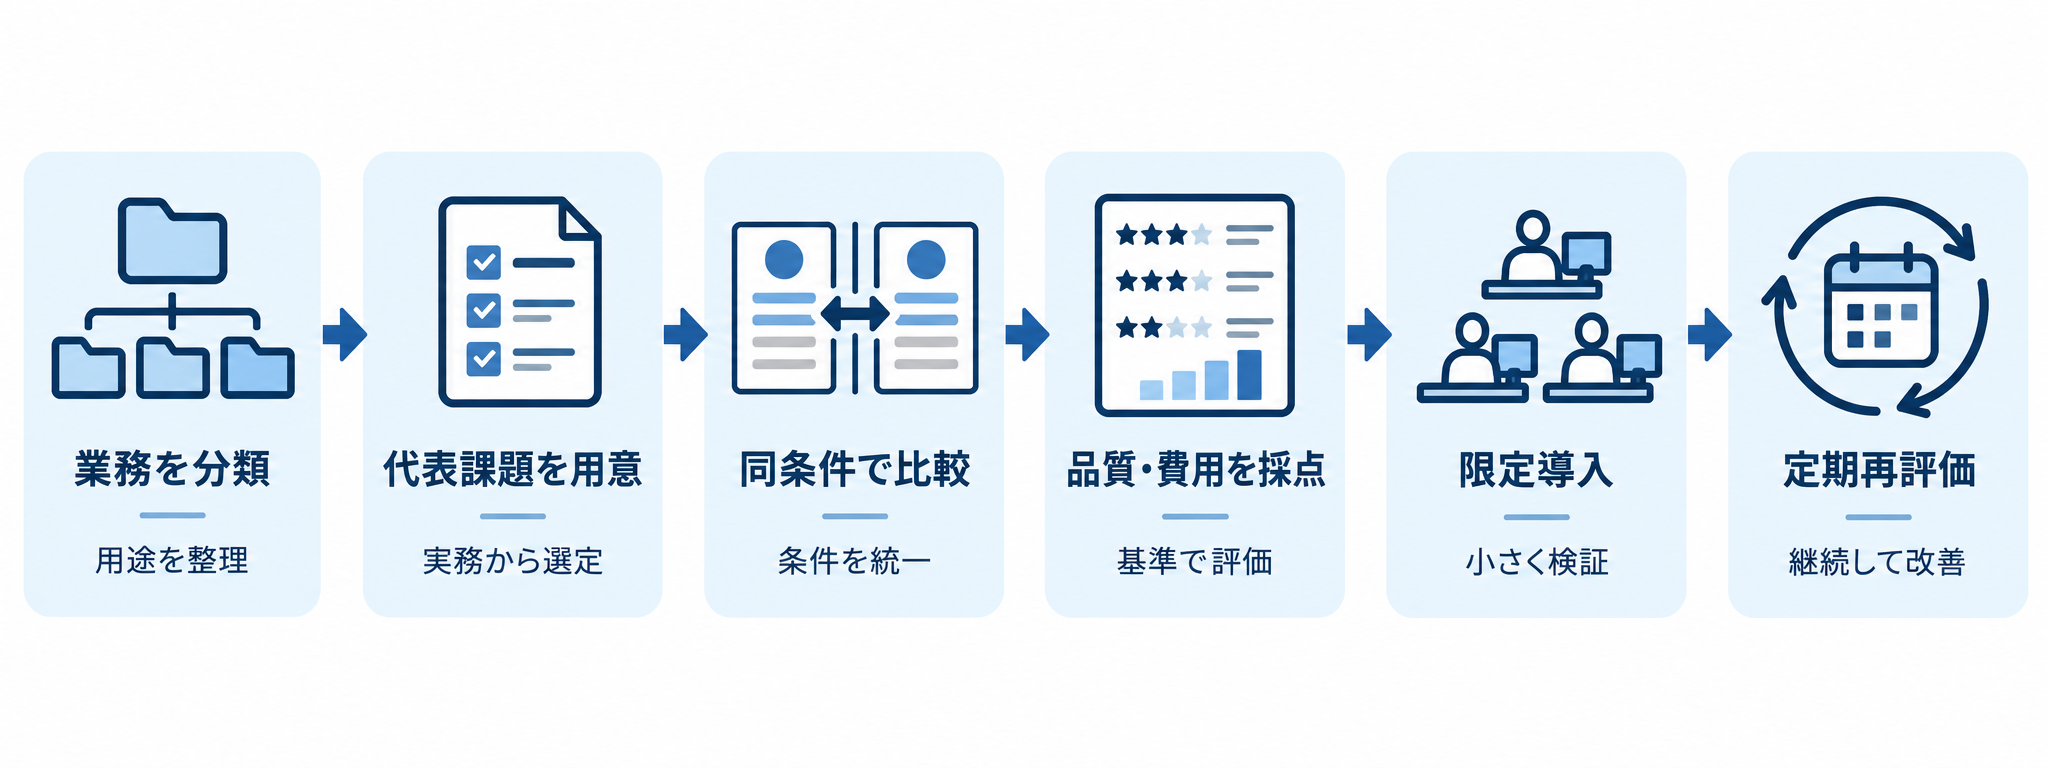
日本企業がモデルを選ぶ際は、公開された評価値やモデルの序列だけでなく、実際に扱う日本語データを使って確認する必要があります。敬語、社内用語、製品固有の表現、曖昧さを含む依頼などは、一般的な評価問題だけでは再現しにくいからです。海外向けの技術情報を日本語の顧客説明へ変換する業務であれば、正確さだけでなく、用語の統一や読みやすさも採点対象になります。評価用の課題は、日常業務から代表例を集めて作成します。正解を明確に判定できる抽出や分類では一致率を確認し、文章作成では事実性、指示への適合、修正に要する時間などを人が評価するとよいでしょう。技術コミュニケーションを試す場合は、専門家向けの説明と非専門家向けの説明を分け、読み手に応じた表現ができるかを確かめます。
候補モデルには同じ入力と同じ条件を与え、品質と費用を記録します。マルチエージェント構成を採用する場合は、単体モデルとの比較も必要です。複数のエージェントによる確認で品質が上がっても、処理回数や運用の複雑さが増えるため、得られる改善が追加負担に見合うかを判断しなければなりません。
運用開始後も評価は終わりません。新しい小型モデルが古い大型モデルを上回ることがある以上、一定の間隔で候補を再評価できる仕組みが必要です。ただし、モデル更新のたびに全面移行するのではなく、限定した業務で試し、既存モデルとの差を確認してから適用範囲を広げるほうが安全です。入力データの取り扱い、出力の確認責任、問題が起きた際の切り戻し方法も、選定時に決めておくべきでしょう。
着手点として、自社の生成AI業務を「品質最優先」「品質と費用の均衡」「費用最優先」の三群に分けてみてください。そのうえで各群から代表タスクを選び、Astra、Sol、Terra、Lunaの候補を同じ基準で比べます。モデル名から性能を推測する段階を越え、自社データに基づく選択へ移るための具体的な一歩になります。