
2026/10/27
SAP「Joule」が目指す自律型企業、AIエージェントを動かす「統制された扉」
企業向けAIエージェントが、社内データを参照するだけでなく、承認や更新を含む業務まで担うようになったとき、精度と同じくらい重くなるのが「何を許可し、誰が監督するか」という問題です。SAPは年次開発者会議TechEdで、AIアシスタント「Joule」とBusiness AI Platformの新機能を発表しました。その中心にあるのは、エージェントの自律性を広げながら、企業が統制を失わないための仕組みです。
オープンな連携を支える「統制された扉」
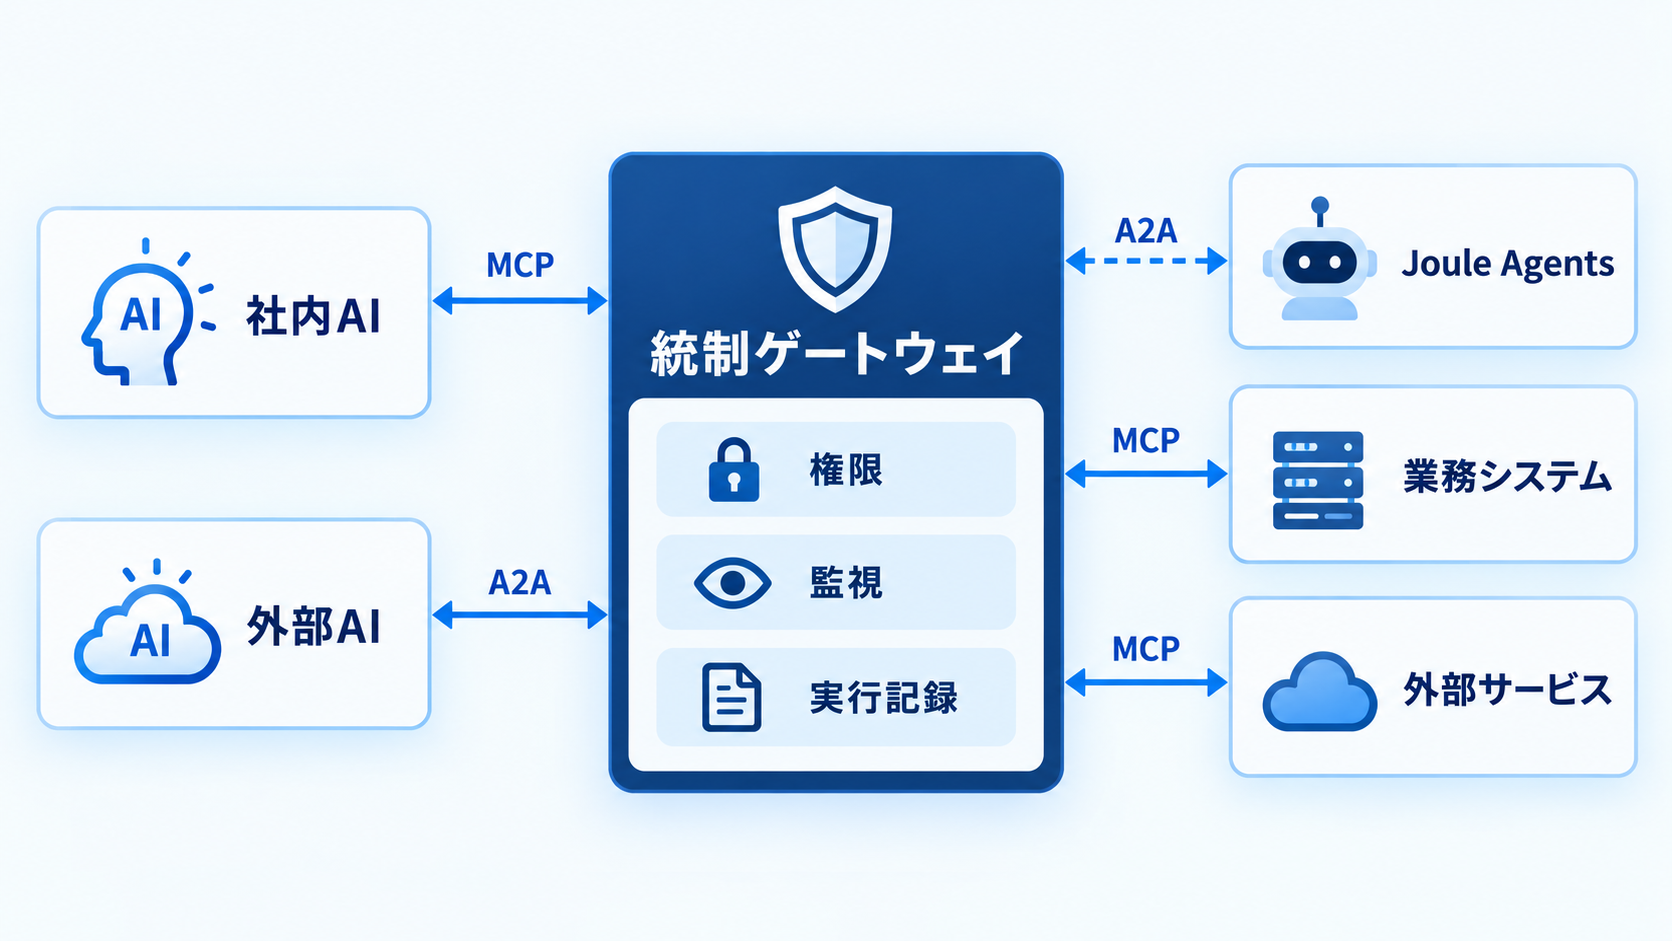
SAPがJoule Workに加える新機能は、AIエージェント同士の連携を効率化し、社外のデータやサービスも業務フローに組み込めるようにするものです。連携には、AIとツールの接続方法を標準化するModel Context Protocol(MCP)と、異なるエージェント間の協調を可能にするAgent2Agent(A2A)が使われます。Jouleはこれらのオープンプロトコルを通じて業務の背景を集め、判断し、複数の工程からなる処理を進められるようになります。ただし、接続先を増やすだけでは企業システムとして成立しません。SAPでBusiness AI Product Engineeringのバイスプレジデント兼最高製品責任者を務めるテッド・ウェイ氏は、「オープンプロトコルには統制された扉が必要です」と説明しています。人間の従業員が役割に応じたアクセス権を与えられるのと同様に、エージェントにも参照できる情報、利用できるツール、実行可能な操作を明確に定める必要があるという考え方です。
SAPが用意する新たなオーケストレーション層は、社内外のアシスタントやエージェントがJoule Agentsを呼び出す際のゲートウェイになります。企業はこの入口で活動を監視し、権限や接続方法を管理できます。顧客企業が独自に構築したエージェントとSAPの業務エージェントを協調させつつ、無制限な相互接続にはしない設計です。
この構想で重要なのは、「自律型企業」が人間の監督を排除するという意味ではない点です。実行主体が人からAIへ移っても、権限管理や監査の責任は組織に残ります。エージェントの能力を競う段階から、安全に参加させるための運用基盤を整える段階へ、企業向け生成AIの焦点が移りつつあることを示す発表と受け取れます。
生成AIの柔軟性とn8nの確実性を組み合わせる設計
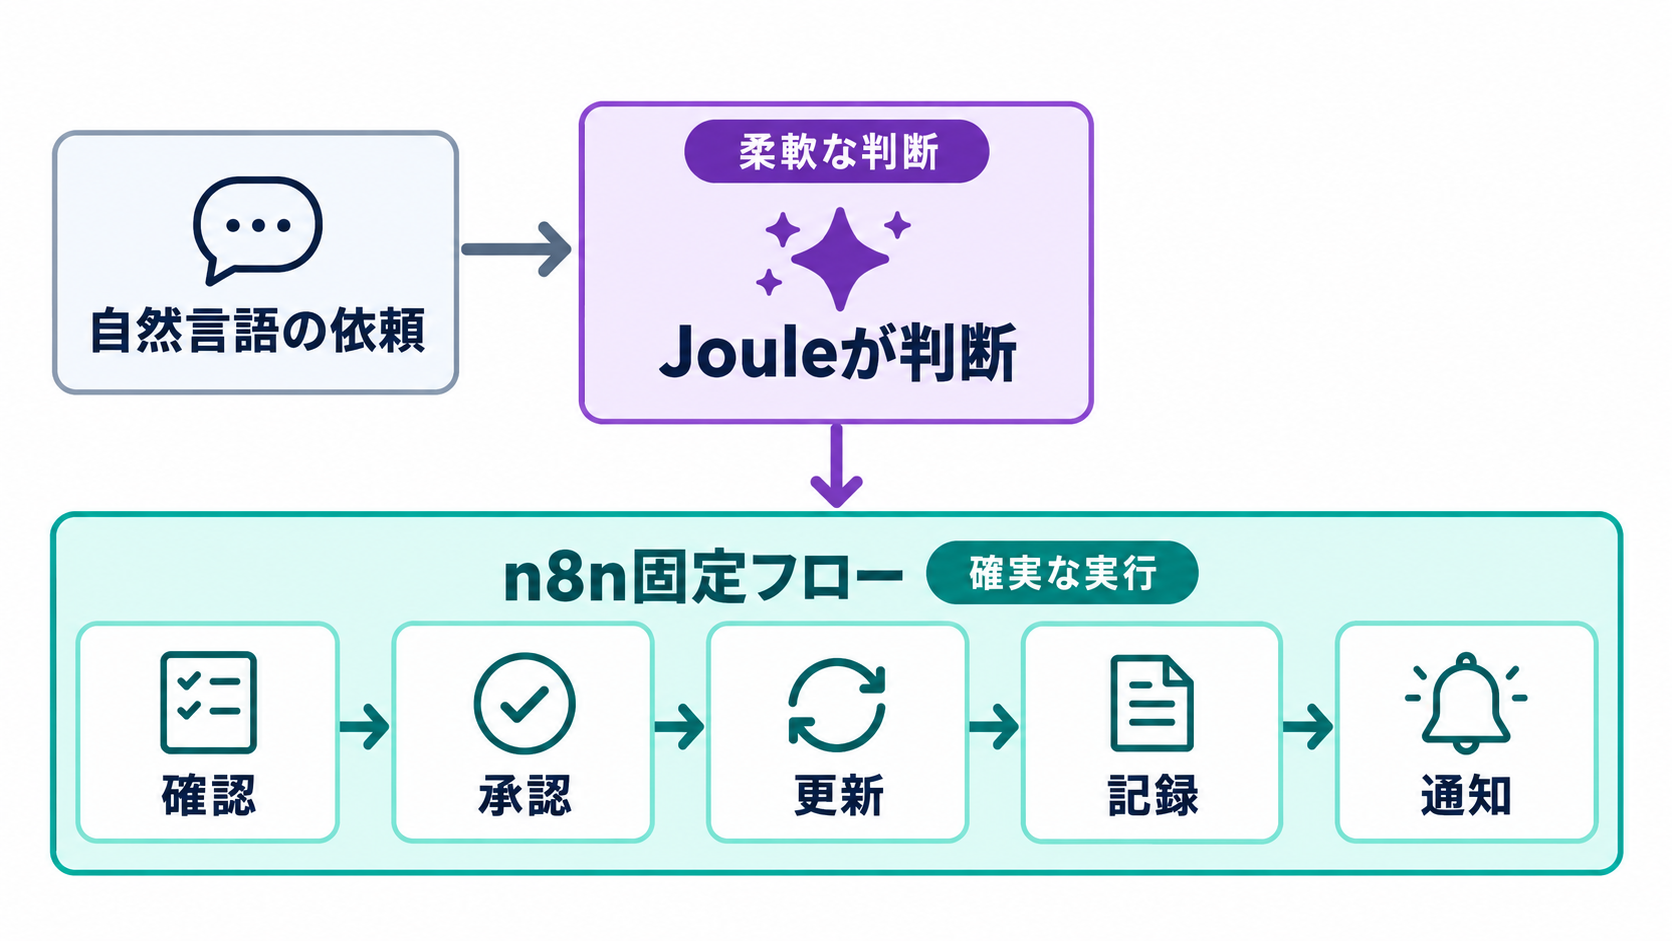
Joule Studioでは、AIエージェントからワークフロー自動化基盤「n8n」の処理を起動できるようになります。n8nは、アプリや処理をノードとしてつなぎ、イベントやトリガーに従って決められた手順を実行するプラットフォームです。自然言語から内容を生成するAIとは異なり、設定された条件と順序に沿って処理するため、同じ入力と条件であれば同じ流れを再現しやすいという特徴があります。ウェイ氏は、五つの工程を毎回まったく同じ順番で実行しなければならない業務では、n8nが適していると説明しています。生成AIには、利用者の曖昧な依頼を読み取り、状況に応じて使う機能を選べる利点があります。その反面、厳密な処理順序が求められる手続きを、すべて確率的な判断に任せることは適切ではありません。
SAPの狙いは、両者を競合させるのではなく、役割を分けることです。Jouleのエージェントが会話や業務状況から「いつ処理を開始するべきか」を判断し、実行段階ではn8nが規定された手順を崩さずに進めます。規制対応や機密性の高い業務では、柔軟な入口と決定論的な実行経路を組み合わせることで、使いやすさと再現性を両立しやすくなります。
もっとも、決められた通りに動くことは、ワークフローの内容自体が正しいことを保証しません。誤った手順を登録すれば、その誤りも正確に繰り返されます。企業が導入する際には、AIの回答精度だけでなく、固定フローの承認者、変更履歴、例外発生時の停止条件まで設計する必要があるでしょう。今回の連携は、生成AIを既存の業務統制へ接続するための具体的な分業モデルを示しています。
エージェントの判断を支える業務データの意味付け
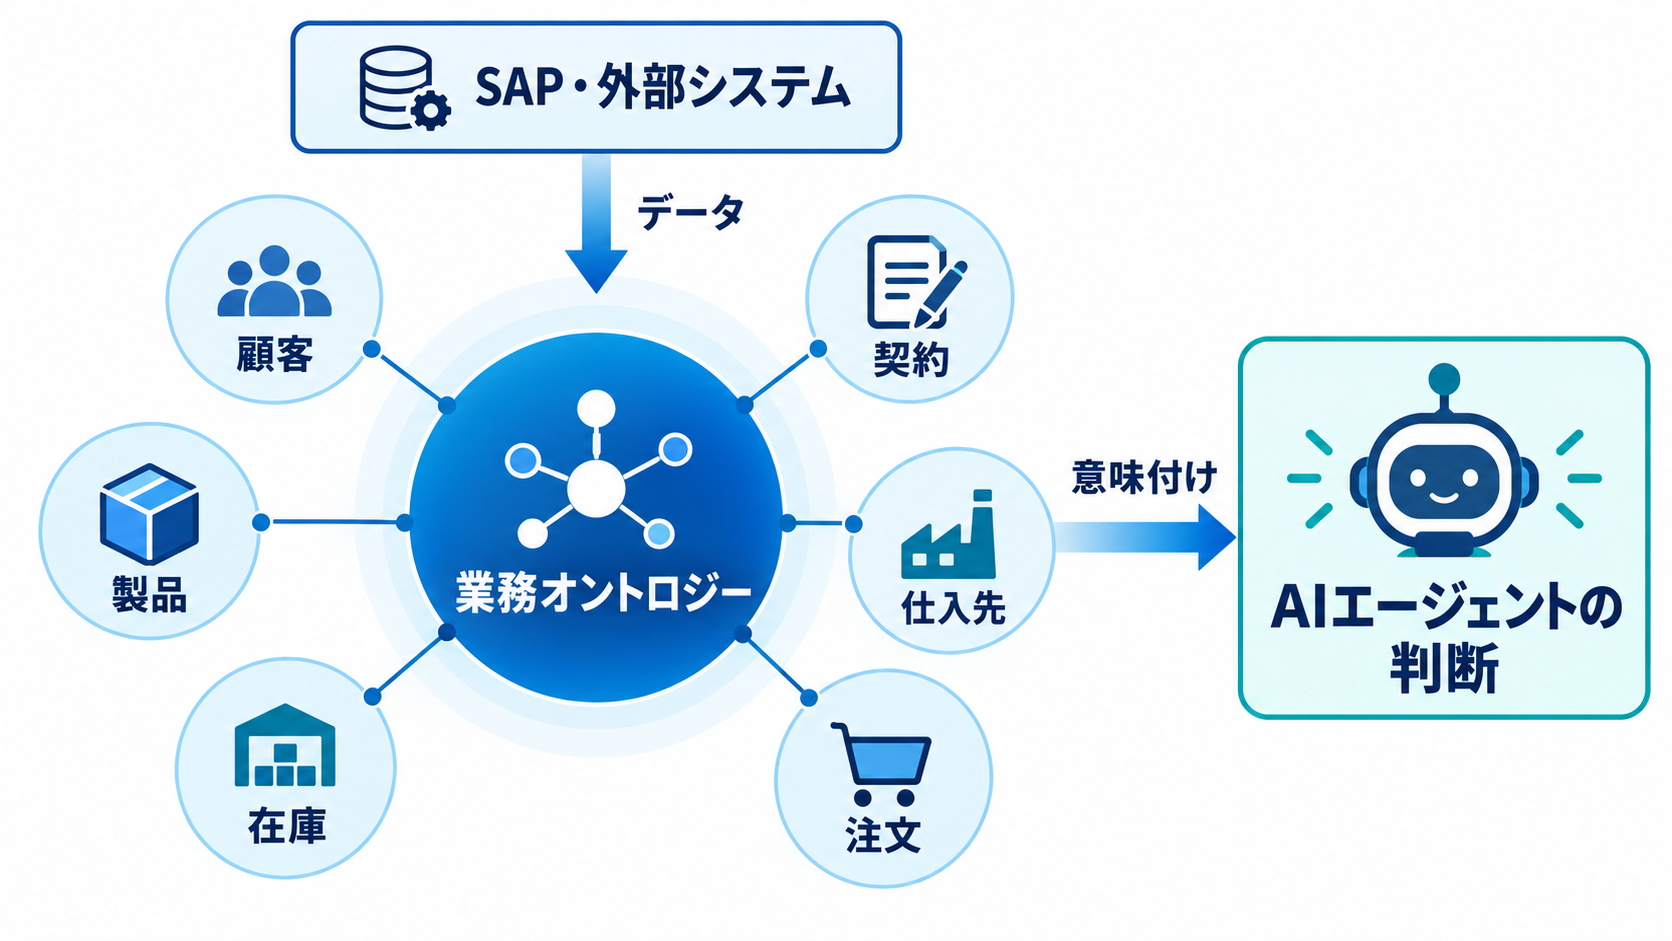
AIエージェントが企業全体で判断するには、データを検索できるだけでは不十分です。「顧客」と「契約」、「製品」と「在庫」のように、業務上の概念がどう結び付いているかを理解できなければ、複数システムをまたぐ処理で誤った関係を推測するおそれがあります。SAPはこの課題に対応するため、SAP Business Data Cloud(BDC)のOntology Managerを拡張すると発表しました。オントロジーとは、データが表す概念と、その概念同士の関係を定義する仕組みです。単に列名やファイル形式をそろえるのではなく、異なるアプリケーション上の情報が業務上どのような意味を持つのかを記述します。Ontology ManagerにはAIネイティブな作成体験が加わり、企業内の事実関係を定義することで、エージェントがアプリケーション間のつながりを理解し、より正確に推論できるようにします。
SAPが買収を発表したReltioのマルチドメイン・データ管理技術も、BDCに組み込まれます。対象となるのは顧客、仕入先、製品などの記録です。SAP製品と第三者システムに分散する情報を、信頼できるデータプロダクトとして統合し、アプリケーションやエージェントから利用しやすくします。SAPデータに豊富な業務コンテキストを与える既存のKnowledge Graphとは、相互に補完する位置付けです。
企業では、同じ取引先が部署やシステムごとに異なる名称や識別子で登録されていることも珍しくありません。その状態で自律実行を広げれば、AIは矛盾した記録を前提に処理を進めかねません。モデルを高性能化するだけでなく、判断材料の意味と信頼性を整えるSAPの方針は、企業向けAIにおけるデータ管理の重さを映しています。エージェント導入は、チャット画面の追加ではなく、業務用語とデータの関係を再点検する取り組みにもなるでしょう。
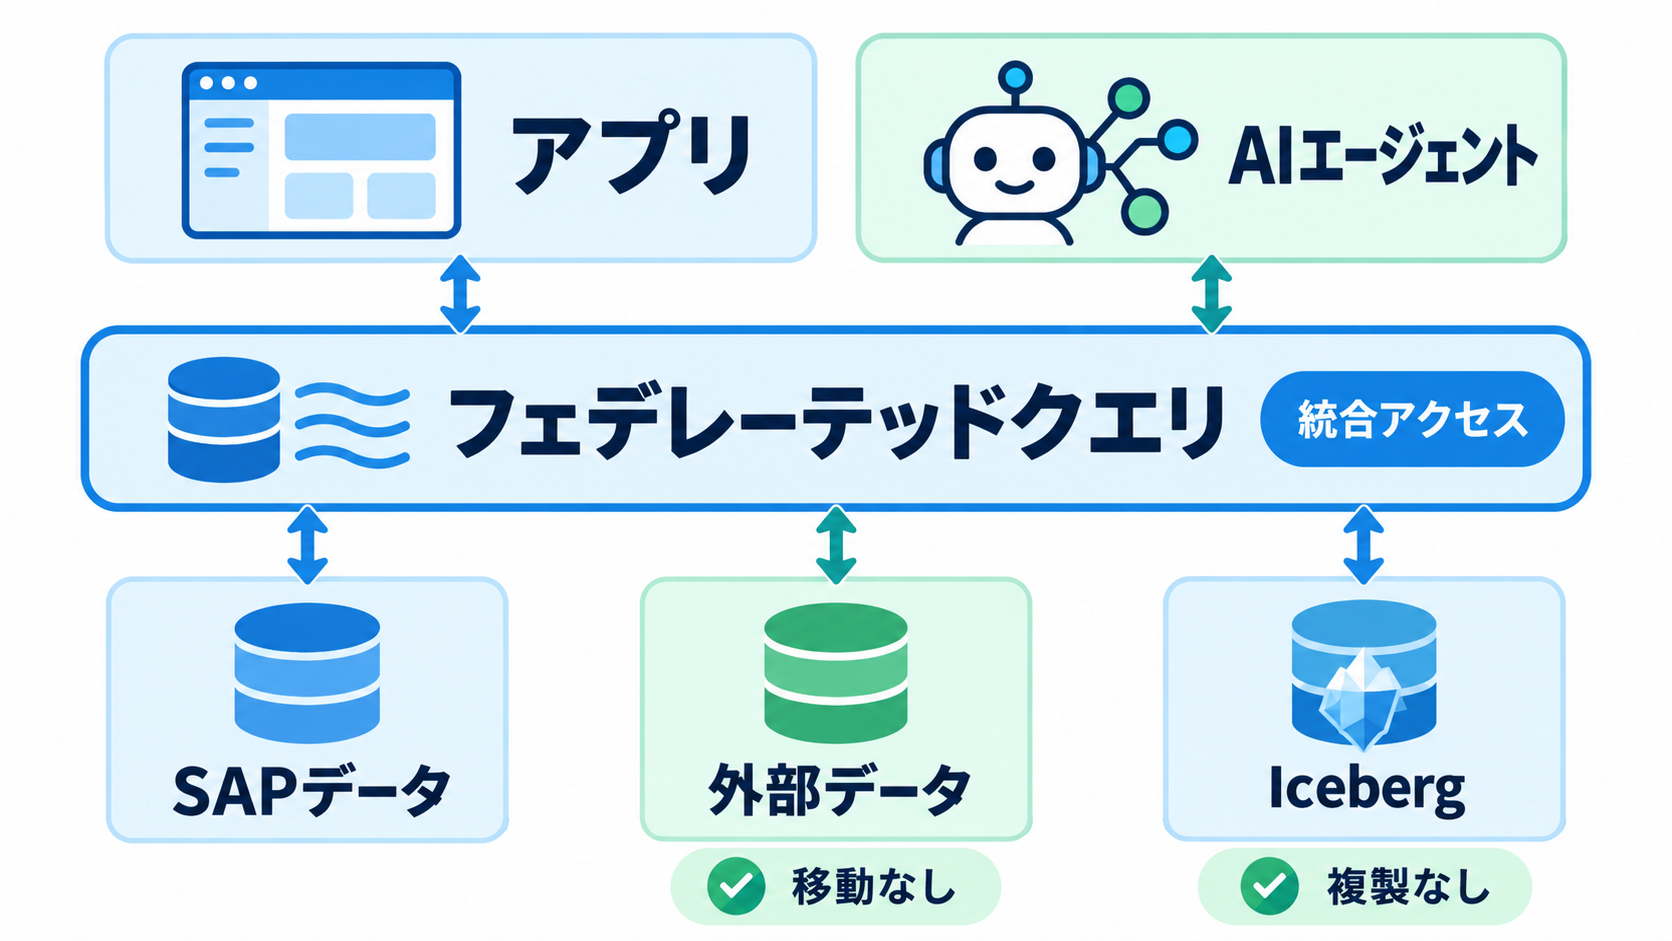
データを移さず横断利用するレイクハウス基盤
SAPは、買収したDremioの技術を活用し、レイクハウス機能も拡張します。レイクハウスは、多様なデータを蓄積するデータレイクの柔軟性と、整合性を保ちながら分析するデータウェアハウスの性質を組み合わせる考え方です。新機能では、表形式データを管理するオープンな仕様であるApache Icebergと、そのカタログ管理に関係するApache Polarisをネイティブにサポートします。高性能なフェデレーテッドクエリエンジンも追加されます。フェデレーテッドクエリは、複数の場所にあるデータを一カ所へコピーしてから分析するのではなく、保存先をまたいで問い合わせる方式です。SAPは、データを移動または複製せずに統合アクセスできると説明しています。エージェントが社内の幅広い情報を利用するほど、コピーの増加や更新時差が問題になりやすいため、この方式はデータの所在を維持しながら活用範囲を広げる選択肢になります。
企業側から見ると、データを動かさない設計には、既存基盤を生かしやすいという利点があります。ただし、保存場所が分散したままであれば、アクセス権、データ品質、応答性能の管理が不要になるわけではありません。横断検索の入口だけを統一しても、各データの責任者や利用条件が曖昧であれば、エージェントに安全な判断材料を渡すことは難しいでしょう。
Ontology Managerが「データの意味と関係」を整え、Reltioが主要な業務記録の信頼性を高め、Dremio由来の機能が「データへ到達する経路」を広げる構成です。これらを組み合わせることで、SAPはエージェントの会話能力だけでなく、その背後にあるデータ層まで自律型企業の基盤としてまとめようとしています。AI導入とデータ基盤刷新を別々の計画として扱っている企業には、両者の依存関係を見直す材料になります。
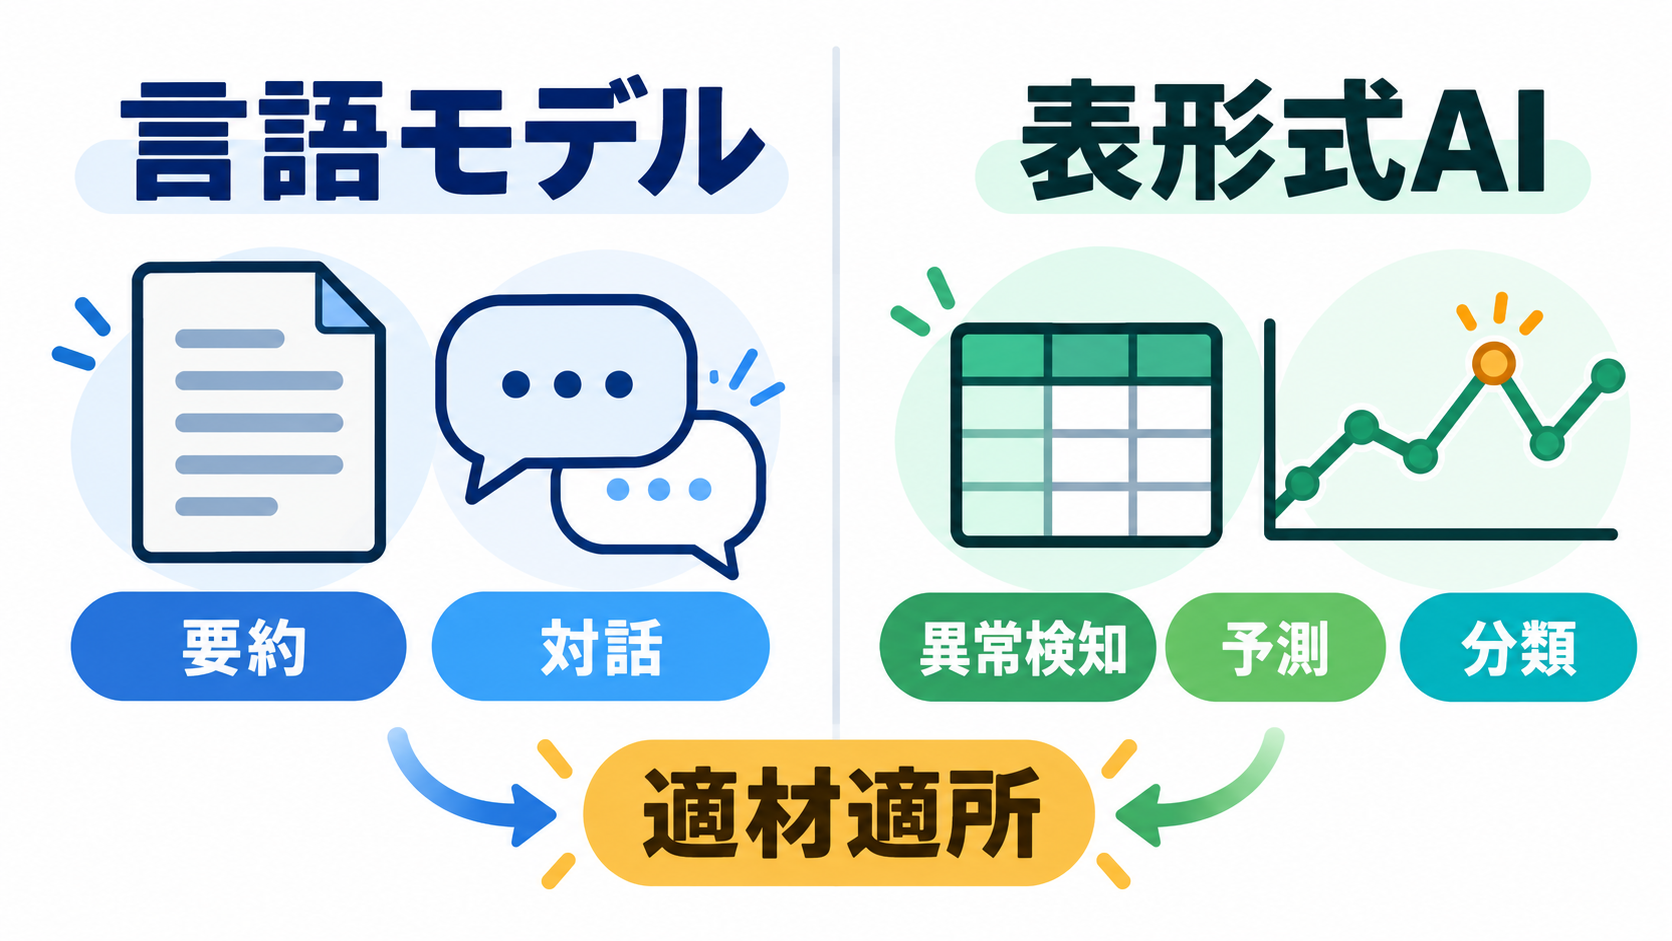
言語モデルでは捉えにくい表形式データへの対応
企業活動で蓄積される情報の多くは、文章ではなく、売上、在庫、取引履歴、センサー値などの表として保存されています。ウェイ氏も「すべての企業課題が言語の問題ではありません」と指摘しています。チャット形式の生成AIが注目を集めても、業務判断に必要な変化や異常を見つけるには、構造化データに適したモデルが欠かせません。SAPが発表したSAP-RPT-2.0は、表形式データを扱うAIモデルです。従来の分類や回帰に加え、異常値や外れ値の検出をサポートし、埋め込み表現を使った分析を提供します。複数テーブルを扱う機能によって、分析前の手作業によるデータ加工を減らし、構造化データからより深い知見を得るまでの時間を短縮する狙いです。
時系列データ向けには、新しいSAP-RPT-TSも用意されます。時間の順序を持つ指標の将来値を予測し、主要な計画業務に利用するモデルです。SAP Business Planningを通じて、企業独自の機械学習モデルを一から構築しなくても導入できるため、高度な開発スキルを持たない利用者にも扱いやすくする方針です。
ここでの変化は、言語モデルを表計算データに無理に当てはめるのではなく、データの性質に合ったモデルを組み合わせる点にあります。自然言語のエージェントが利用者の意図を理解し、RPT系モデルが表の傾向や異常を分析する構成も考えられます。ただし、異常として検出された値が業務上の問題を意味するかどうかは、季節性や制度変更などの背景にも左右されます。モデルの出力を自動処理へつなぐ場合には、検知結果の説明可能性と、人が確認すべき基準を同時に定めることが求められます。
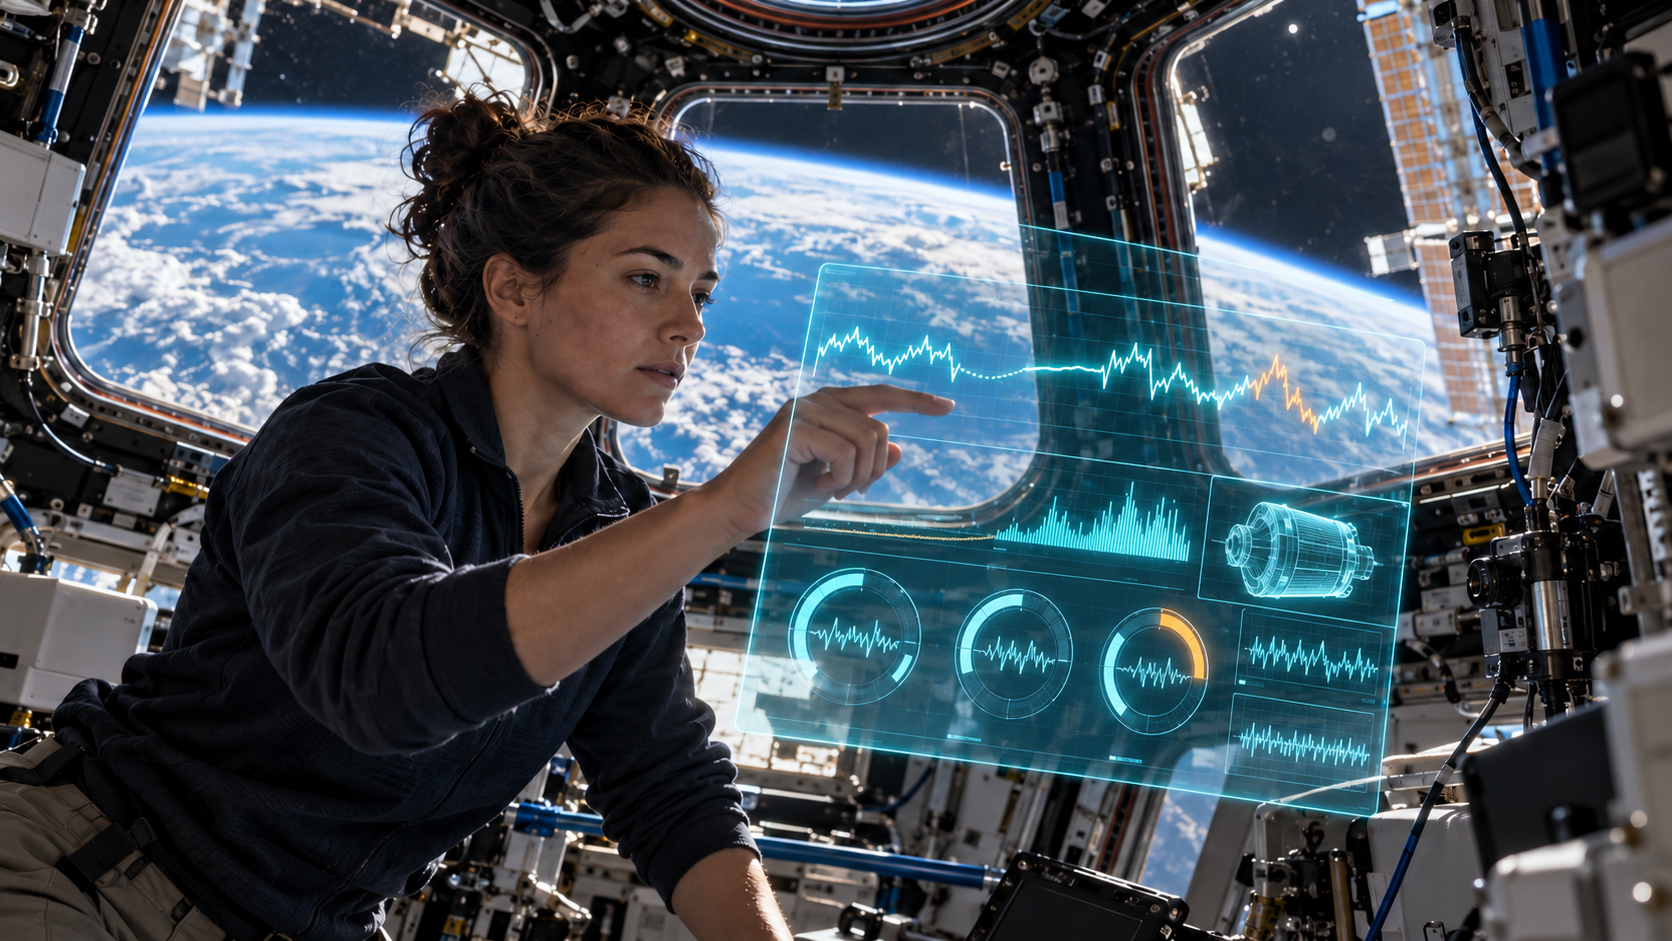
国際宇宙ステーションで試される現場内分析
SAPはHewlett Packard Enterprise(HPE)との提携により、SAP-RPTを国際宇宙ステーション(ISS)へ展開すると発表しました。目的は、機器の問題が重大な故障へ発展する前に兆候を予測し、欠落したセンサー値を過去のデータから再構成し、宇宙飛行士と地上チーム向けに説明可能なミッション状態レポートを生成することです。特徴的なのは、分析の前にデータを地球へ送り返す必要がない点です。通信先の計算環境へ毎回データを移すのではなく、データが生まれる場所に近い環境で処理する考え方は、一般にエッジ側の分析として理解できます。ISSの事例では、表形式や時系列のモデルが、言語の生成ではなく設備状態の把握に使われる姿が示されています。
この展開は、SAP-RPTの用途を印象的に伝える実証の場でもありますが、地上の企業がそのまま同じ条件を持つわけではありません。注目すべきなのは宇宙という舞台そのものより、通信やデータ移動に制約がある環境でも、現場側で予測、補完、報告を完結させようとしている設計です。工場や遠隔拠点などを検討する際にも、どのデータを現場で分析し、どの結果だけを中央へ共有するかという設計上の視点が参考になるでしょう。
予測結果を設備運用へ反映するには、誤検知や見逃しへの備えも必要です。SAPは説明可能なレポートの生成を用途に含めており、単なる警告値ではなく、宇宙飛行士や地上チームが状況を理解するための情報提供を目指しています。自律化が進む環境ほど、人間が判断を引き継げる説明と記録が必要になるという点は、統制されたJoule Agentsの構想とも共通しています。
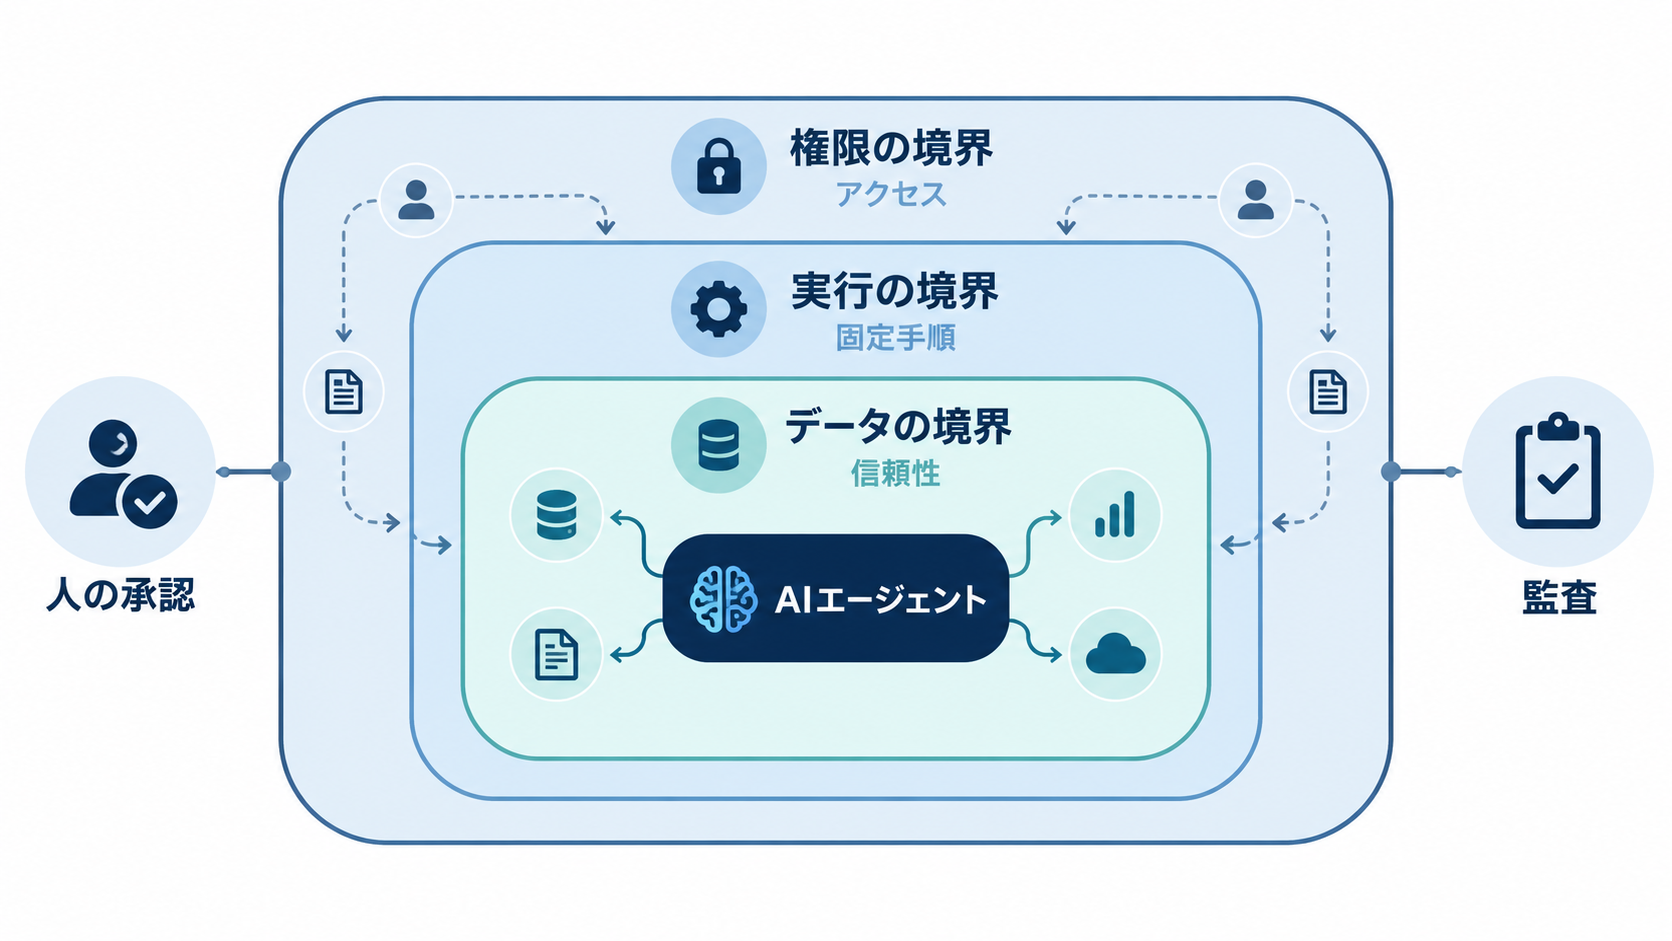
日本企業が導入前に整理したい三つの境界線
SAPの発表を自社の計画へ落とし込む際には、「どのAIモデルを採用するか」だけでなく、AIに任せる範囲の境界線を整理する必要があります。第一の境界線は権限です。エージェントが読めるデータ、更新できる項目、呼び出せる外部サービスを、利用者の権限と対応付けて定義します。ゲートウェイを置くだけで終わらせず、実行履歴を誰が確認し、問題時に誰が停止させるかまで決めておくことが欠かせません。第二の境界線は、柔軟な判断と固定手順の分担です。依頼の意図を読み取る部分や、必要な処理を選ぶ部分にはエージェントが向いています。順番を変えてはいけない承認、記録、通知などは、n8nのような決定論的ワークフローへ渡す設計が候補になります。業務ごとに「AIが選んでよいこと」と「必ず規則通りに動かすこと」を分ければ、生成AIを全面的に信頼するか禁止するかという二者択一を避けられます。
第三の境界線はデータです。エージェントから利用できることと、判断材料として信頼できることは同じではありません。顧客、製品、仕入先などの定義をそろえ、重複や矛盾を管理し、データ間の関係を説明できる状態にする必要があります。表形式モデルを使う場合も、入力データの期間、欠損、異常値の扱いを確認しなければ、分析の自動化が誤った判断を速める結果になりかねません。
導入の第一歩としては、一つの業務フローを選び、判断、データ参照、実行、承認の各工程を書き出す方法が現実的です。その上で、自然言語エージェント、固定ワークフロー、人間の担当者をどこに配置するかを検討します。SAPの構想が示しているのは、エージェントを賢くするだけでは自律型企業にならず、統制、データの意味、確実な実行経路を一体で設計しなければならないということです。