
2026/10/27
文章を生成しない27Bモデル「d3-ultra」、企業AIの判断処理を1回の推論に集約
生成ではなく「判断」に特化した27Bモデル
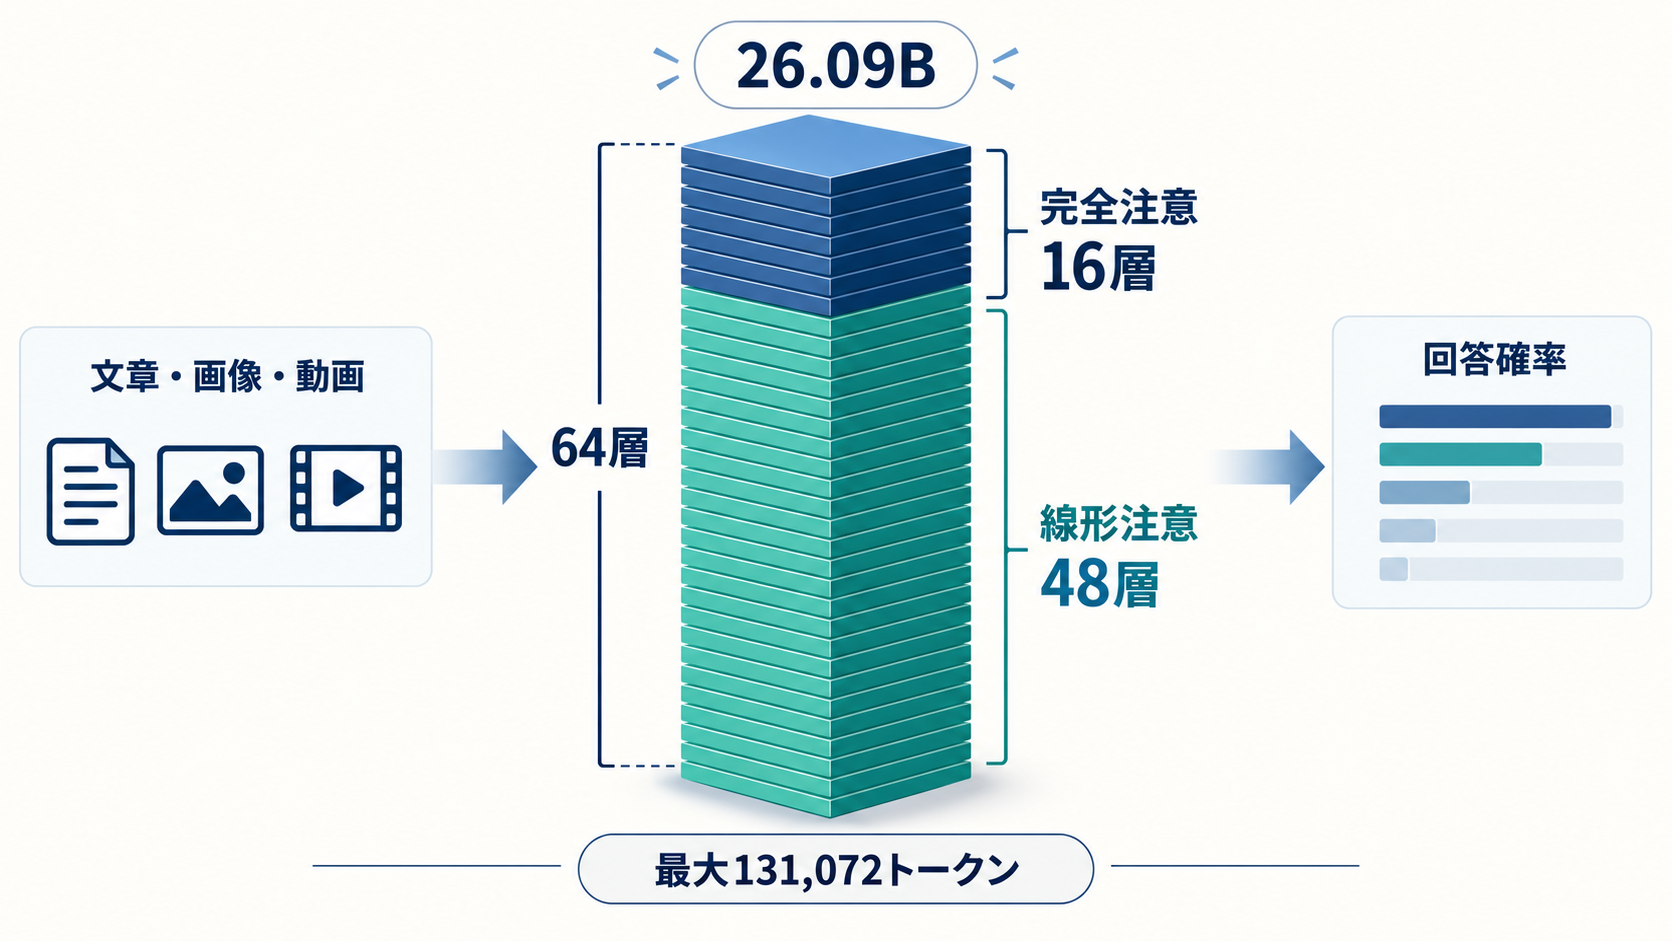
顧客から届いた問い合わせを担当部署へ振り分け、添付画像を確認し、対応の優先度を決める。こうした業務では、文章を作る能力よりも、決められた選択肢を一貫して評価できる仕組みが求められます。vLLM Semantic Routerチームが公開したd3-ultraは、その判断処理に焦点を合わせたマルチモーダルモデルです。d3-ultraのパラメータ数は26.09Bで、約4.6億パラメータの画像エンコーダーを含みます。ライセンスはApache-2.0で、重みを入手して自社環境へ展開できるオープンウェイトモデルです。Decision 3.0と呼ばれる0.6Bから27Bまでのモデル群では、最大規模のモデルに位置付けられています。
特徴的なのは、回答文を一切生成しない点です。テキストやJSON、画像、動画を読み取り、与えられた各質問について回答候補ごとの確率を返します。チームはこの設計をSystem One decision modelと表現しており、時間をかけて文章を組み立てる用途ではなく、入力に対して定型的な判断を返す用途を想定しています。
したがって、d3-ultraは汎用チャットAIの代替というより、その手前や周辺で動く判定レイヤーとして捉えると分かりやすいでしょう。問い合わせのルーティング、分類、ツール選択、画像内の対象物の特定、動画チェックなどを、共通のモデルと入出力形式で扱えることが中心的な価値です。ただし、確率を業務上の結論へ変換する基準や、曖昧な場合に人へ引き継ぐ仕組みは、利用企業側で設計する必要があります。
1回の読み取りで複数の質問に答える仕組み
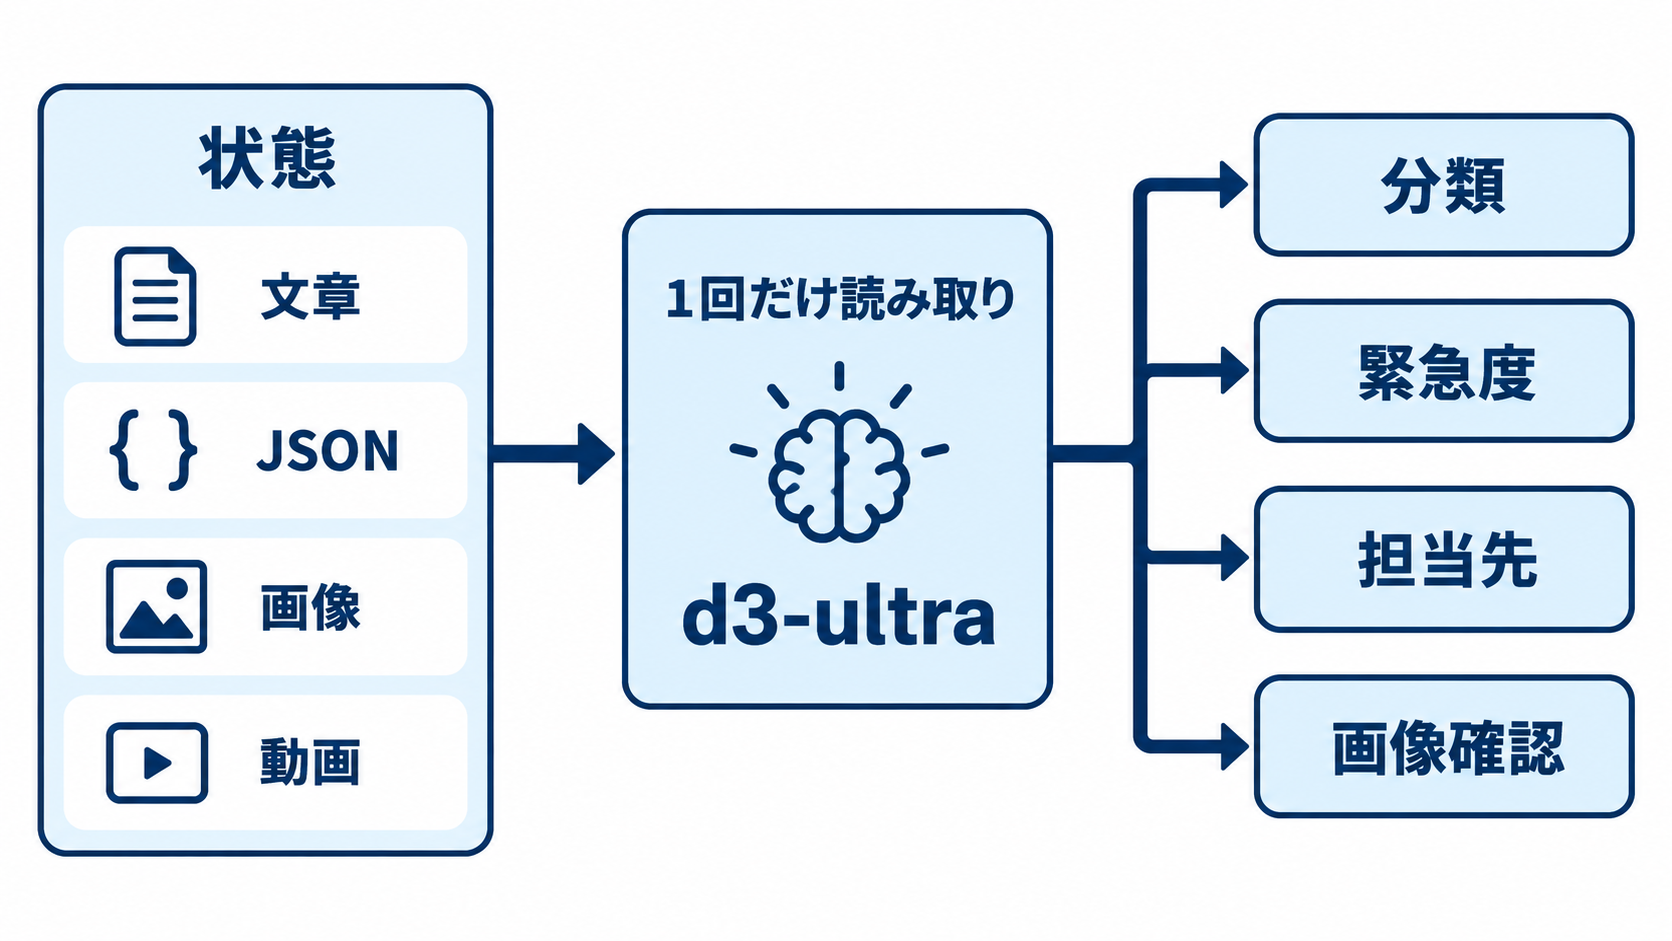
一般的なAIシステムでは、同じ文書や画像について複数の判定を行うたびに、入力全体をモデルへ送り直す構成になりがちです。d3-ultraはstate once、すなわち状態を一度だけ読み取る考え方を採用しています。利用者はテキストやJSON、画像、動画で構成される状態と、その状態について確認したい複数の質問を一つのリクエストとして渡します。モデルは入力を一度処理し、その結果を使ってすべての質問に回答します。例えば、サポートチケットを読み取った後に、製品カテゴリ、緊急度、不正利用の可能性、担当チームという複数の項目を同時に評価できます。個別の分類器を連結する構成と比べ、モデルの種類や呼び出し方法を統一しやすくなると考えられます。
公開された測定では、1枚の写真に関する1問の処理時間が304ミリ秒だったのに対し、255問では2.16秒でした。単純に255回の独立処理を繰り返すのではなく、共有した読み取り結果から回答を増やせる設計が、この差に表れています。追加の質問1問当たりに換算すると約7.3ミリ秒ですが、これはAMD Instinct MI325Xを1基使用し、AutoModelで実行した特定条件での測定値です。実環境の性能は、入力量、画像サイズ、実装、並行処理などによって変わるでしょう。
複数の判断が同じ入力理解を共有することには、注意点もあります。最初の読み取りで対象を取り違えれば、その影響が複数の回答へ広がる可能性があります。導入時には平均精度だけでなく、関連する判定が同時に誤るケースや、質問数を増やした場合の遅延も確認することが欠かせません。
Choiceから動画追跡までを統一する5種類の質問
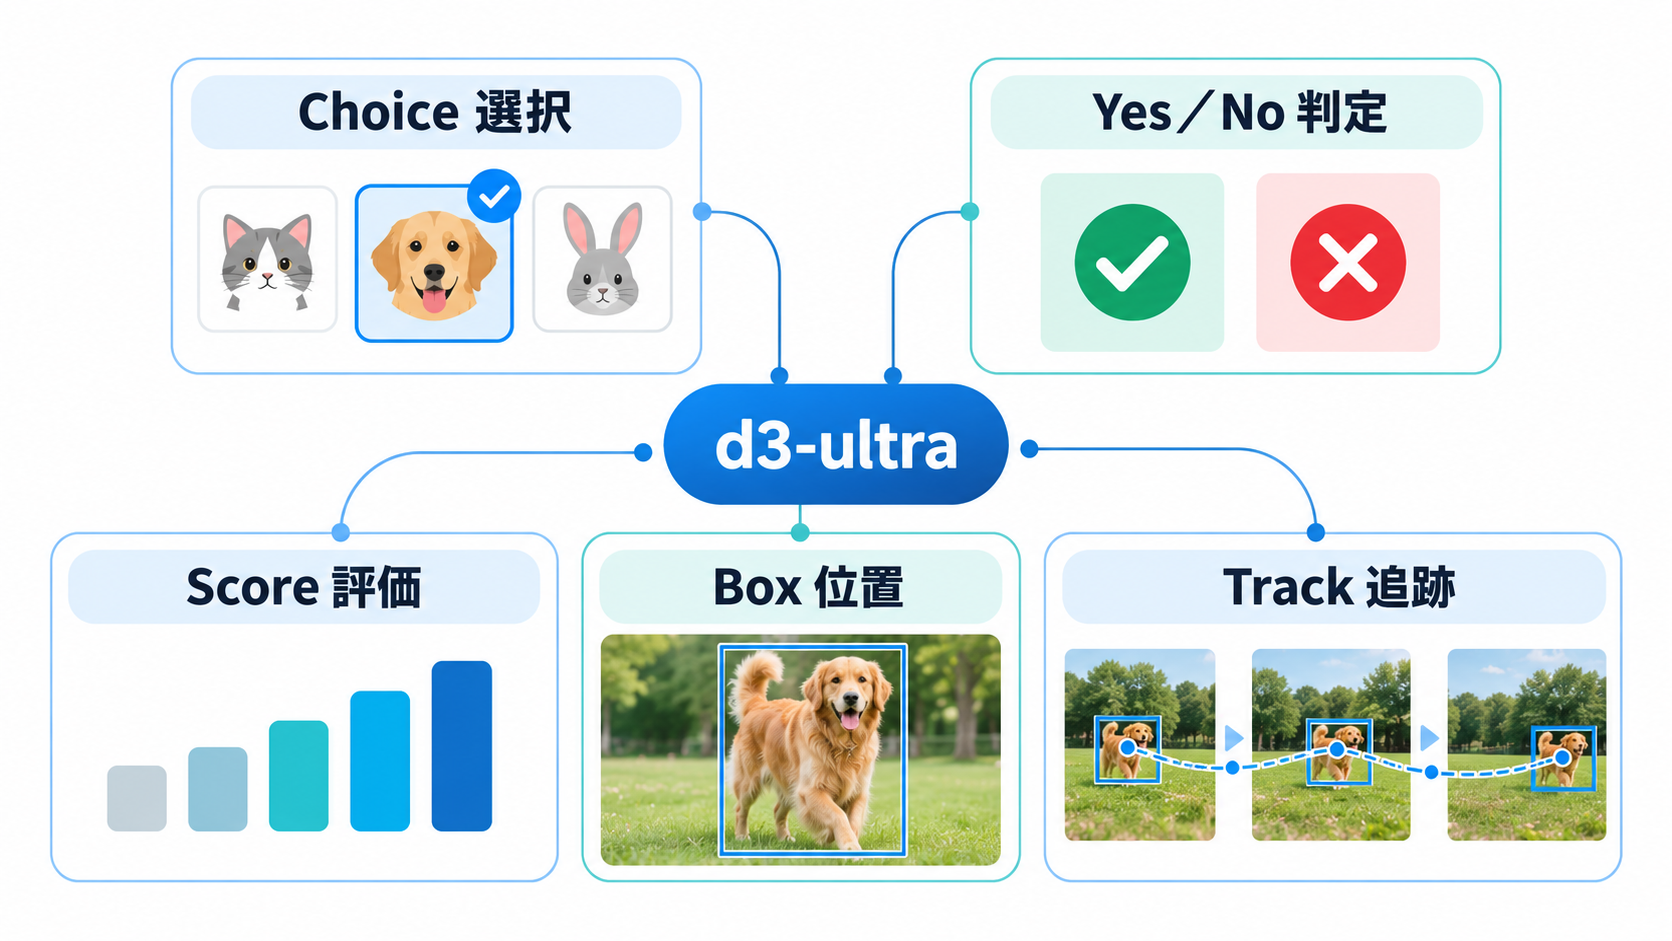
d3-ultraが受け付ける質問形式は、Choice、Yes/No、Score、Box、Trackの5種類です。Choiceは複数候補から一つを選び、Yes/Noは肯定である確率を返します。Scoreは指定した尺度で評価する形式です。業務システム側は返された確率やスコアを参照し、自動処理、再確認、人への引き継ぎといった動作を決められます。Boxは、画像または動画の一場面から対象物の位置を特定する形式です。回答には必ず一つの矩形領域と信頼度が含まれ、対象が見つからないと判断した場合は信頼度がゼロに近づきます。対象が存在しない場合にも形式が変わらないため、受け取る側は信頼度のしきい値を設けて不在判定を行う必要があるでしょう。
Trackは、指定した対象を動画全体にわたって追跡します。Boxが特定の瞬間における位置を示すのに対し、Trackは時間軸をまたぐ確認に向いています。ただし、公開された比較結果ではSR-Boxの数値が詳しく示されている一方、Trackの独立した精度指標は明らかにされていません。動画業務へ適用する場合は、移動速度、遮蔽、場面転換など、自社の映像条件で確認する必要があります。
画像は状態部分だけでなく、質問や回答候補にも含められます。写真を提示し、その写真に対応する4枚の版画から一つを選ばせるような問題も構成できます。これは商品画像の照合、デザイン候補の分類、画面キャプチャーに基づく操作判定など、テキストだけでは表しにくい選択肢を扱う際に役立つ設計です。異なる質問形式を一つのモデルで扱える反面、自然文による説明は返らないため、監査用の理由文が必要なら別の仕組みを組み合わせなければなりません。
13万トークンとハイブリッド注意機構の構成
d3-ultraはQwen3.5アーキテクチャーに基づくバックボーンを採用し、全64層で構成されています。その内訳は、計算効率を意識した48層の線形注意層と、入力要素同士の広い関係を扱う16層の完全注意層です。モデルカードでは基礎となったチェックポイント名が示されていません。兄弟モデルのd3については、vLLM Semantic Routerの学習手順でQwen3.8-27Bから学習したと説明されていますが、同じ経緯をd3-ultraへそのまま当てはめることはできません。質問ごとのコンテキスト上限は131,072トークンです。長い規程集、ログ、会話履歴などを状態として渡せる余地がありますが、上限を超えた質問はmax_length_exceededエラーになります。入力を上限内へ収めるために内容が黙って切り捨てられる仕様ではありません。重要箇所の欠落に気づかないまま判定を続ける危険を避けやすい反面、利用側にはエラー処理や分割方針が求められます。
動作確認にはAMD Instinct MI325Xが1基使われ、重みの形式はBF16でした。公式な量子化版は現時点で掲載されていません。26.09Bという規模を考えると、手元のGPUへそのまま載せられるか、期待する同時実行数を確保できるかは、導入前に検証すべき項目です。必要メモリや処理能力を、公開された単一GPUでの測定だけから一律に判断するのは適切ではありません。
長い入力、画像・動画、複数質問を一つのモデルで扱えることは、システム構成を簡素化する材料になります。ただし、131,072トークンを常に使う必要があるわけではなく、入力が長くなれば処理コストや待ち時間にも影響します。企業利用では、判定に必要な情報だけを抽出する前処理と、モデルに一括して読ませる範囲とのバランスが実装上の焦点になるでしょう。
テキスト判断で首位となったSR-Textの読み方
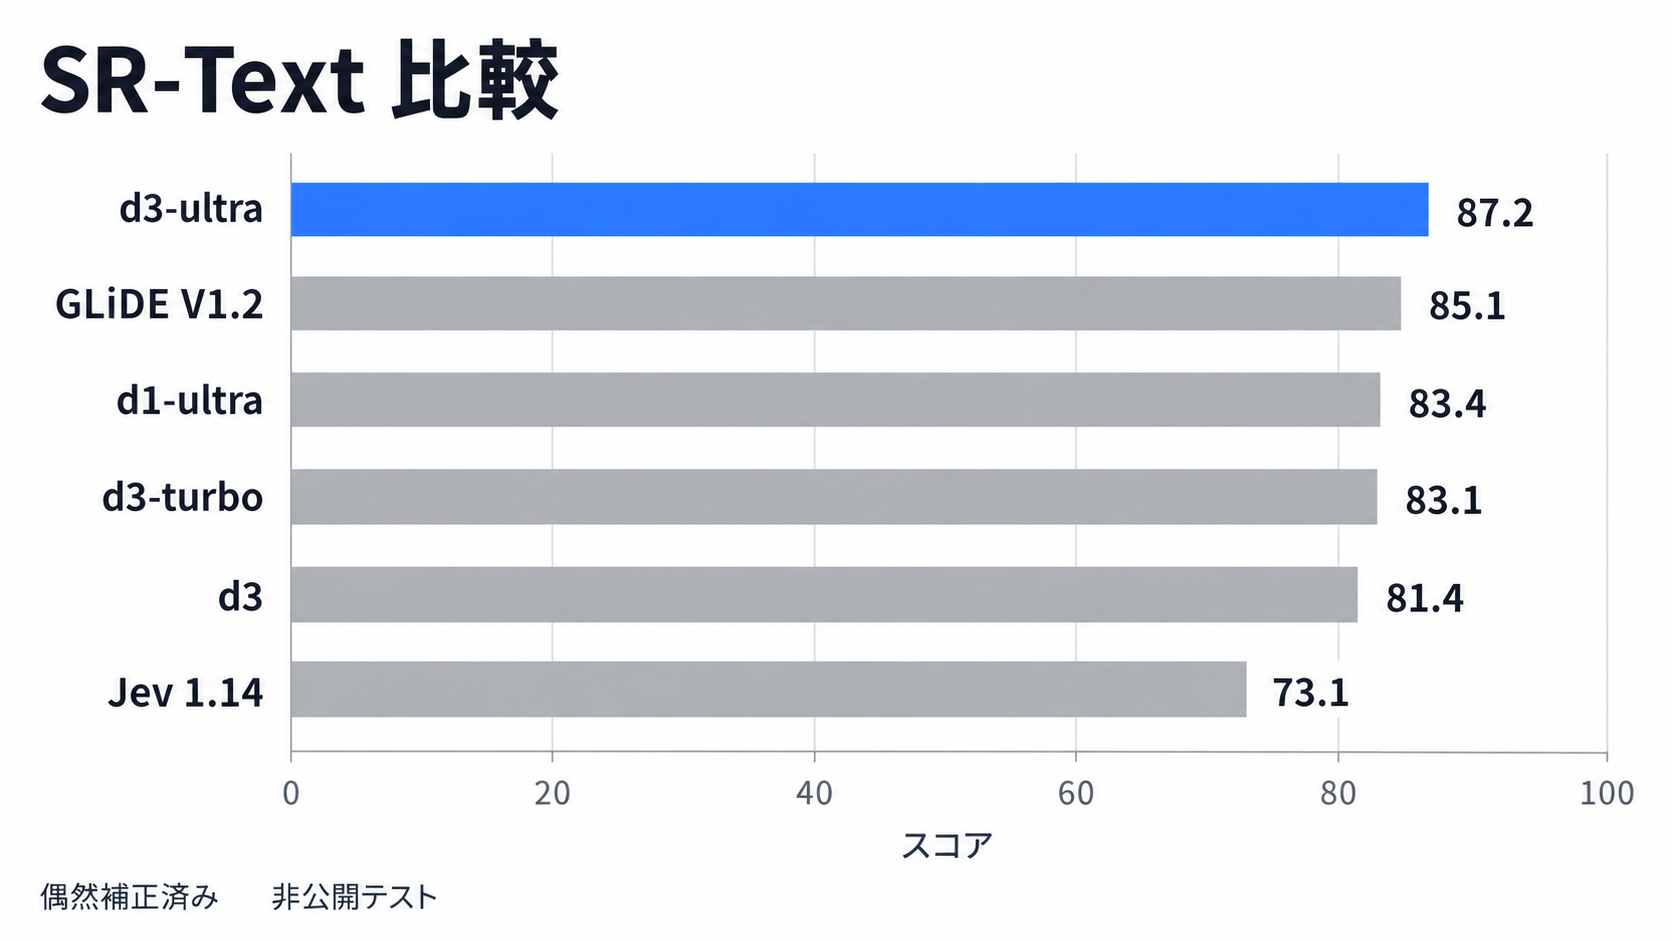
vLLM Semantic Routerチームは、d3-ultraを含む6モデルを社内テストのSR-Textで比較しています。SR-Textは10,411件のテキストリクエストと73,495問で構成されます。多くは34種類の公開ベンチマークが扱う能力を新しい問題で再現したもので、これとは別に、SQLの確認やチケットのルーティングなど43種類の新しいタスク群から4,896問が追加されています。総合スコアはd3-ultraが87.2で首位となり、GLiDE V1.2の85.1、d1-ultraの83.4、d3-turboの83.1、d3の81.4、Jev 1.14の73.1が続きました。スコアは偶然の正解を補正しており、0が偶然と同等、100が完全正解を表します。単純な正答率とは尺度が異なるため、87.2%の問題へ正解したという意味ではありません。
d3-ultraは、芸術と人間の嗜好を除く各領域で最も高い成績を示しました。芸術と嗜好ではd1-ultraが90.8、d3-ultraが89.6でしたが、この差は誤差範囲内とされています。特にツールと自動化の領域では、d3-ultraが97.8を記録しました。構造化された選択やルーティングを企業システムへ組み込むという製品の方向性と整合する結果です。
ただし、これらは開発チーム自身が非公開テストセットで測定した自己申告値です。問題データや評価手順の全体を第三者が再現できる公開ベンチマークとは、証拠の性質が異なります。競合モデルとの数ポイントの差だけで採用を決めるのではなく、自社のラベル定義、言語、長文比率、誤判定コストを反映した評価が必要です。
日本語業務で使う場合は、日本語での数値が個別に示されていない点にも注意が要ります。社内文書特有の略語、敬語を含む顧客文面、複数言語が混在するチケットなどを用意し、回答確率が実際の正誤と対応しているかまで確認するとよいでしょう。順位を見るためのベンチマークと、運用しきい値を決めるための検証は分けて考えるべきです。
画像の位置特定ではd3-turboを下回る結果
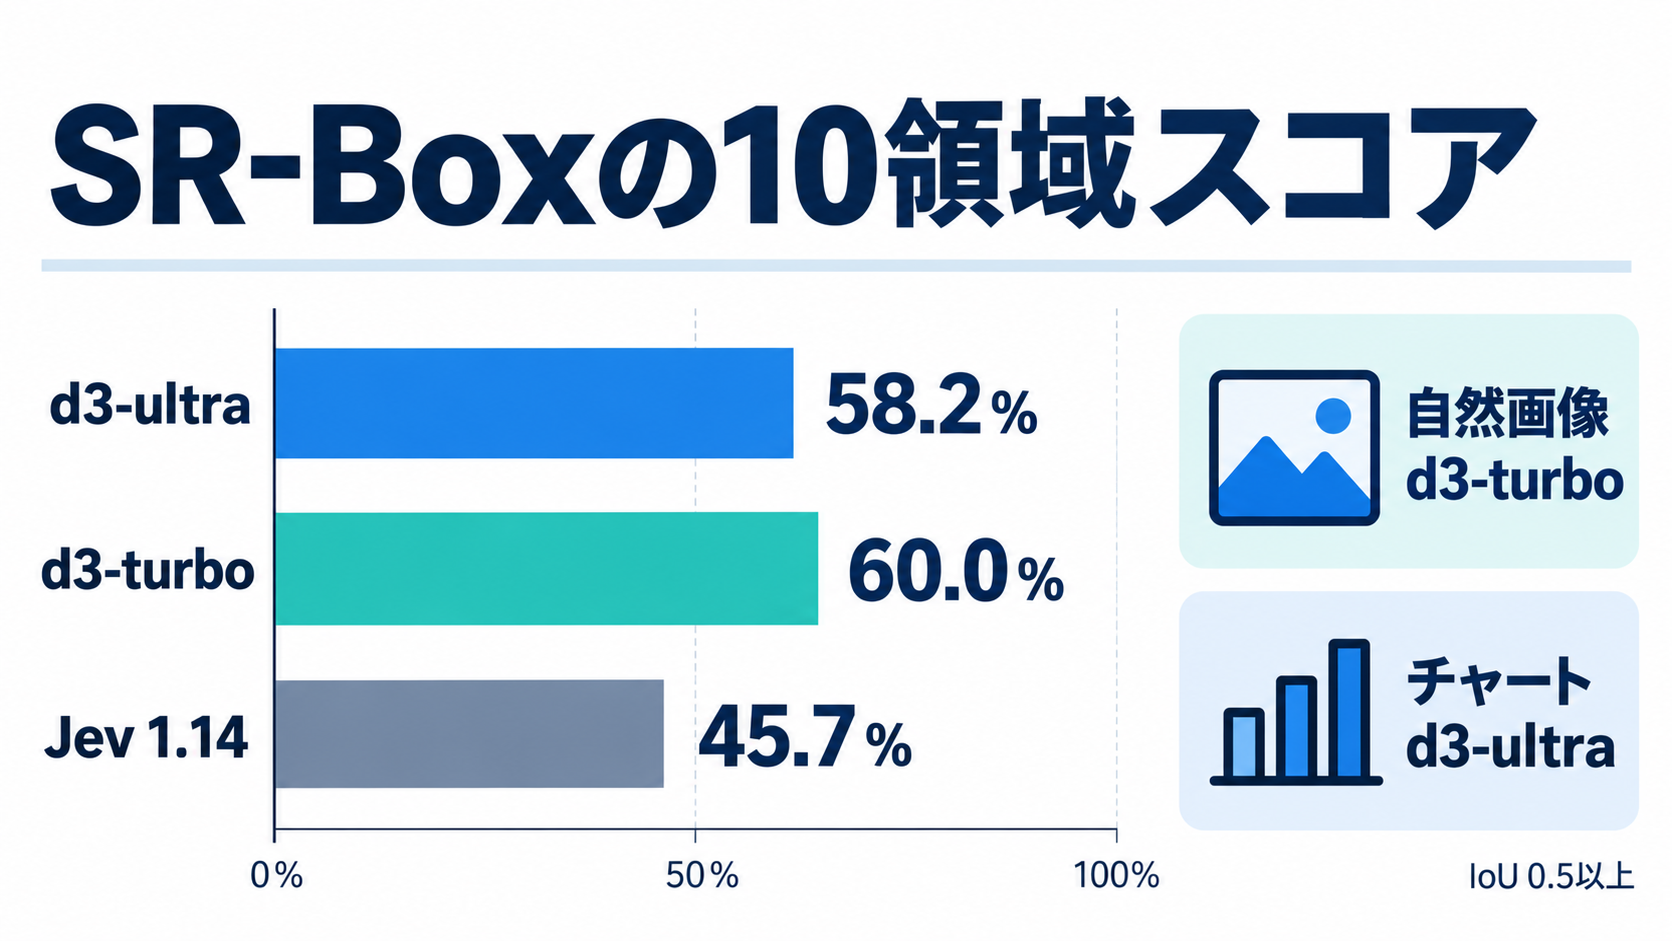
画像内の対象位置を答えるSR-Boxでは、d3-ultraの強みと限界がより明確に表れています。このテストは4,984枚の画像に対する5,678問で構成され、10領域を対象としています。予測した矩形と正解領域の重なりを示すIoUが0.5以上の場合に正解として扱われます。d3-ultraの成績は10領域で58.2%、特定の1領域を除く9領域では54.6%でした。d3-turboはそれぞれ60.0%と59.6%で、9領域の集計ではd3-ultraを5.0ポイント上回ります。Jev 1.14は10領域で45.7%、9領域では46.9%でした。最大規模のd3-ultraが、すべての視覚タスクで小さな兄弟モデルを上回るわけではありません。
チームの分析では、自然画像についてはd3-turboが強く、チャートではd3-ultraが優位とされています。企業で扱う画像も、店舗や工場を撮影した写真、文書のスキャン、グラフ、管理画面など性質が異なります。全体スコアだけでは、自社の対象画像に合うモデルを判断しにくいでしょう。チャート理解を重視する業務と、現実空間の物体検出を重視する業務では、試すべき候補が変わります。
Box形式は常に一つの矩形を返すため、同じ種類の対象が複数存在する画像では、期待する対象を質問文で明確にする必要があります。信頼度が低い回答を対象不在として扱うしきい値も、誤検出と見逃しのどちらを重く見るかによって調整しなければなりません。安全確認や品質検査のように見逃しの影響が大きい用途では、自動判定だけで処理を完了させない設計が妥当です。
SR-Boxの結果は、テキスト判断での首位を、そのまま視覚的な位置特定能力へ読み替えられないことを示しています。画像とテキストを一つのモデルで処理できる利便性を評価しながらも、主要な視覚タスクでは専用モデルやd3-turboとの比較を行うべきでしょう。
4つの導入経路と運用時の確認点
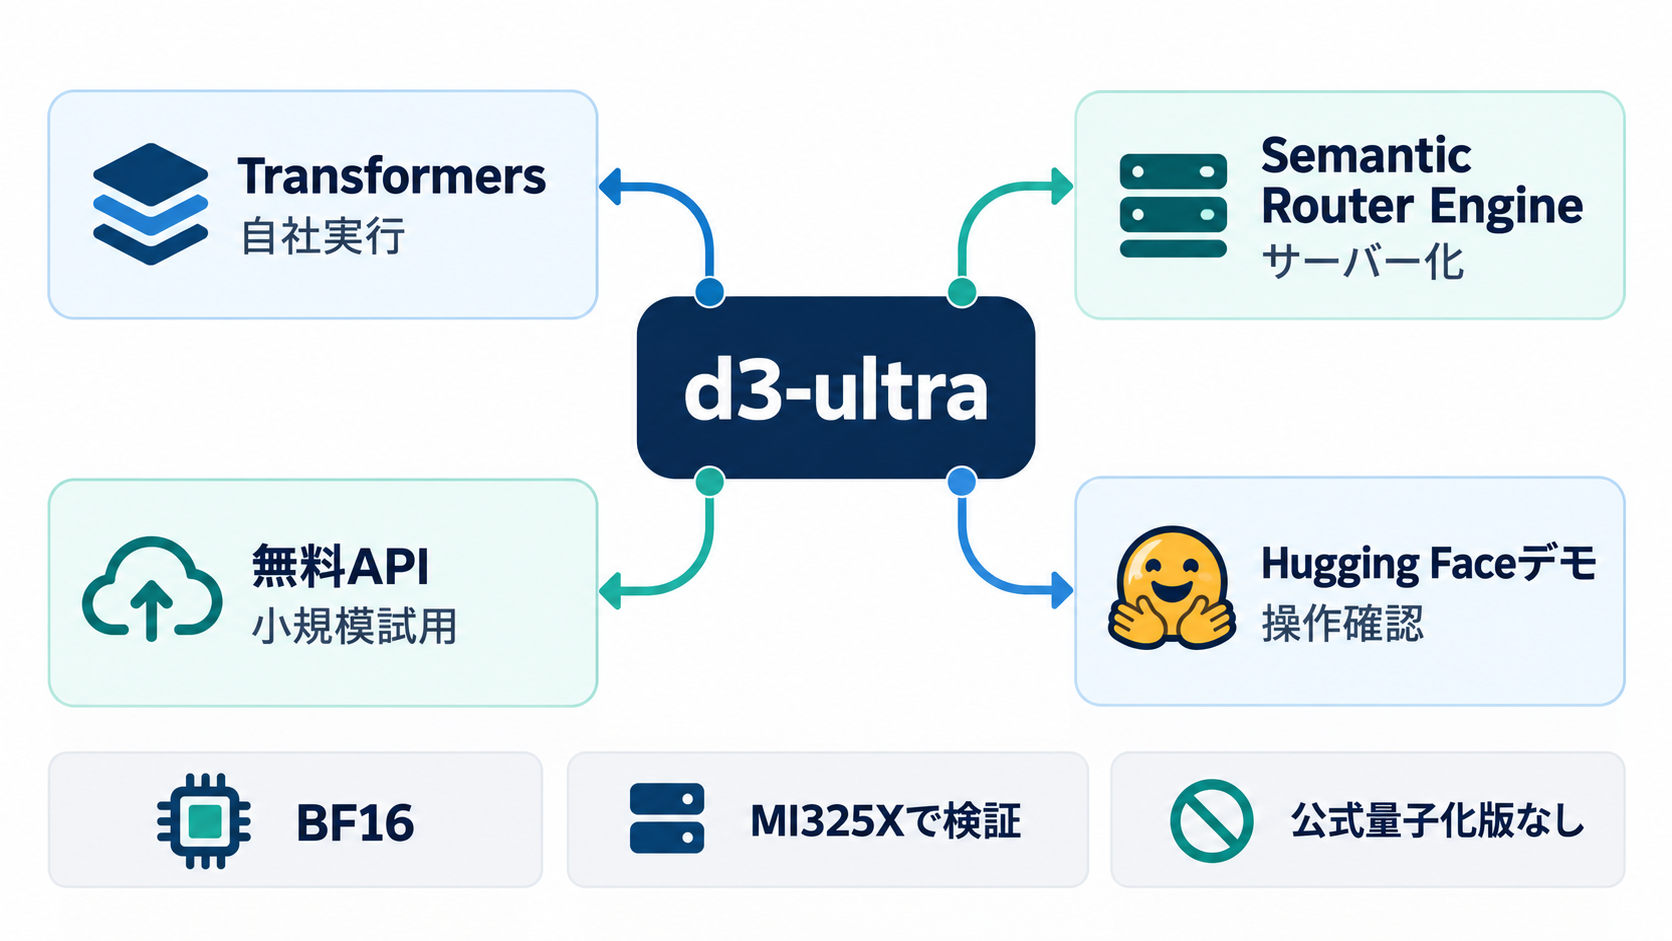
d3-ultraには、ローカル実行から試用環境まで4つの利用経路が用意されています。Transformersでは、transformers 5.17.0とAutoModel.from_pretrainedを使い、vllm-sr/d3-ultraを読み込みます。この方法ではtrust_remote_code=Trueが必要です。外部リポジトリの実装コードを実行する設定になるため、企業環境ではコードの内容、依存関係、更新手順を事前に確認することが望まれます。任意のflash-linear-attentionパッケージを追加すると、高速なGPUカーネルを利用できます。vLLM Semantic Router Engineでは、vllm-sr serveコマンドからモデルを提供でき、この対応は2026年10月25日のPR #5449で追加されました。自社サービスから呼び出す場合は、認証、同時実行制御、タイムアウト、モデル更新時の回帰テストも運用設計へ含める必要があります。
インフラを用意せずに試す経路として、decision.vllm-sr.aiの無料APIが案内されており、モデルカードでは無料キーを取得できるとされています。公式のHugging Face Spaceにはデモもあります。機密情報や顧客データを扱う企業は、試用のしやすさだけで外部APIを選ばず、データの送信範囲、保存方針、利用条件を確認しなければなりません。
Apache-2.0のオープンウェイトであることは、自社管理環境への配置や実装の検証を進めやすくします。半面、公式な量子化版が掲載されていない現状では、GPUコストを抑えたい組織が独自に量子化する場合、精度低下を含む再評価が必要です。BF16での単一GPU測定値も、量子化後や異なるGPUで同じになるとは限りません。
導入経路は、デモで入出力を確認し、APIで小規模な業務データを試し、要件を満たす場合に自社運用を検討する順序が現実的です。ただし、外部送信できないデータを使う場合は、最初から隔離した検証環境でセルフホストする選択肢もあります。どの経路でも、モデルの精度だけでなく、障害時の代替処理とバージョン固定を含めて評価する必要があります。
企業導入では「共通の判断レイヤー」として検証
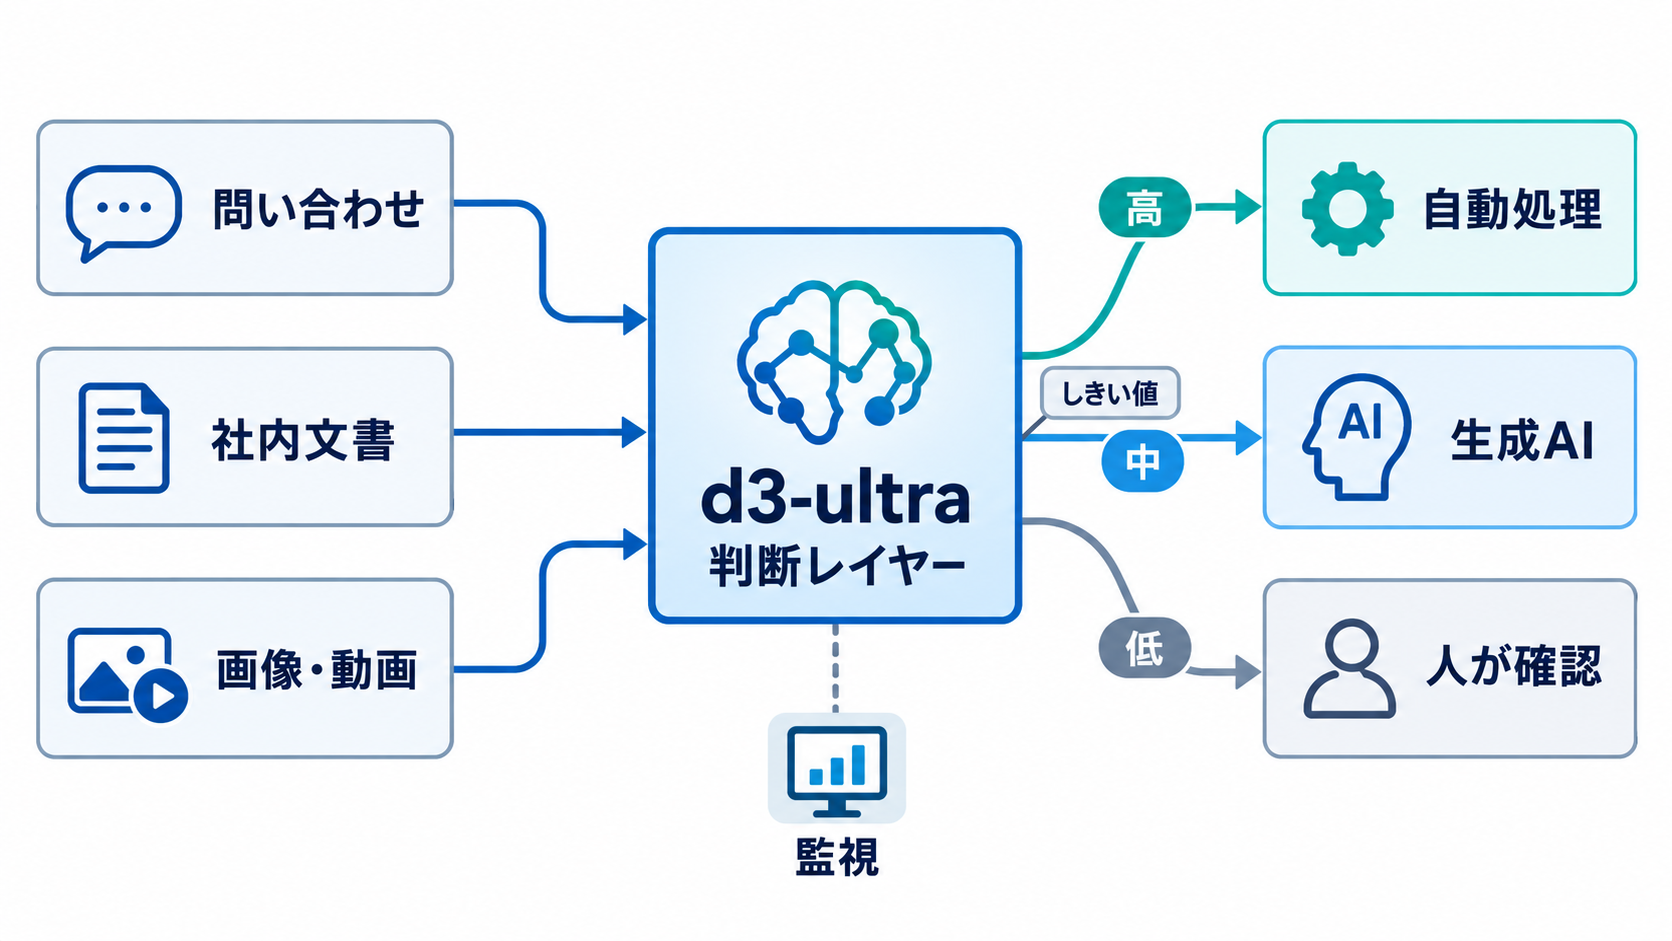
d3-ultraが企業システムにもたらし得る変化は、個々の分類精度だけではありません。テキスト分類、画像上の位置特定、動画確認といった異なる処理を、状態と質問という共通形式へ寄せられる点にあります。業務ごとに専用分類器を構築してきた企業では、推論インターフェースや監視方法をまとめられる可能性があります。例えば、問い合わせ受付では、d3-ultraが製品カテゴリ、緊急度、必要なツールを判定し、その結果を受けた生成モデルが回答案を作る構成が考えられます。画像を伴う保守受付なら、対象機器の種別や異常箇所の候補も同じリクエストで確認できます。ここでd3-ultraに文章作成まで期待せず、判断と生成の役割を分けることが設計上の要点です。
確率が返るからといって、その数値を無条件に信頼度として扱えるとは限りません。予測確率と実際の正答率が対応しているかを業務データで調べ、用途ごとにしきい値を設定する必要があります。確率が高い案件だけを自動処理し、中間域を人へ回し、低い場合は再入力や別モデルへ切り替える構成なら、段階的な導入がしやすいでしょう。
評価では、SR-Textの総合順位、SR-Boxでのd3-turboとの差、非公開テストによる自己申告値という3点を同時に見る必要があります。ツール選択やチケット分類では有望な結果が示されていますが、自然画像の位置特定までd3-ultraへ統一することが最適とは限りません。モデル数を減らす運用上の利点と、個別タスクで専用モデルを使う精度上の利点を比較すべきです。
採用判断の第一歩は、代表的な業務データを匿名化して小規模な評価セットを作り、現在のルールやモデルと並行稼働させることです。正答率だけでなく、誤判定の種類、確率の妥当性、質問を追加した際の遅延、GPU使用量を記録します。その結果から、自動化できる範囲と人の確認を残す範囲を決めれば、ベンチマークの順位に依存しない導入判断へつなげられます。