
AI LAB
2026/10/20
Cloudflare「Clairic」が示す生成AI業務設計の転換点――抽出・判断・文章生成を分ける理由
LLMにすべてを任せない業務設計
請求書から合計金額と日付を読み取り、問い合わせメールから注文番号を抜き出してJSONに格納する――こうした処理には、文章を巧みに生成する能力よりも、指定された項目を速く、決められた型で返す能力が求められます。CloudflareがWorkers AIでプレビュー公開した「Clairic」は、このデータ抽出工程に特化したモデルです。テキストまたは画像を受け取り、自由記述の回答ではなく、数値、日付、期間、リストなどの型付きデータを返します。多くの企業では、汎用LLMに「この文書から必要項目をJSONで返してください」と指示しています。ただし、この方法では、回答を文章として生成した後にJSONの形式を確認したり、存在しない値が補われていないか検証したりする工程が必要です。Clairicは要求された各フィールドを、推論過程や文章生成を伴わない1回のフォワードパスで処理します。出力トークンに対する課金もありません。モデルの役割そのものを抽出に絞ることで、速度と挙動の一貫性を確保しようとしています。
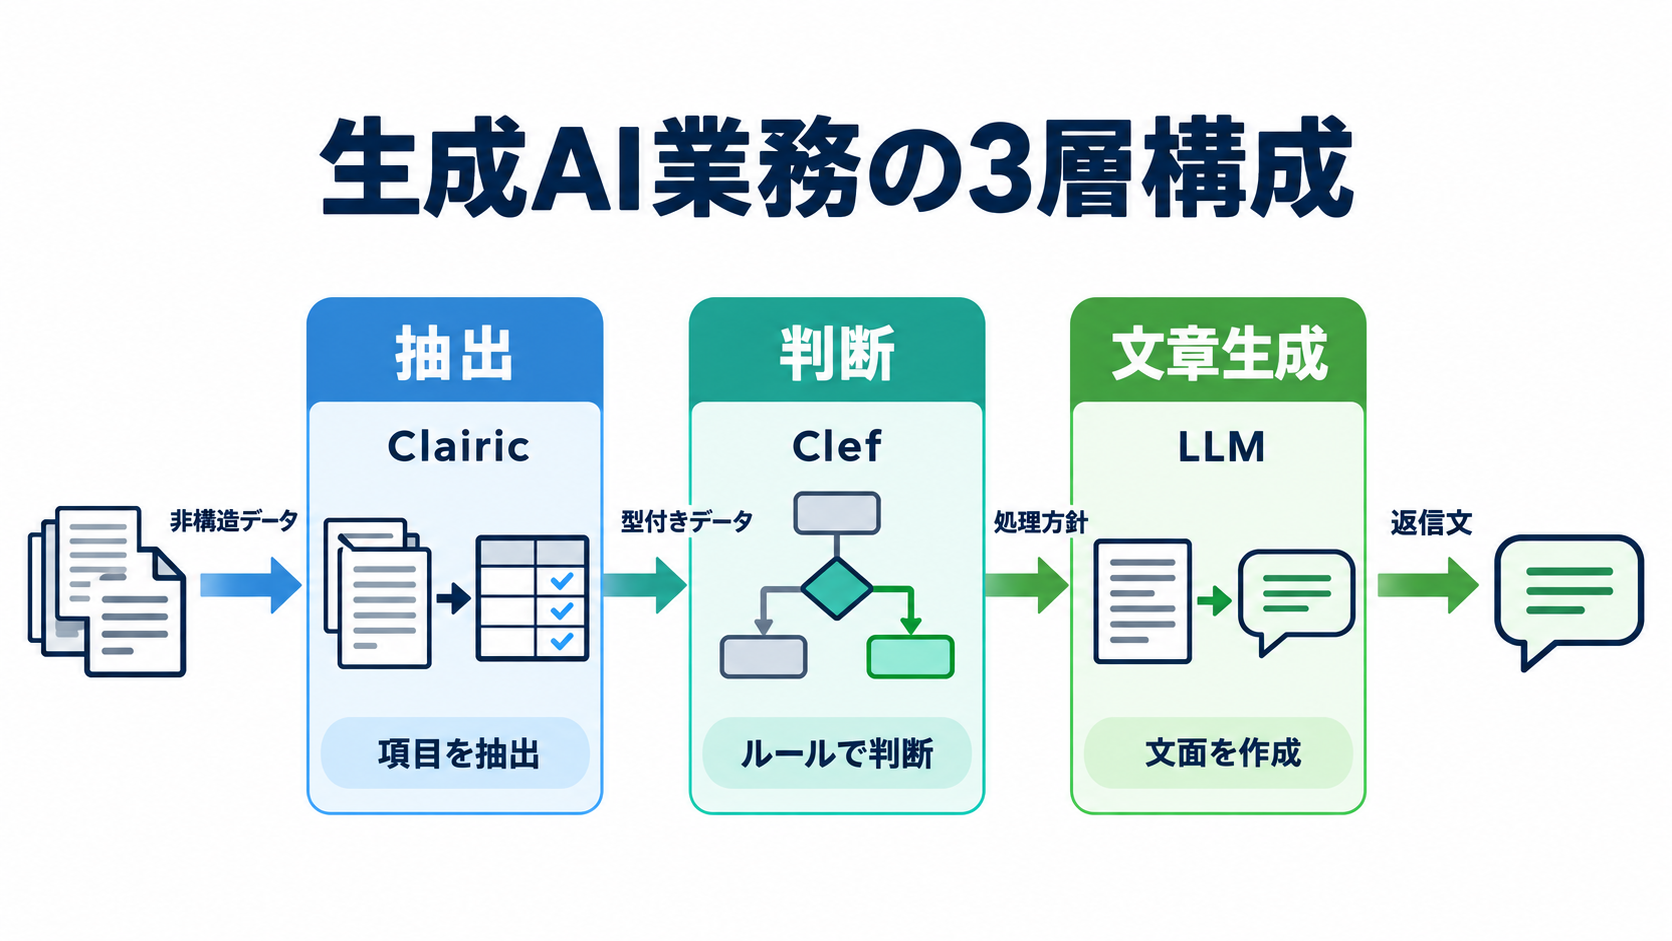
重要なのは、ClairicがLLMを全面的に置き換える製品ではない点です。Cloudflareが示す構成では、抽出モデルが入力を型付きデータへ変換し、意思決定モデルがその値を基に処理方針を選び、LLMが最終的な文章を作ります。業務全体を一つの巨大なプロンプトに詰め込むのではなく、性質の異なる処理を分ける発想です。企業向け生成AIでは、モデル単体の性能だけでなく、どの工程をどの種類のモデルに担当させるかが、処理時間やコスト、監査のしやすさを左右するでしょう。
型・欠損確率・根拠位置まで返す仕組み
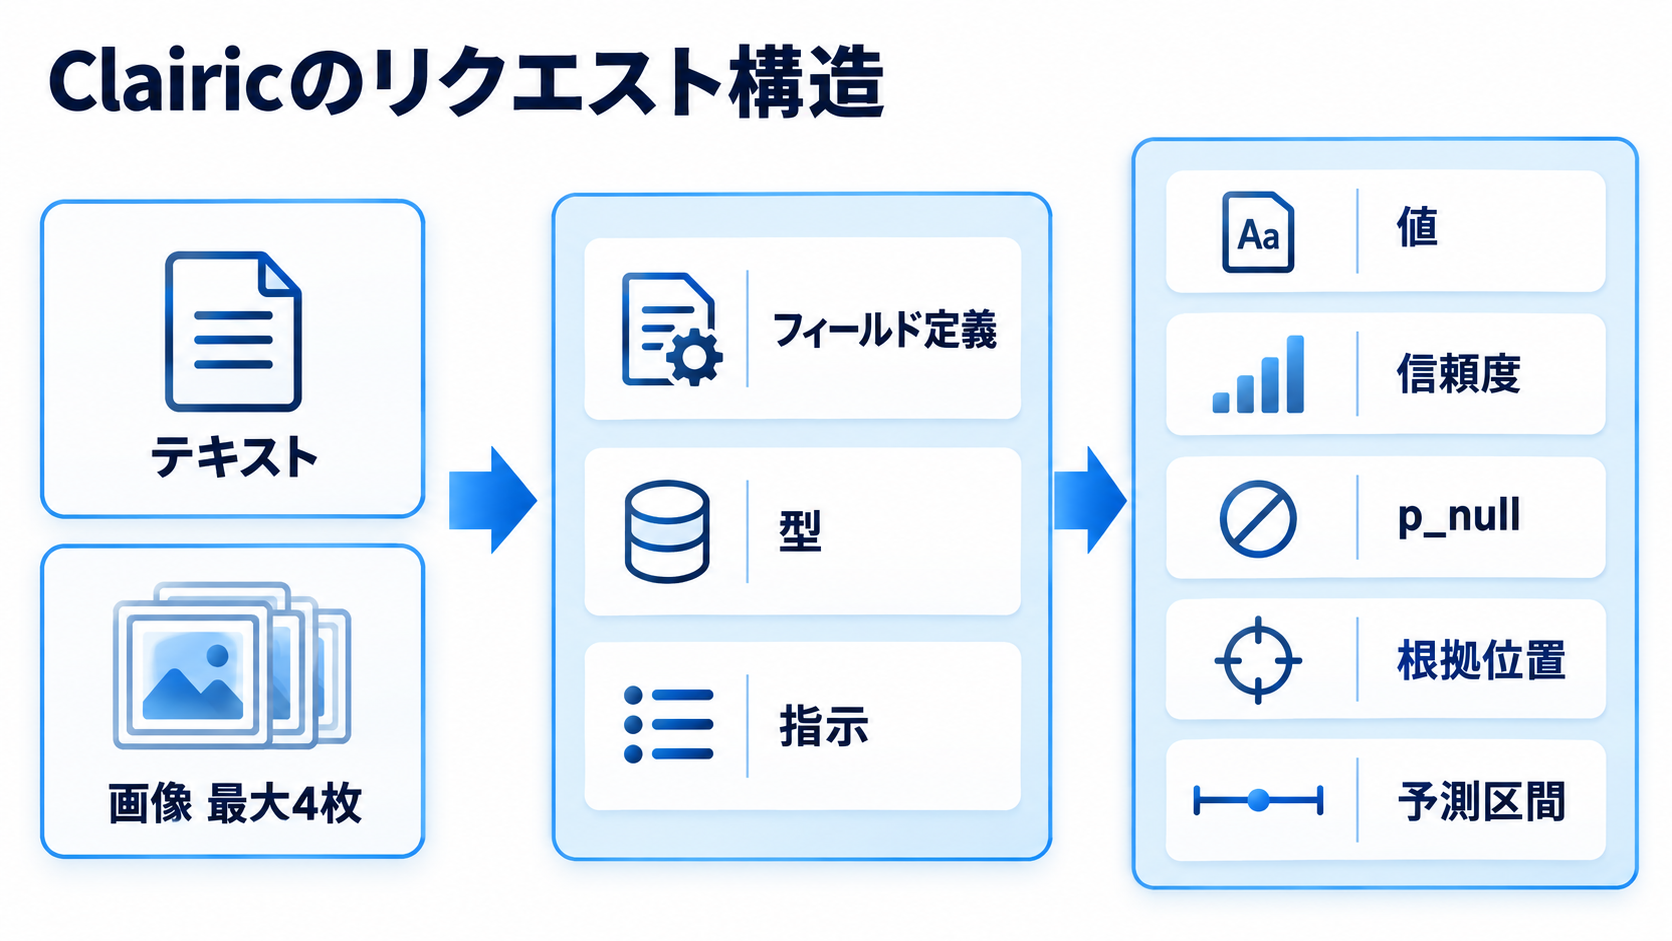
Clairicへのリクエストは、処理対象となる「state」と、抽出したいフィールドの定義で構成されます。stateにはテキストと最大4枚の画像を含められます。フィールドは名前とデータ型を指定するほか、「請求書に記載された支払期限を取得する」といった自然言語の指示も付けられます。Workers AIの変更履歴で示されている型は、テキスト、数値、日付、時刻、日時、期間、リスト、推定値、予測値です。単に値を返すだけではありません。スカラー値には信頼度と、対象の値が入力内に存在しない確率を示す「p_null」が付きます。テキスト型では、抽出元となった文字列と文字位置のオフセットも返されるため、利用者が元の文書上で根拠を確認できます。推定値と予測値には中央値に加えて、p10からp90までの80%区間が示されます。予測では最大64ステップ先まで扱えます。確信の度合いや根拠位置を後続処理に渡せる点は、値だけをJSONで返す一般的なLLM利用との違いです。
指定できるフィールド数に明示的な上限はありませんが、一度の処理単位では入力文とフィールド定義を8,192トークン以内に収める必要があります。収まらない場合は複数の並列パスに分割され、それぞれが入力全体を参照します。モデル全体のコンテキストウィンドウは65,536トークンです。「各フィールドを1回のフォワードパスで回答する」という説明は、リクエスト全体が常に単一パスになるという意味ではありません。項目数が多いスキーマでは処理が分割されるため、設計時には文書の長さだけでなく、フィールド名や指示文が占めるトークン数も考慮する必要があります。
抽出・判断・文章生成を分担する3層構造
Clairicの背景には、人間の速く直感的な思考を表す「システム1」の考え方があります。この呼称は、行動経済学で知られるダニエル・カーネマンの思考モデルに由来します。TypeSafe AIの「Jev」も同じ発想を掲げていますが、JevとCloudflareの「Clef」は、あらかじめ列挙された選択肢を評価する意思決定モデルです。これに対してClairicは、請求総額や日付、修理費用のように、事前に候補を列挙できない値を扱います。Cloudflareが示した3層構造では、Clairicが非構造データから事実や推定値を抽出し、Clefなどの意思決定モデルが選択肢ごとの確率を計算します。その決定を顧客向けの自然な文章へ変換する段階で、Z.aiの推論LLM「GLM-5.3」などを利用します。抽出、判断、表現という異なる仕事を、それぞれに適したモデルへ割り当てる構成です。
この分離は、企業システムの責任範囲を整理するうえでも意味を持ちます。たとえば返金申請で誤った回答が送られた場合、抽出した金額が誤っていたのか、返金条件の選択が誤っていたのか、文章化の段階で表現が変わったのかを切り分けやすくなります。すべてを一つのLLMに処理させる構成では、同じプロンプト内で事実認識と判断と文章生成が混在します。専用モデルを組み合わせる方式なら、各段階の入力と出力を記録し、個別に評価できます。ただし、構成要素が増える分、モデル間で受け渡すデータ型やエラー時の処理ルールを明確にする必要があります。
返品対応で示された速度とコストの差
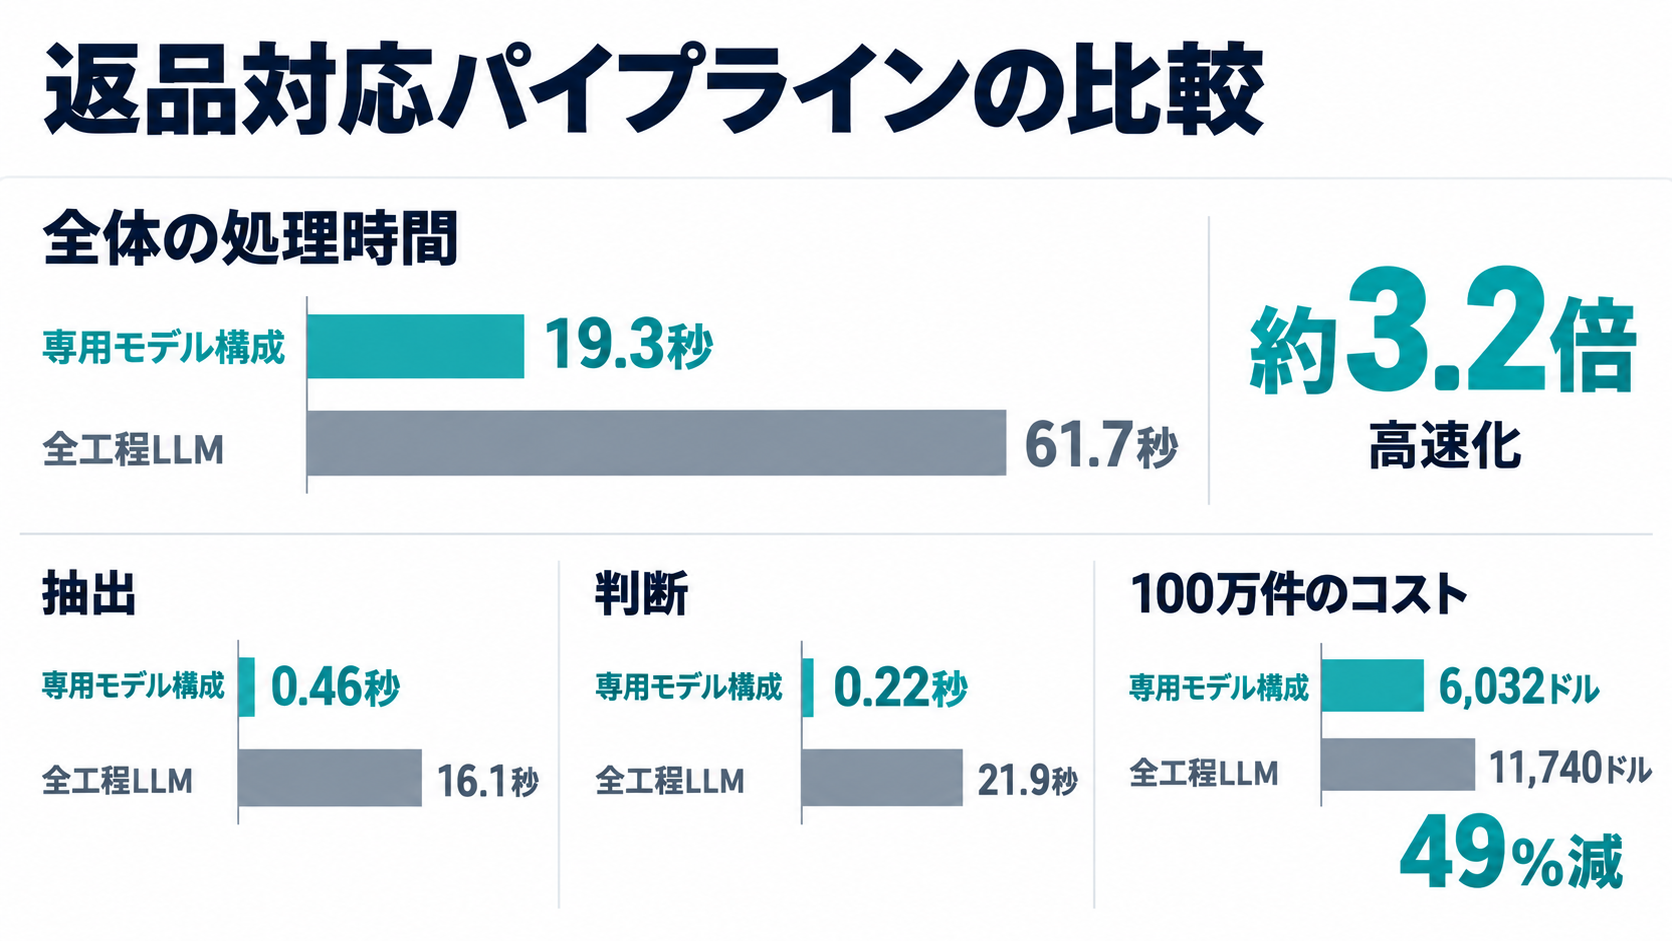
Cloudflareは、破損商品の申請処理を題材に、専用モデルを組み合わせる構成と、GLM-5.3に全工程を担当させる構成を比較しました。専用モデル側では、Clairicが申請内容から事実を抽出し、Clefが返金または修理を選び、GLM-5.3が返信文を作成しています。全工程をGLM-5.3で処理した場合は61.7秒でしたが、役割を分けた構成では19.3秒となり、約3.2倍の速さでした。差が特に大きかったのは、抽出と判断です。Clairicによる抽出は0.46秒で、GLM-5.3による抽出は16.1秒でした。Clefの判断は0.22秒、GLM-5.3では21.9秒です。100万件当たりの費用についても、全工程をGLM-5.3で実行する構成の11,740ドルに対し、分業構成では6,032ドルとなり、Cloudflareの試算では49%減少しました。ただし、これは同社が用意した一つの業務パイプラインによる比較であり、あらゆる文書や業務で同じ差が生じると確認されたわけではありません。
両方の構成で、事実抽出と処理方針の判断自体は正解しました。修理費の推定では、Clairicが実行ごとに同じ値を返したのに対し、GLM-5.3は250ドル、250ドル、220ドルと変動しています。Cloudflareによると、Gemma 4とQwenを使った全工程LLM版は、この検証を完了できませんでした。分業構成でも返信文の作成には18.6秒を要しており、全体19.3秒の大部分を占めています。つまり、専用モデルで前段を短縮しても、最終的な生成処理が遅ければ、そこがシステム全体の待ち時間を決めます。導入時にはモデルごとの速度だけでなく、処理経路全体を測定する必要があるでしょう。
成功例だけでは判断できない精度上の限界
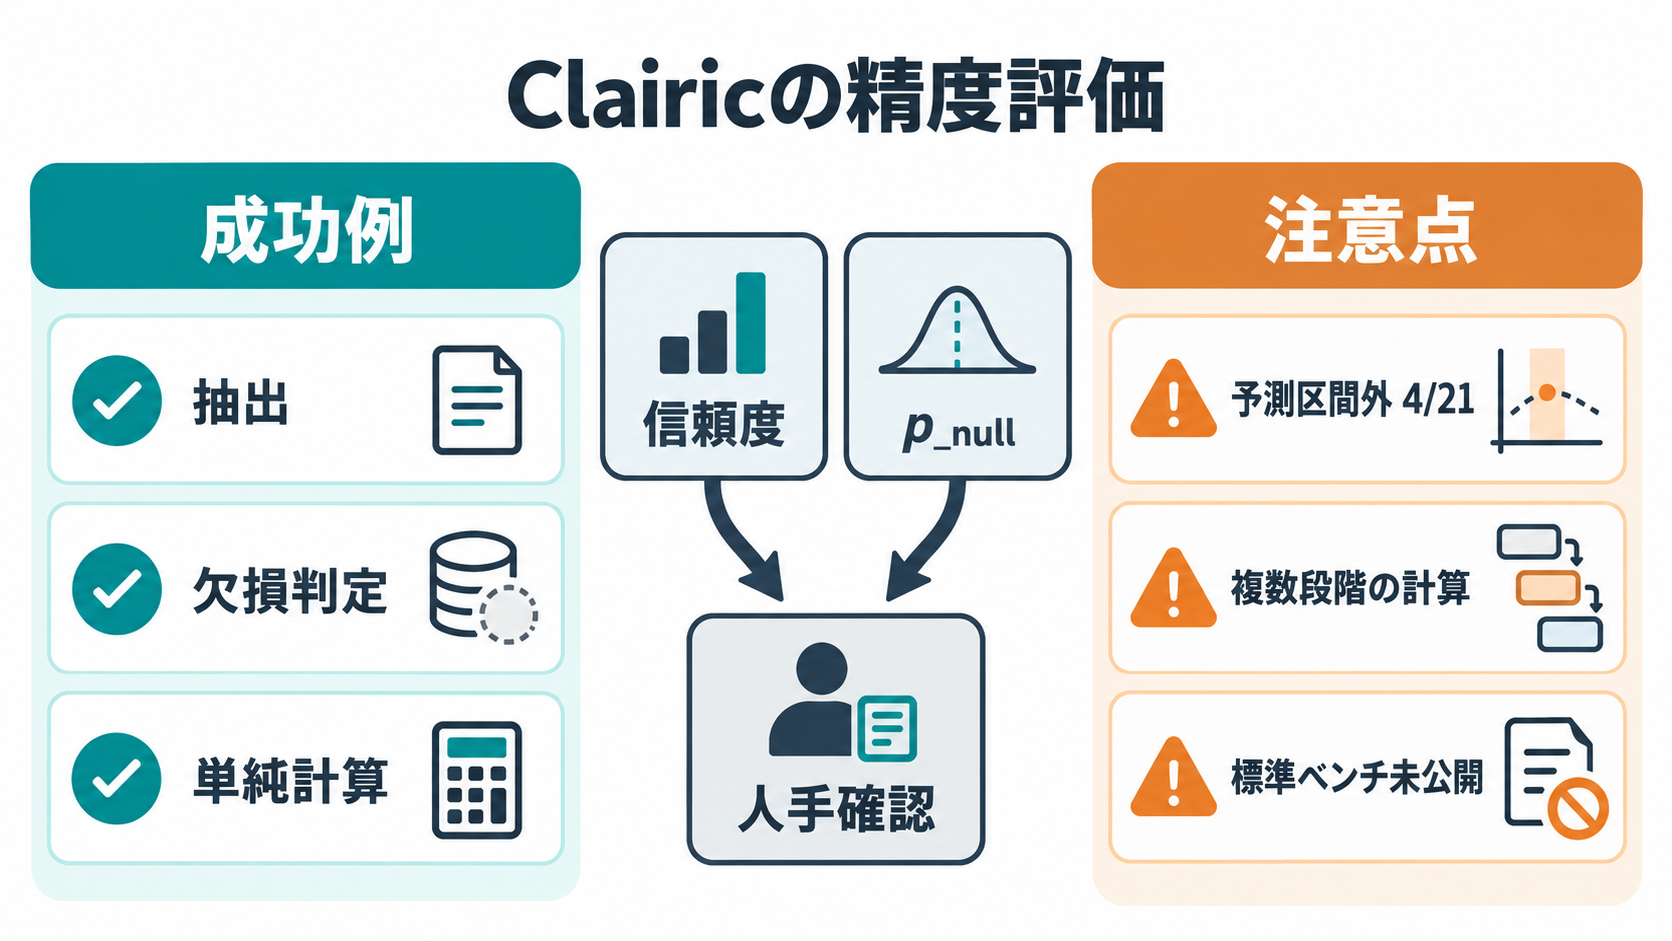
公開された例では、Clairicはサポートメールに記載された価格と税額を加算し、701.10ドルという値を返しました。配達からの経過日数も計算し、メール内に存在しない追跡番号については、もっともらしい番号を生成せずnullを返しています。傾いたレシート画像からは、実際に記載された7項目をすべて読み取り、存在しない割引をnullとして扱いました。このとき最も低かった信頼度は注文番号の0.776でした。予測機能の検証では、米国運輸保安庁(TSA)の保安検査場を通過する人数を21日分予測しています。平均誤差は3.3%で、実測値のうち17日分が80%予測区間に入りました。区間から外れた4日分のうち3日分は、米国の祝日であるコロンブス・デーの週末に集中しています。通常と異なる需要変動を含む期間では、予測区間を提示していても実測値を捉えられない場合があることを示す結果です。
注意したいのは、標準的な精度ベンチマークがまだ公開されていない点です。パラメーター数も明らかにされておらず、複数段階の算術処理については信頼性に課題があるとされています。信頼度やp_nullは、値を採用するか人手確認へ回すかを判断する材料になりますが、正解を保証する指標ではありません。企業が利用を検討する場合は、自社で実際に扱う帳票、画像品質、言語、例外パターンを含む評価データを用意し、フィールド単位で誤抽出と欠損判定を確認する必要があります。特に金額や支払期限など、誤りが直接損失につながる項目は、自動確定の基準を慎重に設定すべきでしょう。
低い単価の裏側にあるスキーマコスト
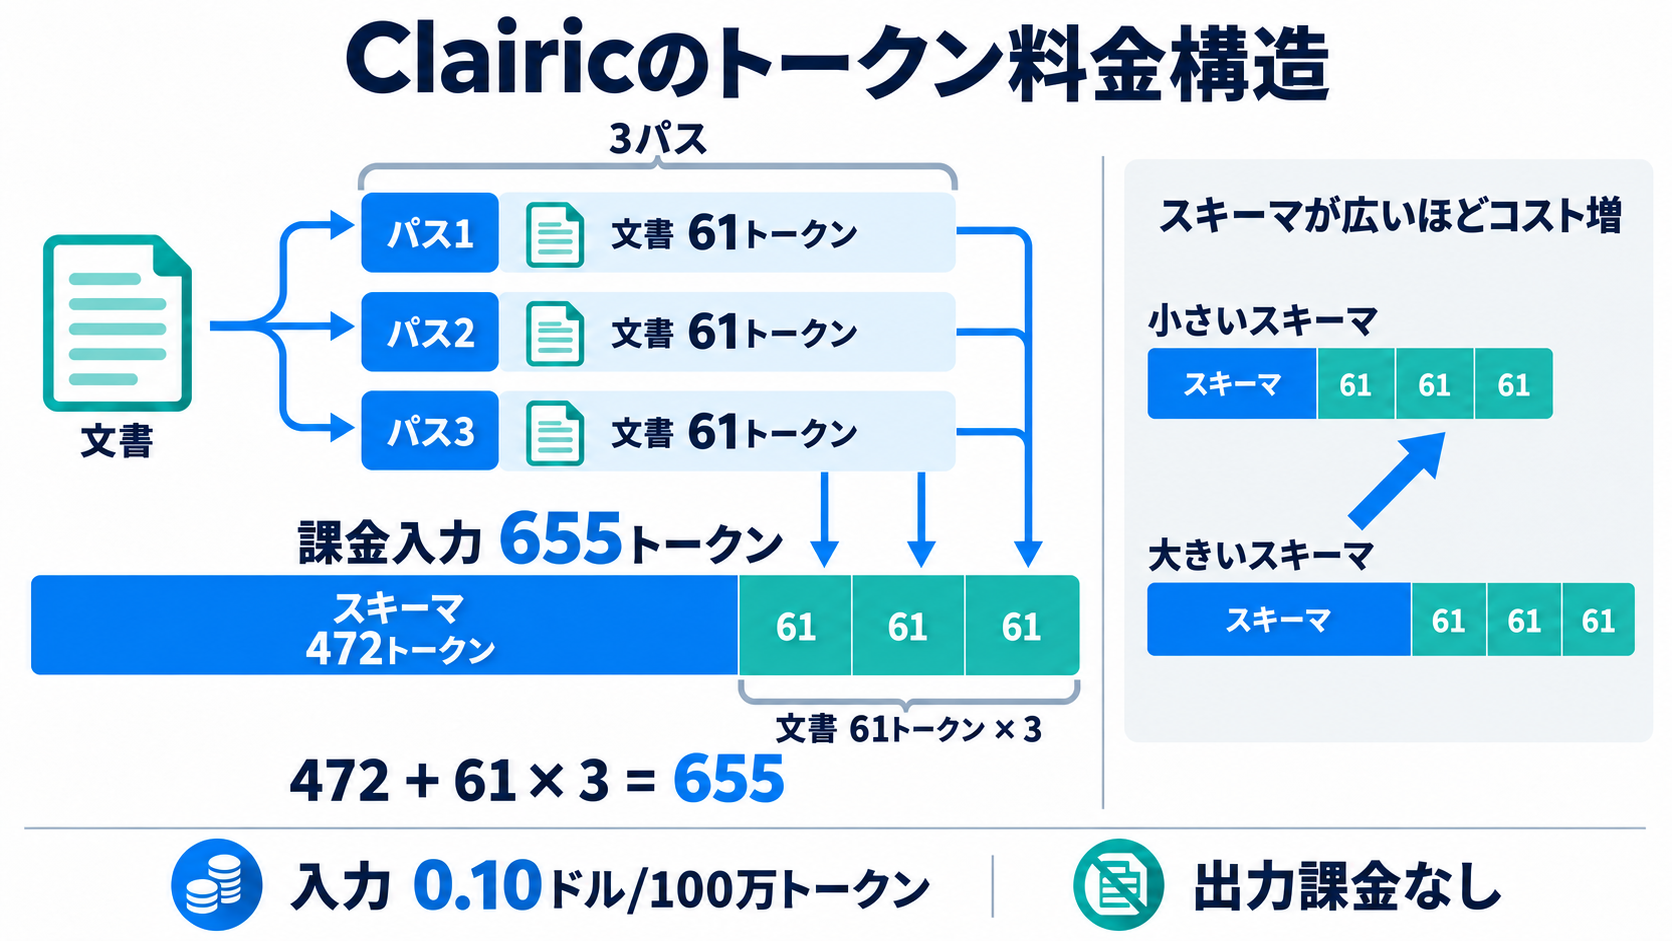
ClairicはWorkers AI上で「@cf/cloudflare/clairic」として提供され、Workers AIバインディングのenv.AI.run()またはREST APIから呼び出せます。AI Gatewayも同じエンドポイントと組み合わせられます。プレビュー時点の料金は入力100万トークン当たり0.10ドルで、出力トークンの料金はありません。比較対象では、CloudflareのClefが入力100万トークン当たり0.24ドル、TypeSafe AIのJevが0.042ドル、GLM-5.3が入力1.40ドル、出力4.40ドルとされています。単価だけを見ると安価ですが、Clairicでは抽出スキーマも入力トークンとして計上されます。ドキュメントで示された請求書の例は本文が61トークンだったものの、処理は3パスに分かれ、課金対象の入力は655トークンでした。このうち472トークンをスキーマが占めています。抽出項目が多く、それぞれに長い説明を付ける構成では、対象文書よりスキーマのほうが高コストになる可能性があります。フィールド数を増やすほど常に得になるわけではなく、後工程で本当に使う項目へ絞る設計が必要です。
現時点ではCloudflareが運用するGPU上でのみ利用でき、ローカル実行の選択肢はありません。Cloudflareはウェイトの公開を予定していますが、まだ提供していません。機密情報を扱う企業は、料金や速度に加えて、データの送信先、保存方針、監査ログ、障害時の代替経路を確認する必要があります。また、プレビュー版では仕様や料金が変わる可能性も考慮し、本番システムへ組み込む際には依存範囲を限定しておくほうが扱いやすいでしょう。
日本企業が試すなら一業務・少数項目から
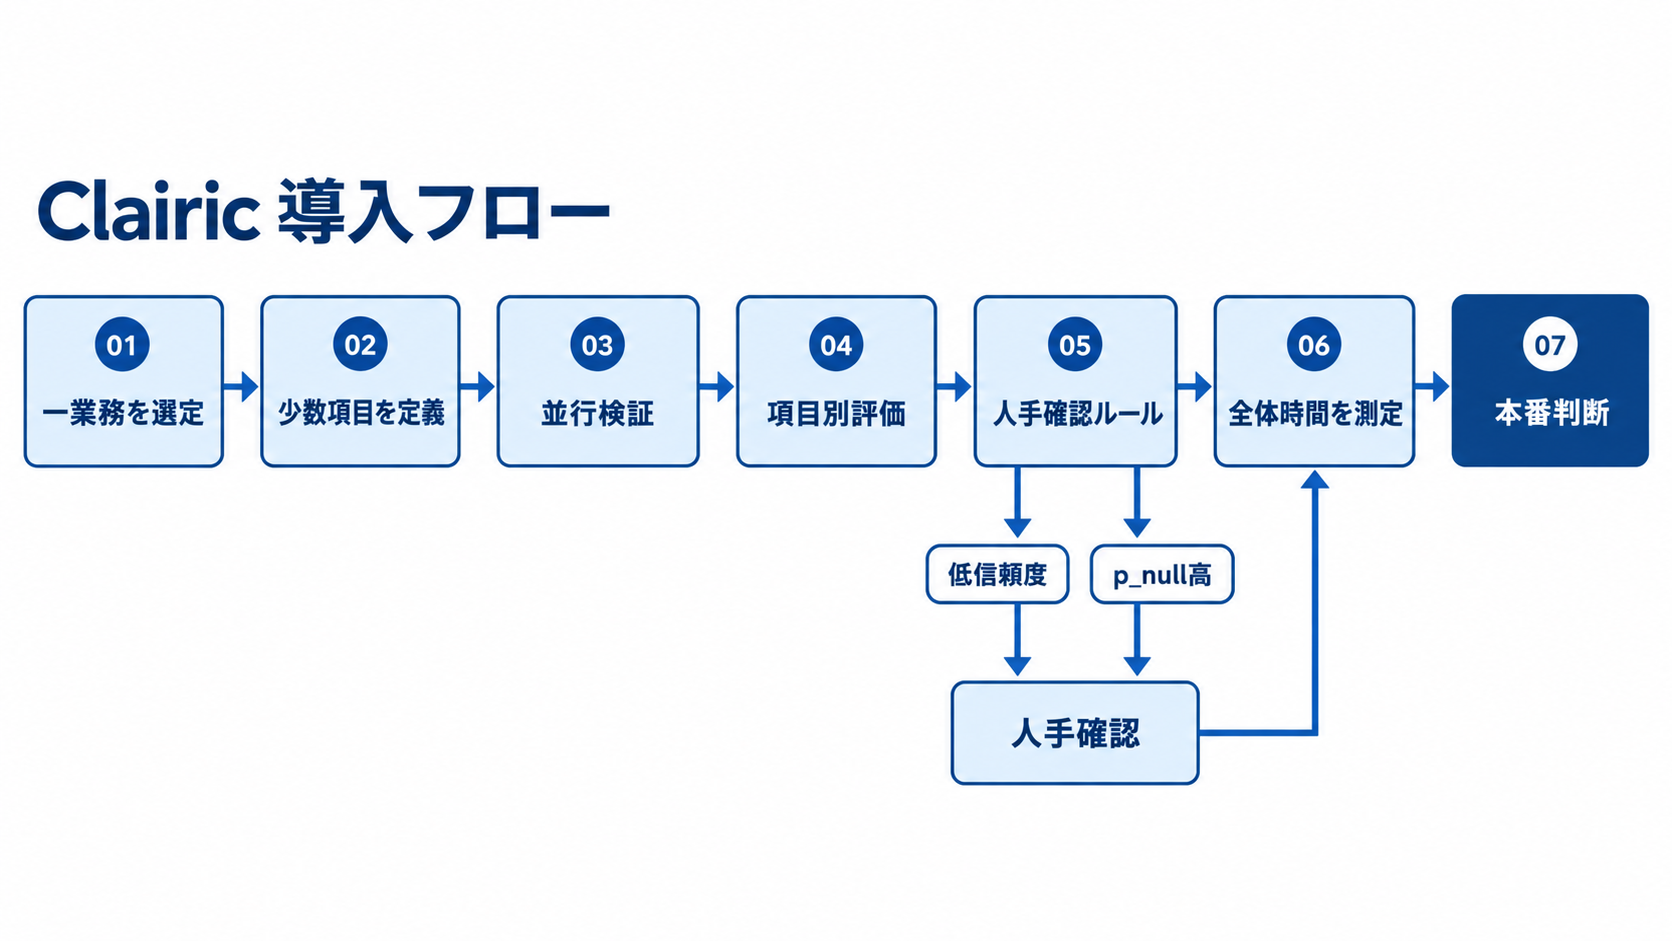
Clairicの適性を確認するには、問い合わせメールや請求書など、入力形式と必要項目を明確にできる一つの業務から始める方法が現実的です。初期検証で数十種類の帳票を統合しようとすると、モデルの能力とスキーマ設計の問題を区別しにくくなります。たとえば「注文番号」「請求額」「受付日」のように後続処理で用途が決まっている項目を選び、値、信頼度、p_null、根拠位置を保存します。既存の人手処理と並行させれば、誤抽出だけでなく、存在する値をnullと判定するケースも確認できます。評価では、文書全体の正解率だけでなく、項目ごとの業務影響を分けて考える必要があります。商品名の表記揺れと請求総額の誤りでは、同じ一件のエラーでも影響が異なります。影響の大きい項目には高い信頼度基準を設け、p_nullが一定値を超えた場合や根拠位置を確認できない場合は人手へ回す、といった分岐を用意できます。推定値や予測値については中央値だけを保存せず、p10からp90までの区間も後続の判断材料に含めるべきです。
本番化を判断する際は、抽出モデルだけの応答時間ではなく、意思決定、データベース更新、返信生成までを含めた総時間を測ります。Cloudflareの検証でも、抽出を0.46秒まで短縮した後は返信生成が主要な待ち時間になりました。速度改善の目的が顧客対応の短縮にあるなら、生成文を定型文へ置き換えられる場面や、返信を非同期化できる場面も検討対象になります。Clairicが示しているのは、単に新しいモデルを追加する選択肢ではありません。業務を「値の抽出」「規則や確率に基づく判断」「人に伝える文章」の三つに分け、各工程に必要な能力を見直す機会です。最初の一歩は、現在LLMへ渡しているプロンプトの中から、自由な文章生成を必要としない項目抽出を一つ切り出すことです。