

2026/11/13
AIニュース
PerplexityがDecider v1.3を公開、文章を生成しない判断モデルに「Locate」を追加
この記事の要点
Perplexityが、文章ではなく選択肢ごとの確率を返すDecider v1.3とFlash版を公開しました。新機能Locateは、指定した文字列を本文中の位置とともに抽出します。企業での採用判断には、自己申告の評価やAPI単価に加え、日本語での誤分類、抽出の見落とし、人による確認負担を検証する必要があります。
目次
文章を生成せず、業務の分岐を確率で返すAI
問い合わせを担当部署へ振り分けたいだけなのに、AIから長い説明文が返ってくる。企業の業務システムでは、回答の文章よりも「どの選択肢に該当するか」という判断そのものが必要になる場面があります。Perplexityが公開した「pplx-decider-v1.3」と軽量版の「pplx-decider-flash-v1.3」は、その用途に向けたモデルです。中心となるのは文章の生成能力ではなく、入力に対する選択肢ごとの確率を返す仕組みです。
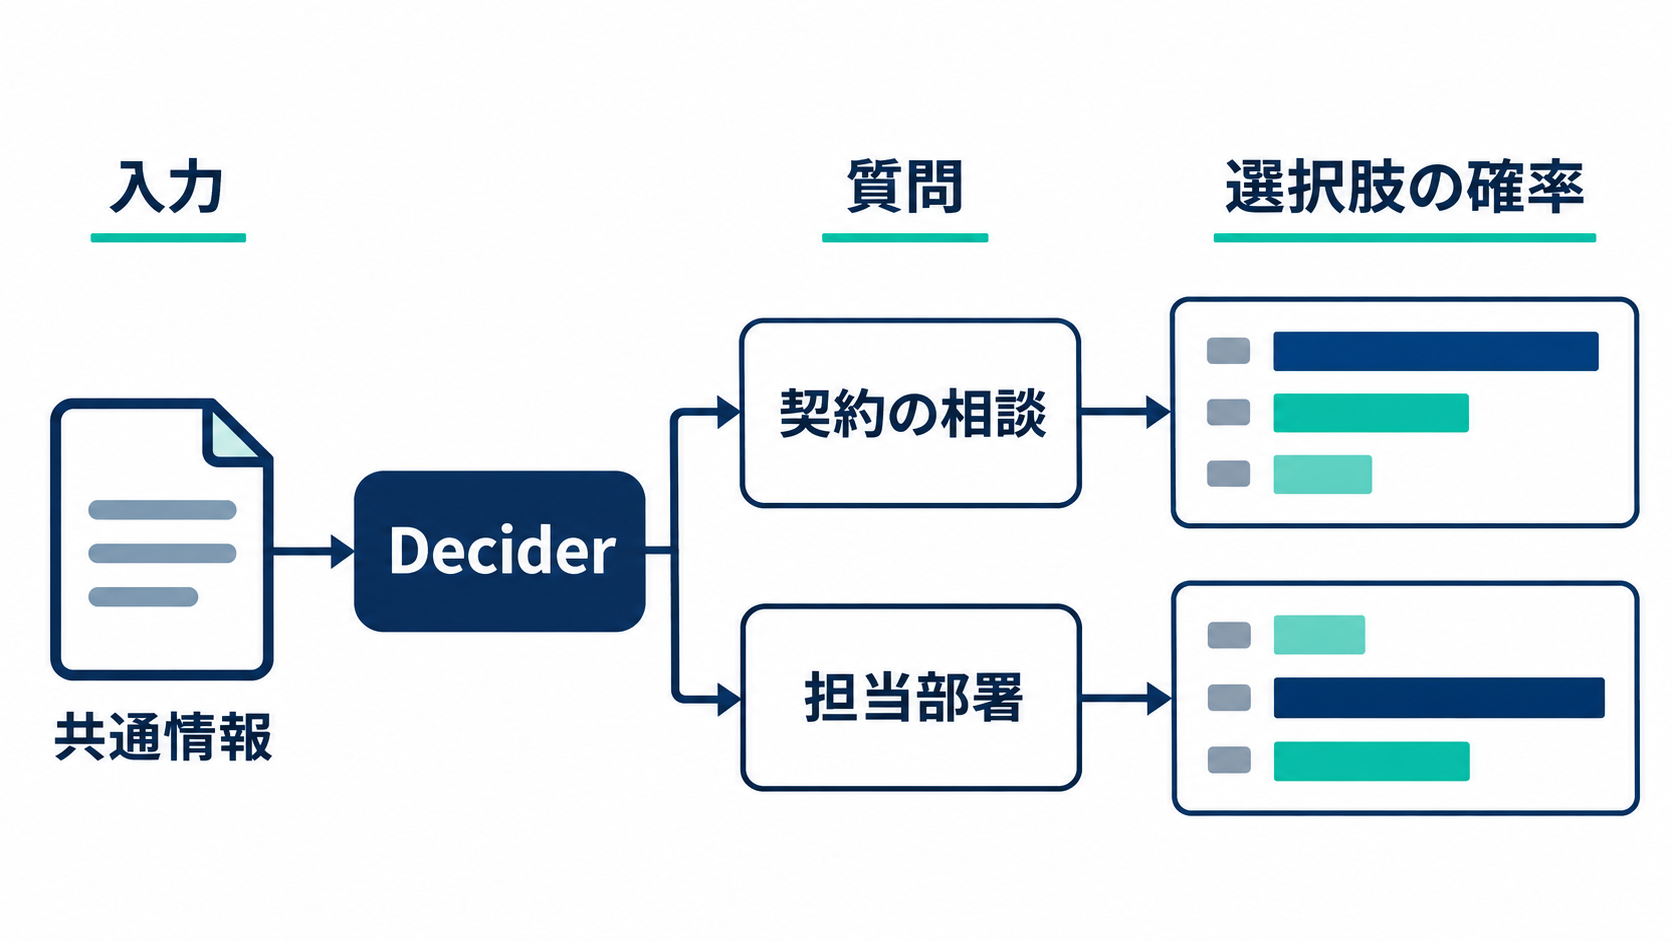
Deciderには、判断対象となる文章や画像などの共通情報を「state」として渡し、それに対する質問と、ラベルを付けた選択肢を指定します。はい・いいえの判定、複数候補からの分類、評価尺度に沿った採点に対応します。たとえば問い合わせ内容を共通情報として、「契約に関する相談ですか」「担当部署はどこですか」といった質問を組み合わせる使い方が考えられます。
この形式は、後続の処理を決める業務と相性がよいと考えられます。自由な文章から部署名を読み取る処理を設ける代わりに、あらかじめ用意した選択肢の確率を使って振り分けられるためです。ただし、最も確率が高い候補を常に自動採用する必要はありません。判断が割れる入力を人へ回す設計も可能でしょう。返された確率が実際の正解率とどの程度対応するかは、自社データで確かめる必要があります。
今回の更新を企業の視点で捉えるなら、焦点は「会話がどれだけ自然になったか」ではありません。分類や抽出を、業務の一工程としてどこまで安定して組み込めるかです。新機能のLocateも、その方向性を示しています。
Locateは必要な語句を本文中の位置とともに抽出
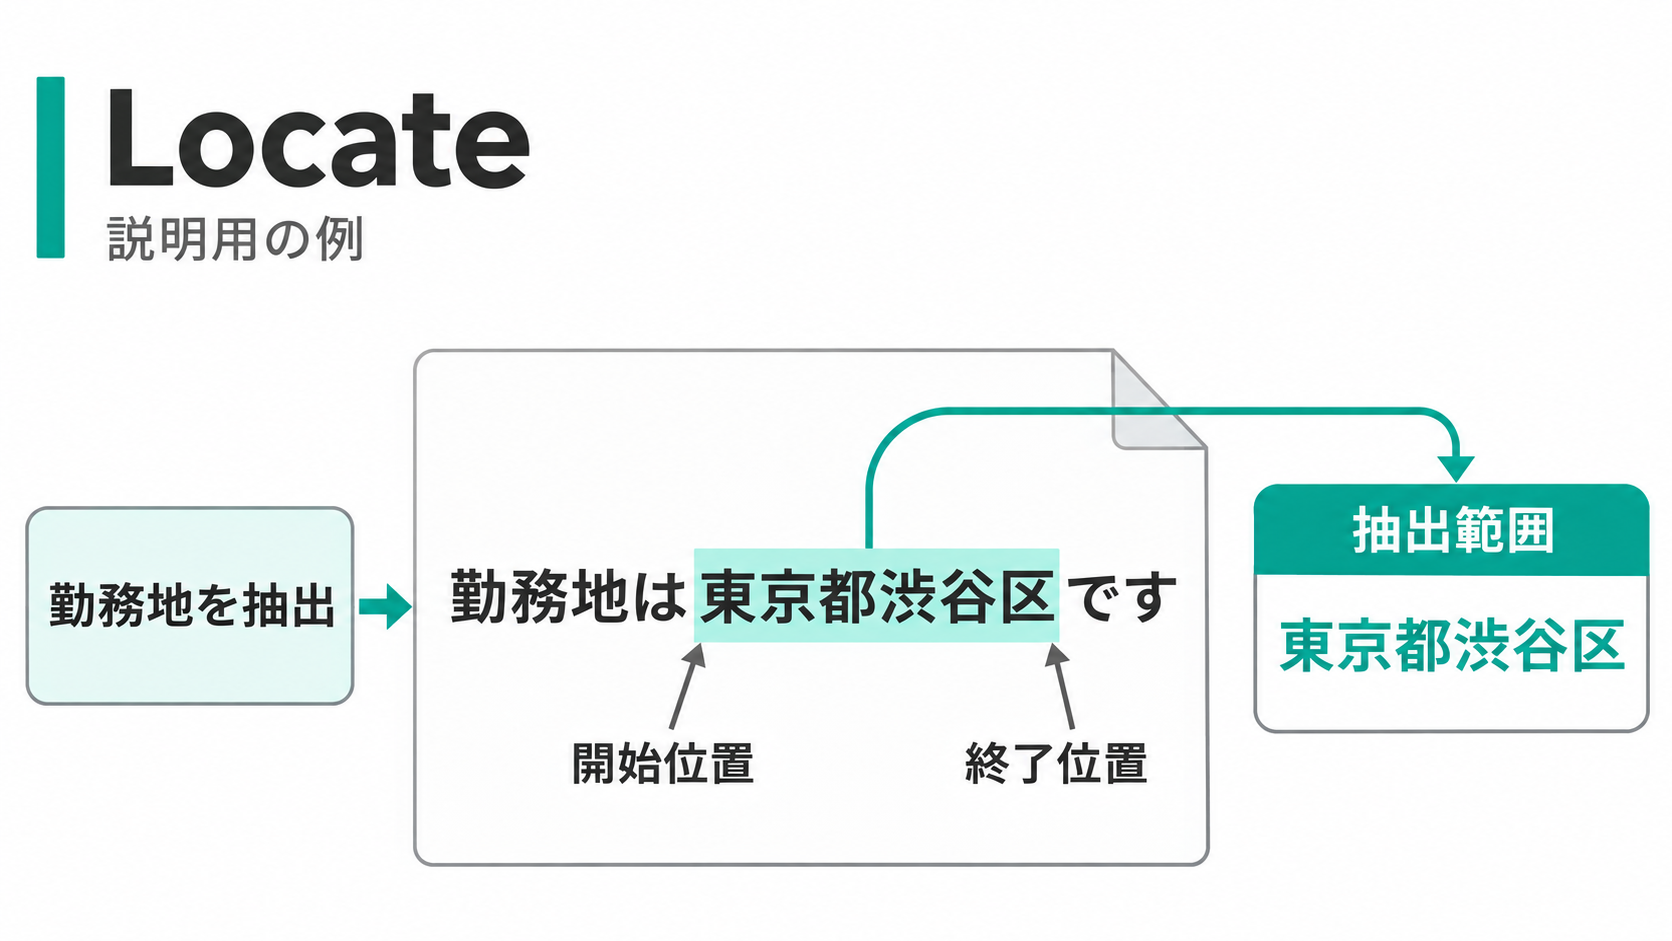
v1.3で追加された「Locate」は、入力された文章から指定の文字列を抜き出す機能です。抽出結果には、対象範囲の開始位置と終了位置が文字オフセットとして含まれます。内容を言い換えて回答するのではなく、文章内のどの部分を選んだのかを示せる点が特徴です。用途として、固有表現抽出、個人情報の検出、文章中にある答えを取り出す抽出型の質問応答が挙げられています。
指定方法は、短い項目名でも、文章による指示でも構いません。たとえば「location」というラベルに加え、「求人の勤務地となる都市名を抽出してください」といった条件を渡せます。固有表現抽出とは、人名や地名など、意味のある名称を文章から見つける処理です。Locateは、このような対象を項目や指示に沿って取り出す役割を担います。
文字列の位置が得られると、確認画面で該当箇所を強調表示したり、個人情報に当たる部分をマスクしたりする処理につなげやすくなります。もっとも、これは利用方法の例であり、抽出結果が必ず正しいことを意味しません。対象の見落としや、隣接する語句まで含める誤りがあれば、後続の表示や加工にも影響します。特に個人情報を扱う場合、抽出精度の確認は省けないでしょう。
実装では、要求する項目ごとに専用のトークンを追加し、文字列の範囲を選ぶ出力部分と、追加学習用のLoRAアダプターを訓練しています。基盤モデルと既存の判断用出力部分は固定する構成です。Perplexityの検証では、アダプターを本体へ統合すると判断精度が下がったため、分離して保持しています。なお、Locateの対象はテキストです。画像からの領域抽出と混同しないことが必要です。
複数の質問をまとめても判断が揺れにくい設計
業務で使う分類モデルには、正解率に加えて判断の一貫性が求められます。同じ問い合わせに対して、選択肢の並び順を入れ替えただけで担当部署が変われば、運用上の扱いが難しくなるためです。Decider v1.3では、複数の質問をまとめて処理するときの情報の参照方法が見直されています。この変更は、単に処理をまとめるだけでなく、質問同士の影響を抑えることを狙っています。
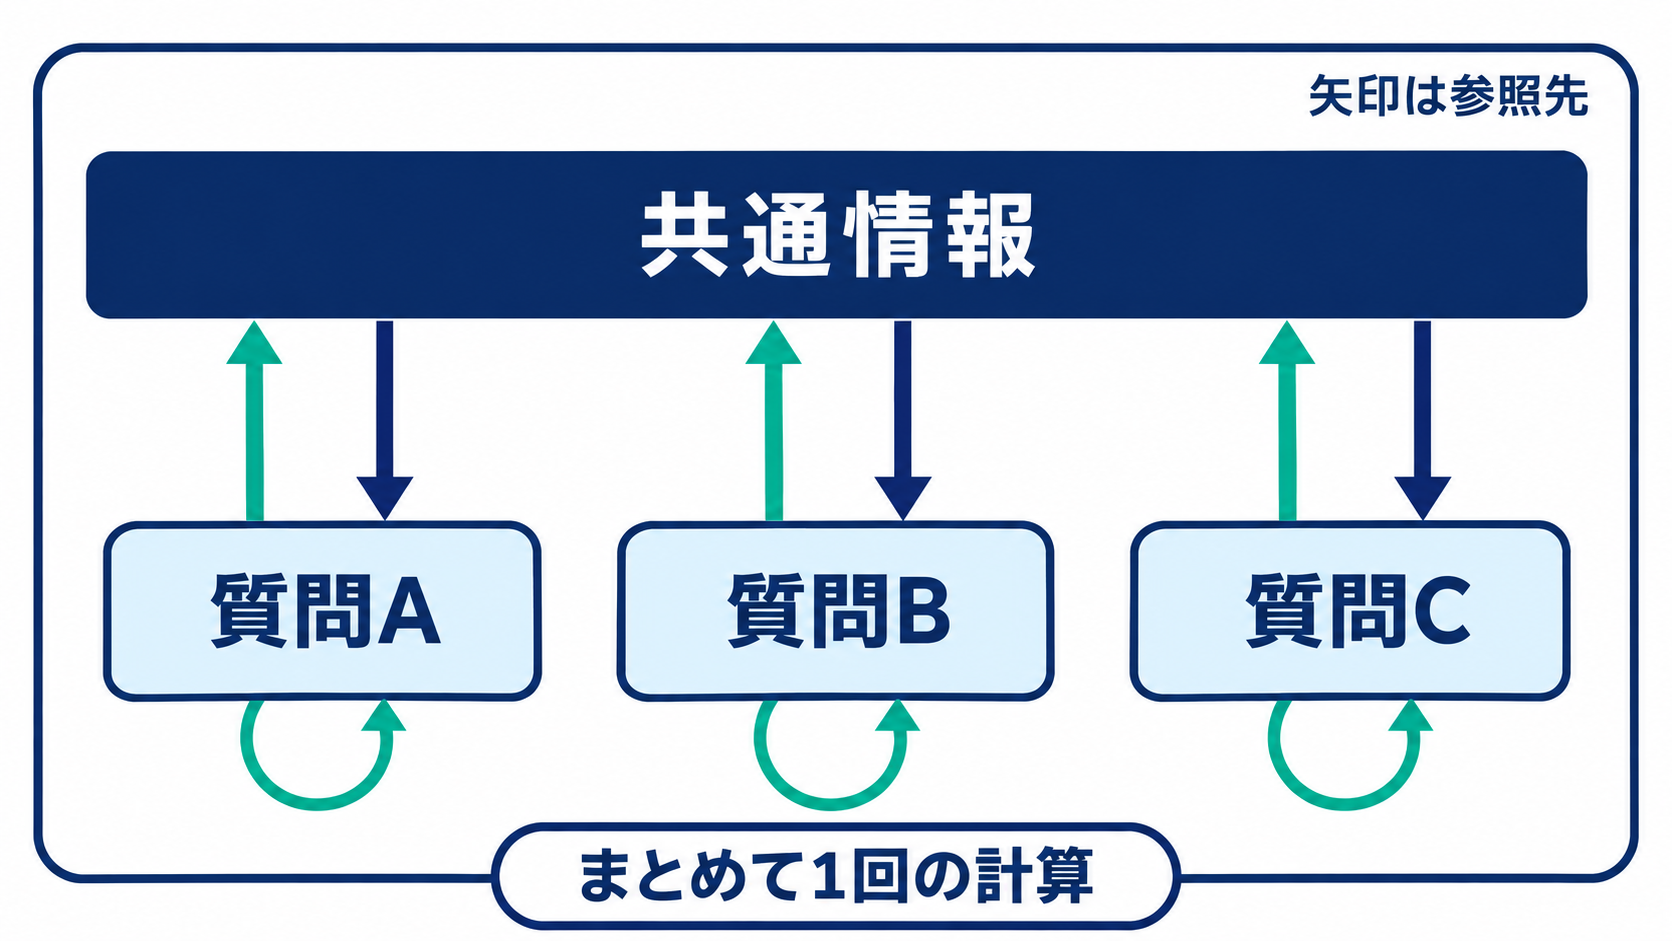
v1.2では、それぞれの質問が他のすべての質問を参照でき、組み合わせによって回答が変わる場合がありました。v1.3では、共通情報に当たるstateは全質問を参照しますが、各質問が参照する範囲をstateと自分自身に限定しています。複数の質問を一度のモデル計算で扱う構造は維持されています。業務上は、一つの文書に対する複数の確認事項をまとめながら、判断の変動を抑えるための変更と理解できます。
モデル内部では、生成型の大規模言語モデルを分類向けに調整しています。選択肢のラベルに対応する出力を利用し、専用の目印となるトークン位置の内部表現から、各選択肢の確率を計算します。また、一部の注意機構を、前後の情報を双方向に参照する方式へ変更しています。これは文章を順番に書き続ける用途とは異なり、与えられた入力全体から判断する用途に合わせた設計です。
Perplexityの自己評価では、並べ替えやラベル変更によって回答が反転する割合は0.27%でした。比較対象のTypeSafe製判断モデル「Jev 1.14」は、同社が示した条件で2.69〜4.84%とされています。ただし、この数字をあらゆる業務へそのまま当てはめることはできません。自社の質問文や選択肢でも判断が安定するかを、導入前に再現して確かめる価値があります。
高い分類成績と、Locateに残る検証課題
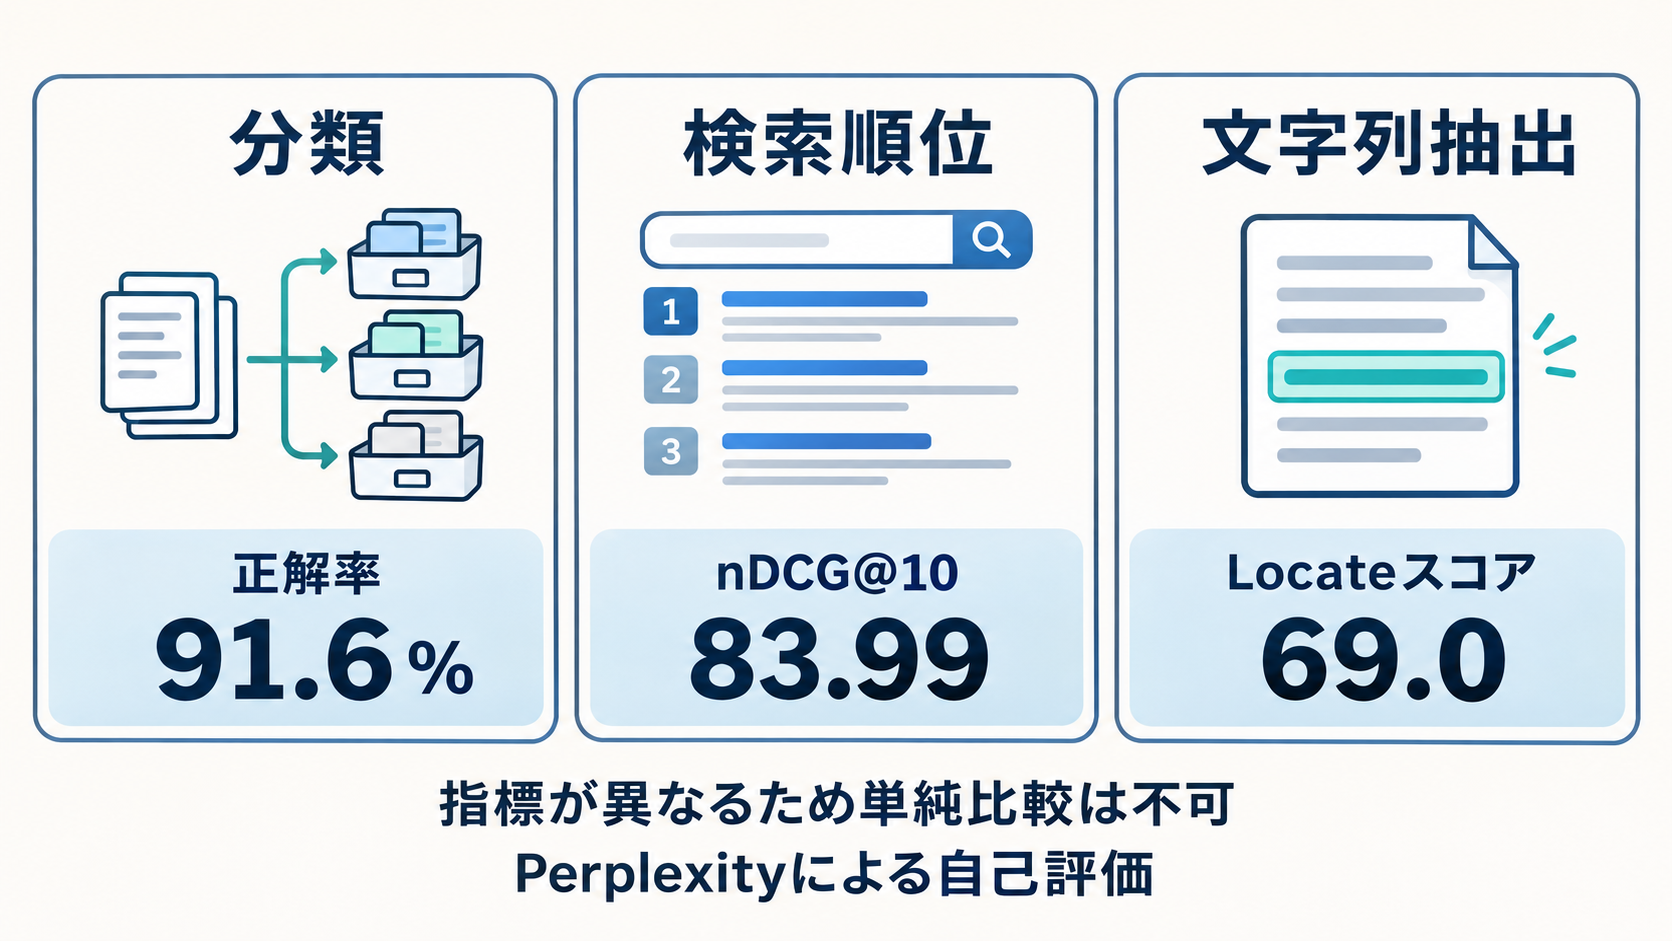
Perplexityが公表した評価では、Decider v1.3は63種類のクエリー分類タスクで平均正解率91.6%を記録しています。同社が比較した本番用分類器を6.54ポイント上回る結果です。ここでいうクエリー分類は、問い合わせや検索要求などを内容に応じて分類する処理を指します。企業にとっては、文章を生成する能力とは別に、入力を決められた区分へ整理する性能を評価した数字として読むと理解しやすいでしょう。
検索と並べ替えに関する72タスクでは、平均nDCG@10が83.99でした。これは、上位10件に関連性の高い結果をどれだけ適切に並べられたかを見る指標です。Perplexityの評価では、検索結果の並べ替えに用いる「Qwen3-Reranker-8B」を1.81ポイント、Jev 1.14を2.24ポイント上回っています。ただし、分類の正解率とは異なる指標なので、91.6という数値と直接比較することはできません。
新機能のLocateは、学習領域外の17タスクで平均スコア69.0、Flash版は63.6と報告されています。比較対象より高い結果でも、抽出を無条件に任せられることを示す数字ではありません。分類、検索、抽出では評価対象も尺度も異なるため、製品全体を一つの「精度」で捉えない姿勢が必要です。Flash版は、金融、プログラミング、法律の分野でJev 1.14を下回るという結果も示されています。
これらはすべてPerplexityによる自己申告の評価です。100万件の実運用リクエストでは、高性能LLMによる評価との一致率が93.98%でしたが、人間が確定した正解との一致率とは区別すべきでしょう。多言語評価も8言語・19タスクで88.16%とされていますが、提示された情報から日本語単独の成績は確認できません。日本語の敬語、省略、社内略語を含むデータで検証する余地が残ります。
APIの低い単価と、自社運用で必要になるGPUメモリー
導入方法は、Perplexity Decisions API、OpenRouter経由の利用、公開された重みによる自社運用に分かれます。モデルの重みは、学習で得られたパラメーター群です。両モデルともHugging FaceでApache 2.0ライセンスの下に公開されています。API利用と自社運用を選べるため、試験導入の進め方やデータ処理の要件に応じて検討できますが、実際の負担は利用形態によって変わります。
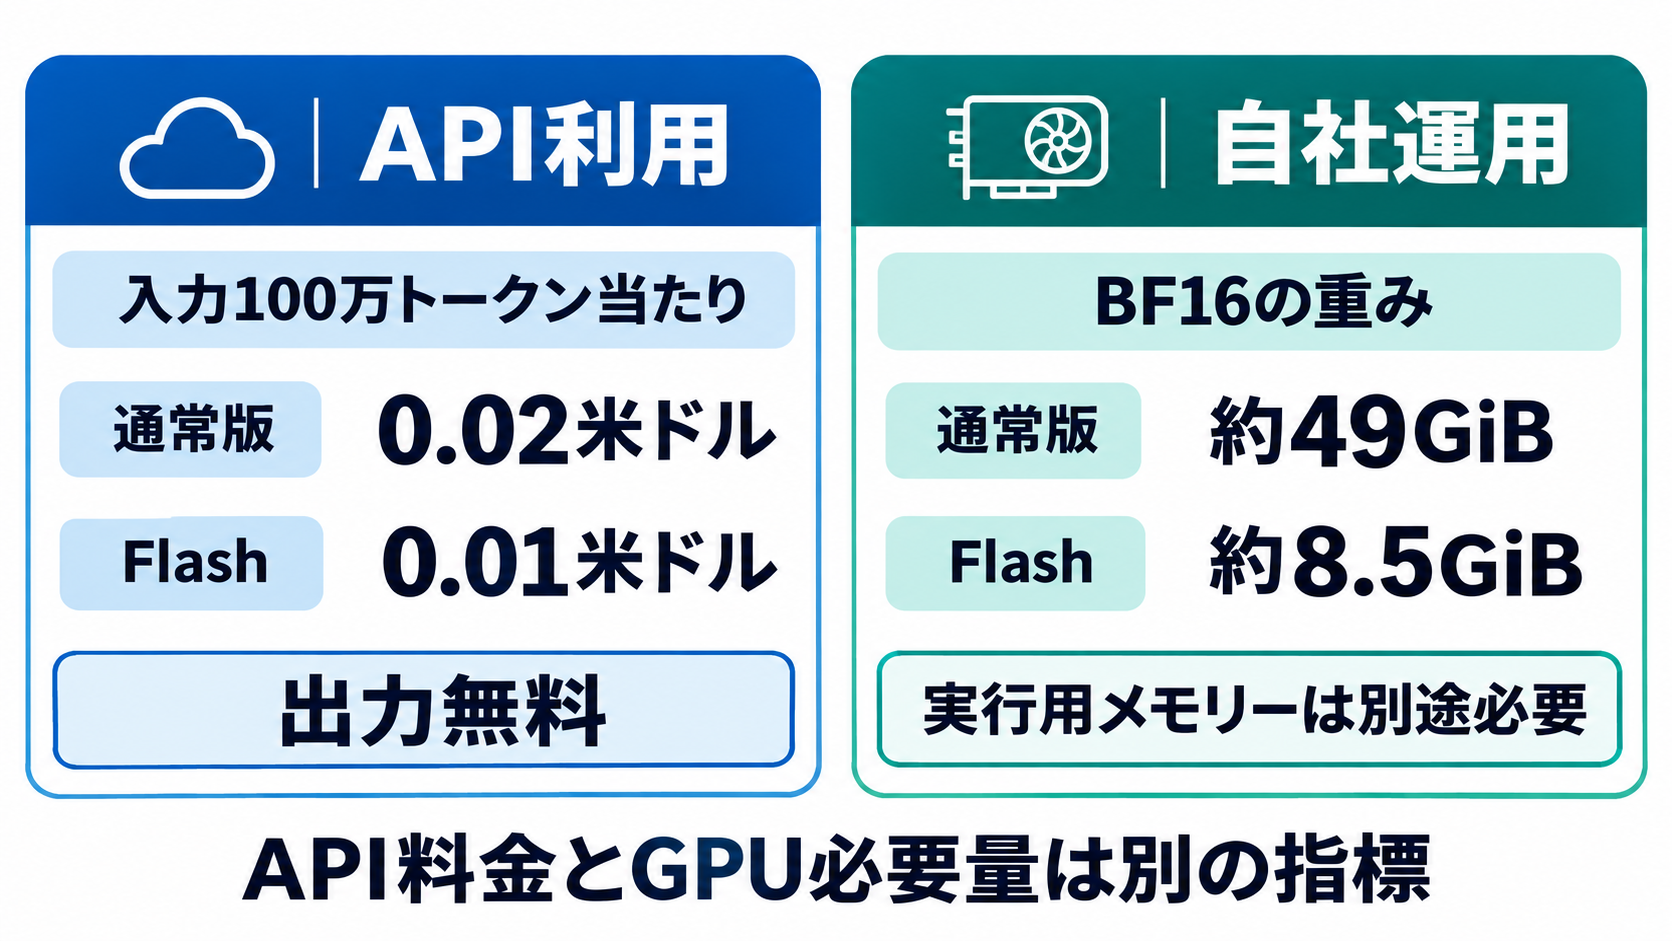
公表されたAPI料金は、入力100万トークン当たり通常版が0.02米ドル、Flash版が0.01米ドルで、出力は無料です。トークンはモデルが文章を処理するときの単位であり、日本語の文字数と単純には一致しません。Perplexityが示した100万リクエストの費用は通常版26.47米ドル、Flash版13.24米ドルですが、この値は同社の評価に用いた入力量に依存します。100万回の呼び出しに対する固定料金ではありません。
自社運用では、BF16形式の重みだけで通常版に約49GiB、Flash版に約8.5GiBのGPUメモリーが必要とされています。実行には、それに加えて処理用のメモリーも必要です。提供情報では量子化版は用意されていません。重みの容量が収まるかだけでなく、入力の長さや同時処理数を含めて見積もる必要があるでしょう。モデル規模の表記にも、説明資料では27Bと4B、Hugging Faceでは26Bと5Bという差があり、調達判断では実際に読み込む構成の確認が欠かせません。
APIの入力上限は256Kトークン未満、ローカル実行の既定値は32,768トークンです。約243Kトークンの入力を使ったPerplexityの遅延テストでは、通常版が16秒、Flash版が5秒でした。長い入力への対応力と、業務で許容できる待ち時間は分けて考えるべきです。API単価の低さだけでは、応答時間や運用体制まで含めた採用判断はできません。
日本企業は一つの振り分け業務から適合性を確認
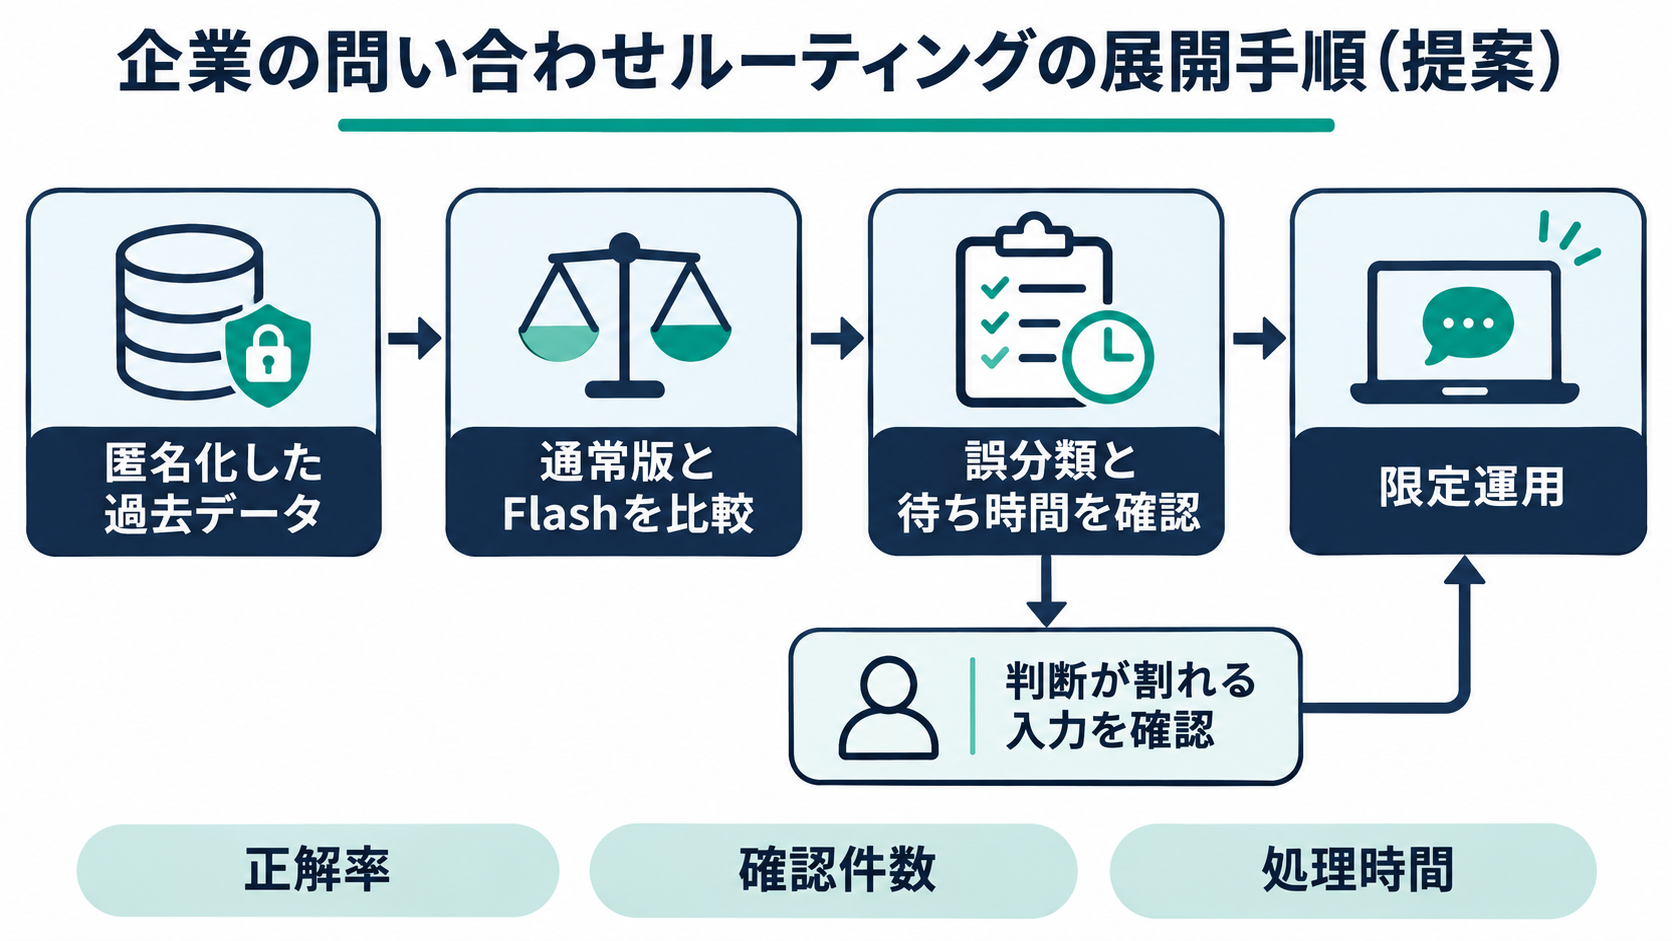
Deciderを試す際は、「社内業務をAI化する」という広い目標より、判断対象を一つ決めるほうが評価しやすくなります。たとえば、問い合わせを既存の担当部署へ振り分ける業務であれば、過去の文章と実際の担当部署を対応させられます。モデルには同じ選択肢を渡し、正しい部署を選べた割合に加えて、どの組み合わせで取り違えるかを確認します。部署間の境界が曖昧なら、モデルの性能と業務ルールの問題を切り分ける必要もあるでしょう。
通常版とFlash版の比較には、同じ入力と質問を使います。Perplexityは、細かな判断基準には通常版、大量の振り分けにはFlash版を推奨しています。ただし、自社の条件で軽量版の誤りが増えるとは限りません。誤分類による手戻り、人による確認件数、待ち時間を並べて評価すれば、モデルの価格差が実務上どれだけ意味を持つかを判断できます。入力トークン当たりの単価と、業務一件を処理し終える費用は別の観点です。
Locateを組み込む場合も、抽出できた件数だけでは十分ではありません。人名や所在地を見落とした場合と、対象ではない文字列を誤って抽出した場合では、業務への影響が異なります。開始位置と終了位置が正しく、実際に必要な範囲を選べているかまで確認します。抽出結果をマスク処理などへ直結させるなら、誤りを見つける手段も併せて設計する必要があります。
今回の公開が示すのは、生成AIの役割を文章作成から、確率を返す判断や範囲を示す抽出へ広げる選択肢です。採用を検討する企業が着手しやすい一歩は、既存の振り分け業務から匿名化した検証用データを用意し、通常版とFlash版に同じ条件で判断させることです。平均正解率に加えて「どの誤りなら人が補えるか」を確認できれば、自動化する範囲を具体的に決められます。