
2026/11/01
AIニュース
生成しないAIを社内で動かす――Nace AI「Drex Max v1」が示すローカル意思決定モデルの実力
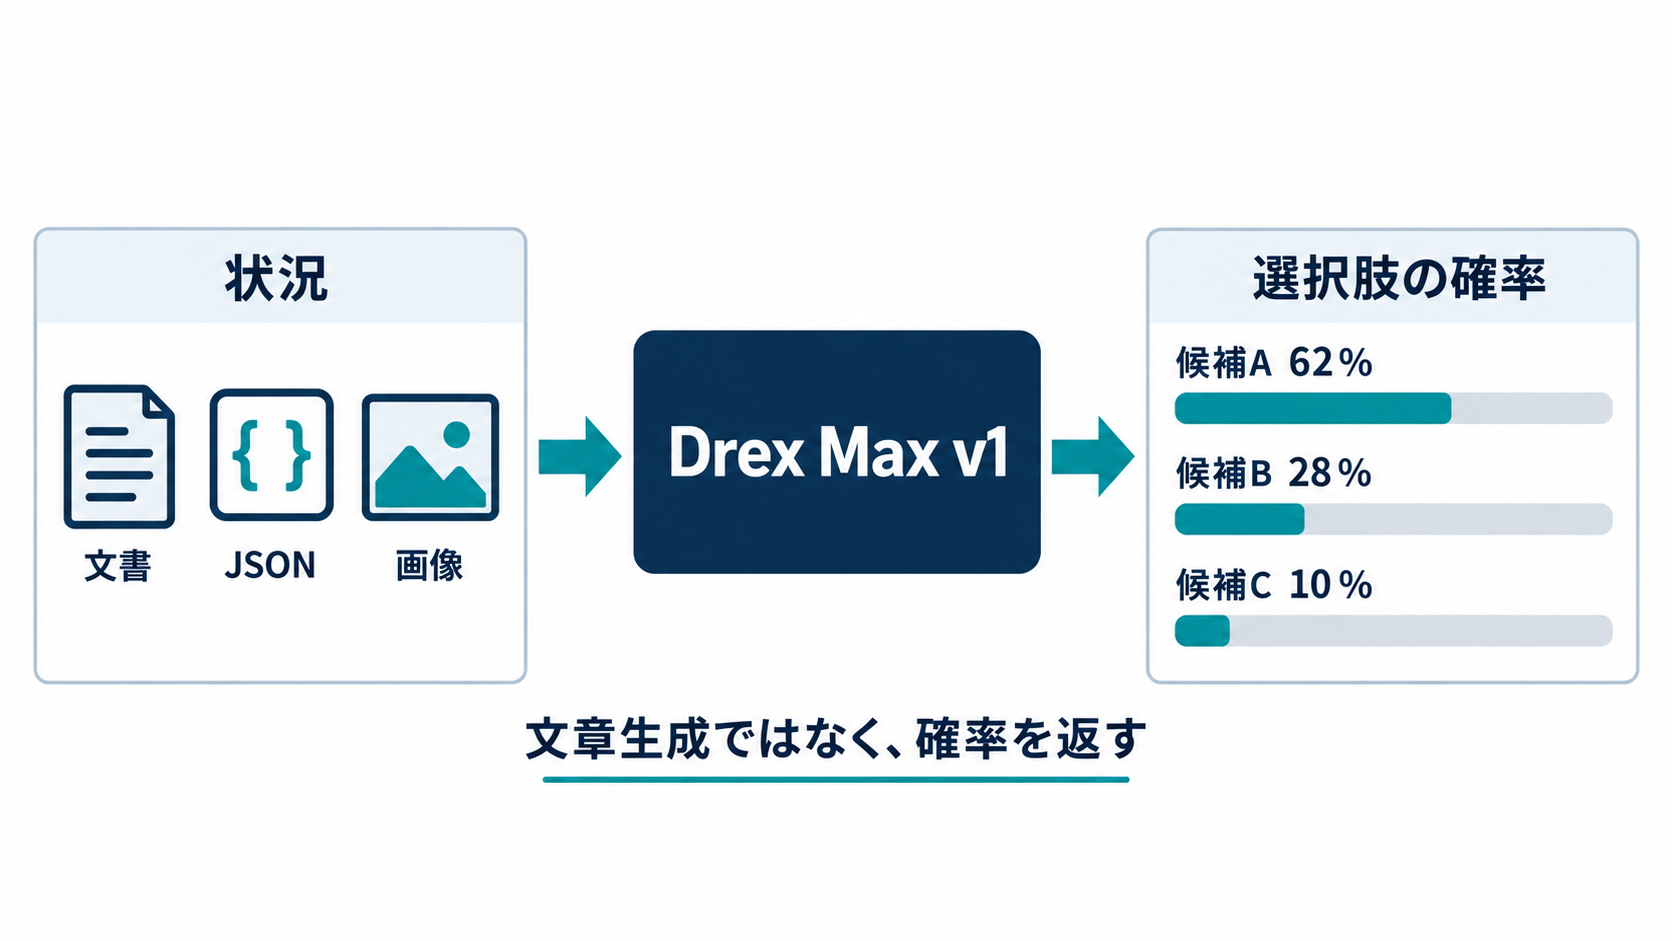
文章ではなく確率を返すDrex Max v1
問い合わせを担当部署へ振り分ける、エージェントに使わせるツールを選ぶ、社内ルールに反する依頼を止める。こうした業務では、流暢な文章を作る能力よりも、決められた候補を一貫して評価する機能が求められます。Nace AIが重みを公開したDrex Max v1は、この用途に焦点を当てた「意思決定モデル」です。
Drex Maxには、テキスト、JSON、画像で表現した状況と、名前を付けた質問を渡します。モデルは文章による回答を生成せず、各選択肢の確率を1回の推論で返します。質問形式は、複数の候補から選ぶ選択式、はい・いいえの二択、段階的な評価を求める順序尺度の3種類です。1問あたり最大255個の選択肢を扱えるため、単純な二値分類だけでなく、多数の担当部署や処理経路から候補を選ぶ設計にも対応できます。
一般的な生成AIでは、指示文を工夫して回答形式を固定しても、余計な説明が加わったり、想定外の文字列が返ったりする可能性があります。Drex Maxは出力を選択肢ごとの確率に限定しているため、後続システムが値を機械的に受け取りやすい点が特徴です。ただし、確率が得られることと、業務上正しい判断が保証されることは同じではありません。採用する選択肢や判定基準は、利用企業が実データで検証する必要があります。
モデルは密な27Bパラメータ構成で、最大コンテキスト長は262,144トークン、標準設定は16,384トークンです。大きなモデルでありながら、量子化版を使えばApple Silicon搭載Macでも動作させられます。顧客情報や社内文書を外部サービスへ送らず、ルーティング、分類、ポリシーチェックを手元の環境に残せることが、今回の公開で最も実務的な変化でしょう。
27Bモデルを支える混合アテンションと255択ヘッド
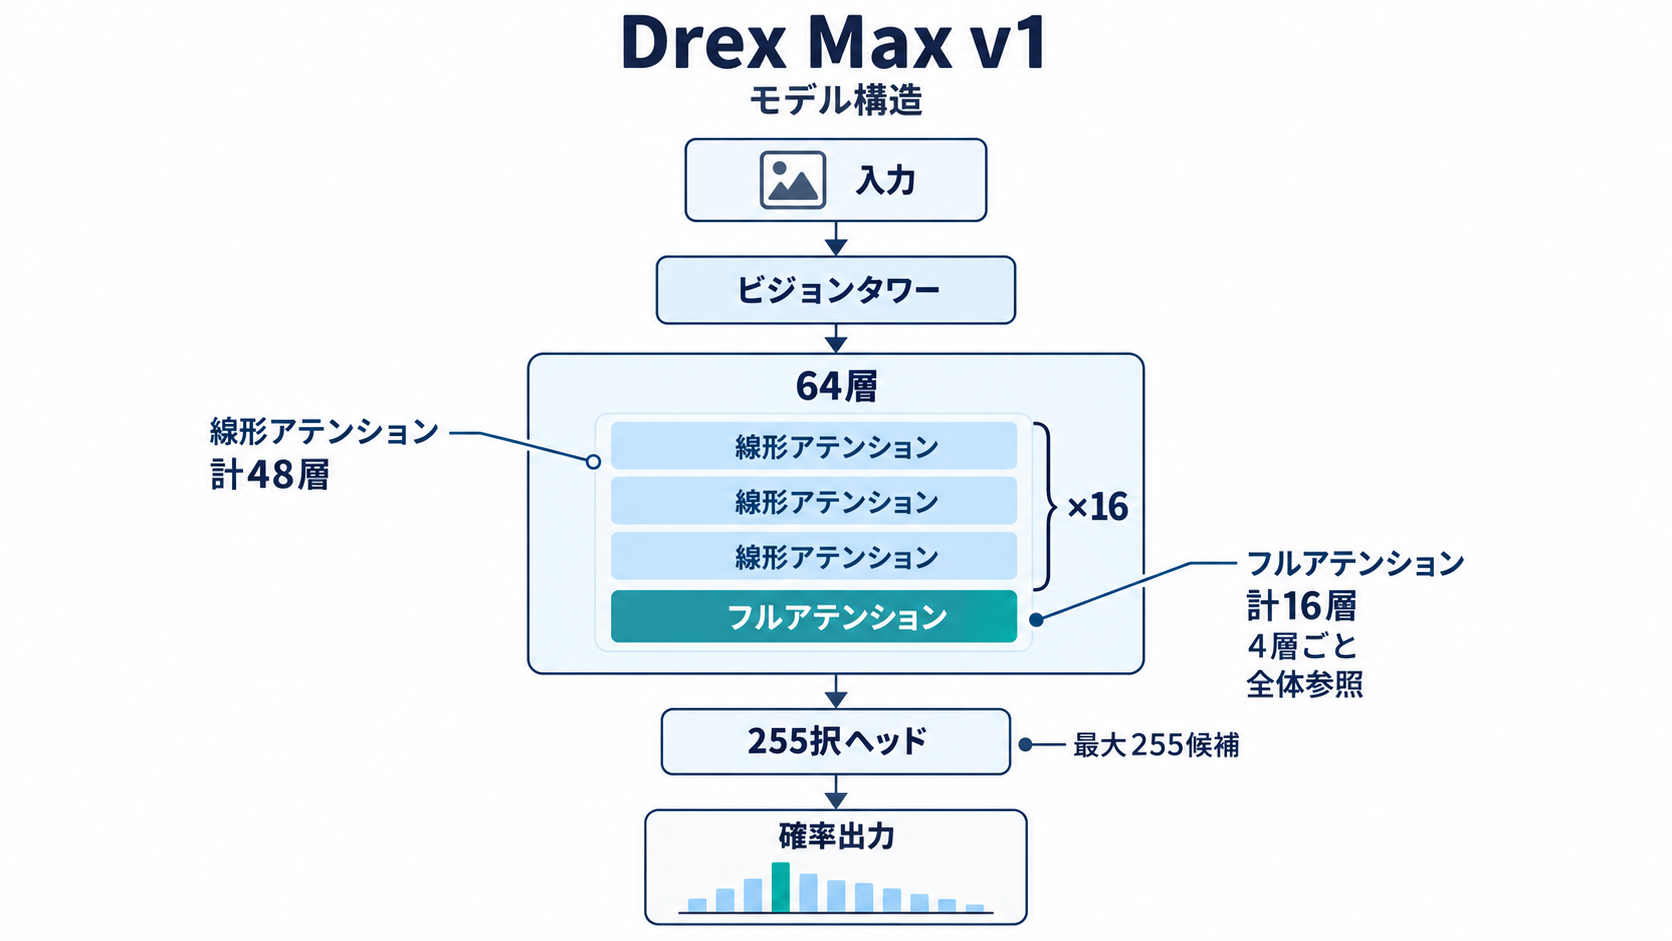
Drex Maxの中核は64層の密な27Bバックボーンです。そのうち48層には、左から右へ情報を処理する線形アテンション方式のGated DeltaNetが使われています。残る16層は4層ごとに配置されたフルアテンション層で、こちらは非因果的に動作します。各トークンが系列全体を参照できるため、入力の後半に置かれた質問や条件も含め、文脈全体を照合する構成です。
すべてをフルアテンションにするのではなく、線形アテンションと組み合わせている点は、長い入力を扱う設計と関係しています。設定上は262,144位置のウィンドウを持ちますが、最大長を実際に使えるかどうかは、実行方式、メモリ容量、処理時間に左右されるでしょう。標準値が16,384トークンに設定されていることからも、カタログ上の上限と日常的な運用設定は分けて考える必要があります。
画像は専用のビジョンタワーを通り、同じリクエストに含まれるすべての質問から参照できます。最後の隠れ状態を255方向の読み出しヘッドへ渡し、候補ごとの確率へ変換する仕組みです。モデル設定にはqwen3_5というモデル種別が記載されていますが、構成の詳細だけで他のQwen系モデルと同じ挙動だと判断するのは適切ではありません。Drex Max固有の推論コードと提供された実装を前提に扱うべきです。
この構造が業務システムにもたらす利点は、自由文の解釈と選択肢の評価を一つのモデルで処理できることです。たとえば、問い合わせ本文と顧客属性をまとめて渡し、「営業」「技術支援」「請求」といった候補の確率を得られます。ただし、入力形式や質問文が変われば分布も変化し得ます。実装時には質問の名称、候補の順序、欠損値の表し方を固定し、モデル更新時にも同じ条件で比較できるようにしておくことが欠かせません。
67.52というベンチマーク成績の読み方
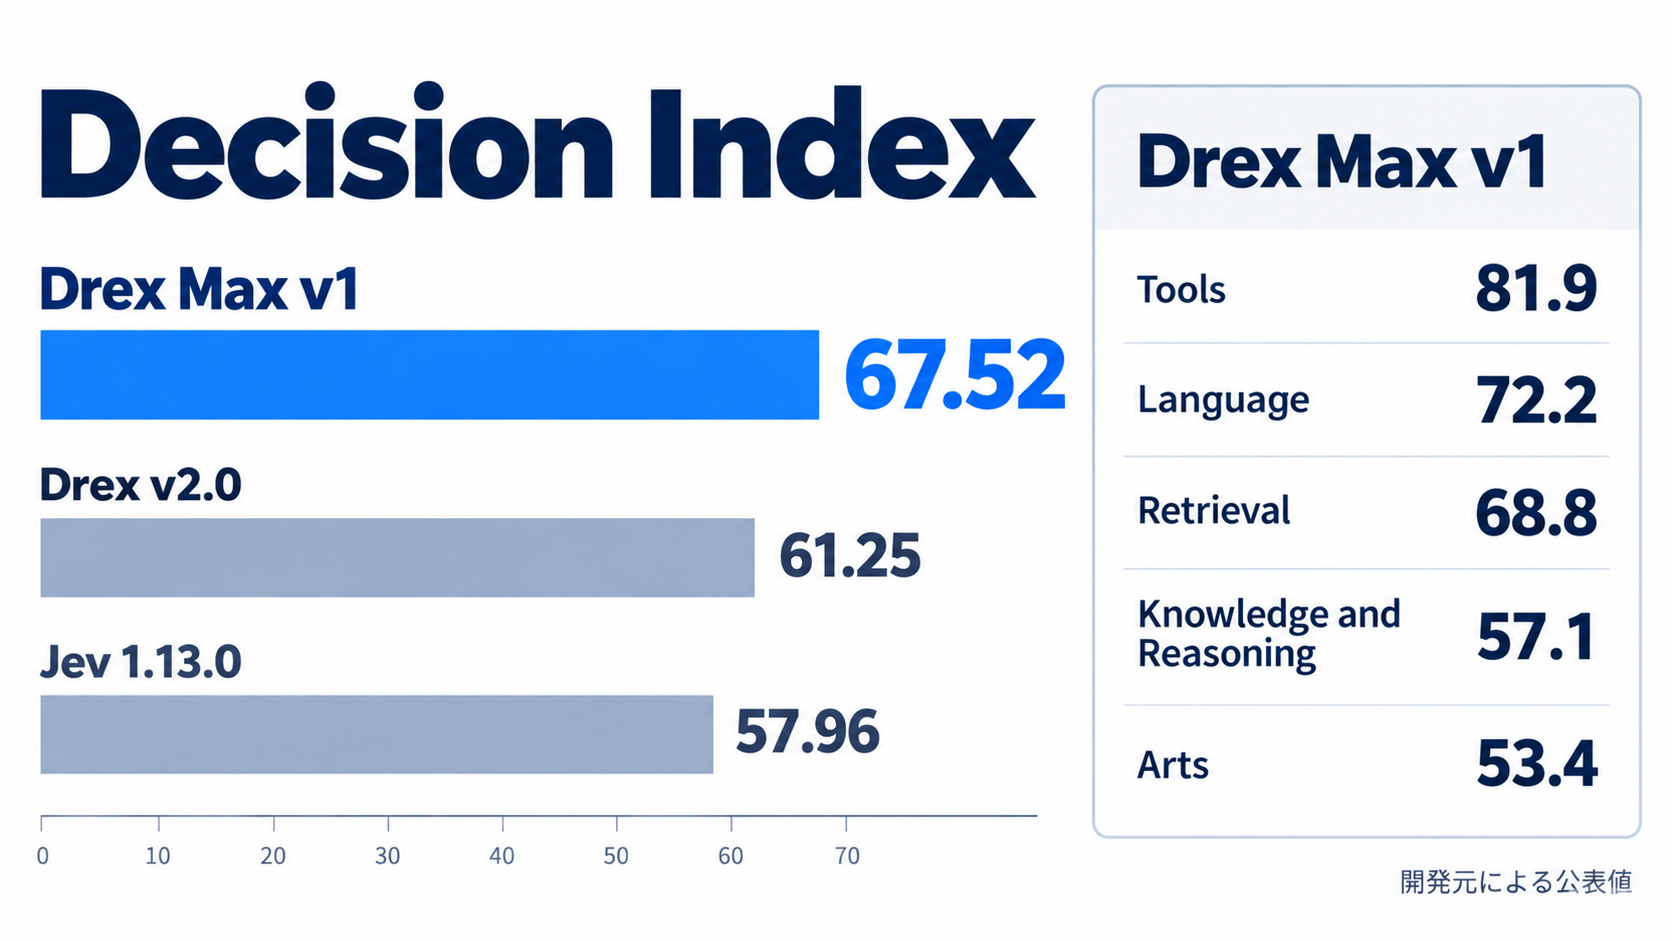
Nace AIが公表したDecision Index 0.4のスコアは67.52です。Drex v2.0の61.25を6.27ポイント上回り、Jev 1.13.0の57.96よりも高い結果とされています。分野別ではToolsが81.9と最も高く、Languageは72.2、Retrievalは68.8、Knowledge and Reasoningは57.1、Artsは53.4でした。ツール選択などの用途で強みを示す一方、分野による差も小さくありません。
| 評価項目 | Drex Max v1の結果 | 公表された条件 |
| --- | --- | --- |
| Decision Index 0.4 | 67.52 | 公開テキスト評価 |
| Public Vision Index | 73.92 | 11ベンチマーク、12,210行 |
| Artificial Analysis Decision Index | 64 | Nace AIによれば18モデル中4位 |
| JevBench | 92.2% | 231件中213件 |
| Decision Bench v4 | 94.30% | 1,071件中1,010件 |
| InfographicVQA | 97.3 | 画像理解を含む評価 |
評価結果のデータセット全体は140,620リクエストで、無回答も不正解として数えられています。Nace AIは、Decision Index 0.4が旧版の0.3.1と同じ公開スイートを使っていると説明しています。ただし、掲載されている数値はいずれもNace AIによる自己申告です。公開ページにはスポンサー記事であることも明記されているため、順位や差分は第三者による独立評価としてではなく、開発元が提示した検証結果として読む必要があります。
企業が注目すべきなのは、総合点だけではありません。自社の問い合わせ分類で必要なのが日本語の微妙な意図理解なら、英語中心の総合ベンチマークで高得点を得ても、そのまま業務品質を予測できない可能性があります。誤分類の損失も用途ごとに異なります。担当部署の振り分けミスと、セキュリティポリシーの見逃しを同じ正答率で評価するべきではないでしょう。
導入判断では、自社データを使って候補別の適合率や再現率、確率の校正状態を確認する必要があります。特に確率をしきい値判定に利用する場合、0.8という値が実運用でどの程度信頼できるのかを検証しなければなりません。公開スコアは候補選定の材料にはなりますが、業務上の受け入れ試験を置き換えるものではありません。
MacからH100までをつなぐ5つの実行経路
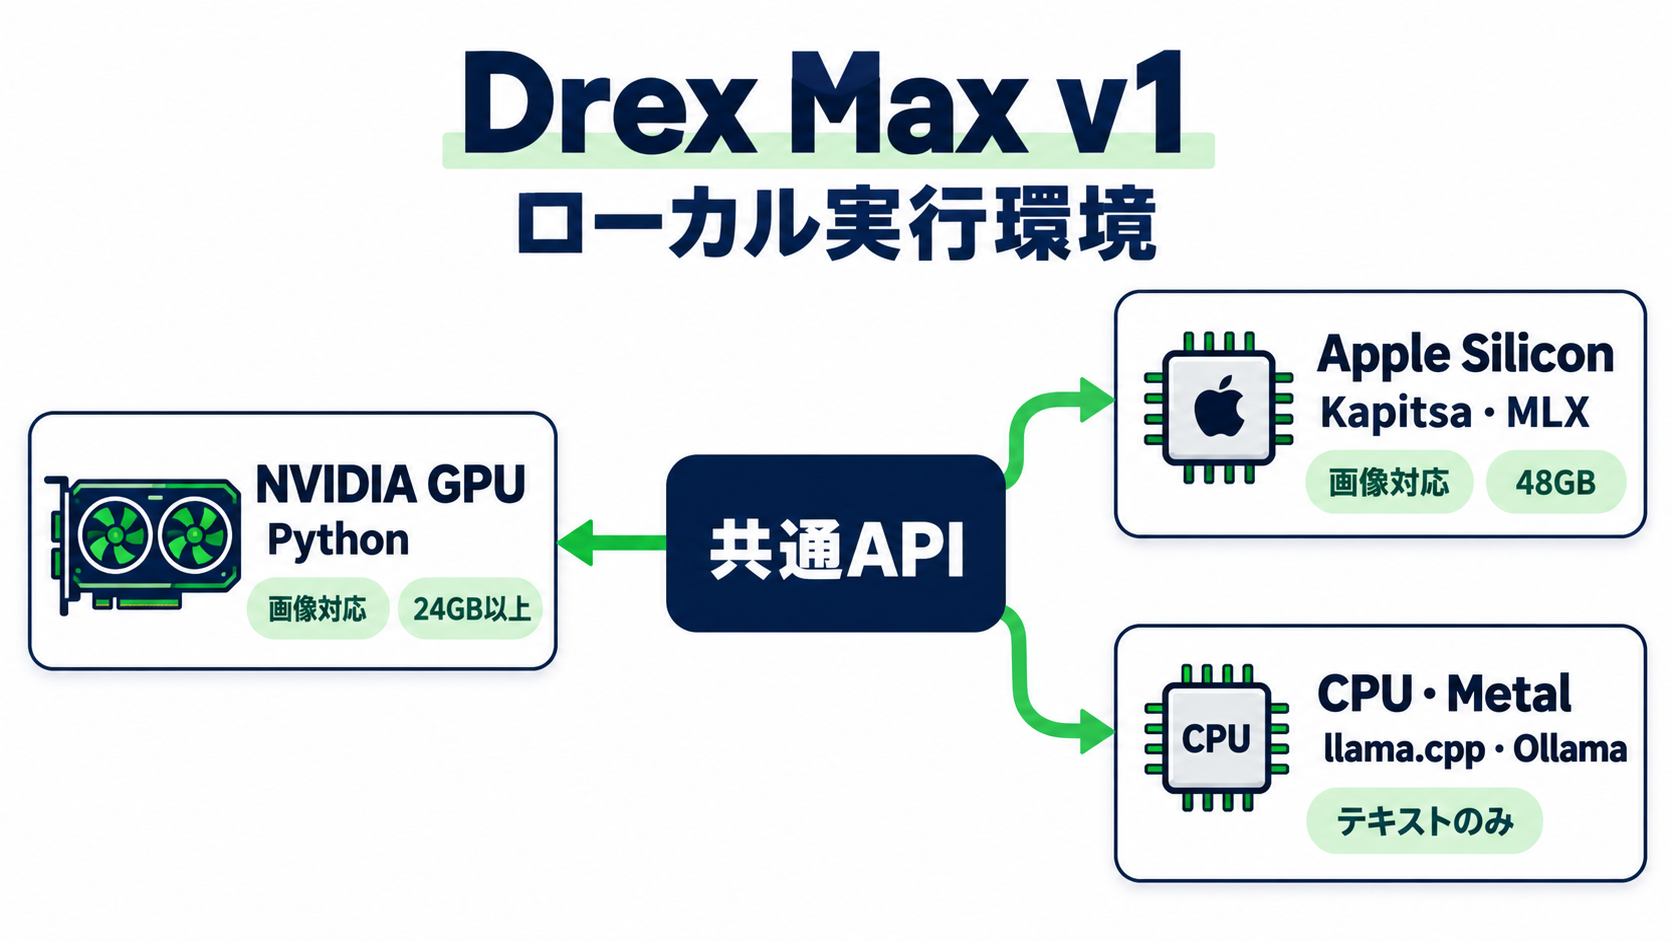
Drex Maxには5種類の実行経路が用意され、いずれもPOST /v1/systemoneという共通APIを提供します。アプリケーション側の呼び出し方をそろえながら、NVIDIA GPU、Apple Silicon、CPUから環境を選べる構成です。ただし、各方式で使えるチェックポイントと画像入力の対応状況は異なります。
| 実行方式 | 主なハードウェア | チェックポイント | 画像入力 |
| --- | --- | --- | --- |
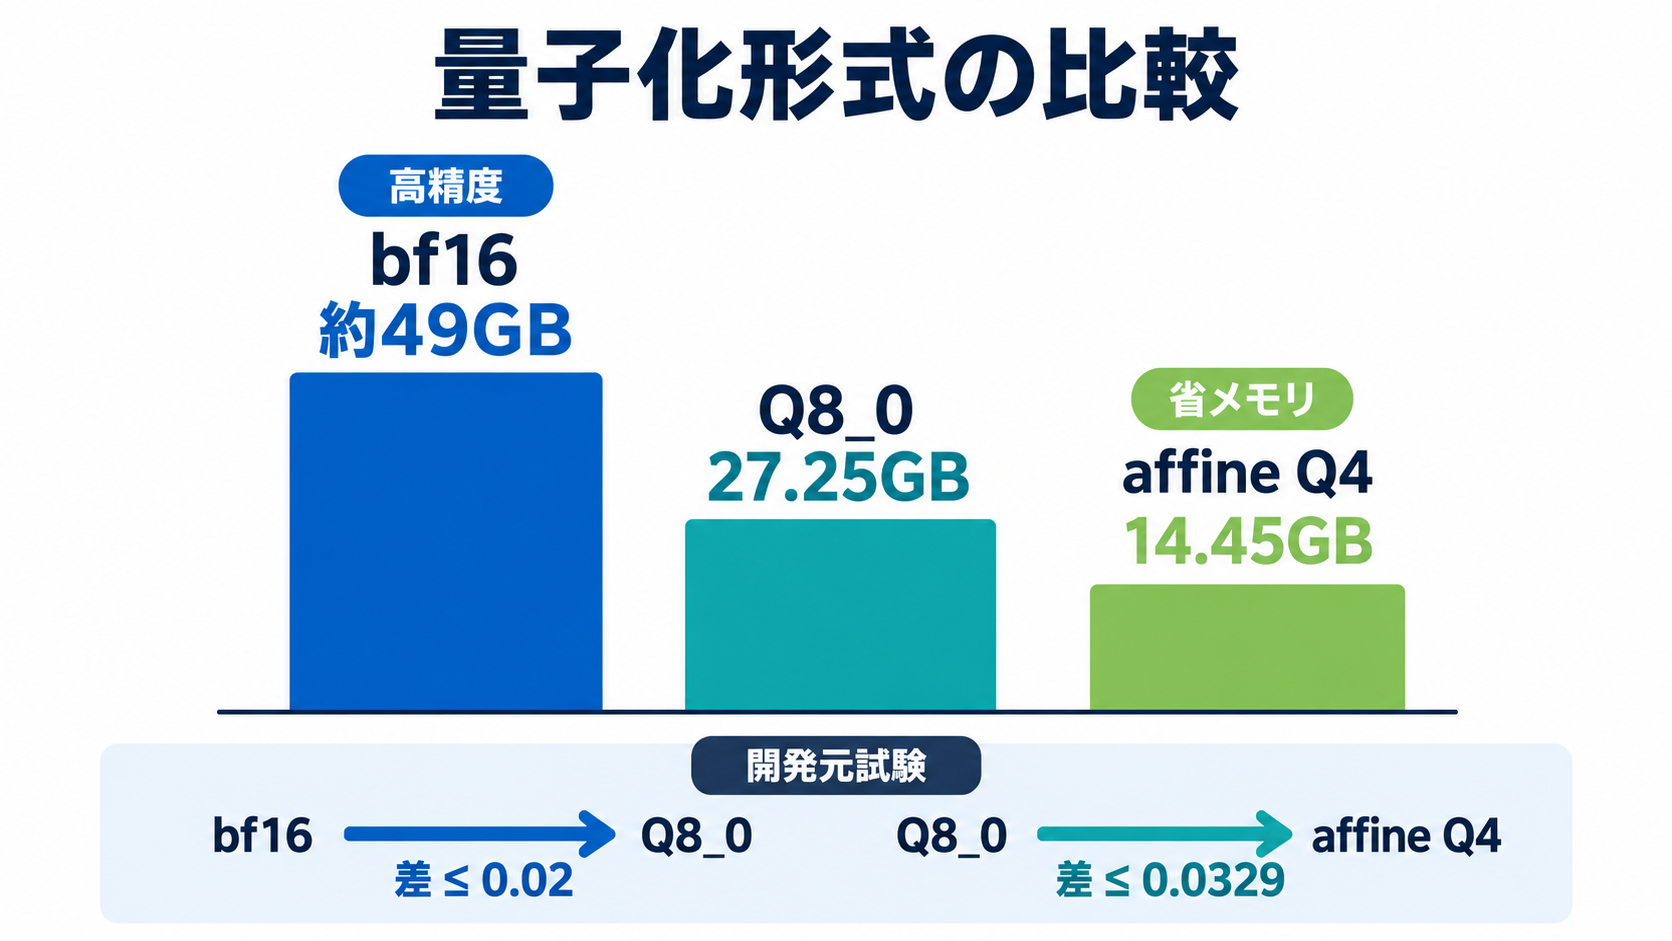
| Python | NVIDIA GPU | bf16約49GBまたは8ビット約26GB | 対応 |
| llama.cpp専用フォーク | Apple Metal、CPU | Q8_0 GGUF 27.25GB | 非対応 |
| Ollama専用フォーク | Apple Metal、CPU | Q8_0 GGUF | 非対応 |
| Kapitsa 0.2.25以降 | Apple Silicon | Q8_0 GGUFまたはaffine Q4 | 非対応 |
| MLX | Apple Silicon | affine Q4 14.45GB | 非対応 |
NVIDIA環境では、H100でbf16版を動かす構成と、48GBのL40Sで8ビット版を動かす構成が示されています。画像を判断材料に含めたい場合、今回説明されている5経路の中ではPython版を選ぶ必要があります。MacやCPU向けの経路は現時点でテキストのみであり、ローカルで動くという説明から画像入力まで利用できると誤解しないよう注意が必要です。
Apple Siliconでは、14.45GBのaffine Q4が24GB以上のメモリを搭載したMacを対象としています。27.25GBのQ8_0 GGUFには48GBが必要です。Apple SiliconはCPUとGPUが共有メモリを利用するため、モデルファイルの大きさだけでなく、コンテキストや実行時領域も見込んで構成を選ばなければなりません。Nace AIは48GBのMacでKapitsaを使う場合、コンテキストを2,048に設定するよう推奨しています。
Ollama利用者には、40層をMetalへオフロードするnum_gpu 40という設定が案内されています。num_gpu 0にすればCPU実行となり、ModelfileにはCAPABILITY decisionという行が必要です。標準版ではなくNace AIが提供する専用フォークを使う点も運用上の確認事項でしょう。共通APIがあっても、更新方法や依存関係、社内サポートの範囲まで共通になるわけではないため、採用する実行系を絞って検証するのが現実的です。
4ビット量子化で維持された精度と残る検証課題
27Bモデルを一般的なMacへ収める鍵が量子化です。量子化では、モデル内部の重みをより少ないビット数で表現し、必要なメモリを削減します。その代わりに計算結果がわずかに変化する可能性があるため、分類やポリシー判定では、ファイルサイズだけでなく選択結果への影響を確認しなければなりません。
Nace AIの検証では、48GBのApple M5 Proで動かしたQ8_0 GGUFは、H100上のbf16版に対して選択肢ごとの確率差が0.02以内でした。affine Q4とQ8_0の差は0.0329以内で、この試験では最上位の選択肢が入れ替わる事例はなかったと報告されています。24GBのMacで動かせる4ビット版でも、少なくとも開発元の試験範囲では意思決定結果が保たれたことになります。
ただし、「選択肢の逆転がなかった」という結果は、あらゆる入力に対する保証ではありません。1位と2位の確率が接近する境界事例、日本語特有の省略を含む入力、長文、業界固有の用語では、別の傾向が現れる可能性があります。また、確率差が小さくても、しきい値の直前と直後に分かれれば、後続システムの処理は変わってしまいます。
企業内の検証では、bf16版を基準にして量子化版の一致率を見るだけでなく、正解ラベルに対する品質も測るべきでしょう。両方のモデルが同じ誤答を選べば、モデル間の一致率は高くても業務品質は上がりません。候補間の余裕、しきい値付近の件数、特定カテゴリへの偏りを併せて確認すると、量子化による影響を捉えやすくなります。
Q4は搭載しやすさ、Q8_0は精度維持への期待、bf16は比較基準としての扱いやすさがそれぞれ異なります。機密データを手元に残す目的だけならQ4が有力ですが、誤判定の損失が大きい業務では、より高精度な形式や人手確認を含む運用も検討対象になります。ハードウェア要件から逆算するだけでなく、許容できる業務リスクから形式を選ぶ姿勢が必要です。
社内ルーティングとポリシー判定への組み込み方
Drex Maxの用途として挙げられているのは、エージェントのルーティング、チケットの振り分け、分類、ポリシーチェックです。共通するのは、入力を読んだ後に自由文を書くのではなく、あらかじめ決めた処理経路から候補を選ぶ点です。生成AIの前段に配置すれば、依頼内容に応じて使うモデルやツールを切り替える制御層として利用できます。
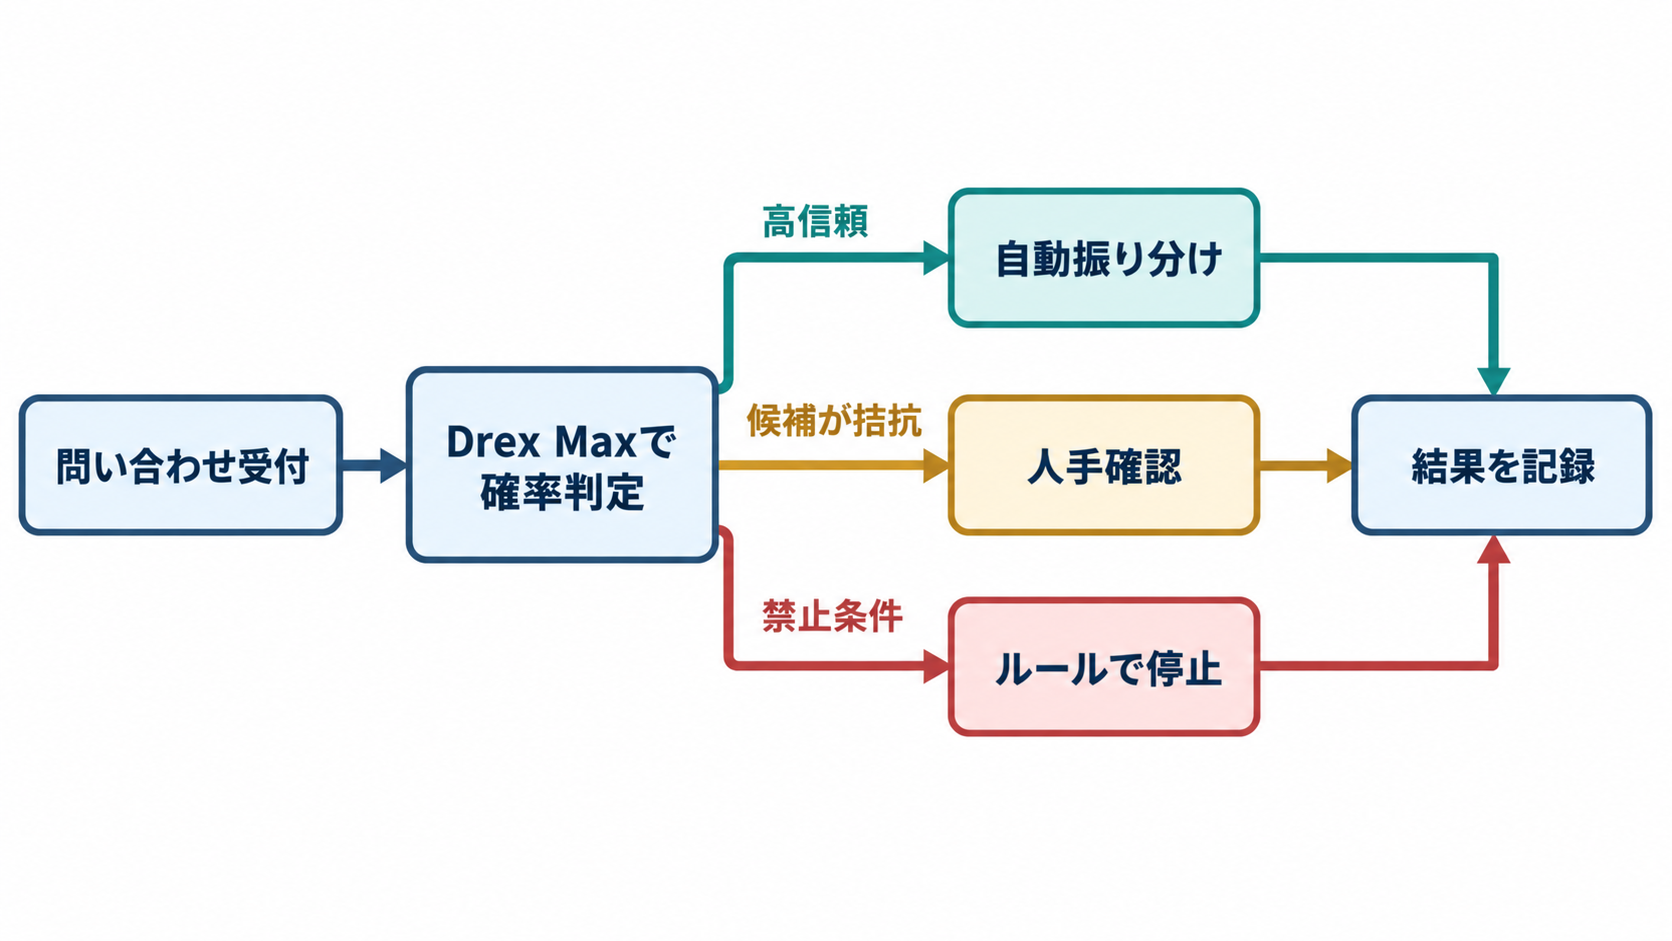
たとえば社内ヘルプデスクでは、問い合わせ本文と利用部門を状況として渡し、「アカウント」「端末」「業務アプリ」「情報セキュリティ」といった候補の確率を受け取れます。最大確率が十分に高い場合だけ自動で担当キューへ送り、候補が拮抗した場合は人が確認する設計が考えられます。これはDrex Maxに自動判断の最終権限を与えるという意味ではなく、確率を既存の業務ルールへ組み込む考え方です。
ポリシーチェックでは、依頼が許可対象か、確認が必要か、拒否すべきかを候補として定義できます。ただし、モデルの判定だけで法令順守やセキュリティが保証されるわけではありません。明確な禁止条件は従来のルールエンジンで処理し、曖昧な文章の分類をモデルが補い、高リスク案件を人へ回す多層構成のほうが管理しやすいでしょう。
ローカル推論には、入力を外部の推論APIへ送らずに済むという利点があります。顧客対応履歴や未公開の製品情報を扱う企業にとって、データの送信先を限定できることは採用理由になり得ます。ただし、ローカル化だけで安全になるわけではありません。APIへのアクセス制御、ログに残す情報、モデルファイルの取得経路、実行環境の更新手順は別途整備する必要があります。
出力が構造化された確率であるため、監査ログには入力の識別子、質問と候補の版、各確率、採用した処理、最終結果を記録しやすいと考えられます。モデルや質問文を更新した際には、同じ評価セットを再実行し、判定分布の変化を確認できます。Drex Maxの価値は単体のスコアだけでなく、こうした制御可能な業務フローを構築できるかどうかで評価すべきです。
導入前に固めたい評価・運用・ライセンス
Drex Maxを試す場合、最初から全社の判断基盤に据えるのではなく、一つの分類業務に範囲を絞ると評価しやすくなります。候補の定義が明確で、過去の正解データがあり、誤判定を人が修正できる業務が適しています。問い合わせ振り分けなら、過去のチケットから機密情報を適切に処理した評価セットを作り、現在のルールや既存モデルと同じ条件で比べられるでしょう。
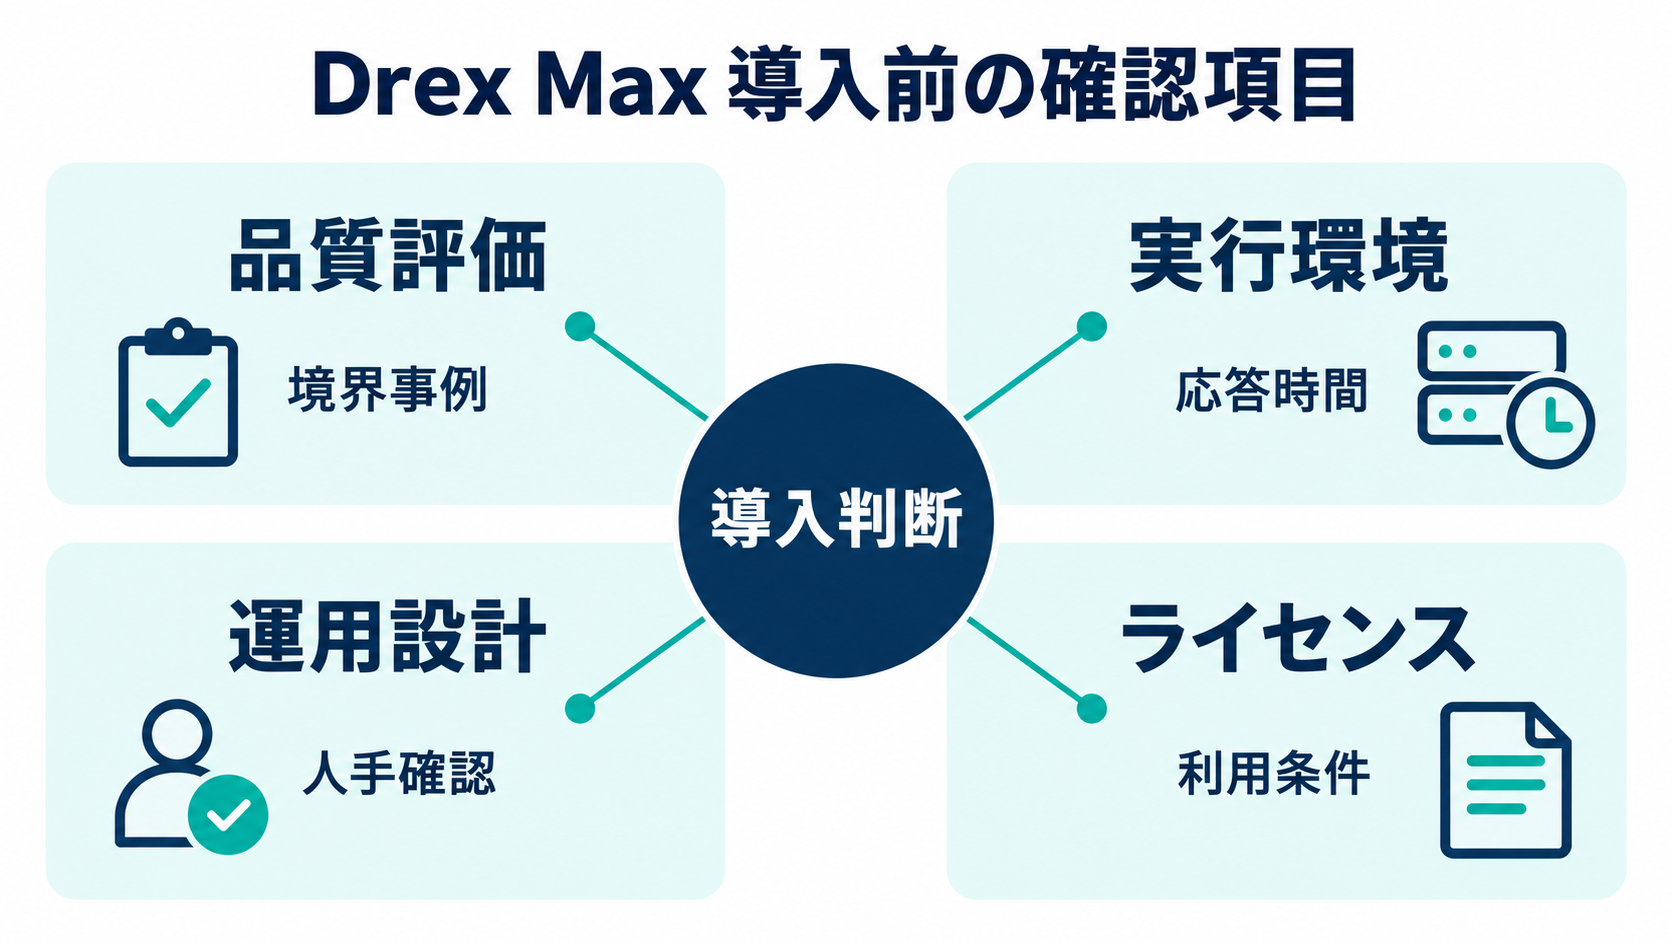
品質評価では、全体の正答率だけでなく、カテゴリ別の誤りと確率の分布を確認します。自動処理へ進めるしきい値、人へ戻す条件、モデルが利用できない場合の代替経路も事前に決めておく必要があります。標準コンテキストは16,384トークンであり、最大262,144トークンという仕様だけを前提に処理量を設計するべきではありません。採用予定のハードウェアとチェックポイントで、応答時間、同時実行数、メモリ使用量を測ることが重要です。
画像入力が必要ならNVIDIA GPU上のPython版、テキストだけで小規模に試すならApple Silicon向けの量子化版が候補になります。MacやCPU向け経路では画像が使えないため、将来の拡張を見越して入力要件を明文化しておくと構成変更を減らせます。専用フォークを利用する実行方式では、上流プロジェクトとの更新差分や脆弱性対応を誰が追跡するのかも決めておきたいところです。
重みはNace.AI Open RAIL-Mの下で公開されています。「重みを取得できる」ことと「用途を問わず自由に利用できる」ことは同義ではないため、商用利用、再配布、禁止用途などの条件を実際のライセンス文書で確認する必要があります。提供コードや各依存ソフトウェアについても、重みと同じ条件だと決めつけず、個別に精査すべきでしょう。
最初の一歩としては、実際の業務例を100件単位で無理に増やすより、判断が難しい境界事例を意識して集めることが有効です。公開ベンチマークの順位ではなく、自社の誤判定コスト、必要な処理速度、データ管理要件を満たせるかを確認してください。その小規模な結果から、自動処理の範囲と人が介入する位置を決めることが、ローカル意思決定モデルを安全に活用する出発点になります。
参考情報
Nace AI Open-Sources Drex Max v1: A 27B Decision Model That Runs Locally on Apple Silicon
公開ページでは、Nace AIによるスポンサー記事であることが明記されています。性能値や比較結果を採用判断に使う際は、モデルカード、配布物、ライセンス、実環境での評価結果も併せて確認する必要があります。