
2026/10/28
FlashMapはLLM推論をどう速めるのか――16トークンをまとめて予測する連続フローマップの実力
LLMの応答を速くするために、小型モデルへ先読みさせる「投機的デコーディング」が使われています。ただし、先読みした候補が文脈に合わなければ、大型のターゲットモデルに却下されます。候補を安く作るだけでは足りず、複数トークンを一貫したまとまりとして予測できるかどうかが、実効速度を左右します。
Polymathic AI、プリンストン大学、南カリフォルニア大学情報科学研究所(USC ISI)、ニューヨーク大学、Flatiron Instituteの研究チームが公開したFlashMapは、この問題に連続フローマップで取り組みます。最大6.14倍という数値以上に注目したいのは、16トークンを1回の順伝播で共同生成し、ブロック内部の整合性を高めようとした設計です。
Polymathic AI、プリンストン大学、南カリフォルニア大学情報科学研究所(USC ISI)、ニューヨーク大学、Flatiron Instituteの研究チームが公開したFlashMapは、この問題に連続フローマップで取り組みます。最大6.14倍という数値以上に注目したいのは、16トークンを1回の順伝播で共同生成し、ブロック内部の整合性を高めようとした設計です。
16トークンを一度に先読みするFlashMap
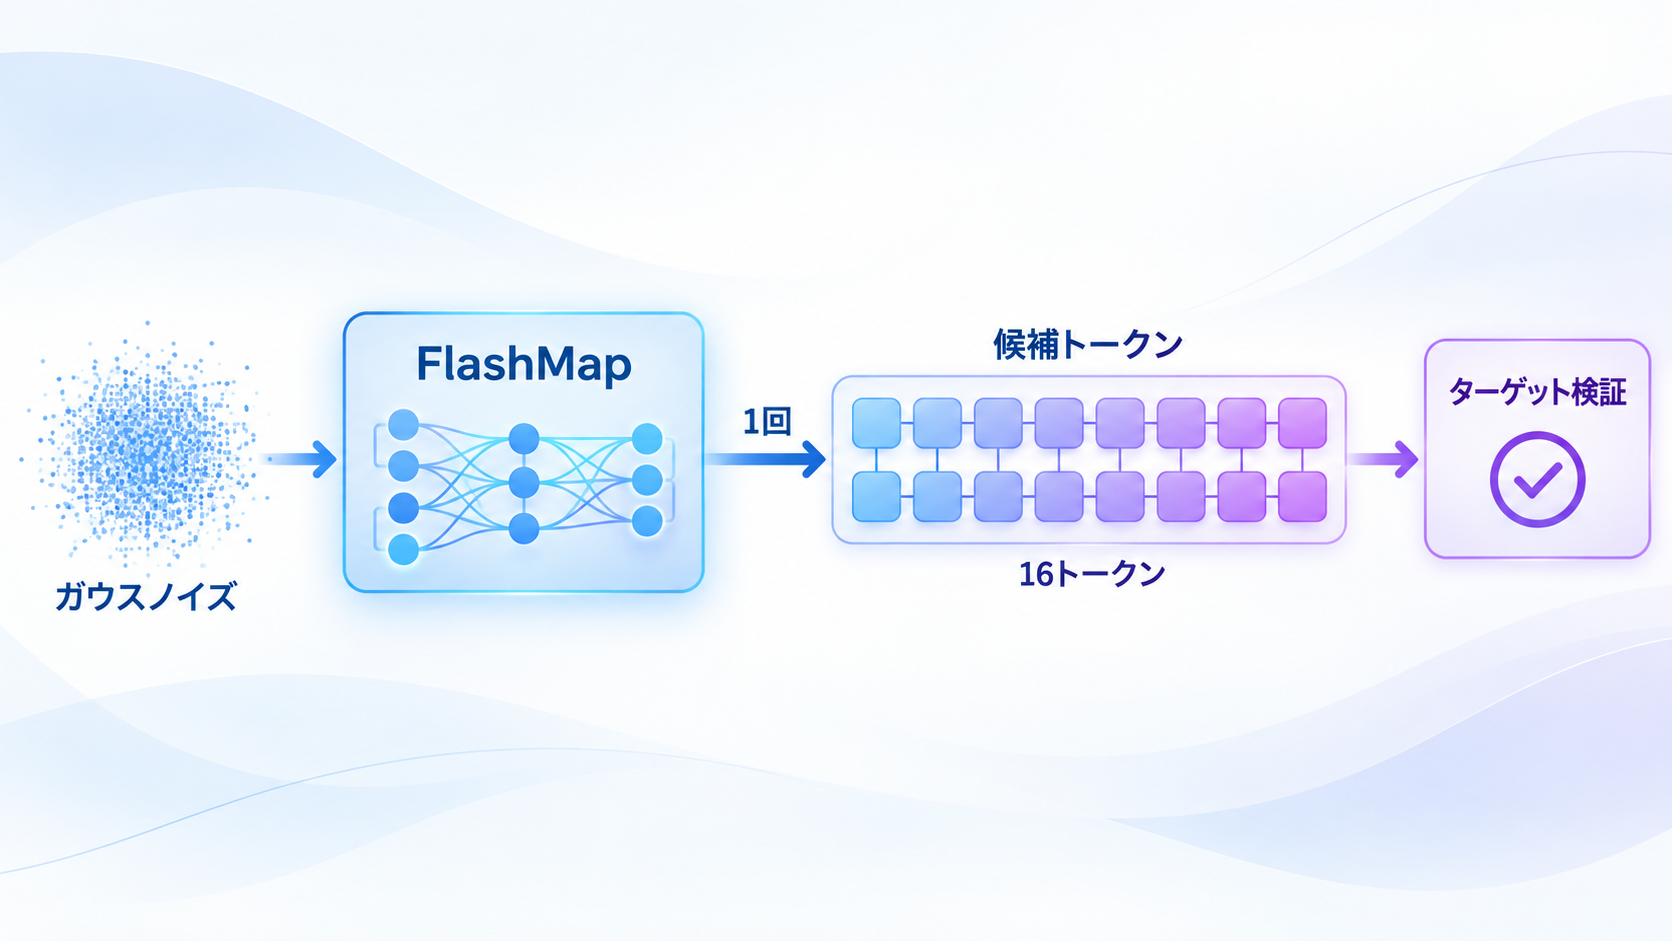
FlashMapは、LLM本体の代わりに次のトークン群を予測する「ドラフター」と呼ばれる小型モデルです。Qwen3-8B向けのドラフターは約5億パラメータで、ガウスノイズから16トークンの候補ブロックを1回の処理で作ります。Qwen3-4B向けには4億7,500万パラメータの重みが用意されています。特徴は、16個の空欄を別々に埋めるのではなく、ブロック全体を一つの予測対象として扱う点です。ある位置で選んだ単語が、その後の語句と自然につながるように共同で候補を形成します。長い候補を一括生成しても、内部に矛盾が多ければ検証時に早い位置で却下されるため、この一貫性には計算コストと同じくらいの意味があります。
研究チームはQwen3-8BとGSM8Kの組み合わせにおいて、温度0で最大6.14倍のロスレス高速化を報告しました。この条件では、1回の検証で平均7.69トークンが受理されています。ただし、16トークンすべてが常に採用されるわけではありません。効果はタスクやサンプリング設定によって変わり、Alpacaを温度1で実行した条件では2.28倍でした。
したがって、FlashMapの価値を「どの処理も6倍になる」と捉えるのは適切ではないでしょう。企業利用で見るべきなのは、一括予測の安さと候補の受理率を両立させ、対象ワークロードで待ち時間をどこまで縮められるかです。
出力を変えずに高速化する投機的デコーディング
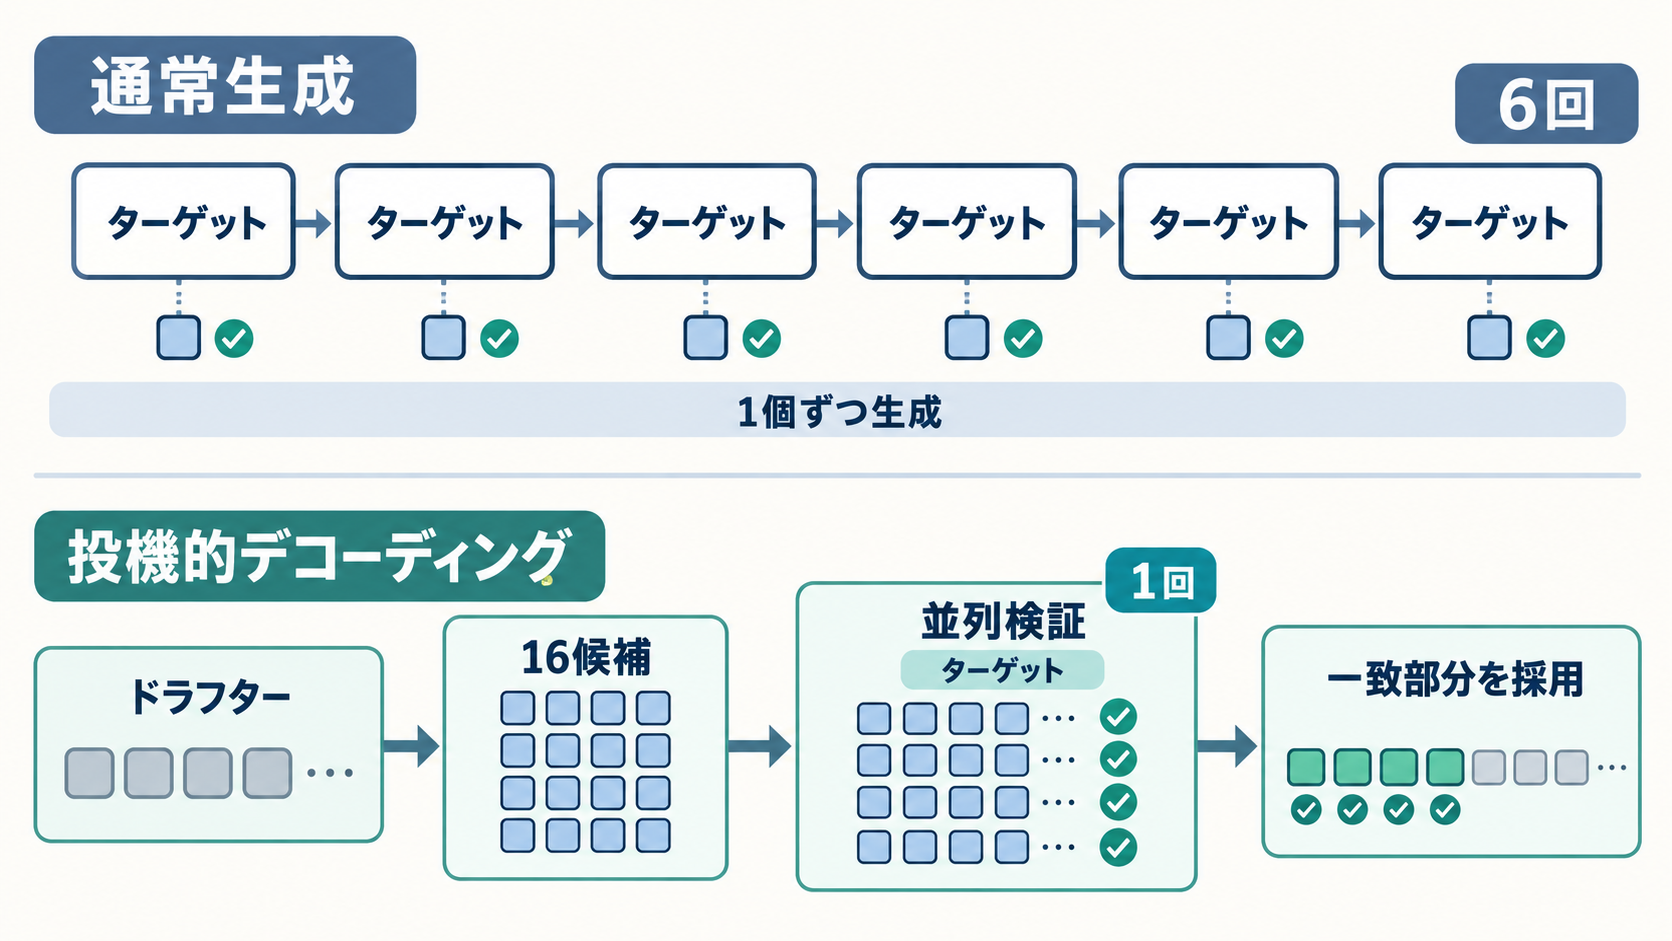
通常の自己回帰型LLMは、直前までの文脈を読み、次の1トークンを決める処理を繰り返します。生成が長くなるほどターゲットモデルの呼び出し回数が増えるため、モデルが高性能でも逐次処理が応答時間のボトルネックになり得ます。投機的デコーディングでは、計算の軽いドラフターが複数の候補を先に作り、ターゲットモデルがその候補を並列に検証します。FlashMapは16トークンを提案し、ターゲットモデルは一度の処理で全体を確認したうえで、先頭から一致する最長部分を採用します。不一致が現れた後の候補は使われません。
ここでいうロスレスとは、ドラフターがターゲットモデルの代わりに最終回答を決めるのではなく、ターゲットモデルの生成規則を保ったまま計算を省くことを指します。小型モデルの推測が外れても内容を妥協して採用するわけではないため、速度のために別モデルの品質へ置き換える方式とは性格が異なります。
性能は大きく二つの要因で決まります。一つは、提案したトークンが何個連続して受理されるかです。もう一つは、その提案をどれだけ少ない計算で作れるかでしょう。EAGLE-3は自己回帰的に候補を作るので、ブロックが長くなるほどドラフトの処理量が増えます。DFlashとFlashMapはブロックをまとめて生成し、このコストを抑える方向を選びました。
企業システムでの利点は、回答品質の基準を維持しながらレイテンシー改善を狙えることです。ただし、ドラフター自体の計算やメモリー使用量は追加されます。受理数が少ない業務では検証回数を十分に削減できず、期待した効果が出ない可能性もあります。
独立予測で崩れる語句の組み合わせ
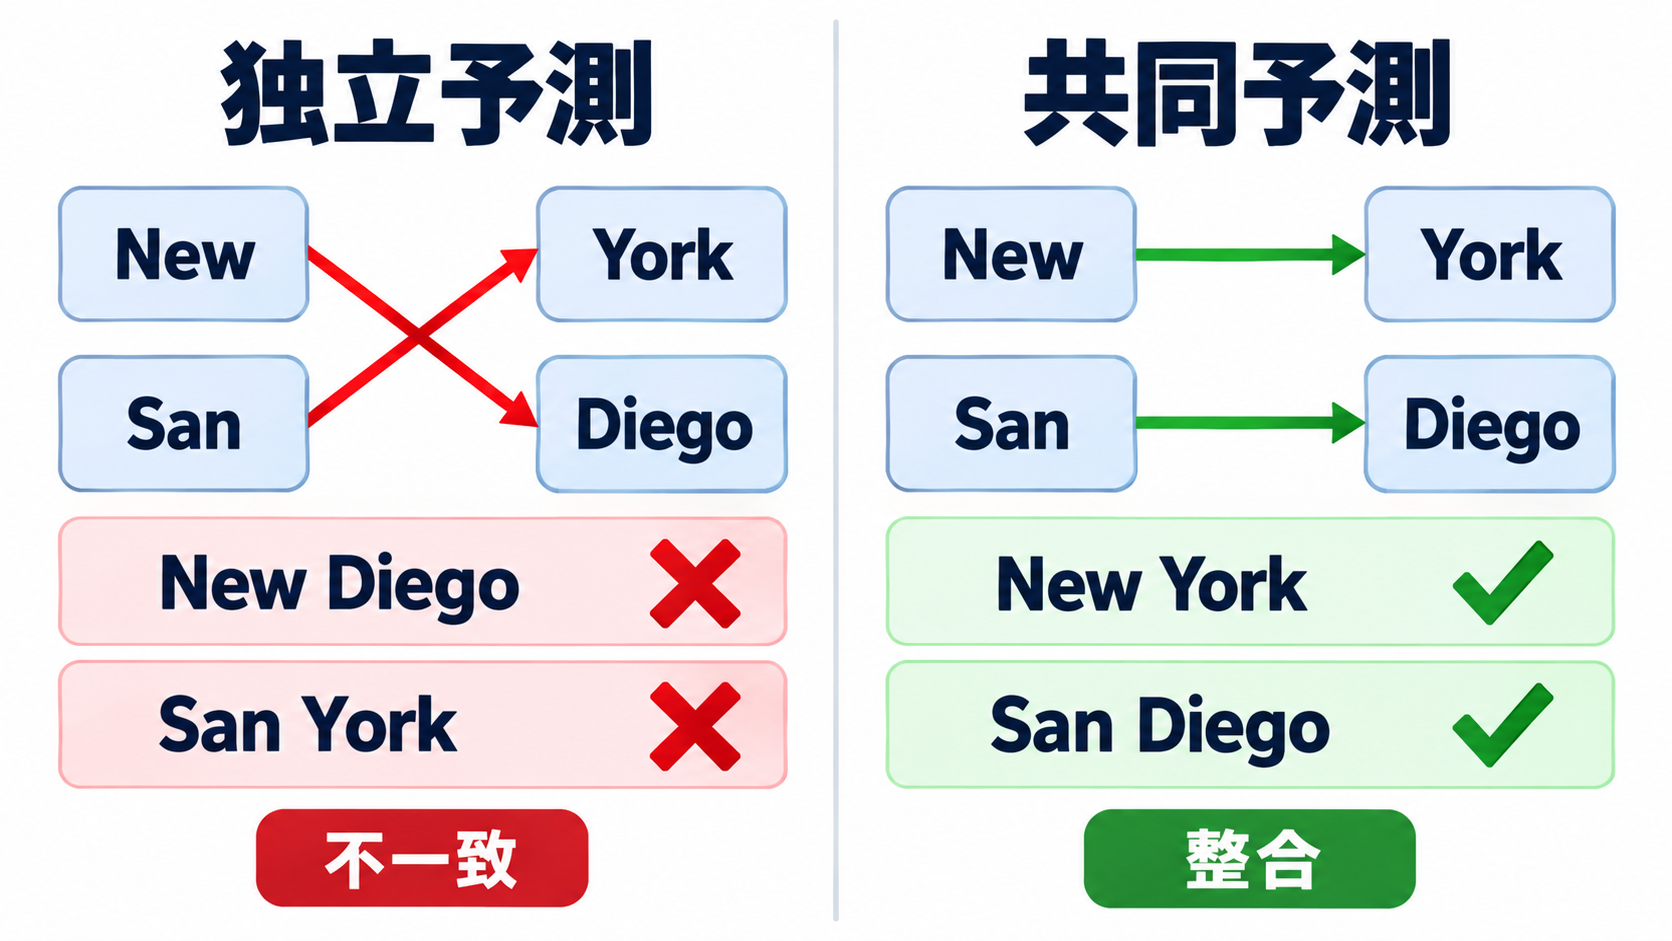
ブロック型ドラフターの難しさは、各位置で確率の高いトークンを選ぶだけでは、まとまりとして自然な候補になるとは限らないことです。DFlashはブロック内の各位置を独立に予測する「因子化近似」を採用しています。1回で候補を出せる反面、位置同士の依存関係を直接表現しにくい構造です。たとえば、続きとして「New York」と「San Diego」が同じ程度に考えられる場面を想定します。各位置を別々に選ぶと、「New Diego」や「San York」のように、それぞれの単語は候補に含まれていても、組み合わせとして不自然な案が生まれます。ターゲットモデルは2番目の語で不一致を検出し、それより後ろの候補も受理できません。
FlashMapでは、一つのノイズサンプルを一つの完全なトークンブロックへ写像します。ノイズがブロック全体の生成モードを選ぶため、「New」を選んだ流れでは「York」へ、「San」を選んだ流れでは「Diego」へ向かうような共同構造を学習できます。研究チームが狙っているのは、各位置の正解率を個別に高めることだけではなく、候補列として成立する確率を上げることです。
この差は固有名詞に限りません。コードの構文、数式の途中式、定型的な業務文書など、前の選択によって後続候補が強く制約される生成では、トークン間の関係が受理長に影響すると考えられます。ただし、個別の業務領域でどの程度有利になるかは今回の結果だけでは判断できません。公開された評価は数学、コード、チャットを含む9ベンチマークで行われており、企業固有の文書や専門用語については別途検証が必要です。
FlashMapの中心的な提案は、予測回数を減らすだけでなく、一括生成される候補の意味的・構文的な整合性も速度設計の一部として扱うことにあります。
連続フローを1ステップへ圧縮する学習方式
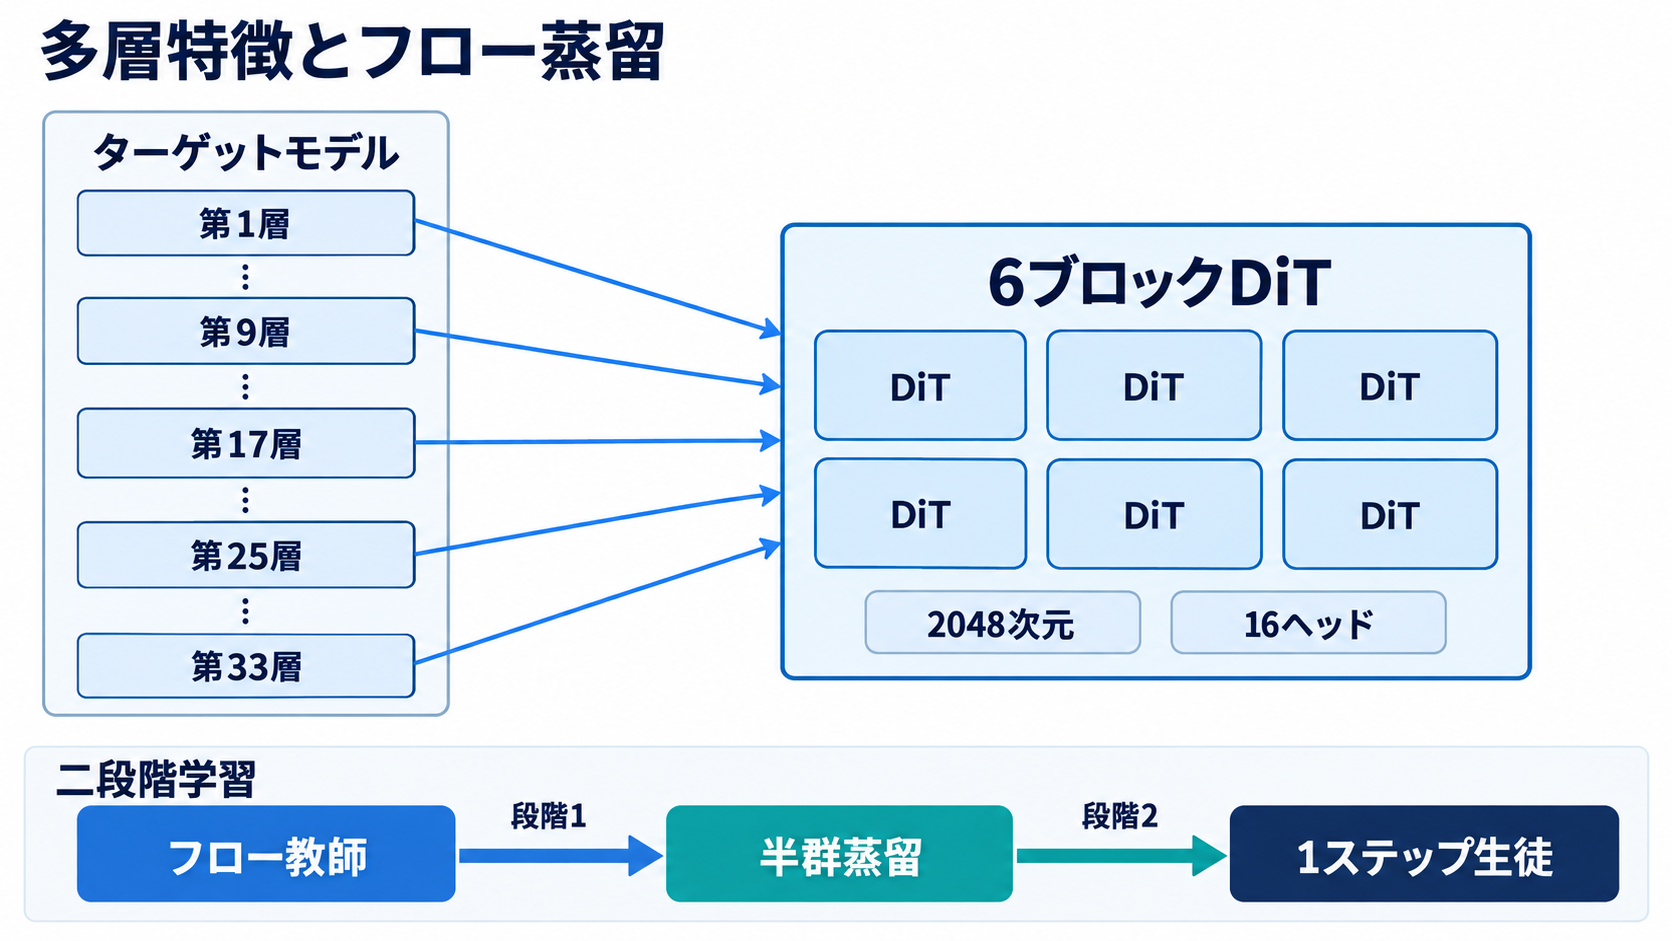
FlashMapのドラフターは、6ブロックの拡散Transformer(DiT)で構成されています。埋め込み次元は2,048、アテンションヘッドは16です。ターゲットモデルの第1、9、17、25、33層から隠れ状態を受け取り、すでに計算された文脈表現を候補生成へ利用します。埋め込み行列とLMヘッドはターゲットモデルからコピーされ、学習中は固定されます。これにより、ターゲット側の語彙表現と出力空間を共有しながら、ドラフトに必要な部分を学習する設計です。Qwen3の語彙数は151,936と大きいため、連続フローの時間パラメーターを調整する再パラメーター化も組み込まれています。
学習は二段階です。第1段階のフロー教師モデルは、ワンホット表現されたトークンブロック上の連続フローをクロスエントロピーで学びます。ノイズからデータへ徐々に移動する経路を捉える役割があり、共同分布を表現する基盤となります。
第2段階では、半群蒸留と呼ばれる手法を使い、そのフローを二つの時刻を扱うデノイザーへ圧縮します。これによって、複数ステップでたどる変換を、実行時にはノイズからトークン候補へ1ステップで移れるようにします。共同構造を学ぶ教師と、低コストで実行する生徒を分ける発想です。
Qwen3-8B用とQwen3-4B用のドラフターは、いずれもOpen-PerfectBlendから得た50万サンプルで訓練されました。全モデルとアブレーション実験を合わせた計算量は、NVIDIA H200で約4,600 GPU時間と報告されています。これは公開済みの重みを利用する企業が同じ計算を負担するという意味ではありませんが、別のターゲットモデルへ展開する場合には、専用ドラフターの学習や適合確認が軽い作業ではないことを示唆します。
ベンチマークで見える強みと条件差
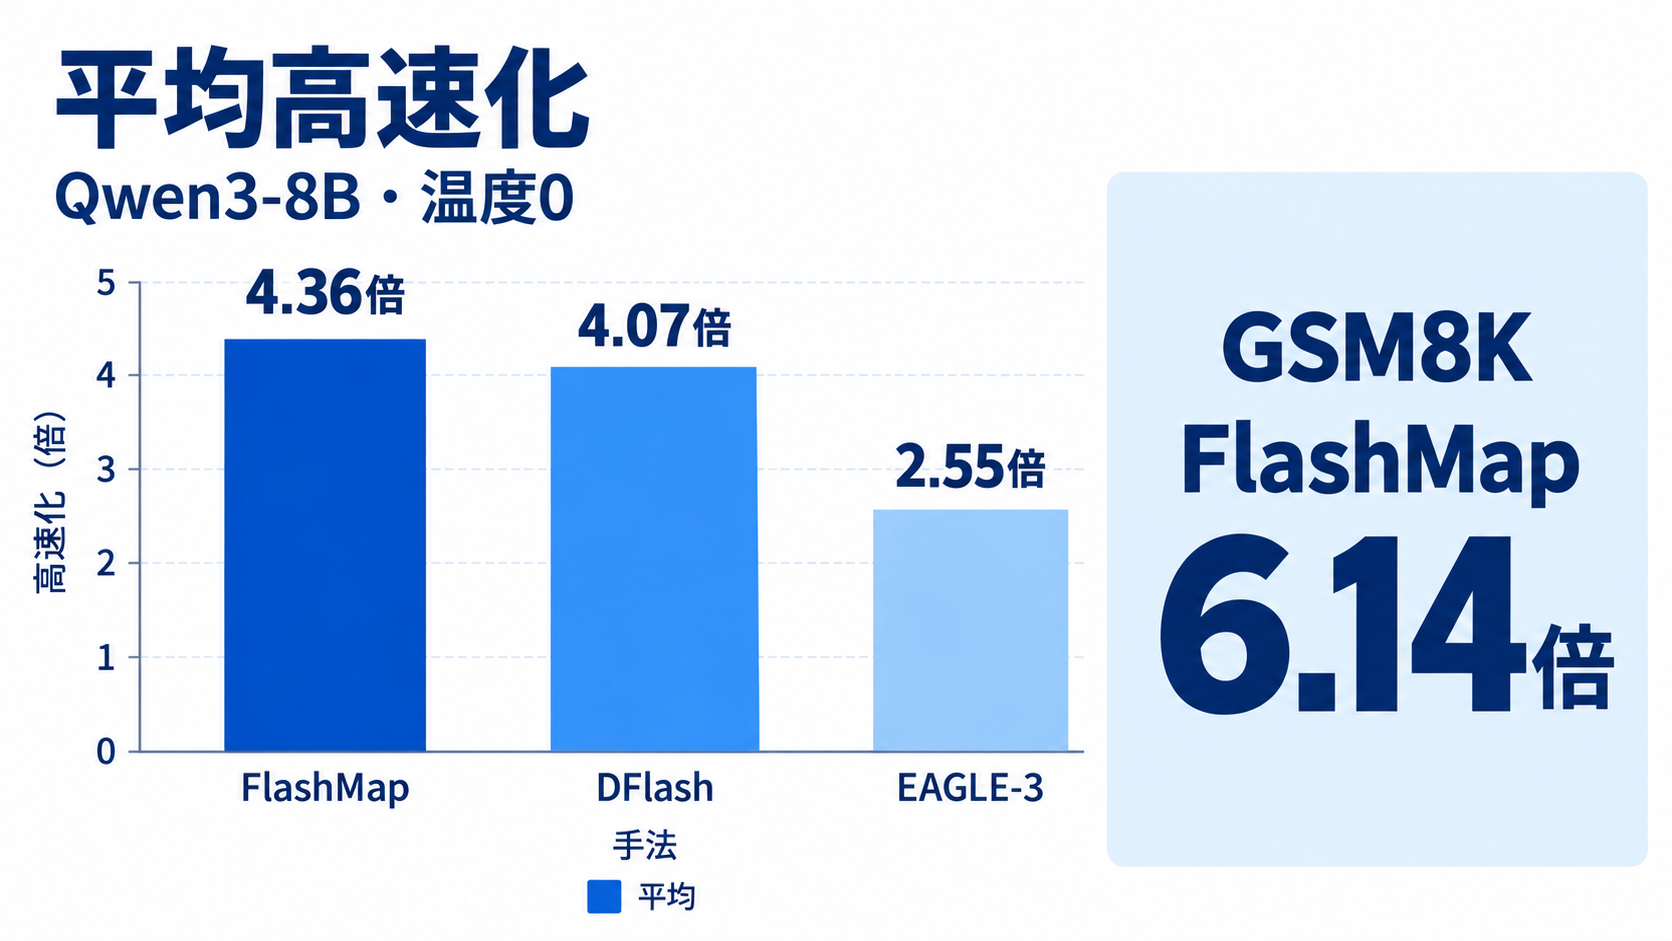
比較では、学習データと設定をそろえてEAGLE-3とDFlashを再訓練し、数学、コード、チャットにまたがる9種類のベンチマークを温度0と1で評価しています。この条件統一は重要です。異なる研究が掲げる最大値を横に並べるよりも、同じ環境で測った結果の方が方式の差を読み取りやすいためです。Qwen3-8Bでは、1ステップ版FlashMapが両方の温度設定において全9タスクで最速でした。平均速度は温度0で4.36倍となり、DFlashの4.07倍、EAGLE-3の2.55倍を上回っています。GSM8KではFlashMapが6.14倍、DFlashが5.77倍、EAGLE-3が3.20倍でした。
| 比較項目 | FlashMap | DFlash | EAGLE-3 |
|---|---:|---:|---:|
| Qwen3-8B向けドラフター規模 | 5億 | 10億 | 3億200万 |
| 温度0の平均高速化 | 4.36倍 | 4.07倍 | 2.55倍 |
| GSM8K・温度0 | 6.14倍 | 5.77倍 | 3.20倍 |
| 候補の作り方 | 共同・1〜2回 | 各位置を独立・1回 | 自己回帰・ツリー |
FlashMapは、受理長でもDFlashを18条件中15条件で上回りました。温度0におけるDFlash比の改善幅は、数学タスクで5.5%、チャットで11.1%です。ここでの受理長は回答の正答率ではなく、ドラフト候補が連続して何トークン採用されたかを表す指標である点には注意が必要でしょう。
EAGLE-3は温度1でFlashMapより受理長が9%高いものの、実行速度は35%遅いと報告されています。候補の質だけを高めても、候補生成そのものが重ければ全体速度で不利になることを示す結果です。FlashMapは受理率の最大化ではなく、受理される長さとドラフト費用の均衡で優位に立っています。
結果はモデル規模によっても変わります。Qwen3-4Bの温度0では、FlashMapは9タスク中4タスクでDFlashを下回りました。最大6.14倍という値は、H200 NVLを1基使用し、bf16、同時実行数1で測定したQwen3-8BとGSM8Kの結果です。実際の導入判断では、平均値、下限に近い条件、利用モデルの三つを併せて確認しなければなりません。
1ステップ、2ステップ、複数候補の選び分け
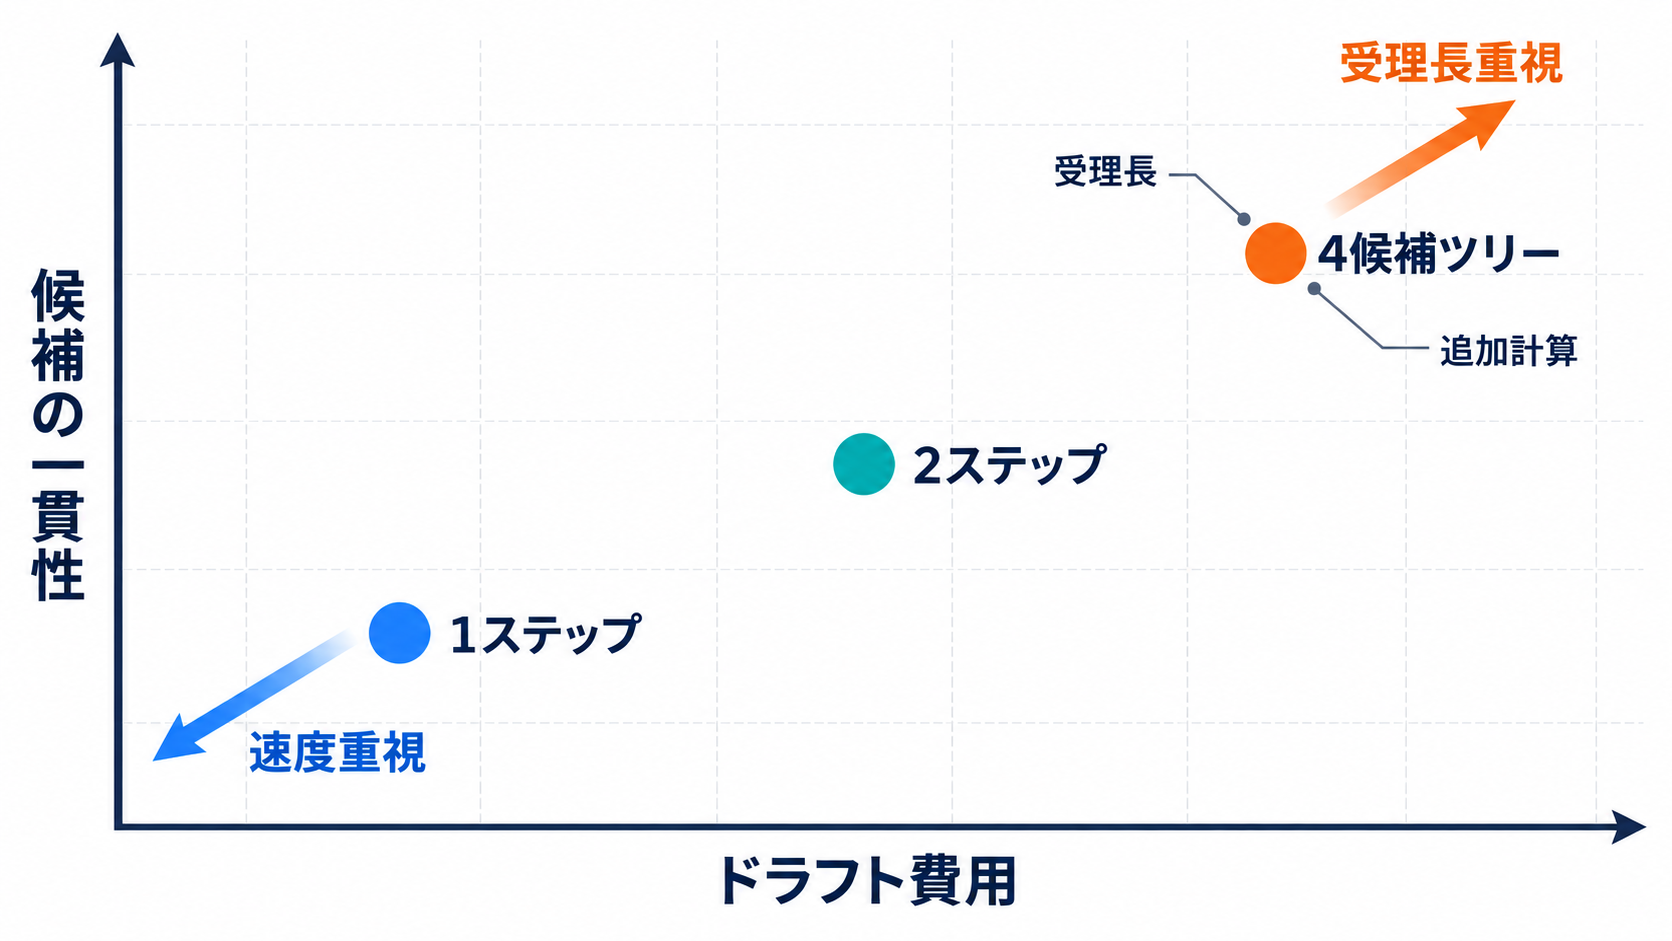
FlashMapには1ステップと2ステップの動作があります。1ステップはドラフト費用を最小限に抑える構成で、Qwen3-8Bの速度比較では最も良い結果を示しました。2ステップにすると追加計算が生じる代わりに候補の一貫性が高まり、DFlashを18条件すべての受理長で上回り、平均改善率は10%となっています。研究チームは、生成したブロックの順序を崩すシャッフルテストによって、モデルがトークン間構造を実際に利用しているかも調べました。2ステップ版は、16ステップの教師モデルが持つ共同構造の利得を大部分取り戻しています。対照的に、1ステップ版が保持する利得は小さな割合にとどまりました。
それでも1ステップ版が高い速度を示すのは、構造表現の強さだけで最終性能が決まらないためです。2回目の処理で受理トークンが増えても、その増加分が追加計算を埋め合わせられなければ、応答時間は短くなりません。共同構造をどこまで精密に再現するかと、ドラフトに使う時間の間に明確なトレードオフがあります。
別の選択肢として、4個のノイズサンプルから複数の候補をツリー状に作る方法も評価されました。この構成では平均高速化率が11%向上しています。単一候補に賭けるのではなく、異なる生成モードを並行して用意し、ターゲットモデルと一致する可能性を高める考え方です。
実運用では、対話UIのように初回応答の速さを優先するなら1ステップが出発点になります。コードや定型文など、長く一貫した候補が受理されやすい処理では、2ステップや複数候補も比較対象になるでしょう。設定名だけで決めず、追加されたドラフト時間と削減できたターゲット呼び出し回数を同じ計測結果の中で見る必要があります。
vLLMとSGLangを使った導入経路
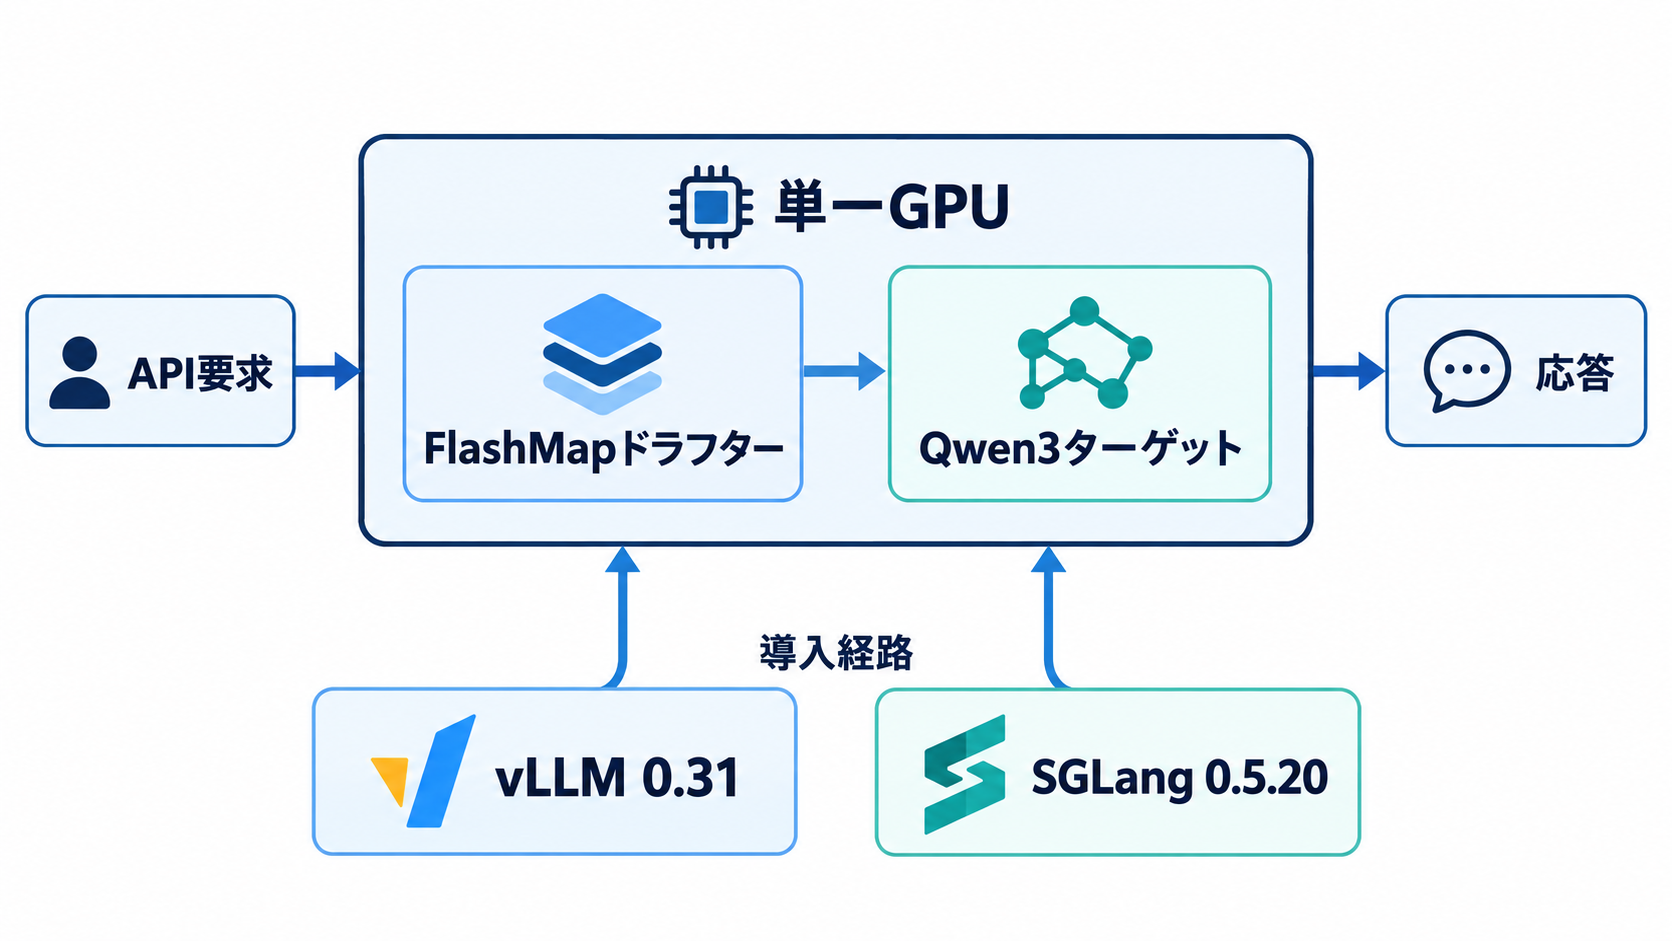
FlashMapのパッケージが必要とする主な依存関係は、PyTorchと`transformers>=4.56`です。`uv pip install flashmap`で導入でき、`spec_generate`を使ってドラフターとターゲットモデルを同一GPU上で動かします。別の推論サーバーを追加する構成ではないため試しやすい反面、同じGPUの計算資源とメモリーを両モデルで共有します。サービング向けには、vLLMとSGLangのプラグインが用意されています。公開されている手順では、vLLM 0.31の`--speculative-config`にドラフターを指定し、`num_speculative_tokens`を16に設定します。SGLang 0.5.20では、`--speculative-algorithm DSPARK`とFlashMapのドラフトモデルへのパスを指定する構成です。
`num_steps=2`を選ぶと、処理を増やして受理長を高めるモードへ切り替えられます。温度0を超えるサンプリングをvLLMで行う場合には、`draft_sample_method`を`probabilistic`にする必要があります。温度設定は速度だけでなく候補の一致しやすさにも関わるため、本番と異なる温度で測った値をそのまま容量設計に使うべきではありません。
公開済みのドラフター重みはQwen3-8BとQwen3-4B向けです。ドラフターはターゲットモデルの中間層や埋め込みを前提にするので、任意のLLMへ同じ重みを接続できる汎用アクセラレーターではありません。採用前には、対象モデル、ライブラリのバージョン、重みの対応関係を固定して再現性を確認する必要があります。
重みはApache-2.0、コードはMITライセンスで公開されています。商用検討では利用しやすい条件ですが、ライセンス確認だけで導入準備が終わるわけではありません。GPUメモリー、同時実行時のスループット、既存の量子化やキャッシュ機構との組み合わせなど、自社の推論構成全体で評価することが欠かせないでしょう。
企業が6.14倍より先に確認すべき指標
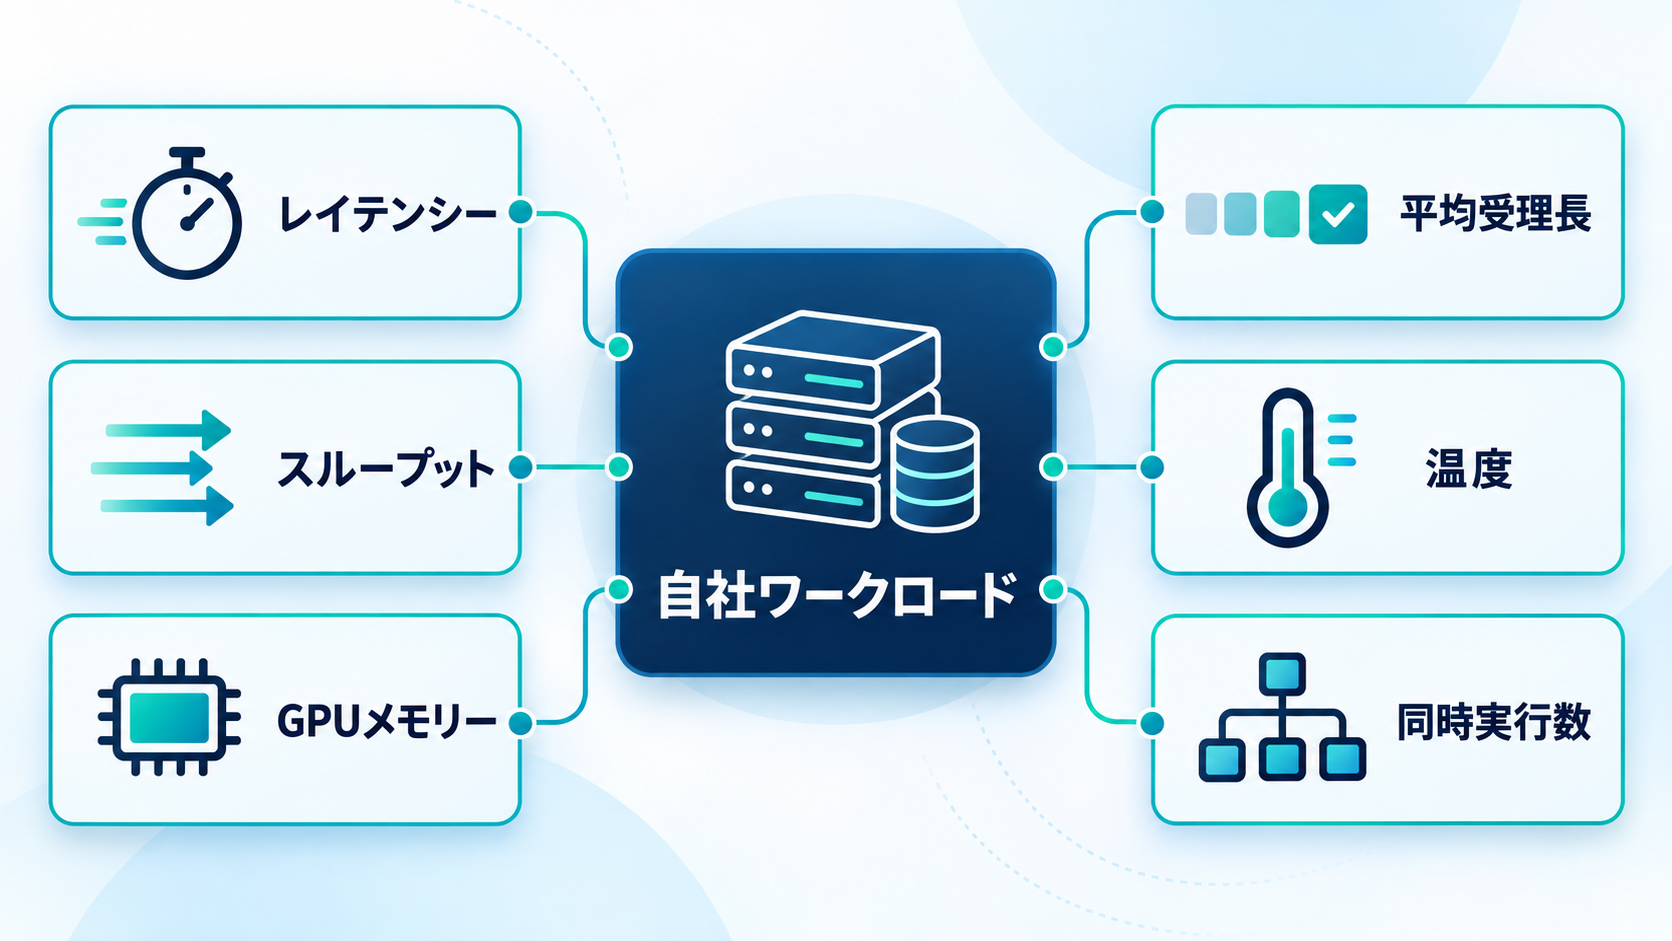
B2BシステムでFlashMapを評価する際は、最大高速化率を目標値として置くより、実際のリクエスト分布に合うかを確かめる方が現実的です。GSM8K、温度0、同時実行数1という好条件は、社内チャット、文書生成、コード支援などの本番負荷をそのまま表すものではありません。小規模な検証では、従来デコードとFlashMapを同じGPU、同じターゲットモデル、同じプロンプト群で比較します。確認したいのは、平均応答時間だけではありません。初回トークンまでの時間、生成完了までの時間、時間当たりの処理量、GPUメモリー、候補の平均受理長を並べると、どこで効果が生まれたかを把握しやすくなります。
温度0と、実運用で使用するサンプリング設定は分けて測るべきでしょう。今回の結果でも、温度やタスクによって2.28倍から6.14倍まで差があります。同時実行数を増やした場合には、単一リクエストの短縮率だけでなく、サーバー全体の処理能力がどう変わるかも確認が必要です。
品質面では、ロスレスという仕組みを理解したうえで、従来経路と同じ生成規則が維持されているかをテストします。バージョンや確率的サンプリング設定の違いが混ざると、方式ではなく構成差を比較してしまう恐れがあります。既存の監視、タイムアウト、フォールバック経路がドラフター追加後も機能するかも運用上の確認事項です。
FlashMapが示したのは、投機的デコーディングの改善余地が単なる小型化だけではなく、トークン群を共同で予測する設計にもあることです。導入を検討する企業は、代表的なプロンプトを少量選び、まずQwen3対応環境の1基のGPUで1ステップ版を比較するとよいでしょう。その結果から受理長とドラフト費用の内訳を確認し、必要な場合だけ2ステップや複数候補へ広げる進め方が適しています。