
2026/10/28
AIニュース
Google「Genie 4」、会話で書き換える3D世界をロボット学習へ
映像生成から「操作できる世界」への転換
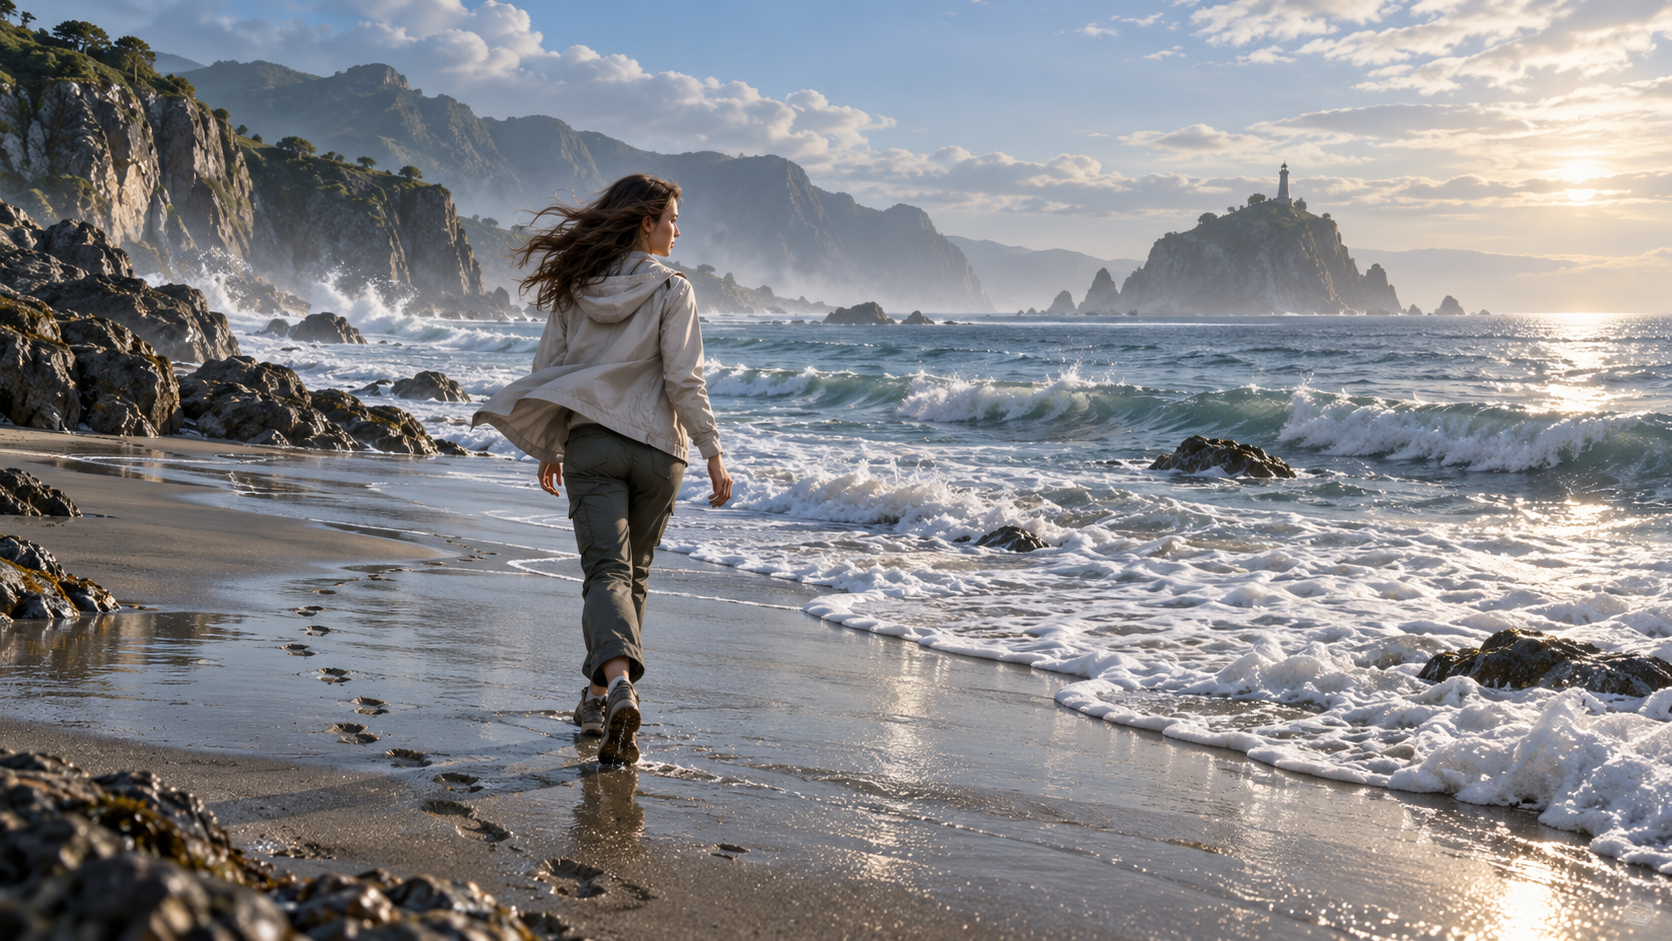
「波打ち際を歩く人物」を映像にするだけでなく、途中で天候を変え、物体を追加し、カメラを動かしながら世界を探索できるとしたら、生成AIの用途はどこまで広がるでしょうか。Googleは、自然言語から写実的な3D環境を生成する世界モデル「Genie 4」をプレビューしました。2024年から展開してきた同社の世界モデル群に加わる新モデルで、従来版より滑らかな動きや複雑な細部の表現が改善されたと説明しています。世界モデルとは、環境の状態や、その中で起きる変化を表現するAIモデルです。一般的な動画生成では、完成した映像を視聴する体験が中心になります。Genie 4が目指すのは、生成された環境へ利用者が継続的に働きかけられる仕組みです。入力に応じて場面が変化しても、人物、物体、背景の関係を保つ必要があるため、単に高精細なフレームを作るだけでは足りません。
Google DeepMindが特に強調しているのは、人間の動作と環境への反応です。登場人物が自然に動き、周囲の変化へ違和感なく反応し、利用者がリアルタイムで操作できるとしています。波が砕ける音のような環境音も生成対象に含まれました。映像、音、操作、時間的な一貫性を組み合わせた点に、Genie 4の中心的な狙いがあります。
ただし、誰もがすぐ利用できる段階ではありません。現在は限られた早期利用者によるテストが進められており、今後は個人向けのGoogle AI Ultra、開発者向けのGemini API、Google AI Studioを通じて提供する計画です。企業にとっては、完成度の高いデモ映像よりも、操作を重ねた際に世界がどれだけ破綻せず応答するかが、実用性を見極める焦点になるでしょう。
会話とキーボードで変化する生成環境
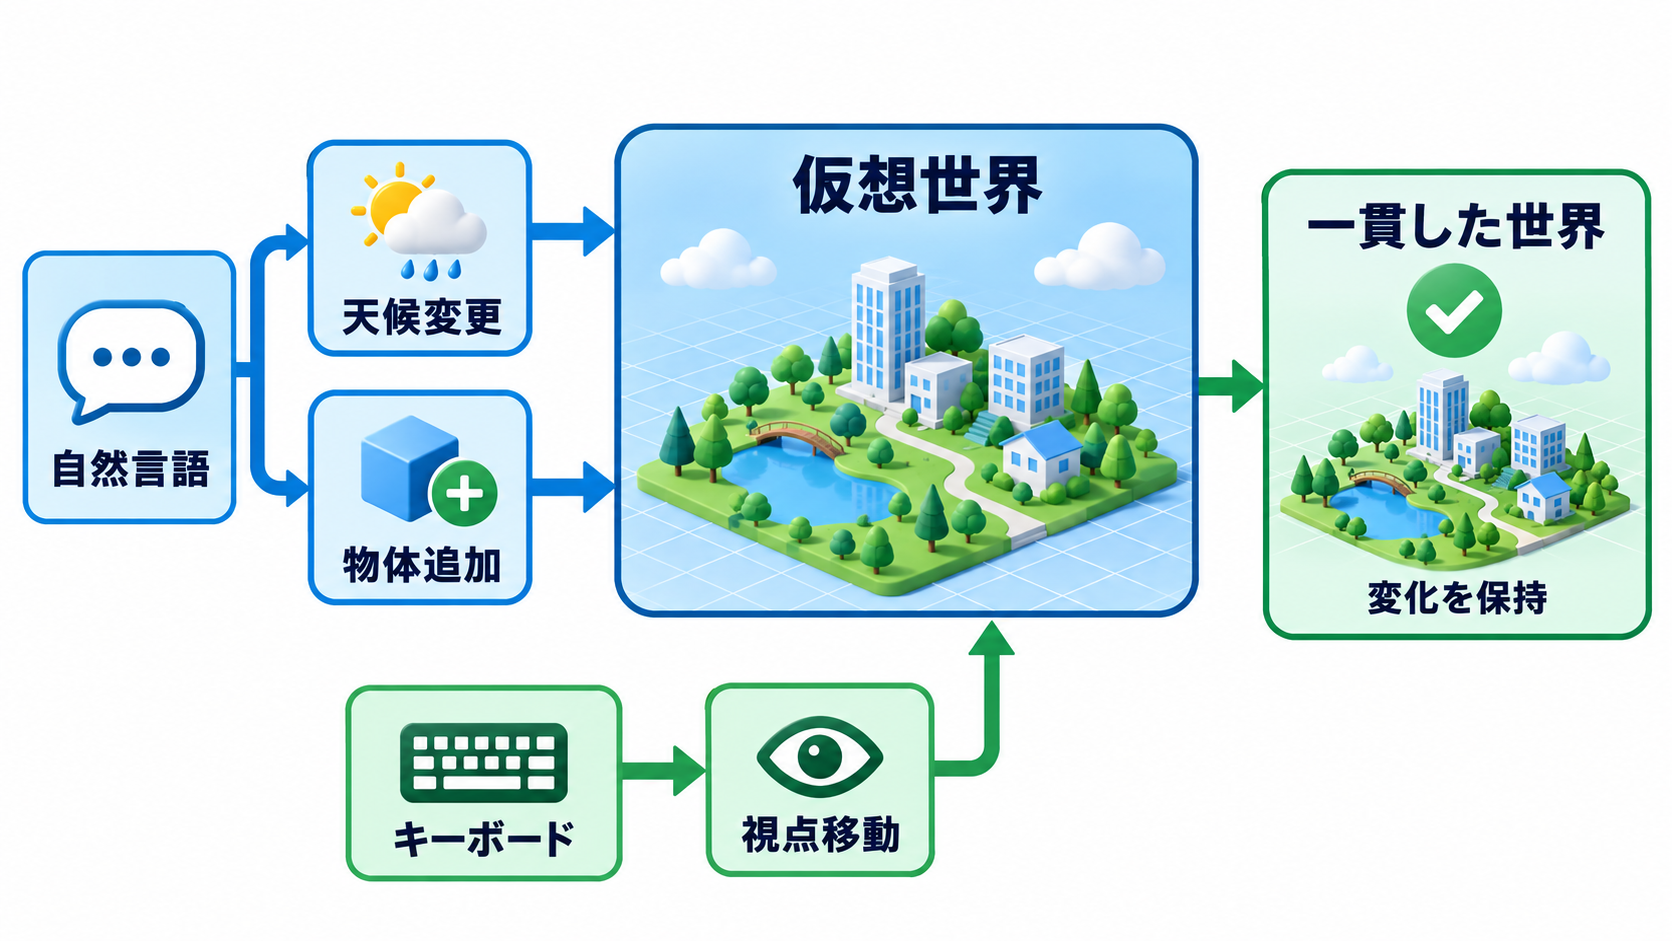
Genie 4では、作りたい世界を自然言語で記述すると、対応する仮想環境が生成されます。利用者はその空間を移動しながら、追加の指示によって内容を変更できます。たとえば、晴天を雨へ変える、場面に物体を加えるといった編集が可能です。Googleは、こうした変更を加えても、写実性や世界全体の一貫性を損なわないよう設計したと説明しています。操作方法は文章による指示だけではありません。キーボード操作を併用し、カメラの位置や角度を変えられます。言葉は場面の意味や構成を変更するために使い、キーボードは視点を直接調整するために使うという役割分担です。この組み合わせにより、利用者は毎回新しい映像を生成し直すのではなく、ひとつの環境に留まりながら試行を続けられます。
企業利用を考えると、この編集方式は「最初の指示だけで望む成果を得る」という使い方からの転換を示します。デザイナーや開発者が結果を確認し、修正指示を重ねて仕上げる対話型の制作工程に近いからです。製品コンセプトの検討や空間演出の試作などへの応用は考えられますが、Googleが今回明らかにした中心用途は、生成環境の探索とロボット向けシミュレーションです。個別業界への適合性は、実際の提供条件と出力精度を確認して判断する必要があります。
生成結果の価値を左右するのは、個々の画像の美しさだけではありません。視点を変えたときに物体の位置関係が保たれるか、天候を変えた後も人物の動きが自然か、追加した物体が次の操作でも存在し続けるか、といった連続性が問われます。会話で編集できること自体より、編集後の世界が矛盾なく続くことのほうが、業務用途では重要な評価項目になると考えられます。
複数のGeminiモデルが支える一貫性
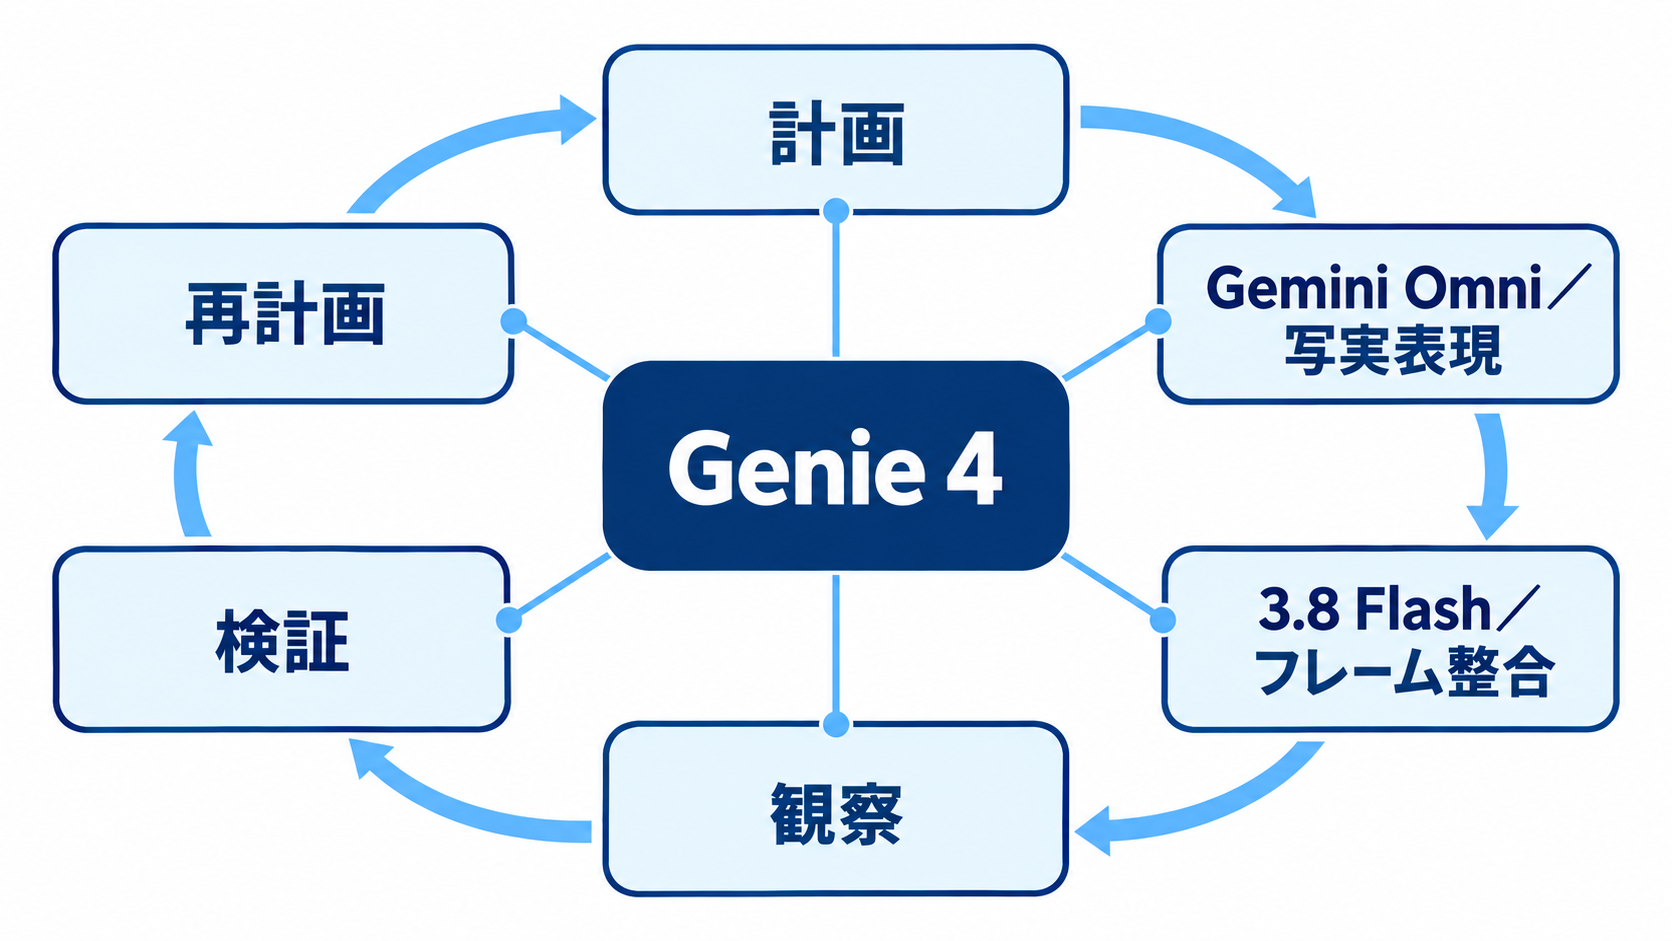
Genie 4の出力は、単独のモデルだけで作られているわけではありません。Googleは複数の自社モデルを組み合わせ、写実性と時間的な一貫性を高めています。視覚表現を担うのが、同社が5月に発表した動画生成モデル「Gemini Omni」です。生成される人物、物体、背景などの見た目を現実的に保つ役割を受け持ちます。フレーム同士のつながりには、コスト効率を重視した推論モデル「Gemini 3.8 Flash」が使われています。動画やシミュレーションでは、一枚ごとの画像が精細でも、直前まで存在した物体が突然消えたり、人物の姿勢が不自然に変わったりすれば、世界としての信頼性が崩れます。Gemini 3.8 Flashは個別フレームを継続的に確認し、場面の状態を整合させる役割を担うとされています。
Google DeepMindの説明によると、Geminiは場面を観察し、目標を複数の手順へ分解したうえで、届いたフレームから進捗を追跡します。それぞれの手順が成功したかも確認し、世界の変化や利用者の介入があれば、その場で計画を調整します。生成、観察、検証、再計画を繰り返す構造であり、一度だけ指示を処理する仕組みとは性格が異なります。
この役割分担は、企業が生成AIシステムを評価する際にも参考になります。見た目の品質、指示の解釈、時間的な整合性、目標達成の確認は、それぞれ異なる課題です。Genie 4は、用途別に最適化されたモデルを連携させることで、それらを一つの操作体験にまとめています。もっとも、構成が複雑になるほど処理時間や利用コスト、障害発生時の切り分けも検討事項になるでしょう。これらの具体的な性能値や運用条件は、現時点では明らかにされていません。
人物・環境音がもたらす没入感
Google DeepMindがGenie 4で最も大きな進歩として挙げたのは、人物のシミュレーションです。キャラクターが自然に動くだけでなく、その場の環境へ有機的に反応し、利用者がリアルタイムで進行方向や行動に関与できると説明しています。人間の動きは関節の連続性、重心、周囲との接触など複数の要素が絡むため、静止した風景より破綻が目立ちやすい領域です。音も、世界を理解する手掛かりになります。Genie 4は、波が砕ける音など、生成した場面に伴う音声を作れます。視覚と音が一致していれば、利用者は画面に映っていない出来事や、物体との距離感を把握しやすくなるでしょう。反対に、映像と音のタイミングがずれれば没入感は損なわれるため、実用段階では両者の同期も確認すべき点になります。
こうした機能は、完成済みの映像を一方向に見せる用途より、利用者の行動によって展開が変わる体験と相性がよいと考えられます。研修環境や製品体験の試作なども検討候補になり得ますが、これらへの正式な対応が示されたわけではありません。企業が応用範囲を判断するときは、魅力的な一場面だけでなく、長時間操作した際の人物の一貫性や、想定外の入力に対する挙動を見る必要があります。
人物表現には、技術品質とは別の注意点もあります。実在人物に似た外見が生成される可能性、用途に適さない行動、偏りを含む表現などをどう管理するかは、導入側の確認事項です。Googleによる安全対策や利用制限の詳細は今回示されていないため、提供開始後の規約や技術文書を待つ必要があります。没入感の高さだけで採用を決めず、生成物の利用範囲と確認責任を事前に定めることが欠かせません。
ロボット学習用データを作る新しい流れ
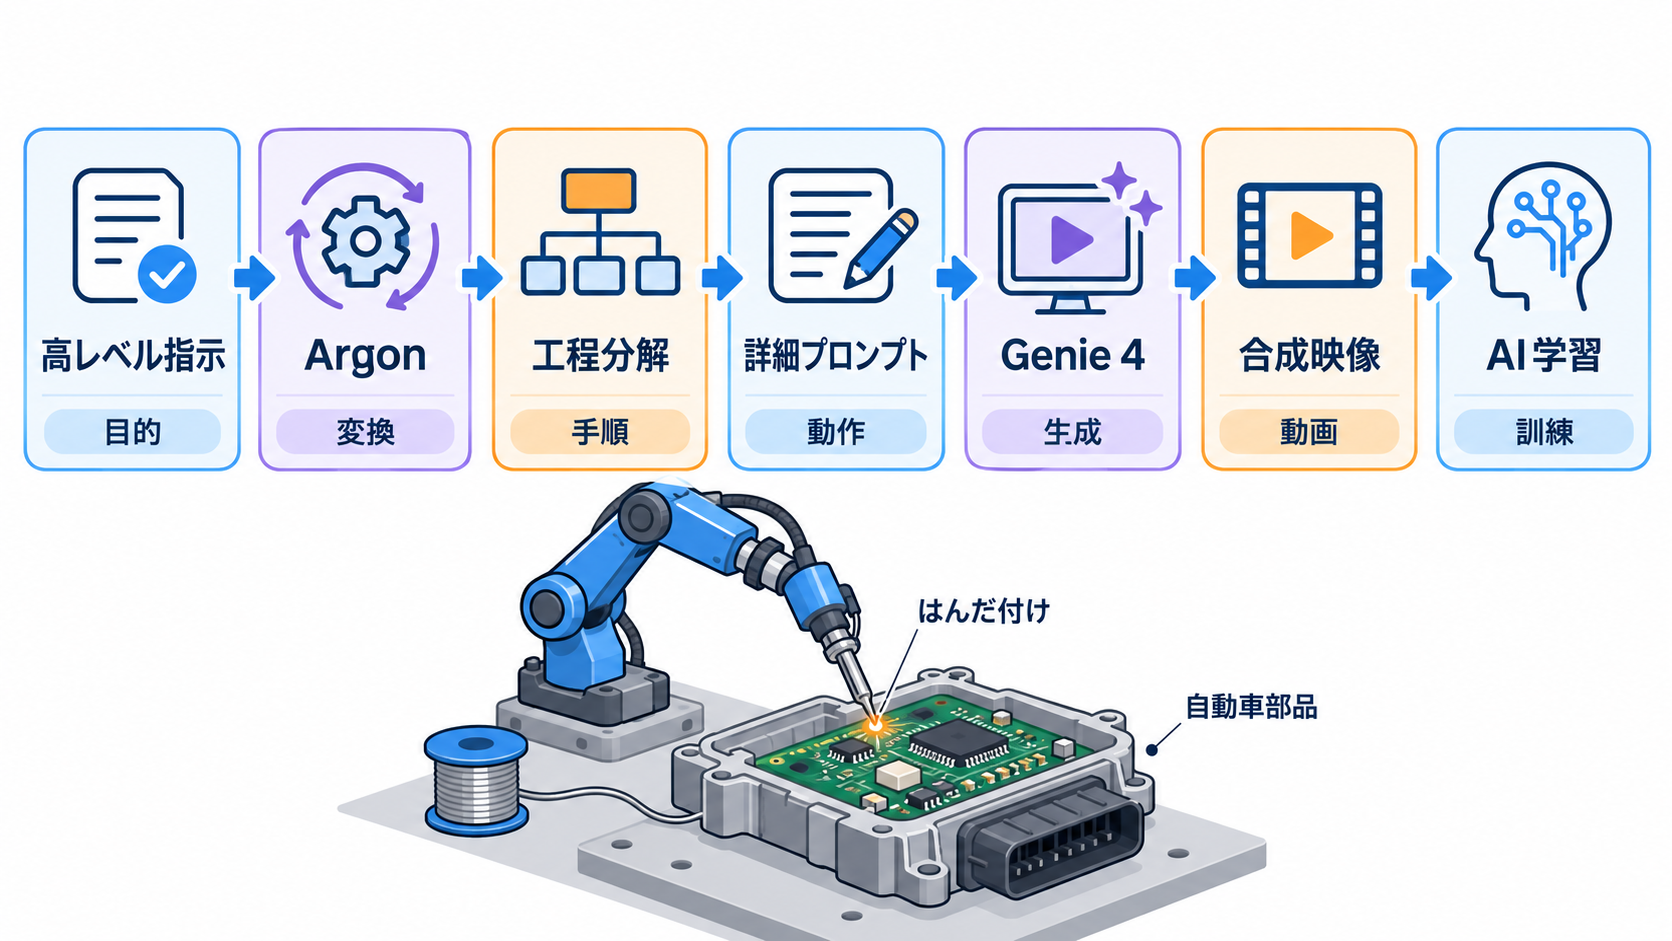
Google DeepMindは、Genie 4をロボティクスへ応用する研究も進めています。この取り組みでは、Genie 4と、推論に最適化されたGoogleの主力大規模言語モデル「Gemini 4 Argon」を組み合わせます。狙いは、技術者が細かな映像演出を一つずつ指定しなくても、上位レベルの指示からロボットの作業シミュレーションを生成できるようにすることです。例として示されたのが、ロボットアームで二つの自動車部品をはんだ付けする作業です。利用者が短い依頼をArgonへ入力すると、Argonは作業を細分化し、各段階を記述する数十件の詳細なGenie 4向けプロンプトへ展開します。それぞれは複数の文からなり、ロボットの動きや対象物、作業の進行を具体的に指示します。Genie 4は、その指示群を基に合成映像を生成する仕組みです。
プロンプトの数と精度を高めるほど、Genie 4の描画品質も向上するとGoogleは説明しています。ロボット制御AIは、実行すべき作業の視覚例を学習材料として利用します。そのため、手順が曖昧な映像や物理的に不自然な映像では、訓練データとしての価値が下がりかねません。Argonが作業計画を詳細な記述へ変換し、Genie 4が視覚例にする流れは、合成データ作成の品質を指示設計の段階から高めようとするものです。
ただし、写実的に見える映像が、そのまま現実の物理現象を正確に再現しているとは限りません。接触、摩擦、工具の扱い、作業誤差などが現実と異なれば、シミュレーションで学んだ制御を実機へ移した際に問題が生じる可能性があります。企業がロボット学習へ利用する場合は、生成映像の外観だけでなく、手順の妥当性や物理的整合性を専門家が検証し、実環境のデータと組み合わせて評価する必要があるでしょう。
企業導入で見極めたい価値と未確定要素
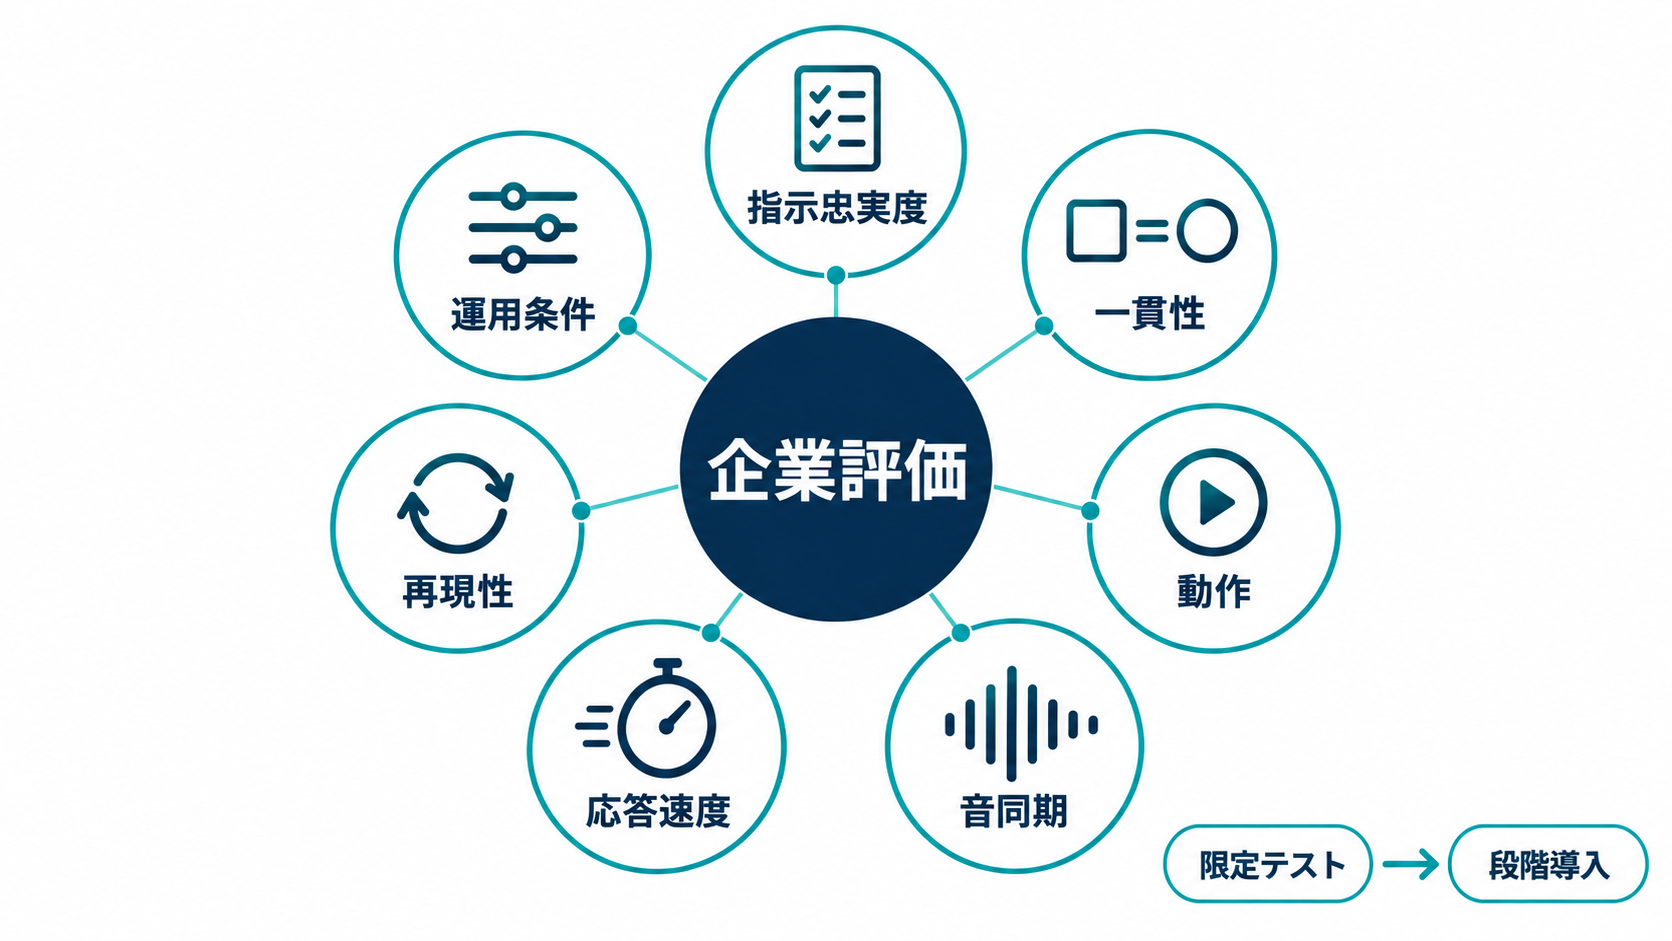
Genie 4が企業へ提供する価値は、3Dコンテンツを素早く作れることだけではありません。試したい場面を言葉で定義し、その場で条件を変えながら複数の展開を確認できる点にあります。現実の設備や人員を使った撮影・検証が難しい場面では、仮想環境を使う意義が生まれます。ただし、具体的な費用削減や開発期間の短縮は発表されておらず、効果は用途ごとに測定しなければなりません。評価では、画質だけに注目しないことが大切です。指示への忠実度、連続操作後の一貫性、人物や物体の動き、音との同期、応答速度、出力の再現性などを、実際の業務シナリオに沿って確認する必要があります。ロボット学習に使うなら、生成した手順の正確性と現実環境への転用可能性が中心になります。体験設計に使う場合は、操作のしやすさや、変更指示が既存の場面へ与える影響も評価対象になるでしょう。
提供先としてGoogle AI Ultra、Gemini API、Google AI Studioが挙げられていますが、一般提供の開始時期、料金体系、利用量の上限、処理時間などの詳細は示されていません。企業向けには、入力データの保持方法、生成物の利用条件、監査ログ、アクセス制御、サービス水準も判断材料になります。利用可能な窓口が発表されたことと、本番業務に必要な運用条件が整ったことは分けて捉えるべきです。
市場への影響という観点では、世界モデルが動画制作の道具にとどまらず、AIやロボットを訓練する環境へ接続されつつある点が注目されます。もっとも、現段階は限定的な早期テストです。企業は将来性だけを前提に大規模な計画を組むのではなく、公開後に確認できる仕様と自社データによる検証結果を基に、投資範囲を段階的に決めるのが現実的でしょう。
日本企業が準備できる小規模な検証設計
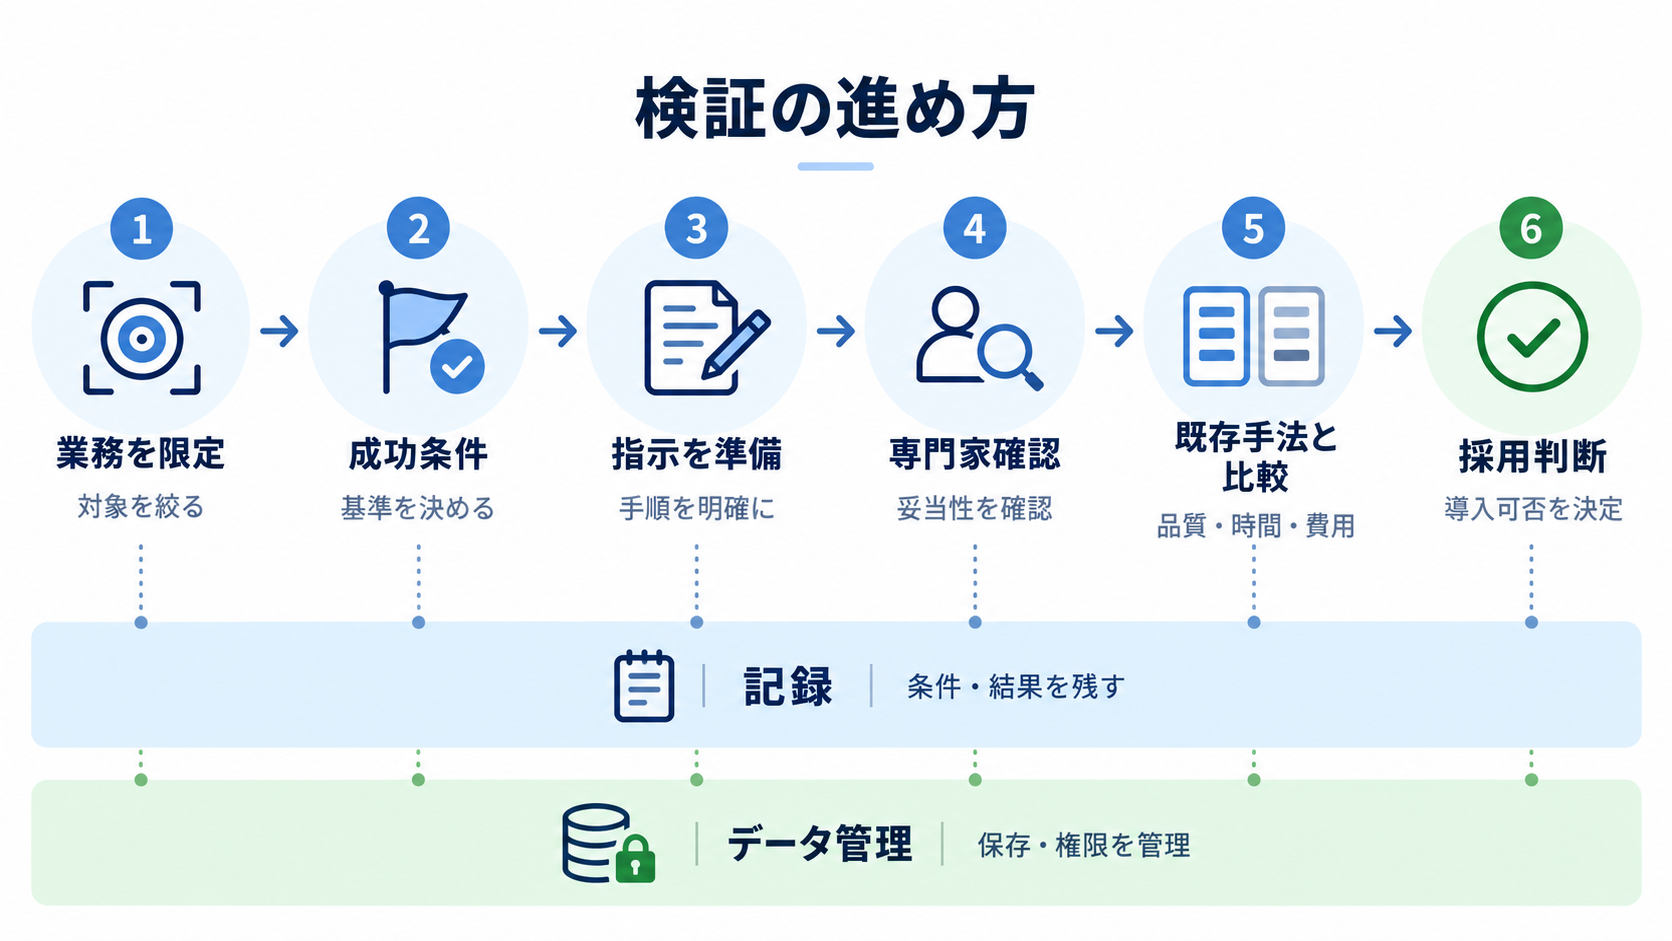
Genie 4の提供を待つ間にも、企業は検証対象を具体化できます。出発点は、「世界モデルを使いたい」という広い目標ではなく、ひとつの業務場面を選ぶことです。たとえばロボット作業を想定するなら、対象物、開始状態、作業手順、期待する完了状態を文章で定義します。どの条件を変更し、何が維持されれば成功とするのかも決めておけば、生成映像の印象だけに左右されにくくなります。検証用の指示は、高レベルの依頼と詳細な工程記述を分けて準備するとよいでしょう。Argonが短い指示を数十件のプロンプトへ展開する構成を踏まえ、人間が作った工程表とAIが生成した工程を比較できるようにします。各工程について、物体の位置、動作の順序、安全上の制約、完了条件を確認すれば、どの段階で誤りが生じたかを追いやすくなります。日本語による指示への対応品質は示されていないため、提供後に実際の業務用語を使って確かめる必要があります。
生成物を訓練データへ利用する場合は、人による確認工程を外せません。現場担当者、ロボット技術者、AI開発者が異なる観点で評価し、見た目は自然でも作業として誤っている映像を除外する仕組みが必要です。採用したデータの生成条件やプロンプト、確認結果を記録しておけば、後からモデルの挙動を検証しやすくなるでしょう。機密情報を含む図面や設備データを入力する可能性があるなら、契約条件とデータ処理方針の確認も前提になります。
最初の実証では、広い仮想工場を作るより、短い一作業に範囲を絞るほうが比較しやすくなります。成功率、一貫性、修正回数、専門家による承認率など、自社に必要な指標を先に置くことが肝心です。Genie 4が利用可能になった段階で、準備した同一シナリオを実行し、実写データや既存シミュレーターと比較すれば、採用判断につながる具体的な材料を得られるでしょう。