
2026/10/29
AIニュース
モデルを変えずにAIエージェントを育てる「Hermit」――外付けハーネスを学習対象にする新設計
モデルの再学習ではなく「エージェントの働き方」を更新
AIエージェントを自社業務に合わせようとすると、モデルの追加学習やプロンプトの個別調整、実行基盤の改修が候補に挙がります。しかし、モデルを調整するには計算資源や学習データが必要になり、エージェント基盤そのものを変更すれば、複数のツールや指示が連携する仕組みを崩すおそれがあります。Infini-AI-Labが公開したオープンソースのPythonフレームワーク「Hermit」は、この問題に対して、モデルでも既存の実行基盤でもない外付けの層を学習させる設計を採用しています。この外付けの層は「ハーネスアダプター」と呼ばれます。ハーネスとは、AIモデルに指示を渡し、ツールの呼び出しやメモリー、複数エージェントの連携などを管理する実行基盤を指します。Hermitではモデルとハーネスを固定したまま、タスクへの対応方法を持つアダプターだけを反復的に改善します。OpenAIのコーディングエージェントであるCodexや、AnthropicのClaude Codeを、新しいタスクに適応させる用途が想定されています。
初版のv0.1.0は2026年10月25日に公開され、米カーネギーメロン大学の博士研究員Haizhong Zheng氏が同月27日にXで発表しました。Apache License 2.0で提供され、フレームワーク自身は学習パラメーターを持ちません。企業にとっての注目点は、より大きなモデルを導入することではなく、指示、スキル、記憶、ツールなどをまとめた外部資産を改善単位として扱えることです。AIエージェントの能力を、モデルの性能だけでなく運用構成から高める考え方が明確に打ち出されています。
ハーネスアダプターが保持する業務知識と実行ロジック
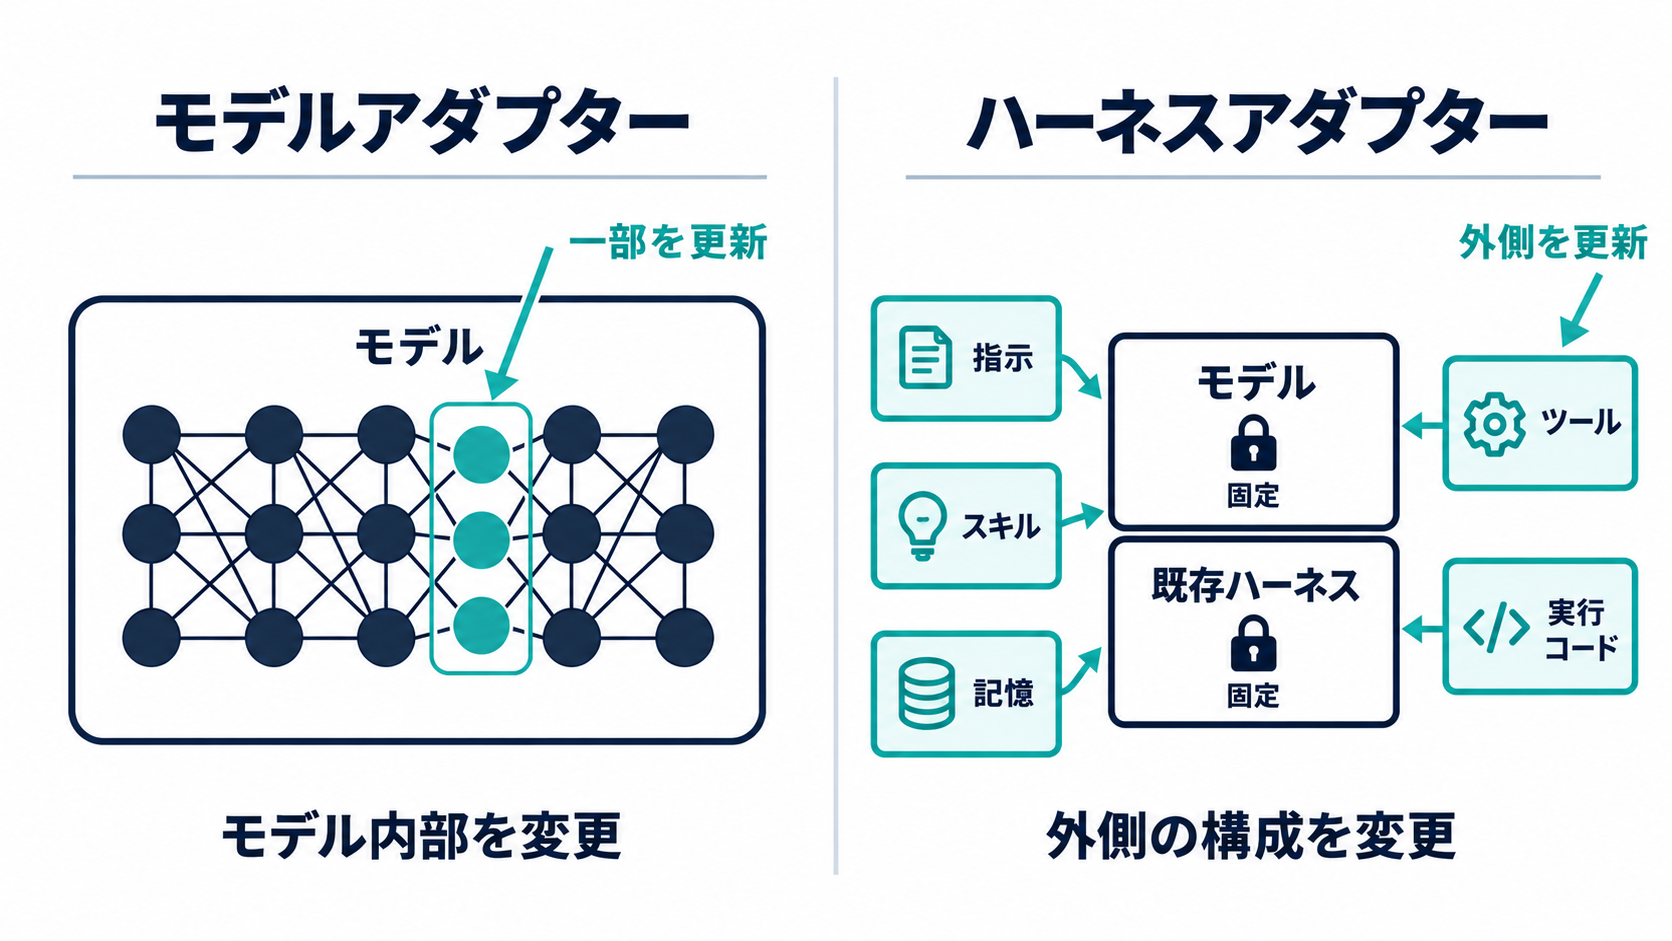
LoRAに代表されるモデルアダプターは、基盤モデルの一部に小規模な学習可能パラメーターを加え、モデルの振る舞いを特定用途へ寄せます。これに対してハーネスアダプターが変更するのは、モデルの内部ではなく、そのモデルをエージェントとして動かすための外部構成です。プラグインに学習機能を加えたものと考えると、位置付けをつかみやすいでしょう。アダプターには、システム指示、再利用可能なスキル、過去の情報を扱うメモリー、利用可能なツール、実行コード、複数エージェントの調整ロジックなどを含められます。必要であれば、リポジトリ全体を一つのアダプターとして扱うことも可能です。仕様には、どの部分を学習対象とするか、新しい内容をどのように検査するかを記述します。更新の境界を明示し、モデルと既存ハーネスには手を加えない点が設計の中心です。
Infini-AI-Labは、この方式を採る理由を三つ挙げています。商用エージェントのハーネスにはソースコードが公開されていないものがあり、内部を直接編集できません。オープンソースであっても、慎重に調整された構成要素の関係を変更すると、別の機能へ予期しない影響が及ぶ可能性があります。外部アダプターとして切り離せば、互換性のあるモデルやハーネス間で学習成果を移せる余地も生まれます。
企業システムに当てはめるなら、アダプターは業務手順とエージェント実装をつなぐ変更可能な層になります。モデルを入れ替えるたびに業務知識を一から埋め込み直すのではなく、移植可能な資産として管理できる可能性があります。ただし、どの組み合わせで実際に互換性が保たれるかは、対象ハーネスやツール仕様に左右されるため、導入先ごとの検証が欠かせません。
評価、改善、検査を循環させる学習フロー
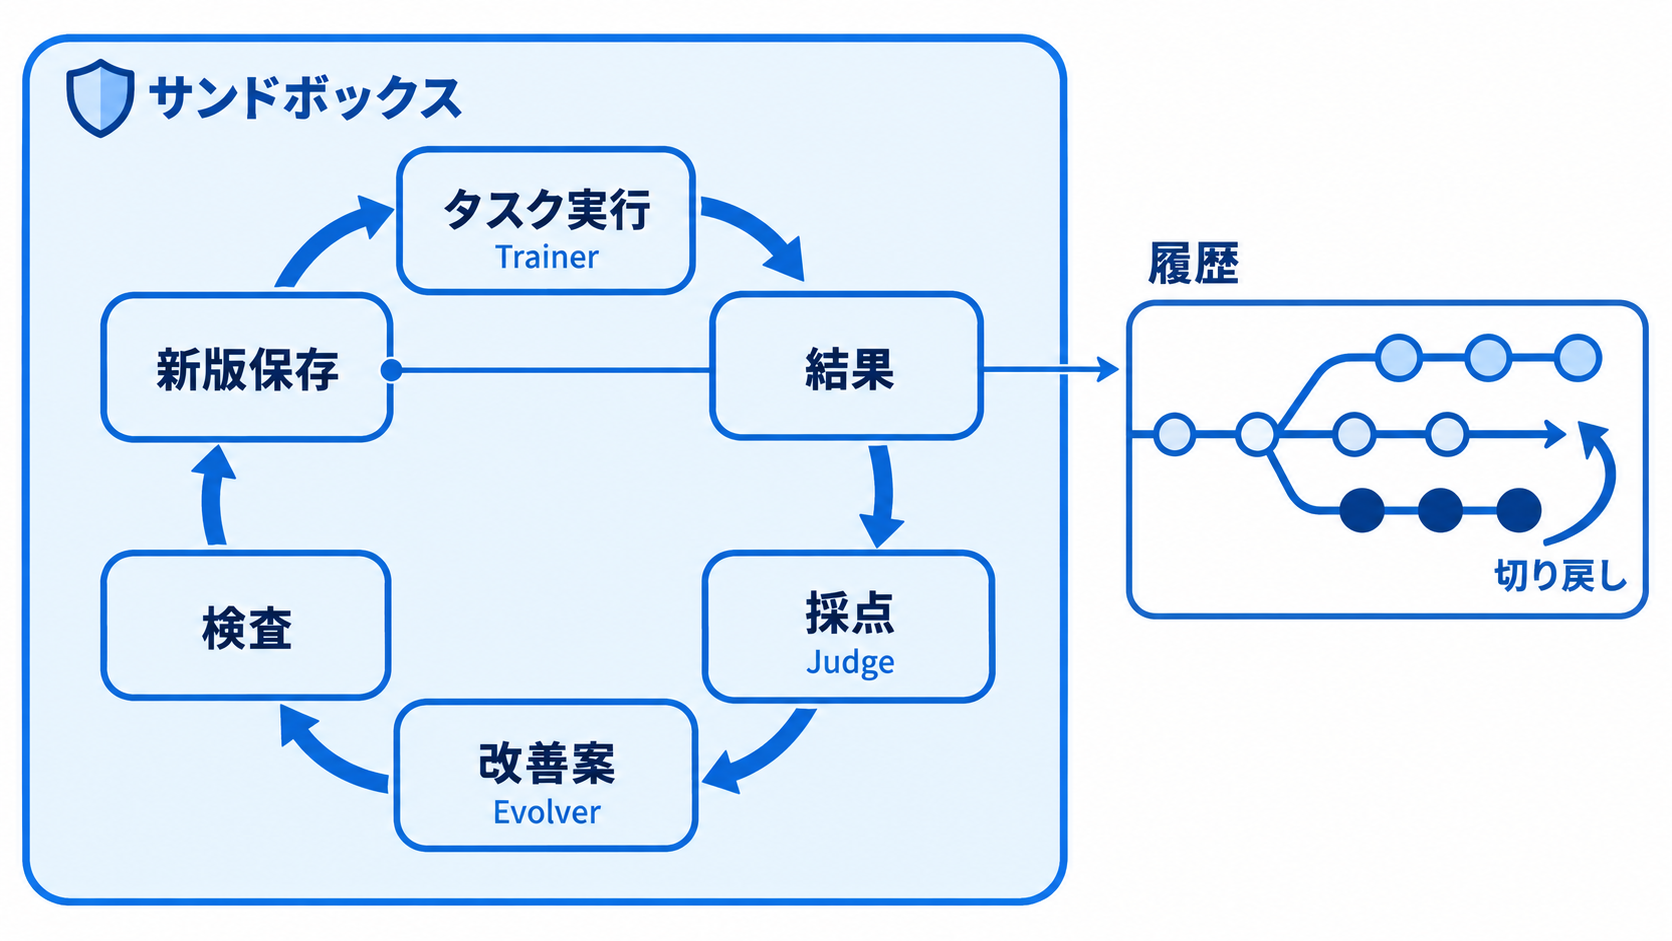
Hermitの学習は、強化学習に似た反復ループで進みます。Trainerが現在のアダプターを装着したエージェントに複数のタスクを実行させ、Judgeが結果を採点します。Evolverは実行履歴と評価結果を読み取り、改善版のアダプターを提案します。Trainerがテンプレートとの整合性を確認し、問題がなければ次の版として確定する流れです。更新のたびにアダプターの版がGitツリーへ保存されるため、変更内容の確認、以前の状態への切り戻し、特定バージョンの配布が可能です。エージェントが生成したコードや設定を学習過程で採用する場合、単に精度が上がったかどうかだけでなく、何が書き換わったかを追跡できることが運用上の意味を持ちます。Linux環境ではbubblewrapを利用し、学習プログラムを隔離されたサンドボックスで動かす構成も用意されています。
初版には、GEPA、SkillOpt、MetaWorld Model(MWM)、Harness²、Continual Harnessという五つの進化手法が含まれています。ACEとReHarnessは今後の対応予定として掲げられており、利用者が独自のEvolverを実装することもできます。手法ごとに別々の学習基盤を組むのではなく、同じTrainer、Judge、バージョン管理の枠内で試せることがHermitの特徴です。
企業で利用する場合、Judgeにどの評価基準を与えるかが結果を大きく左右すると考えられます。正答率だけを最適化すると、説明の分かりやすさ、安全性、処理時間、社内規定への適合といった要件が取り残されかねません。業務導入では、複数の評価軸を定め、更新候補を自動採用する範囲と人が確認する範囲を分ける設計が必要になるでしょう。学習ループそのものより、採点基準と承認手続きの設計が実務上の要点になります。
ベンチマークで見えた改善幅と検証上の留意点
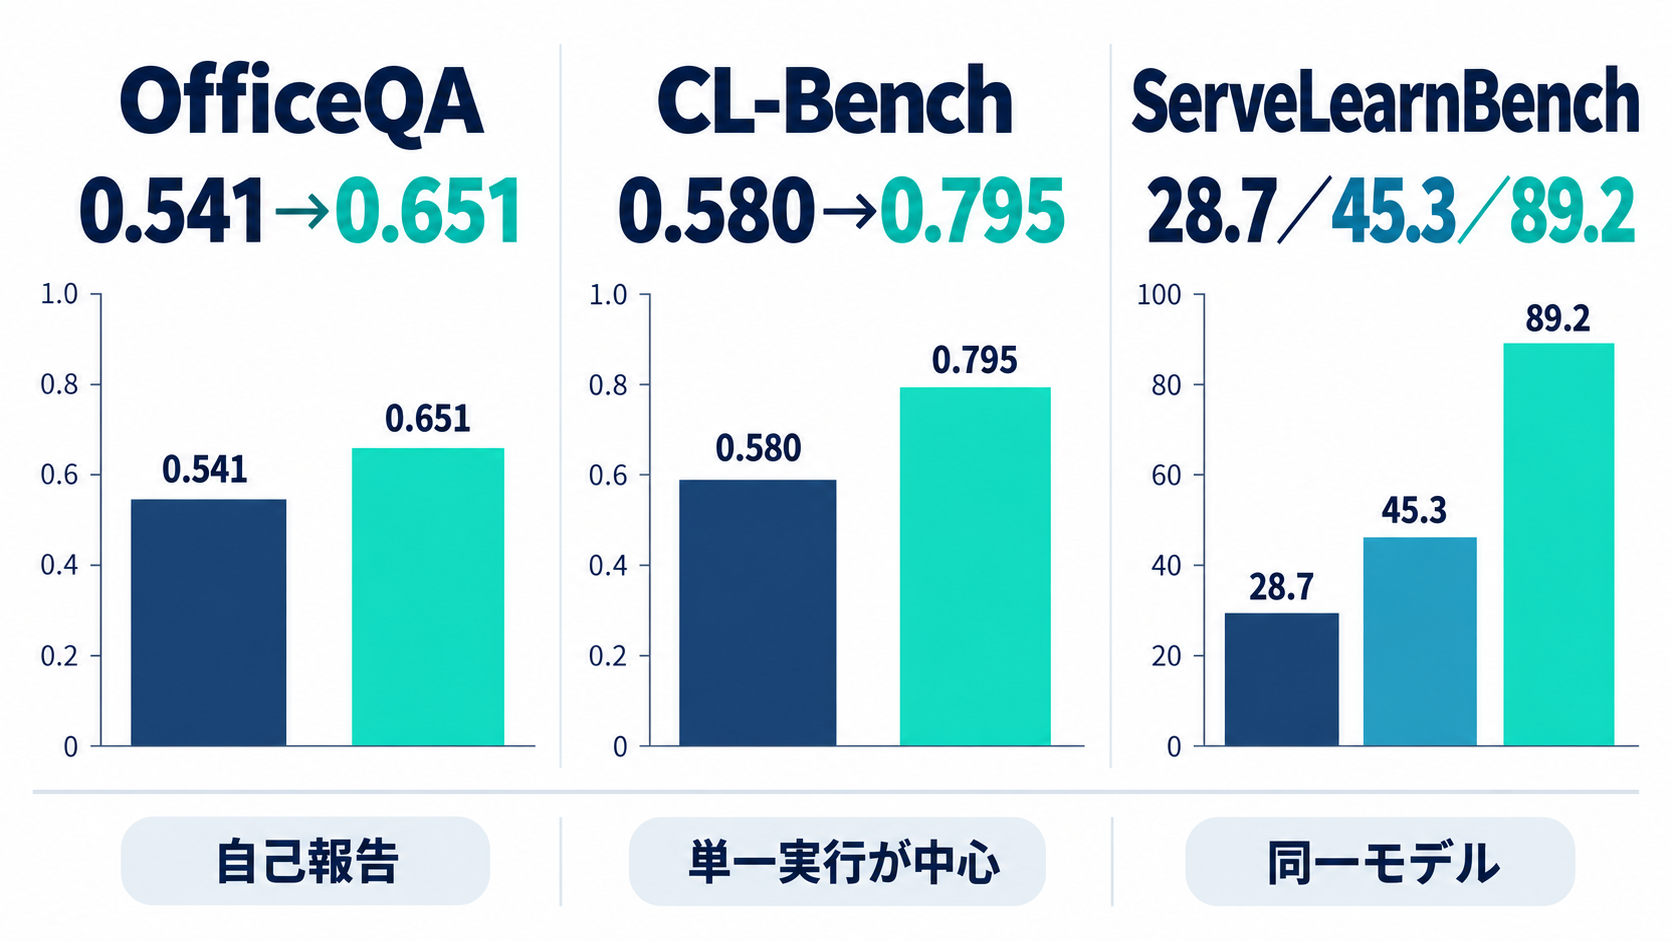
公開されたベンチマーク結果では、すべての実行モデルにGLM 5.3 Flashが使われています。米国財務省の公報を題材にしたOfficeQAでは、アダプターなしの正解率が0.541、初期スキルが0.576でした。GEPAは0.580、SkillOptは0.600、Continual Harnessは0.634、Harness²は0.651となり、複数の手法で基準値を上回っています。OfficeQAのテスト問題は172問で、回答は完全一致によって採点されています。GEPAとSkillOptは50問で学習した後に構成を固定して評価されました。Continual HarnessとHarness²は、テストデータを一度だけ順番に処理しながら学習する方式です。Harness²については、参照実行より7.6ポイント高く、95%区間はプラス1.7からプラス13.4ポイントと報告されています。同じOfficeQAでも学習条件が異なるため、数値だけを横並びにせず、固定評価と継続学習を分けて読む必要があります。
状態を持つ環境を扱うCL-Benchでは、MWMがデータベース探索で0.795の正解率を記録しました。文脈内学習による基準値は0.580です。攻略可能なポーカー課題では、MWMが1ハンド当たり3.08ビッグブラインドを獲得し、文脈内学習の2.51を上回りました。隠れた方針が途中で変化する小売サポート課題ServeLearnBenchでは、MWMが45.3、比較対象の学習手法CHが28.7、方針を知らされたオラクルが89.2でした。
数字は、外部アダプターの更新だけでも成績が変わり得ることを示しています。ただし、結果は開発チームによる自己報告であり、多くは単一実行です。同じモデルを用いた限定的な条件でもあるため、他のモデル、異なる乱数条件、複数回の試行、実業務データで同様の改善が得られるとは限りません。プロンプトだけを更新する手法がCL-Benchのデータベース探索で0.470となり、基準値の0.580を下回った例もあります。学習可能な仕組みを導入すれば自動的に品質が上がるわけではない点も、同時に確認しておくべきです。
既存のエージェント最適化手法との境界線
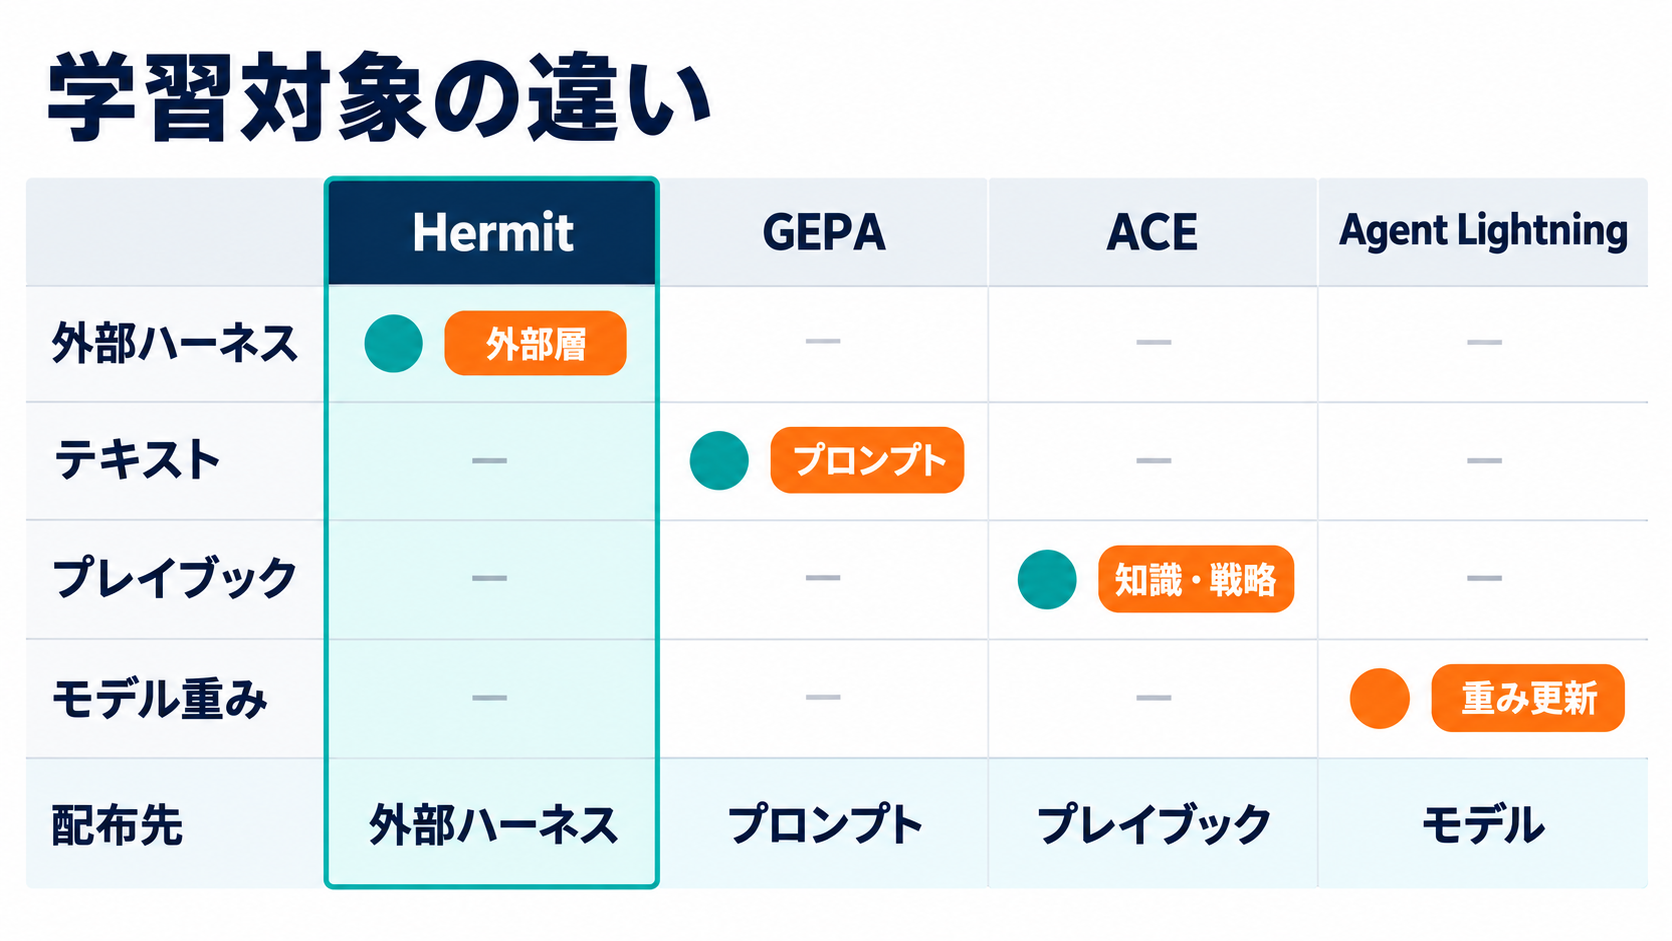
AIエージェントの改善手法には、プロンプトを書き換えるもの、実行時の文脈を蓄積するもの、モデルの重みまで更新するものがあります。Hermitは、この中で「外部ハーネスアダプター」を学習対象に据えています。モデルの重みを変更せず、既存ハーネスにも直接手を入れないため、何を更新し、何を固定するのかが比較的明確です。GEPAはプロンプトやコードを含む任意のテキストパラメーターを対象とし、反省的な改善とパレート選択を行う方式です。ACEは文脈内で使うプレイブックをGenerator、Reflector、Curatorによって改善します。Agent Lightningは、強化学習、プロンプト最適化、教師あり微調整を通じて、プロンプトだけでなくモデルの重みも対象にできます。Hermitは五つの手法と独自Evolverを共通の学習ループで扱い、Codex、Claude Code、Piへの配布やプラグイン変換を想定しています。
ライセンスにも違いがあります。HermitとACEはApache License 2.0、GEPAとAgent LightningはMIT Licenseとされています。企業が選定する際には、ライセンスだけでなく、学習対象、対応するエージェント基盤、評価方法、更新履歴の追跡性をまとめて比較する必要があります。モデルの重みを変えられない環境ならHermitの境界設計が候補になり、モデル自体を業務特化させたい場合は別の手法が適するでしょう。
なお、各プロジェクトが示す代表的な成績は、課題、モデル、評価指標が異なります。HermitのCL-Benchにおける0.795と、GEPAがAIME 2025で示した46.6%から56.6%への改善、ACEがAppWorldで報告した10.6%の向上を、そのまま優劣として比べることはできません。選定時には公開された最高値よりも、自社に近い課題を再現できるか、失敗時に原因を調べられるかを重視した方が実務的です。
導入からCodex・Claude Codeへの配布まで
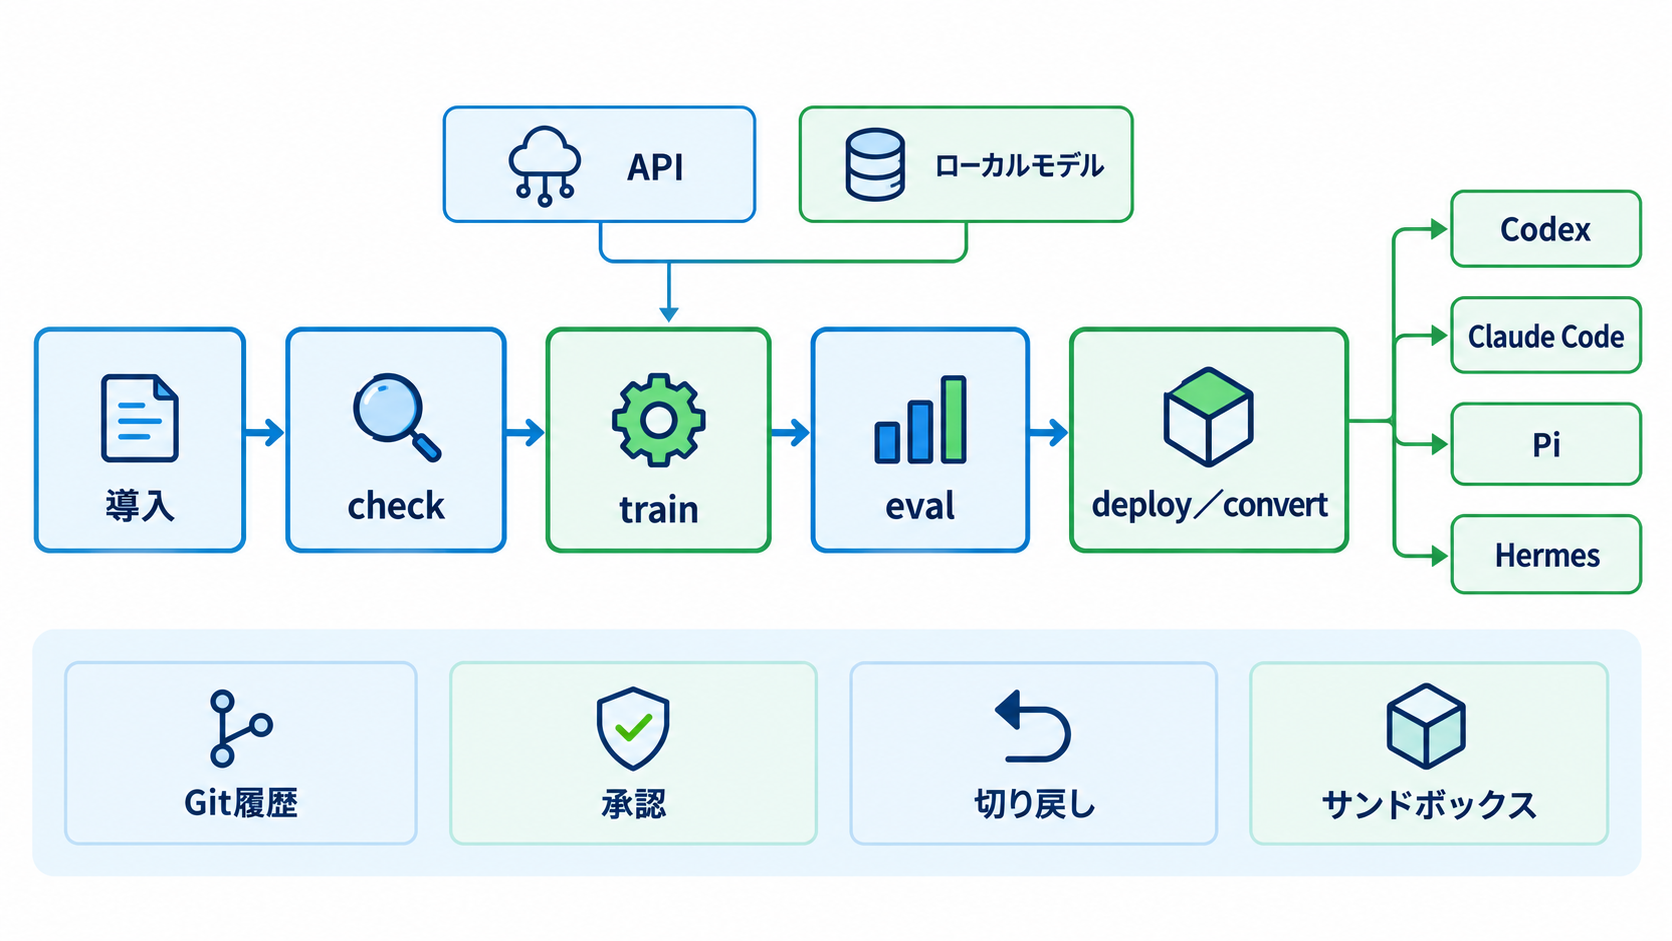
HermitはPyPIから「pip install hermit-harness」で導入でき、サンプルを確認したい場合はリポジトリを複製できます。オフラインのQuick StartにはGPU、モデル提供サービスのアカウント、データセットが不要です。本格的な実行では各種APIを利用できるほか、vLLM、SGLang、Ollamaで動かすローカルサーバーにも接続できます。コマンドラインには、設定やアダプターの検査を行うcheck、学習用のtrain、評価用のeval、ワークスペースを生成するdeploy、ネイティブプラグインへ変換するconvertが用意されています。APIの接続先として、Fireworks、OpenAI、Anthropic、DeepSeekなどが挙げられています。利用するモデルと提供元を切り替えながら、同じアダプター学習の流れを適用できる構成です。
「hermit deploy」を実行すると、Codex、Claude Code、Pi向けのワークスペースが出力されます。「hermit convert」では、学習済みアダプターをCodex、Claude Code、Pi、Hermes用のネイティブプラグインへ変換できます。事例として、五つのCodexエージェントを連携させ、一つの定理証明に取り組ませるLean用アダプターも示されています。Leanは、証明を機械的に検証できる定理証明支援系です。
業務環境では、Quick Startが動くことと、本番導入に耐えられることを分けて考える必要があります。APIへ送るデータの範囲、生成コードの実行権限、サンドボックスの境界、アダプター更新時の承認、以前の版へ戻す手順を確認する必要があるでしょう。Gitによる履歴管理は監査材料になりますが、それだけで組織のセキュリティ要件や変更管理を満たすとは限りません。既存のコードレビューやリリース承認に接続して運用する設計が求められます。
日本企業が試すなら「狭い業務と固定評価」から
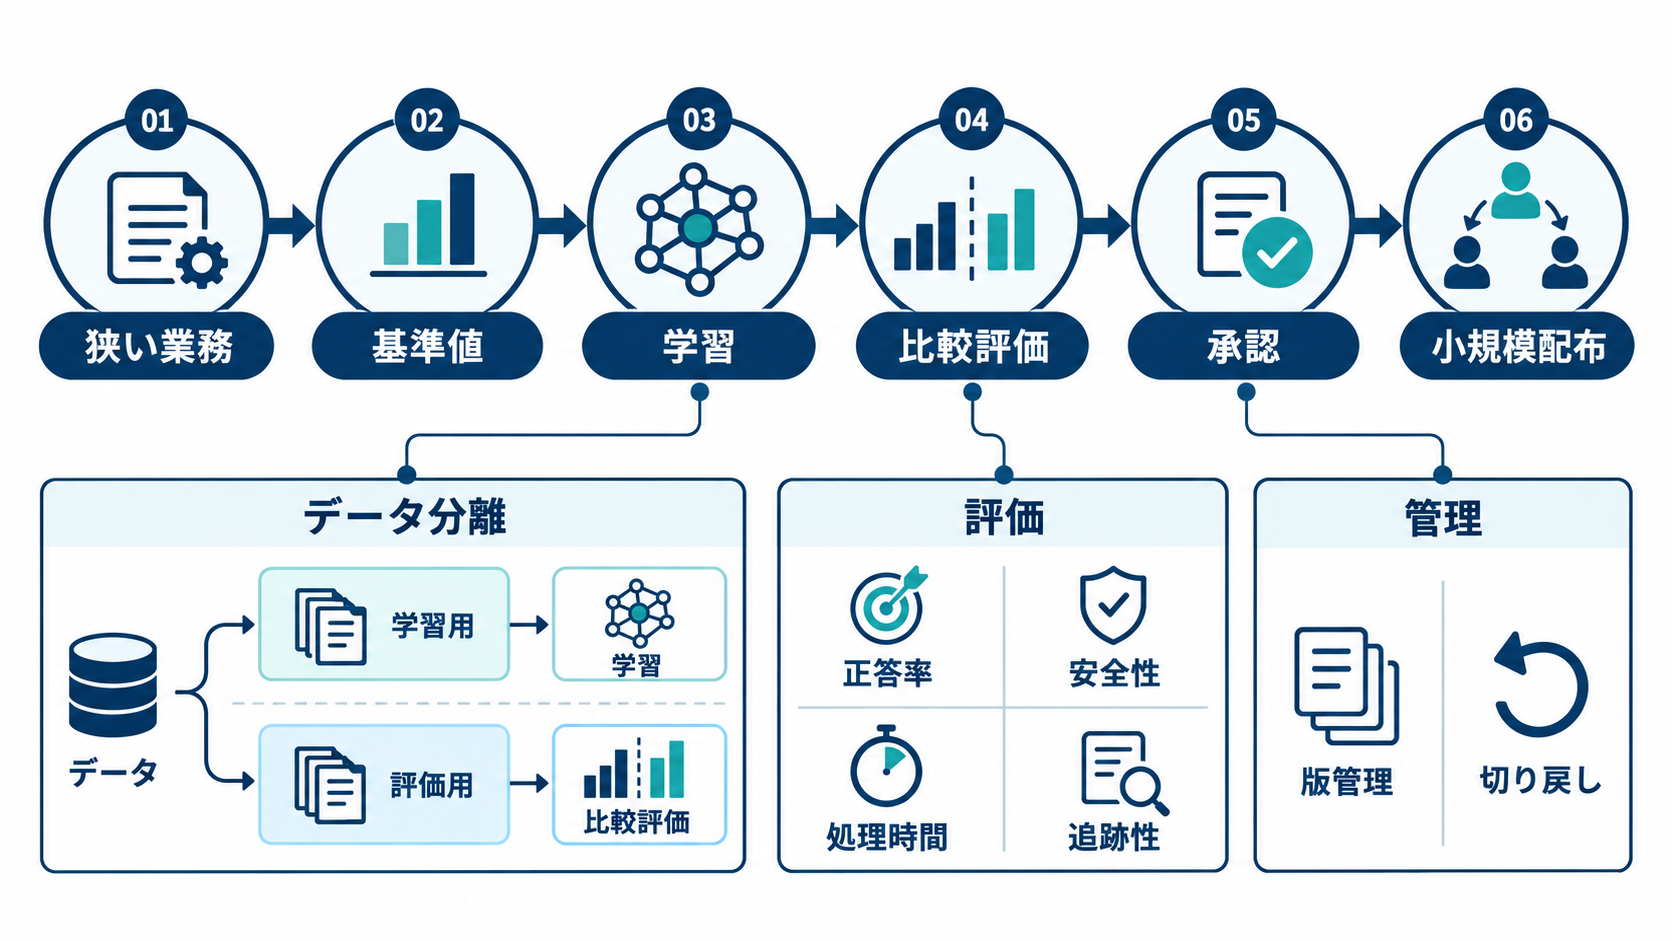
Hermitを企業で評価する際は、最初から汎用的な社内エージェントを育てようとせず、正解や合格条件を定義しやすい業務に対象を絞る方が適しています。たとえば、社内文書から所定の項目を探す、決められた形式のコード変更を提案する、複数のツールを一定の順序で呼び出すといった課題です。これは特定の利用成果を保証する例ではなく、評価基準を作りやすい対象を選ぶという考え方です。検証前には、アダプターなしの状態を基準として保存し、同一のタスク群で更新後の結果と比較します。正答率に加えて、禁止されたツールを使っていないか、根拠のない回答を増やしていないか、処理時間やAPI利用量が許容範囲かを確認すると、業務上の変化を捉えやすくなります。学習用と評価用の課題を混ぜると、アダプターが既知の問題だけに適応した可能性を排除しにくいため、評価データを分離することも欠かせません。
Hermitの価値は、モデルを固定したまま改善できるという一点だけではありません。業務知識やエージェントの調整ロジックを外部資産として版管理し、複数の進化手法を共通の工程で比較できることにあります。その反面、誤った評価基準を与えれば、望ましくない方向へアダプターが最適化される可能性もあります。性能評価、セキュリティ審査、業務部門による妥当性確認を分離せず、同じ更新プロセスに組み込む必要があります。
現段階のベンチマークは有望な事例を示していますが、自己報告かつ単一実行が多く、企業導入の判断材料としては再現検証が必要です。着手するなら、HermitのオフラインQuick Startで構造を確認した後、自社データを含まない小規模な評価セットを用意し、アダプターなし、単純な指示調整、Hermitによる学習の三条件を比べるとよいでしょう。改善率だけでなく、変更内容を説明でき、問題時に確実に切り戻せるかまで確認することが、次の判断につながります。