
2026/11/01
今更聞けないAI知識
AIは質問するたびに賢くなる?「学習」と「回答」を分けて考える
訂正した直後に答えが変わるのは「学習」なのか
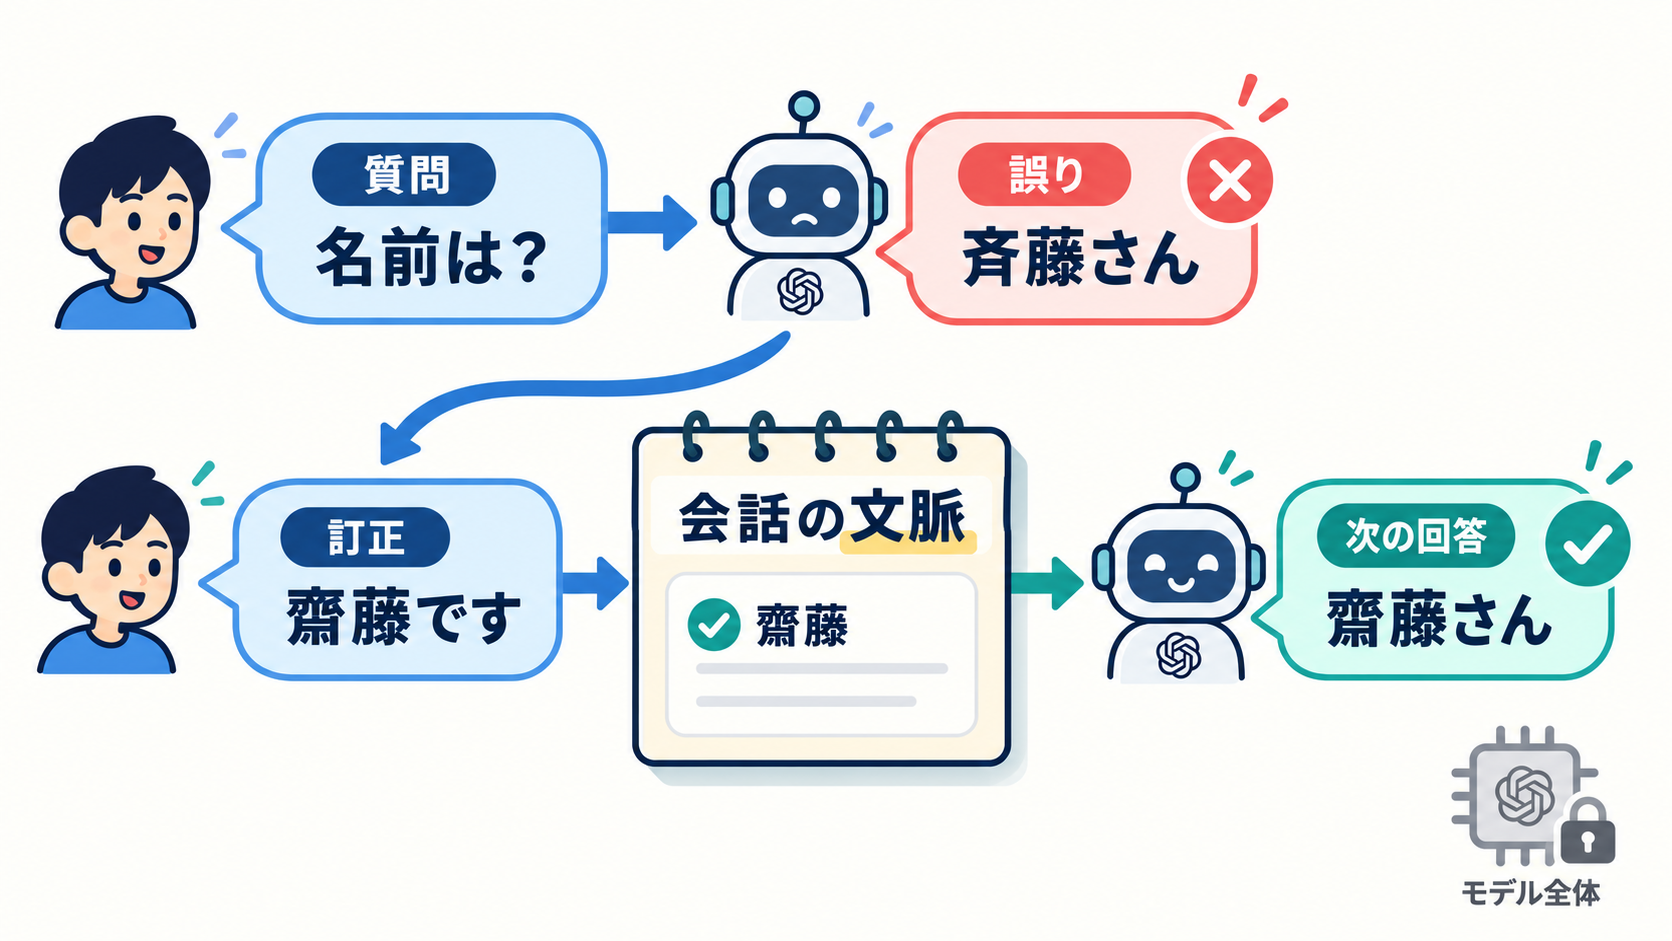
仕事の相談をAIにしたところ、社名を間違えられたとします。「その表記ではなく、こちらが正しいです」と伝えると、次の返答ではきちんと修正されました。こんな場面に出会えば、「いまの訂正でAIが学習したのでは」と感じるのも自然です。
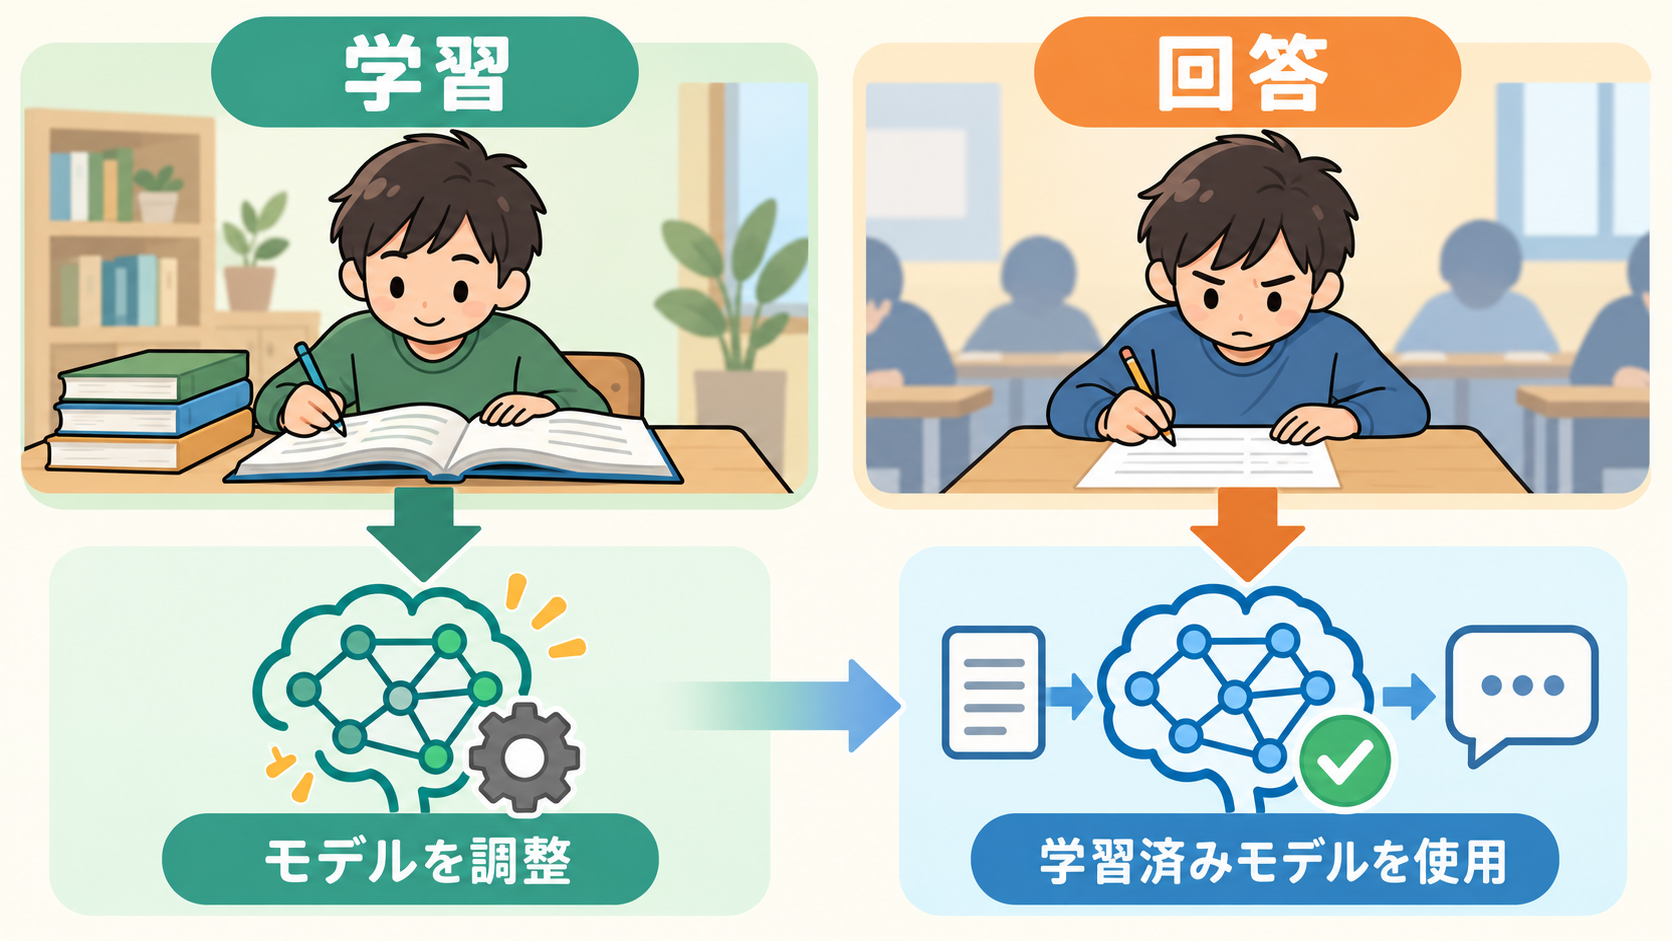
一言で答えると、一般的な対話で起きているのは、学習済みのモデルを使った「回答」であり、質問のたびにモデル全体を作り直す「学習」ではありません。会話中の訂正は、その後の回答に使う文脈として扱われることがありますが、モデルそのものがその場で恒久的に書き換わったとは限らないのです。
学校生活に置き換えると分かりやすいでしょう。教科書や問題集を使って知識や解き方を身につける時間が「学習」、身につけたものを使って試験問題に答える時間が「回答」に相当します。試験中に問題文から条件を読み取り、前の設問を参考にしたとしても、それだけで教科書の内容や長期間の学習成果が書き換わるわけではありません。
AIは、人の学習や理解をそのまま再現した存在ではありません。IBMはAIを、人の学習、理解、問題解決、意思決定などを模擬できるようにする技術として説明し、その内側にデータから予測や判断を行うモデルを作る機械学習があると整理しています(出典: IBM)。AIという広い言葉と、モデルをデータで調整する学習、学習済みモデルによる回答を分けると、「訂正を理解したように見える」という現象も落ち着いて捉えられます。なお、このIBM資料は2024年8月9日に公開され、2026年10月2日に更新されたものです。公開日と更新日は同じではありません。
AIの「モデル」は学習後に残る調整結果
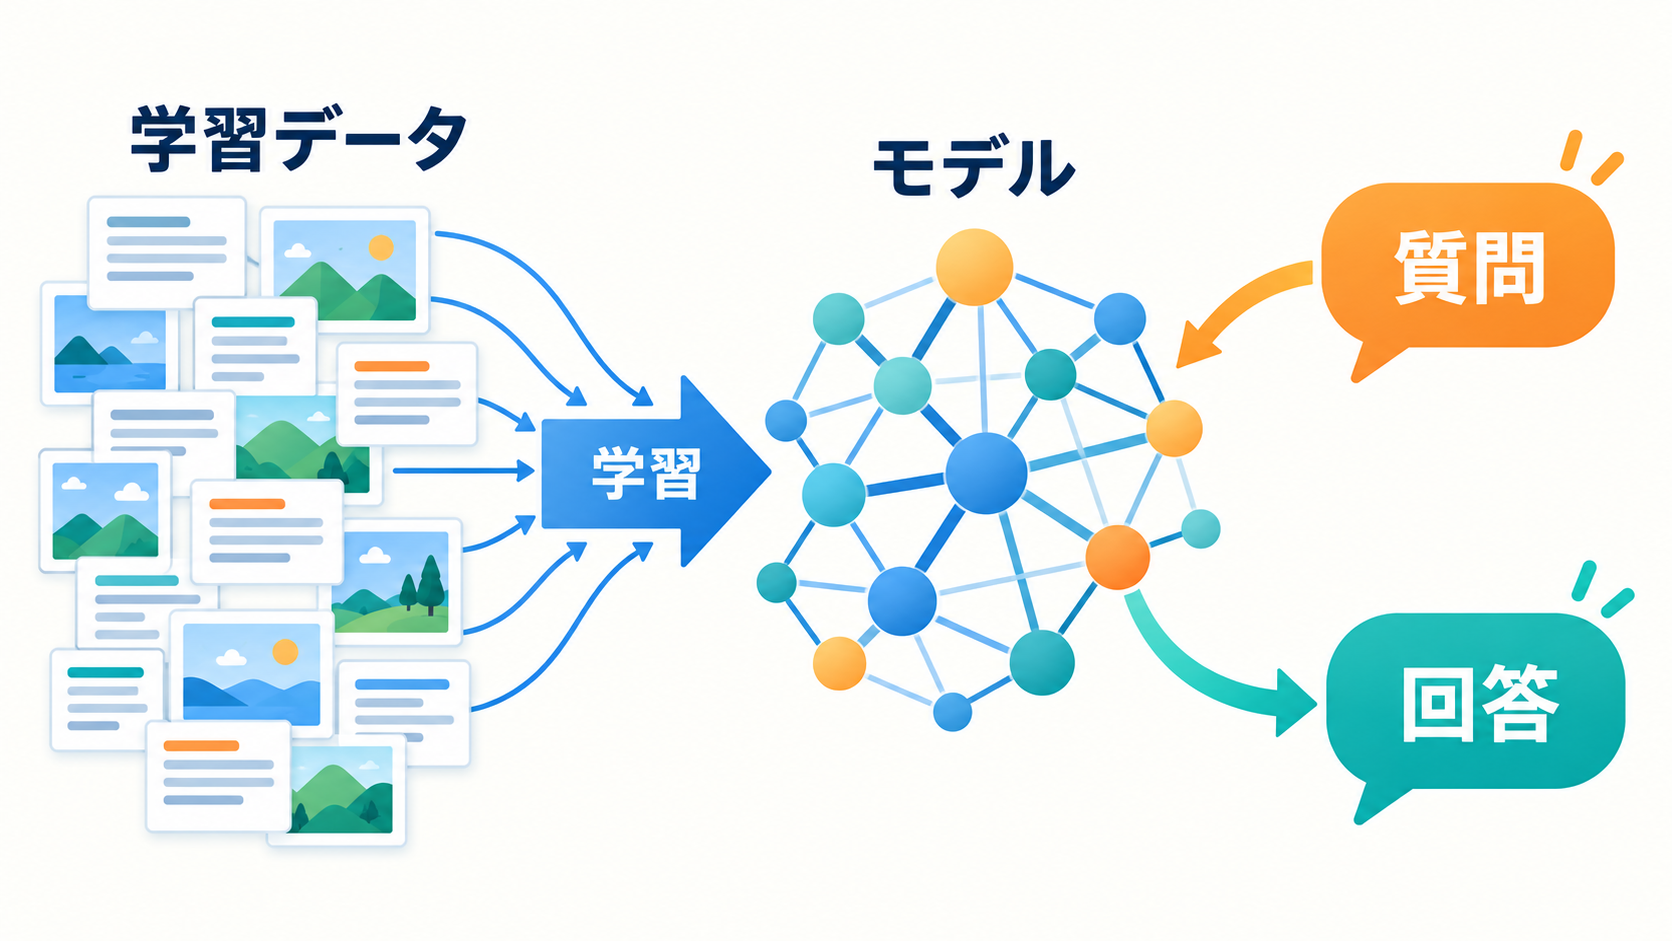
「学習済みモデル」と聞いても、何が学習済みなのか想像しにくいかもしれません。モデルとは、学習用のデータから見つけたパターンや関係を、回答や予測に利用できる形で保持したものです。Google Cloudも、機械学習モデルを、アルゴリズムを学習データに適用した結果として説明しています(出典: Google Cloud)。文章生成AIの場合は、言葉の並びや文脈に見られる多くの関係が調整結果に反映されます。
料理にたとえるなら、学習データは多数の料理例、学習方法は例を比べながら加減を調整する工程、モデルは調整後に残った「作り方の傾向」に近いものです。質問するたびに全料理例を最初から読み直しているわけではありません。すでに整えられた傾向を使い、渡された材料や注文に応じて、その場の出力を組み立てます。ただし、AIには味覚や経験があるわけではないため、このたとえは処理の段階を分けるためのものです。
IBMの説明では、生成モデルは学習データを単純化した表現として取り込み、その表現を基に、元データと似ていても同一ではない新しい内容を生成します(出典: IBM)。そのため、モデルを「過去の文章をそのまま保管した巨大な回答集」と考えるのも正確ではありません。入力された質問と学習で得た調整結果を使い、続く内容を生成する仕組みとして見るほうが実態に近づきます。
質問への回答中にも計算処理は行われますが、計算があることと学習があることは同じではありません。一般的な対話の一回一回では、入力された内容を読み取り、学習済みモデルを使って出力する処理が中心です。ここを分けておけば、「返事が変わったからモデル全体が成長した」「同じ質問なら必ず同じ答えになる」といった早合点を避けやすくなります。
事前学習・追加調整・回答時の処理という三段階
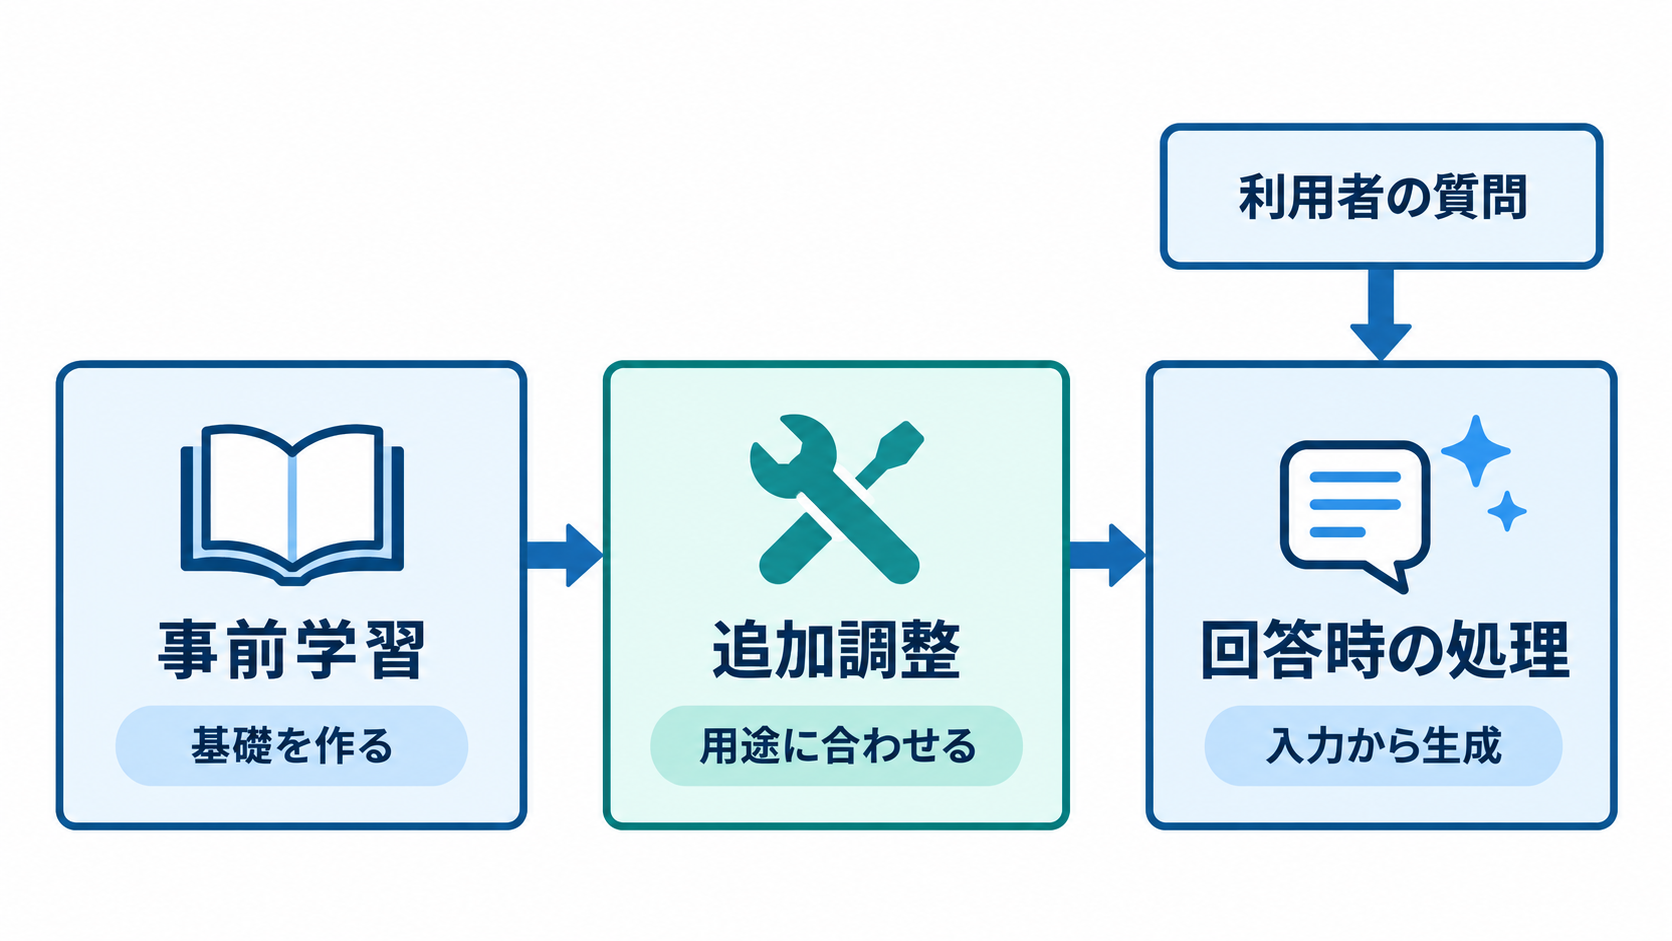
生成AIが利用者の前に届くまでには、大きく分けて複数の段階があります。IBMは生成AIの流れを、基盤モデルを作る学習、用途に合わせる調整、生成と評価、追加調整という段階で説明しています(出典: IBM)。日常の会話で見えているのは主に生成の部分であり、その前に大規模な準備が行われています。
違いを整理すると、次のようになります。
| 段階 | 何をするか | 利用者の一回の質問との関係 |
| --- | --- | --- |
| 事前学習 | 大量のデータから言葉や画像などのパターンを捉え、基礎となるモデルを作る | 通常は質問の前に行われています |
| 追加調整 | 特定の用途や望ましい回答形式に合わせてモデルを調整する | 開発側が別の工程として実施します |
| 回答時の処理 | 学習済みモデルと入力内容を使って、その場の出力を生成する | 利用者が目にする対話の中心です |
事前学習で作られた大規模なモデルは、さまざまな用途の出発点になるため「基盤モデル」と呼ばれます。Googleの機械学習用語集では、基盤モデルを、巨大で多様なデータで事前学習され、幅広い依頼への対応や追加調整の土台として使えるモデルと説明しています(出典: Google for Developers)。ここでいう「基盤」は、すべての事実を完全に知っているという意味ではありません。
追加調整の代表例がファインチューニングです。これは、事前学習済みモデルに対して、特定の仕事に関係する例などを使って行う二度目の学習工程です。Googleの用語集も、特定用途に向けてモデルのパラメーターを調整する学習として説明しています(出典: Google for Developers)。会話欄に一つ訂正を書き込むことと、まとまったデータや評価方法を用意して追加調整を行うことは、規模も目的も異なります。
実際の製品がどのモデルをいつ更新し、どのような調整を行うかは、提供者や製品によって変わります。資料に示されていない更新頻度や内部工程まで推測するのは避けるべきです。初心者が押さえておきたいのは、「準備段階の学習」と「利用時の回答」は別工程であり、画面上では後者を主に見ているという点です。
会話中の訂正が次の返答に反映される理由
では、なぜ訂正した直後の回答では間違いが直るのでしょうか。鍵になるのは「文脈」です。文脈とは、その返答を作る際に参照される会話の流れや条件を指します。Googleの用語集では、チャットにおける過去のやり取り、つまり利用者の入力とモデルの返答が、その後の会話の文脈になると説明されています(出典: Google for Developers)。
たとえば、架空の店舗について文章を作る途中で、「店名の読み方は『あおば』ではなく『せいよう』です」と訂正したとします。続く依頼で同じ店名を扱えば、AIは前の訂正を含む会話を参照し、「せいよう」という読み方を使う可能性があります。これは、その回答を作る材料の中に訂正が含まれているからです。
この働きは、教科書を書き換えるというより、机の上のメモを見ながら作業する状況に似ています。「この案件では商品名を英字で表記する」「対象読者は新入社員」といったメモが会話内にあれば、次の文章にも条件を反映しやすくなります。しかし、そのメモを参照できない別の状況でも、同じ条件が自動的に使われるとは限りません。
文脈として扱える情報量には範囲があります。Googleの用語集は、モデルが一つの入力で処理できるトークン数を「コンテキストウィンドウ」と呼んでいます。トークンは、モデルが文章を処理する際の細かな単位です。会話が長くなれば、利用者が重視する条件を簡潔に言い直す必要が出ることも考えられます。ただし、具体的な上限や古い会話の扱いはモデルや製品の仕様に左右されるため、ここでは一律の数値として示せません。
「同じ会話で直った」という観察から確かに分かるのは、訂正が次の回答に利用されたことです。モデル全体のパラメーターが更新されたことまでは確認できません。見た目が似ている二つの現象を分けると、AIに指示を出す際にも、必要な条件を会話内で明示する理由が分かりやすくなります。
利用者のフィードバックと後日の調整は別の話
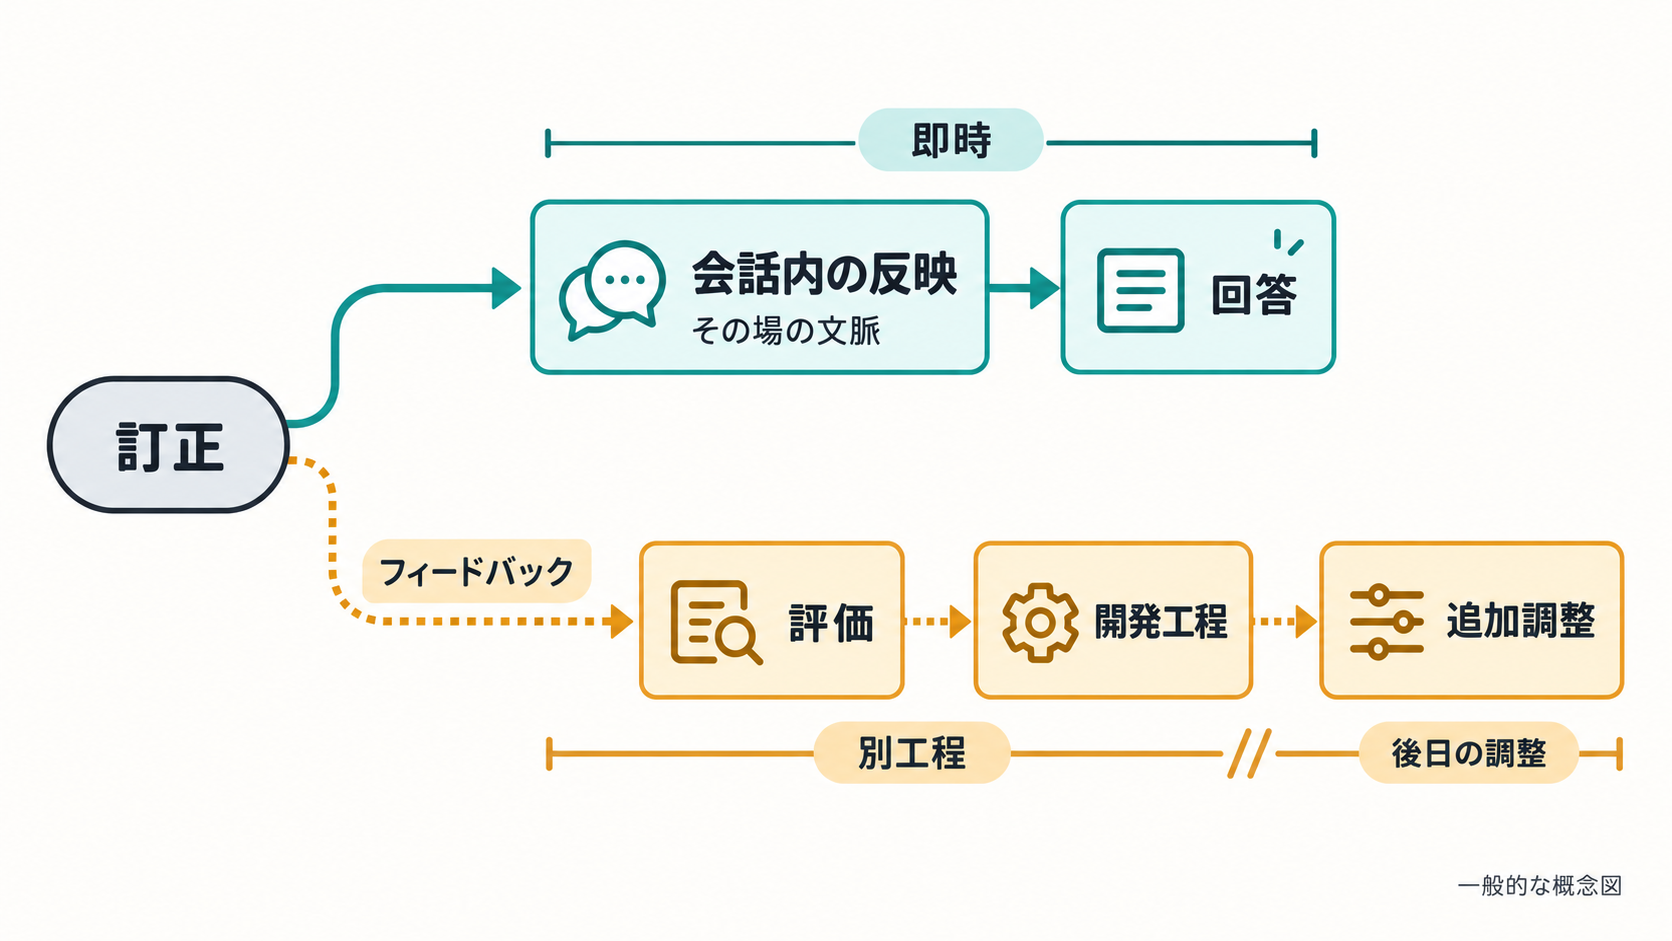
ここまでの説明を聞くと、「それなら利用者の訂正は将来の改善に一切使われないのか」という疑問も生まれます。答えは、個別製品の提供条件を確認しなければ断定できません。会話中の回答処理と、提供者がデータや評価を集めて後日モデルを調整する工程は、分けて考える必要があります。
IBMはモデル調整の方法の一つとして、人間のフィードバックを用いる強化学習を挙げています。人が出力の正確さや関連性を評価し、その評価をモデル改善に役立てる方法です(出典: IBM)。これは開発工程として整理された仕組みであり、利用者が一度「違います」と書いた瞬間に、全利用者向けのモデルが更新されるという説明ではありません。
整理すると、同じ「訂正」でも三つの場面が考えられます。一つ目は、現在の会話で次の回答を直すための条件です。二つ目は、サービス側が品質評価の材料として扱う可能性のあるフィードバックです。三つ目は、集められた評価やデータを基に開発者が実施する追加調整です。画面上の操作がどこまで後二者につながるかは、各サービスの説明や設定によって異なります。
入力内容の保存期間、学習や改善への利用条件、拒否や設定の方法についても、今回の参考資料だけでは製品横断で断定できません。仕事上の秘密、個人情報、未公開情報を入力してよいか判断する際は、「質問するたびに学習するか」という一般論だけで決めず、利用中のサービスが示す規約、プライバシー情報、組織内の利用ルールを確認する必要があります。
ここで役立つ見方は、「画面上で直ったこと」と「将来のモデル改善に使われたこと」を一本の出来事にしないことです。前者は対話の結果から観察できますが、後者は提供者の説明がなければ確認できません。仕組みを知ることは、不安を無条件に否定するためではなく、確認すべき場所を切り分けるために役立ちます。
「学習しているから正しい」とは限らない理由
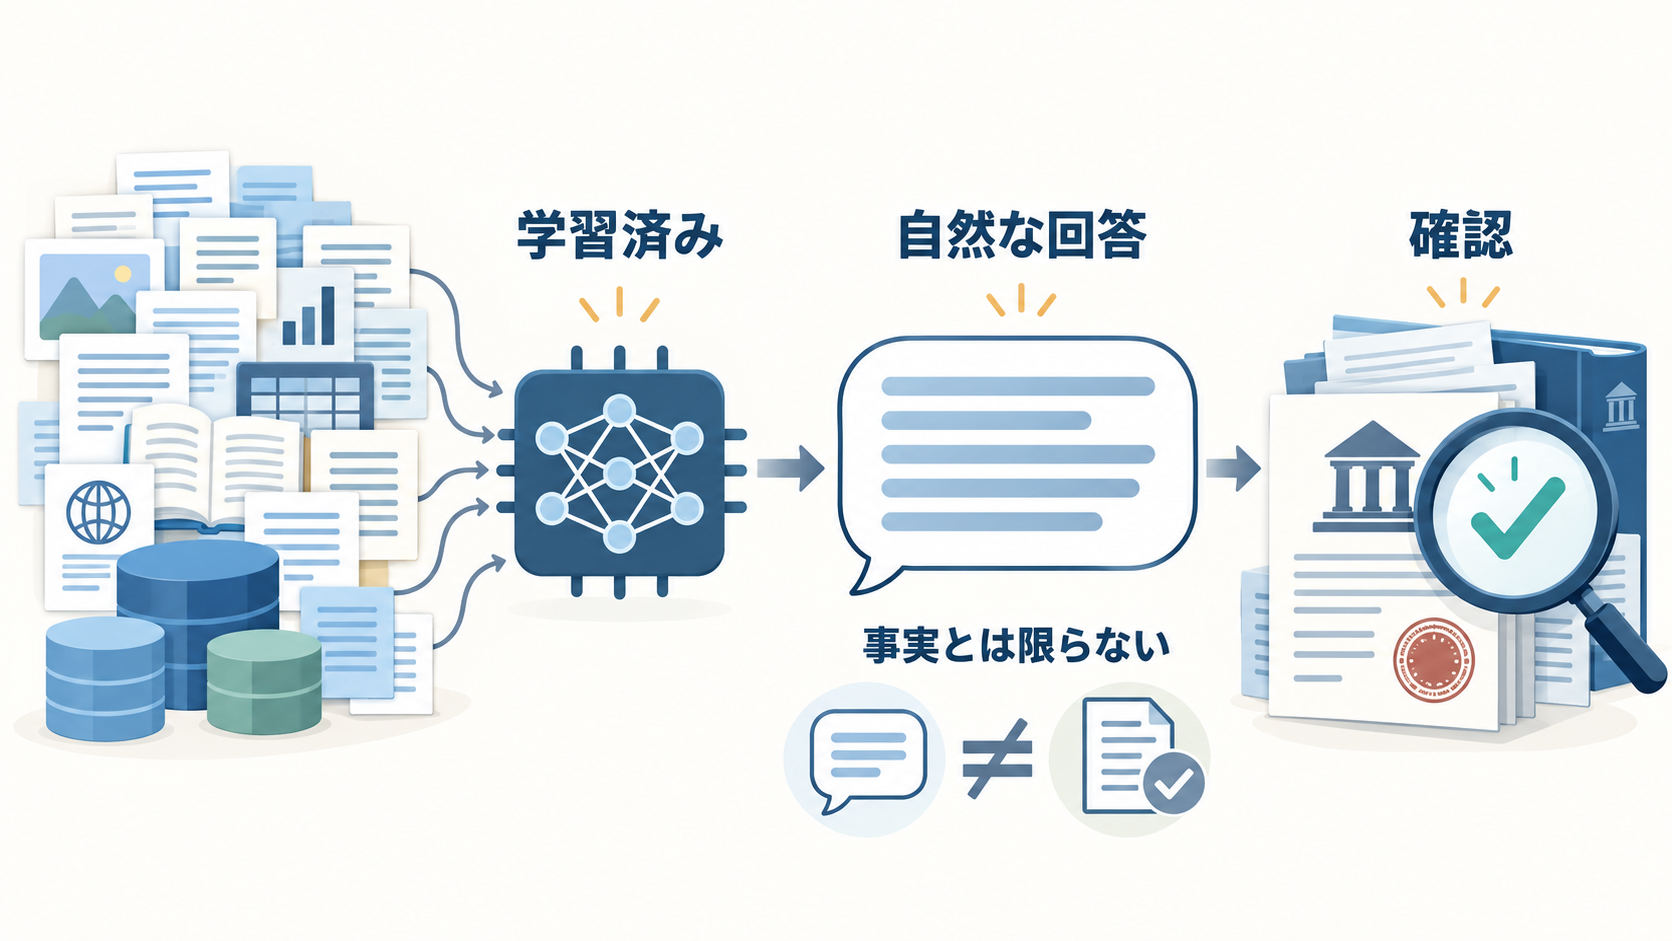
AIが大量のデータで学習していると聞くと、「多くを学んだのだから、回答も正しいはず」と考えたくなります。しかし、学習量と個々の回答の正しさは同じものではありません。生成AIは、学習で捉えたパターンを使って内容を作ります。質問に対して自然な文章を返せても、その文章が現実の事実と一致している保証にはなりません。
Googleの用語集では、現実に基づく出力の性質を「事実性」と説明しています。また、事実性は単純な一つの評価指標ではなく、概念として扱われています(出典: Google for Developers)。創作を頼んだ場合には現実に存在しない内容を作ることが目的になりますが、法律、日付、人物、製品仕様などを尋ねた場合には事実との一致が必要です。依頼の目的によって、望ましい出力の基準が変わるわけです。
もっともらしいものの、事実と異なる内容を生成する現象は、一般にハルシネーションと呼ばれます。ここで「AIがうそをついた」と擬人化すると、仕組みを見誤りやすくなります。意図を持って人をだましたと決めつけるより、学習済みのパターンから生成された文章と、確認済みの事実が一致しなかったと捉えるほうが、対策につながります。
よくある誤解は、「会話で一度訂正したので、今後は必ず正しく答える」というものです。その会話では訂正が文脈として働いても、別の条件や別の回答で同じ誤りが起きないとは限りません。また、「回答が具体的で断定的だから正しい」「出典らしい名前が付いているから確認済み」とも判断できません。文章の流暢さは、事実確認の代わりにはならないのです。
事実が重要な場面では、生成された説明を出発点として扱い、公式資料や一次情報と照らし合わせる姿勢が必要です。検索や外部資料の参照が組み合わされた製品も考えられますが、どの情報源をいつ参照するかは個別の仕様です。回答だけを見て検索済みだと推測せず、出典の提示や提供者の説明を確認するほうが安全でしょう。
明日から使える「学習」と「回答」の見分け方
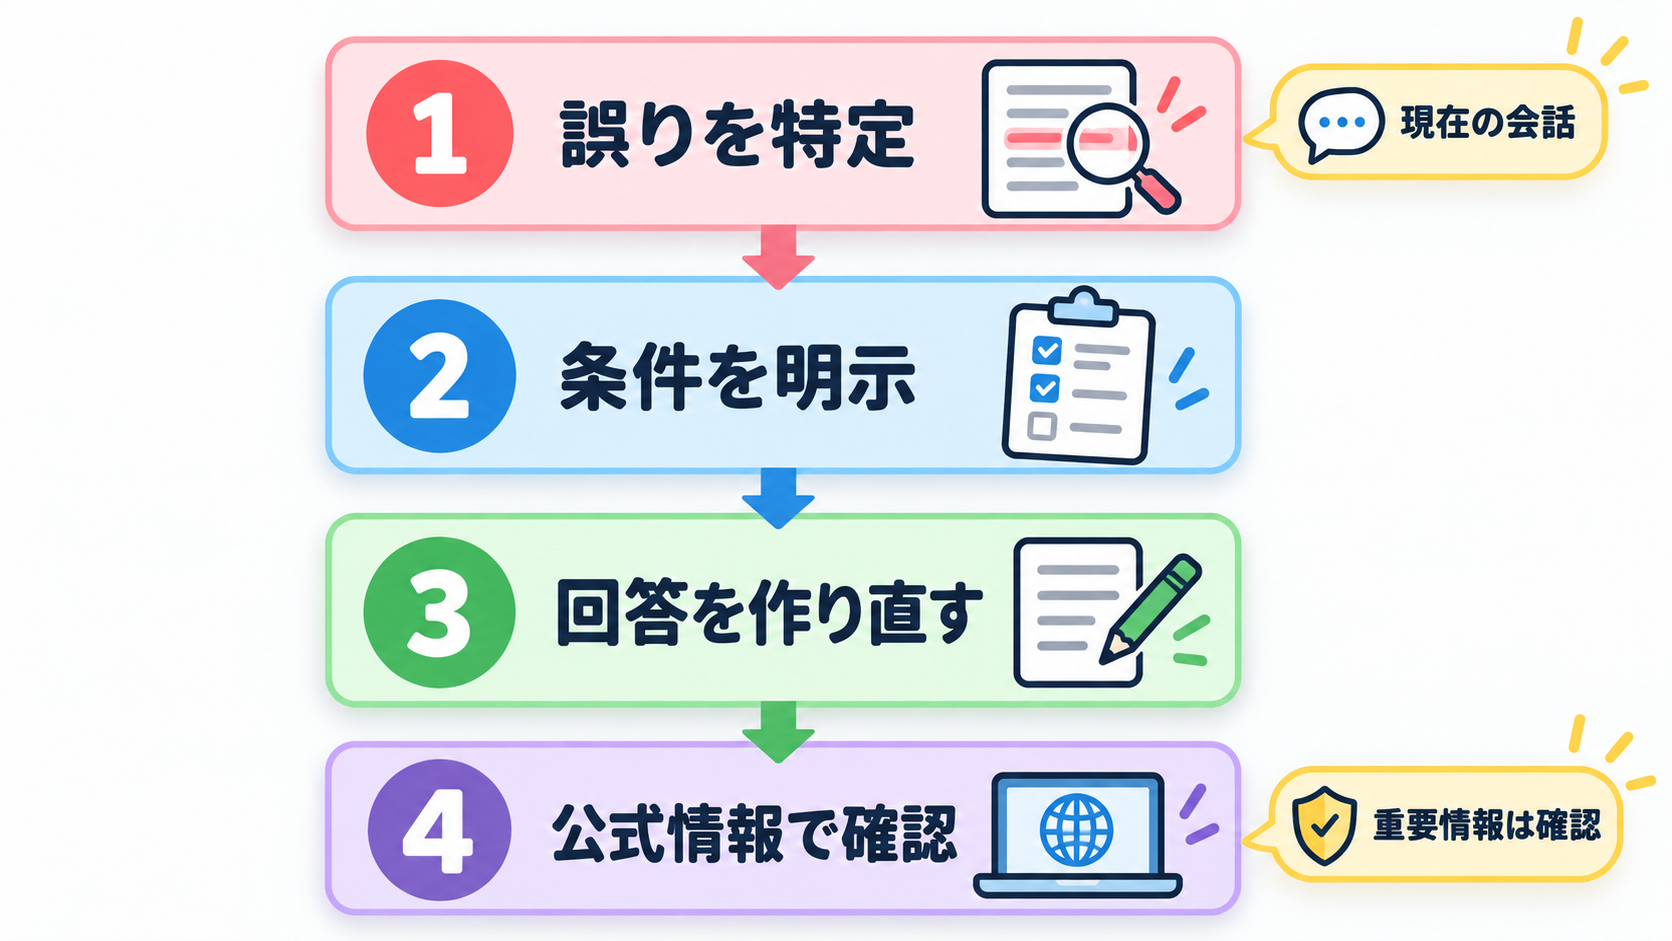
AIを使うときに毎回内部構造を思い出す必要はありません。「いま変わったのは、会話の条件か、モデル自体か」と一度問い直すだけでも、判断はかなり整理できます。同じ会話で言い直した直後に出力が変わったなら、最初に考えるべきなのは文脈の反映です。モデル全体の学習だと断定する材料にはなりません。
実務では、訂正を短く明確に伝え、その後の依頼にも使う条件だと示す方法が考えられます。たとえば次の入力文は、架空の業務を想定した提案例です。特定製品での効果を実測したものではなく、必ず正しい回答を保証するものでもありません。
> 商品名は「Mori Note」ではなく「Mori Notes」です。この会話では、以後すべて「Mori Notes」と表記してください。変更後の名称を使って、案内文を作り直してください。
訂正と同時に目的を示しているため、「何が誤りか」「どの範囲で使うか」「次に何をするか」を区別できます。回答が長くなった場合には、重要な条件を再掲する方法も提案できます。これはモデルを再学習させる操作ではなく、その回答に必要な文脈を渡す工夫です。
事実確認が必要な依頼では、別の入力も考えられます。たとえば、「確認できない日付や固有名詞は推測せず、不明と示してください。回答後に、私が公式資料で確認すべき項目を列挙してください」と頼む方法です。ただし、この指示を添えても誤りが完全になくなるわけではありません。最終的な確認先と判断者を決めておくことが欠かせません。
次にAIへ訂正を送る場面では、返答が直ったかだけで終わらせず、①訂正は現在の会話だけの条件か、②事実確認が必要な内容か、③入力してよい情報か、の三点を確認してみてください。「学習」と「回答」を分ける知識は、専門用語を覚えるためではなく、AIに任せる部分と人が確かめる部分を見極めるために使えます。