
2026/11/01
今更聞けないAI知識
正解表なしでAIは何を学ぶ?「教師なし学習」を仕分け箱から理解する
正解を教えないのに「学習」と呼べる理由
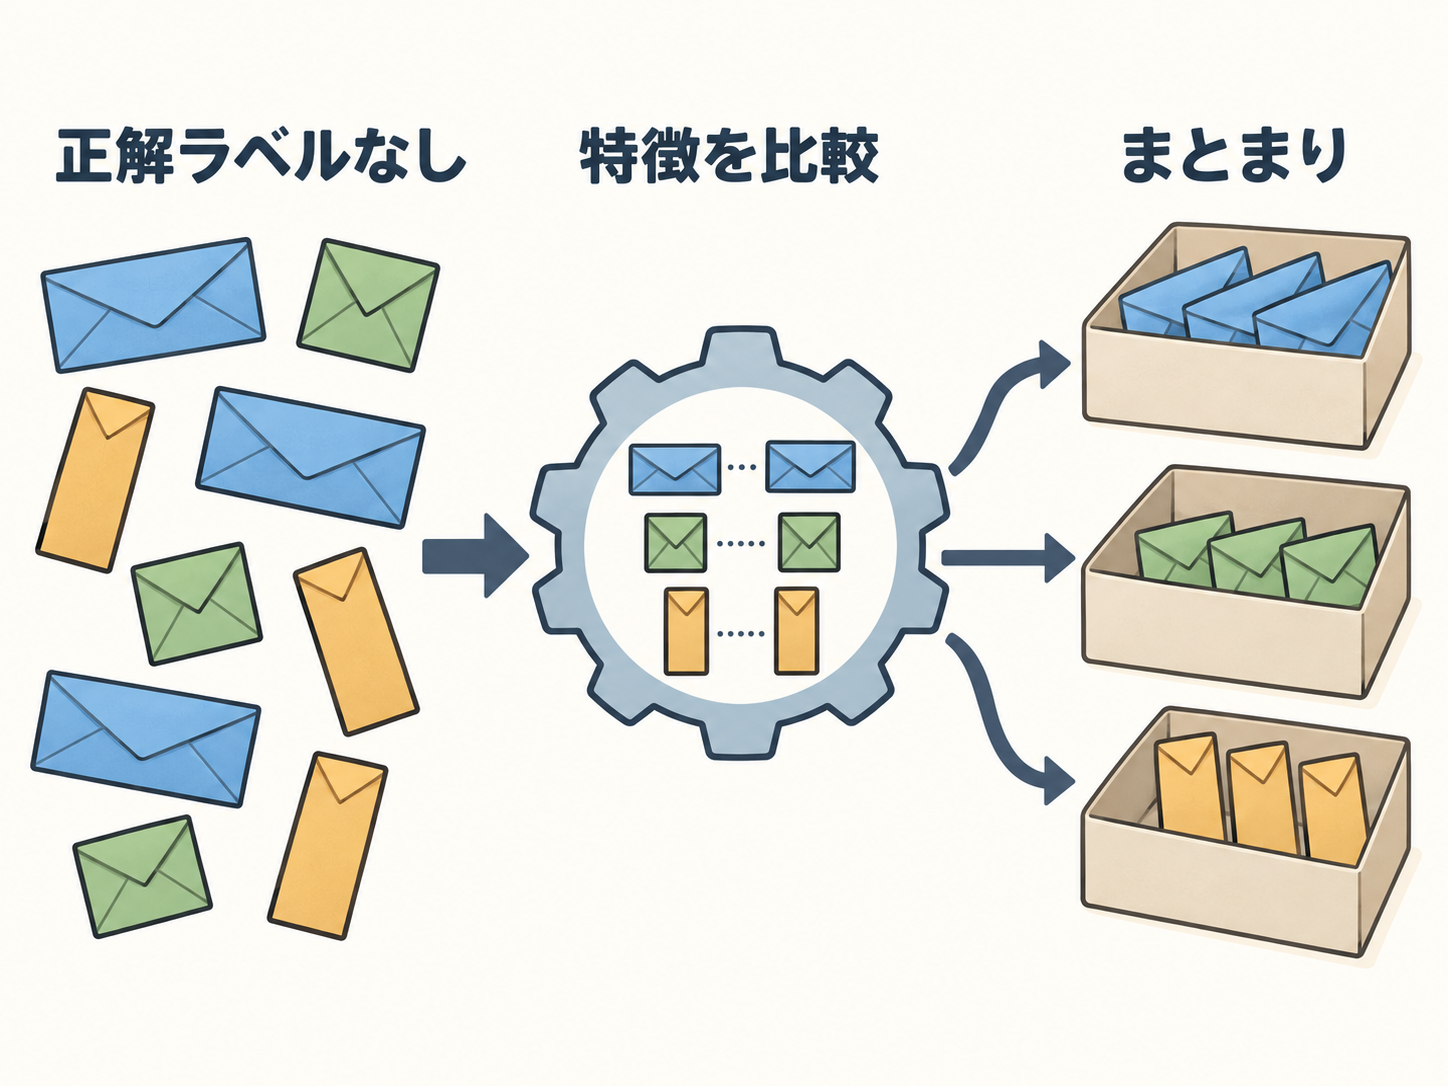
机の上に、送り主も内容も異なる大量の封筒が置かれているとします。「好きなように整理してください」と頼まれたものの、分類名や正解例は渡されていません。それでも、封筒の大きさ、色、厚さ、消印などに注目すれば、似たものを同じ箱へ集められます。教師なし学習を一言で表すなら、このように正解ラベルのないデータから、似ているものや繰り返し現れる特徴を見つける機械学習の方法です。
ここでいう「学習」は、コンピューターが人間のように意味を理解したり、経験を思い出したりすることではありません。機械学習では、アルゴリズムと呼ばれる計算手順をデータに適用し、予測や分類に使えるパターンを反映したモデルを作ります。AIは人の知的な働きに関連する機能を機械で実現する広い概念であり、機械学習はデータからパターンを得る、その内側の技術として説明されています(出典: IBM、Google Cloud)。
「教師なし」という名称も、機械へ何も指示しないという意味ではありません。人は、どのデータを渡すか、何を数値として扱うか、どの計算方法を使うかを決めます。ただし、個々のデータに「これは請求書」「これは案内状」といった正解を付けてから覚えさせるわけではありません。正解表の代わりに、データ同士の近さや共通点を手掛かりにするところが要点です。
そのため、教師なし学習が返すのは、試験問題に対する唯一の正答ではありません。「このデータには、こう分けると見えやすいまとまりがあります」という観察結果に近いものです。結果を受け取る人には、そのまとまりが目的に照らして役立つのか、偶然できただけなのかを確かめる役割が残ります。この距離感を押さえると、「AIが隠れた真実を発見した」という過大な受け止め方を避けられるでしょう。
ばらばらのデータがまとまりになるまで
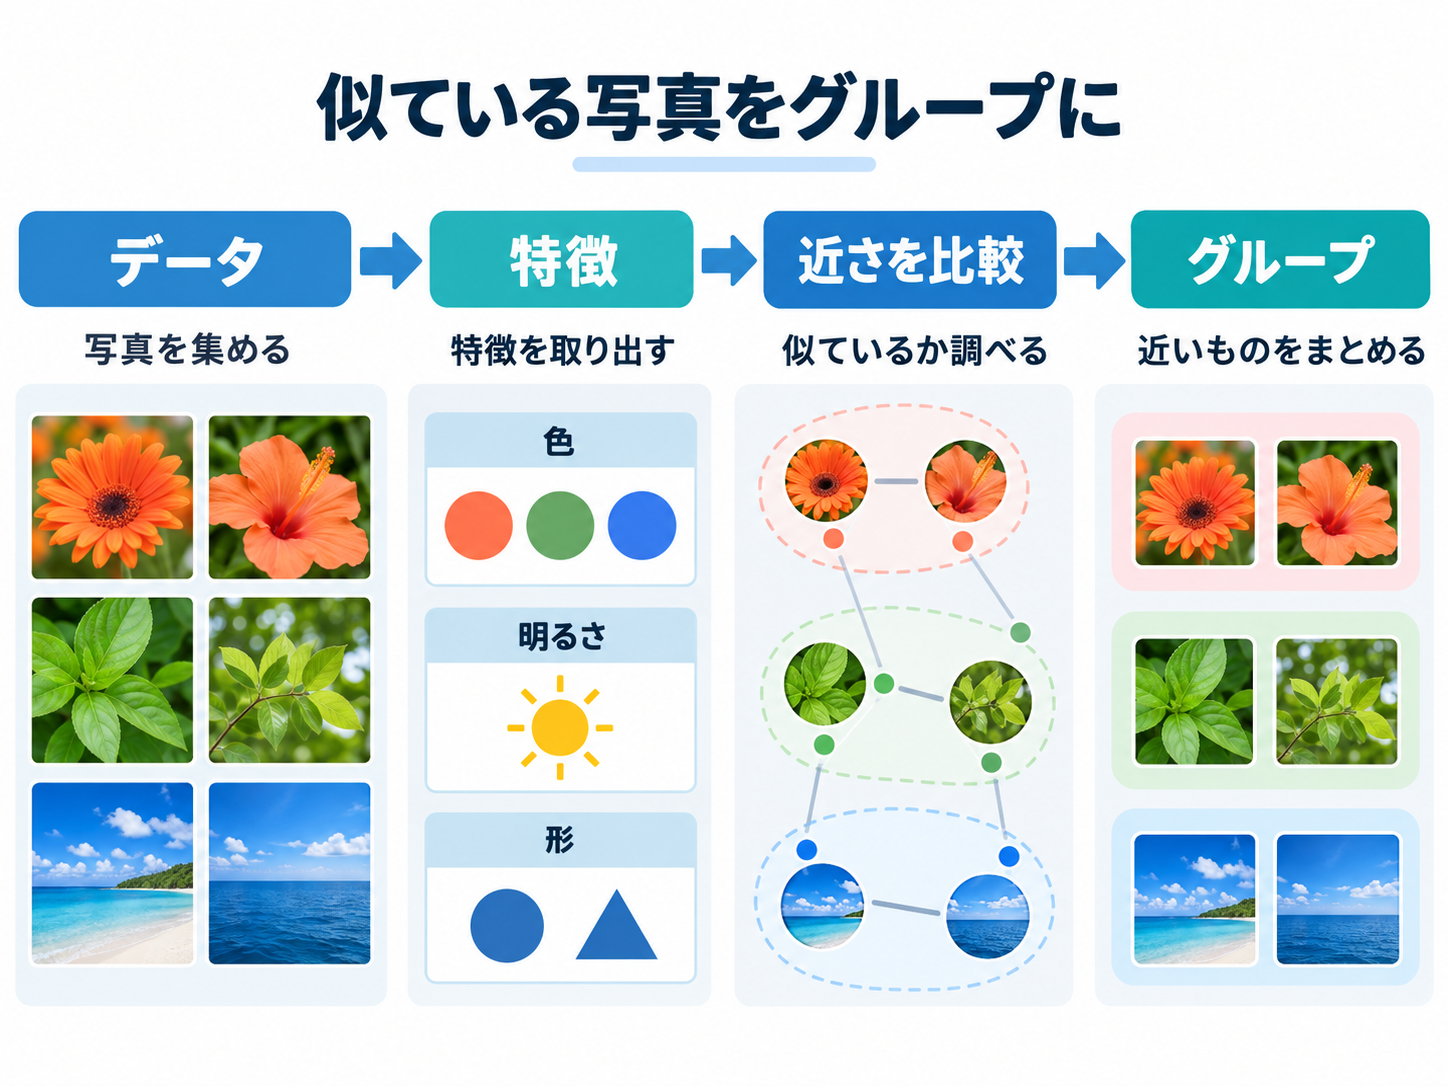
身近なたとえとして、名前の付いていない写真カードを考えてみましょう。カードには、明るい写真、暗い写真、青色が多い写真、丸い形が目立つ写真などが混ざっています。教師なし学習の代表的な考え方であるクラスタリングは、データの特徴を比べ、近いものをまとまりに分けます。クラスタリングは、機械学習で使われる手法の一つとして挙げられています(出典: IBM)。
処理の見方は、三つの場面に分けると理解しやすくなります。入力されるのは、正解名が付いていないデータです。計算では、それぞれが持つ特徴を比較します。出力されるのは、互いに似ていると計算されたデータのまとまりです。写真なら色や明るさ、商品の記録なら価格帯や購入時期などが、比較材料の架空例として考えられます。実際に何を特徴として扱うかは、対象データと目的によって変わります。
ここで注意したいのは、計算結果に最初から「夏の思い出」「仕事用」といった人間向けの意味が付くわけではないことです。出力が仮にA群、B群、C群へ分かれていても、その名前は単なる区別にすぎません。A群を調べると青い写真が多かったため、人が後から「青色が目立つ写真」と説明することはできます。しかし、モデル自身が青色の文化的な意味や撮影者の思いを理解したと解釈するのは行き過ぎです。
また、似ているかどうかは、何を比較したかに左右されます。同じ写真でも、色を重視すれば青い写真が集まり、明るさを重視すれば昼間の写真が集まるかもしれません。どちらか一方だけが正解なのではなく、問いに応じて見え方が変わります。教師なし学習は「意味を当てる装置」というより、大量のデータを眺めるための切り口を提示する方法だと捉えると、結果を扱いやすくなります。
教師あり学習との違いは「正解表」の有無
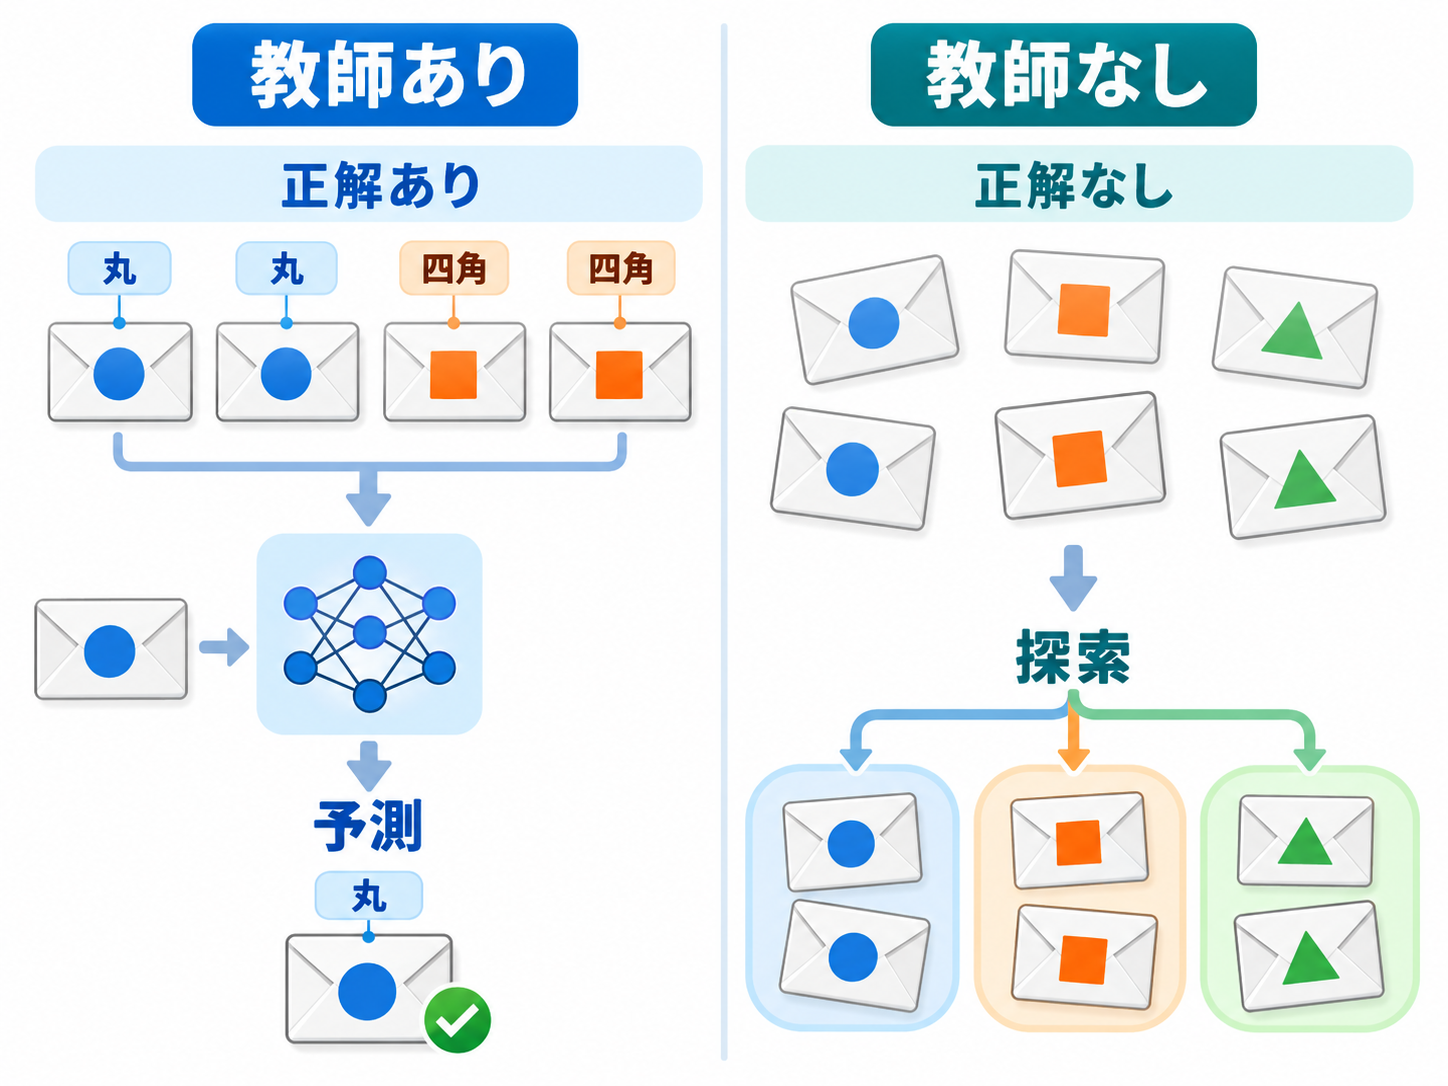
教師なし学習と対になる言葉として、教師あり学習があります。違いを理解する鍵は、人間の先生が横にいるかどうかではなく、学習用データに正解ラベルが付いているかどうかです。IBMは教師あり学習について、人が学習例と出力ラベルを組み合わせ、モデルが入力と出力の対応を学ぶ方法だと説明しています(出典: IBM)。
| 見る点 | 教師あり学習 | 教師なし学習 |
| --- | --- | --- |
| 学習時のデータ | 正解ラベルが付いている | 正解ラベルが付いていない |
| 目指すこと | 新しいデータの分類や値を予測する | 似たものや隠れたまとまりを探す |
| 封筒の架空例 | 請求書などの見本を基に種類を予測する | 外見の似た封筒をいくつかの群に分ける |
| 結果の確認 | 予測と正解を比べやすい | まとまりの意味や有用性を人が検討する |
たとえば、過去の問い合わせ文に「配送」「返品」「支払い」という正解ラベルが付いており、新しい問い合わせをどれかに振り分けたいなら、教師あり学習の形に近くなります。正解ラベルはないものの、どのような問い合わせが集まっているのかを眺めたいなら、似た文章をまとめる教師なし学習が候補になります。いずれも架空の活用例であり、特定の製品が自動的にこの処理を行うと示すものではありません。
教師あり学習には、答え合わせの基準を用意しやすい利点がありますが、事前にラベルを付ける作業が必要です。教師なし学習なら未整理のデータをそのまま調べる入口を作れますが、出てきた群に業務上の意味があるかは別に判断しなければなりません。優劣ではなく、すでに答えが決まっている問いなのか、データの中身を探索したい問いなのかで使い分けます。
「ラベルがないなら、AIが本当の分類を見つけてくれる」という理解も正確ではありません。教師なし学習が示すのは、選ばれた特徴と計算方法に基づく分け方です。人が期待していた分類と一致する場合もあれば、別の共通点が前面に出る場合もあります。結果を見る前に目的を言葉にしておくことが、二つの学習方法を選ぶうえでも役立ちます。
見つかったまとまりが正解とは限らない理由
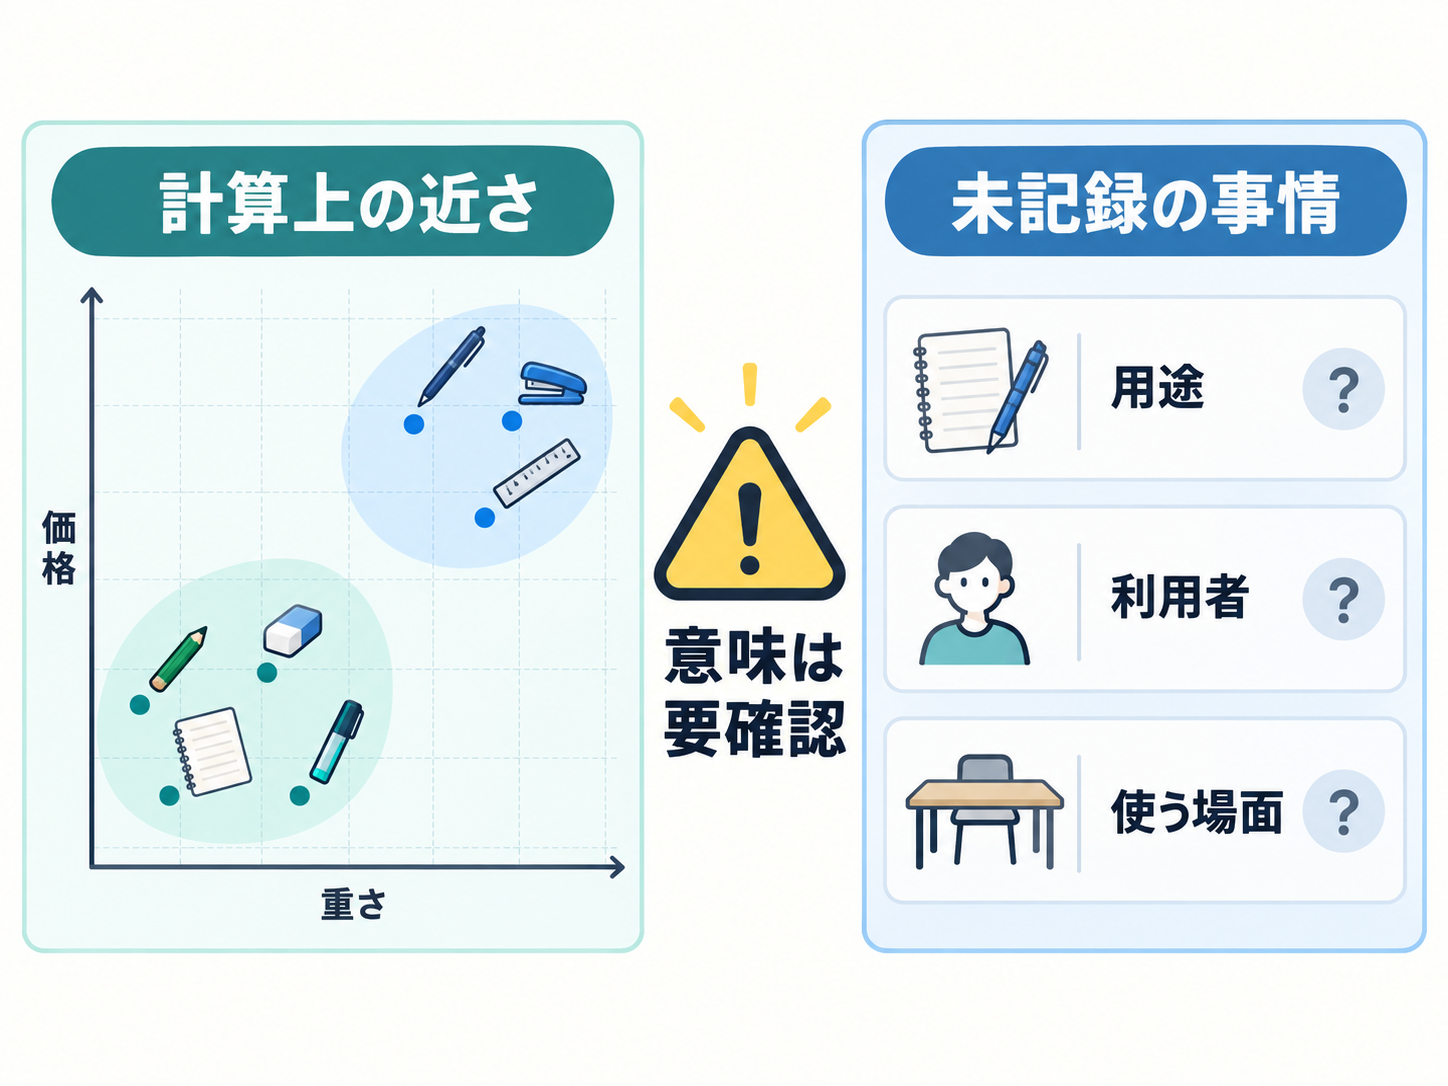
教師なし学習の結果には、もっともらしいまとまりが現れます。色分けされた図で境界がはっきり見えると、そこに客観的な種類が存在するように感じるかもしれません。しかし、データ上の近さと、現実世界で意味のある分類は同じではありません。この違いが、教師なし学習を読む際の中心的な注意点です。
たとえば、架空の文房具データを価格と重さだけで分けたところ、「軽くて安い群」と「重くて高い群」ができたとします。この結果から、前者は子ども向け、後者は専門家向けだとは断定できません。用途、材質、購入者、販売場所といった情報を計算に含めていないからです。モデルは与えられたデータの関係を反映しますが、記録されていない事情まで補って事実として示すものではありません。
データの集め方によっても見え方は変わります。ある季節の記録だけを渡せば、その季節に多い特徴が強く表れる可能性があります。対象の一部しか記録されていない場合、得られたまとまりを全体の傾向として扱うのは危険です。また、手法や設定が変われば、同じデータでも異なる分かれ方が得られる場合があります。これは失敗と決めつけるべき現象ではなく、「何を似ているとしたのか」を確認する合図になります。
群へ名前を付ける段階にも、人の解釈が入ります。「慎重な顧客」「関心が低い顧客」のような心理を推測する名称は、データにその根拠がなければ印象を事実のように見せてしまいます。「閲覧回数が少ない群」「問い合わせ件数が多い群」のように、実際に観察した特徴へ寄せた名前のほうが誤解を抑えられるでしょう。人物に関わるデータでは、分類が不利益な決定へ直結しないよう、目的と扱い方を慎重に検討する必要もあります。
したがって、結果を評価するときは「きれいに分かれたか」だけを見ません。どのデータを使ったのか、何を特徴としたのか、別の条件でも同じ傾向が見えるのか、その群分けが当初の問いに役立つのかを確かめます。教師なし学習の価値は、正解を宣告することではなく、人が詳しく調べるべき候補を見つけやすくする点にあります。
仕事や日常のデータで考える架空の活用例
教師なし学習は専門家だけの遠い話に見えますが、「名前のない山を、眺めやすい単位に分ける」と考えると用途を想像できます。たとえば、自由記述の社内アンケートが大量に集まり、あらかじめ回答の種類が決まっていない場面です。似た記述のまとまりを探せば、設備、働き方、情報共有など、確認すべき話題の候補が見えてくるかもしれません。これは活用の提案であり、分類精度や作業時間の短縮を保証するものではありません。
家庭なら、持ち物の記録を整理する架空例があります。品名、使った時期、置き場所などの記録から似たものをまとめれば、「同じ時期に使う物」や「同じ場所に置かれやすい物」が候補として現れる可能性があります。ただし、捨ててよい物や大切な物を機械が判断したことにはなりません。家族の思い出や今後の予定は、記録された特徴だけでは決められないためです。
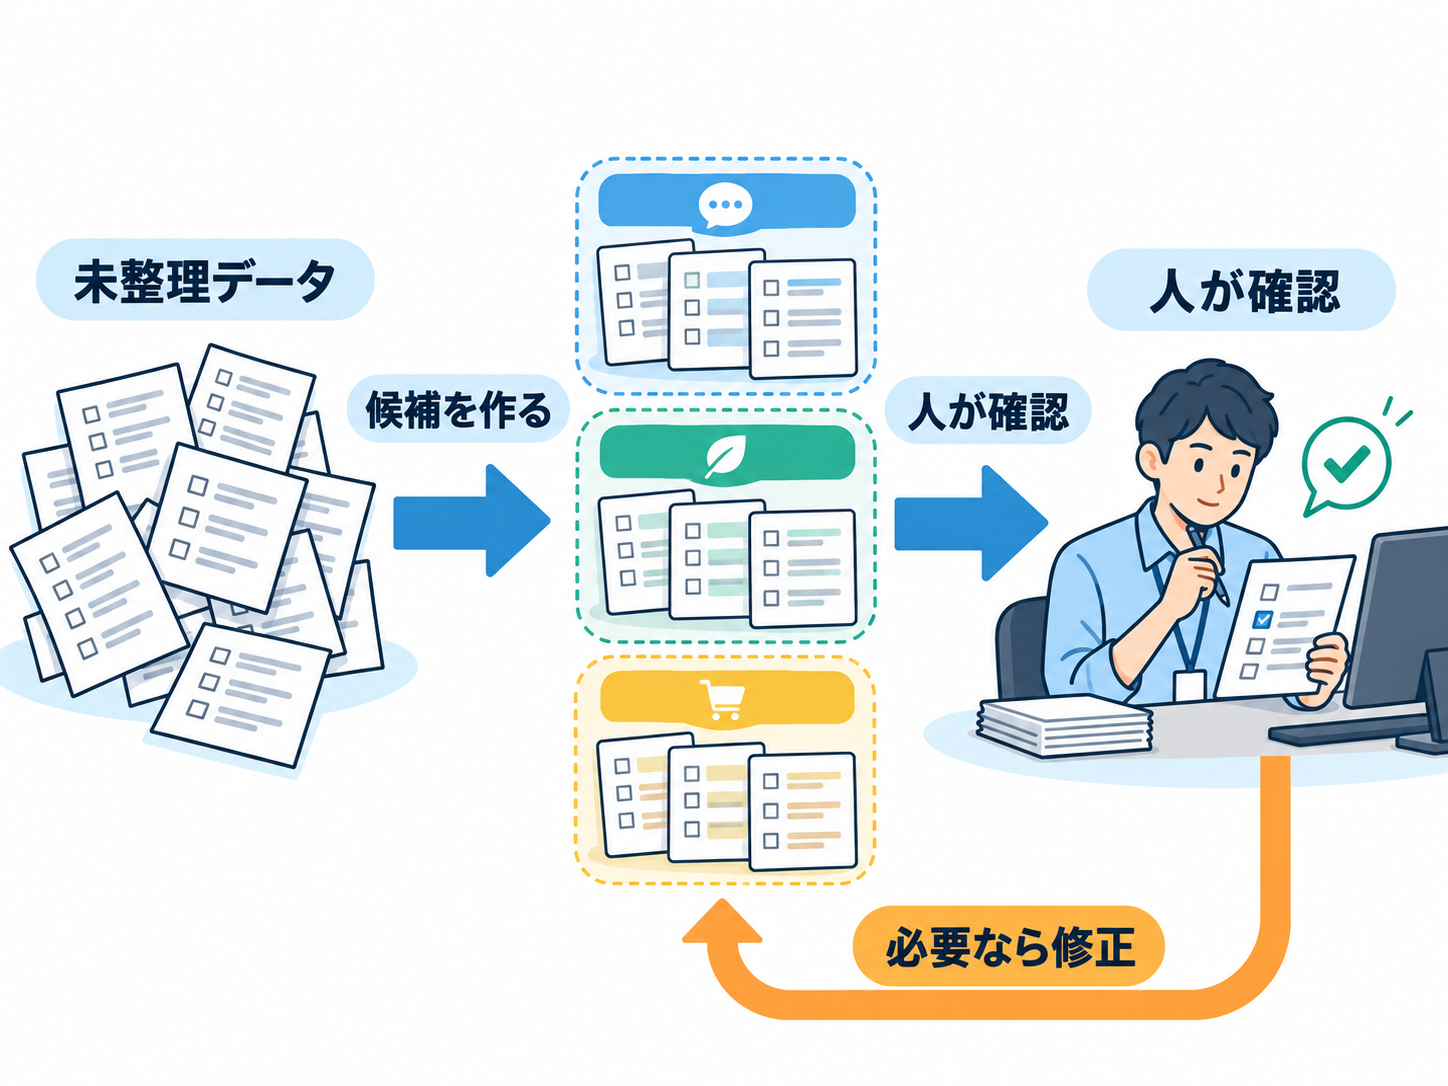
仕事で検討するなら、入力と出力の間に人の確認工程を置きます。未整理の文章をそのまま正式な区分へ採用するのではなく、似た記録の候補を作り、担当者が各群の内容を読み、必要なら分け直します。判断の流れは「データを集める、まとまりを候補として得る、根拠となった特徴を見る、目的に合うか確認する」と考えられます。ここで最終判断を人に戻せば、計算上の近さを業務上の正解と取り違えにくくなります。
生成AIとの混同にも注意が必要です。生成AIは、利用者のプロンプト、つまり入力した依頼に応じて文章や画像などの内容を作る深層学習モデルとして説明されています(出典: IBM)。それに対して、今回扱う教師なし学習の中心は、正解ラベルのないデータから構造やまとまりを探すことです。生成AIへ「似た意見をまとめて」と頼む場面があっても、画面に表示された分類がどの手法で作られたかは、その依頼文だけでは判断できません。
活用を考える際は、製品名から入るより、「正解ラベルはあるか」「予測したいのか、探索したいのか」を先に整理すると迷いが減ります。データの中に未知の傾向があるかを調べる段階なら教師なし学習の考え方が合い、すでに決めた種類へ新しいデータを振り分けたいなら教師あり学習が候補になります。
結果を受け取ったときの五つの確認
教師なし学習を自分で構築しなくても、その結果を見る機会はあります。「似た利用者を三つに分類しました」「文章から話題の群を抽出しました」といった説明を受けたとき、図の見栄えだけで納得する必要はありません。専門用語を知らなくても、問い方を変えれば結果の性質を確かめられます。
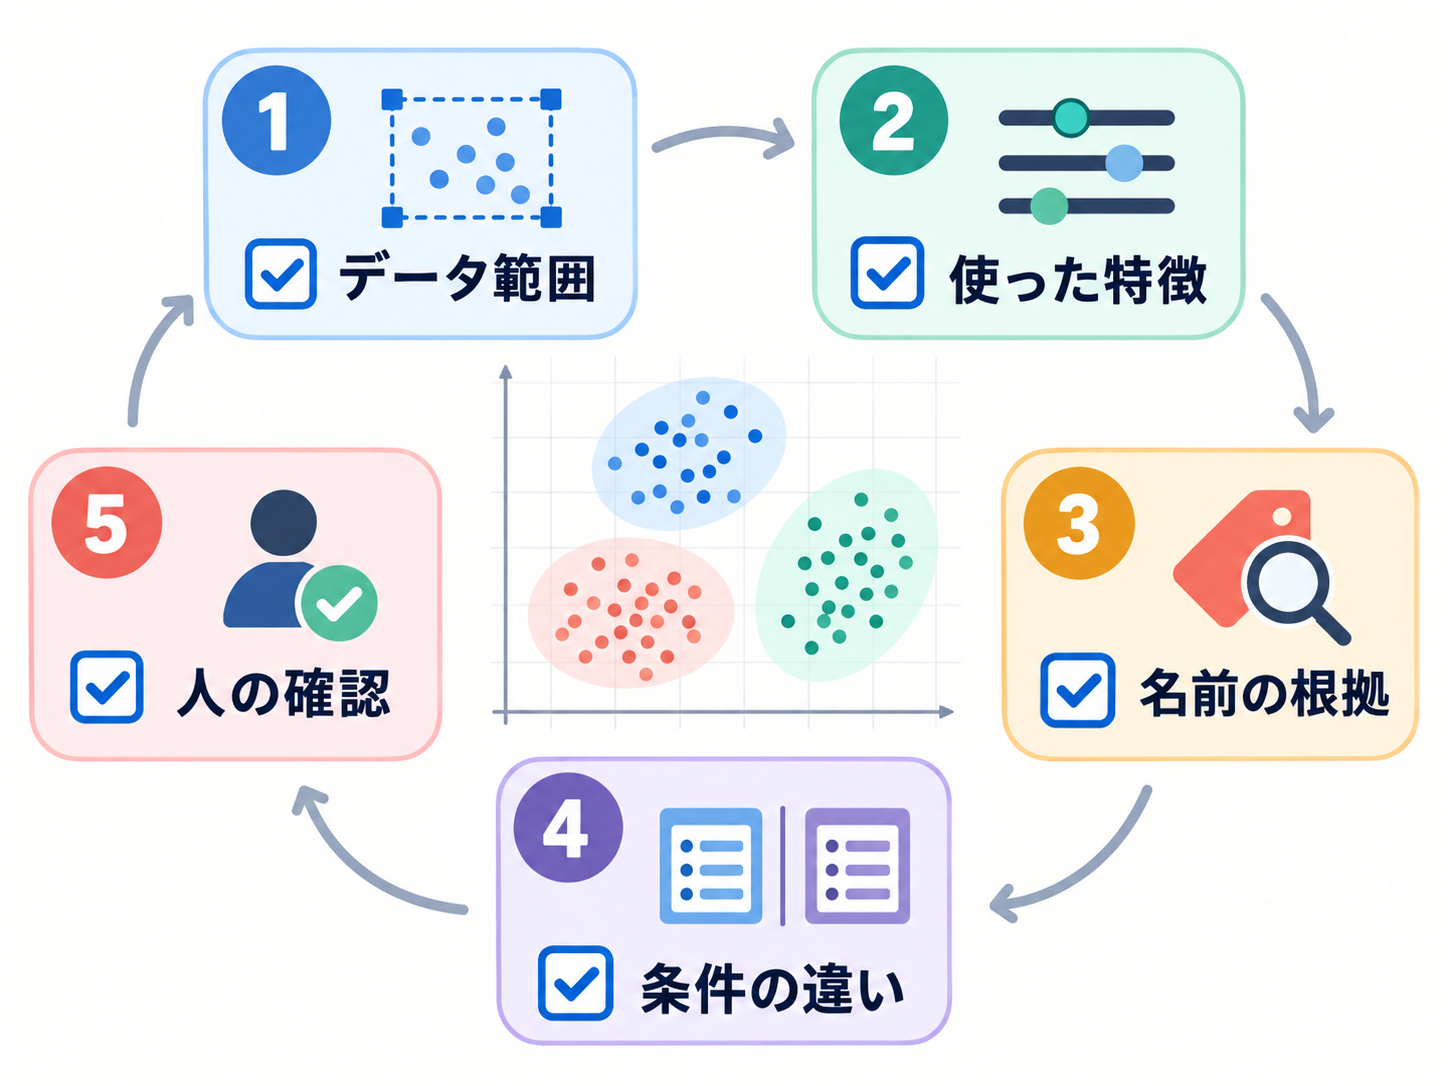
確認したい点は、次の五つです。
- 元になったデータは何で、どの期間や範囲を含みますか。
- 似ているかどうかを決める際、どの特徴を使いましたか。
- 群の名前はデータに含まれていたものですか、それとも後から付けた解釈ですか。
- 条件やデータを変えても、同じようなまとまりが見つかりますか。
- この結果だけで決定せず、元データを人が確認できるようになっていますか。
これらは、モデルの内部計算をすべて理解するための質問ではありません。結果がどこまで観察事実で、どこからが解釈なのかを分けるための質問です。特に「三つのタイプが存在する」という説明を見たら、最初から三つに分ける条件だったのか、計算の結果として三つが選ばれたのかを確認するとよいでしょう。前提が違えば、数字の受け止め方も変わります。
教師なし学習を知った後に変えたいのは、AIへの期待の置き方です。正解のないデータを扱えることと、正しい意味を自動で決められることは同じではありません。出力は結論というより、観察を始める地図です。地図に描かれた境界が現実の境界と一致しているかは、目的を持つ人が元の情報へ戻って確かめます。
明日からできる一歩として、手元の未整理な記録を一つ選び、「すでに正解の分類があるか」「似たものを眺めたいだけか」を書き分けてみてください。前者なら教師あり学習、後者なら教師なし学習という基本的な方向が見えてきます。そのうえで、どの特徴を使うと望む見方に近づくのかを考えれば、AIという言葉だけに振り回されず、目的から方法を選べるようになるでしょう。
参考情報
- What Is Artificial Intelligence (AI)?(IBM、2024年8月9日公開、2026年10月2日更新、2026年11月1日取得)
- AI vs. Machine Learning: How Do They Differ?(Google Cloud、資料内に公開日の記載なし、2026年11月1日取得)