
2026/10/31
今更聞けないAI知識
AIはなぜ、もっともらしい間違いを答えるのか――ハルシネーションの正体と確かめ方
自然な回答ほど信じたくなる落とし穴
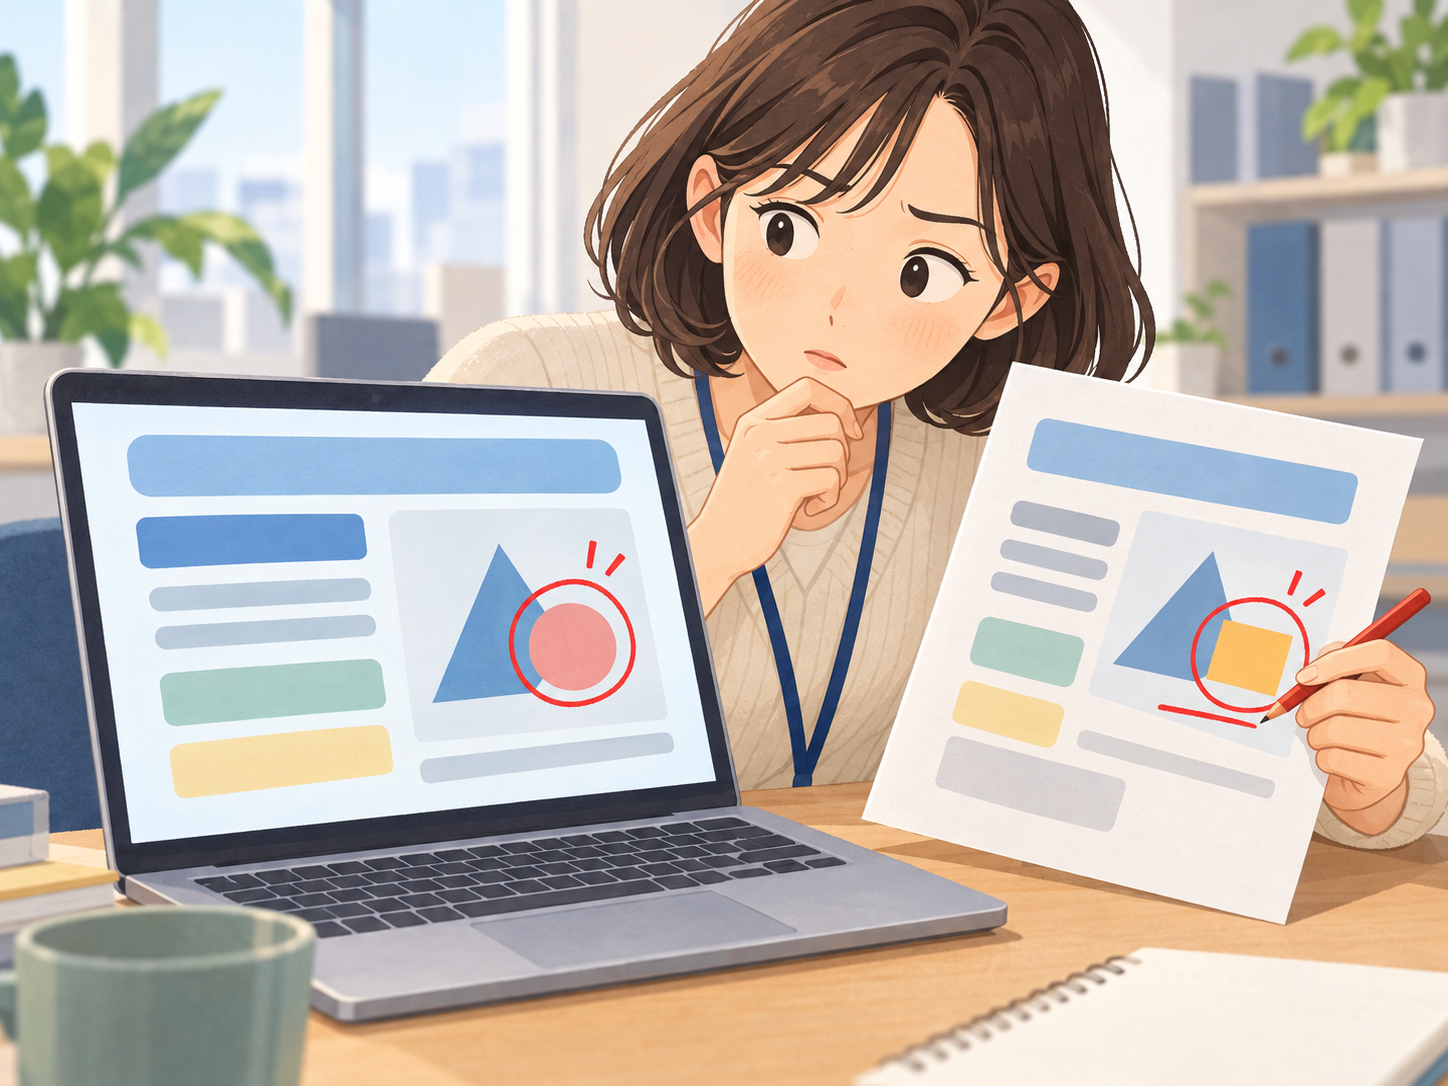
会議の資料を作るため、生成AIに制度の開始日を尋ねたとします。返ってきた文章は読みやすく、制度名や担当組織まで具体的です。ところが公式サイトを確認すると、その日付も組織名も見当たりません。このような場面で起きている可能性があるのが、生成AIの「ハルシネーション」です。
一言で表すなら、ハルシネーションとは、生成AIが事実とは異なる内容や根拠を確認できない内容を、もっともらしい文章として出力する現象です。文章が不自然に崩れるとは限りません。むしろ、説明が滑らかで具体的だからこそ、読む側が誤りに気づきにくい点に注意が必要です。
Googleの機械学習用語集では、現実に基づく出力の性質を「factuality」、日本語では事実性と捉えられる概念として説明しています。ここで大切なのは、生成AIの回答が文章として成立していることと、事実性を備えていることは同じではない、という点です(出典: Google for Developers)。
ハルシネーションを知る目的は、AIを怖がることでも、すべての回答を疑って捨てることでもありません。文章の下書きと、事実の確認を別の作業として扱えるようになることです。社内メールの言い回しを整える用途と、契約条件や日付を確定する用途では、必要な確認の重さが違います。その境界を見分けられれば、生成AIの回答を「正解」ではなく「確認前の候補」として落ち着いて扱えるでしょう。
空欄を自然に埋めるように文章を続ける仕組み
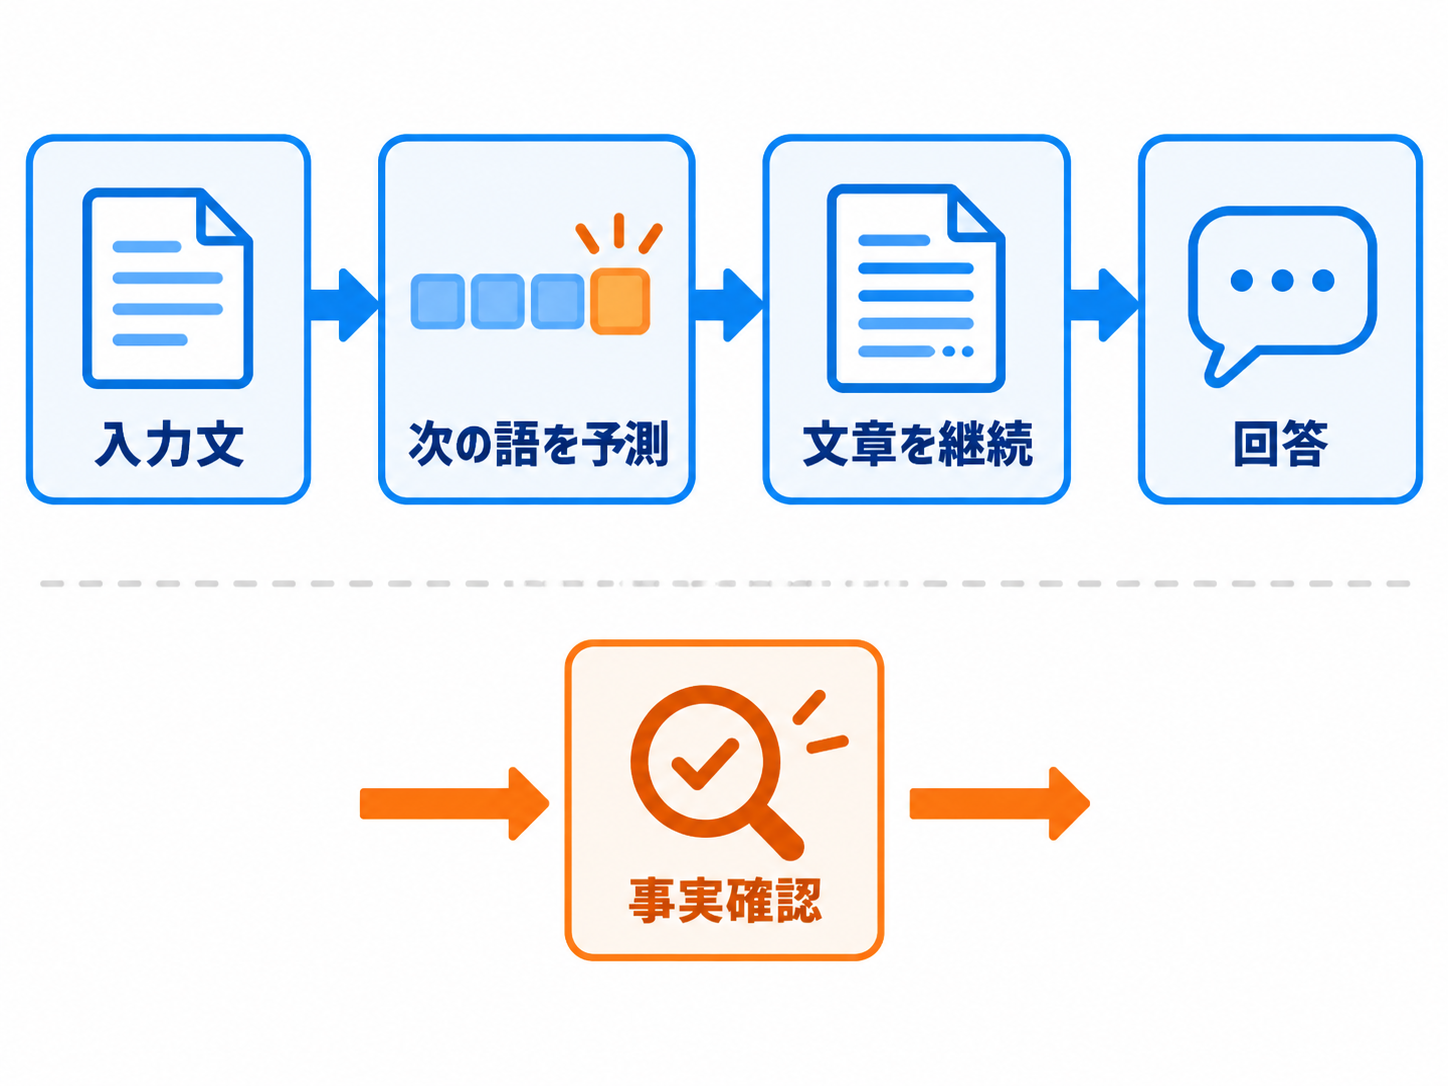
生成AIがもっともらしい間違いを作る理由は、文章を生成する基本的な仕組みから考えると理解しやすくなります。身近なたとえとして、「冷蔵庫を開けたら、牛乳が__」という空欄を見てください。「入っていた」「切れていた」など、前後につながりやすい言葉を思い浮かべられます。ただし、実際の冷蔵庫を確認しなければ、どれが事実かは決まりません。
文章を扱う大規模言語モデルも、これに似た予測を積み重ねます。Googleの用語集では、自己回帰型モデルを、それまでに予測した内容を基に次のトークンを予測するモデルと説明しています。トークンは、ここでは文章を処理するための細かな単位と考えれば十分です。また、Transformerを基盤とする大規模言語モデルは自己回帰型だとされています(出典: Google for Developers)。
この仕組みが得意なのは、文脈に合う続きを作ることです。質問に「理由を三つ挙げてください」とあれば、理由を三項目に整理した回答を生成できます。しかし、続きとして自然な表現を選ぶことと、現実の資料を一件ずつ調べて裏付けることは別の仕事です。確認材料が回答時に使われていなければ、実在しそうな名称や日付を組み合わせる可能性があります。
AIがうそをつこうとしている、と擬人化する必要はありません。そこに人間のような意図があると決めつけるより、「文章の続きは作れても、現実との照合が済んでいるとは限らない」と捉えるほうが実用的です。仕組みを知ると、流暢さを能力の万能さと取り違えにくくなります。
文章の自然さと事実の正しさは別の軸
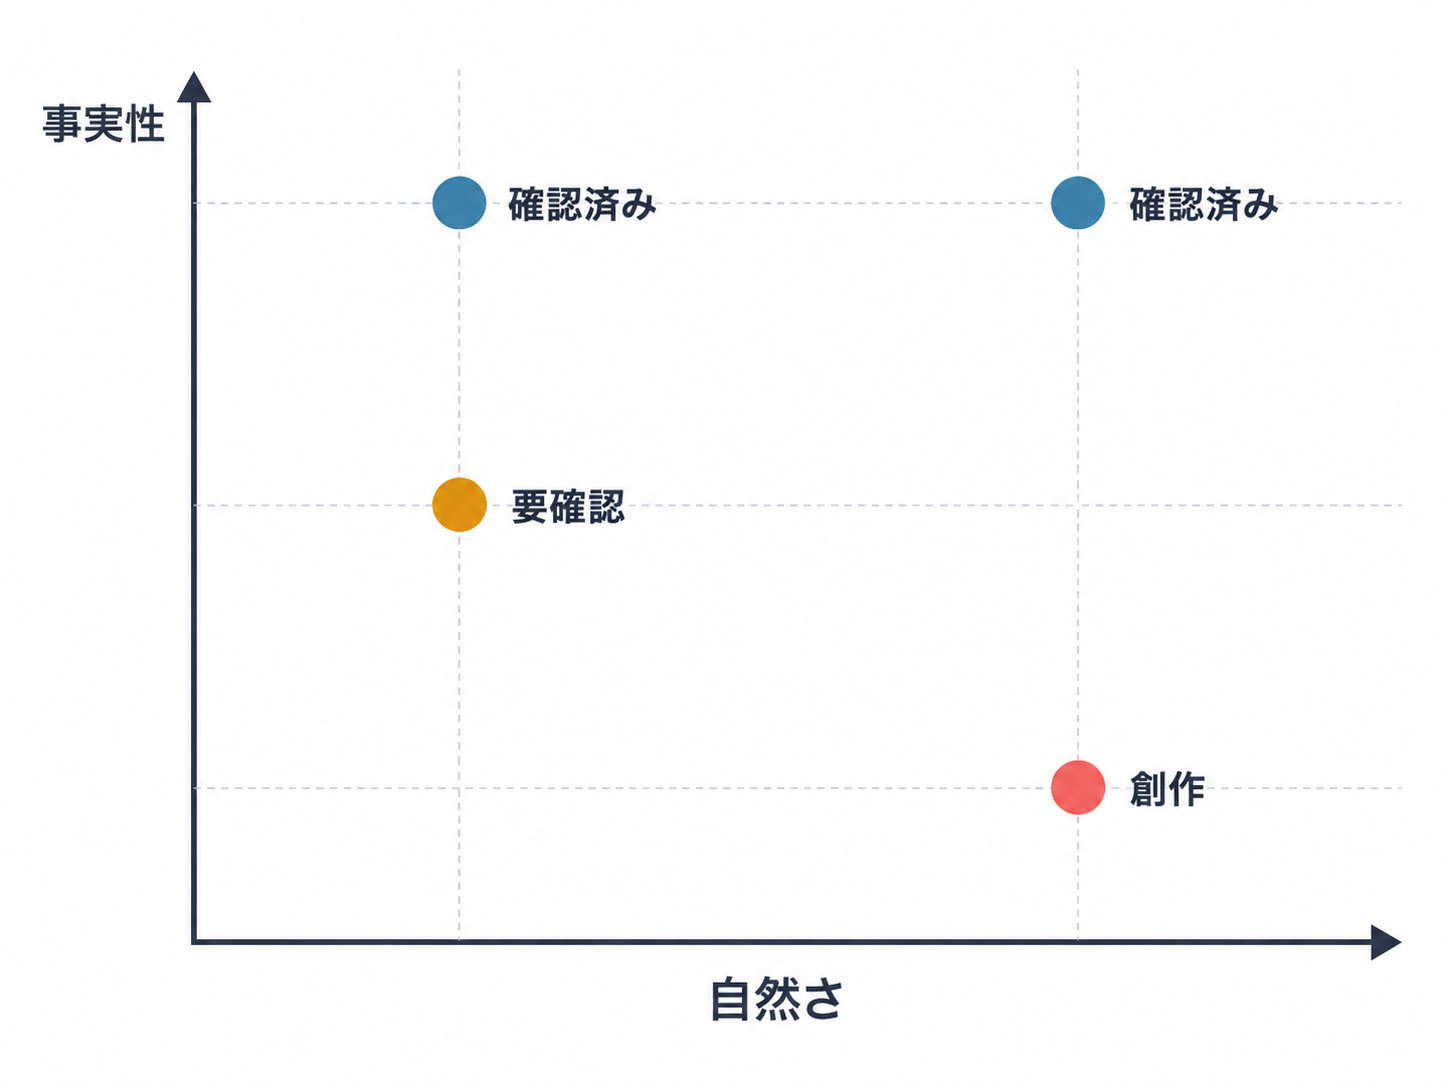
回答を読むときは、「読みやすいか」と「正しいか」を一つの物差しで測らないことが大切です。たとえば架空の商品の広告文なら、創造性や表現の豊かさが役立ちます。実在する補助金の締切を確認する場面では、文章の魅力よりも、公式資料と一致しているかどうかが優先されます。
Googleの用語集も、事実性が望まれる質問と、創造性が求められる依頼を区別しています。食塩の化学式を尋ねる質問では現実に基づく回答が必要ですが、架空の詩を作る依頼では、現実の出来事である必要はありません。つまり、生成AIの出力を評価する基準は、依頼の目的によって変わります(出典: Google for Developers)。
| 依頼の例 | 主に見る点 | 確認の考え方 |
| --- | --- | --- |
| 架空の店名を考える | 発想や雰囲気 | 既存商標などを使う前に別途確認します |
| お礼メールを整える | 読みやすさや失礼のなさ | 日時や氏名を送信前に見直します |
| 制度の締切を尋ねる | 事実性と最新性 | 公式資料の日付と対象条件を確認します |
| 会議内容を要約する | 元資料との一致 | 発言者や決定事項を原文と照合します |
よくある誤解は、説明が詳しければ信頼性も高いと感じてしまうことです。長い理由、専門用語、具体的な数字が並んでいても、それだけでは裏付けになりません。反対に、短い回答でも公式資料と一致していれば、事実確認の目的には適しています。文章力と事実性を分けて見るだけで、見た目の説得力に引っ張られにくくなるでしょう。
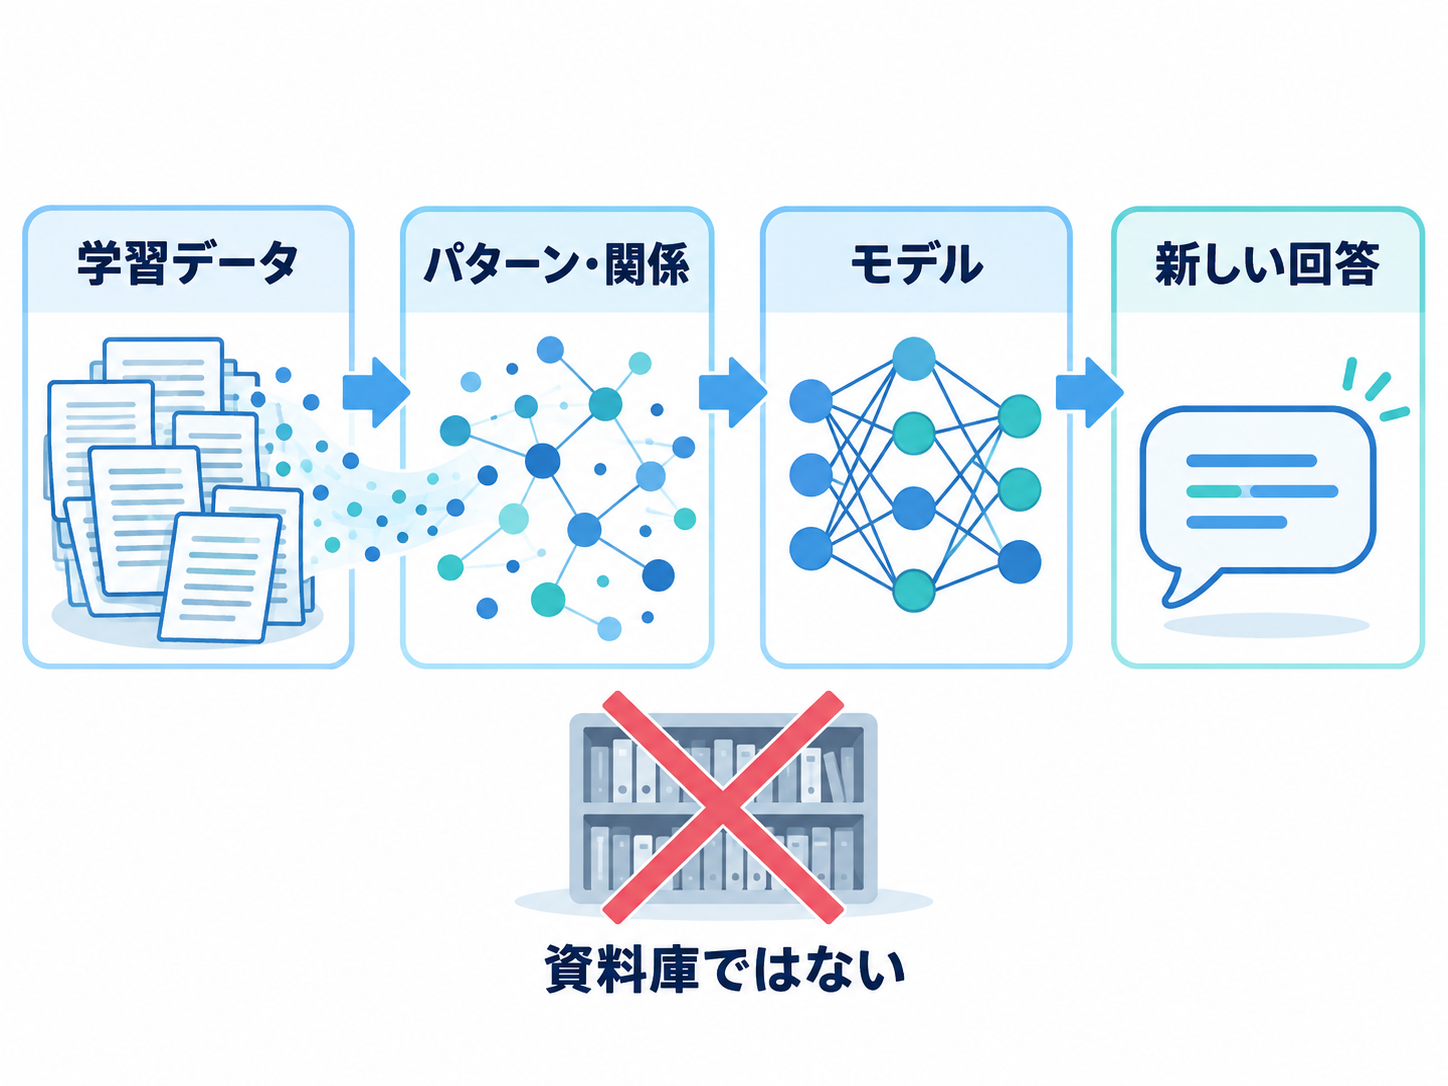
学習済みでも正解集をそのまま取り出しているわけではない
「大量の情報を学習しているなら、正しい答えを覚えているのでは」と感じるかもしれません。ここでは、AIの「学習」を、試験前に正解集を暗記することと同じだと考えないほうが理解しやすくなります。学習によって作られるモデルは、読んだ資料をページ単位で並べた書庫そのものではありません。
IBMの解説によると、生成モデルは学習データを簡略化した表現として取り込み、その表現を基に、元のデータと似ていても同一ではない新しい内容を生成します。大規模な基盤モデルでは、データに含まれる対象、パターン、関係性が多数のパラメーターに符号化されます(出典: IBM)。パラメーターは、モデルが出力を組み立てる際に使う調整値と捉えればよいでしょう。
この説明から分かるのは、「学習に使われた可能性がある情報」と「今の回答で根拠を確認できる情報」は同じではないということです。制度名を知っているように見えても、現在の適用条件や改定日まで正しいとは限りません。似た名称の制度や過去の情報が混ざれば、文章としては自然でも現状に合わない回答になる可能性があります。
学習と、利用者が質問したときの回答生成も区別しておきたいところです。質問文は、どの方向の回答を作るかを示す材料になりますが、それだけで外部の公式資料との照合が完了するわけではありません。質問を詳しく書くことは有効でも、「詳しいプロンプトなら誤りがなくなる」とは考えず、確認が必要な項目を見つけやすくする手段として使うのが現実的です。
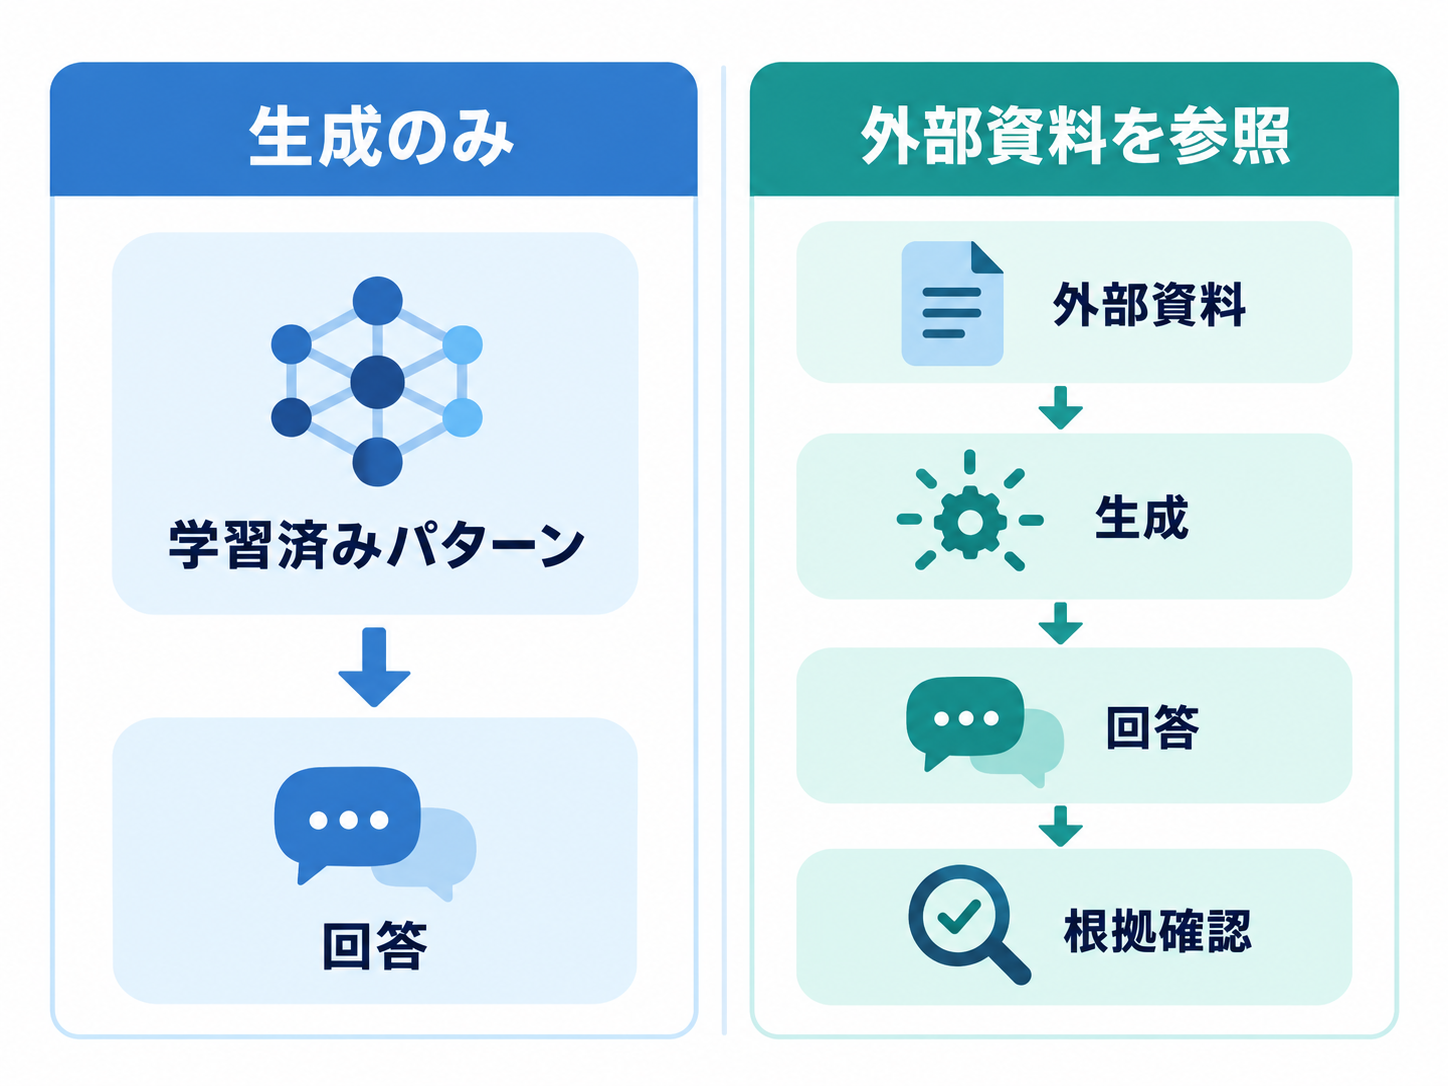
検索と生成を混同しないための見分け方
検索と生成AIは、どちらも質問に関係する情報を画面に示すため、同じものに見えがちです。ただし、利用者が受け取る結果の役割は異なります。検索では、候補となるページを見つけた後、利用者がリンク先の発信者、公開日、本文を読んで判断します。生成AIでは、学習したパターンを基に文章そのものが組み立てられます。
IBMは、生成AIの性能を高める方法の一つとして、検索拡張生成、略してRAGを紹介しています。これは、学習データの外にある関連情報源を基盤モデルで利用し、回答の正確性や関連性を高めるための技術です(出典: IBM)。この説明は、裏返せば、生成と外部資料の参照が別の要素であることを示しています。
| 見るポイント | 生成された文章 | 確認可能な外部資料 |
| --- | --- | --- |
| 主な役割 | 質問に沿って内容をまとめます | 根拠となる記述を示します |
| 読みやすさ | 一つの回答に整理されやすいです | 複数ページの確認が必要な場合があります |
| 確認方法 | 主張を項目に分けます | 発信元、日付、本文を照合します |
| 注意点 | 自然な誤りが混ざる可能性があります | 資料自体の古さや適用範囲も確認します |
ただし、外部資料を使う仕組みがあれば、必ず正しいという意味ではありません。選ばれた資料が古い、質問と対象範囲が違う、資料の読み取り方がずれる、といった余地は残ります。利用中のサービスが検索や外部資料を使ったかどうかは、そのサービスの表示や提供条件で確認してください。出典らしい名称が回答に書かれているだけなら、実在するページか、記載内容が回答を本当に支えているかまで開いて確かめる必要があります。
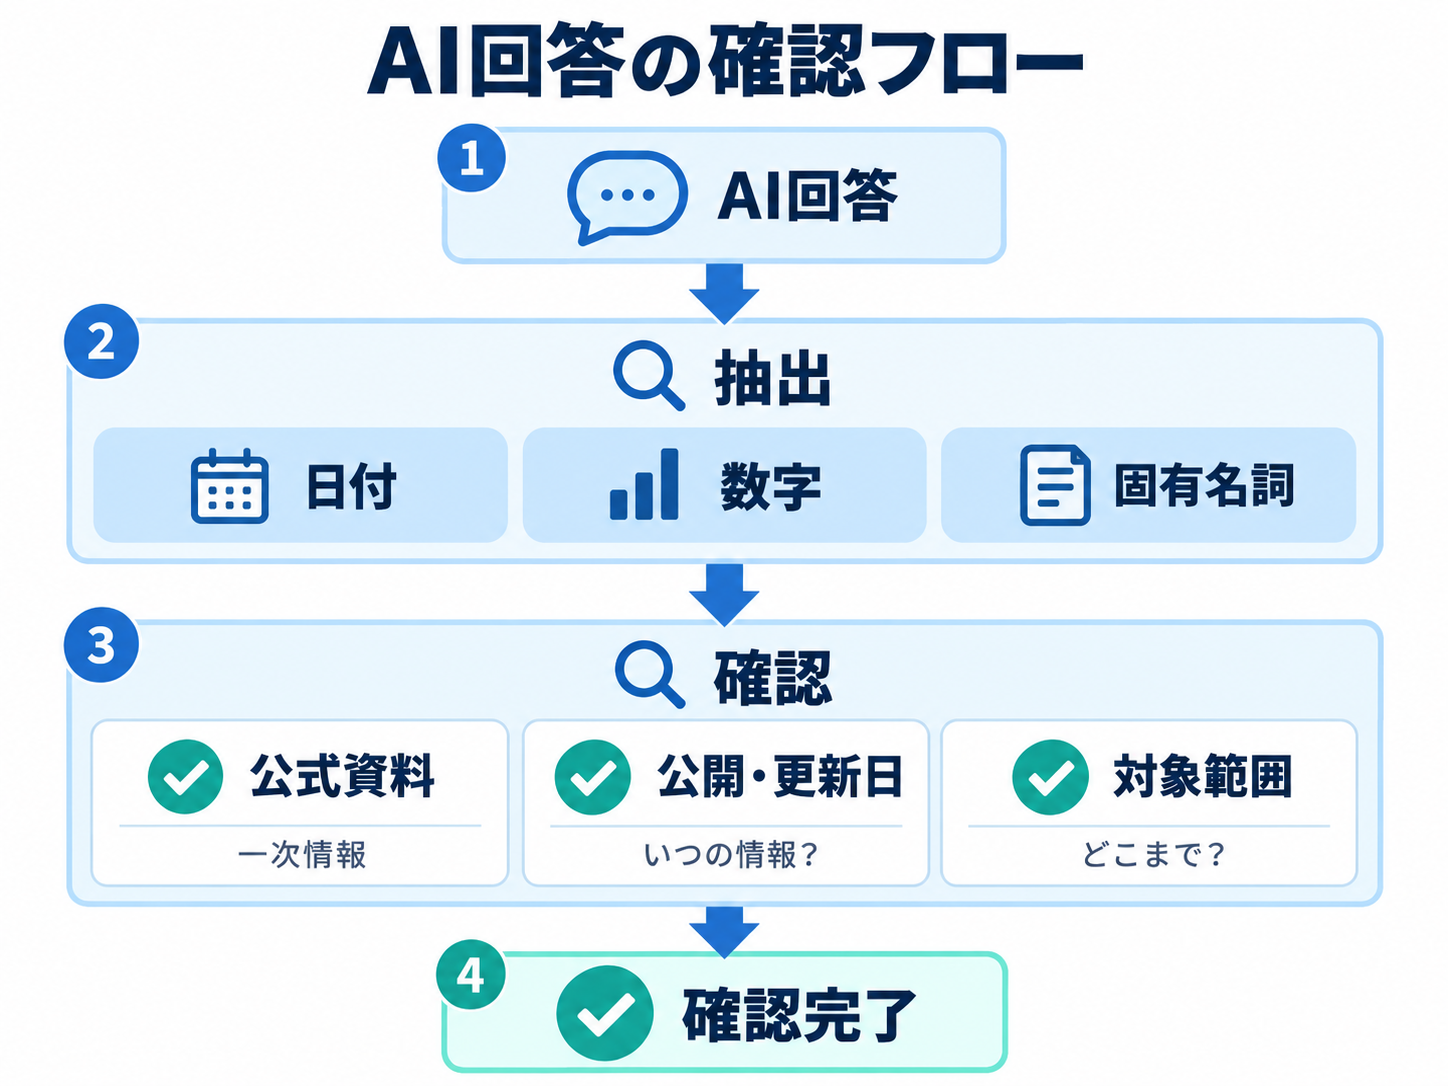
日付・固有名詞・数字から確認を始める方法
回答の全文を一字ずつ調べるのは現実的ではありません。そこで、間違った場合の影響が大きく、照合しやすい箇所から確認します。目印になるのは、日付、金額、割合、制度名、会社名、人名、製品名、法律や規則の名称です。これらは文章の説得力を高める要素でもありますが、誤っていれば申請、契約、発注、社外説明などに直接影響します。
たとえば、生成AIから「申請期限は11月30日です」という回答を得たとします。この場合は、検索結果の見出しだけで決めず、制度を運営する組織の公式ページを開きます。年度、対象地域、申請者の条件を確認し、ページの公開日や更新日も見ます。同名の過去制度を参照していないかまで確かめれば、日付だけを拾うより判断しやすくなります。これは架空の確認例であり、特定制度の実際の期限を示すものではありません。
社内文書を要約させた場合は、別の確認が必要です。会議の決定事項、担当者、期限を元の議事録と照合します。「検討する」と「実施する」では意味が違うため、言い換えによって確定事項に変わっていないかも見逃せません。文章の調子を整える作業では、宛名、日時、添付ファイル名を確認すると、事実に関する事故を減らしやすくなります。
確認の深さは用途に合わせます。個人用のアイデアメモなら、すべての表現に出典を付ける必要はないでしょう。医療、法律、金融、安全、契約など、誤りの影響が大きい判断では、生成AIの回答だけで決めず、専門家や所管組織が示す資料を確認する必要があります。「どこまで疑うか」ではなく、「間違ったときに何が起きるか」から確認範囲を決めるのが実用的です。
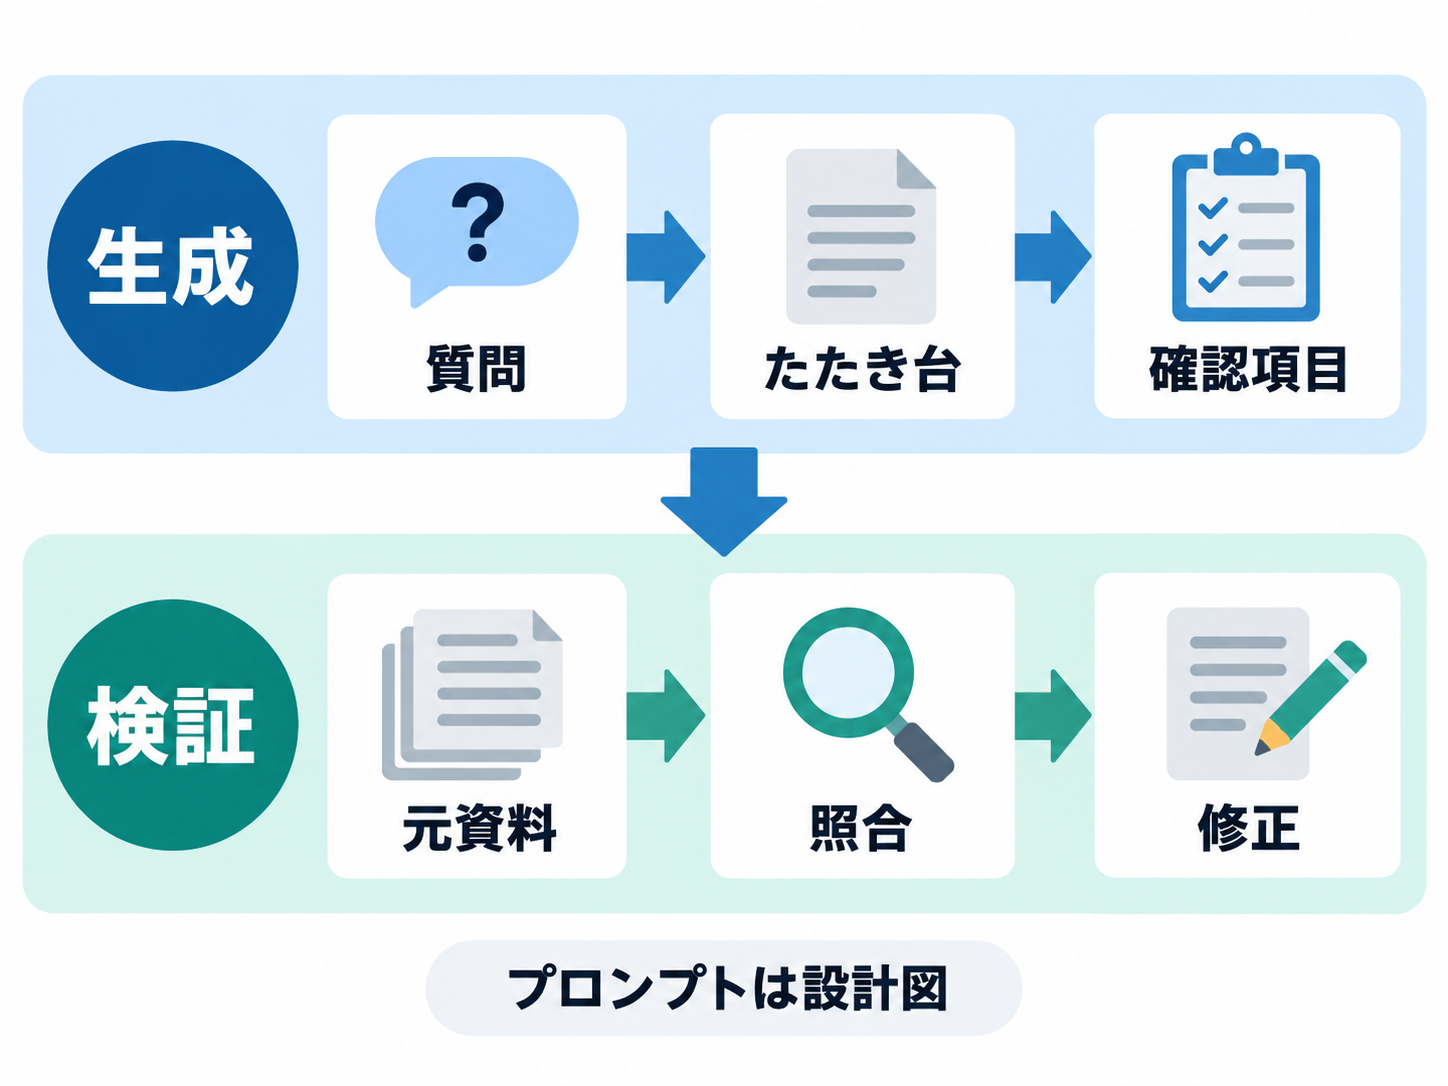
プロンプトは正解を保証する呪文ではなく確認作業の設計図
プロンプトとは、生成AIに渡す質問や指示のことです。書き方を工夫すると、回答の目的や形式を伝えやすくなります。ただし、丁寧なプロンプトを使っても、内容の正しさが自動的に保証されるわけではありません。役に立つのは、AIに断言させることより、利用者が後で確認しやすい形に回答を分けてもらう使い方です。
たとえば、調査のたたき台を作るなら、次のような入力が考えられます。これは利用方法の提案であり、特定の製品で検証した操作手順ではありません。
この回答は確認前のたたき台として作成してください。
事実として確認が必要な日付、数字、固有名詞を分けて示してください。
根拠を確認できない内容は、未確認と明記してください。
元資料が手元にある場合は、推測を減らすため、回答範囲を限定する方法もあります。たとえば「以下の文章に書かれている範囲だけで要約してください。書かれていない点は不明としてください」と依頼します。その後、要約に含まれる数字や担当者名を原文と見比べます。元資料を渡したこと自体を確認完了とせず、重要項目は人が照合するのが安全です。
出典を求める場合も、「出典を書いてください」で終えないほうがよいでしょう。確認したい主張を一文ずつ分け、どの資料のどの記述に対応するかを整理してもらうと、利用者がリンク先を確認しやすくなります。リンクが開けない、資料名が見つからない、記載箇所が主張を支えていない場合は、その回答を根拠として使いません。プロンプトの役目は誤りを消すことではなく、誤りを発見できる作業の形を作ることです。
AIを信じるかではなく、回答をどこで止めるか
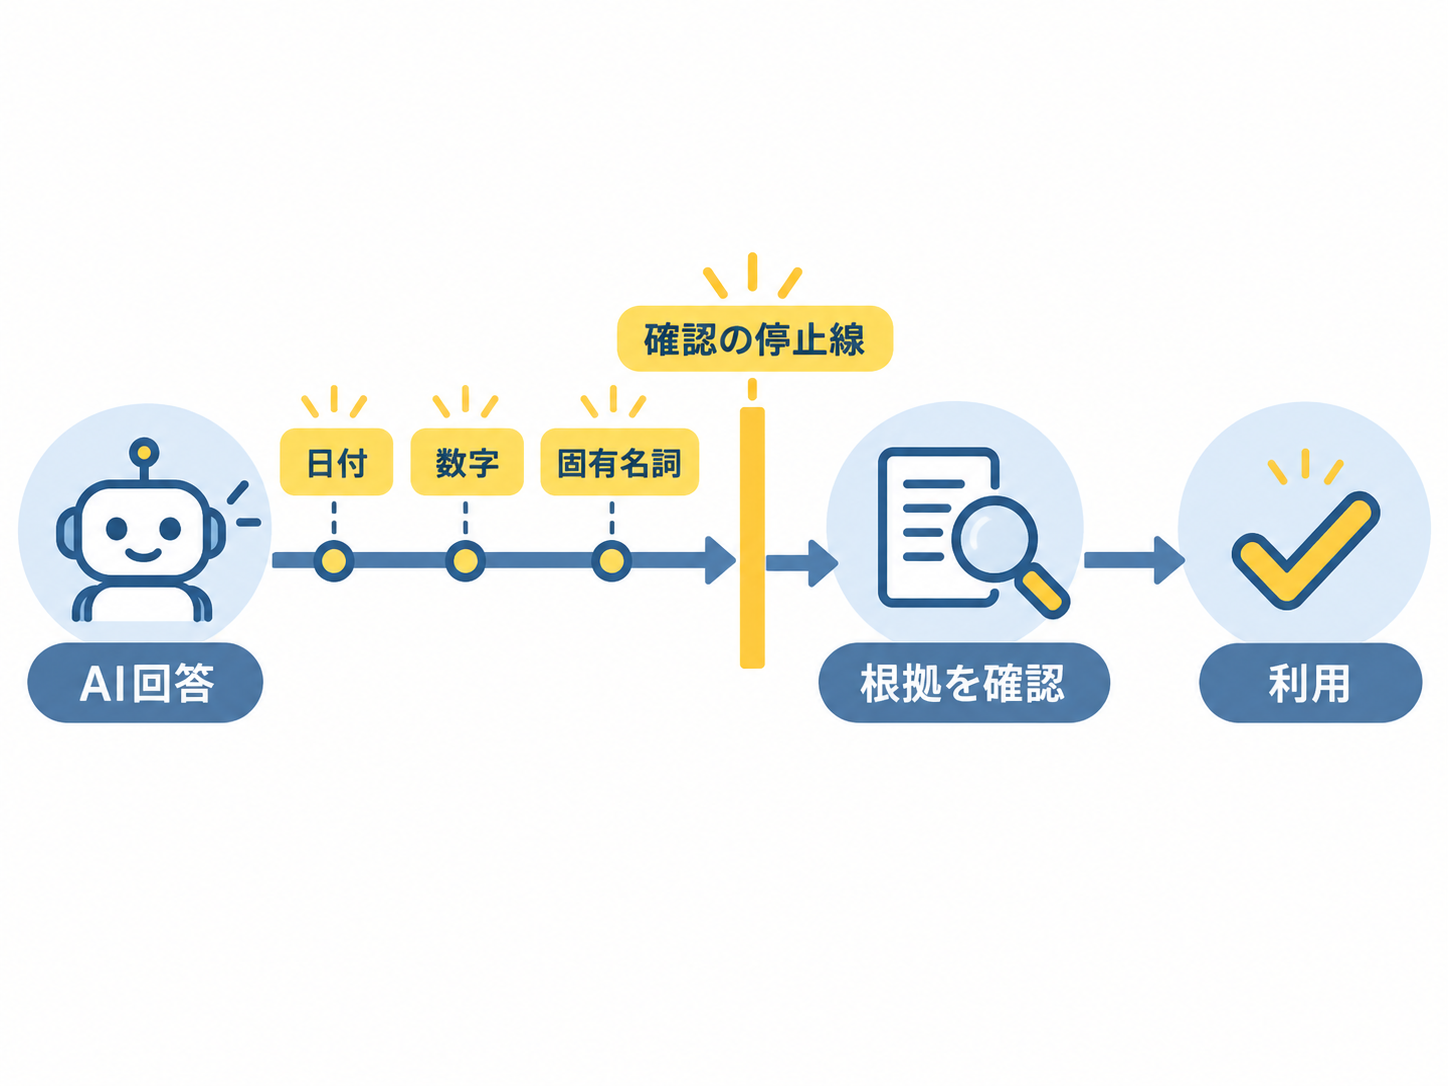
生成AIとの付き合い方を「信じるか、信じないか」の二択にすると、便利さか安全性のどちらかを諦めることになります。実際には、文章を作る段階と、その文章を意思決定に使う段階の間に確認の停止線を置けばよいのです。言い回しの候補や構成案はすぐに利用し、日付、数字、固有名詞を含む主張は根拠を確認するまで外部へ出さない、という分け方ができます。
明日から試せる一歩は、AIの回答を読んだときに、色や記号で「文章案」と「事実主張」を分けることです。事実主張の中から、誤ると困る項目を三つだけ選び、公式資料と照合します。すべてを調査しようとして続かなくなるより、期限、金額、対象条件など、判断を変える情報から確かめるほうが実行しやすいでしょう。
ハルシネーションは、回答が不自然だから起きる問題ではありません。自然な文章と事実性が別の軸だからこそ起きる問題です。この区別がつけば、生成AIの得意な文章整理を利用しながら、正しさの判断まで任せきりにせずに済みます。
次に生成AIへ質問するときは、回答を受け取って終わりにせず、「この中で、確認しないと仕事の判断が変わる箇所はどこか」と一度立ち止まってください。その短い確認が、もっともらしさと根拠を切り分ける習慣になります。
参考情報
- What Is Artificial Intelligence (AI)?(2024年8月9日公開、2026年10月2日更新、2026年10月31日取得)
- Machine Learning Glossary: Generative AI(2026年10月31日取得)