
2026/10/30
今更聞けないAI知識
生成AIの答えは何点? 「評価」が正解探しだけではない理由
読みやすい回答が「良い回答」とは限らない
生成AIに取引先向けのメールを作ってもらったとします。一つは言葉遣いが丁寧で、文章の流れも滑らかですが、打ち合わせの日付を間違えています。もう一つは少し素っ気ないものの、日付や場所は正確です。どちらを良い回答と呼ぶべきでしょうか。実際に送るメールなら、読みやすさだけでなく事実の正しさが欠かせません。下書きのアイデアが欲しいだけなら、表現の豊かさを優先する場合もあるでしょう。
一言で答えると、生成AIの「評価」とは、回答が利用目的に合っているかを、決めた物差しで確かめることです。Googleの機械学習用語集でも、評価はモデルの品質を測ったり、異なるモデルを比較したりする過程だと説明されています(出典: Google for Developers)。難しそうな言葉ですが、日常の買い物で価格、使いやすさ、耐久性を見比べることと大きくは変わりません。
ここで大切なのは、文章が自然に見えることと、内容が正しいことを分けて考える姿勢です。生成AIはもっともらしい形で回答を作れるため、読みやすさだけを基準にすると、誤った日付や存在しない情報を見落とすかもしれません。反対に、企画の発想を広げたい場面で事実確認だけを採点しても、目的に合った判断にはならないでしょう。
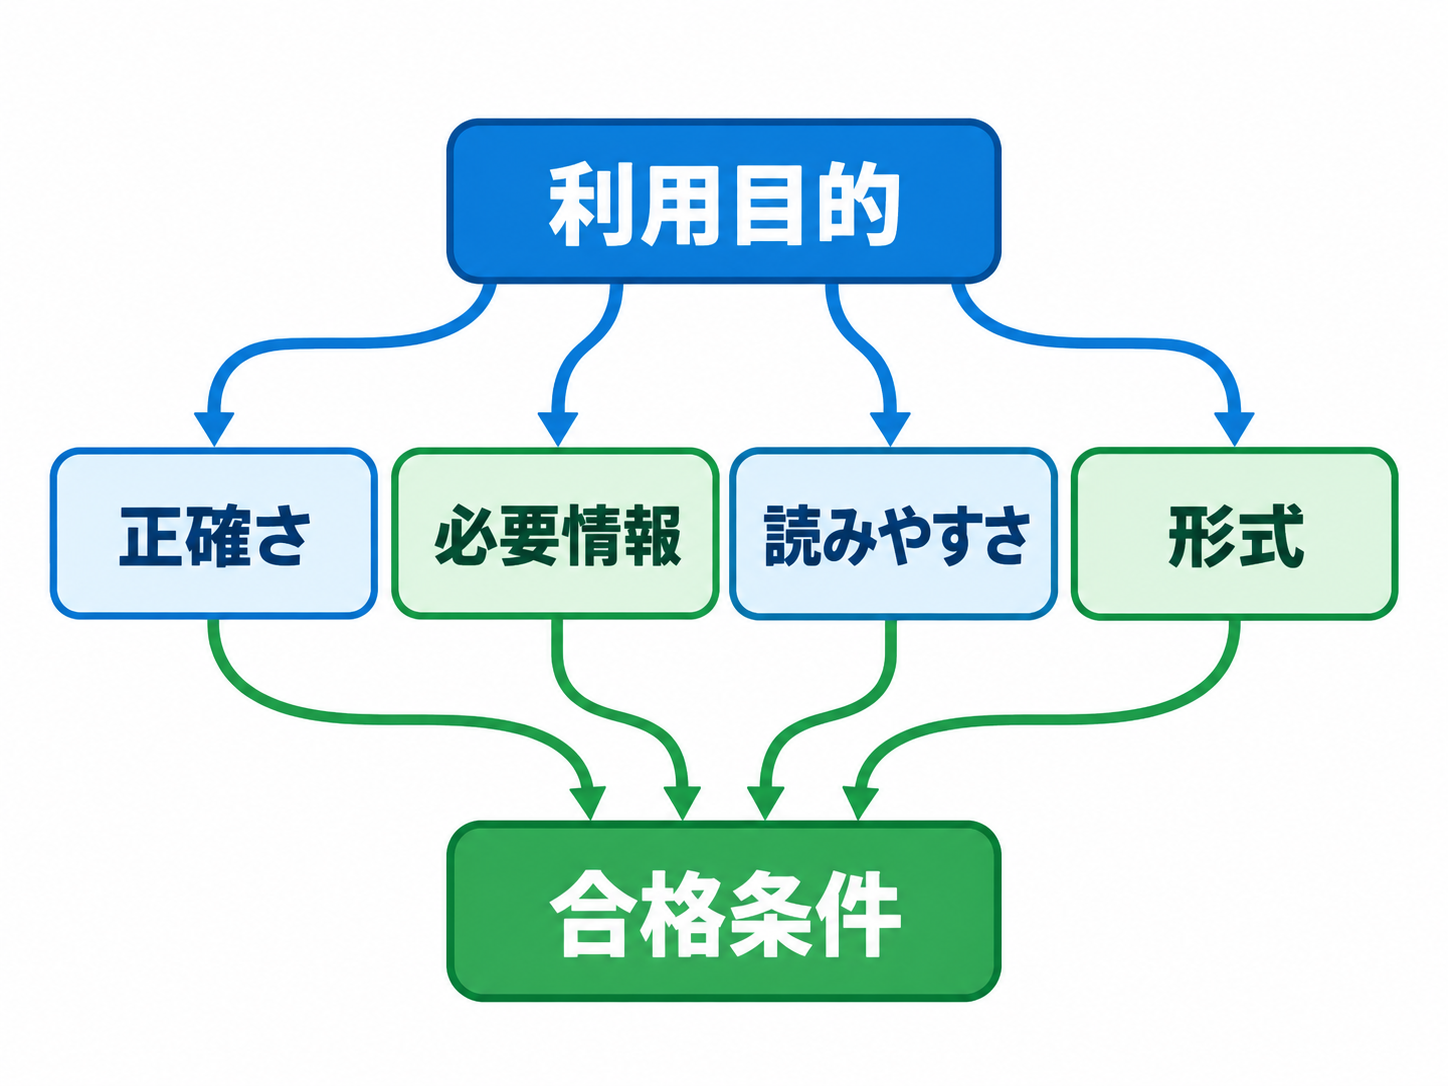
評価はAIに万能の点数を付ける作業ではありません。「この回答を何に使うのか」を決め、その用途で困る間違いを見つける作業です。したがって、良い回答かどうかを考える前に、依頼の目的を一文で言える状態にする必要があります。評価の出発点はAIの性能ではなく、使う側の目的なのです。
回答を見る前に決める採点の物差し
料理を食べてから「おいしかったか」と尋ねるだけでは、味付け、温度、量のどこが良かったのか分かりません。生成AIの回答も同様です。評価する前に、何を満たせば合格なのかを分けておくと、印象だけに引っ張られにくくなります。この確認項目を、ここでは「評価基準」と呼びます。
たとえば、社内会議のメモを要約させる架空の例なら、確認したいのは美しい文章かどうかだけではありません。決定事項が残っているか、担当者と期限を取り違えていないか、メモにない内容を付け加えていないか、指定した長さに収まっているか、といった項目が候補になります。顧客への案内文なら、正確さに加えて、読み手に失礼な表現がないことや、必要な行動が伝わることも見るべきでしょう。
基準は多ければよいわけではありません。項目を増やしすぎると、どれを優先するのか曖昧になります。実務で試すなら、「絶対に間違えてはいけない条件」「できれば満たしたい条件」「好みで選べる条件」の三つに分ける方法が考えられます。日付の正確さは絶対条件、文章の短さは希望条件、言い回しは好みというように整理できます。
採点方法も目的に合わせます。必須情報がすべて含まれていれば合格とする方法もあれば、正確さ、分かりやすさ、表現の適切さを個別に確認する方法もあります。架空の点数を精密に付けるより、「期限を間違えたら不合格」のように判断条件を明文化したほうが扱いやすい場面も少なくありません。
この物差しは、回答を見てから都合よく変更しないことも大切です。先に基準を置けば、流暢な文章を過大評価したり、好みと品質を混同したりするのを防ぎやすくなります。評価とは答えを眺めて感想を述べることではなく、目的と回答の間にずれがないかを確かめる作業だと捉えると分かりやすいでしょう。
正解が一つの課題と一つではない課題
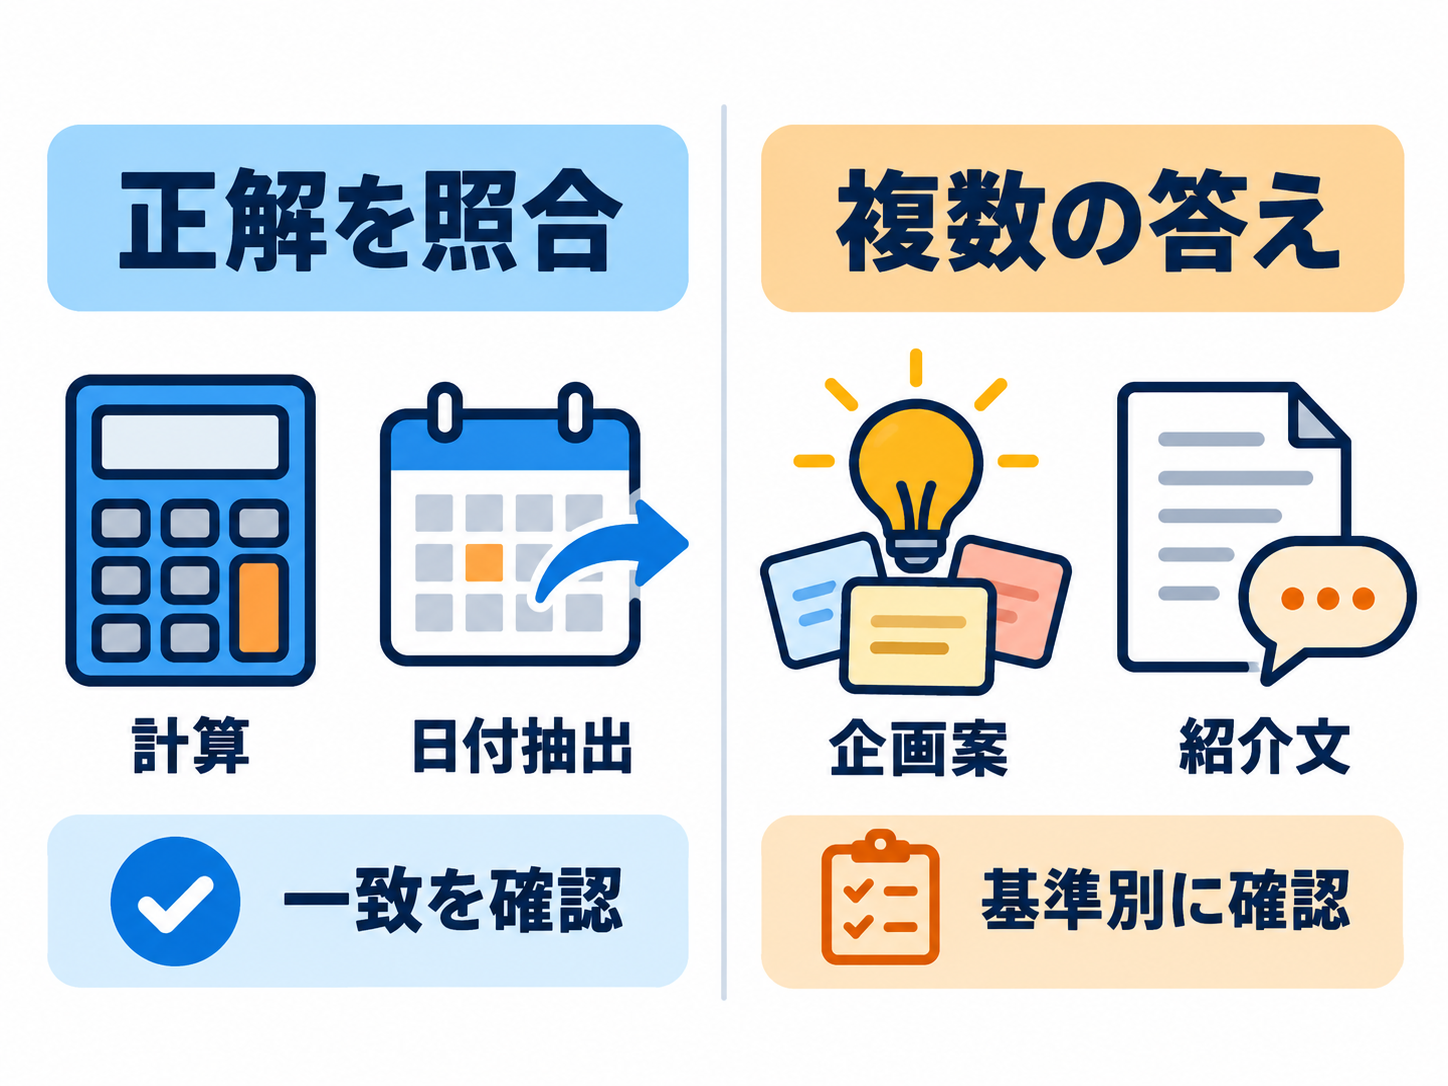
生成AIへの依頼には、答えを機械的に照合しやすいものと、複数の答えが成り立つものがあります。この違いを無視すると、適切な評価ができません。計算問題の答えと、商品の紹介文を同じ方法で採点するのが難しいことを想像すると理解しやすいでしょう。
| 課題の種類 | 架空の依頼例 | 主な確かめ方 |
| --- | --- | --- |
| 正解を照合しやすい課題 | 資料から申込期限を抜き出す | 元資料の日付と一致するか確認する |
| 条件で判定できる課題 | 指定語句を含む見出しを作る | 語句、長さ、形式の条件を確認する |
| 正解が一つではない課題 | 新商品の紹介文を考える | 目的、読み手、正確さ、表現を分けて見る |
| 発想を広げる課題 | 社内イベント案を複数出す | 多様さ、実行条件、重複の少なさを見る |
正解を照合しやすい課題では、模範となる回答と一致しているかを調べられます。Googleの用語集では、検証可能なコード生成や数学問題などについて、成功した出力の数を全出力数で割る「成功率」という評価方法が紹介されています(出典: Google for Developers)。ただし、これは正否を判定できる条件が用意されている場合に向く考え方です。
紹介文や企画案には、唯一の正解がありません。文章Aは簡潔さで優れ、文章Bは親しみやすさで優れることもあります。この場合、一つの総合点だけを付けると、それぞれの長所と弱点が見えなくなるでしょう。事実関係、読み手との相性、伝えるべき内容、表現の独自性などに分けて確認するほうが、採用理由を説明しやすくなります。
正解が一つではないからといって、評価できないわけではありません。「誰に、何を伝え、読んだ後にどうしてほしいか」を決めれば、目的との一致は判断できます。反対に、正解がある課題でも、模範回答そのものが間違っていれば評価は崩れます。答えだけでなく、照合に使う資料や条件も確認対象に含める必要があるのです。
人が読む評価とソフトウェアによる自動評価
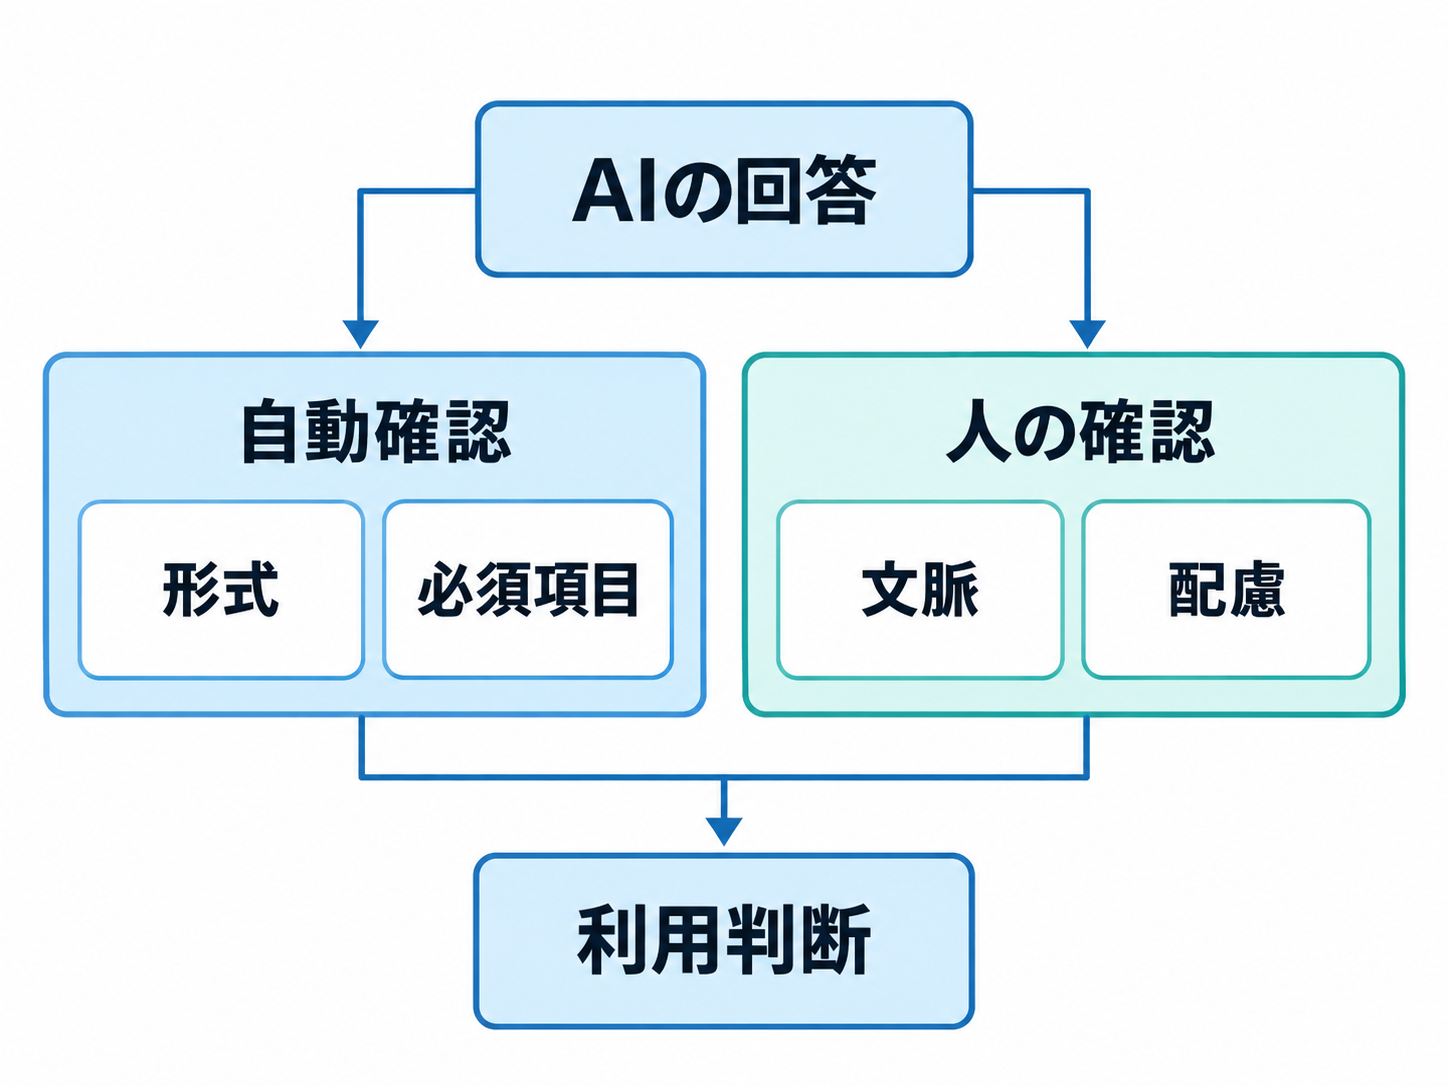
回答を確かめる役割は、人だけが担うとは限りません。条件が明確なら、ソフトウェアで自動的に確認できる部分があります。Googleの用語集では、モデルの出力品質をソフトウェアで判定する方法を自動評価と呼び、単純な出力なら正解例との比較が可能だと説明されています。また、文章の重なりを測る指標としてROUGEやBLEUが役立つ場合もあるとされています(出典: Google for Developers)。
自動評価に向くのは、答えの形式や合格条件がはっきりしている項目です。指定された文字列があるか、必要な項目がそろっているか、決めた形式になっているか、といった確認です。大量の回答を同じ条件で調べたい場面でも扱いやすいでしょう。ただし、言葉が一致しているから意味まで適切とは限りません。違う表現で同じ内容を伝えた回答を、誤りとして扱ってしまう可能性もあります。
人による評価は、文脈や相手への配慮、表現の自然さなどを見やすい方法です。謝罪文が状況に合っているか、企画案が現場の制約を踏まえているかといった判断には、人が持つ背景知識が関わります。その反面、評価者の好みや経験によって判断が揺れることもあるでしょう。基準の説明や回答例を用意し、複数の項目を別々に見る工夫が必要です。
複雑な回答を別の機械学習モデルに判定させる「自動評価器」という考え方もあります。Googleの用語集では、人が評価したデータを使って、人の判断をまねるよう学習させる仕組みとして説明されています(出典: Google for Developers)。便利に見えても、判定する側も機械学習モデルです。その評価を最終的な事実確認の代わりにするのは避けたほうがよいでしょう。
実際には、機械で確認できる条件を先に調べ、意味や重要事項を人が読む組み合わせが考えられます。どちらが優れているかではなく、何を判定するかで役割を分けるのが要点です。
事実性と創造性を同じ点数で測らない考え方
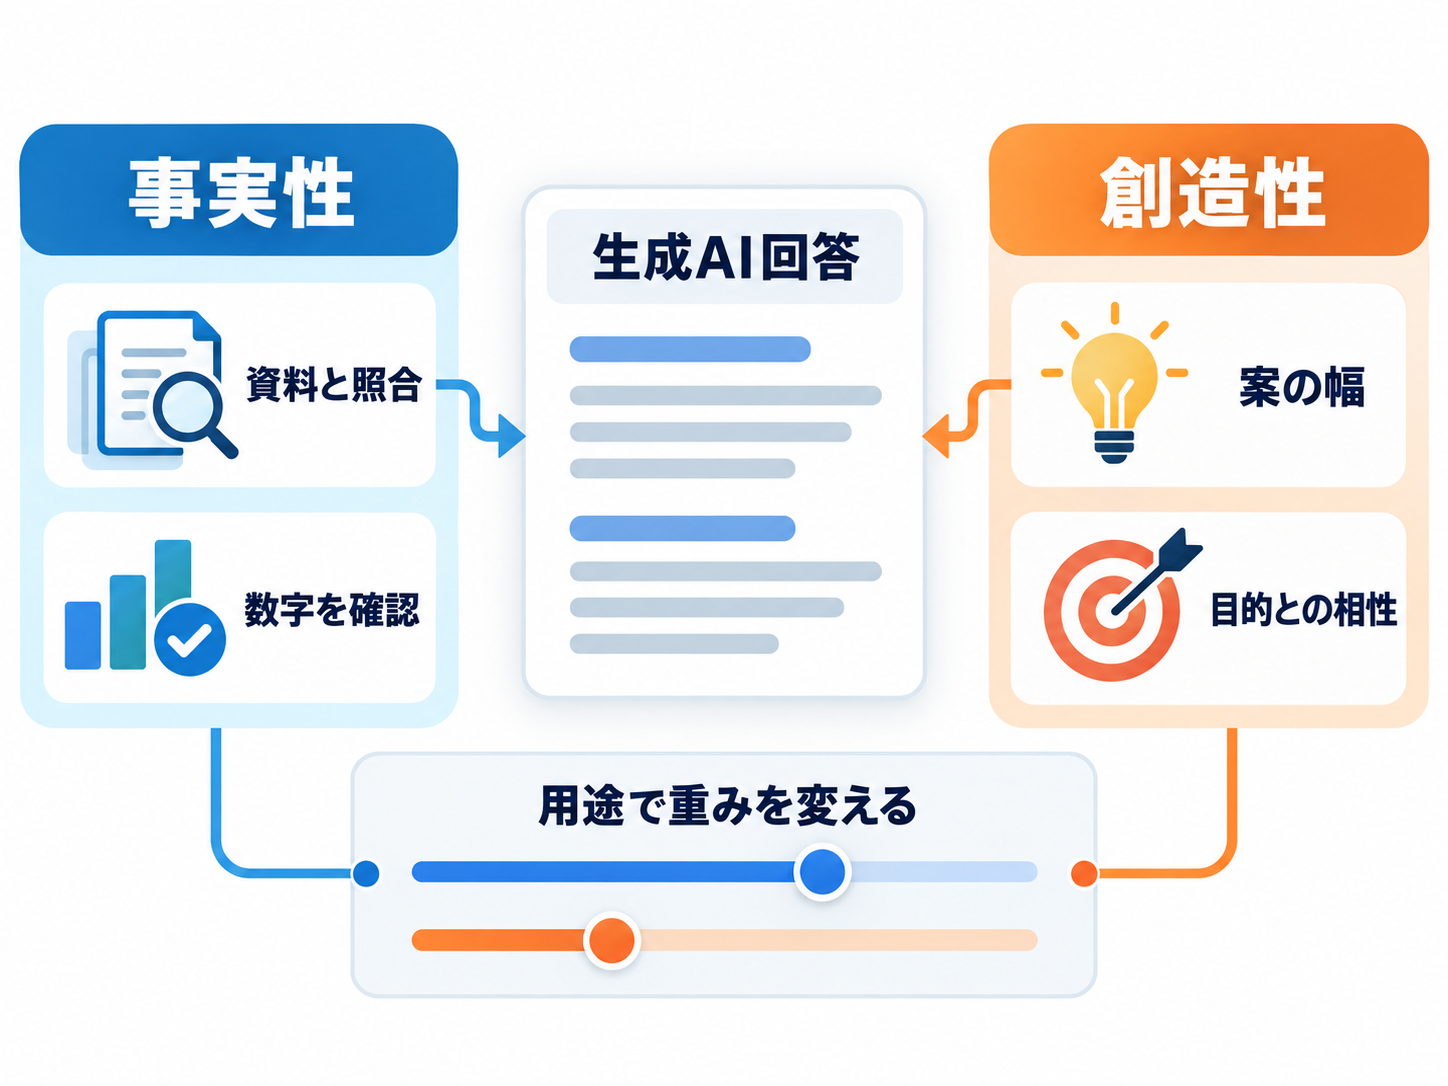
「正しい回答ほど良い」と考えるのは自然ですが、生成AIへの依頼がすべて事実問題とは限りません。Googleの用語集では、事実性は出力が現実に基づいている性質であり、単独の評価指標ではなく概念だと説明されています。また、化学式を答える依頼では事実性が求められる一方、架空の詩を作る依頼では創造性を重視する例が示されています(出典: Google for Developers)。
たとえば、「会議資料に書かれた売上額を抜き出してください」という依頼では、数字を創作してはいけません。元資料との一致が中心の評価になります。「春の店頭企画の案を五つ考えてください」という架空の依頼なら、案の幅や目的との相性も見たいところです。ただし、創造的な案の中に実在する制度や費用が書かれていれば、その部分は別途確認しなければなりません。
つまり、一つの回答の中でも評価軸を分ける必要があります。事実として述べた箇所は資料と照合し、提案として述べた箇所は実行条件や新しさを検討します。「事実」「推測」「提案」を回答内で区別するよう依頼する方法も、初心者が確認しやすくする提案例です。区別が表示されても正しさが保証されるわけではありませんが、どこを調べるべきかは見つけやすくなるでしょう。
創造性を重視するからといって、誤情報を許す必要はありません。反対に、事実性を重視する場面で、表現の面白さまで一律に否定する必要もないでしょう。目的ごとに優先順位を変えることが大切です。社外へ公表する文章なら事実確認を先に置き、個人で使う発想メモなら案の幅を先に見る、といった違いが考えられます。
「事実性か創造性か」の二者択一ではなく、回答のどの部分にどちらを求めるかを決めるのが現実的です。同じ物差しですべてを測ろうとしないことが、評価を分かりやすくします。
明日から試せる小さな評価手順
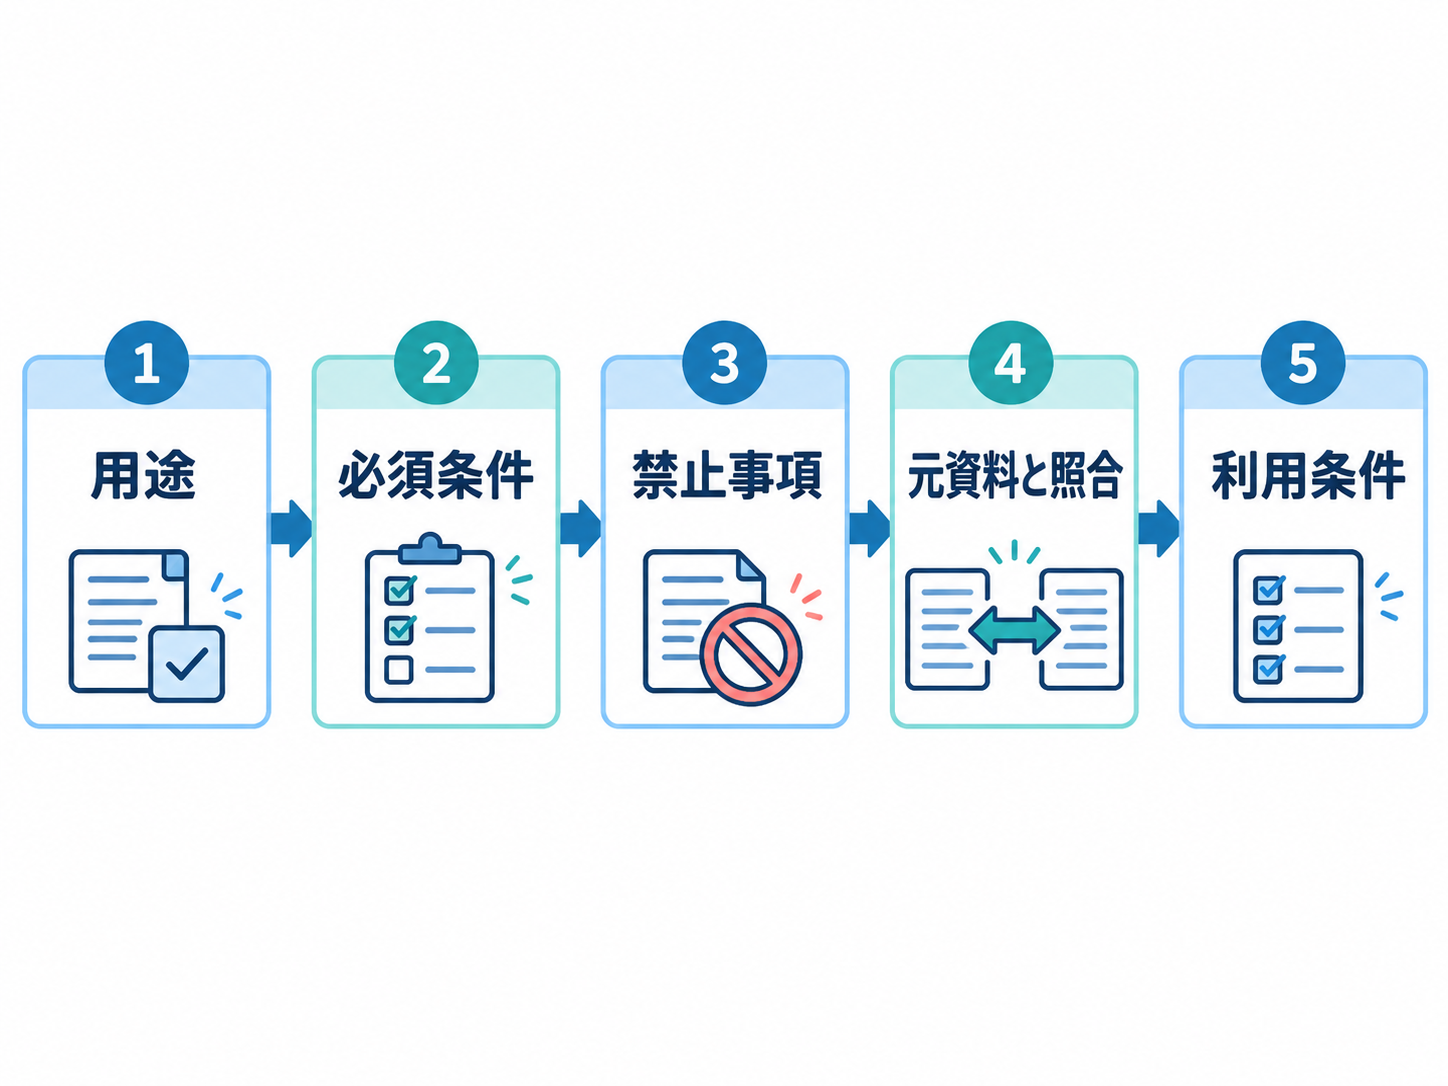
専門的な評価環境がなくても、普段の利用でできる確認はあります。最初から多数の回答を採点する必要はありません。よく使う依頼を一つ選び、困る間違いを先に書き出すところから始められます。以下は、会議メモの要約を依頼する場合の提案例です。
1. 用途を一文にします。「欠席者が決定事項と自分の担当を確認するため」のように、読む人と目的を決めます。
2. 必須条件を三つ程度選びます。たとえば、決定事項、担当者、期限を落とさないことです。
3. 禁止事項を決めます。メモにない予定を補わない、不明な担当者を推測しない、といった条件が候補になります。
4. 回答と元のメモを並べ、項目ごとに確認します。文章全体の印象だけで合否を決めません。
5. 見つけた問題を次の依頼に反映します。「担当者が不明な場合は不明と書いてください」のように、具体的に伝えます。
入力文の提案例は、「次の会議メモを、決定事項、担当者、期限に分けて整理してください。メモに書かれていない内容は補わず、不明な項目は不明と記載してください」です。これは正解を保証する呪文ではありません。評価しやすい出力の形を指定し、確認箇所を見つけやすくするための依頼です。
試す題材には、内容を自分で確かめられる短い文書が向いています。自分が正解を知らない専門分野では、回答が自然でも誤りを発見できません。重要な判断に使う場合は、元資料や詳しい担当者による確認が必要でしょう。個人情報や社外秘情報の扱いについても、所属先のルールを先に確認しなければなりません。
一度の回答だけでAI全体の能力を決めつけないことも大切です。ここでの小さな評価は、統計的に性能を証明する試験ではなく、自分の用途でどこに注意すべきかを知るための確認です。評価結果を「使える」「使えない」の二択にせず、「下書きには使えるが、日付は照合する」のように利用条件へ変換すると、次の行動につなげやすくなります。
よくある誤解をほどき、利用条件を決める視点
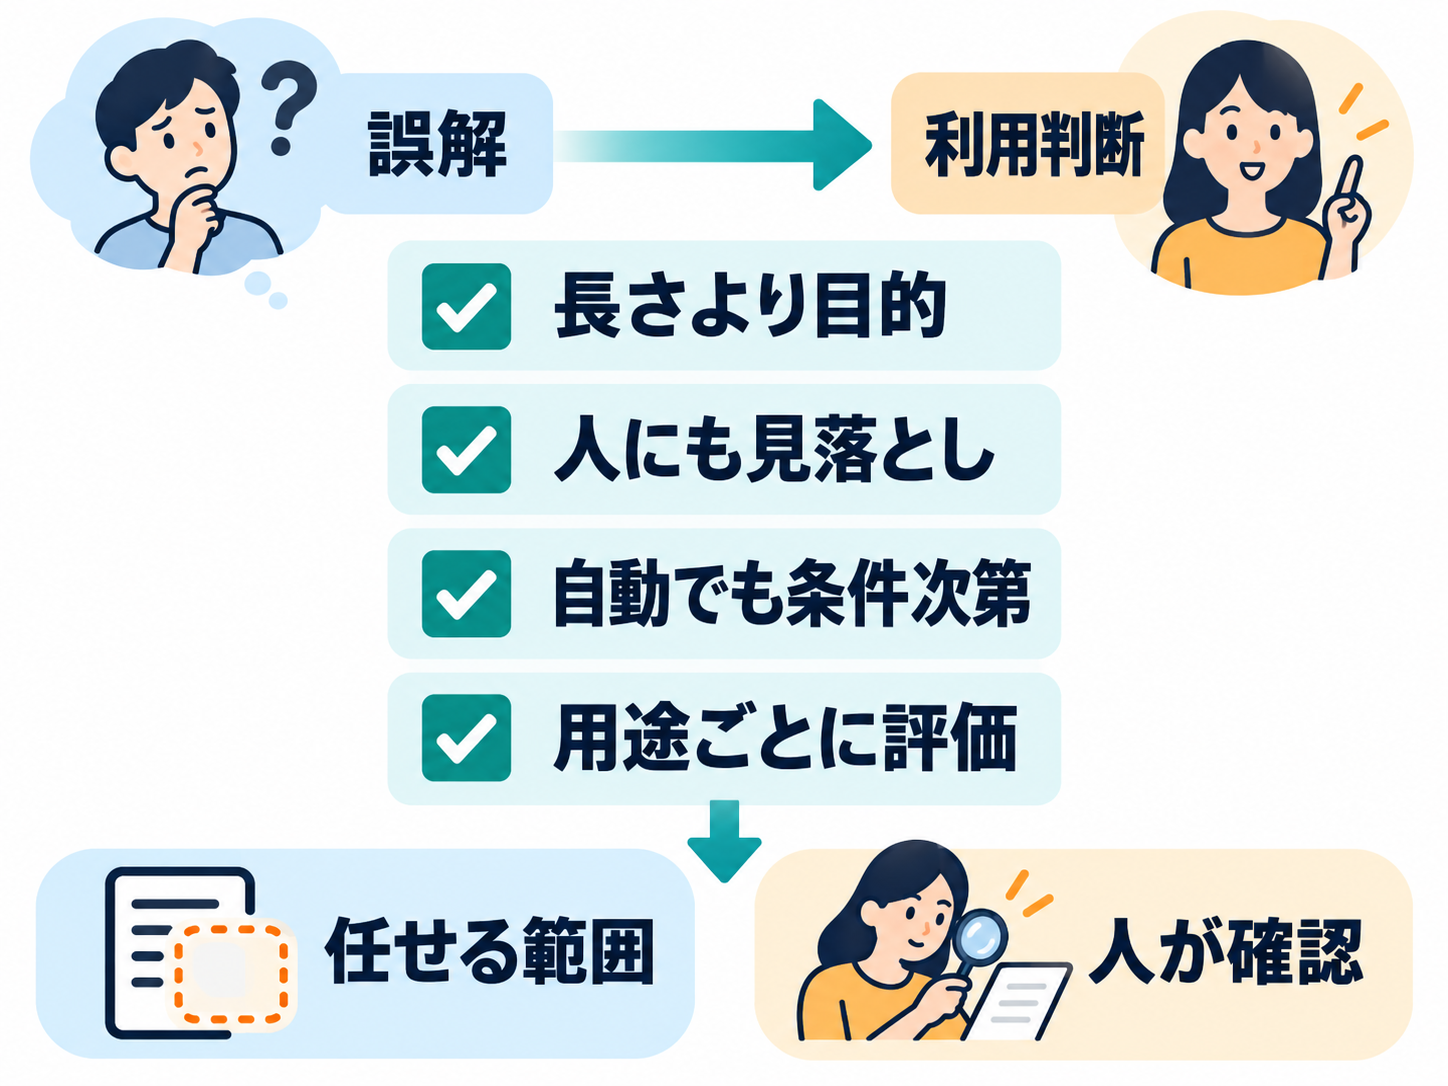
よくある誤解の一つは、「詳しく長い回答ほど質が高い」という見方です。必要な情報が埋もれていれば、長さは利点になりません。短い回答でも目的を満たすことがあります。文字数ではなく、必要事項が見つかるか、不要な断定がないかを確かめるほうが実用的でしょう。
「人が評価すれば正しい」という思い込みにも注意が必要です。人は文脈を読めますが、好みや見落としもあります。評価基準を先に決め、事実確認と表現の好みを別項目にすれば、判断理由を共有しやすくなります。逆に、自動評価なら中立とは限りません。判定条件を選ぶのは人であり、自動評価器も人の評価データから判断を学ぶ仕組みとして説明されています(出典: Google for Developers)。
もう一つの誤解は、高い評価を得た回答やモデルなら、別の仕事でもそのまま優れているという考え方です。正解を照合する問題で良い結果を出しても、顧客向け文章の配慮まで確認できたことにはなりません。評価結果には、「何を」「どの条件で」「誰が」確かめたのかを添える必要があります。物差しの違う点数を、そのまま横に並べない姿勢が求められます。
評価は導入前に一度行えば終わるものでもありません。IBMの解説では、生成AIの流れに生成、評価、追加調整が含まれ、開発者や利用者が出力を継続的に評価するとされています(出典: IBM)。日常利用でも、依頼内容や元資料が変われば、確認すべき点は変化するでしょう。過去に問題がなかったことだけを根拠に、今回の回答を無確認で使うのは避けたいところです。
明日からの一歩は、よく使う依頼を一つ選び、「絶対に間違えてほしくないこと」を三つ書くことです。その三項目を回答の横に置けば、評価は漠然とした感想ではなくなります。AIに何点を付けるかより、どこまで任せ、どこを人が確かめるかを決めること。それが、評価を実際の利用判断へつなげる見方です。