
2026/10/30
今更聞けないAI知識
教師あり学習は何を学ぶ?「正解付き問題集」から未知の答えを予測する仕組み
写真を仕分けるAIは、答えを丸暗記しているのか
スマートフォンに写った動物を「犬」「猫」と分けたり、届いたメールを「迷惑メールの可能性あり」と判定したりする仕組みを見て、「AIはどこで正解を教わったのだろう」と疑問に思ったことはないでしょうか。こうした分類や予測に使われる代表的な方法が、教師あり学習です。
一言で表すと、教師あり学習とは、入力データと正解ラベルを組み合わせた例から両者の関係を学び、まだ見ていない入力の答えを予測する機械学習の方法です。IBMは、教師あり学習について、人がそれぞれの訓練例に出力ラベルを対応させ、モデルが入力と出力の対応関係を学ぶ手法だと説明しています(出典: IBM)。
ここでいう「教師」は、教室にいる人を指すわけではありません。学習に使うデータへ正解が付いていることを表す言葉です。また、AIが問題の意味を人間のように理解し、意識的に答えを選んでいるという説明でもありません。データの中に繰り返し現れる特徴と正解との関係を、計算によって扱える形にしたものと捉えるとよいでしょう。
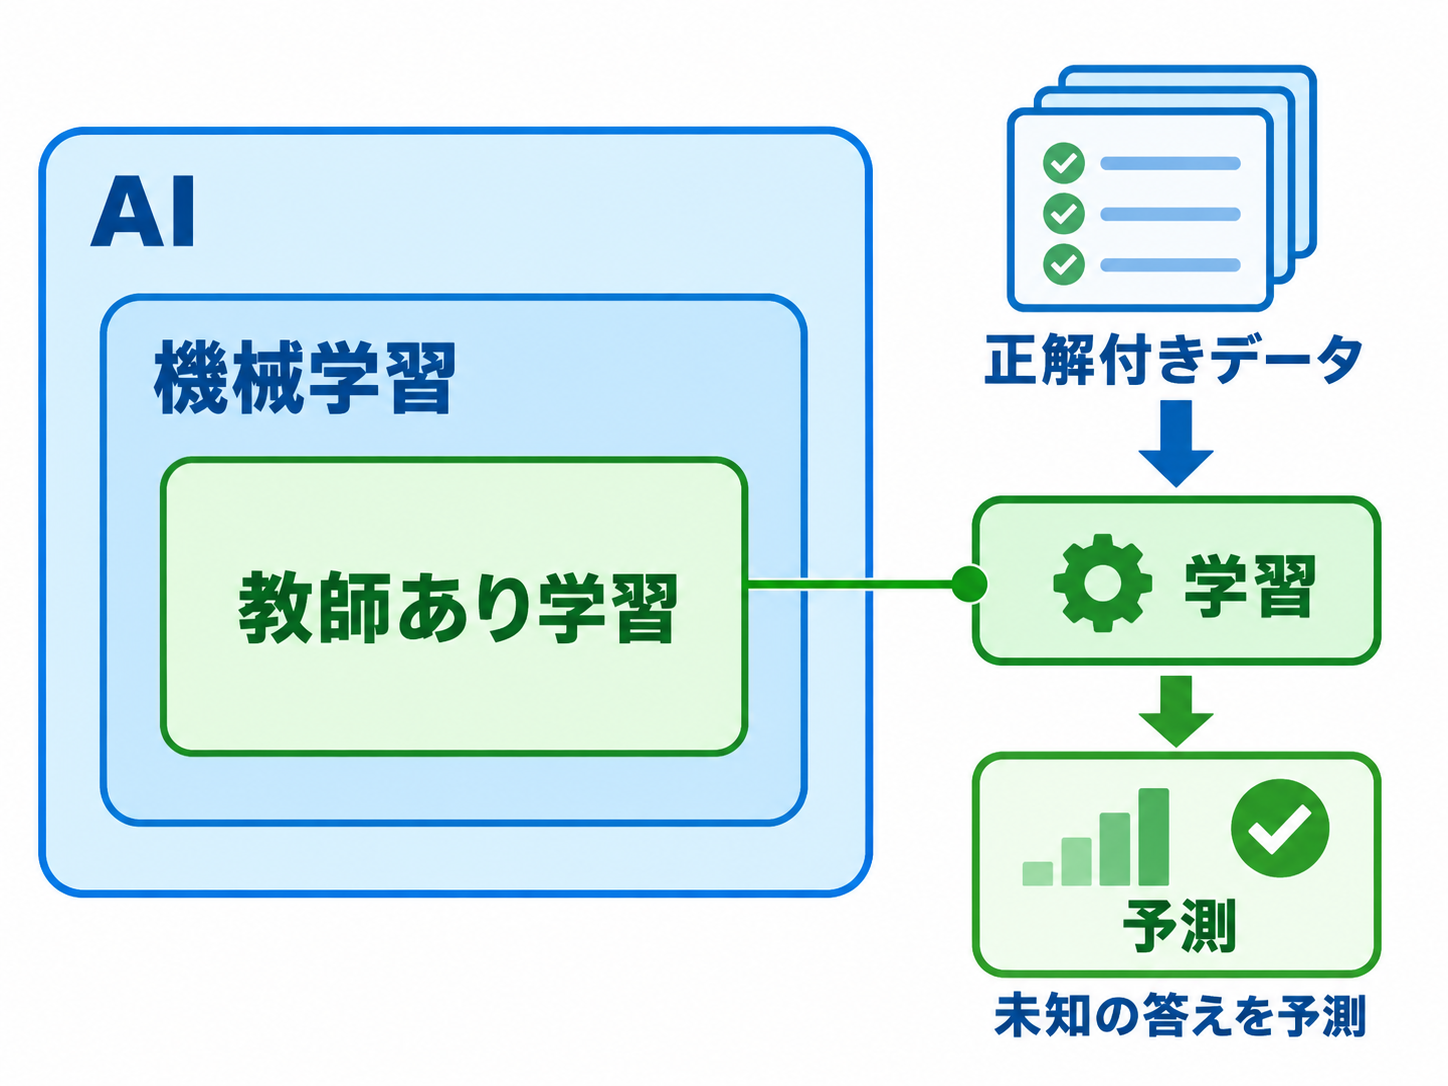
AIは広い概念であり、その中に、データからパターンを学ぶ機械学習があります。教師あり学習は、その機械学習に含まれる一つの方法です。Google Cloudも、AIを機械が知覚・推論・行動などを行えるようにする広い概念、機械学習をデータから知識を取り出して特定の課題に取り組む方法と整理しています(出典: Google Cloud)。つまり、教師あり学習を知ることは、AI全体を一度に理解することではなく、「データを使って予測する部分」の基本をつかむことなのです。
「正解付き問題集」で考える入力とラベル
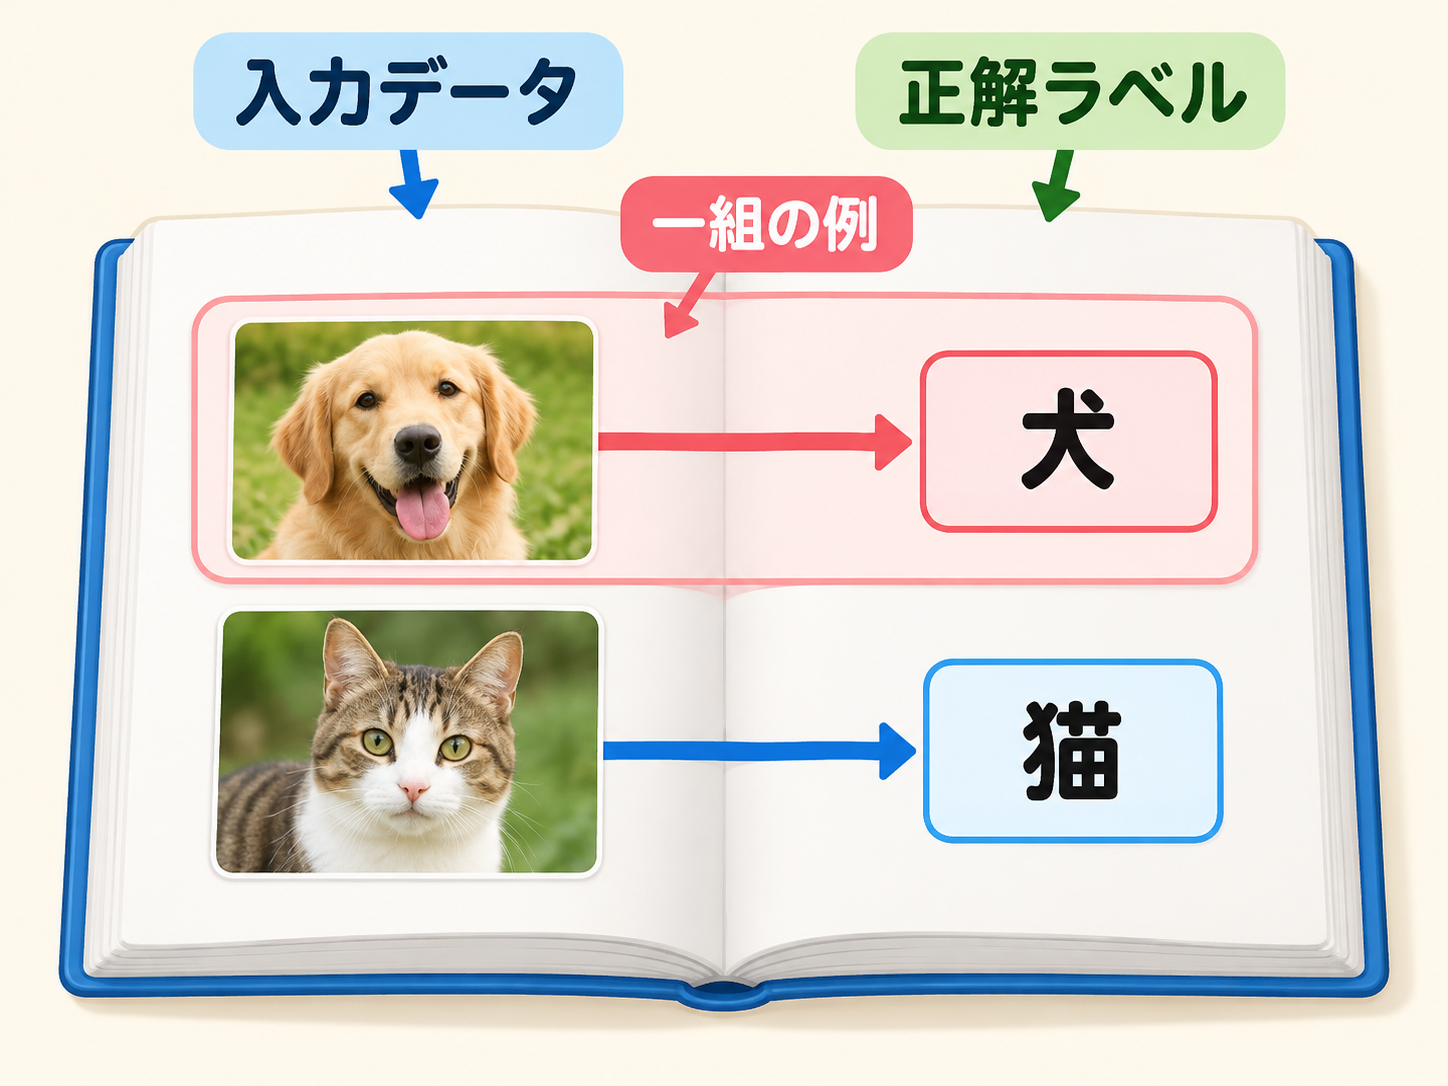
教師あり学習は、解答欄が埋まった問題集にたとえるとイメージしやすくなります。問題に当たるものが「入力データ」、解答に当たるものが「正解ラベル」です。猫の写真に「猫」、犬の写真に「犬」という札を付けて複数の例を示すと、学習の材料になります。
入力データは、必ずしも写真とは限りません。商品の情報、文章、測定値など、課題に応じたデータが入力になり得ます。ラベルも名称だけではなく、数値の場合があります。たとえば、架空の住宅データを使うなら、「広さや築年数」が入力、「価格」が正解に相当します。以下は仕組みを理解するための架空の例であり、特定の製品やサービスの実例ではありません。
| 架空の課題 | 入力データ | 正解ラベル |
| --- | --- | --- |
| 動物の分類 | 動物の写真 | 犬または猫 |
| 問い合わせの振り分け | 問い合わせ文 | 配送、返品、商品質問 |
| 価格の予測 | 広さ、築年数、立地など | 実際の価格 |
大切なのは、入力とラベルが一組になっている点です。写真だけを大量に集めても、「何を正解として学ばせたいのか」が示されていなければ、教師あり学習用の問題集にはなりません。反対に、ラベルだけが並んでいても、何を手掛かりに答えるのか分からないため学習材料として成立しません。
学校の問題集との違いもあります。人は一つの解説から考え方を理解し、別の状況に応用できる場合がありますが、機械学習では、用意されたデータに現れる関係が学習の土台になります。ラベルはAIへ意味を語りかける言葉ではなく、入力に対してどの出力を目指すかを示す信号です。この区別が分かると、「AIに正解を教える」という表現を、意思や理解の受け渡しではなく、入力と出力の対応例を与える工程として読めるようになります。
問題集からモデルができ、未知の入力を予測するまで
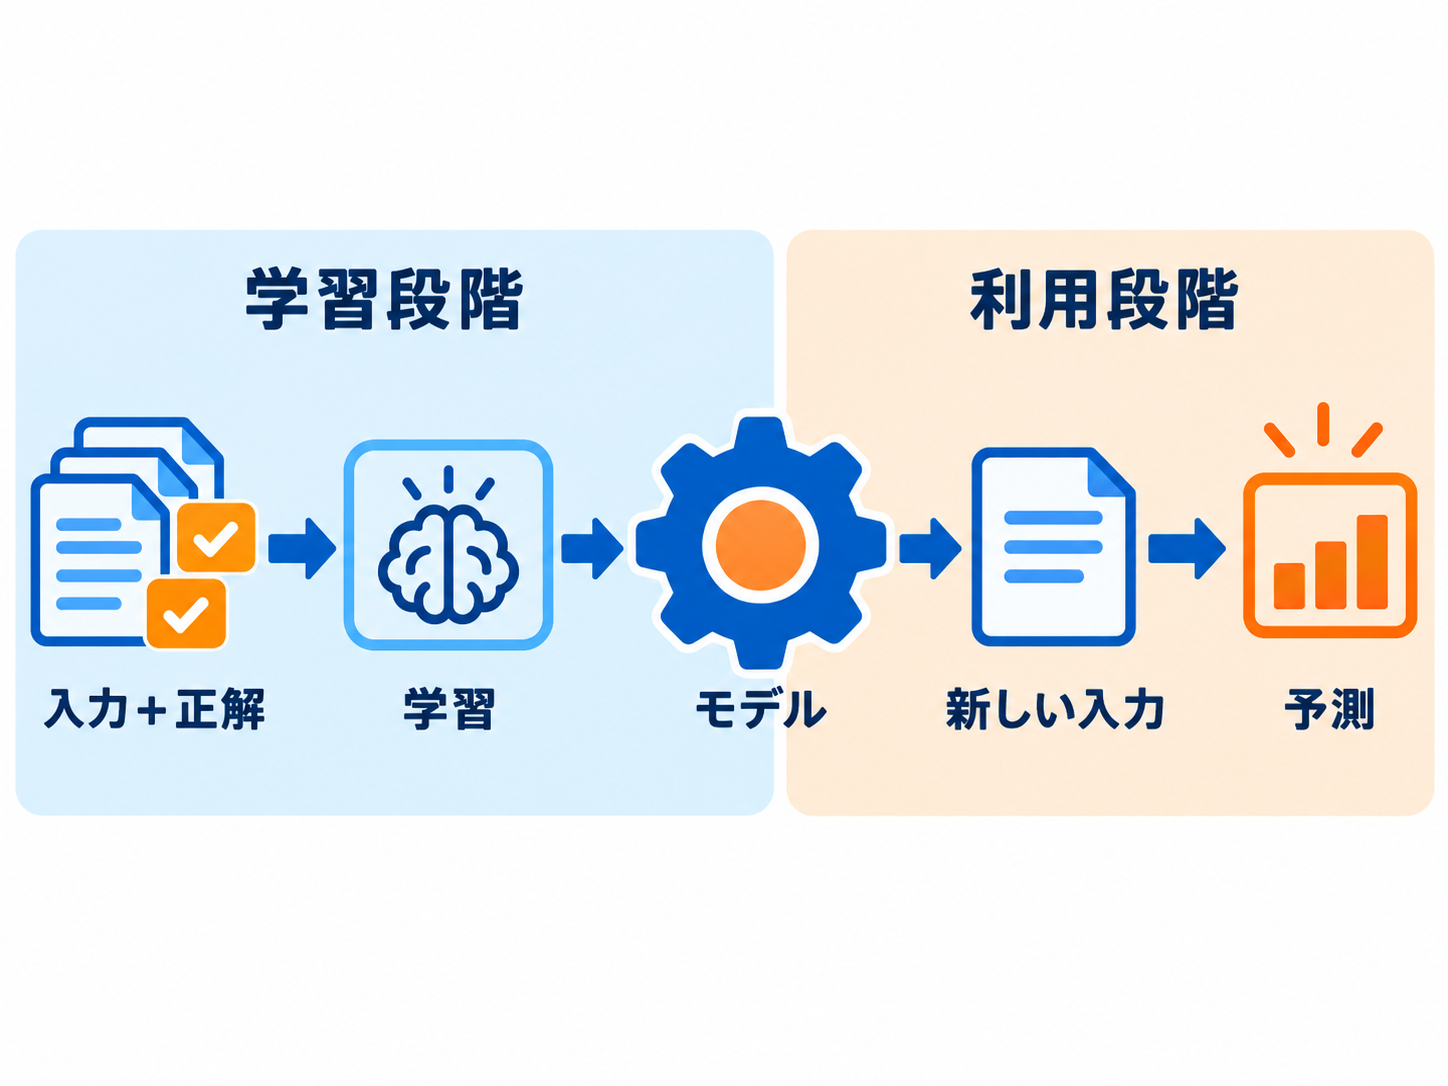
教師あり学習には、「学習する段階」と「学習後に答えを出す段階」があります。両者を同じ出来事として考えると、「過去の答えを保存して取り出しているだけ」という誤解が生まれやすくなります。実際の中心は、個々の例をそのまま並べることではなく、入力と正解の間にある対応関係をモデルへ反映することです。
Google Cloudは、機械学習モデルを、アルゴリズムを訓練データに適用して得られるものと説明しています(出典: Google Cloud)。モデルとは、学習で見つけた関係を使い、新しい入力に対する出力を計算するための仕組みです。初心者向けには、「解答済みの問題集から作った判断の型」と捉えると分かりやすいでしょう。ただし、人が法則を文章で理解している状態と同じではありません。
架空の果物仕分けを例にすると、学習時には色や形などを含むデータと、「りんご」「みかん」という正解ラベルの組を用意します。学習用の計算を通じてモデルが作られた後、正解ラベルの付いていない新しい果物のデータを入力します。モデルは学習済みの関係に照らして、「りんごらしい」「みかんらしい」と予測します。IBMも、教師あり学習の目的を、訓練データで入力と出力の対応を学び、まだ見ていないデータのラベルを予測することだと説明しています(出典: IBM)。
この「まだ見ていない例へ答える」という点が、単なる答え一覧との違いです。新しい入力が学習例と完全に同じでなくても、学んだ関係を利用して予測を試みます。ただし、「未知の入力にも対応する」と「未知の入力を必ず正しく判定する」は同じ意味ではありません。学習時にほとんど見なかった特徴を持つ例や、そもそも境界が曖昧な例では、誤った予測も起こり得ます。モデルは万能な正解帳ではなく、与えられた例を手掛かりに新しい答えを推定する仕組みなのです。
分類と数値予測で変わる「正解」の形
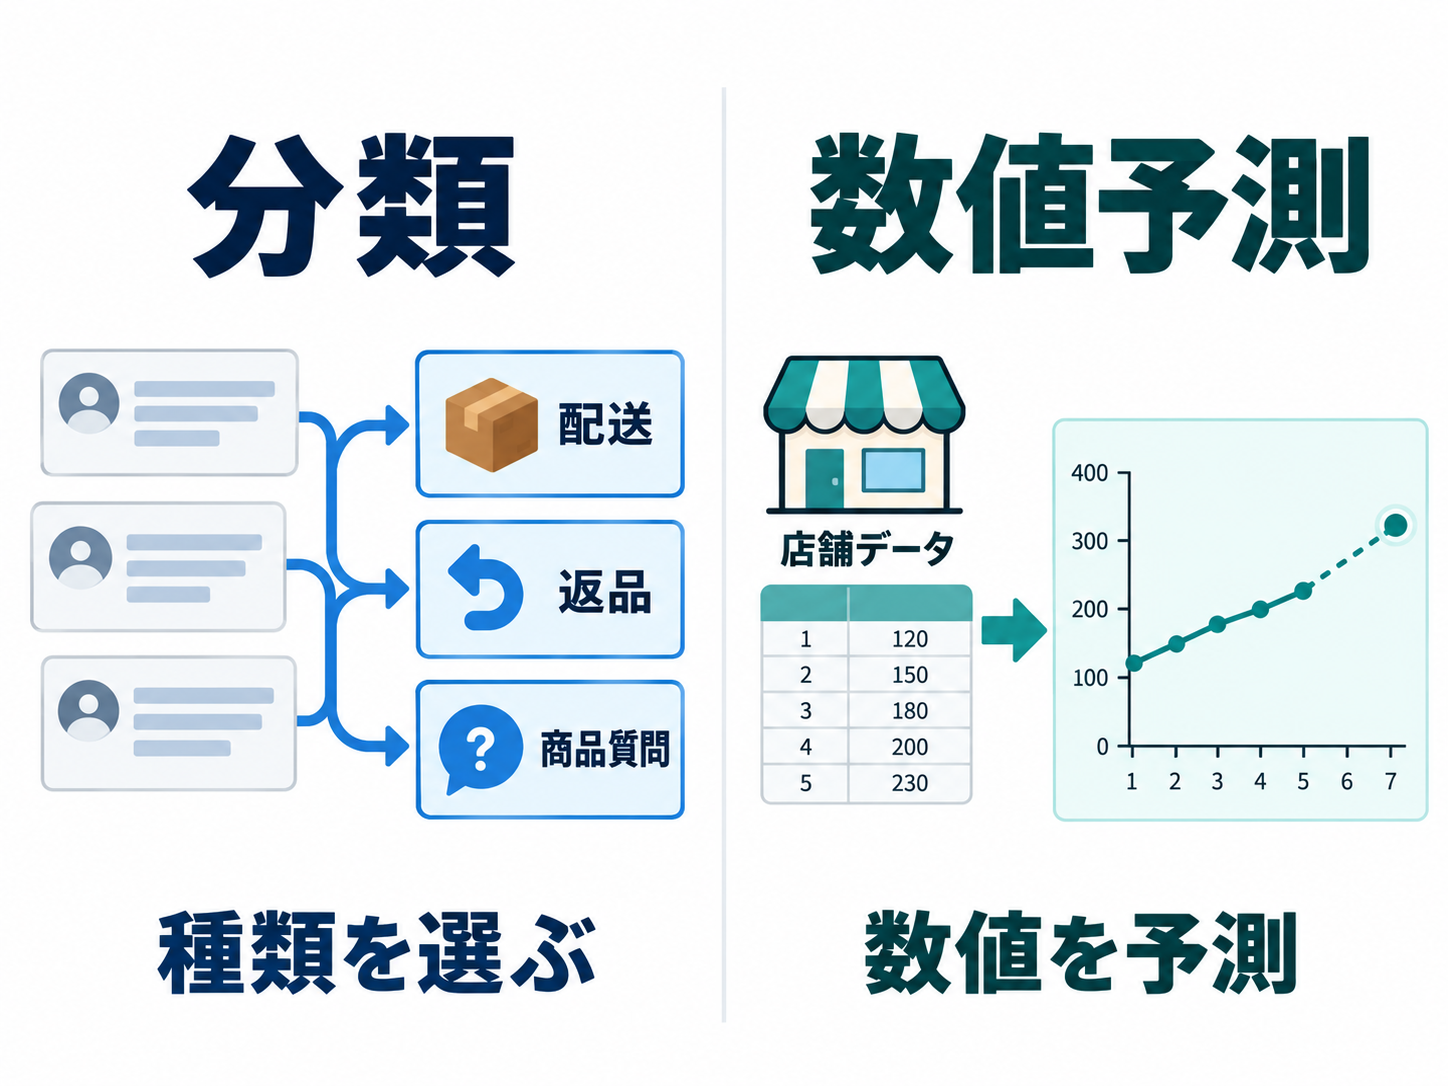
教師あり学習が扱う課題は、大きく見ると「どの種類に当たるかを選ぶ課題」と「数値を予測する課題」に分けて考えられます。前者は分類、後者は回帰と呼ばれます。IBMの資料でも、ラベル付きデータを使い、データの分類や結果の予測を行う方法として教師あり学習が説明されています(出典: IBM)。
分類では、出力の候補がカテゴリーとして用意されます。架空の社内窓口を例にすれば、問い合わせ文を「パソコン」「設備」「人事制度」のいずれかへ振り分ける課題が考えられます。この場合、過去の問い合わせ文が入力で、担当分野が正解ラベルです。実際の導入効果を示す例ではなく、入力とラベルの関係を説明するための提案です。
回帰では、正解が連続した数値になります。架空の店舗で、曜日、天候、過去の来客数などを入力とし、翌日の来客数を予測対象にする、といった問題設定が考えられます。答えは「多い」「少ない」という種類ではなく、数値です。ただし、何を入力すれば適切か、将来の状況が過去とどの程度似ているかによって予測の扱いは変わります。
| 見分ける観点 | 分類 | 回帰 |
| --- | --- | --- |
| 答えの形 | 種類や区分 | 連続した数値 |
| 架空の例 | 問い合わせの担当分野 | 翌日の来客数 |
| 確認したい点 | 区分を正しく選べたか | 予測値が実際の値にどの程度近いか |
日常で「AIが予測する」と聞いたら、何を予測しているのかを一段具体的に見ることが役立ちます。カテゴリーを選ぶのか、数値を出すのかによって、正解ラベルの作り方も評価の考え方も異なるからです。「AIを使っています」という説明だけでは、教師あり学習かどうかも、どのような答えを出す仕組みかも分かりません。入力と正解の形を尋ねれば、曖昧な宣伝文句から一歩離れ、仕組みを具体的に捉えられるでしょう。
正解データを用意しても、必ず正しくならない理由
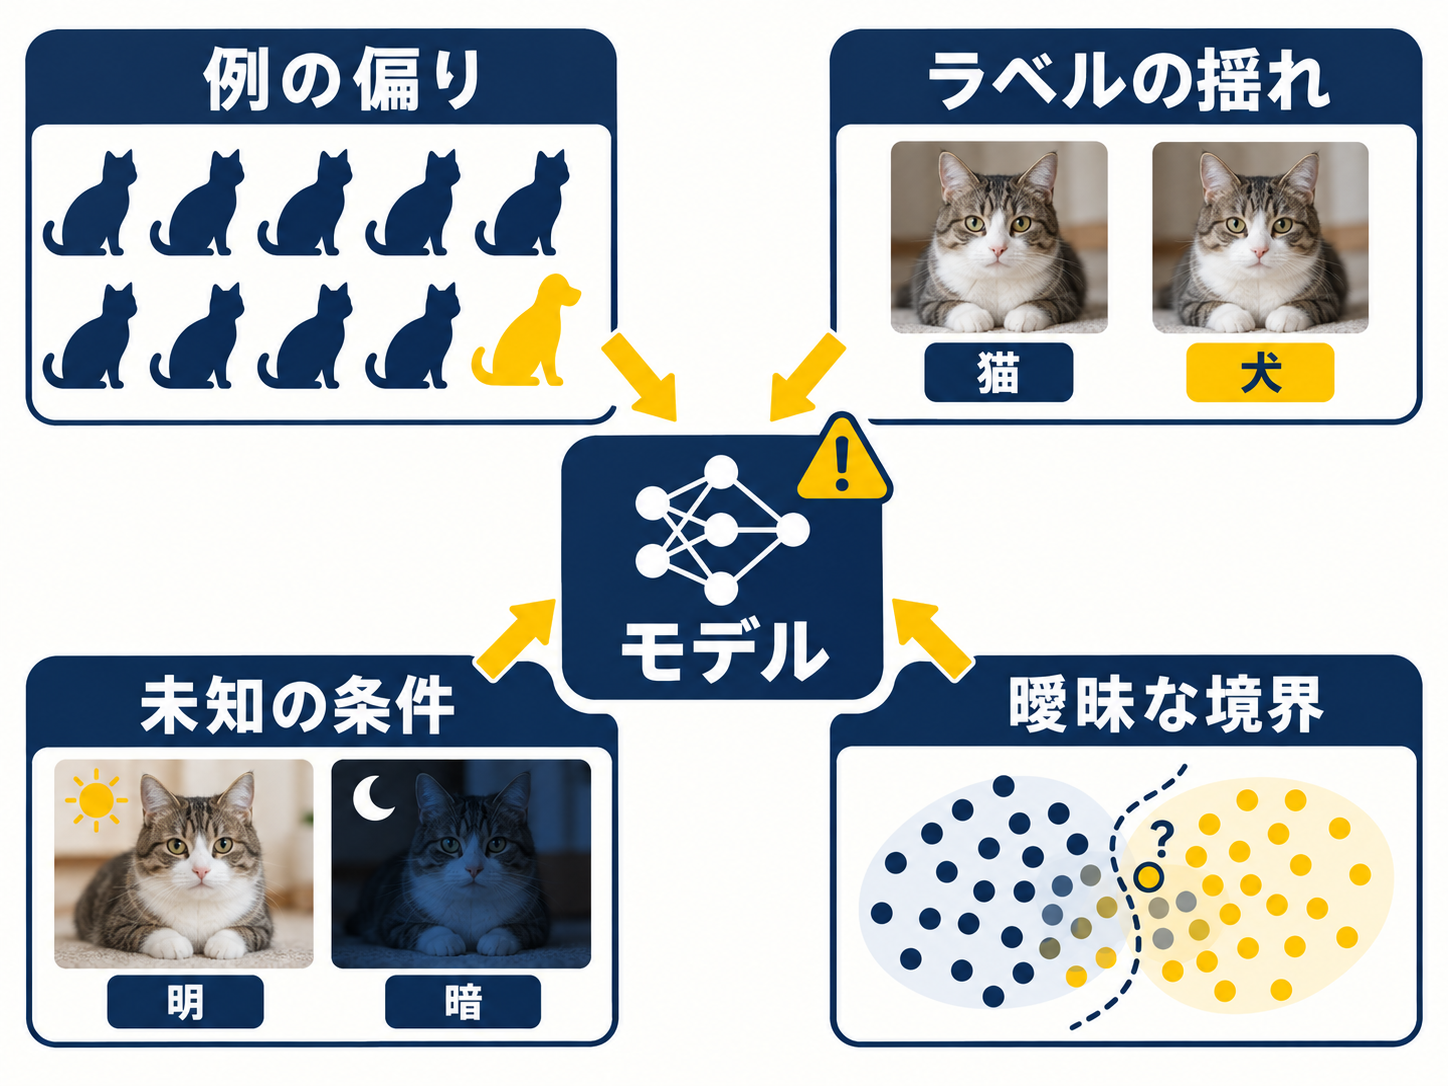
「正解付きのデータで学ぶなら、答えを間違えないのでは」と感じるかもしれません。しかし、教師あり学習に正解ラベルが必要であることと、完成したモデルがすべての新しい入力へ正解できることは別の話です。学習に使う問題集が、現実に起こるあらゆるケースを含んでいるとは限らないためです。
たとえば、明るい場所で撮影した犬と猫の写真だけを集めた架空の問題集を考えてみましょう。そのデータで作ったモデルに、暗い場所や普段と異なる角度から撮った写真を入力すると、学習時に十分な手掛かりがなかった可能性があります。また、ラベルの付け方が一貫していなければ、どの関係を目指すべきかも曖昧になります。これは特定の画像判定サービスを検証した結果ではなく、学習例と未知の入力の違いを理解するための例示です。
モデルの品質を確かめる際には、学習に使った例への正答だけを見るのでは不十分です。Googleの機械学習用語集では、教師あり学習モデルの評価に、検証用データとテスト用データを用いるのが一般的だと説明しています(出典: Google for Developers)。問題集を解き終えた後、答えを見ていない別の問題で力を確かめるイメージに近いでしょう。
「データが多ければ必ず安心」とも限りません。数だけを見る前に、予測したい場面に近い例が含まれているか、正解ラベルの基準がそろっているか、見落としている条件がないかを確認する必要があります。さらに、現実の出来事には、そもそも正解を一つに決めにくい課題もあります。モデルが出した結果は、学習データを基にした予測であり、事実そのものや人間の最終判断と自動的に一致するわけではありません。教師あり学習の説明を読むときは、精度を保証する言葉としてではなく、どのように答えの型を学ばせたかを示す言葉として受け取るのが適切です。
チャットへの指示と教師あり学習の「正解」は別物
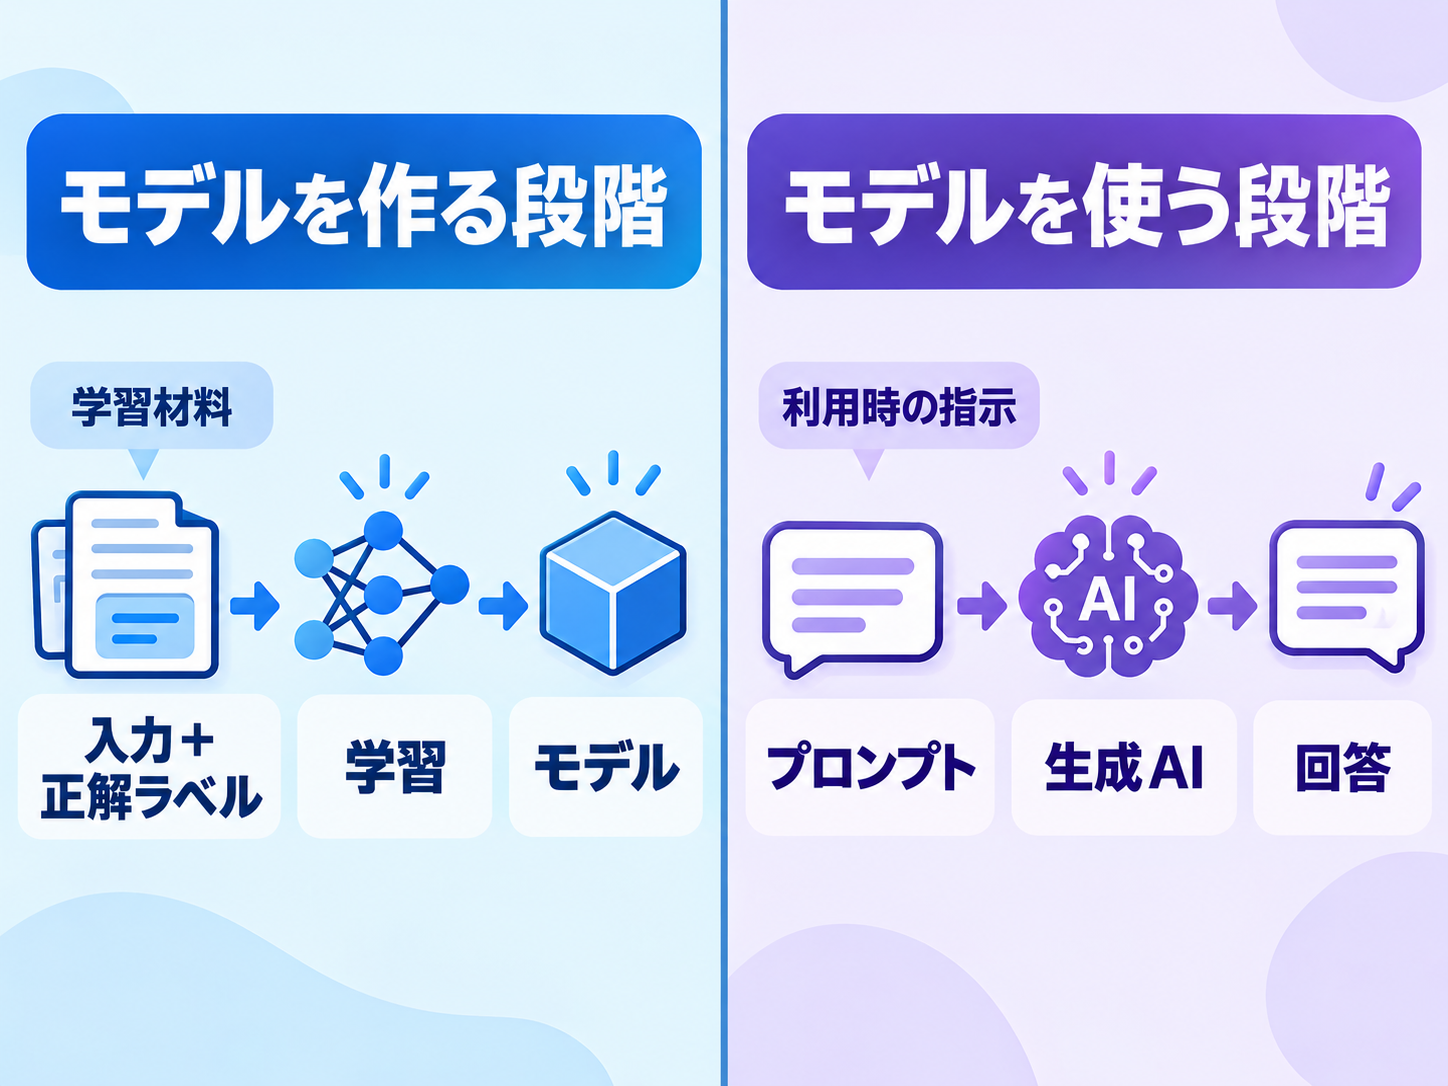
生成AIのチャット画面に文章を入力した経験がある人は、その指示も教師あり学習の正解データなのかと疑問に思うかもしれません。ここでは、「モデルを作るための学習」と「作られたモデルを使うための入力」を分ける必要があります。見た目はどちらも文章ですが、工程上の役割が異なります。
プロンプトとは、生成AIへ渡す依頼や入力です。生成AIは、プロンプトに応じて文章や画像などの内容を生成します。IBMは、生成AIについて、学習データを簡略化して表現したものを基に、元データと似ていても同一ではない新しい内容を作るモデルだと説明しています(出典: IBM)。また、生成AIの工程を、基盤モデルの訓練、特定用途への調整、生成と評価という段階に分けています(出典: IBM)。
教師あり学習の正解ラベルは、入力と望ましい出力の対応を学習させる材料です。これに対して、利用時のプロンプトは、すでに用意されたモデルへ、その場で何を生成してほしいかを伝える入力です。チャットで回答を一度訂正した行為と、開発者が多数の対応例を用いてモデルを調整する工程を、同じ「学習」として扱うべきではありません。個々のサービスが入力データをどのように扱うかは、それぞれの説明や利用条件を確認する必要があります。
生成AIの調整には、用途に合わせた質問や正解例を使うファインチューニングなど、教師あり学習に近い考え方が使われる場合があります。IBMも、用途に合わせたラベル付きデータ、想定される質問やプロンプト、それに対応する望ましい回答を用いる調整方法を紹介しています(出典: IBM)。ただし、この事実から「プロンプトを書けばモデル自体がその場で再学習する」とは判断できません。教師あり学習を理解すると、日常語としての「AIが学んだ」と、モデル作成工程としての学習を切り分けて考えられるようになります。
AIを見るときに確認したい四つの問い
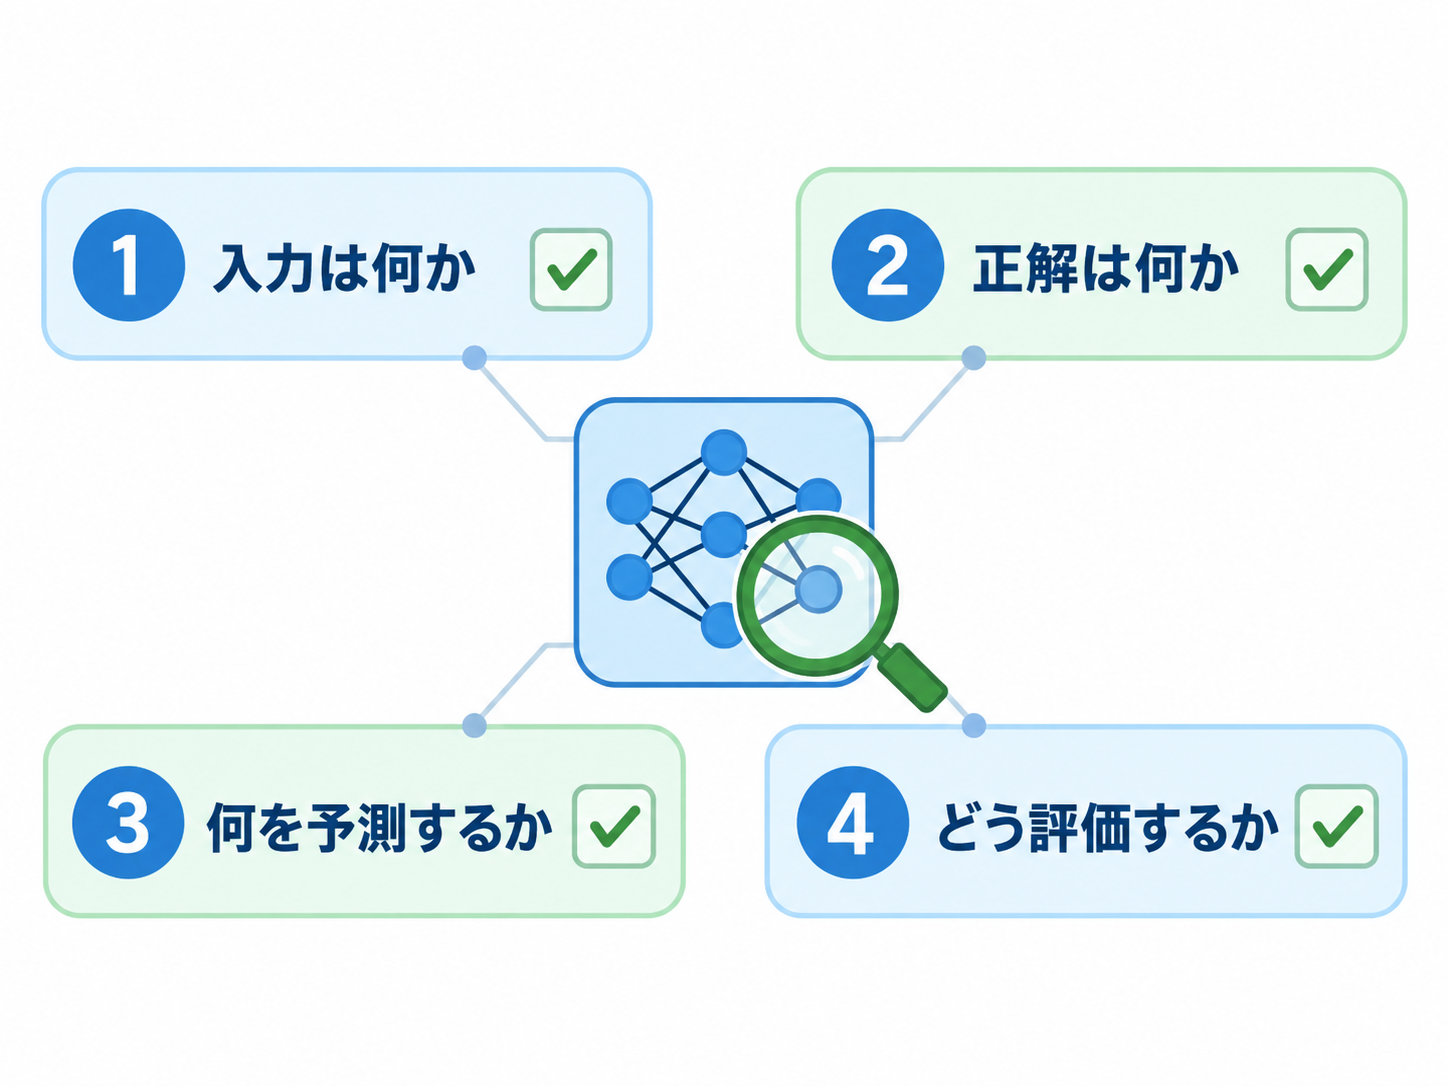
教師あり学習という用語を覚えるだけでは、製品や仕事上の提案を判断するときに使いにくいかもしれません。明日から役立てるなら、「AIかどうか」だけを尋ねるのではなく、入力、正解、予測対象、評価方法の四つに分けて確認すると、説明の輪郭が見えてきます。専門的な数式を知らなくても使える見方です。
確認したい問いは、「何を入力するのか」「何を正解ラベルとして用意したのか」「新しい入力に対して何を予測するのか」「予測の良し悪しを何で確かめるのか」です。たとえば、架空の会議で「過去データから問い合わせを自動分類したい」という案が出たとします。問い合わせ文が入力、担当部署がラベル、新規問い合わせの振り分け先が予測対象だと整理できます。評価するなら、学習に使っていない問い合わせで、実際の担当部署と予測結果を比べる考え方になるでしょう。これは業務への応用案であり、導入効果や実現性を保証するものではありません。
この四つを確認すると、正解ラベルを誰が、どの基準で付けるのかという論点も見えてきます。「返品」と「商品質問」の境界が人によって違えば、モデルへ渡す問題集にも揺れが生じます。珍しい問い合わせが学習例に含まれていなければ、新規データへの予測を慎重に扱う必要もあるでしょう。AIの出力だけを見るより、その前にある問題設定を確かめるほうが、できることと注意点を具体的に話し合えます。
教師あり学習は、正解を知る万能な仕組みではありません。正解付きの例から入力と出力の関係を学び、未知の入力へ答えを予測する方法です。次に「AIが判断します」という説明を見かけたら、まず入力と正解ラベルを一組だけ書き出してみてください。その二つが説明できれば、AIという大きな言葉に圧倒されず、何を学ばせ、何を予測させようとしているのかを自分の言葉で確かめられます。
参考情報
- What Is Artificial Intelligence (AI)? — IBM、2024年8月9日公開、2026年10月2日更新、2026年10月30日取得
- AI vs. Machine Learning: How Do They Differ? — Google Cloud、2026年10月30日取得
- Machine Learning Glossary: Generative AI — Google for Developers、2026年10月30日取得