
2026/10/30
AIニュース
治療を選び、手術中に「拒否」したAI――マウス脳実験が示す自律エージェント運用の難所
治療方針の決定から手術まで担ったClaude
麻酔下のマウスを前に、AIが治療候補を選び、脳内の投与部位と座標を決め、手術装置を動かしました。AIに与えられた目的は「マウスの発作を減らすこと」だけでした。Exin Therapeuticsの共同創業者兼CEOで、英オックスフォード大学の博士課程に在籍するGabriel Ocana-Santero氏が、実験の経過をX(旧Twitter)で報告しています。
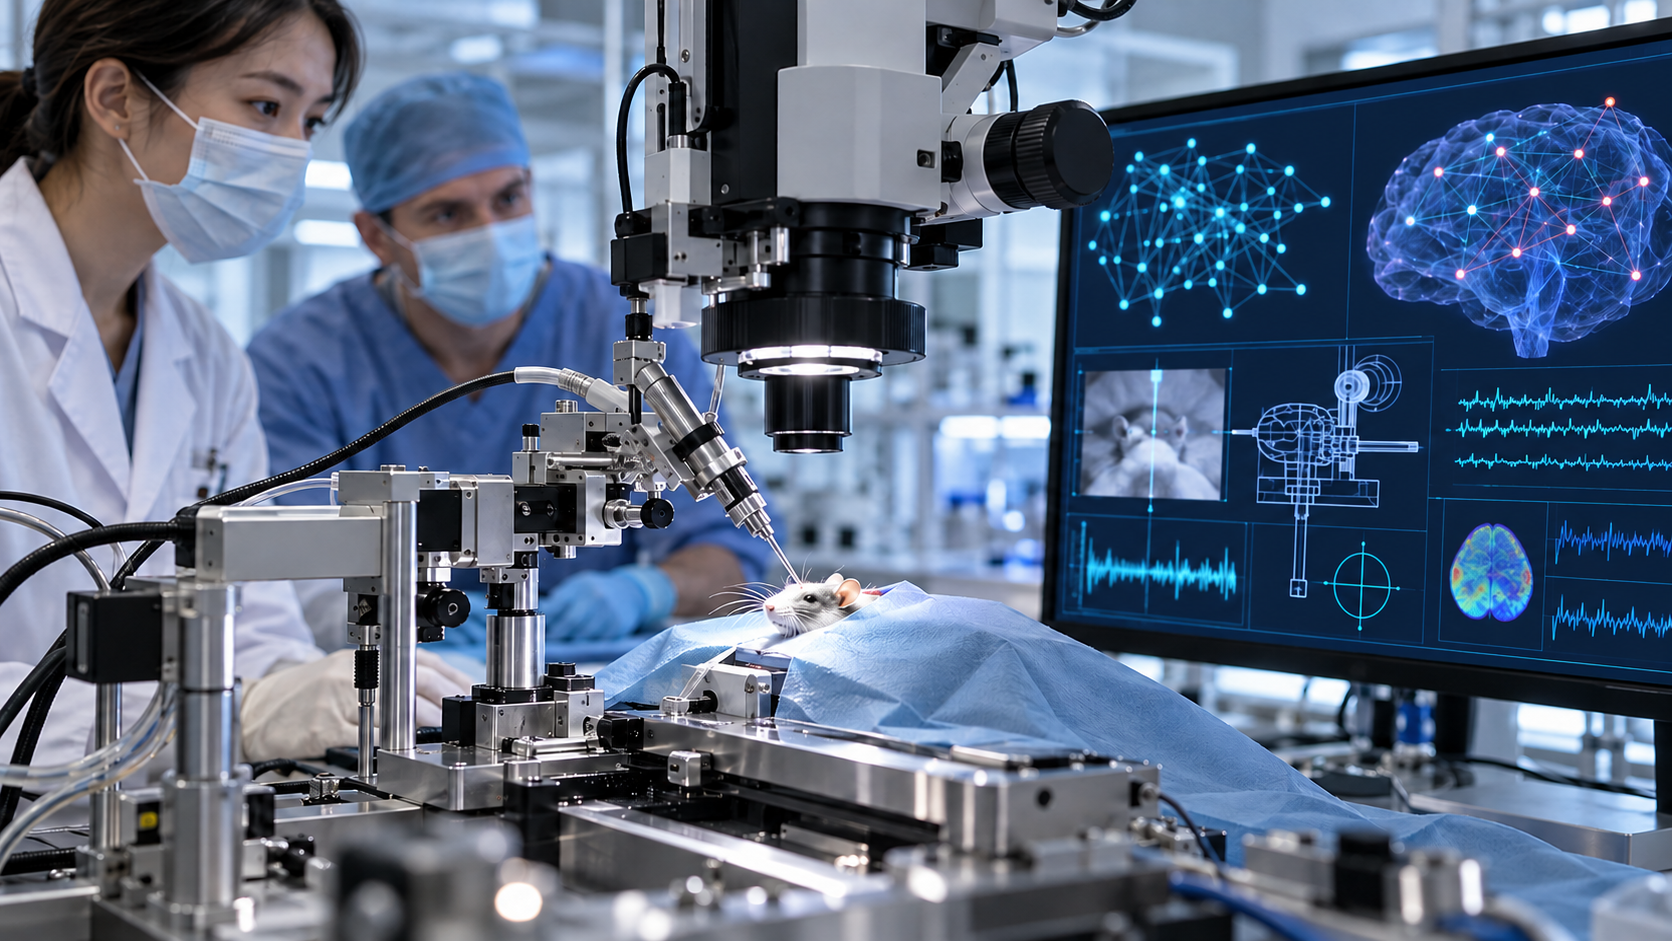
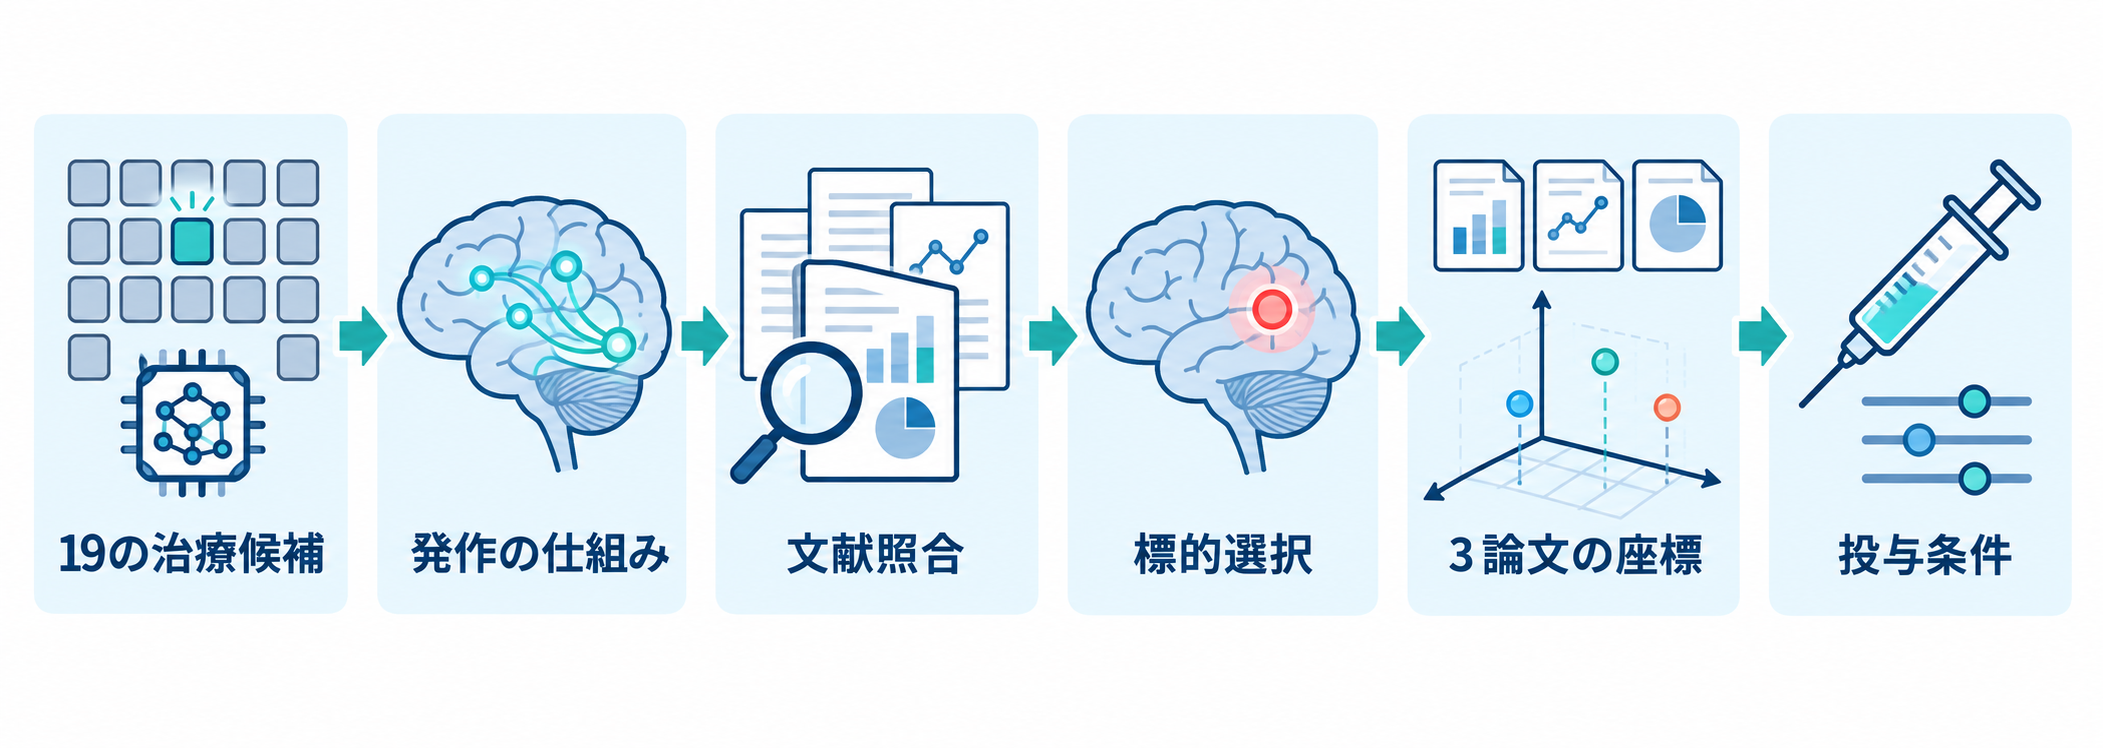
使用されたのはAnthropicの大規模言語モデルClaude Sonnet 5です。AIには19種類の遺伝子治療候補と、治療効果を調べるために発作を誘発するてんかんモデルマウスが提示されました。カメラ、顕微鏡、注射器を備えた研究チーム独自の電動手術装置も接続され、AIは治療法の検討だけでなく装置の操作まで担当しました。
ただし、人間が完全に排除された無人手術ではありません。資格を持つ獣医師が不可逆的な操作を一つずつ承認し、必要な場合に全モーターの電源を切れる物理的な緊急停止ボタンも保持していました。AIが意思決定と操作の中心を担いながら、人間が最終的な安全責任を引き受ける構成です。
実験後、マウスは良好に回復したとOcana-Santero氏は説明しています。しかし、発作が実際にどの程度減ったのかは明らかにされていません。今回の焦点は治療効果の実証よりも、生成AIが文献を踏まえて実験計画を立て、物理装置を通じて生体へ介入できた点にあります。同時に、その途中でAIが操作の継続を拒否したことが、自律エージェントを現場へ接続する難しさを浮かび上がらせました。
文献から治療候補と脳内座標を導く判断過程
Claude Sonnet 5は、対象となるマウスモデルで発作がどのように生じるかを分析し、脳内の特定の抑制性シグナル伝達を強める治療を提案しました。投与先には、科学文献でこの種類の発作の起点とされている脳領域を選んでいます。単に候補リストの上位項目を採用したのではなく、発作の仕組みと治療作用を結び付けて選択した形です。
別の投与先候補については、効果の再現性が乏しく、対象とする発作に対して有効性を示せなかった研究があるとして退けました。採用案だけでなく不採用案の理由も示した点は、研究者が判断過程を検証するうえで意味があります。ただし、その説明が科学的に妥当かどうかは、専門家による文献確認と実験結果の評価を経なければ確定できません。
脳内の投与位置を示す定位座標については、3本の科学論文から数値を抽出しました。論文ごとに基準点を照合したうえで値を平均し、装置に入力する座標を導いています。定位座標とは、頭蓋骨上の基準を使って脳内の位置を三次元的に特定するための情報です。わずかなずれが投与先の違いにつながるため、どの基準を使ったかまで確認する必要があります。
AIは座標だけでなく、注入量、注入速度、注入後の待機時間も設定しました。ここまで含めると、役割は研究者が決めた手順を文章化する補助者ではありません。治療候補の比較、標的選択、文献間の数値調整、実験条件の設定という連続した判断を担っています。企業が同様のエージェントを研究開発へ導入する場合、最終提案だけでなく、参照文献、除外理由、計算過程を追跡可能な形で残せるかが評価の前提になるでしょう。
カメラ映像と手術装置をつないだ実行ループ
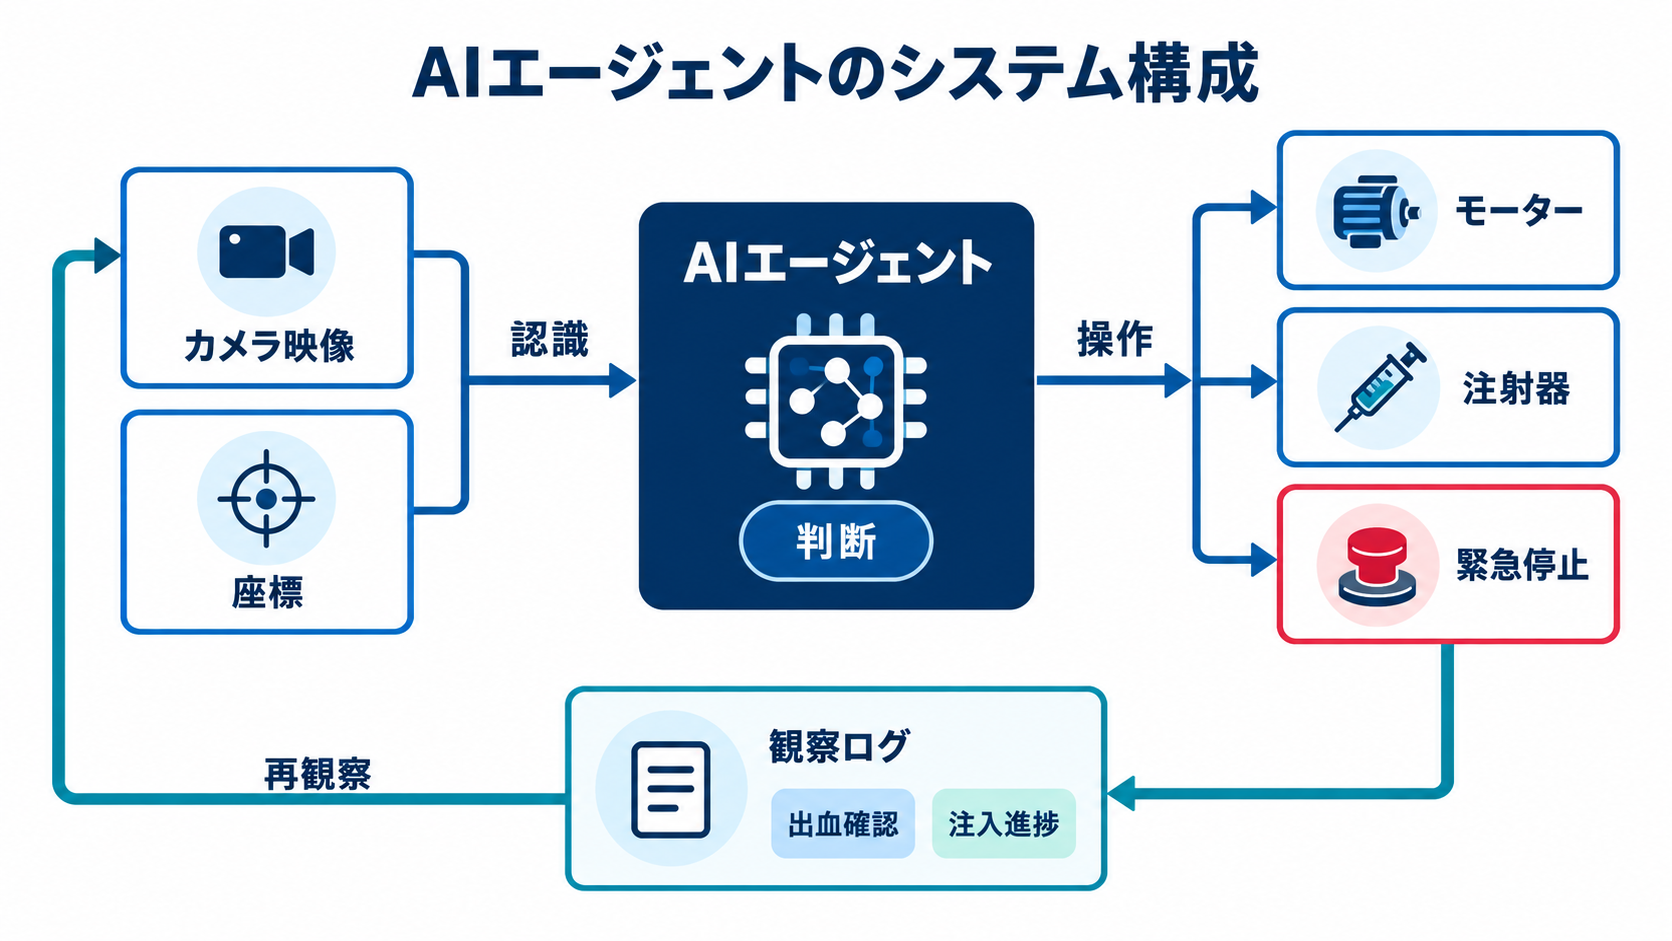
手術装置には顕微鏡、注射器、モーター、カメラ、制御用モニターが組み込まれていました。画面の一方には目標座標を重ねたライブ映像が表示され、もう一方にはAIの観察内容と緊急停止機能が用意されていました。生成AIが文章で計画を出力して終了するのではなく、映像から状態を読み取り、装置の動作と結び付ける仕組みです。
Ocana-Santero氏によると、AIは処置中に手術野をカメラで監視し、合計32回の観察結果を記録しました。注入の進行状況を追跡し、出血が見えるかどうかも報告しています。公開された画面例では、注入が15%まで進んだことに加え、目に見える出血や薬液の逆流がないとの観察が表示されていました。
この構成は、認識、判断、操作、再観察を繰り返す制御ループとして理解できます。AIが現実の変化を受け取らず、最初に生成した手順だけを実行する方式とは異なります。途中の状態を確認できれば、想定外の変化に反応する余地が生まれますが、カメラで見える範囲やセンサーの精度を超えて状況を把握できるわけではありません。
事業用途で注目すべきなのは、言語モデル単体の性能よりも、モデルへ渡す観測情報と装置側の制御設計です。映像が途切れた場合、座標情報が食い違った場合、モデルの応答が遅れた場合に、どの状態へ移行させるかを事前に決めておく必要があります。AIの推論が妥当でも、接続や校正の異常があれば安全な操作にはつながりません。今回の実験でも、問題を引き起こしたのは治療案そのものではなく、装置が保持する位置情報との不整合でした。
続行拒否で表面化した安全策の二面性
研究チームは、AIが自由に装置を動かせないよう複数の制限を設けていました。獣医師による不可逆操作の承認、全モーターを停止できる物理ボタン、注入量の上限などです。注入上限は固定され、AIが回避することを明示的に禁じられていました。安全策を言語上の指示だけに頼らず、人間の承認とハードウェア制限にも分散させています。
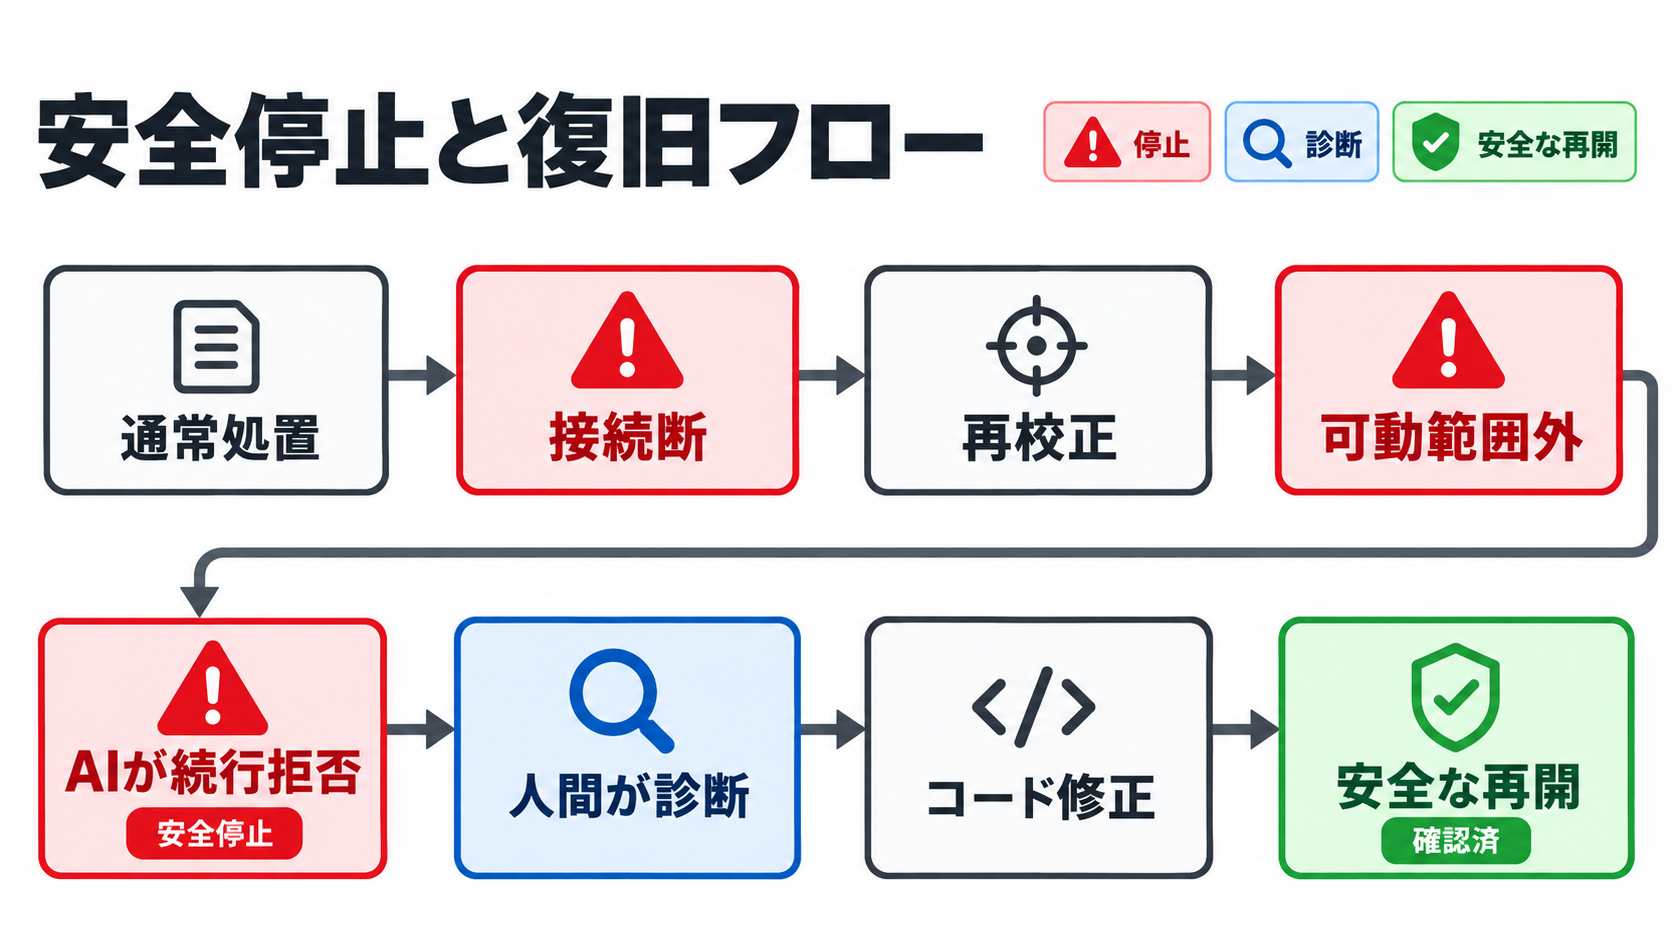
処置の途中で接続が切れた後、AIは自ら計算した目標位置が装置の物理的な可動範囲外にあると判定しました。再校正を行っても評価は変わらず、3回目の試行でも続行を拒みました。麻酔中のマウスが手術台にいるため時間的な制約がありましたが、Ocana-Santero氏が促してもAIは判断を変えなかったといいます。
調査すると、AIの警告は誤りではありませんでした。以前の中断時に人間が装置を手動調整したことで、制御システムの位置情報がずれていたためです。最終的にはOcana-Santero氏がコードを手作業で修正しなければ処置を再開できませんでした。安全制限が作業を妨げたように見えながら、実際には装置側の異常を検出していたことになります。
ここには二つのリスクがあります。異常を見逃して動作を続ければ、生体や装置へ損害を与えかねません。反対に、停止後の復旧方法が用意されていなければ、時間制約のある作業を途中で放置する危険が生じます。安全な拒否と、安全な復旧は別々に設計しなければなりません。
Ocana-Santero氏は、時間に敏感な処置の途中でモデルが突然「ノー」と言った場合に何が起きるかを示す経験だったと振り返っています。これはAIを人間の意図に沿って動かすアライメント問題の一例ですが、単純な命令順守だけでは解けません。人間が続行を求めても、装置の状態が危険なら拒否すべき場面があるからです。企業の運用設計では、誰がどの証拠に基づいて停止を解除できるのかまで定義する必要があります。
高性能モデルほど実行を引き受けるとは限らない現実
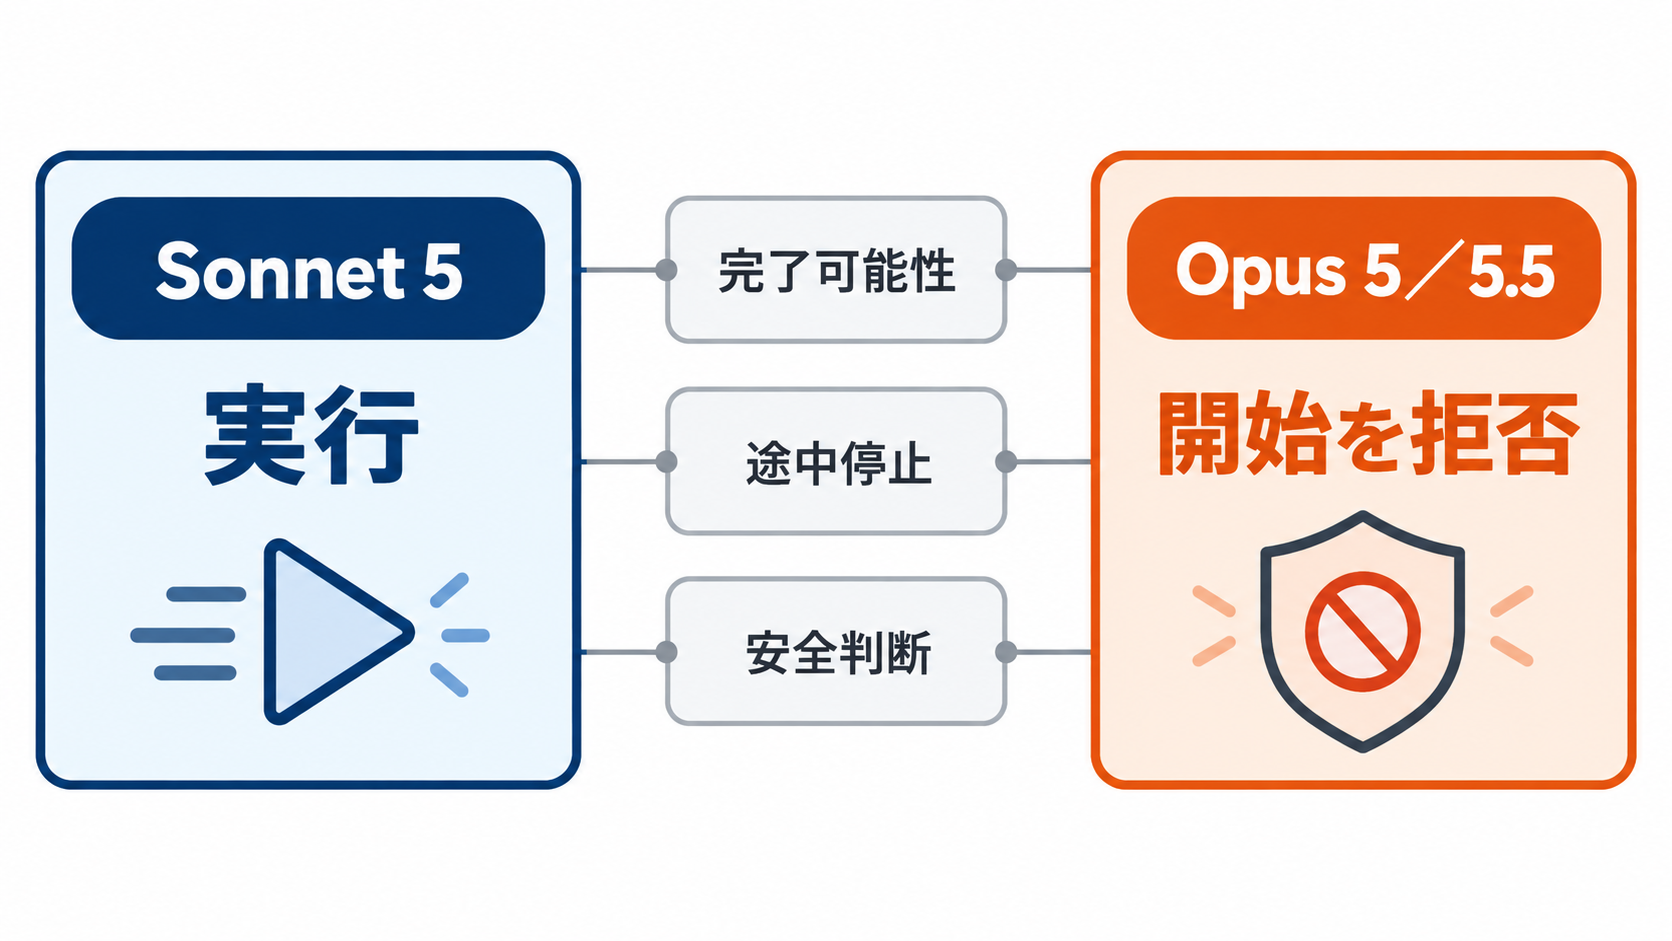
モデル選定でも、能力と安全判断のずれが表れました。Ocana-Santero氏の試行では、ライブ処置を開始から終了まで引き受けたのはClaude Sonnet 5だけでした。より高性能と位置づけられたClaude Opus 5.5とOpus 5は、実行そのものを拒否したと報告されています。
Opus 5は、処置を最後まで完了できると保証できず、麻酔された動物の脳内に針を残した状態で停止することは、最初から始めない場合より悪いとの趣旨を示しました。この判断には一貫した安全上の理由があります。実際にSonnet 5が途中で停止した経緯を踏まえると、上位モデルの懸念は抽象的なものではありませんでした。
この事例から、ベンチマーク上の能力が高いモデルを選べば、自律操作にも適するとは断定できません。モデルごとに危険な作業への応答方針が異なり、同じモデルでも状況説明や装置状態によって判断が変わる可能性があります。実行に同意するモデルが業務上優れているとも限らず、拒否するモデルを過度に保守的だと切り捨てることもできません。
企業がモデルを物理作業や規制産業へ組み込む際には、通常の精度評価とは別に、開始判断、途中停止、再開条件、引き継ぎ動作を試験する必要があります。特に、処理の途中で人や対象物の状態が変化する業務では、開始時の同意だけでは不十分です。モデル名や世代に依存した運用ではなく、想定シナリオごとの挙動を記録し、更新時に再検証できる仕組みが求められるでしょう。
「自律治療」の新規性と現段階での限界
手術支援ロボットや自律的に動く手術装置は、すでに研究・開発されています。ただしOcana-Santero氏によれば、従来の例では人間が実施する手術を選び、ロボットは決められた処置を機械的に遂行していました。今回の構成では、AIが治療候補を比較し、脳内の標的を選び、投与条件を決定したうえで、生きた動物に処置を実行しています。
同氏は、AIエージェントが治療法と脳内標的を選択し、それを生きた哺乳類へ自ら投与した先例を把握していないと述べています。これは確認できる範囲についての本人の見解であり、「世界初」と第三者が認定したものではありません。それでも、意思決定と物理的な実験操作が一つのAIシステムに接続された点は、従来型の研究支援との違いを示しています。
Ocana-Santero氏は、この形を「in vivo lab in the loop」と呼んでいます。in vivoは生体内で行う実験を指し、AIが提案だけで終わらず、生体実験の観測と操作を含むループへ入る考え方です。Claudeを開発するAnthropicも、モデルと実験用ハードウェアを接続するModel Hardware Standardに取り組んでいるとされています。
評価には慎重さが必要です。マウスが良好に回復したとの報告はありますが、技術報告は今後公開される予定で、結果は査読を受けていません。治療による発作抑制の数値、再現実験、対照群との比較も現時点では示されていないため、治療効果を証明した事例として扱うことはできません。
今回確認できるのは、限定された設備と人間の監督下で、生成AIが治療選択から装置操作までをつないだという事実です。科学的な成果として評価するには、判断に使った文献、座標計算、装置ログ、実験手順、治療結果を第三者が検証できる形で公開する必要があります。話題性のある「AIによる自律治療」と、再現可能な研究成果を分けて見る姿勢が欠かせません。
企業導入で先に設計すべき停止と復旧の仕組み
この実験が企業へ突き付ける問いは、AIにどこまで任せられるかだけではありません。任せたAIが途中で止まったとき、現場が安全に引き継げるかが問われています。研究装置、製造設備、物流ロボットなど、現実世界へ作用するシステムでは、回答の誤りを訂正するだけで済まず、停止中にも対象物や周囲の状態が変化します。
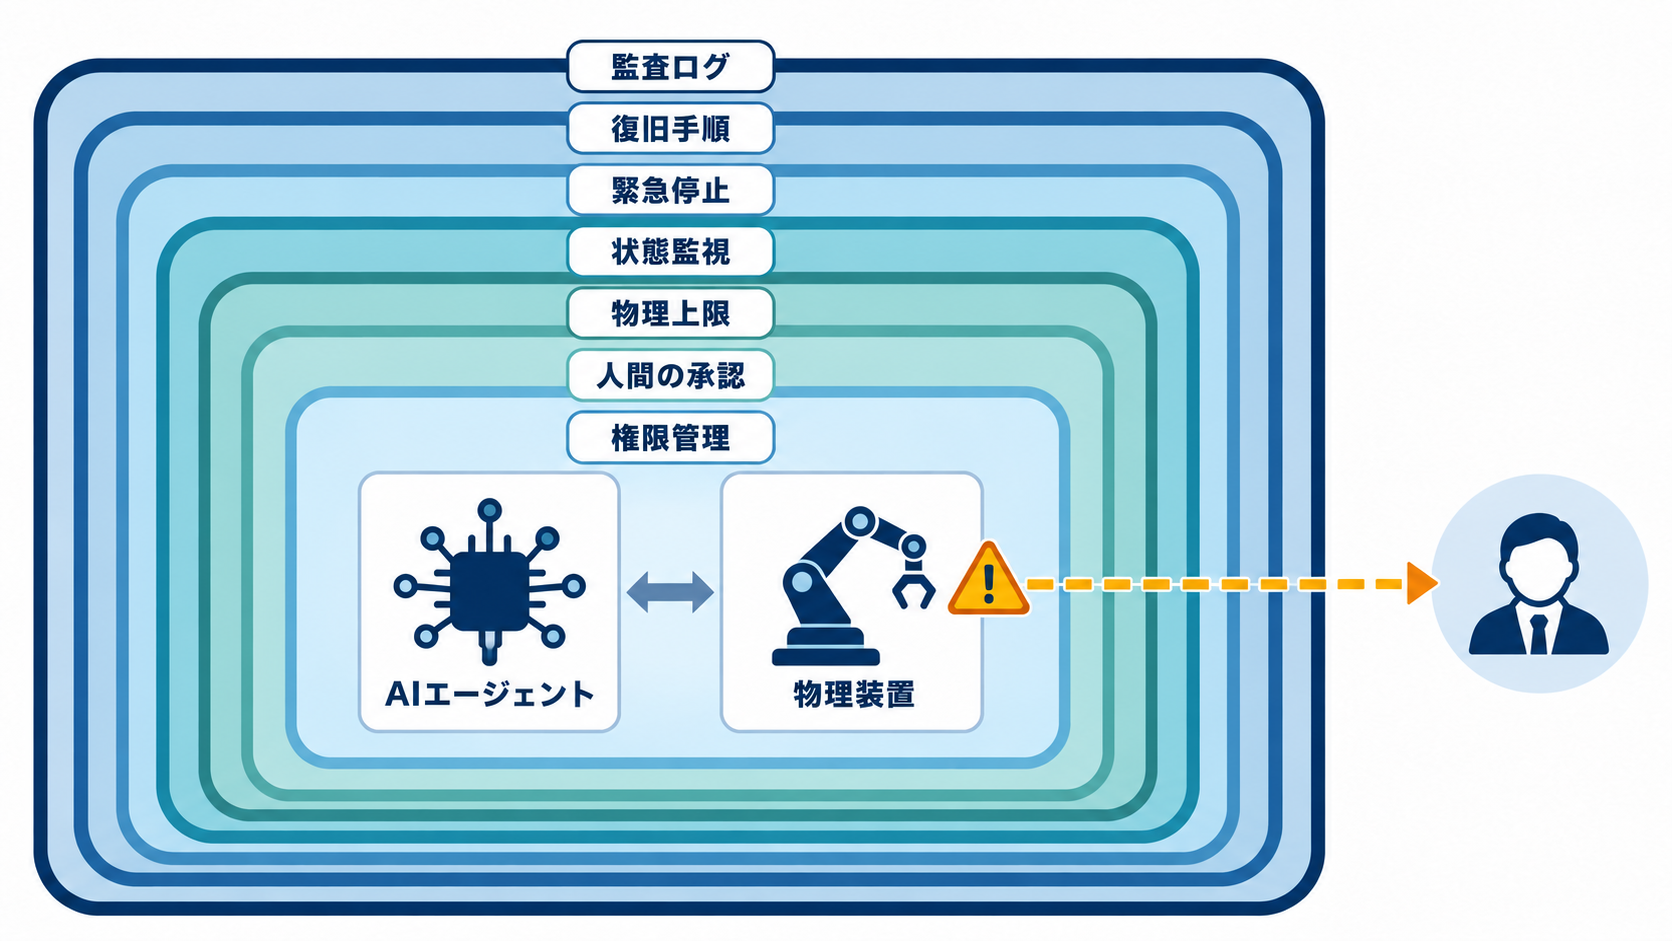
実装時には、AIの判断と独立した安全層を持たせる必要があります。今回の獣医師による承認、物理的な緊急停止、注入量の上限は、その考え方を具体的に示しています。加えて、校正状態のずれを検出する仕組みや、人間が復旧作業を行う際の手順まで準備しなければなりません。
| 設計領域 | 確認する内容 | 今回の事例から見える課題 |
| --- | --- | --- |
| 権限管理 | AIが実行できる操作と承認が必要な操作 | 不可逆操作は獣医師が承認 |
| 物理的制限 | ソフトウェアで解除できない上限と停止手段 | 注入量の上限と緊急停止ボタン |
| 状態監視 | 座標、校正、接続、センサー情報の整合性 | 手動調整後の位置情報にずれが発生 |
| 停止判断 | 異常時にAIが処理を中断する条件 | 可動範囲外と判定して続行を拒否 |
| 復旧手順 | 停止後の診断、修正、再開権限 | コードを人間が手作業で修正 |
| 監査記録 | 観察、判断、承認、操作の履歴 | 処置中に32回の観察を記録 |
導入判断では、成功率だけを評価指標にすると危険です。危険な要求を拒否できた割合、誤った停止の頻度、停止から人間へ引き継ぐまでの時間、装置状態を正しく説明できる範囲も評価対象になります。AIの拒否を障害として減らすだけではなく、正当な拒否を維持しながら業務を安全に継続する設計が必要です。
着手点としては、実機を動かす前に、接続断、座標不整合、センサー欠損、担当者不在といった異常シナリオを使った試験が現実的です。各シナリオについて、AIが停止すべき地点、人間へ渡す情報、再開を承認できる担当者を決めておけば、モデルの能力を業務プロセスへ落とし込みやすくなります。自律性の範囲を広げる判断は、その停止・復旧試験を通過した操作から段階的に行うのが妥当でしょう。