
AI LAB
2026/10/23
AI検索を本番で止めない設計──TinyFishが示す「7段階の制御ループ」
デモでは見えないAI検索エージェントの弱点
検索結果を受け取ったAIが、もっともらしい回答を返すところまでは比較的簡単に作れます。ところが業務システムとして動かすと、必要な証拠がそろわない、同じ失敗を何度も繰り返す、処理時間や費用が上限を超えるといった問題が表面化します。回答の文章が自然でも、判断材料となる情報が欠けていれば、企業はその結果を安心して利用できません。AIエージェント向けのWeb基盤を提供するTinyFishは、こうした問題を検索モデル単体の能力ではなく、検索開始から回答確定までの運用設計の問題として捉えています。同社が示した中心的な考え方は、モデルに自由に検索させるだけではなく、取得すべき証拠、利用する道具、失敗時の対応、停止条件をアプリケーション側で管理することです。つまり、本番品質を左右するのは一度の検索精度だけではなく、タスク全体を制御する仕組みとなります。
この視点は、社内規程の確認、競合調査、製品比較、顧客向けレポートの作成など、根拠を示す必要があるB2B用途と相性がよいものです。検索結果の上位ページを要約するだけでは、情報の鮮度や出典の信頼性、調査範囲の充足までは保証できません。何をもって調査完了とするのかを事前に決め、足りない証拠があれば検索方法を変え、それでも解決しなければ未完了として返す必要があります。
TinyFishの報告から読み取れる要点は、AIに考えさせる範囲を広げること自体が目的ではないという点です。柔軟な推論はモデルに任せつつ、状態管理や予算、ツール実行、証拠の検証は明示的な制御下に置きます。この境界を設計できるかどうかが、試作品と業務基盤を分ける条件になると考えられます。
モデルの推論を支える4つのWeb機能と実行基盤
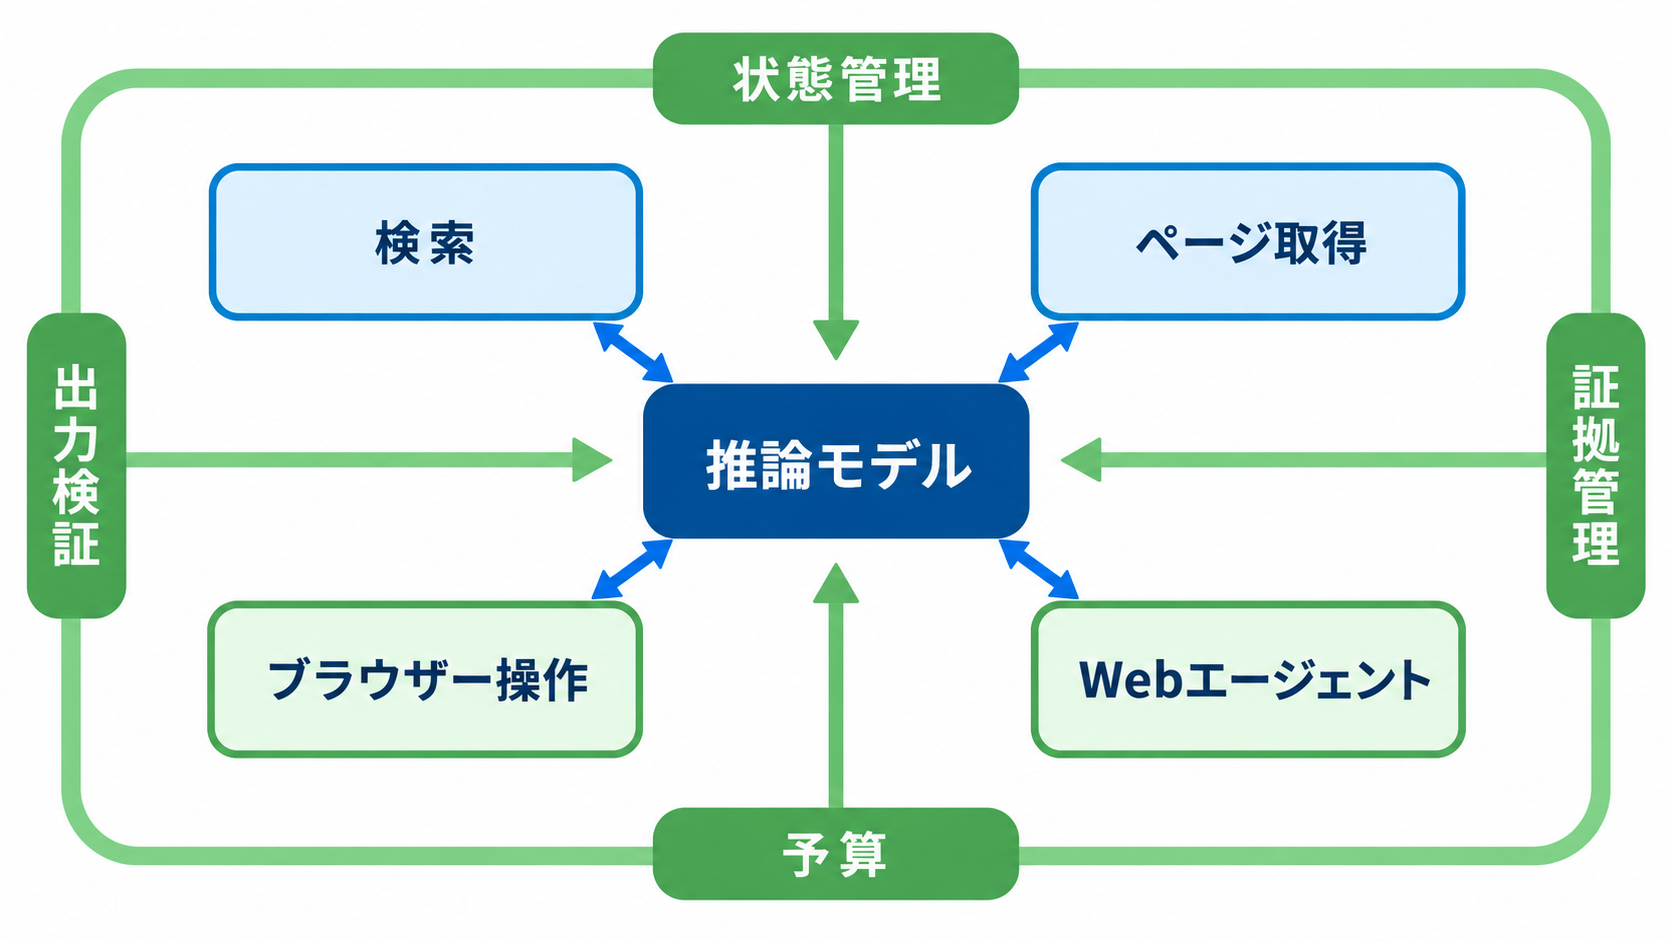
TinyFishの構成は、検索を担うTinySearch、指定ページを取得するTinyFetch、画面操作を行うTinyBrowser、複数ページを横断して判断するTinyAgentという4つのWeb機能を土台としています。すべてを高機能なエージェントに任せるのではなく、必要な情報と操作の性質に応じて機能を分けていることが特徴です。その外側では、アプリケーションがタスクの状態、ツールの実行、取得した証拠、実行時間、費用、出力形式を管理します。モデルは次に何を調べるべきかを考えますが、無制限にツールを呼べるわけではありません。トークン数、処理時間、総費用、ツール呼び出し回数に上限を設け、実行経路を追跡できるようにします。TinyFishが基礎として参照した2026年2月のアーキテクチャー研究でも、型が定義されたツールインターフェースを介し、推論と実行を切り離す考え方が示されています。
ここで重要になるのが「証拠契約」と呼ばれる考え方です。検索を始める前に、回答へ含める項目、利用可能な情報源、求める鮮度、完了と判定する条件を定義します。例えば料金比較なら、価格だけでなく、対象プラン、課金単位、適用地域、確認日までそろわなければ完了としない、といった設計ができます。必要項目が明確であれば、モデルの文章力に惑わされず、証拠が不足している箇所を機械的に検出しやすくなります。
一般的なRAGは、外部文書を検索して生成AIへ渡し、回答の根拠を補う仕組みです。エージェンティック検索では、それに加えて検索計画の修正、追加取得、証拠評価、失敗からの回復までを繰り返します。ただし、判断をモデルだけに委ねると挙動が不安定になりかねません。TinyFishの構成は、柔軟な推論を固定された実行規則で囲み、再現性と監査可能性を確保する設計だと理解できます。
調査を完了へ導く7段階の制御ループ
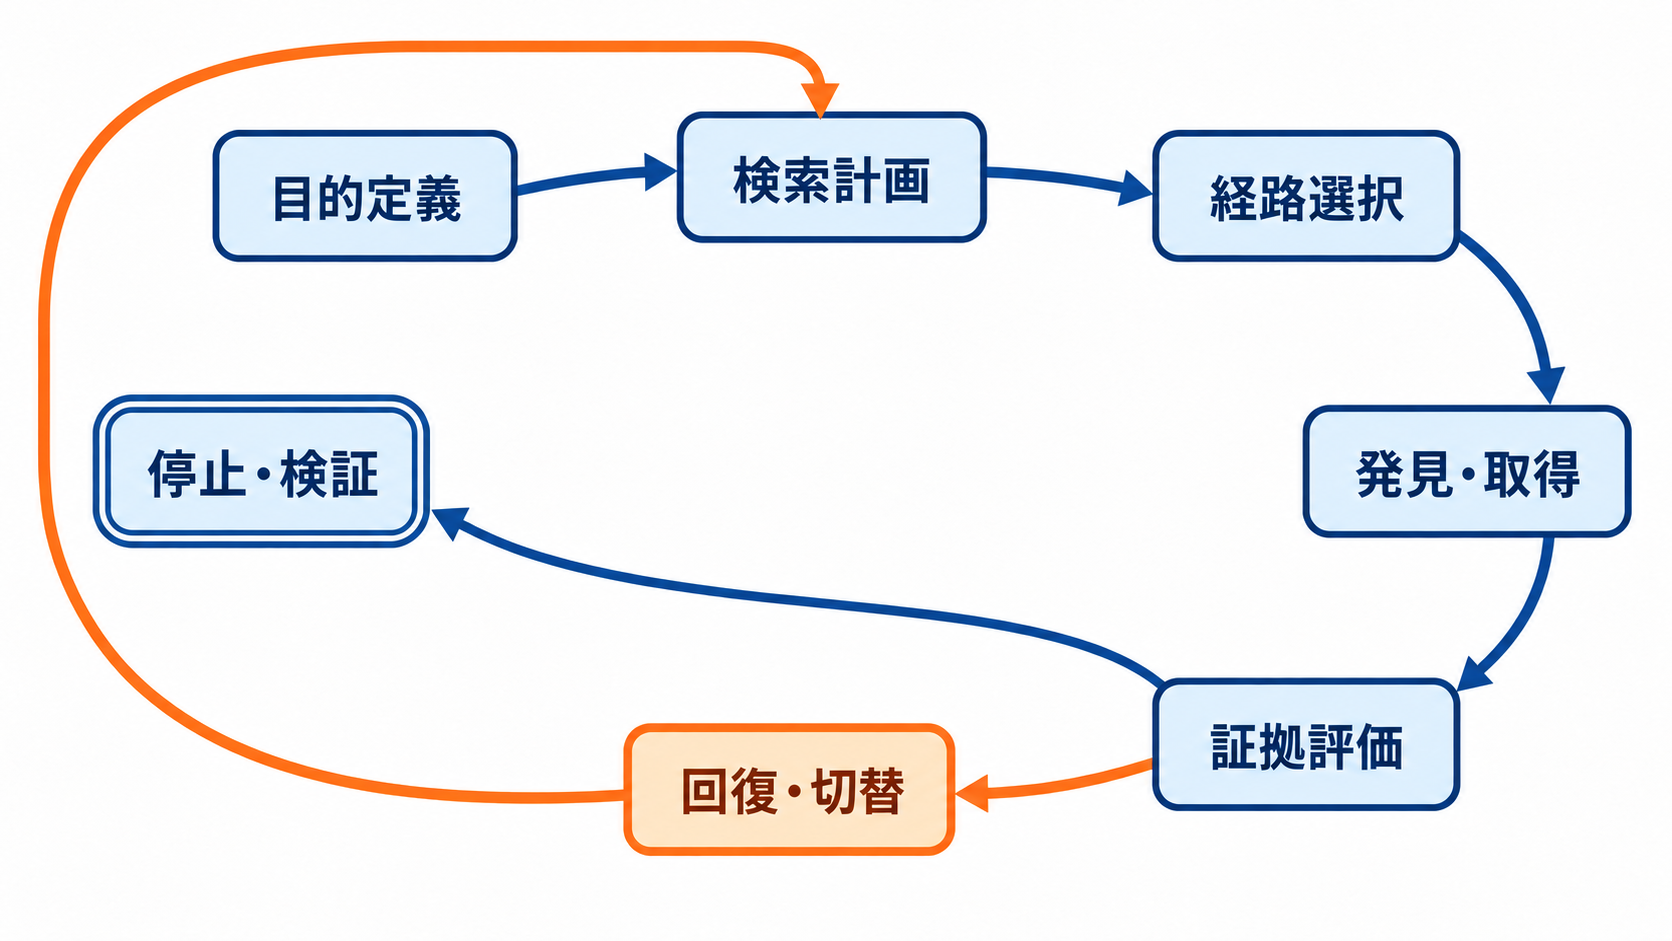
TinyFishは、一回の調査を7つの段階に分けています。起点となるのは、利用者の依頼を証拠契約へ変換する作業です。その後、必要な情報を独立して調べられる項目と、先行する回答がなければ検索できない項目に分けます。依存関係を無視して検索語を一度に作ると、重要な企業名や製品名が後続の検索から抜け落ちる可能性があるためです。第1段階では、必要項目、情報源、鮮度、完了条件を定義します。第2段階では検索の依存関係を整理し、第3段階で最初に使う機能を選びます。第4段階では検索結果を候補として扱い、ページ本文を取得して初めて証拠として検討します。検索一覧に表示された見出しや抜粋だけで、主張を裏付けたと判断しないための区別です。
第5段階では、集めた情報を「十分」「不完全」「矛盾」「アクセス不能」「予算超過」などに分類します。第6段階では、その分類に応じて検索語の修正、再試行、情報源の変更、アクセス方法の切り替えを行います。最後の第7段階では出力を検証し、完了、不完全、失敗、キャンセル、人による確認が必要という状態のいずれかで終了させます。無理に回答を完成させず、未解決の状態を明示できる点も業務利用では欠かせません。
複数段階の検索では、質問を細分化する途中で中心的な固有名詞が失われる「lost-in-retrieval」と呼ばれる問題が起こります。TinyFishは、独立した検索と依存する検索を分けることで、この問題へ対処しています。また、最初の取得結果が不足していれば、推論中に追加クエリを生成する考え方も取り入れています。関連研究のSearch-R1では、7つの質問応答データセットにおいて、学習された複数回検索が従来型RAGの基準をQwen2.5-7Bで41%、Qwen2.5-3Bで20%上回ったと報告されています。
この7段階は、単なる処理順ではありません。各段階で状態を記録し、次の行動を選び直す閉じた制御ループです。検索回数を増やすだけではなく、何が不足し、なぜ次の検索が必要なのかを管理できるため、費用や時間の上限がある環境でも調査を止める判断が可能になります。
情報の不足に合わせたツール選択と再試行
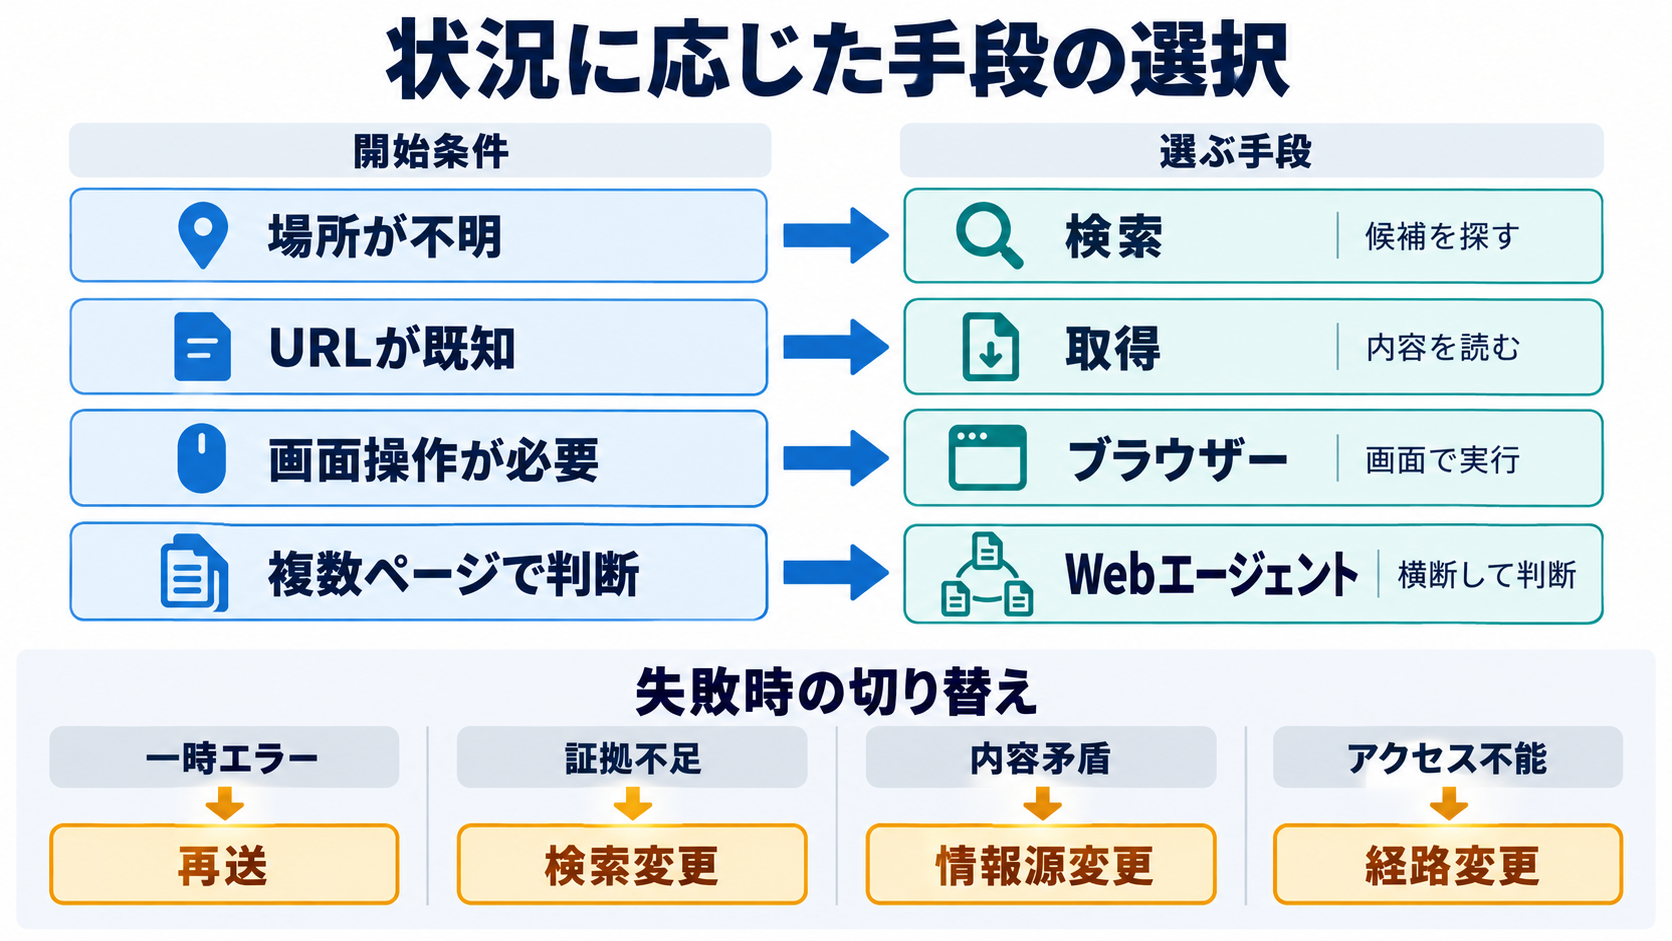
TinyFishは、軽い機能から重い機能へ順番に切り替える固定的な方式を推奨していません。選択基準となるのは、現在どの情報が欠けているかです。情報源の場所が分からないなら検索を使い、URLが判明していて通常の方法で読めるならページ取得を使います。画面上の操作が必要ならブラウザーを選び、複数ページをまたぐ判断や業務ルールの適用が必要な場合にWebエージェントを利用します。機能を選んだ後も、アプリケーション側の責任は残ります。検索ではクエリ設計や情報源の方針、停止条件を管理し、ページ取得では内容の完全性や主張との対応を確かめます。ブラウザー操作では一つひとつの行動とチェックポイントを記録し、Webエージェントには予算や出力検証などの業務規則を適用します。高機能なツールへ切り替えても、弱い検索語や矛盾した証拠が自動的に解消されるわけではありません。
再試行も、単純に同じ操作を繰り返す方式では不十分です。一時的な通信エラーなら同じ要求を再送する余地がありますが、取得内容が不完全なら検索語や情報源を変える必要があります。複数の情報源が食い違っている場合は、より直接的で信頼できる証拠を探さなければなりません。失敗原因を分類せずに再試行回数だけ増やすと、費用と待ち時間が膨らむ一方で、結果は変わらないでしょう。
ブラウザー操作では、再試行による副作用にも注意が必要です。フォーム送信やボタン操作がすでに完了しているのに、失敗したように見えて同じ操作を繰り返せば、二重送信などを招く可能性があります。そのため、どこまで操作が完了したかをチェックポイントとして残し、再開位置を判断する仕組みが求められます。
企業がこの考え方を採用する場合、エラーコードだけでなく、「証拠不足」「内容矛盾」「アクセス制限」「予算到達」といった業務上の失敗分類をログへ持たせるとよいでしょう。分類ごとに次の行動と最大回数を定めれば、再試行を回復手段として管理でき、同じ失敗が際限なく続く状態を避けられます。
独立プランナーとサブエージェントを外した理由
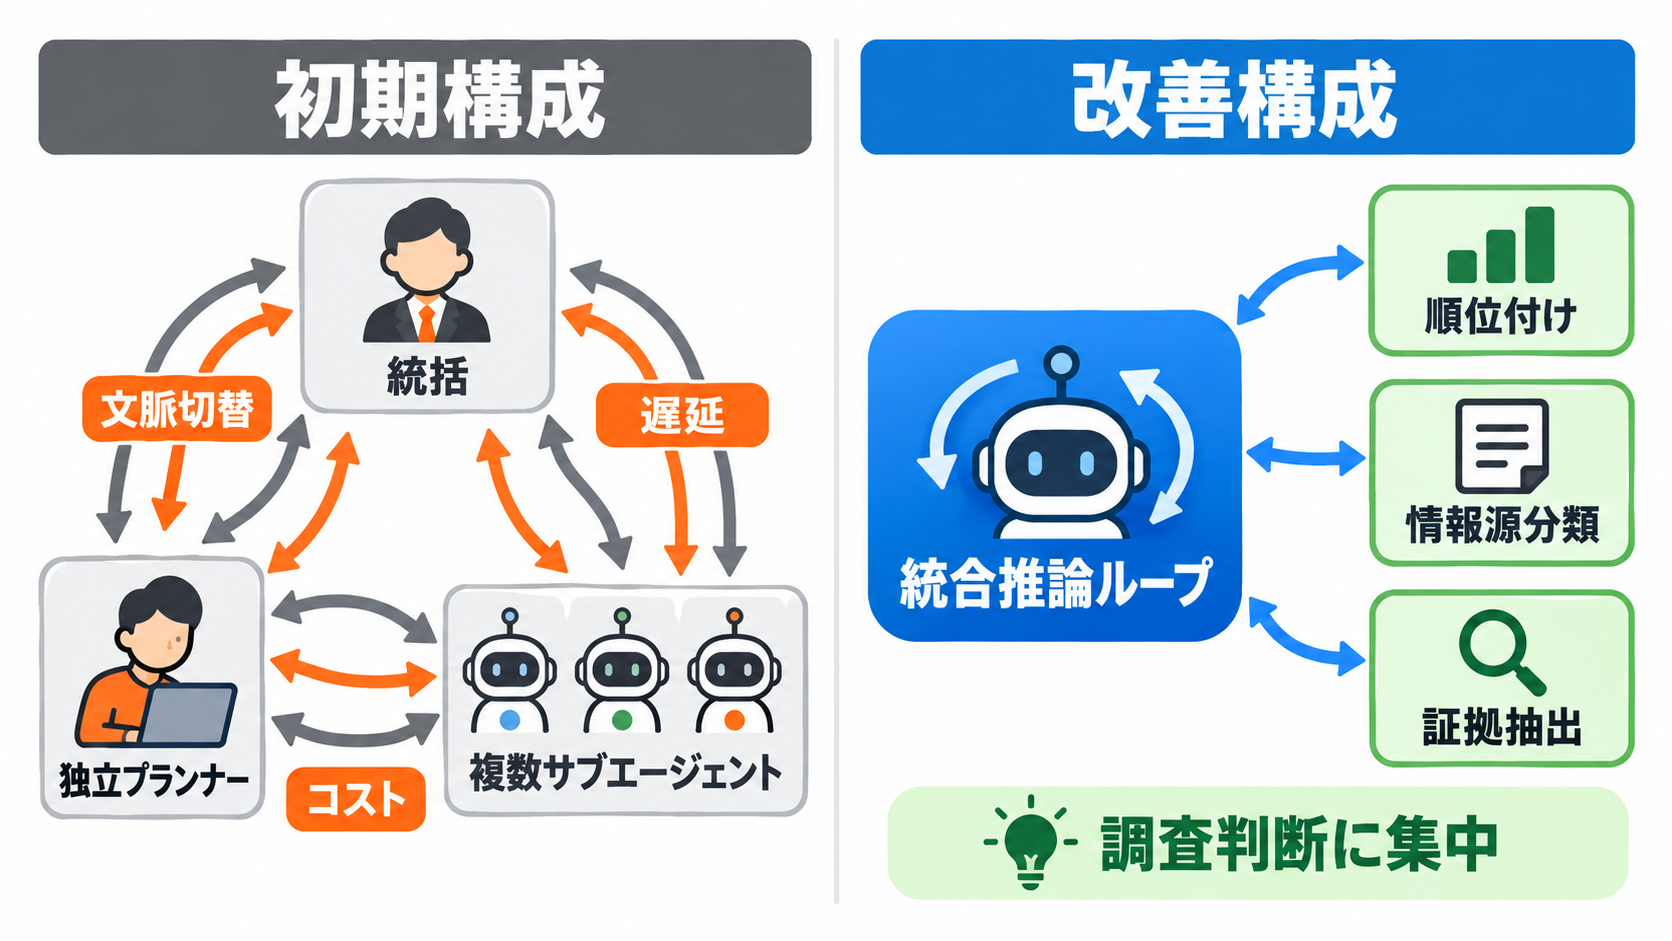
TinyFishの深掘り調査システムは、検索とブラウジングを繰り返し、出典付きのレポートを生成します。開発初期には、調査計画だけを担当する独立したプランナーを毎回呼び出していました。しかし、プランナーへ渡されるのは構造化された状態だけだったため、会話の細かな意図が失われる問題が生じました。例えば利用者が「東南アジアの価格リスクだけに絞ってください」と追加で指示しても、独立プランナーは再び広い市場調査へ戻ることがありました。そこでTinyFishは、計画をオーケストレーター、すなわち調査全体を統括する仕組みの推論ループへ統合しました。過去の会話、取得済みの証拠、残りの予算を同じ文脈で扱うことで、次に調べる内容を継続的に判断できるようにしています。
検索クエリごとに割り当てていたサブエージェントも見直されました。担当を細分化すると並列化しやすく見えますが、文脈の受け渡しが増え、待ち時間と費用が積み上がります。各サブエージェントから大量の情報が戻れば、統括側が再び内容を読み解かなければならず、調査の焦点もぼやけかねません。
TinyFishは、検索結果の順位付け、情報源の分類、証拠の抽出といった繰り返し可能な作業をツール呼び出しへ置き換えました。オーケストレーターは、調査計画と次の論点の判断に集中します。ここでの教訓は、複数エージェント構成そのものを否定することではありません。決まった入力から決まった形式を返せる処理まで、自由な推論を行うエージェントとして実装する必要があるのかを見直すべきだということです。
情報源の評価方法にも変更がありました。当初は幅広いサイトをカバーすることを重視していましたが、利用者は件数よりも、調査目的に合った強い証拠を求めていました。そこで目的に応じた順位付けに加え、特定ドメインを優先、除外、限定する制御が導入されています。レポート評価にはLLMを判定役として使う社内検証基盤を用意し、関連性、証拠の強さ、引用への信頼、情報源の多様性を確認しています。
費用と速度を「1回の検索」ではなくタスク全体で測る視点
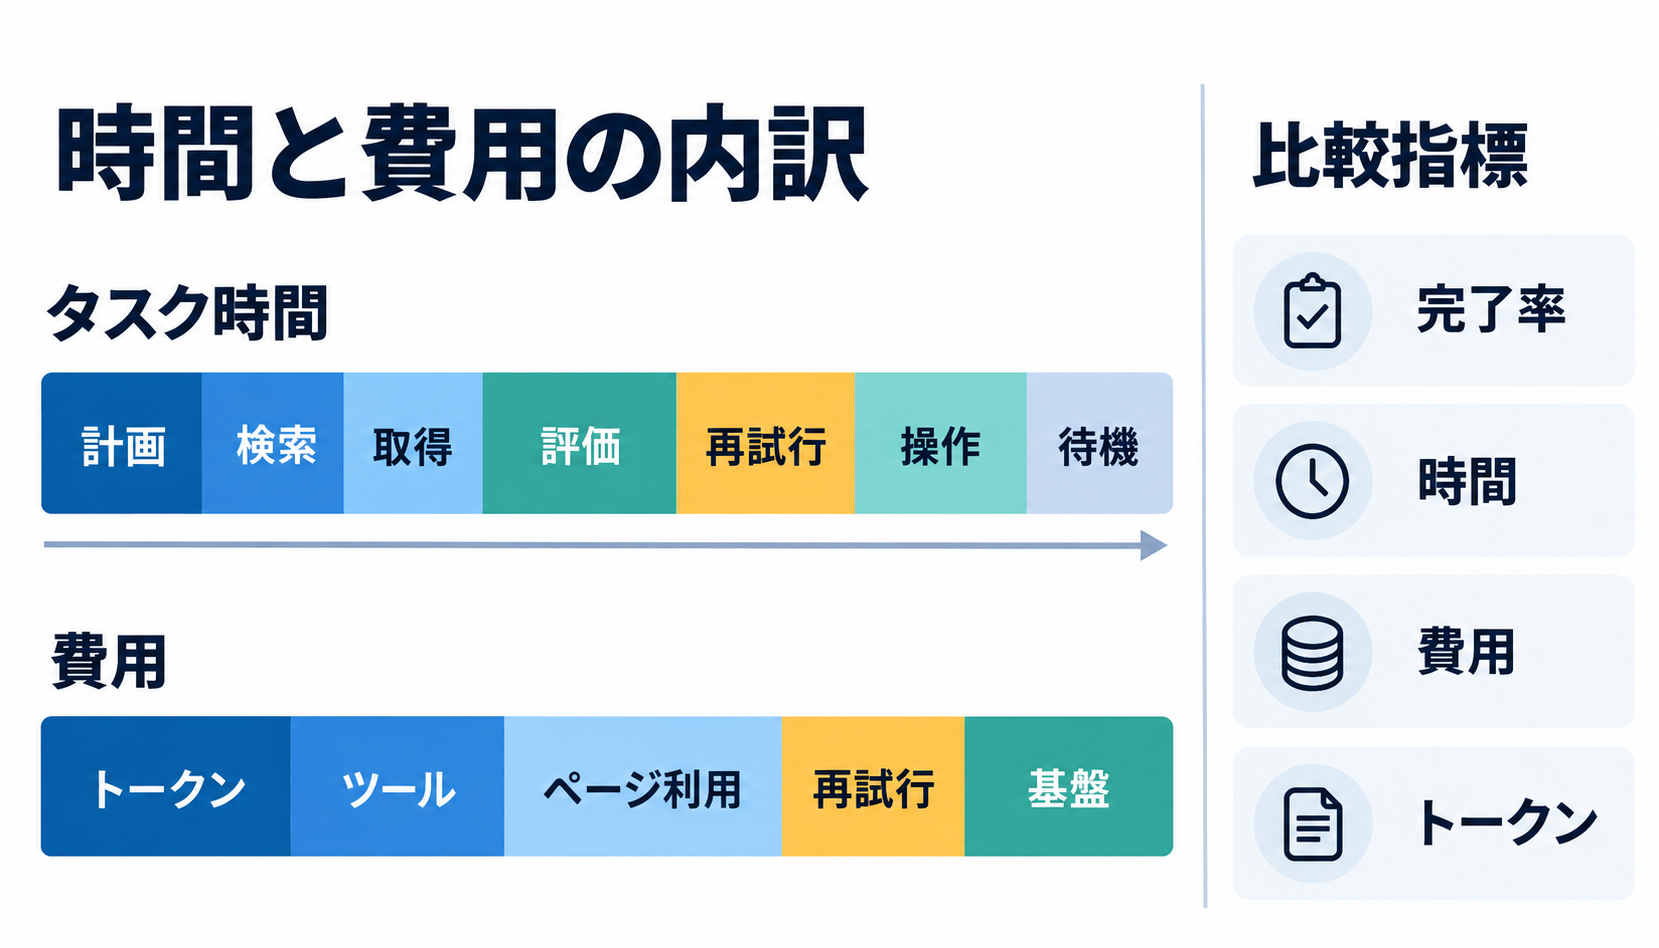
AI検索の費用は、モデルへ一度問い合わせた金額だけでは把握できません。TinyFishは、計画、検索、ページ取得、証拠評価、再試行、対話操作、待ち行列を合計してタスクの所要時間を捉えています。費用についても、トークン、ツール呼び出し、ページ取得やブラウザーの利用、再試行、基盤運用の合計として管理します。関連研究のSearchAgent-Xでは、精密な検索は取得処理の負荷を増やし、粗い検索は後段の推論量を増やすという関係が示されています。同研究の改善策は、比較対象となった方式に対して最大3.4倍のスループットと、最大5分の1の待ち時間を達成しました。検索精度だけを個別に最大化しても、タスク全体の処理効率がよくなるとは限らないことを示す例です。
OpenBenchmarksの比較では、同じgpt-5.6-sol、100件のタスク、共通の予算を使用し、検索・取得サービスだけを変更しています。数値は3回実行した平均です。検索とページ取得を組み合わせた完了率は、TinyFishが79.0%、Exa deepが83.0%、Perplexityが77.7%、Firecrawlが76.0%でした。TinyFishが完了率で首位だったわけではありませんが、中央値のタスク費用は0.050ドルで4サービス中もっとも低く、中央値の使用トークンも12,844で最少でした。中央値の処理時間は24秒です。
検索機能だけを使った別条件では、TinyFishの完了率は59.3%で、Perplexityの77.3%、Firecrawlの70.3%、Exa Fastの66.3%を下回りました。検索と取得を組み合わせた結果とは利用できる機能が異なるため、両者をそのまま比較することはできません。この差からは、TinyFishの強みが検索一覧の生成だけでなく、取得、評価、再試行を含む一連の制御にある可能性が読み取れます。
ベンチマークは2026年9月26日時点のOpenBenchmarksボードに基づき、対象は企業向けドキュメントに限られています。また、TinyFishの情報を紹介したMarkTechPostの記事は同社の提供によるスポンサー記事です。数値は設計上の特徴を理解する材料になりますが、自社のデータ形式、対象サイト、品質基準でも測定し、完了率と費用のどちらを優先するかを決める必要があります。
日本企業が導入前に決めておきたい運用ルール
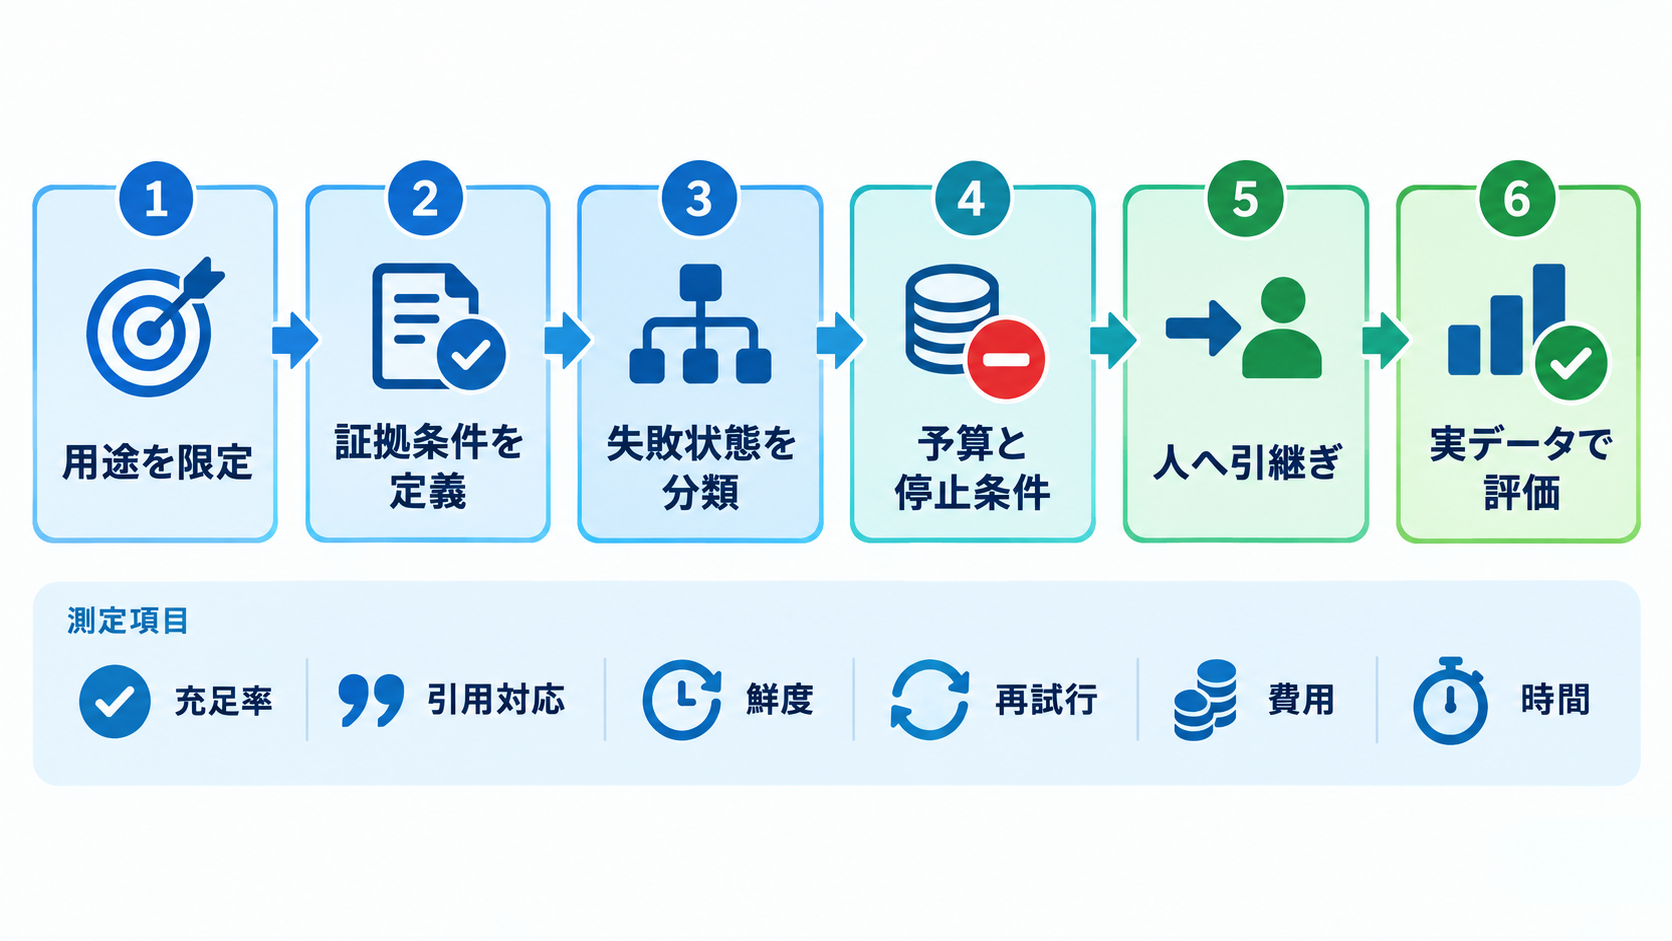
エージェンティック検索を業務へ導入する際は、最初から幅広い調査を完全自動化するより、証拠条件を定義しやすい一つの用途に絞るほうが検証しやすいでしょう。候補としては、公開情報に基づく製品仕様の確認、社内文書からの規程検索、指定した企業群の更新確認などが考えられます。正解の形式と利用可能な情報源を限定できれば、どの段階で失敗したかを追跡できます。検証時には、回答の自然さだけでなく、必要項目の充足率、主張と引用の対応、情報の更新日、再試行回数、タスク単位の費用、処理時間を記録する必要があります。結果を「成功」か「失敗」だけで扱わず、不完全、矛盾、アクセス不能、予算超過、人による確認が必要という状態に分けると、改善対象が見えやすくなります。人へ引き継ぐ条件も、運用開始前に決めておくべきです。
ツールの選択規則については、情報源が不明なら検索、URLが既知なら取得、操作が必要ならブラウザーという基本線を設定できます。ただし、ログインを伴う操作や外部への送信は、読み取り中心の調査とはリスクが異なります。すでに完了した操作を重複させないための記録や承認手順を設け、再試行回数にも上限を置く必要があるでしょう。
システム構成を検討するときは、すべての作業をエージェントへ分配する前に、決定的なツールへ置き換えられる処理を洗い出します。検索結果の整形、ドメイン分類、重複除去、項目抽出などは、入力と出力を固定しやすい領域です。モデルには、調査目標の解釈、証拠不足の判断、次の探索方針といった柔軟性が必要な仕事を担当させるほうが、費用と挙動を管理しやすくなります。
最初の実証では、成功率だけを競うのではなく、未完了を正しく未完了として返せるかも確認してください。必要な証拠がないのに回答を完成させるシステムより、足りない項目と理由を示して人へ引き継げるシステムのほうが、企業の意思決定には組み込みやすいはずです。小規模な対象で証拠契約と停止条件を定め、タスク全体のログを取ることが、次の具体的な一歩になります。