
2026/10/31
今更聞けないAI知識
画像生成AIはなぜ砂嵐から絵を作れるのか――拡散モデルの仕組みを身近なたとえで理解する
何もないところから描いているように見える理由
「赤い傘を差した猫」と入力しただけで、それらしい画像が現れます。猫の写真も傘の見本も渡していないのに、どこから絵を持ってきたのでしょうか。一言で答えるなら、画像生成AIは、学習した画像の特徴や関係を手がかりに、ノイズを少しずつ画像らしい状態へ変えていきます。
ここでいう画像生成AIは、文章や画像などの新しい内容を作る生成AIの一種です。生成AIは、機械学習の中でも多層のニューラルネットワークを使う深層学習を基盤とし、利用者からの依頼であるプロンプトに応じて内容を生成します。IBMは、生成モデルについて、学習データの単純化された表現を内部に持ち、その表現を利用して元のデータに似ていても同一ではない成果物を作るものと説明しています(出典: IBM)。
したがって、画面の向こうに小さな画家がいて、言葉の意味を人間と同じように想像しているわけではありません。入力された言葉と、学習によって得られた色・形・構図などのパターンを結び付け、画像としてまとまりそうな方向へ計算を進めています。「考えて描く」というより、「学習したパターンに基づいて、条件に合う画像を組み立てる」と捉えるほうが実態に近いでしょう。
この記事で焦点を当てるのは、その代表的な仕組みである拡散モデルです。数式やプログラミングを知らなくても、砂嵐のようなノイズを加える過程と取り除く過程に分ければ、基本的な考え方をつかめます。ただし、ここで扱うのは仕組みを理解するための概念図です。特定製品の画面操作や、すべての画像生成サービスに共通する細かな仕様を説明するものではありません。
AI・機械学習・生成AIと拡散モデルの位置関係
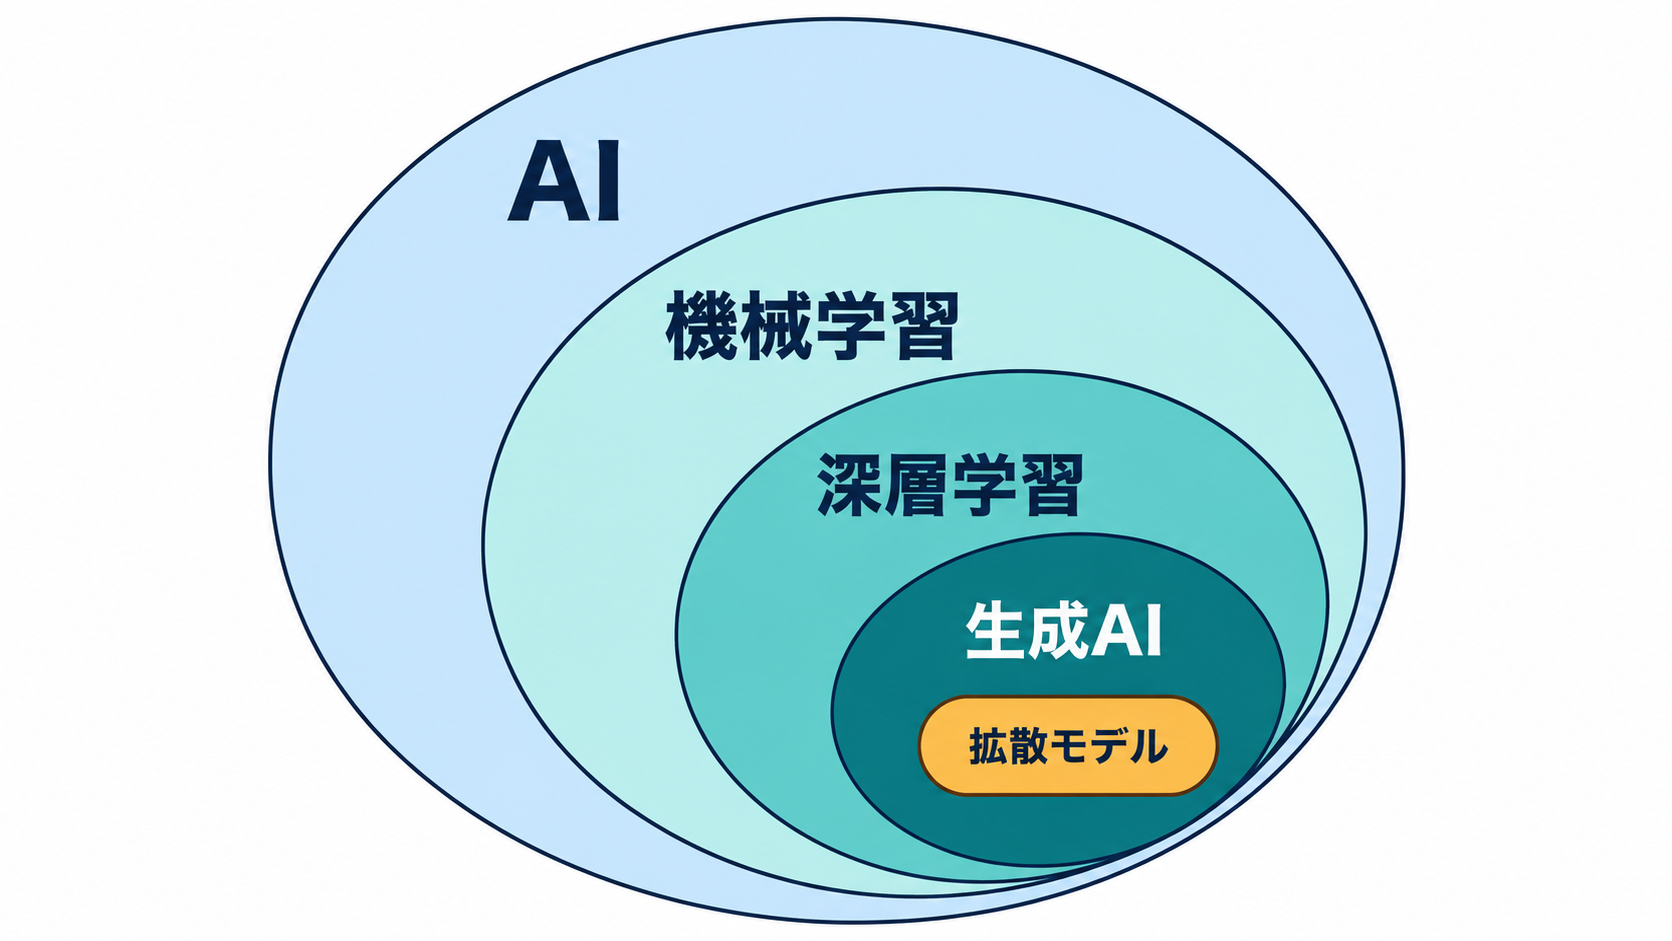
画像生成AIを理解しづらくする原因の一つは、似た用語が一度に登場することです。AIは、人の学習、理解、問題解決、判断、創造などに関連する働きをコンピューターで実現する技術の広い呼び名です。その内側に、データから規則性を学ぶ機械学習があります。さらに、機械学習の一部として、多層のニューラルネットワークを利用する深層学習が位置付けられます(出典: IBM、Google Cloud)。
関係を傘にたとえると、AIが最も大きな傘で、その下に機械学習、深層学習があります。生成AIは深層学習モデルを使い、文章、画像、音声などを作る分野です。拡散モデルは、生成AIで使われるモデルの種類の一つに当たります。すべてのAIが絵を作るわけでも、すべての生成AIが拡散モデルを使うわけでもありません。
| 用語 | 短い意味 | 画像生成との関係 |
| --- | --- | --- |
| AI | 人の知的な働きに関連する機能を機械で実現する広い技術分野 | 画像認識や画像生成などを含む大きな範囲です |
| 機械学習 | データからパターンを学ぶ方法 | 画像の特徴や関係を学ぶ土台になります |
| 深層学習 | 多層のニューラルネットワークを使う機械学習 | 多くの生成AIを支える技術です |
| 生成AI | プロンプトに応じて文章や画像などを作るAI | 画像生成AIはこの一種です |
| 拡散モデル | ノイズを加え、取り除く考え方を利用する生成モデル | 画像を生成する代表的なモデルの一つです |
「AIが絵を描いた」という日常的な表現は間違いとは限りませんが、仕組みを考えるときには範囲を分けると混乱が減ります。AIという広い技術分野の中で、データから学ぶ方法を使い、その中の生成に向いたモデルが画像を作っている、という順序です。名称を全部暗記する必要はありません。「AIと拡散モデルは同じ階層の言葉ではない」と分かれば、製品紹介やニュースを読む際にも、技術分野の話なのか、個別の仕組みの話なのかを切り分けやすくなります。
砂嵐を濃くしてから晴らす二つの過程
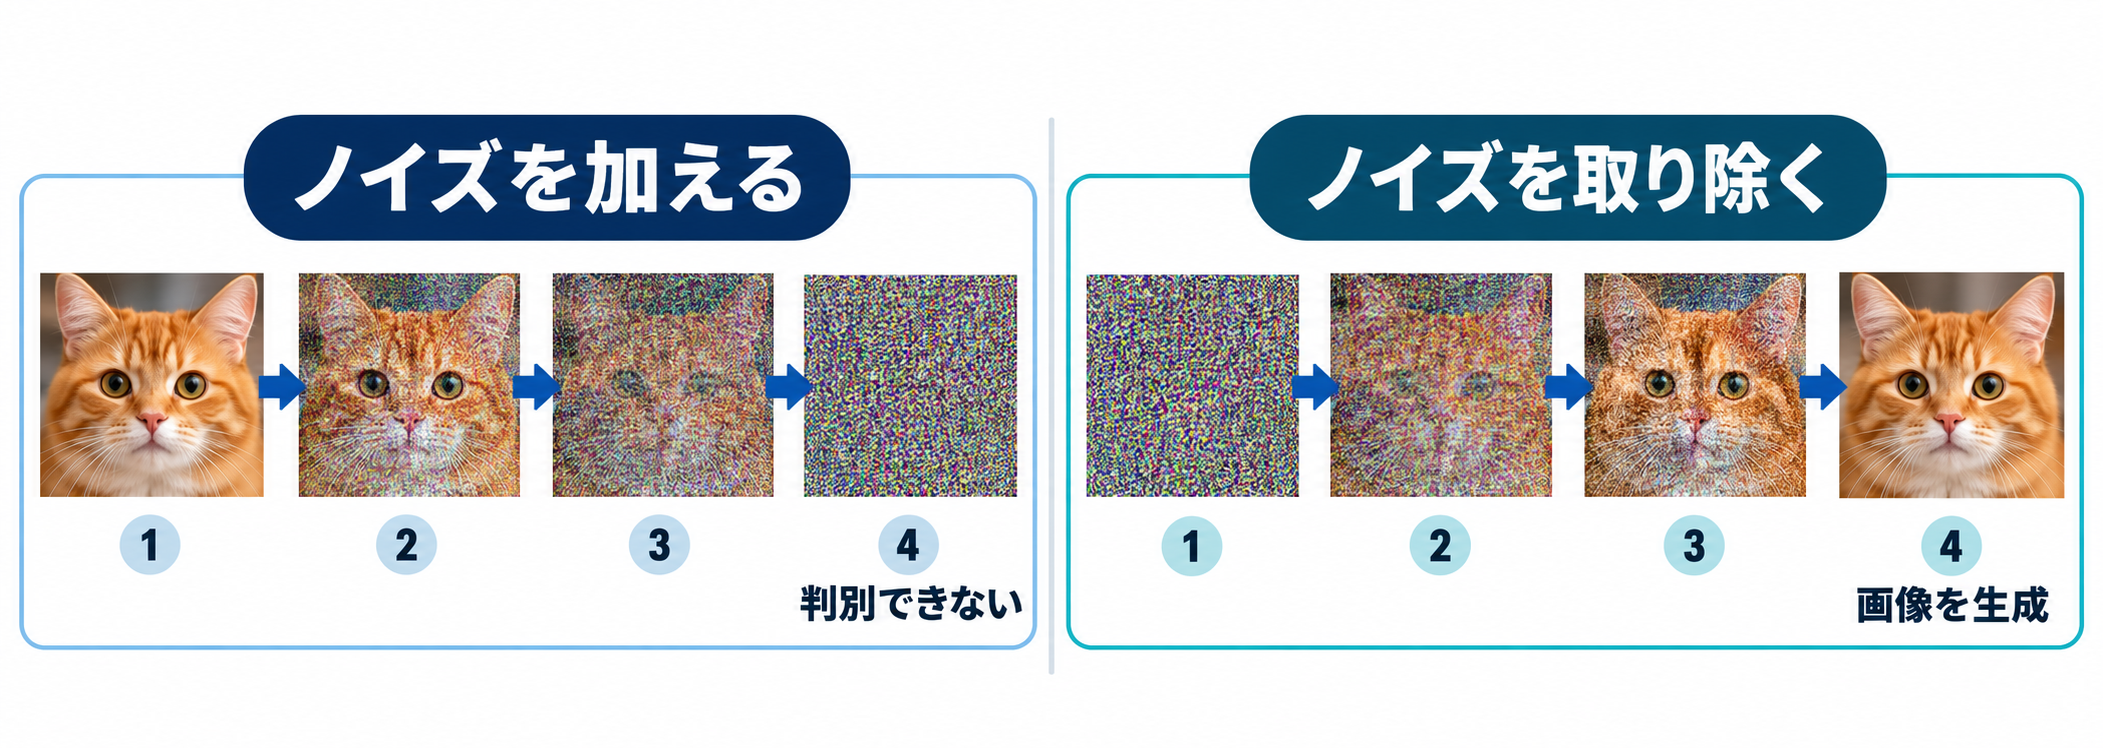
テレビ画面を想像してください。最初は一枚の写真がはっきり見えています。その上に細かな砂嵐を薄く重ねると、輪郭が少し崩れます。何度も砂嵐を加えていけば、最後には元の写真が何だったのか判別できなくなります。拡散モデルの説明では、この「画像へノイズを加え、認識できない状態にする」という流れが一方の過程になります。
もう一方は、その逆向きです。ノイズの多い状態から、画像らしくない成分を段階的に取り除き、形や色のまとまりを浮かび上がらせます。IBMは、拡散モデルを、画像が認識できなくなるまでノイズを加え、そのノイズを取り除いてプロンプトに応じた画像を生成するモデルとして説明しています(出典: IBM)。「砂嵐の中に完成済みの猫が隠れていて、それを発見する」という意味ではありません。砂嵐は仕組みをつかむためのたとえであり、モデルは学習したパターンを使って、各段階で画像らしい方向を計算しています。
ジグソーパズルとの違いも押さえておきたいところです。パズルなら完成図とすべてのピースが最初から用意されていますが、画像生成では完成画像が保管され、分解された状態で待っているとは説明されていません。生成モデルは、学習データそのものではなく、そこから得た単純化された表現を利用して新しい成果物を作ります(出典: IBM)。そのため、「ノイズ除去」は既存画像を元通りに復元する作業だけを指すのではなく、条件に沿う画像を組み立てる生成過程として理解する必要があります。
日常の感覚では、消しゴムで汚れを消すと下から元の線が出てきます。拡散モデルの場合、そのイメージだけでは不十分です。下に完成図が置かれているのではなく、ノイズの中から、学習した関係とプロンプトを手がかりに画像を形作っていくからです。「加えて壊す過程を学び、その反対方向を画像生成に生かす」という二段構えが、初心者向けの理解として役立ちます。
学習と画像生成は同じ作業ではない
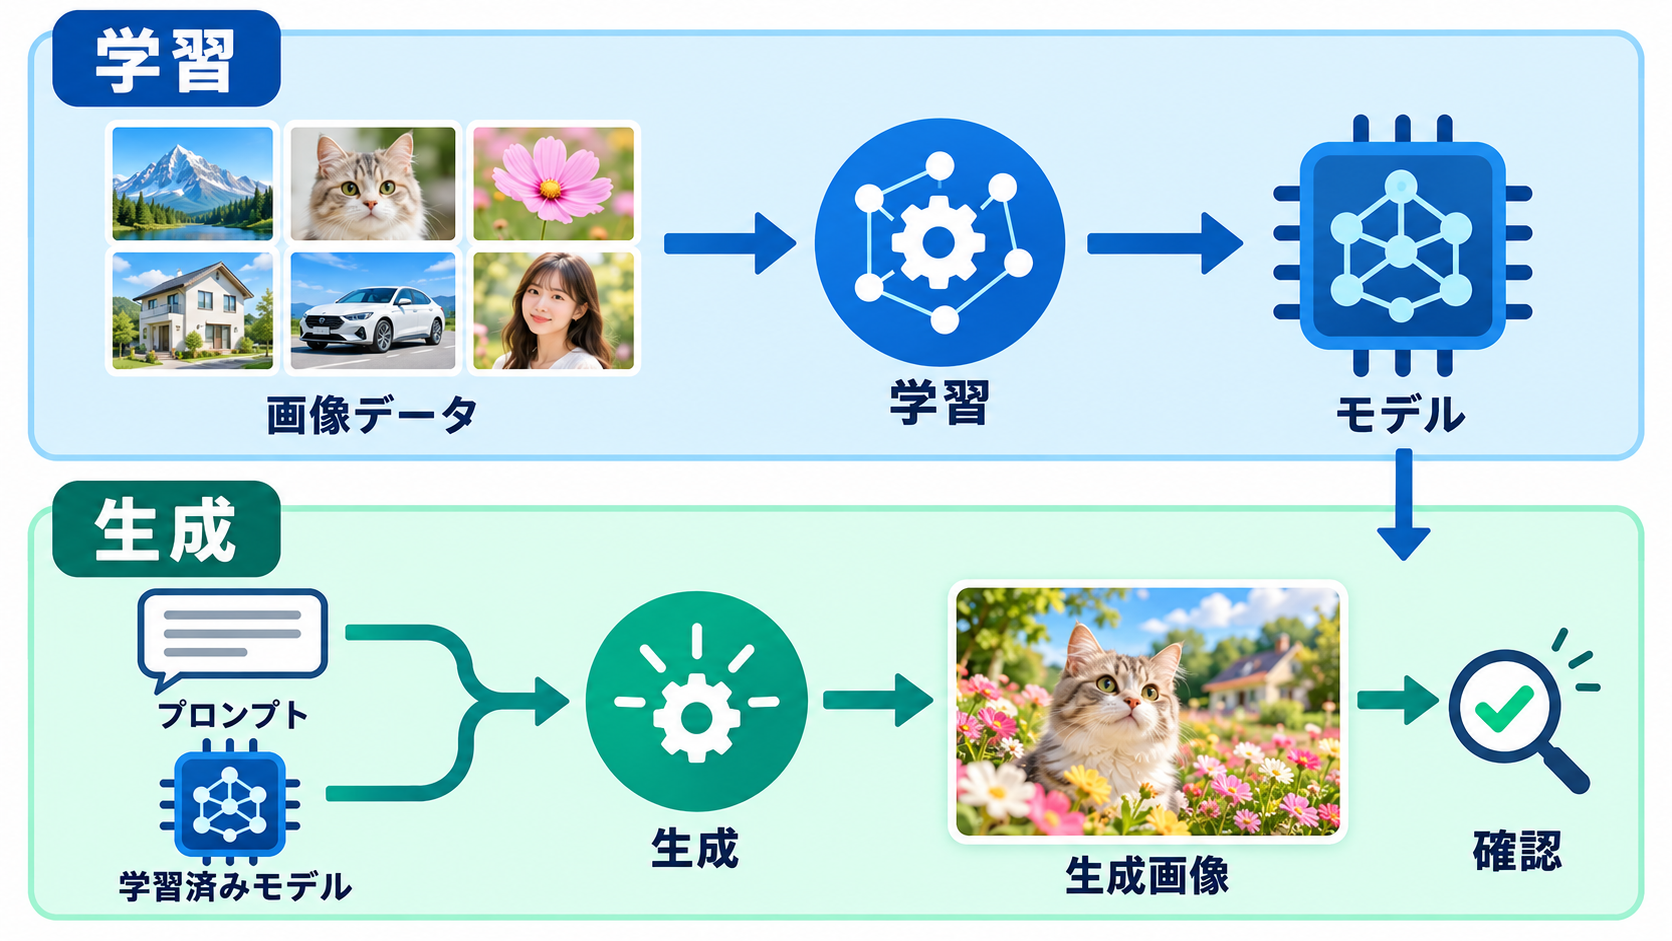
画像生成AIに依頼した瞬間、インターネット上の画像を探して学習し直していると思う人もいるかもしれません。しかし、学習と生成は分けて考える必要があります。学習は、モデルを作るために大量のデータからパターンや関係を取り込む段階です。生成は、作られたモデルがプロンプトを受け取り、その内部表現を利用して出力を作る段階になります。
Google Cloudは、機械学習モデルを、アルゴリズムを訓練用データに適用した結果、つまりプログラムが学んだものと説明しています(出典: Google Cloud)。IBMの説明では、基盤モデルは大量の関連データを使った学習によって作られ、データ内の対象、パターン、関係を表す多数のパラメーターを持ちます(出典: IBM)。パラメーターは、学習で調整される内部の数値と捉えれば十分です。画像を一枚ずつ並べたアルバムとは性質が異なります。
| 段階 | 何をするか | 身近なたとえ |
| --- | --- | --- |
| 学習 | 多くのデータから特徴や関係をモデルへ反映します | さまざまな料理を見て味や組み合わせの傾向を覚える段階です |
| 生成 | 学習済みモデルが依頼に応じて出力を作ります | 覚えた傾向を手がかりに注文に合う一皿を組み立てる段階です |
| 確認 | 出力が目的や条件に合うか人が確かめます | 盛り付けや材料が注文どおりか確認する段階です |
この料理のたとえにも限界があります。AIが味を感じたり、完成図を頭に思い浮かべたりするわけではありません。あくまで、学習と生成を混同しないための置き換えです。また、学習データが多ければ、どの依頼にも必ず正確に応えられるという意味にもなりません。Google Cloudの資料には、モデルは訓練でより多くのデータに触れながら性能を高めるという説明がありますが、個々の生成結果の正しさや利用目的への適合を保証するものではないからです(出典: Google Cloud)。
「いま画像を作る処理」と「モデルを作った過去の学習」を分けるだけで、AIへの見方は変わります。生成画面で入力文を直すことは、通常、基盤モデル全体を一から学習させ直すこととは別の操作です。読者が覚えておきたいのは、モデルが学習済みの傾向を利用して回答していること、そして目の前の出力は学習データそのものではなく、生成段階で作られた結果だという区別です。
プロンプトは完成図ではなく生成条件
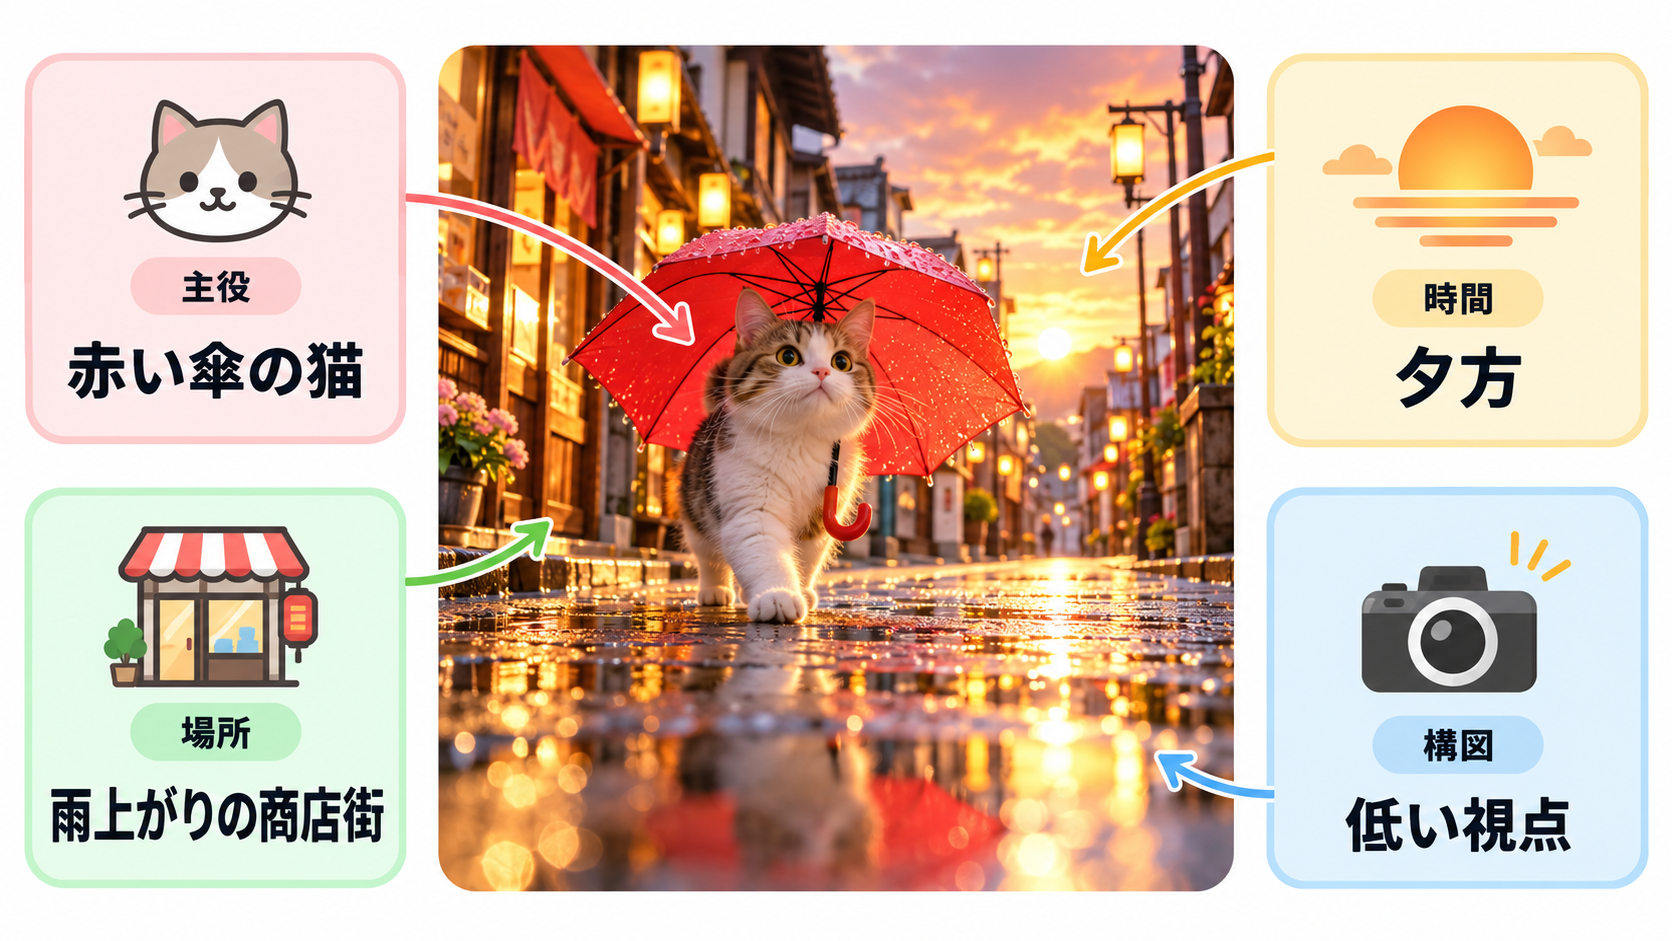
プロンプトとは、生成AIへ渡す依頼や指示です。IBMは、生成AIを、利用者のプロンプトや要求に応じて文章、画像、映像、音声などを作る深層学習モデルとして説明しています(出典: IBM)。画像生成では、「何を描くか」だけでなく、場所、時間帯、色合い、視点などを言葉にすると、作りたい方向を伝えやすくなります。ただし、プロンプトは設計図を一画素ずつ指定するものではありません。
たとえば、架空の作例として「雨上がりの商店街を歩く赤い傘の猫、夕方、店の明かりが水たまりに映る、低い視点」と依頼するとします。「猫」が主役、「雨上がりの商店街」が場所、「夕方」が時間、「水たまりへの反射」が光景、「低い視点」が構図の条件です。これはプロンプトの組み立て方を示す提案例であり、特定のサービスで同じ結果が出ることを保証するものではありません。
長く書けば必ず良くなるとも限りません。依頼の中心が曖昧なまま形容語を増やすと、自分でも優先順位を判断しにくくなります。初めて試すなら、「主役」「場所」「雰囲気や色」「構図」の四つに分け、必要な条件だけを一文にする方法が扱いやすいでしょう。結果を見た後は、すべてを書き換えず、「傘を画面の中央にする」「背景を昼にする」など、確かめたい条件を一つずつ変える進め方を提案できます。
ここでも、AIが言葉を人間と同じ意味で理解していると考えないことが大切です。モデルは、学習したデータに含まれるパターンや関係を利用して、入力と出力を結び付けます。プロンプトに書いた意図が、そのまま読み取られるとは限りません。曖昧な言葉を使う場合は、何をもって成功とするのかを利用者側で決めておくと判断しやすくなります。「明るい画像」なら、色を明るくしたいのか、楽しい場面にしたいのかを分ける、といった具合です。
「画像をコピーして貼る」という誤解との距離
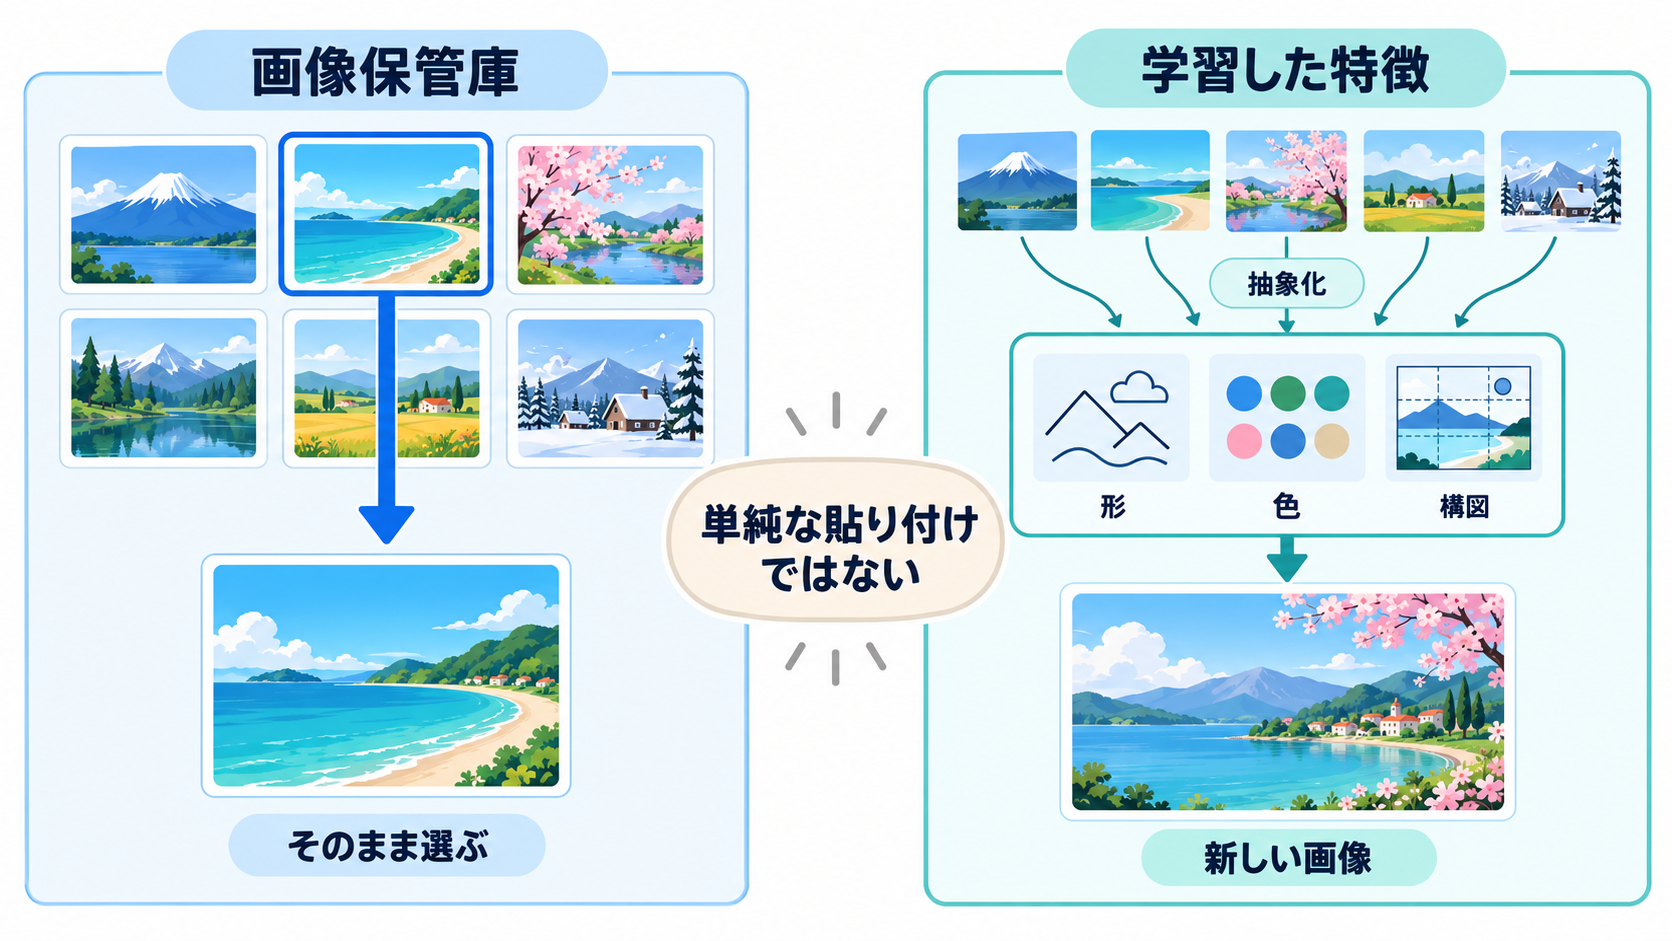
画像生成AIについて、「学習した画像を切り貼りしているだけ」と説明されることがあります。少なくとも今回の公式資料が示す基本像は、それとは異なります。IBMは、生成モデルが学習データの単純化された表現を符号化し、その表現を基に、元のデータと似ていても同一ではない新しい成果物を作ると説明しています(出典: IBM)。拡散モデルについても、画像が分からなくなるまでノイズを加え、それを取り除いてプロンプトに応じた画像を生成する仕組みとして紹介されています。
身近なたとえなら、たくさんの椅子を見た人が「座面、脚、背もたれにはさまざまな組み合わせがある」と傾向をつかみ、新しい椅子を考える場面に近いでしょう。見た椅子の写真を一枚選んで貼り付けるのではなく、得た傾向から形を組み立てます。ただし、AIには人間の観察や発想と同じ意識があるわけではなく、この説明も学習データと内部表現の違いを理解するための比喩です。
ここから「生成画像は必ず既存作品と異なり、権利上も問題がない」と結論付けることはできません。「同じ画像を検索して貼る仕組みではない」という基本説明と、個別の出力が既存作品にどの程度似ているか、どの条件で利用できるかという判断は別問題です。公開や業務利用を考える場合は、利用するサービスの規約、組織のルール、出力の内容を個別に確認する必要があります。これは資料にない保証をAIの仕組みから推測しないための実務上の提案です。
反対に、仕組みを難しく考えすぎて「どの画像とも無関係に、完全な無から作る」と捉えるのも適切ではありません。生成モデルは学習データから得た表現やパターンを利用します。保管画像の単純な貼り付けでも、何の学習にも依存しない創作でもない。その中間にある「データから関係を学び、生成時に条件へ応じて組み立てる」という見方が、誤解を避ける助けになります。
生成された画像を受け取った後の確認項目
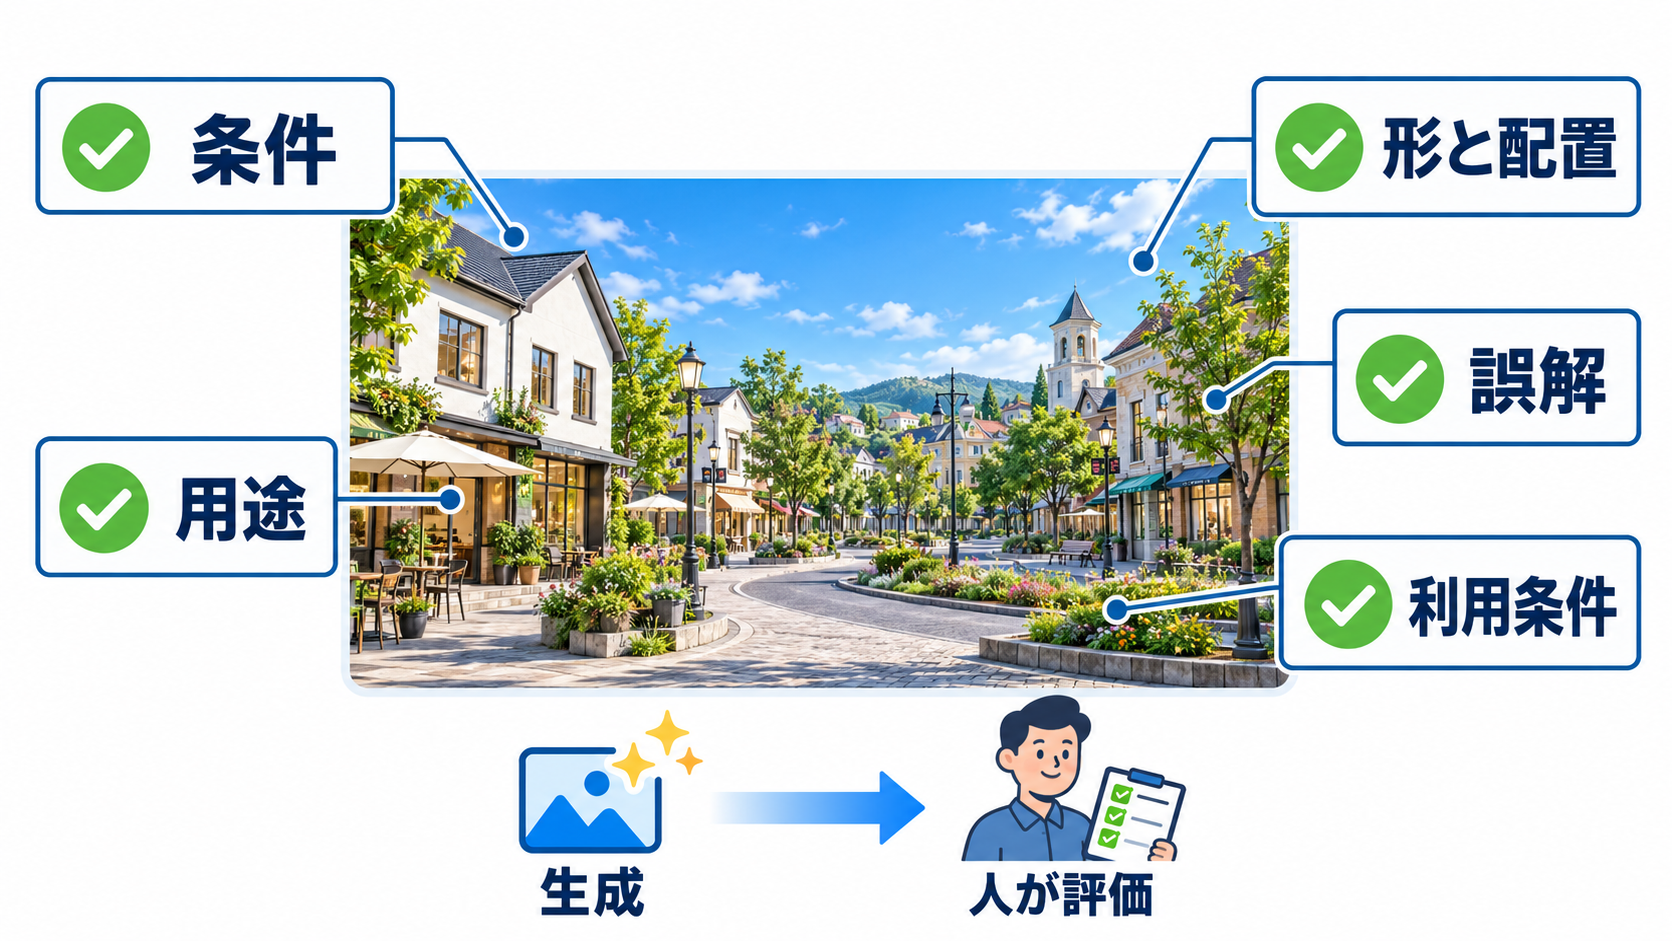
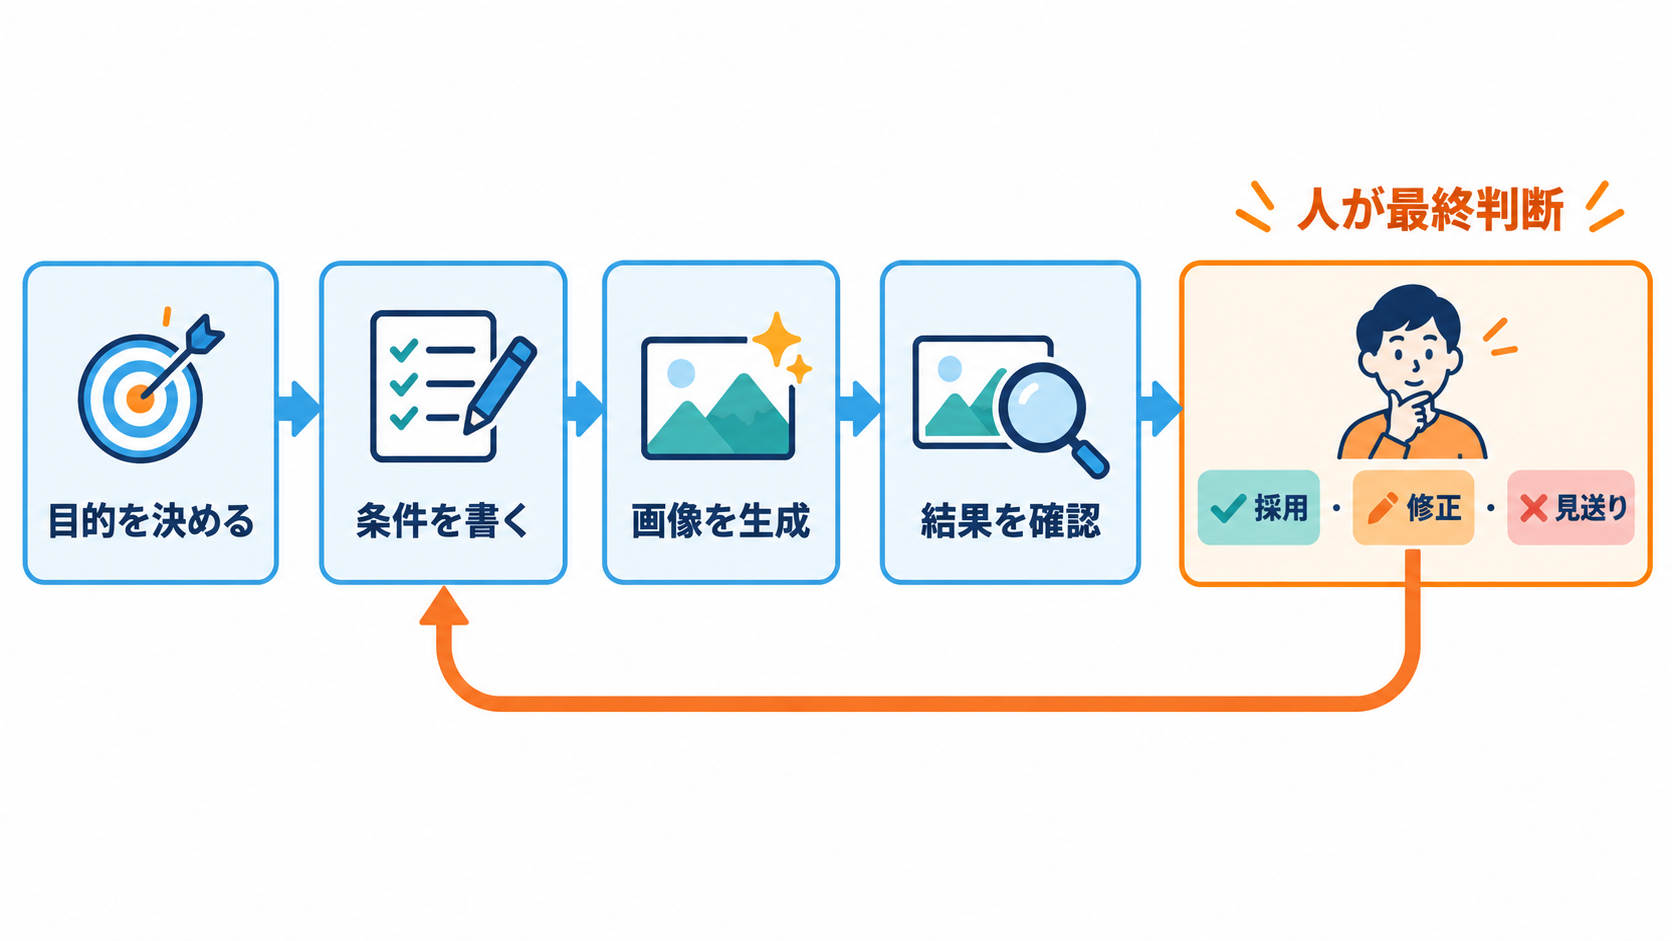
画像が表示された時点で作業を終えると、見栄えの良さに引っ張られて目的とのずれを見落としがちです。生成AIの出力は、利用者が求めた条件を必ず満たすと公式資料が保証しているわけではありません。IBMの説明でも、生成AIの運用には生成、評価、追加調整という段階があり、開発者や利用者が出力を継続的に評価するとされています(出典: IBM)。初心者にとっても、「生成」と「採用」を別の判断にすることが出発点になります。
確認では、絵が上手に見えるかだけでなく、依頼した目的へ戻ります。次の項目は、画像を採用する前の確認方法としての提案例です。
- 主役、場所、時間帯など、必要な条件が反映されているかを確認します。
- 物の形や位置関係に、不自然または説明しにくい部分がないかを見ます。
- ポスターなどに使う場合は、文字を置く余白や構図が用途に合うかを確かめます。
- 実在の人物、商品、場所を示す資料として誤解されないかを考えます。
- 公開や業務利用の前に、サービスの利用条件と組織内の確認手順を調べます。
事実を伝える画像として使う場合は、特に慎重さが必要です。生成された画像が写真らしく見えても、その場面が実際に存在したことの証拠にはなりません。「災害現場の記録」「製品の正確な外観」「歴史上の出来事」のように、現実との一致が重要な用途では、生成画像を資料写真の代わりに扱わず、信頼できる一次資料を別に確認する運用が考えられます。これは画像の美しさではなく、利用目的に対する適否の問題です。
修正するときは、気になる箇所を一度に全部変えるより、目的に直結する条件から見直すと比較しやすくなります。たとえば、社内イベントの案内画像なら、最初に「明るい雰囲気」ではなく「参加者が集まる場面が主役」といった中心条件を確かめます。その後に色や背景を調整する流れです。AIの出力を答えとして受け取るのではなく、検討材料として評価する姿勢が、画像生成を扱う際の基本になります。
明日から変えられる画像生成AIの見方
拡散モデルの細かな数式を覚えなくても、画像を見る目は変えられます。覚えておきたい一言は、「学習したパターンを使い、ノイズから条件に合う画像を段階的に組み立てる」です。ここに、学習と生成は別の段階であること、プロンプトは完成図ではなく条件であること、生成後には人が確認することを加えれば、基本的な判断の軸がそろいます。
画像生成AIを初めて使う場面では、次の小さな試し方が考えられます。実在の人物や重要な業務資料を題材にせず、「雨の日の架空の喫茶店」のような検証しやすい題材を選びます。主役、場所、色、構図の四条件を短く書き、生成結果のどこに反映されたかを確認してください。続けて一条件だけ変え、画像が目的に近づいたかを比べます。これは操作結果を保証する手順ではなく、プロンプトと出力の関係を観察するための提案です。
結果を見るときには、「AIは何を考えたのか」ではなく、「入力した条件と、学習済みモデルが作った出力の間に、どのような対応が見えるか」と問い直します。擬人化を避けると、期待どおりでない結果にも対処しやすくなります。AIの気持ちを推測する必要はありません。条件が曖昧だったのか、画像のどこが用途に合わないのかを具体的に言葉にすれば、採用、修正、見送りを判断できます。
次に画像生成AIの記事や製品説明を読むときは、「AI」「生成AI」「モデル」「拡散モデル」が同じ意味で使われていないかにも目を向けてください。技術全体の話と個別モデルの話を分けるだけで、説明の範囲を見極めやすくなります。そして、生成の仕組みを知る目的は、AIを無条件に信用することでも、遠ざけることでもありません。依頼する条件と確認する責任を人の側に残したまま、どの用途なら検討材料として使えるかを決めることです。最初の一歩として、身近で架空の題材を一つ選び、生成前に「何を確認できたら採用候補にするか」を三つ書き出してみるとよいでしょう。
参考情報
- What Is Artificial Intelligence (AI)?(IBM、2024年8月9日公開、2026年10月2日更新、2026年10月31日取得)
- AI vs. Machine Learning: How Do They Differ?(Google Cloud、2026年10月31日取得)
- Machine Learning Glossary: Generative AI(Google for Developers、2026年10月31日取得)