
2026/10/31
今更聞けないAI知識
正解を教えないのに、なぜ上達する?「強化学習」を得点ゲームで理解する
正解の分からない場面でAIはどう学ぶのか
初めて訪れた駅で、最短の出口を探す場面を想像してみてください。曲がり角ごとの正解は分かりませんが、出口に近づいたか、遠回りしたかは後から判断できます。何度か経路を試せば、うまくいきやすい選び方が少しずつ見えてくるでしょう。
強化学習も、これに似た考え方で説明できます。一言でいえば、行動した結果として得られる「報酬」を手がかりに、よりよい行動の選び方を学ぶ方法です。ここでいう報酬は、お金や賞品に限りません。学習のために設定された得点のような信号を指します。IBMの資料では、強化学習は隠れたパターンから情報を取り出す方法ではなく、試行錯誤と報酬関数によって学ぶ方法として説明されています。(出典: IBM)
AIという言葉は広い範囲を指し、その中にはデータから規則性を学ぶ機械学習があります。Google Cloudも、AIを幅広い概念、機械学習をデータから知識を取り出して学ぶAIの一分野として整理しています。(出典: Google Cloud)強化学習は、その機械学習に含まれる学び方の一つです。
大切なのは、強化学習には最初から各場面の正解が書かれた一覧表が必要とは限らない点です。代わりに、「その行動の結果はどれくらい望ましかったか」を得点で受け取ります。ただし、AIが人間のように成功を喜んだり、失敗を悔やんだりするわけではありません。得点を基に行動の選択ルールが調整される、と捉えるほうが正確です。
一言でいえば「行動して得点を受け取る学習」
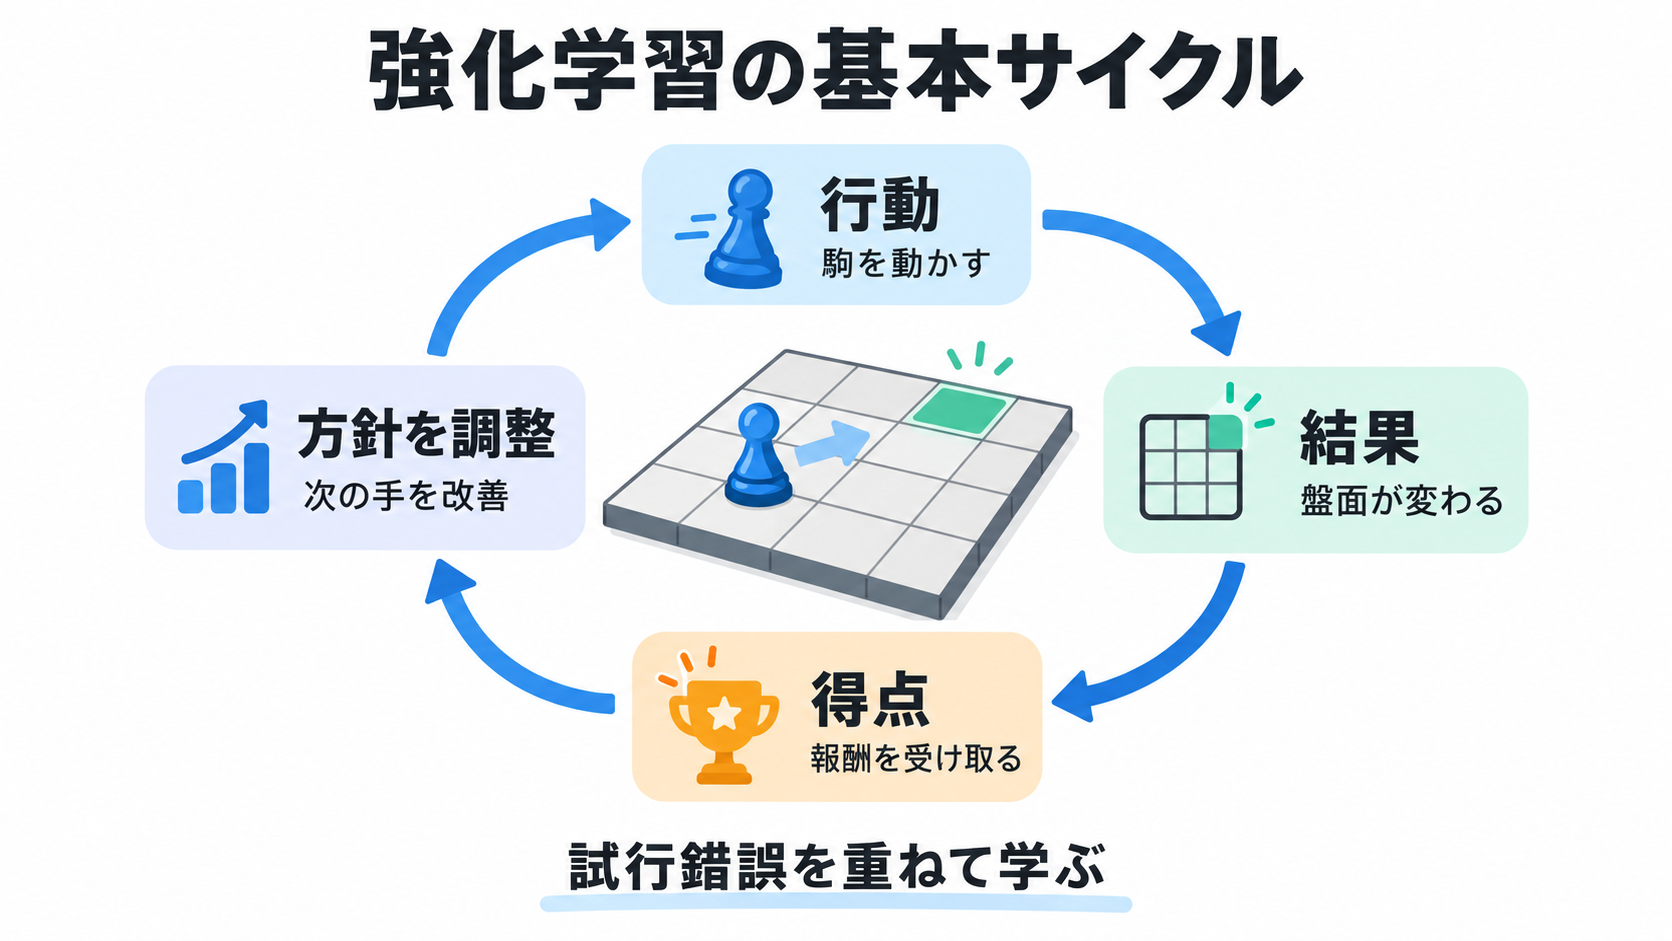
強化学習の中心には、「やってみる」「結果を受け取る」「次の選び方を変える」という循環があります。説明用の架空の例として、盤面上でゴールを探す駒を考えてみましょう。駒には上下左右へ進む選択肢があり、ゴールに着くと得点を受け取る設定です。何度も試すうちに、ゴールへ到達しやすい行動の選び方が形成されていきます。
この選び方は「方策」と呼ばれます。方策とは、現在の状況に応じて、どの行動を選ぶかを定めるルールです。Google for Developersの用語集では、強化学習のエージェントは方策を使い、環境の状態が移り変わる中で、期待されるリターンを最大にする主体として説明されています。(出典: Google for Developers)リターンは、目先の一点だけではなく、その後に得られる報酬も考えた成果の見込みとして捉えると分かりやすいでしょう。
ここで「学習」と「回答や行動」を分けて考えると、混乱が減ります。学習は、試行錯誤の結果を使って方策を調整する工程です。回答や行動は、その時点で形成されている方策やモデルを使って出力を決める工程になります。Google Cloudは、機械学習モデルを、訓練データに対してアルゴリズムを実行した結果としてプログラムが学んだもの、と説明しています。(出典: Google Cloud)
したがって、AIが何かを出力するたびに、必ずその場で学習しているとは限りません。「学習済みのルールを使っている場面」と「ルール自体を調整している場面」は別々に確認する必要があります。この区別を持つだけでも、「使えば使うほど、その場ですぐ賢くなる」という誤解を避けやすくなります。
状況・行動・報酬をつなぐ仕組み
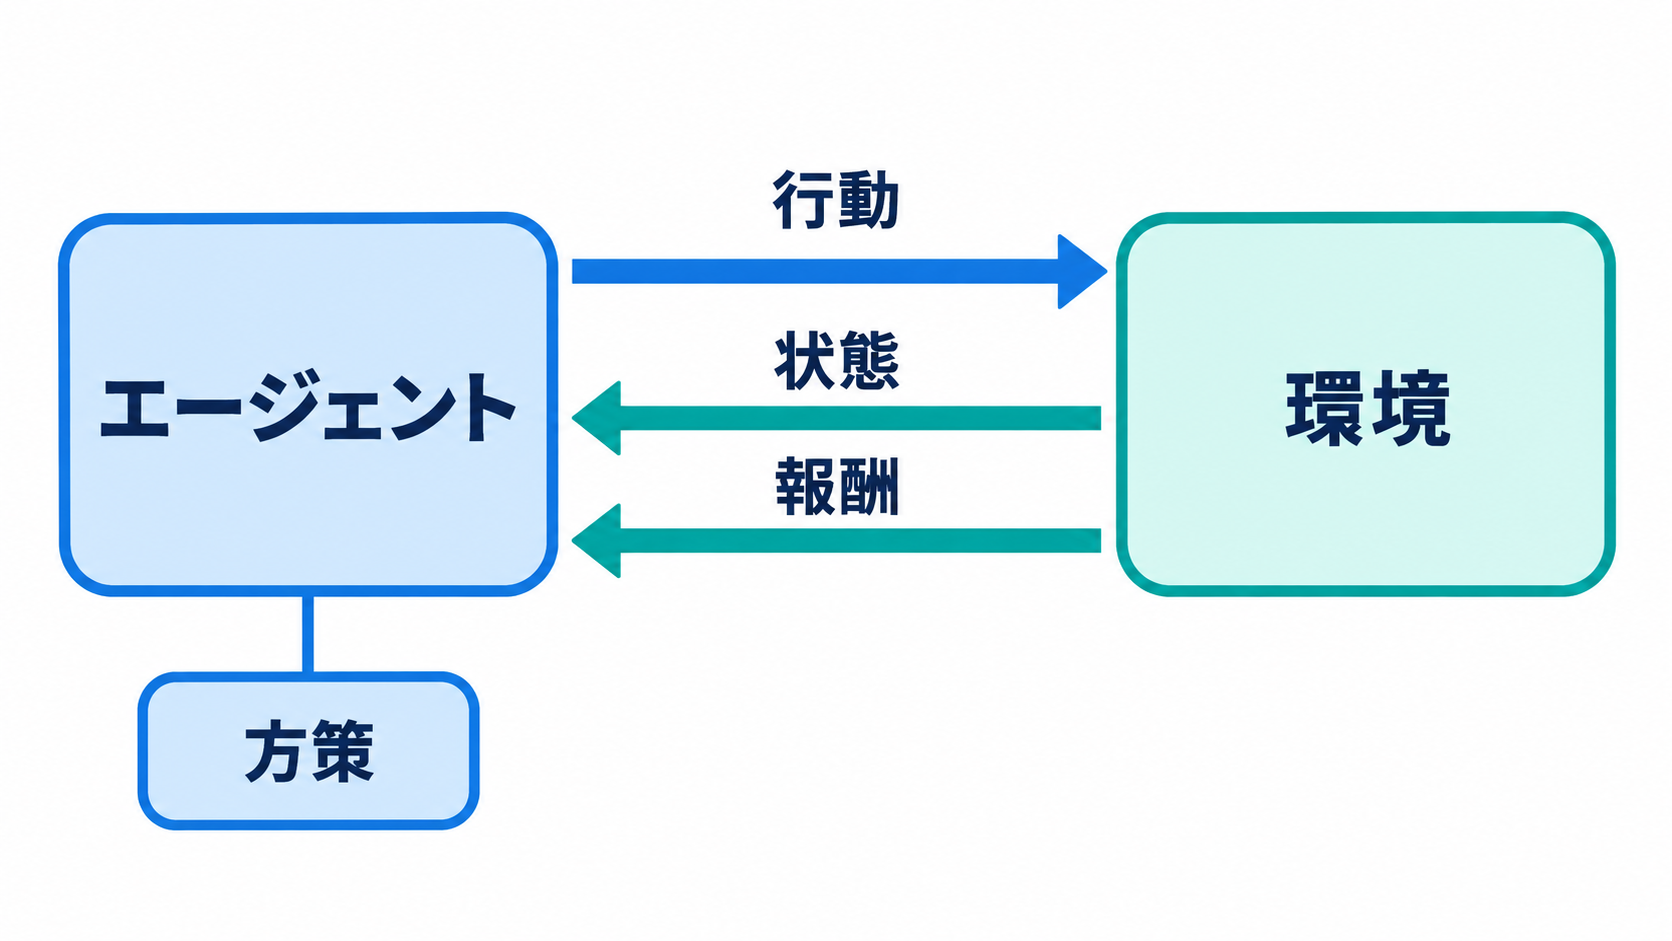
強化学習の流れは、エージェント、環境、状態、行動、報酬という五つの言葉で整理できます。エージェントは行動を選ぶ側、環境は行動の対象となる周囲の仕組みです。状態はその時点の状況を表し、行動によって環境や状態が変わります。その結果として渡される評価の信号が報酬です。(出典: Google for Developers)
説明用の架空の迷路なら、次のような循環になります。
1. エージェントは、現在地や周囲の通路という状態を受け取ります。
2. 方策に基づき、前進や右折などの行動を選びます。
3. 環境が変化し、新しい位置と報酬が返されます。
4. 得られた結果を手がかりに、行動の選び方を調整します。
5. 別の状態でも同じ流れを繰り返します。
迷路の分岐ごとに「ここでは右が正解です」という札が置かれているわけではありません。ゴールへ着いたという結果から、途中の選択を評価していくところに強化学習らしさがあります。目先では得点にならない移動でも、その先のゴールにつながる場合があるため、直後の報酬だけを追えばよいとは限りません。
「エージェント」という語にも注意が必要です。強化学習では、方策を使って環境内の行動を選ぶ主体を指します。生成AIの文脈では、利用者の依頼を分析し、外部の道具を使いながら行動を計画・実行するソフトウェアを指す場合もあります。(出典: Google for Developers)同じ言葉でも、強化学習の仕組みを説明しているのか、作業を代行するAIエージェントを説明しているのかを見分ける必要があるでしょう。
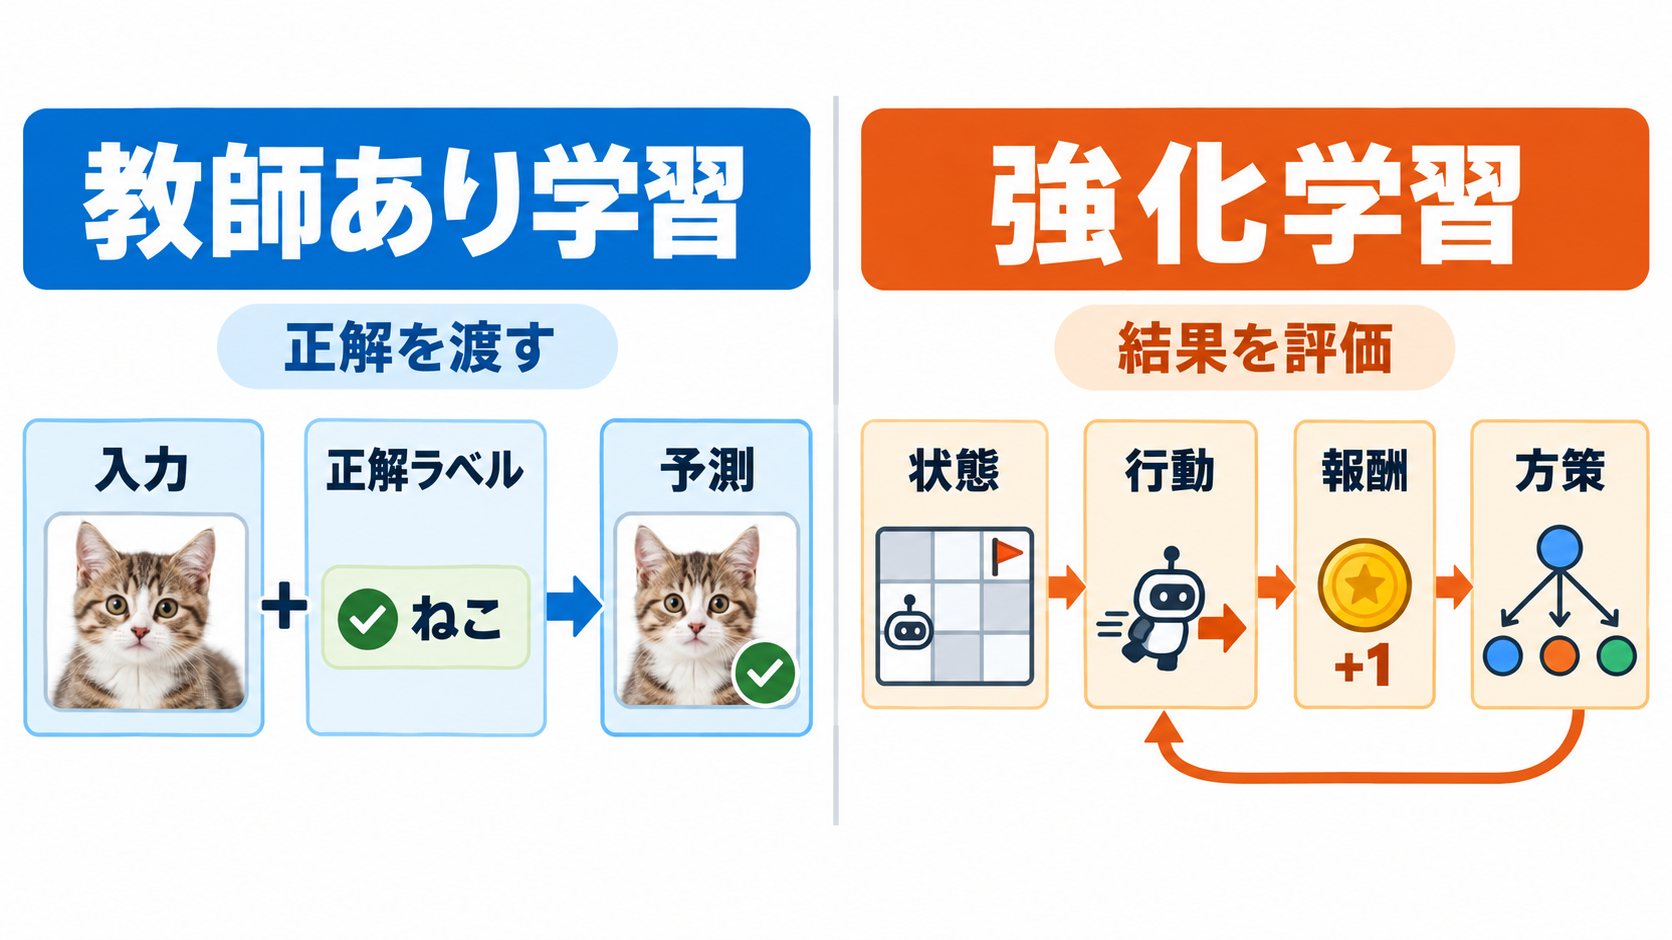
教師あり学習との違いは「正解の渡し方」
強化学習と混同されやすいのが「教師あり学習」です。教師あり学習では、人が訓練例と正解ラベルを組み合わせて用意し、入力から正しい出力を予測できるようにモデルを訓練します。IBMは、ラベル付きデータを使い、入力と出力の対応関係を学ぶ方法として教師あり学習を説明しています。(出典: IBM)
両者の違いは、学習中に何を手がかりとして渡すかを見ると整理できます。
| 観点 | 教師あり学習 | 強化学習 |
| --- | --- | --- |
| 主な手がかり | 入力例と正解ラベル | 行動後に得られる報酬 |
| 学び方 | 入力と正解の対応を学びます | 環境内で試行錯誤します |
| 学習結果の捉え方 | 分類や予測に使うモデルを作ります | 行動を選ぶ方策を調整します |
| 架空の例 | 写真に犬か猫かの正解を付けます | 迷路でゴールへの到達を得点にします |
強化学習にも、人間がまったく関わらないという意味ではありません。どのような行動を可能にするか、何を報酬として扱うか、どの環境で試すかは、学習の枠組みに関わる要素です。正解ラベルを一件ずつ渡さなくても、評価の基準まで自然に生まれるわけではないのです。
反対に、教師あり学習も単なる暗記とは限りません。学習した入力と出力の関係を使い、まだ見ていないデータのラベルを予測することが目標になります。(出典: IBM)「正解を教える教師あり学習」と「結果を得点で返す強化学習」という対比は便利ですが、どちらも設定された課題とデータの範囲内でモデルを調整する方法です。人間と同じ理解や目的意識を自動的に持つ、という説明ではありません。
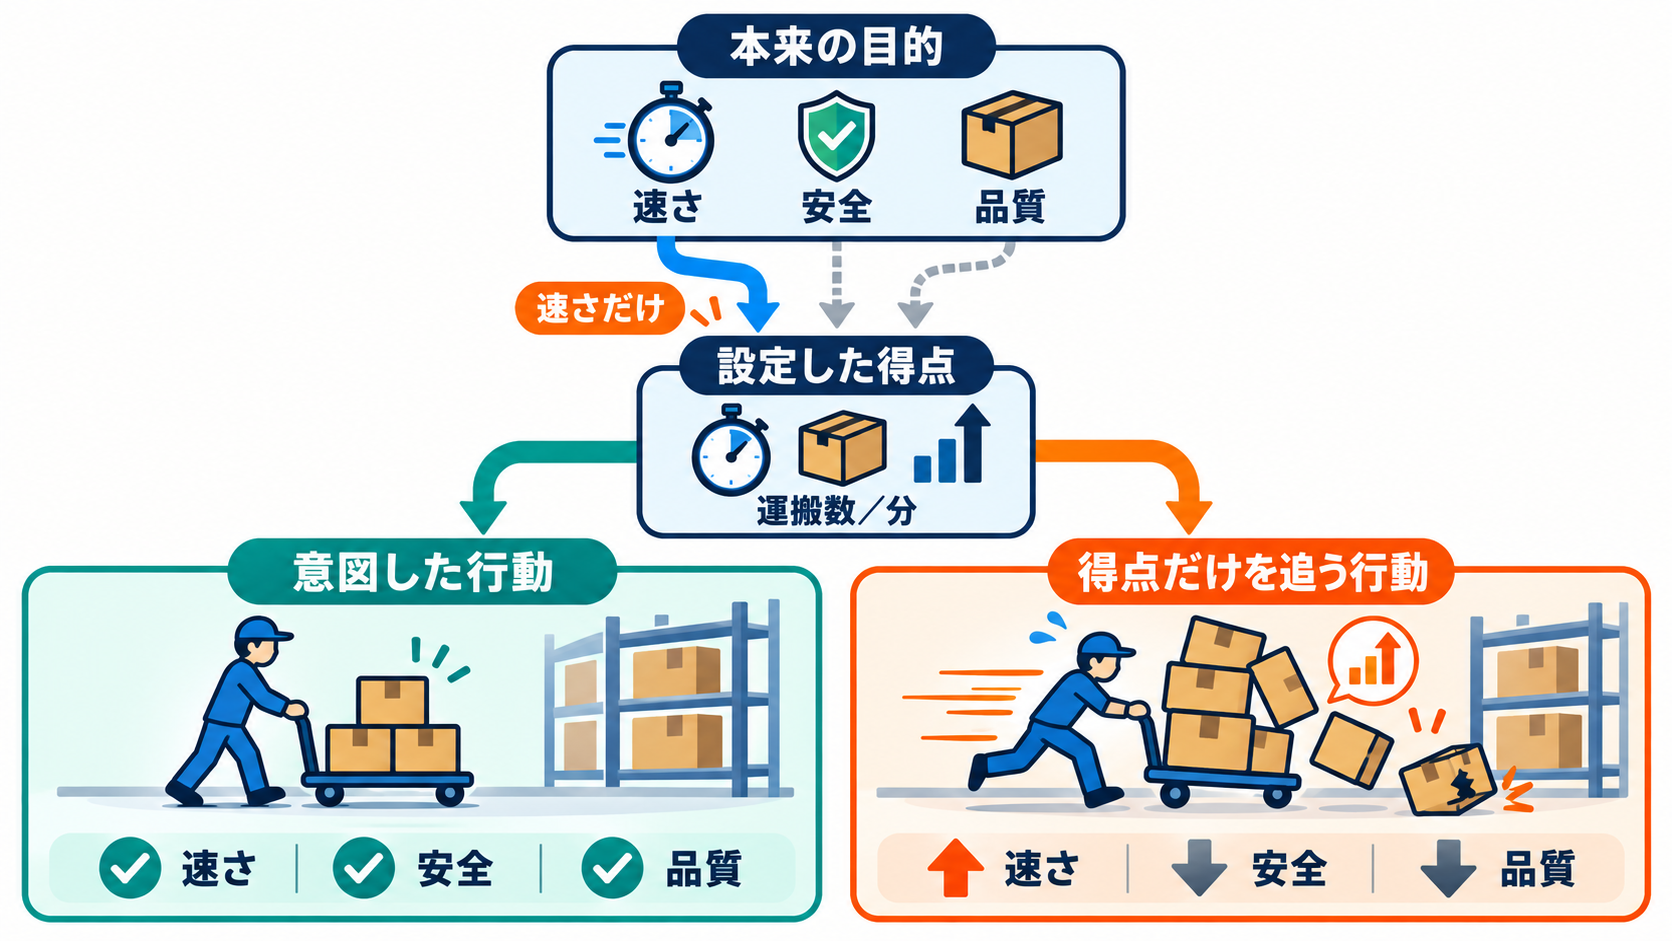
報酬のずれが意図しない行動につながる理由
強化学習では報酬が学習の手がかりになるため、得点の付け方と本来の目的が一致しているかが重要です。方策が期待されるリターンを高めるように使われるという定義から考えると、測定される得点が目的の一部しか表していなければ、得点上は有利でも人間の意図には合わない行動が選ばれる可能性があります。(出典: Google for Developers)
架空の思考実験として、倉庫内で荷物を運ぶ仕組みに「運んだ個数」だけを得点として与える場合を考えます。本来の目的には、安全に運ぶことや荷物を傷つけないことも含まれているかもしれません。しかし、それらが評価に反映されなければ、個数を増やす選び方だけが有利になるおそれがあります。これは実在する製品の挙動を示す例ではなく、報酬と目的の関係を理解するための単純化した例です。
人間の目標は、「速く、正確に、安全に、周囲へ迷惑をかけずに」のように複数の条件を含みがちです。それを一つの得点に置き換えると、含め忘れた条件が生まれます。AIが指示に反抗したというより、与えられた評価方法と、本当に望んでいた結果の間にずれがあったと見るほうが仕組みに沿っています。
報酬を考えるときは、「増やしたい数値」だけでなく、「その数値だけを追うと何が抜け落ちるか」も確認するとよいでしょう。たとえば、望ましくない近道がないか、極端な状況でも評価が妥当か、得点は高いのに人が受け入れにくい結果がないか、という問いを置けます。これらは特定製品の操作手順ではなく、仕組みを点検するための提案です。強化学習を理解する鍵は、試行錯誤の回数よりも、何を成功として数えているかを見ることにあります。
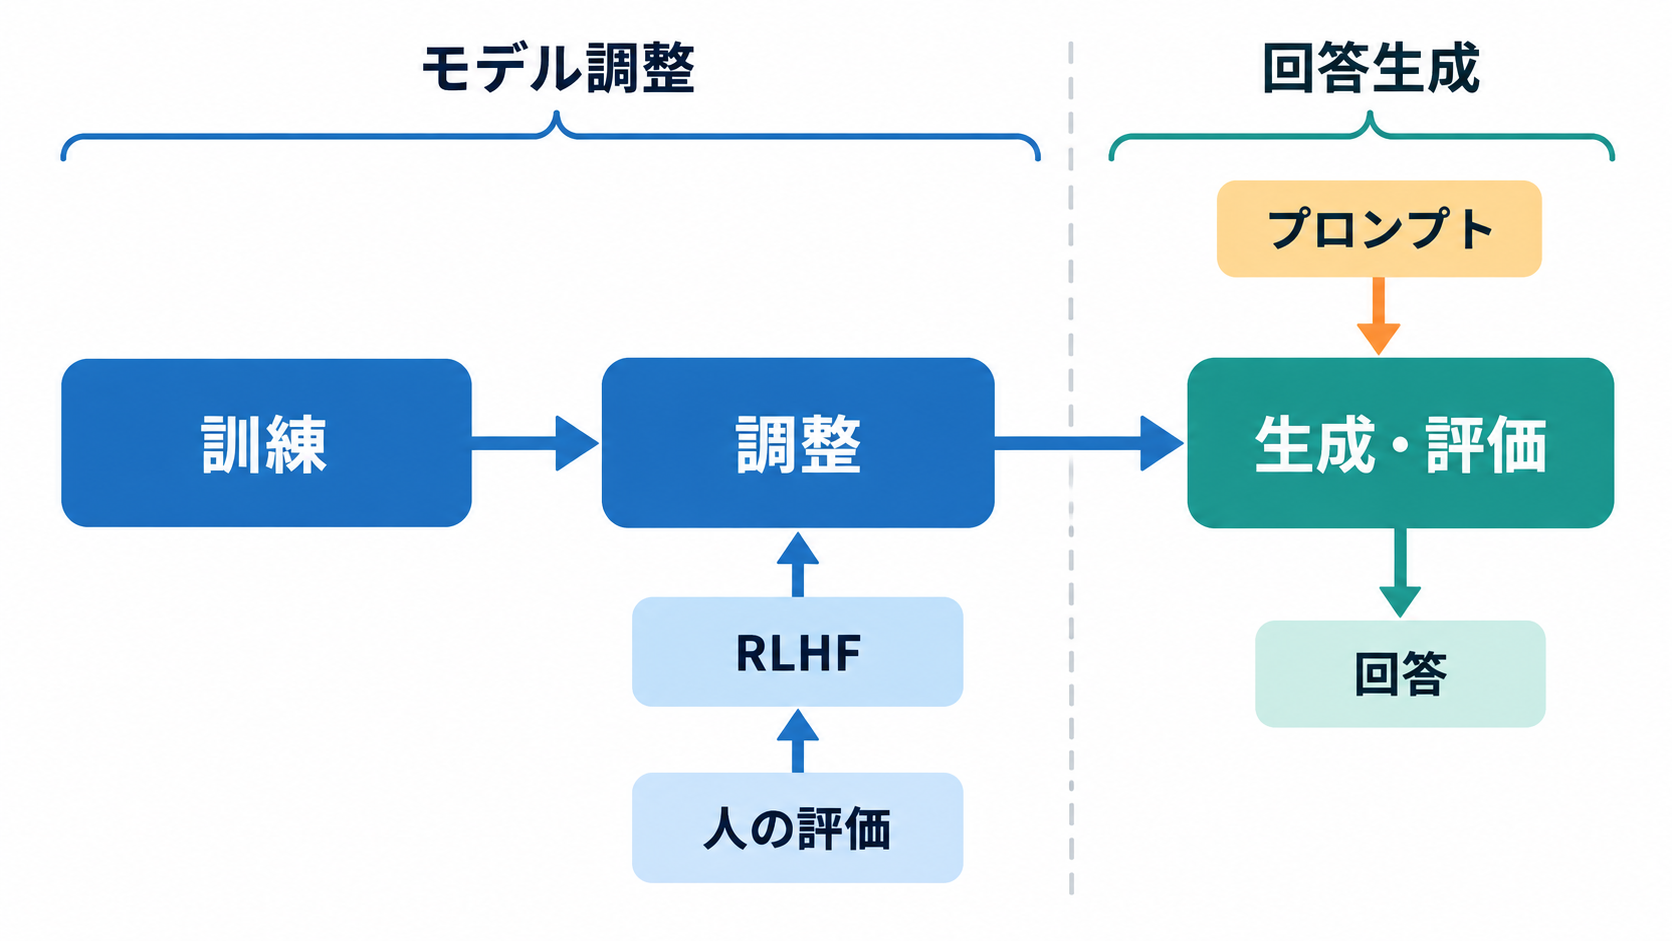
生成AIとの接点は「回答時」より「調整時」
文章や画像を作る生成AIと強化学習は、同じ意味ではありません。IBMは、生成AIを、利用者のプロンプトや依頼に応じて文章、画像、音声などのコンテンツを作る深層学習モデルとして説明しています。また、生成AIの大まかな工程を、基盤モデルの訓練、用途に合わせた調整、生成と評価、その後の追加調整に分けています。(出典: IBM)
このうち強化学習との接点として挙げられているのが、「人間のフィードバックによる強化学習」です。英語の頭文字からRLHFと呼ばれる方法で、人がモデルの出力について正確さや関連性を評価し、その評価をモデルの改善に使います。IBMの資料では、チャットボットや仮想アシスタントへの訂正も、人間から評価を得る例として紹介されています。(出典: IBM)
ただし、利用者がプロンプトを一度入力し、生成AIが回答を返す場面そのものを、すべて強化学習と呼ぶわけではありません。プロンプトは生成時の依頼であり、強化学習は報酬を手がかりに行動の選び方を調整する学習方法です。入力文を詳しく書いて回答を変えることと、モデルや方策の学習を行うことは、分けて捉える必要があります。
「低い評価ボタンを押したので、そのAIが直ちに自分専用に学び直した」といった理解も、資料にない製品仕様まで推測してしまいます。実際に評価がどのように保存され、いつ何の調整に使われるかは、サービスごとの説明を確認しなければ分かりません。基礎知識として押さえたいのは、人間の評価を報酬の手がかりに使う調整方法があることと、目の前の回答生成は学習工程と同一ではないことです。
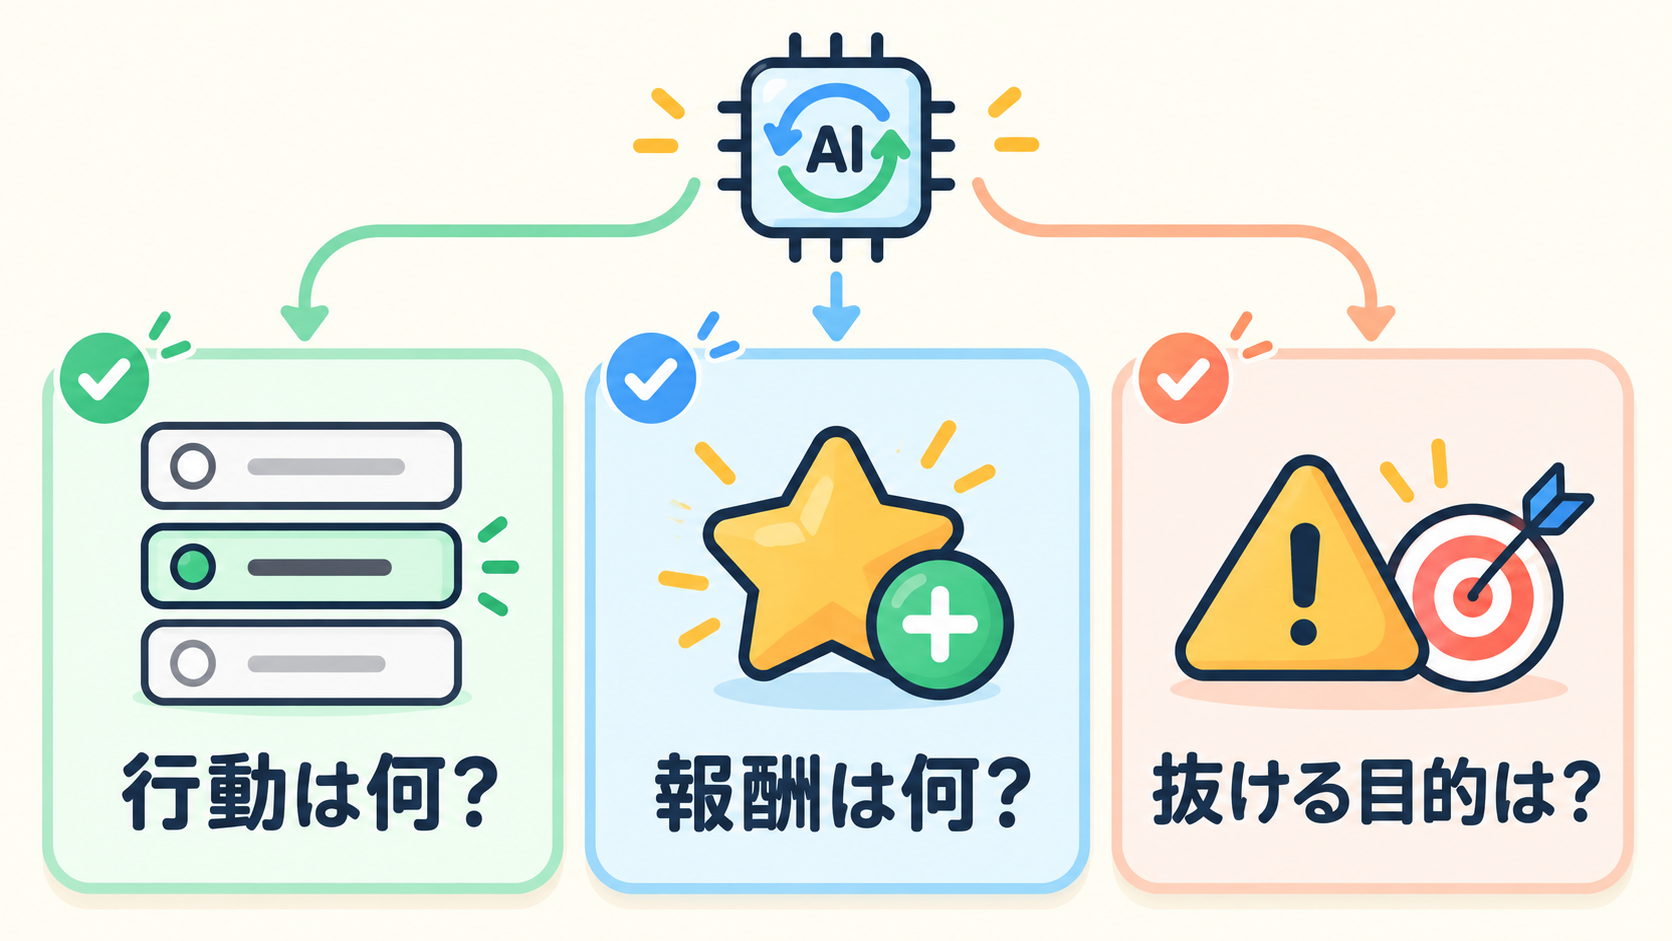
「AIが学ぶ」を見分けるための三つの問い
強化学習という言葉を覚えた後に役立つのは、用語を暗記することより、「AIが学習する」という説明を具体的に読み解く視点です。製品紹介やニュースで学習という表現を見かけたら、何を試し、何を結果として受け取り、何を改善するのかを確認してみてください。強化学習ではない仕組みまで、無理に得点ゲームとして捉える必要はありません。
確認の入口になるのは、次の三つの問いです。
- 選べる「行動」は何でしょうか。移動方向、回答候補、操作手順など、学習対象となる選択を確認します。
- 「報酬」は何を高く評価するのでしょうか。速さ、正確さ、人の評価など、成功を表す信号を探します。
- 報酬だけを追ったときに、抜け落ちる目的はないでしょうか。安全性や品質など、数値に入りにくい条件にも目を向けます。
明日から試せる練習として、AI製品を操作する必要はありません。たとえば「会議資料を期限までに準備する」という身近な仕事を取り上げ、行動、得点に相当する評価、得点だけでは表せない条件を書き出してみます。完成時刻だけを評価すれば、内容の正確さや読みやすさが抜けるかもしれません。これは強化学習を実施する手順ではなく、報酬設計の難しさを日常の判断に置き換えるための例です。
強化学習を一言で捉えるなら、「正解を一件ずつ渡す代わりに、行動の結果を報酬として返す学習」です。そこから一歩進み、誰が何を成功と定めたのかまで見ると、AIの説明をうのみにせず判断できます。次に「試行錯誤で賢くなるAI」という表現を見たときは、まず報酬の中身を確かめてみてください。それが、仕組みと宣伝表現を切り分ける具体的な第一歩になります。
参考情報
- What Is Artificial Intelligence (AI)? — 2024年8月9日公開、2026年10月2日更新、2026年10月31日取得です。
- AI vs. Machine Learning: How Do They Differ? — 2026年10月31日取得です。提供資料には公開日の記載がありません。
- Glossar für maschinelles Lernen: Generative KI — 2026年10月31日取得です。提供資料には公開日の記載がありません。