
2026/10/31
AIニュース
Google・OpenAIらがAI学習クローラーの一括拒否へ、robots.txt新仕様が変えるコンテンツ管理
自社サイトの記事や製品情報が、どの生成AIの学習に使われているのかを把握し、事業者ごとに拒否設定を管理する作業は複雑です。Google、Microsoft、Anthropic、OpenAIが支持を表明した新たな提案は、この負担を単一の指定へ集約しようとしています。
AI学習の拒否設定を一つにまとめる新提案
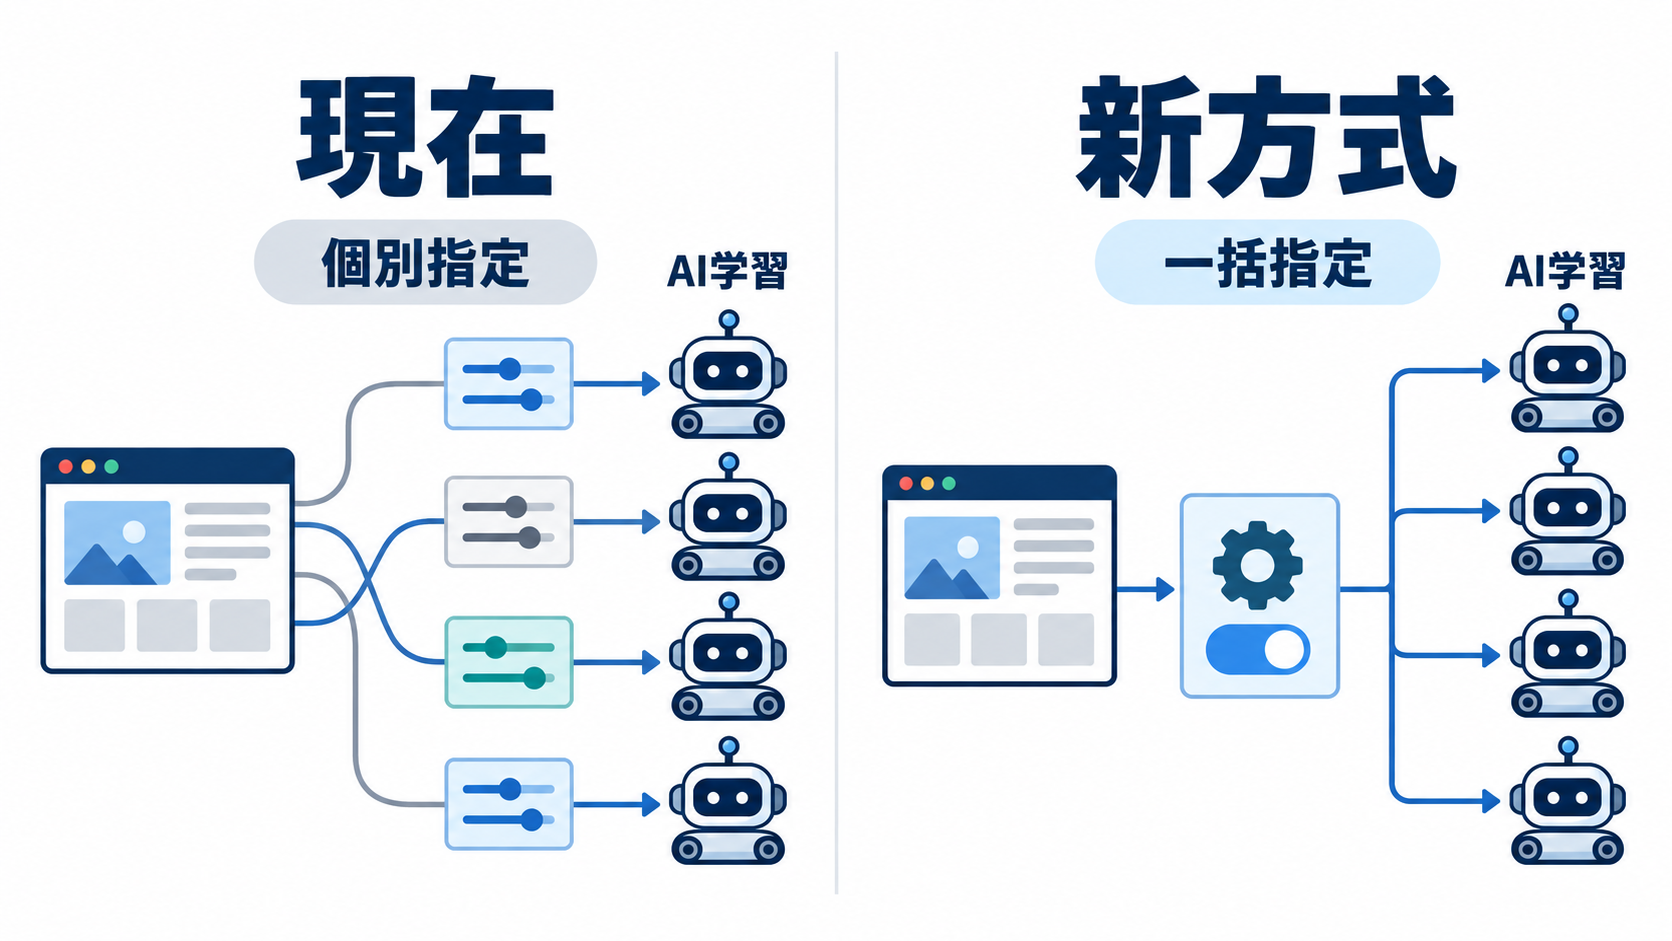
Google、Microsoft、Anthropic、OpenAIは、生成AIモデルの訓練を目的とするクローリングを、ウェブサイト運営者がまとめて拒否できる仕組みを支持すると発表しました。現在は、各AI事業者やクローラーを個別に指定する必要があります。複数の収集プログラムを使う事業者に対応する場合、その数だけ設定項目が増える構造です。
提案されている仕組みでは、`robots.txt`に一つの指定を加えることで、生成AIの訓練データを集めるクローラーを横断的に拒否できるようになります。個々の企業名やクローラー名を追い続けなくても、収集目的に基づいて意思を示せることがポイントです。ただし、生成を行わない処理だけに使われるモデルは対象外とされています。
企業にとっての意味は、設定行数が減ることだけではありません。広報、法務、情報システム、コンテンツ部門が決めた利用方針を、サイト全体へ一貫して反映しやすくなります。もっとも、これは現時点で提案段階の仕様です。支持表明と、標準化の完了、各社による実装、クローラー側での遵守は分けて捉える必要があります。新しい指定を置くだけで、あらゆるデータ取得が技術的に遮断されるわけでもありません。
robots.txtが担ってきた役割と現在の運用負担
`robots.txt`は、ウェブサイトを巡回するクローラーに対し、アクセスを認める範囲や避けてほしいページを伝えるテキストファイルです。サイト全体の収集を拒否するほか、特定のページだけを対象外にしたり、過度な頻度でアクセスしないよう求めたりできます。もともとは、検索エンジンとウェブサイトの関係を調整する用途で広く使われてきました。
生成AIの開発が広がると、検索インデックス作成だけでなく、モデルの訓練データを集めるクローラーへの対応も必要になりました。運営者が訓練目的の取得を拒む場合、AI事業者ごとに異なる識別名を確認し、`robots.txt`へ追加します。同じ事業者が複数のクローラーを使えば、それぞれを別に指定しなければなりません。新しい名称や事業者が増えるたびに、設定の見直しも発生します。
提案の中心は、こうした個別管理を「どの企業が取得するか」から「何の目的で取得するか」へ切り替えることです。目的別の共通指定が機能すれば、新たなクローラーが登場しても、訓練用途という分類に従って同じ方針を適用しやすくなるでしょう。
ただし、`robots.txt`は認証やアクセス権限管理と同じものではなく、クローラーに運営者の意思を伝えるための仕組みです。会員限定ページの保護や機密情報の管理を任せるものではありません。公開してはいけない情報には、認証、ネットワーク制御、適切な公開範囲の設定を別途用いる必要があります。
AI訓練と回答時の参照を分ける二層の制御
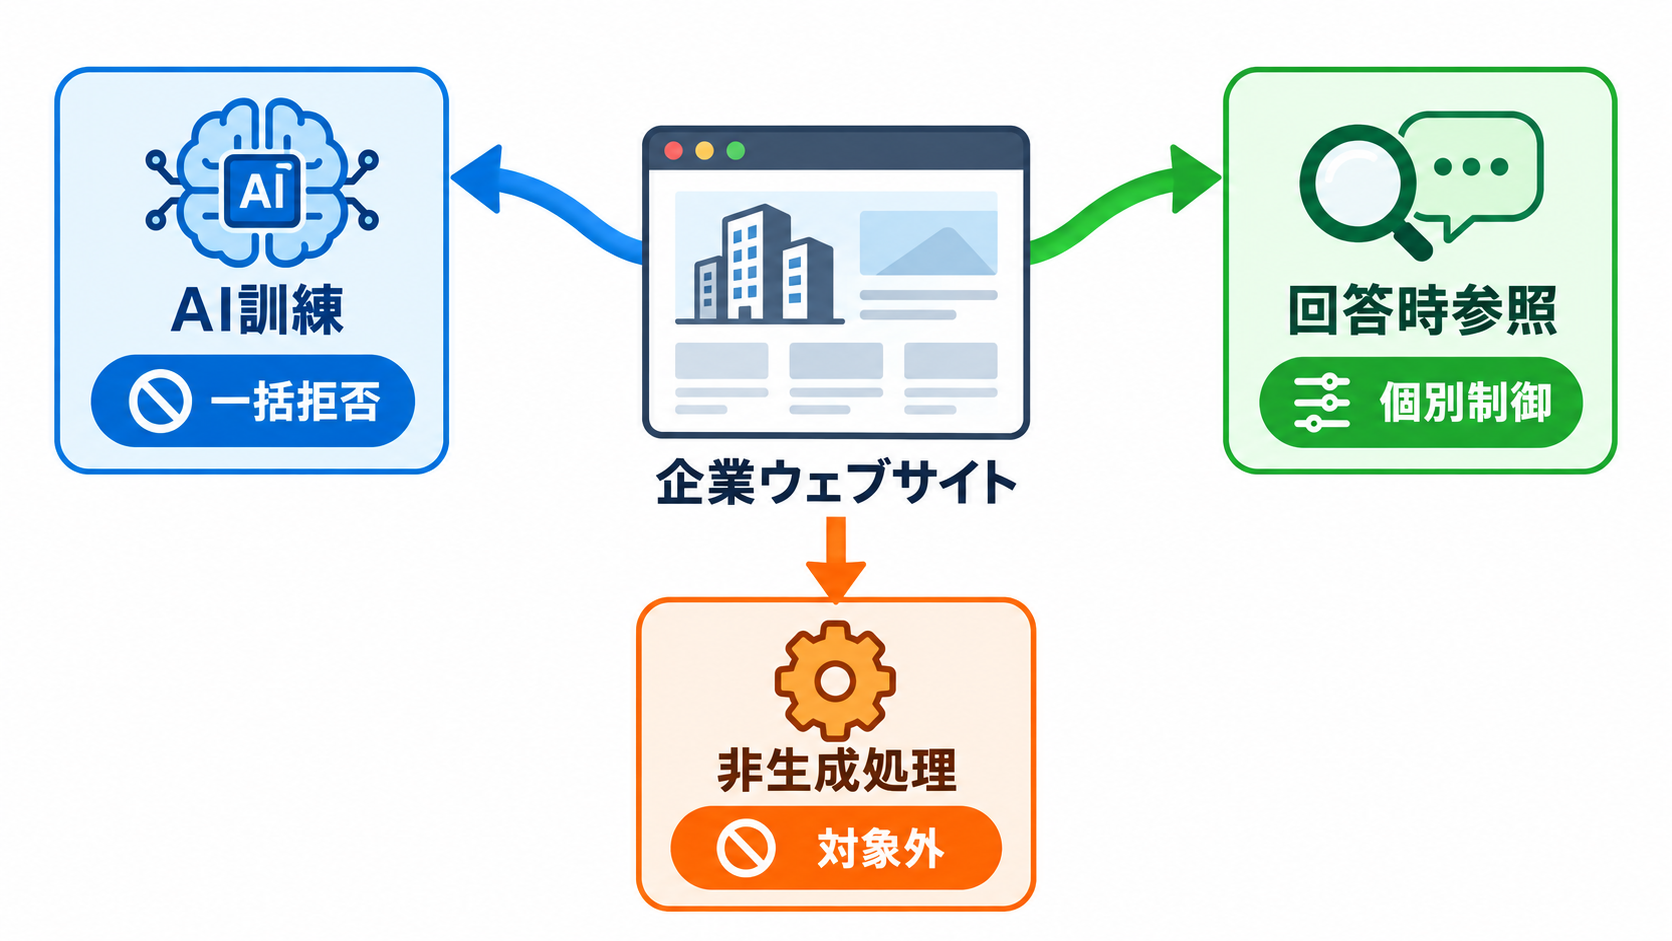
AIによるウェブ利用は、すべて同じ目的で行われるわけではありません。大量のコンテンツを継続的に収集してモデルの訓練に使う場面と、利用者から質問を受けた時点で関連ページを参照する場面では、取得の時期も企業側が期待する効果も異なります。今回の動きでは、この違いが設定体系に反映されようとしています。
| 利用区分 | 主な目的 | 今回示された制御の方向性 |
| --- | --- | --- |
| 生成AIの訓練 | モデル開発用のデータ収集 | 共通の指定で一括拒否 |
| 回答時の参照 | 利用者の質問に答えるためのページ取得 | AI Groundingなどの個別制御 |
| 非生成タスク | 生成を伴わない処理 | 共通の訓練拒否設定の対象外 |
Microsoftは、回答を作る際にウェブページへアクセスする処理を制御する「AI Grounding」という設定も提供する方針です。この設定により、Microsoftのサービスが回答時の参照リクエストを送ることをサイト側で拒否できるようになります。Microsoftの技術を利用してプロンプトを処理する第三者のAIツールにも適用される予定です。OpenAIも、同様の制御を提供する計画を示しています。
この区別は、法人サイトの方針を決めるうえで欠かせません。訓練利用は望まなくても、利用者の質問に対する回答で自社の製品ページが参照されることには価値を見いだす企業があります。逆に、更新頻度の高い情報や契約者向け情報では、回答時の取得も抑えたい場合があるでしょう。「AIを許可するか拒否するか」という一択ではなく、訓練と回答時参照を分けて判断する設計が求められます。
IETFへの草案提出と標準化までの距離
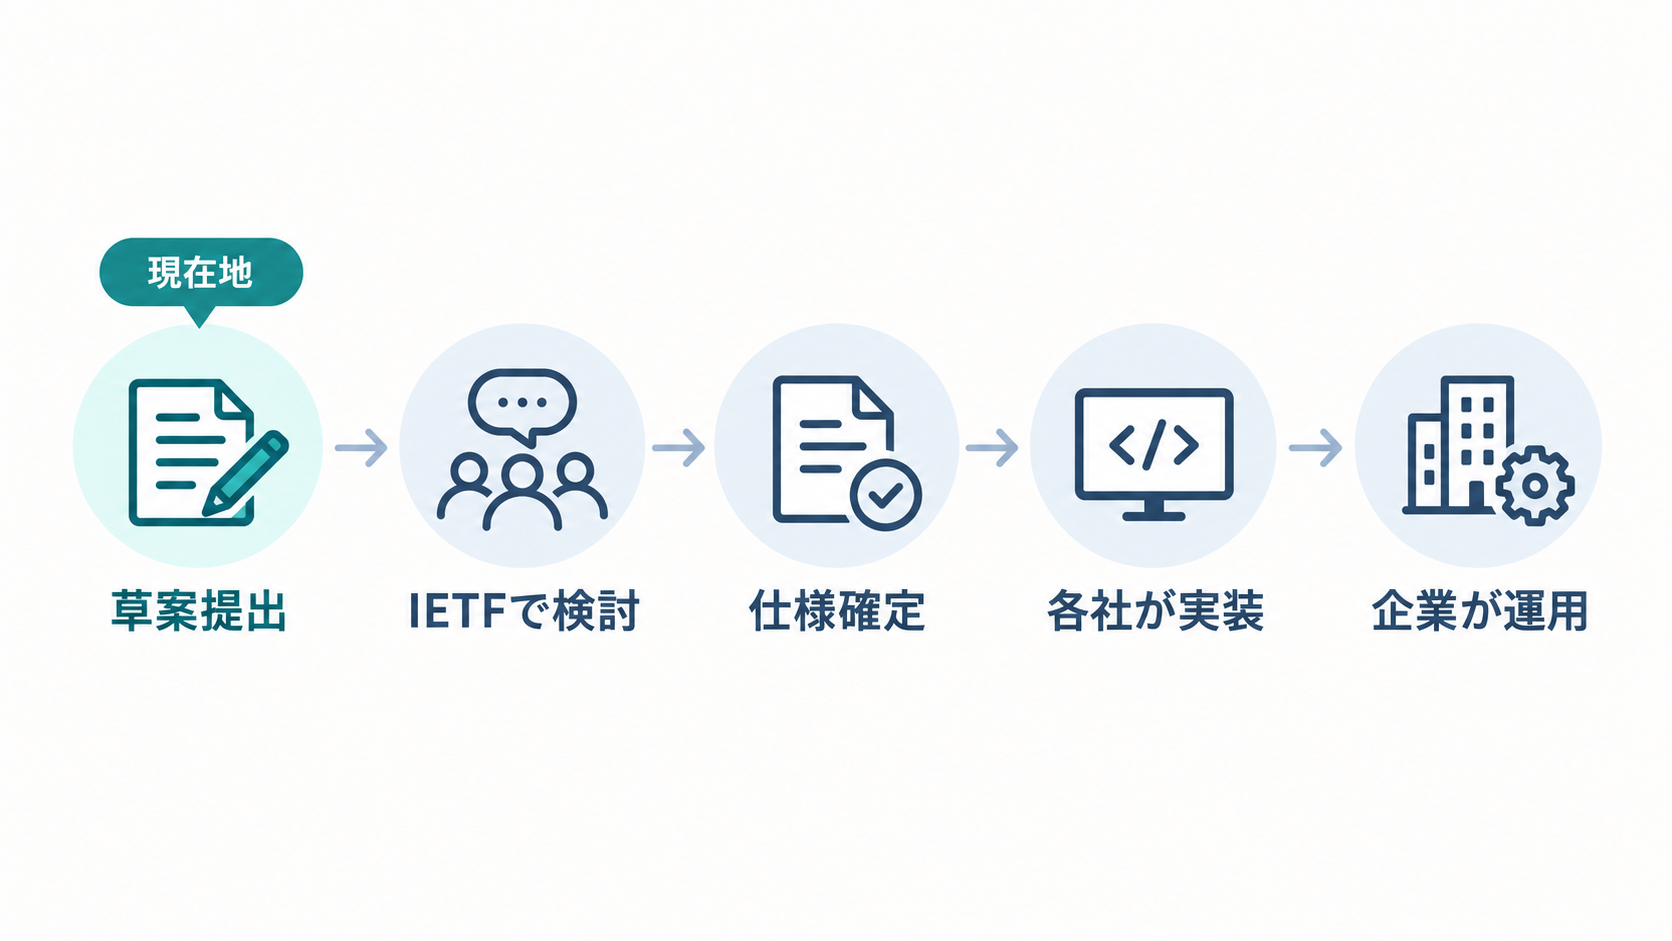
`robots.txt`の構造は、Robots Exclusion Protocolと呼ばれる標準形式に基づいています。4社は、新しいAIクローリング制御をこの形式へ組み込むことを目指し、インターネット技術の標準化を進めるIETFへ草案を提出しました。特定企業だけの独自設定ではなく、共通のプロトコルとして扱う方向を選んだことになります。
共通仕様として定着すれば、サイト運営者は事業者ごとの説明書を読み比べる負担を減らせます。AI事業者にとっても、サイトごとに異なる意思表示を解釈するのではなく、共通の形式に沿って処理できる利点があります。ウェブ制作ツールやコンテンツ管理システムが対応すれば、専門知識を持たない担当者でも管理画面から方針を選べる形へ発展する可能性があります。ただし、そのような製品対応は今回発表された事実ではなく、標準化後に考えられる展開です。
草案の提出は、仕様が確定したことを意味しません。標準化の過程では、対象となるクローリングの定義、既存の指定との優先関係、後方互換性などが検討されると考えられます。最終的な記述方法や運用条件が変わる可能性も残っています。企業が現段階で独自に構文を推測し、本番環境へ追加するのは避けたほうがよいでしょう。
実務では、IETFでの進行状況と各AI事業者の正式な技術文書を確認し、仕様と実装の両方がそろった時点で更新する姿勢が現実的です。標準の成立、サービスへの実装、実際の遵守開始は同時とは限らないため、段階ごとに確認する必要があります。
MicrosoftとOpenAIが先行、Googleは2027年に対応予定
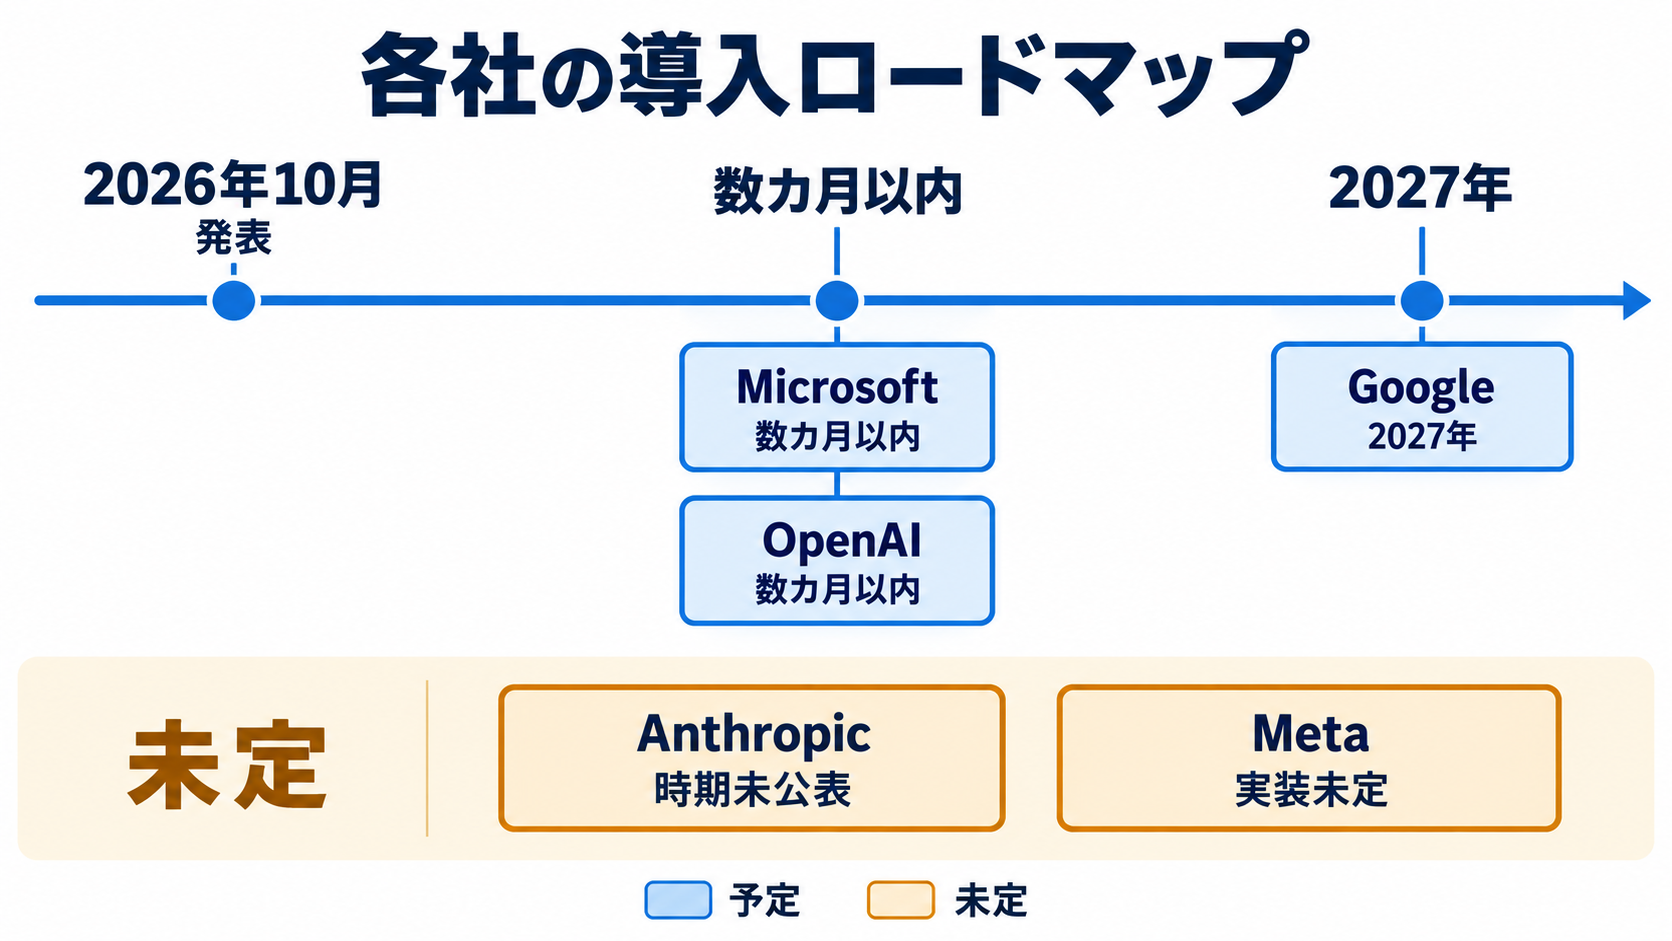
実装時期は各社でそろっていません。MicrosoftとOpenAIは、発表から数カ月以内に新しいクローリング仕様への対応を加える計画です。Googleは、翌年にあたる2027年中の対応を予定しています。Anthropicも提案を支持していますが、確認できる情報では具体的な導入時期まで示されていません。
Microsoftは共通の訓練拒否設定に加えて、AI Groundingの制御も用意します。OpenAIも回答時参照に関する同種の選択肢を提供する方針ですが、設定の詳細は現時点で明らかにされていません。企業側は、共通仕様の導入だけを追うのではなく、各社が設ける補助的な制御も確認する必要がありそうです。
Metaは、この技術の考え方には支持を示したものの、実装までは約束していません。大手AI企業が同じ方向を向き始めた一方、すべての事業者が同時に参加する状況ではないことが分かります。新しい指定が利用可能になった後も、未対応のクローラーに対する既存の個別設定を残す期間が生じるでしょう。
そのため、切り替えは一度に完了させる作業ではなく、共通指定と従来設定を併用しながら進める移行として考えるのが妥当です。既存の記述をすぐ削除せず、各社の対応状況とアクセス記録を確認したうえで整理すれば、意図しない収集許可や検索クローラーへの影響を避けやすくなります。
日本企業が準備しておきたいコンテンツ方針と運用体制
新しい構文が確定するまで待っていても、社内での準備は進められます。最初に整理したいのは、自社サイトにどのようなコンテンツがあり、生成AIの訓練と回答時参照をそれぞれ許可するかという方針です。ニュースリリース、技術ブログ、製品仕様、採用情報、サポート文書などでは、公開目的も更新頻度も異なります。サイト全体へ一律の判断を適用できるとは限りません。
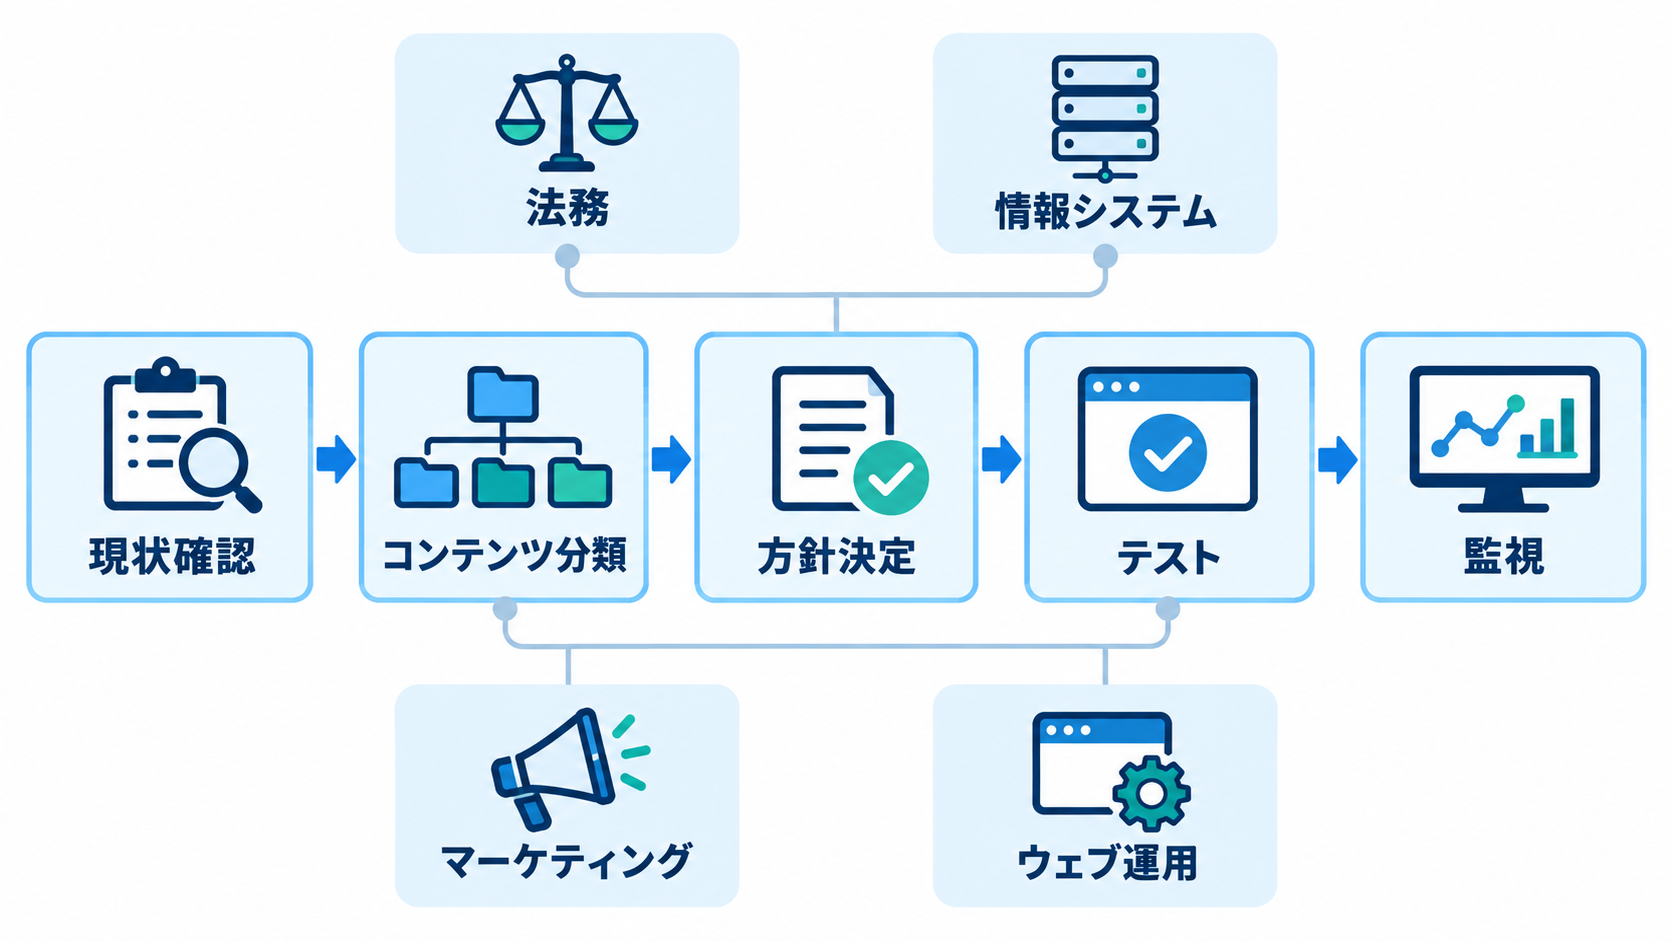
準備作業は、次の順序で進めると整理しやすくなります。
1. 公開サイトとサブドメインを洗い出し、現在の`robots.txt`とクローラー別設定を記録します。
2. コンテンツを種類や公開目的で分類し、訓練利用と回答時参照に対する方針を分けて決めます。
3. 方針決定者、設定変更者、法務確認者を定め、変更履歴と承認記録を残せる運用にします。
4. 各社の正式対応後にテスト環境で設定を確認し、公開後はアクセス記録や検索への影響を監視します。
判断にはウェブ担当者だけでなく、コンテンツの権利関係を把握する法務部門、顧客接点を管理するマーケティング部門、AI活用方針を担う情報システム部門も関わります。外部のライターや写真家から提供された素材を掲載している場合、自社が許可できる利用範囲と契約条件が一致しているかも確認したほうがよいでしょう。
技術設定は、社内方針を実行に移す最後の工程です。方針が曖昧なまま拒否だけを設定すると、AI経由の情報到達まで抑える可能性があります。反対に、露出を優先して無条件に許可すれば、意図しない訓練利用を受け入れることになりかねません。自社が守りたい価値と、AIサービス経由で得たい接点を先に言語化することが、実装方式を選ぶ土台になります。
ウェブ公開を「閲覧可否」から「利用目的」で管理する時代へ
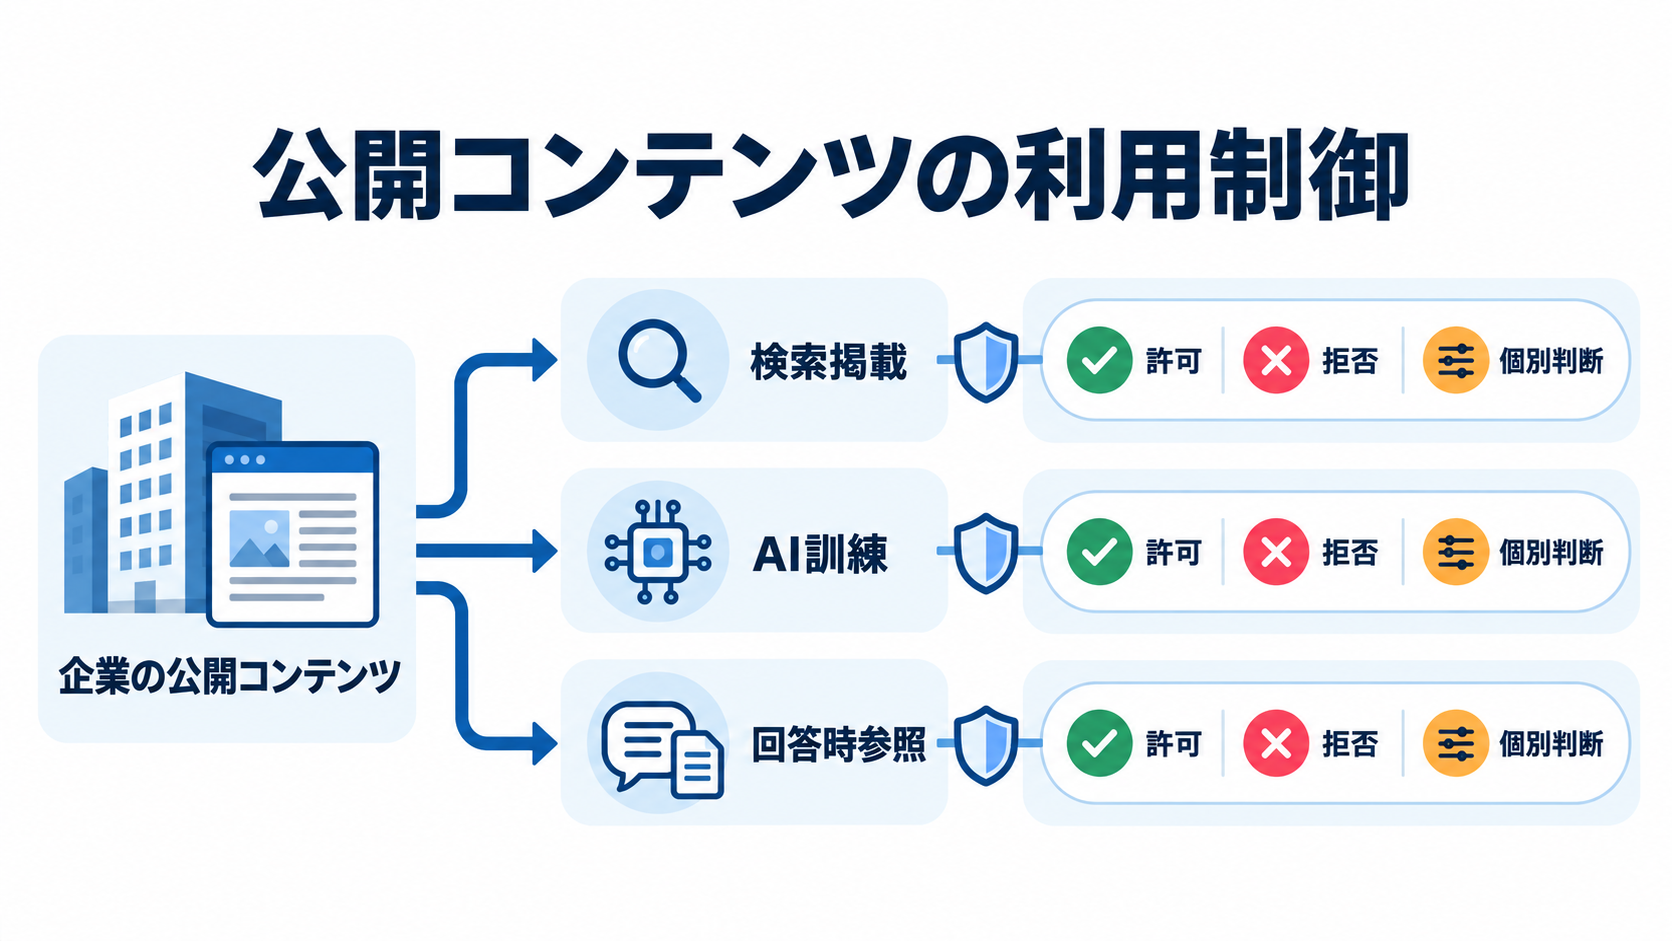
今回の提案が示す本質的な変化は、公開ページへのアクセスを許すかどうかだけでなく、取得後の利用目的まで機械的に伝えようとしている点です。検索エンジンへの掲載、生成AIの訓練、質問回答時の参照は、ウェブページを取得するという動作が似ていても、企業や制作者にとって意味が異なります。共通仕様は、その差をウェブ運用へ組み込むための基盤になり得ます。
B2B企業では、技術資料や導入事例がAIの回答に参照されれば、見込み顧客が自社を発見する入口になる可能性があります。その一方で、時間と費用をかけて制作した専門コンテンツを、モデル訓練へ無条件に提供したくないという判断も成り立ちます。両者を同じ設定で処理せず、回答時参照は認めながら訓練は拒否するなど、目的に沿った選択肢が整うことには実務上の意味があります。
ただし、クローラー制御だけでコンテンツ戦略が完成するわけではありません。公開範囲、契約、認証、更新管理、AIサービス上での表示確認を組み合わせる必要があります。標準に従わない取得主体への対応も残るため、`robots.txt`を唯一の防御策として扱うべきではありません。
企業が今着手できる具体的な一歩は、既存の`robots.txt`を確認し、掲載コンテンツごとに「検索掲載」「AI訓練」「回答時参照」の希望を一覧化することです。仕様が確定してから社内調整を始めるのではなく、利用目的別の方針を先に合意しておけば、正式実装が始まった際に慌てず設定へ反映できるでしょう。