
2026/10/31
今更聞けないAI知識
AIの学習データは「答えの倉庫」ではない――練習材料から考えるモデルの仕組み
「この答えはどこから来たのか」という疑問
生成AIに献立を尋ねると、冷蔵庫にある食材からもっともらしい料理を提案してくれます。ここで「インターネット上のレシピを見つけて、そのまま表示したのだろう」と考える人もいるかもしれません。しかし、生成AIの基本的な動きは、検索結果を一件取り出して見せることとは異なります。
一言で答えると、学習データとは、AIがパターンを身につけるために使う「練習材料」です。通常は、質問に答えるたびに学習データの中から同じ文章を探し出しているわけではありません。この違いを知ると、AIの回答に出典が見当たらない理由や、自然な文章なのに事実が正しいとは限らない理由を理解しやすくなります。
AIは、人間の学習、理解、問題解決などに似た働きをコンピューターで実現する技術の広い呼び名です。その中に、データからパターンを学ぶ機械学習があります。生成AIは、その技術を使って文章や画像などを作る仕組みです。AI、機械学習、生成AIは同じ意味ではなく、広い概念の中に、より具体的な方法や用途が含まれる関係にあります(出典: IBM、Google Cloud)。
この記事で扱う中心の疑問は、「学習データが回答の材料になるとは、どういうことか」です。データの種類、量、内容、偏りを順に見ると、AIを「何でも知っている答えの保管庫」と捉えるのではなく、与えられた材料から一定の傾向を身につけた仕組みとして見られるようになるでしょう。
「練習材料」と「身についた型」の違い
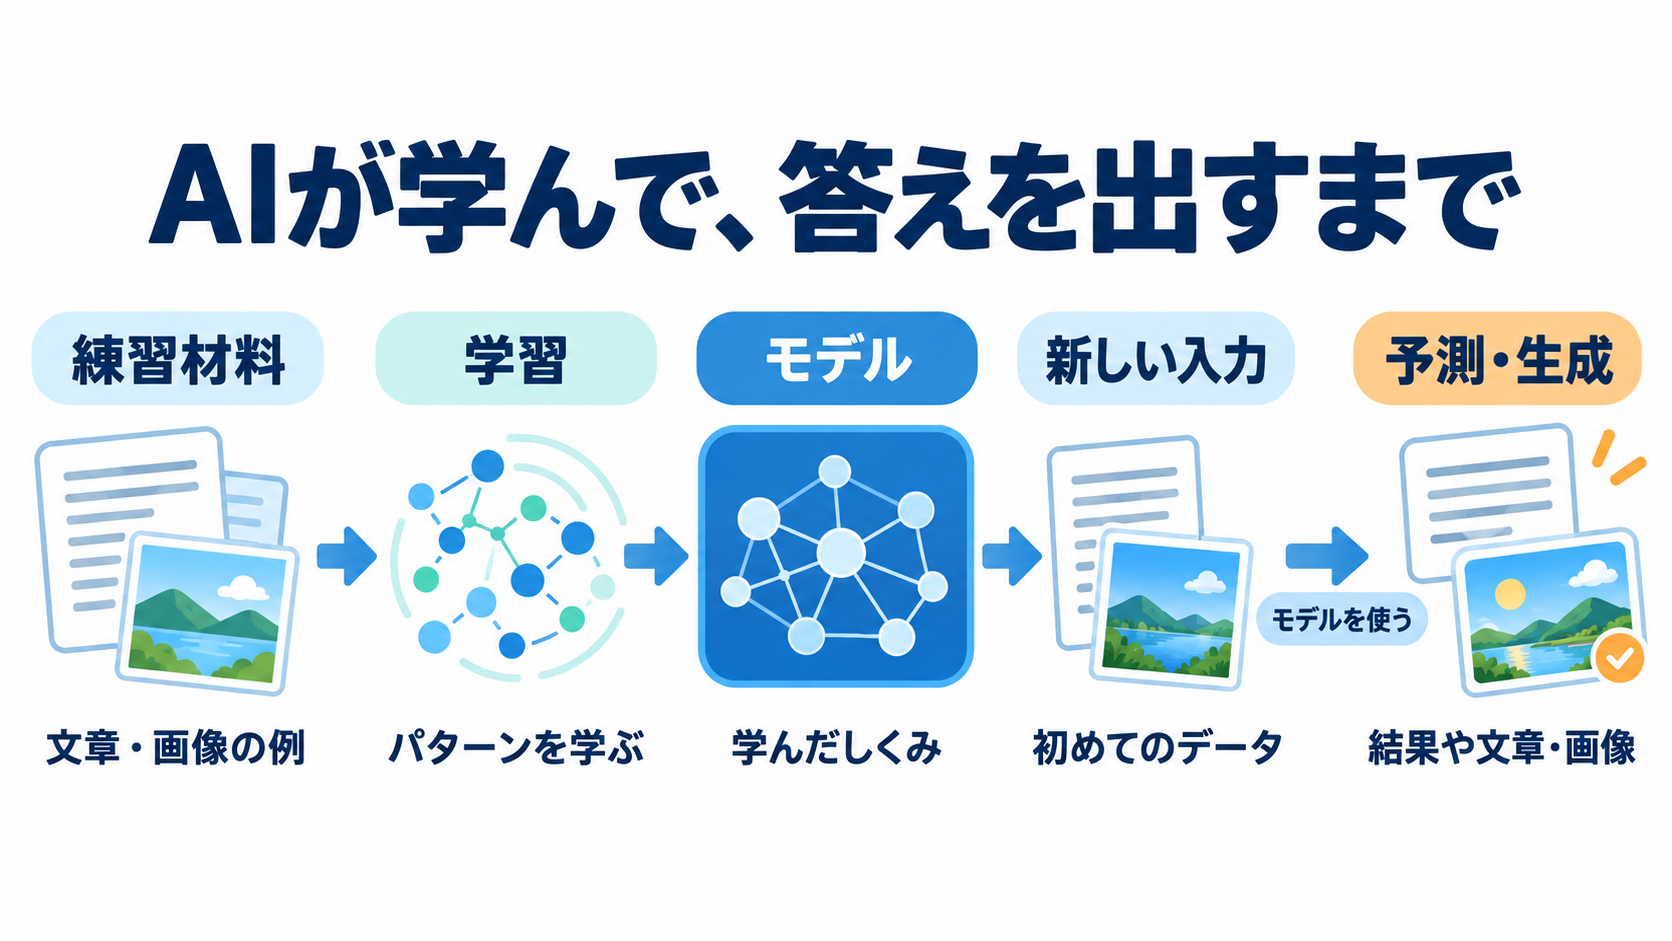
学習データを身近なものに置き換えるなら、料理人が練習で見る食材やレシピ、完成した料理の例に近い存在です。たくさんの例を観察するうちに、「この食材にはこの調理法が合いやすい」「この順番で作ると、この形になりやすい」といった関係を学んでいきます。新しい注文を受けたときは、練習で見た一皿を探して丸ごと出すのではなく、身につけた型を使って対応します。
機械学習では、データを使ってアルゴリズムを訓練し、予測や判断に使えるモデルを作ります。アルゴリズムは学び方の手順、モデルはその手順で学習した結果と考えると整理しやすいでしょう。Google Cloudも、機械学習モデルを、アルゴリズムを学習データ上で動かすことによってプログラムが学んだ成果として説明しています(出典: Google Cloud)。
生成AIの基盤となるモデルでは、大量の文章や画像などから、要素同士のパターンや関係が数値として表現されます。IBMは、生成モデルが学習データの簡略化された表現を内部に持ち、それを基に、元のデータと似ていても同一ではない内容を作ると説明しています(出典: IBM)。つまり、モデルは学習データそのものと同じものではありません。
たとえば、架空の文章生成モデルが「雨の日には傘を持つ」という表現を含む多様な文章から学んだとします。モデルが身につけるのは、特定の一文の保管場所だけではなく、「雨」「傘」「持つ」といった語がどのような文脈で結びつきやすいかという傾向です。そのため、回答は自然に見えても、特定の資料を読み返して事実を確認した結果とは限りません。
正解ラベルがあるデータとないデータ
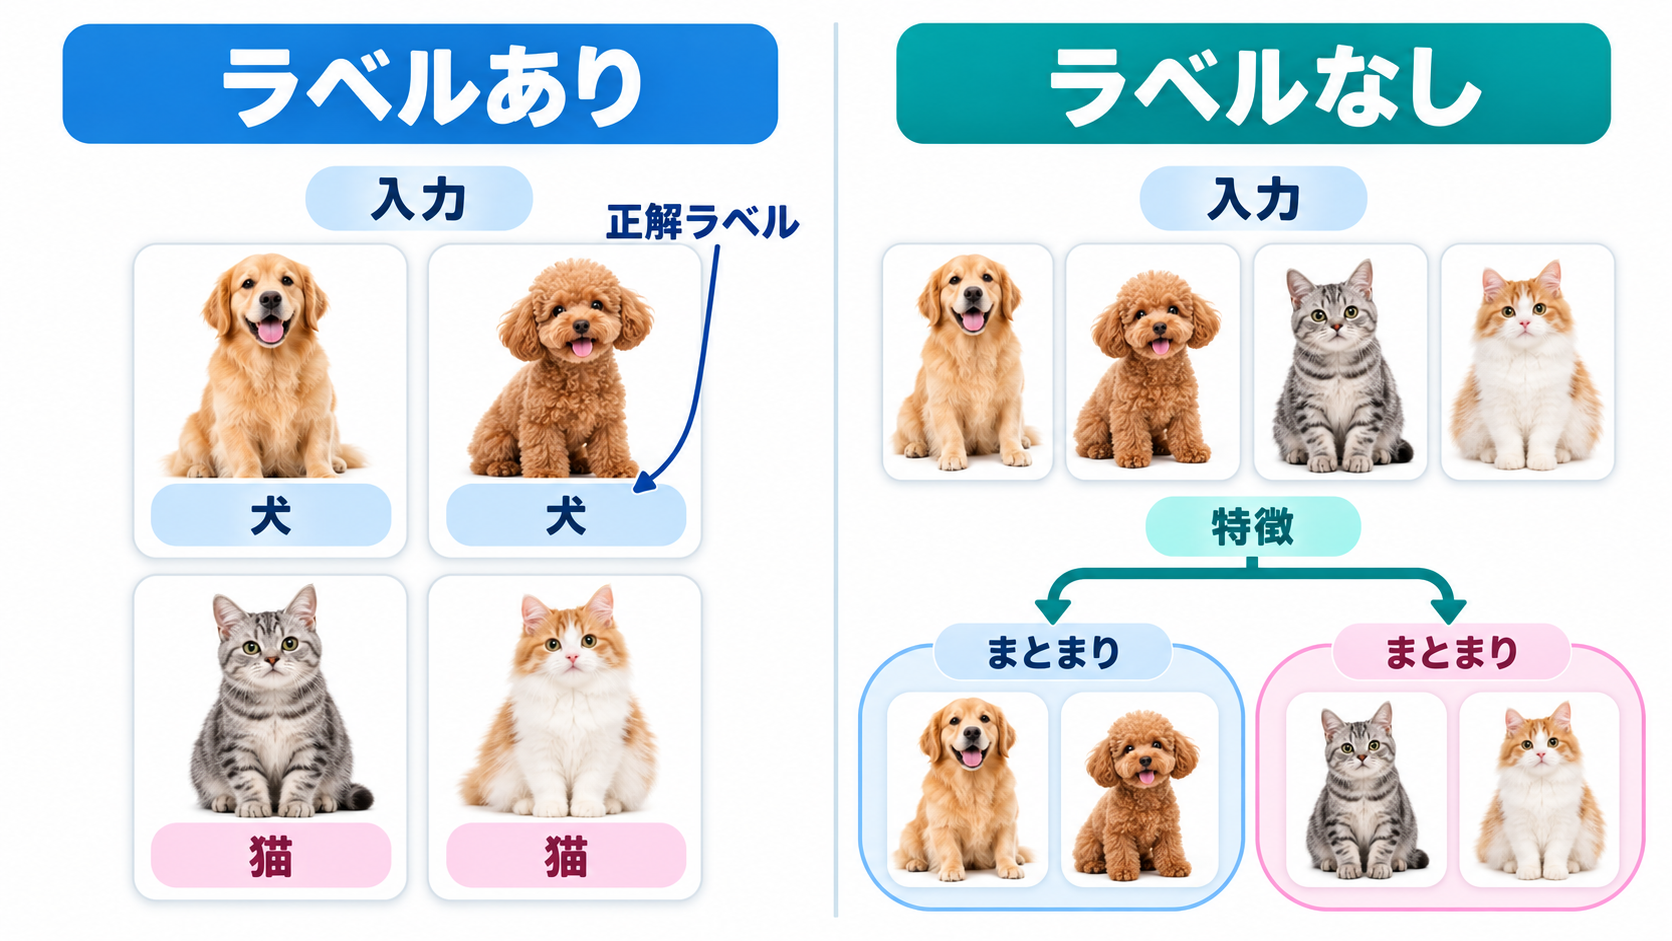
学習データには、あらかじめ正解に当たる目印が付いているものと、付いていないものがあります。この目印は「ラベル」と呼ばれます。ラベル付きデータを使う代表的な方法が教師あり学習です。人が入力例と出力ラベルを組み合わせ、モデルが両者の対応を学べるようにします(出典: IBM)。
架空の迷惑メール判定を例にすると、メールごとに「迷惑メール」「通常メール」という目印を付けたデータがラベル付きデータです。モデルは文章中の特徴とラベルの関係を学び、まだ見ていないメールの分類を試みます。ここでいう正解は、世の中の絶対的な正しさではなく、その学習目的に合わせて人が設定した分類です。ラベルの基準が曖昧なら、学ぶ対応関係も曖昧になり得ます。
ラベルなしデータには、事前に答えが付けられていません。モデルはデータ内の似た特徴やまとまりを探します。IBMは、深層学習によって、大量のラベルなし・非構造化データから特徴を抽出できると説明しています(出典: IBM)。写真をあらかじめ犬や猫に分類する代わりに、見た目の近い画像のまとまりを見つける場面を想像すると違いが分かりやすくなります。
| データの種類 | 練習材料の例 | 学び方のイメージ |
| --- | --- | --- |
| ラベル付きデータ | メールと迷惑メール判定の組み合わせ | 入力と目印の対応を学びます |
| ラベルなしデータ | 分類名が付いていない多数の文章や画像 | 共通する特徴やまとまりを探します |
ラベルの有無は、データの良し悪しを単純に決めるものではありません。分類の正解を学ばせたいのか、データの中にある構造を見つけたいのかによって役割が変わります。「AIにはすべて正解付きの問題集を渡している」という理解も、「人の手を一切借りずに学ぶ」という理解も、実際の方法を単純化しすぎています。
データは多ければよいとは限らない理由
学習例が増えれば、モデルが多様なパターンに触れられる可能性は高まります。Google Cloudの資料でも、機械学習ではデータを使って性能を高めていく関係が説明されています(出典: Google Cloud)。ただし、数が多いことだけを見て、目的に合った学習材料かどうかを無視することはできません。
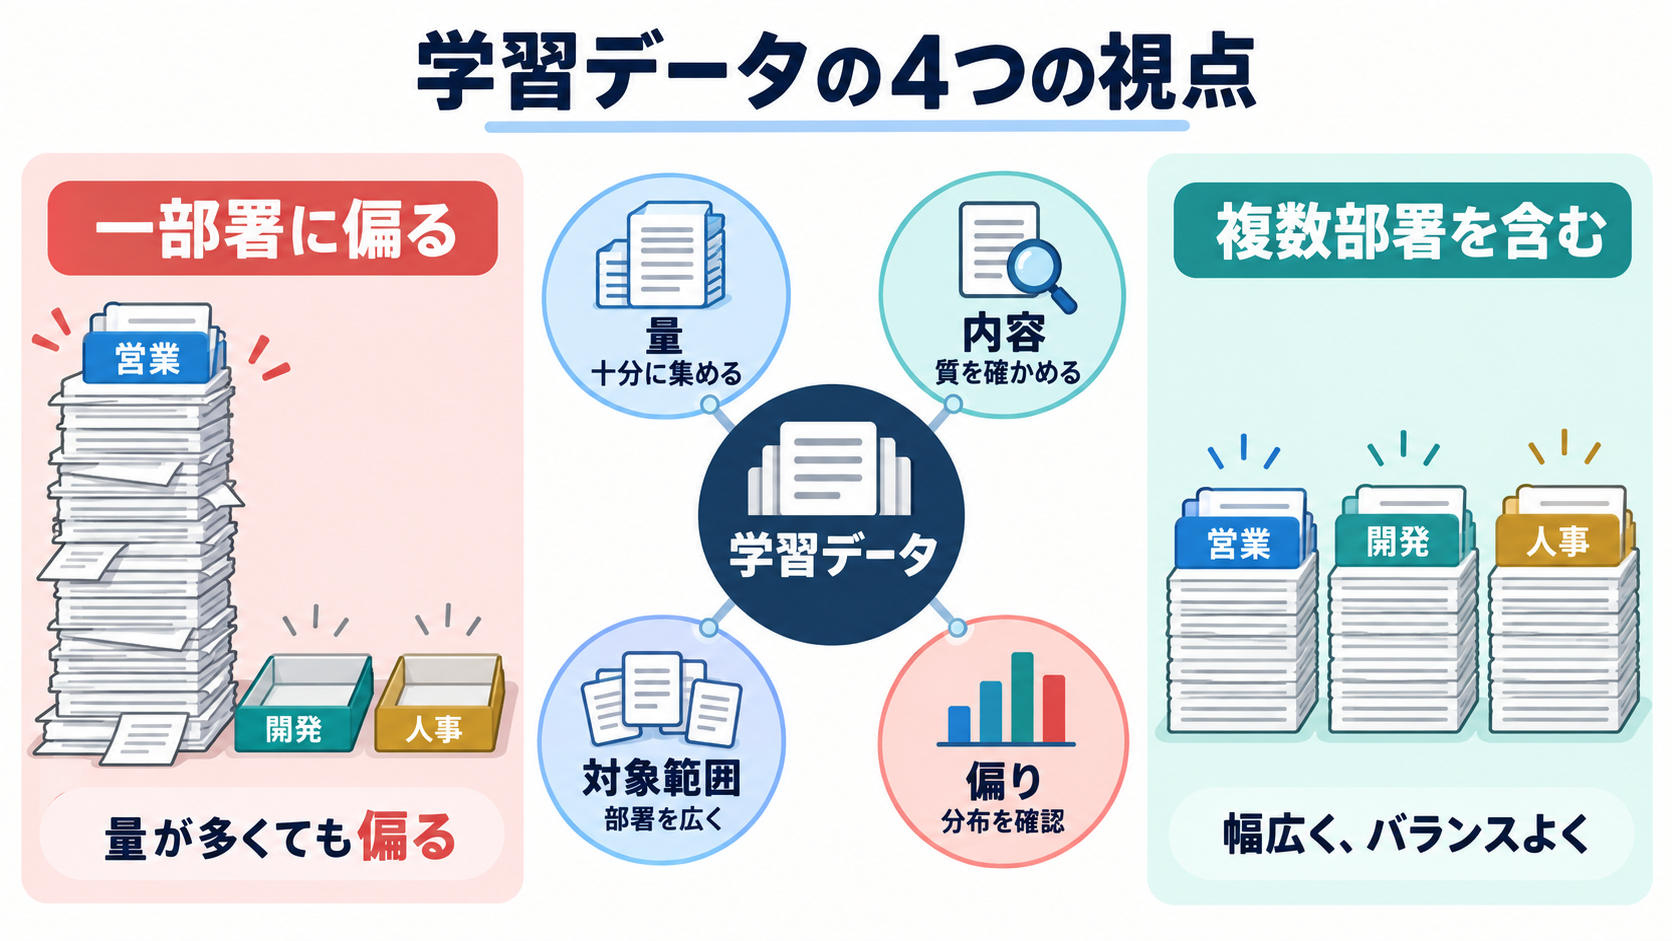
ここからは仕組みを考えるための架空の例です。ある部署の過去メールだけを使って、全社向けの問い合わせ分類モデルを作るとします。営業部門の言い回しは豊富に含まれていても、製造部門や人事部門で使われる表現がほとんどなければ、全社の問い合わせを均等に代表する材料にはなりません。メールが十万件あったとしても、同じ部署や似た期間に集中していれば、件数だけでは補えない範囲が残ります。
データの偏りとは、特定の種類、時期、立場、表現などが多く含まれ、別のものが少ない状態です。これは必ずしも誰かが意図的に作るものではありません。収集しやすいデータだけを選んだ結果や、過去の記録がもともと偏っていた結果として生じることも考えられます。モデルは渡されていない事例を経験したことにはできないため、何が含まれ、何が含まれていないかを見る視点が必要です。
内容の正確さも同様です。古い情報、誤記、互いに矛盾する説明が練習材料に含まれていれば、それらも学習対象になり得ます。だからといって、個々の回答の誤りを特定の一件の学習データだけに結び付けることも適切ではありません。モデルの出力には、学習方法、調整、質問の書き方など複数の要素が関係します。利用者にとって大切なのは、「大量に学習している」という言葉を、正しさの保証と読み替えないことです。
学習と検索を同じものと考えない見方
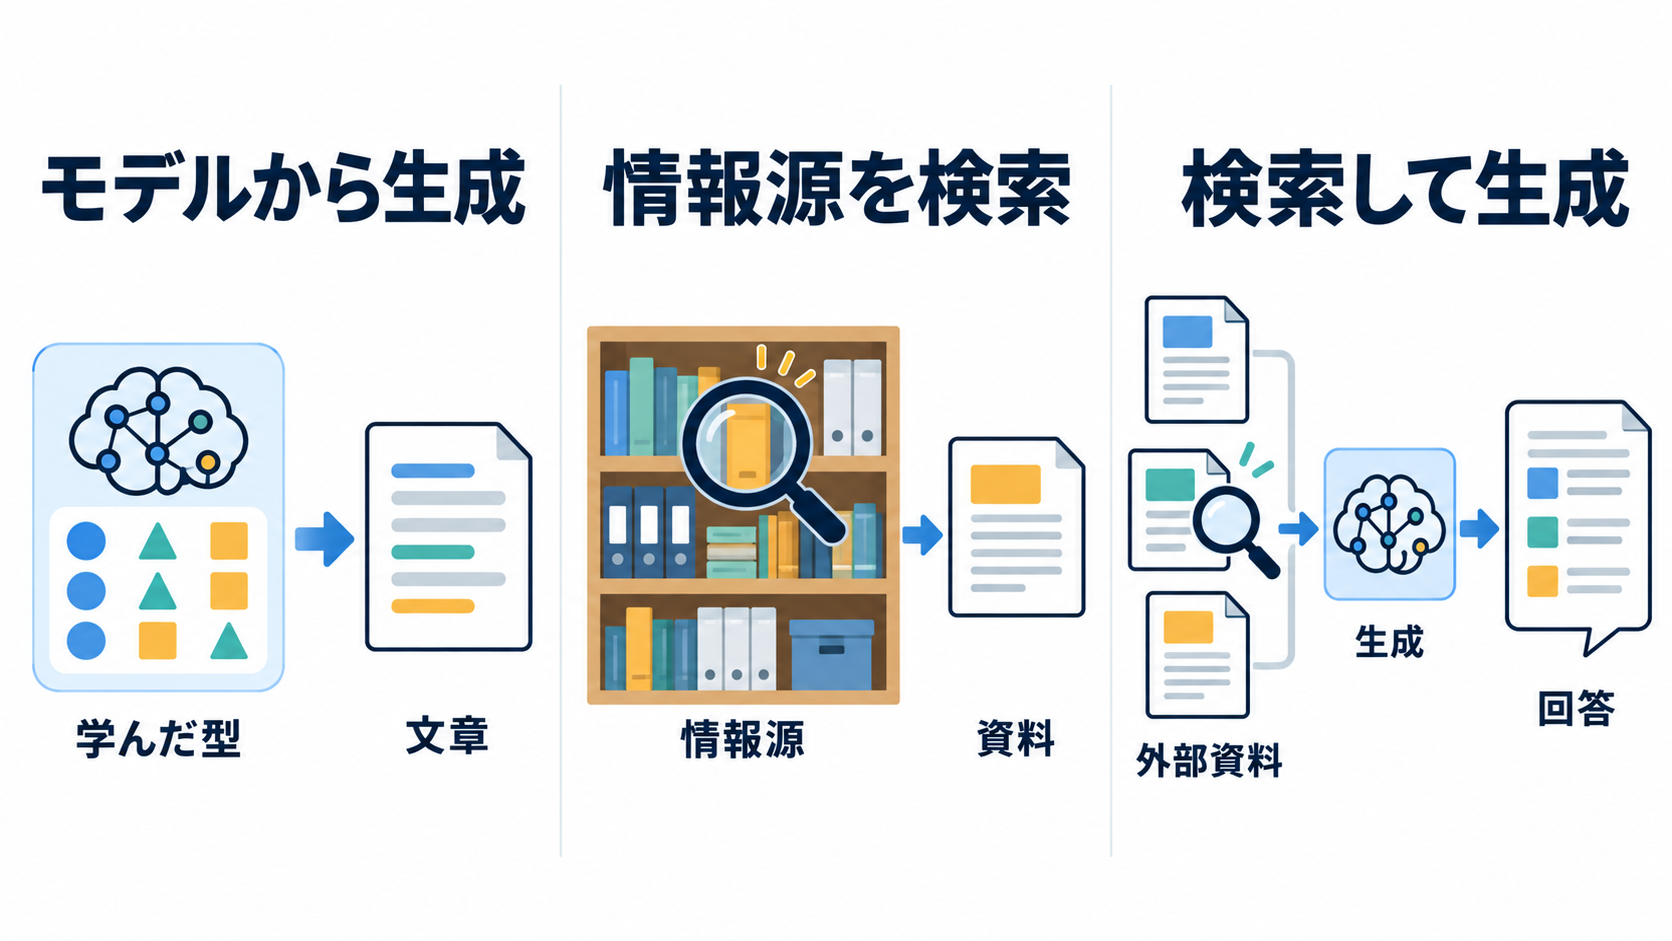
検索と生成AIの違いを考えるときは、本棚の使い方に置き換えると分かりやすくなります。検索は、条件に合う資料を本棚から探す行為に近いものです。学習済みモデルによる生成は、多数の資料を練習材料として身につけた型を使い、新しい文章を組み立てる行為に近いでしょう。このたとえは仕組みを単純化したものですが、「回答文の一文一文に、対応する保管場所があるとは限らない」という点を捉えられます。
IBMは、生成モデルが学習データの簡略化された表現から新しい内容を作ると説明しています(出典: IBM)。そのため、文章が具体的で滑らかでも、回答中の事実が特定の情報源で確認済みとは限りません。もっともらしい固有名詞や日付が示されたときほど、文章の自然さと事実の裏付けを分けて見る必要があります。
生成AIと検索が常に別々に使われるわけでもありません。外部の関連資料を取得し、その内容を回答に利用するRAGは、日本語では「検索拡張生成」などと呼ばれる方法です。IBMは、学習データ外の関連情報源を利用して、生成AIアプリケーションの正確さや関連性を高める手法としてRAGを挙げています(出典: IBM)。ただし、外部資料を使う機能の有無、参照範囲、出典表示の方法は、個別のサービスで確認しなければなりません。
| 見方 | 主な役割 | 利用者が確認したい点 |
| --- | --- | --- |
| 学習済みモデルによる生成 | 学んだパターンから内容を組み立てます | 回答だけで事実確認が済んだと思わないことです |
| 検索 | 関連する情報源を探します | 情報源の発行元と日付を確認することです |
| 外部資料を使う生成 | 取得した資料を回答作成に利用します | どの資料のどの記述に基づくかを確かめることです |
回答にリンクがある場合も、リンクの存在だけで十分とは限りません。リンク先が主張を本当に支えているか、公開日と更新日はいつか、現在も有効な情報かを読む必要があります。学習と検索の違いを知る目的は、どちらかを優れたものと決めることではなく、回答の根拠をどこで確認すべきか判断できるようにすることです。
学習する段階と回答を作る段階
「AIに一度訂正を伝えたら、その場で賢くなり、今後のすべての回答にも反映されるのでしょうか」という疑問も、学習データへの誤解から生まれやすいものです。理解の鍵は、モデルを作る学習と、学習済みモデルが回答を作る生成を別の段階として考えることにあります。
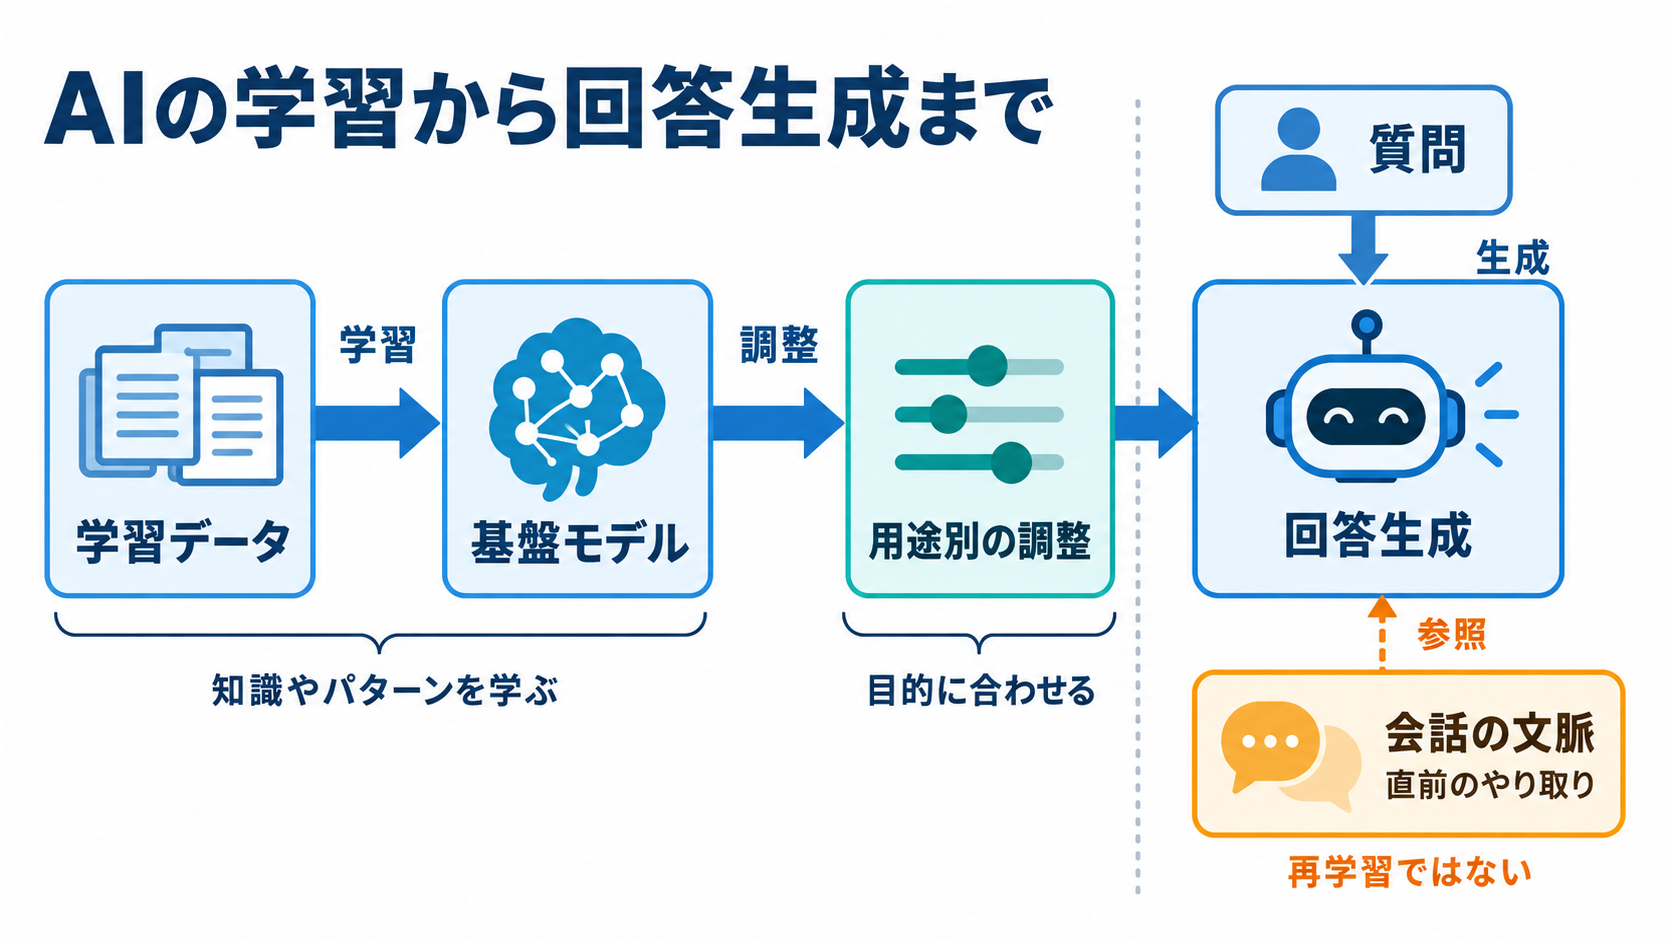
IBMは、生成AIの大まかな流れを、基盤モデルを作る学習、用途に合わせる調整、生成と評価、追加調整という段階で説明しています(出典: IBM)。基盤モデルとは、複数の用途の土台になる事前学習済みモデルです。用途別のデータを使って追加で調整する方法は、ファインチューニングと呼ばれます。Google for Developersの用語集でも、事前学習済みモデルに対し、特定の課題向けの二回目の学習を行う方法として説明されています(出典: Google for Developers)。
これに対して、回答生成は、すでに学習や調整を受けたモデルが、入力された質問に応じて出力を作る場面です。会話型の仕組みでは、前のやり取りが後の会話の文脈として使われる場合があります(出典: Google for Developers)。その会話内で訂正が反映されたように見えても、会話の文脈に加わったことと、基盤モデルがその場で再学習されたことは同じではありません。
入力内容が保存されるか、後の改善や学習に利用されるかというデータの取り扱いは、サービスごとに確認すべき別の問題です。「学習と生成は別段階だから、入力は絶対に保存されない」と考えることもできません。業務上の非公開情報や個人情報を扱う前には、利用中のサービスが示す規約、設定、組織内のルールを確認する必要があります。仕組みの一般論と、個別サービスの提供条件を混ぜないことが大切です。
AIの回答を見るときに役立つ三つの問い
学習データの仕組みを知っても、利用者がモデル内部のすべてを調べられるわけではありません。それでも、回答を見るときの問いを変えることはできます。「AIが言ったから正しいか、間違いか」という二択ではなく、何を任せ、どこから人が確かめるかを考えるための問いです。
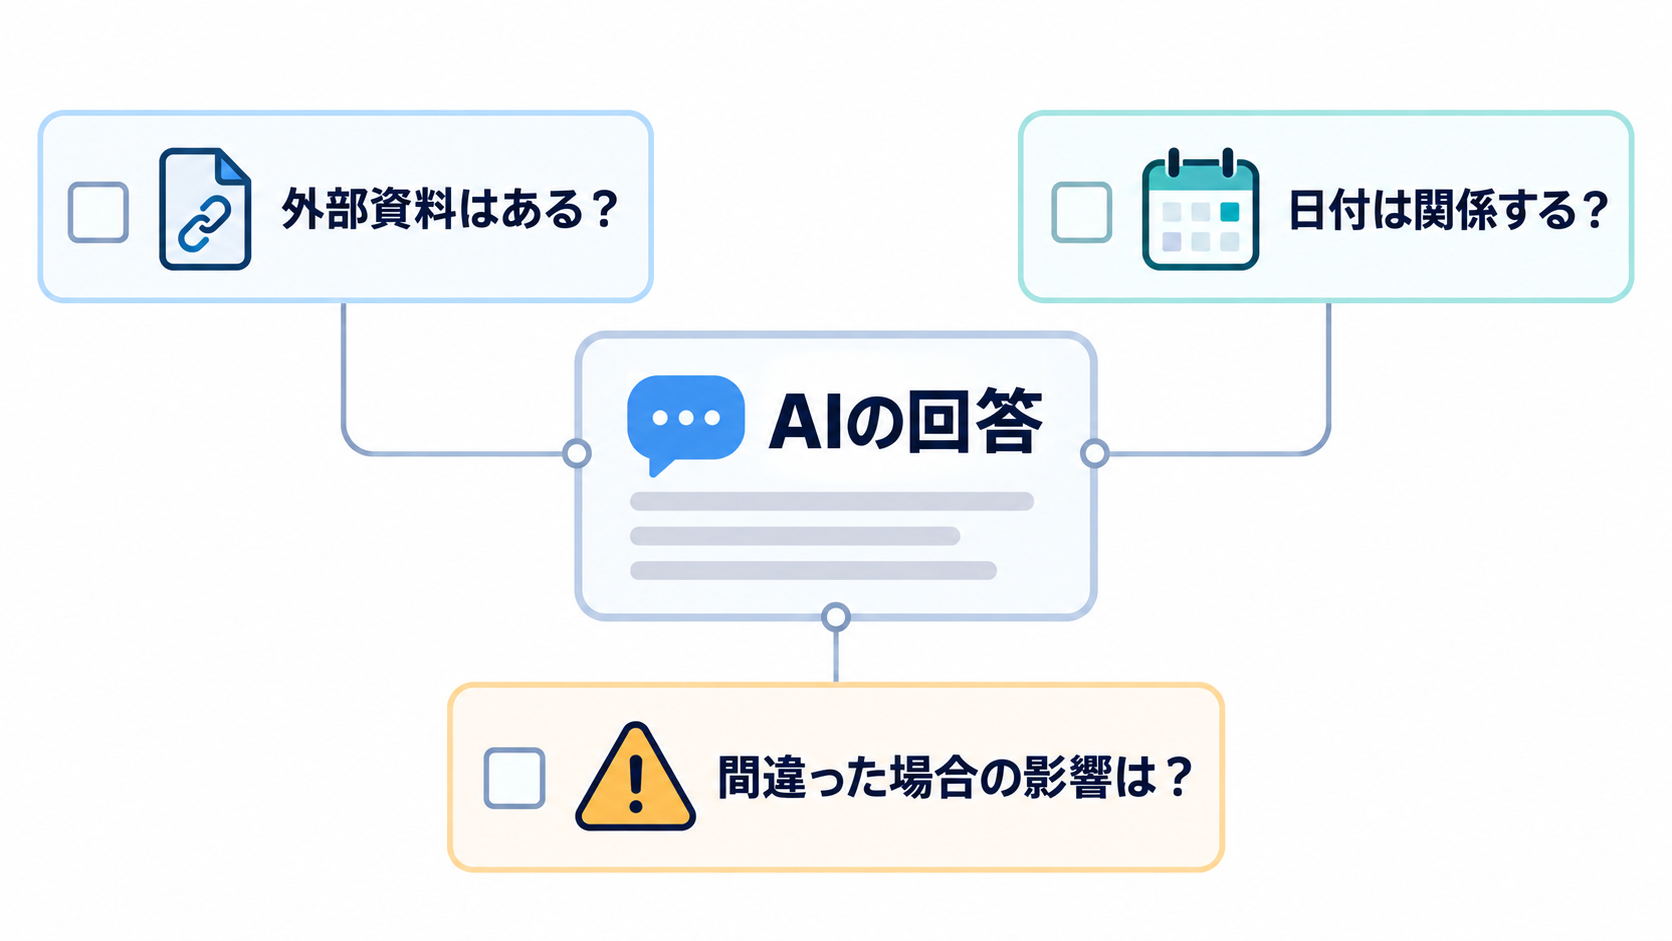
一つ目は、「これは学んだパターンから作られた説明なのか、外部資料を確認した説明なのか」です。出典が必要な質問なら、情報源と該当箇所を示せるか確かめます。二つ目は、「この情報には日付が関係するか」です。制度、料金、製品仕様、役職、予定などは変化し得るため、公開日、更新日、取得日を分けて見る必要があります。三つ目は、「間違った場合に誰へどのような影響があるか」です。影響が大きい内容ほど、一次資料や担当者による確認を省かない判断が求められます。
回答を整理するため、次のように依頼する方法も考えられます。これは活用の提案例であり、正しさを保証する命令ではありません。
> 回答を「確認できる事実」「推測や提案」「追加確認が必要な点」に分けてください。事実には情報源と日付を添え、分からない内容は補わずに示してください。
この依頼をしても、AIが誤った区分や存在しない情報源を示す可能性は残ります。最終確認はリンク先や公式資料で行います。反対に、アイデア出しや架空の文章例のように、唯一の正解を求めない場面では、事実確認よりも目的、読み手、避けたい表現を具体的に伝える方が役立つこともあります。学習データへの理解は、AIを使わない理由ではなく、用途に応じて確認の強さを変える判断材料になります。
「何を覚えているか」より「何で確かめるか」
学習データを答えの倉庫だと思っていると、AIの流暢な回答を「どこかに書いてあった事実」と受け取りやすくなります。練習材料だと捉え直せば、自然な文章を作る力と、最新の事実を裏付ける力が同じではないことに気づけます。モデルはデータからパターンを学びますが、データの量だけでなく、内容、対象範囲、ラベル、偏りも関係します。
今後、生成AIが検索や外部ツールと組み合わされる場面が増えても、この区別は役立ちます。IBMが説明するAIエージェントは、モデルの出力を使いながら外部のアプリケーションやサービスを操作し、目標に向けて作業を進める仕組みです(出典: IBM)。できることが回答作成から行動へ広がれば、参照情報の新しさだけでなく、どの操作を許可するか、実行前に誰が確認するかという視点も必要になります。
明日AIを使うときは、回答のすべてを疑うところから始める必要はありません。回答の中から日付、数値、固有名詞、制度、実在する出来事を一つ選び、「これは学習したパターンによる説明なのか、確認できる情報源に基づくのか」と問い直してみてください。その一手で、AIに任せる部分と、自分で資料を確かめる部分の境界が見えやすくなるでしょう。
参考情報
- What Is Artificial Intelligence (AI)?|IBM — 2024年8月9日公開、2026年10月2日更新、2026年10月31日取得
- AI vs. Machine Learning: How Do They Differ?|Google Cloud — 提供資料上は公開日・更新日の記載なし、2026年10月31日取得
- Glossaire sur le machine learning: IA générative|Google for Developers — 提供資料上は公開日・更新日の記載なし、2026年10月31日取得