
2026/10/31
今更聞けないAI知識
AIの「パラメータ」は知識の数ではありません――大量の「つまみ」で考えるモデルの仕組み
数字だけでは見えにくい「パラメータ」の正体
AIサービスの紹介で「数十億のパラメータを持つモデル」と聞いても、それが自分の質問にどう関係するのかは分かりにくいものです。知識を一件ずつ数えた数字なのか、性能を表す点数なのか、疑問に感じる人もいるでしょう。一言で答えるなら、**パラメータとは、AIモデルが学習を通じて調整する大量の数値**です。IBMは、基盤モデルの学習によって、データに含まれる対象、パターン、関係を表現する数十億のパラメータを持つニューラルネットワークが作られると説明しています(出典: IBM)。
身近なものに置き換えるなら、音響機器に並んだ調整用のつまみを想像すると理解しやすくなります。音を整えるには、一つのつまみだけを最大にするのではなく、多数のつまみを組み合わせて調整します。AIモデルでも、多くのパラメータが一緒に働くことで、入力された文章などに応じた出力が作られます。ただし、実際のパラメータに「猫の知識」「敬語」「計算能力」といった分かりやすい名前が一つずつ付いているわけではありません。このたとえは、あくまで大量の数値が組み合わさって働く様子をつかむためのものです。
ここで押さえたいのは、パラメータ数がそのまま「覚えている事実の件数」や「賢さの点数」になるわけではない、という点です。パラメータはモデルの規模を知る手掛かりの一つですが、どのようなデータから学んだか、用途に合わせてどう調整されたか、回答をどう評価したかまでは一つの数字から分かりません。記事や製品紹介で大きな数字を見たときは、優劣を即断する材料ではなく、「学習によって調整された数値をどの程度持つモデルなのか」を表す情報として読むのが出発点になります。
大量の「つまみ」が回答を形づくる仕組み
パラメータの役割を理解するには、その入れ物となるモデルも一緒に見る必要があります。機械学習は、データから予測や判断を行うモデルを作るための方法であり、AIという広い分野の一部です。Google Cloudは、機械学習モデルを、アルゴリズムを学習データ上で動かした結果としてプログラムが学んだもの、と説明しています(出典: Google Cloud)。AI、機械学習、モデル、パラメータは同じ言葉ではなく、広い概念から具体的な仕組みへと段階的につながっています。
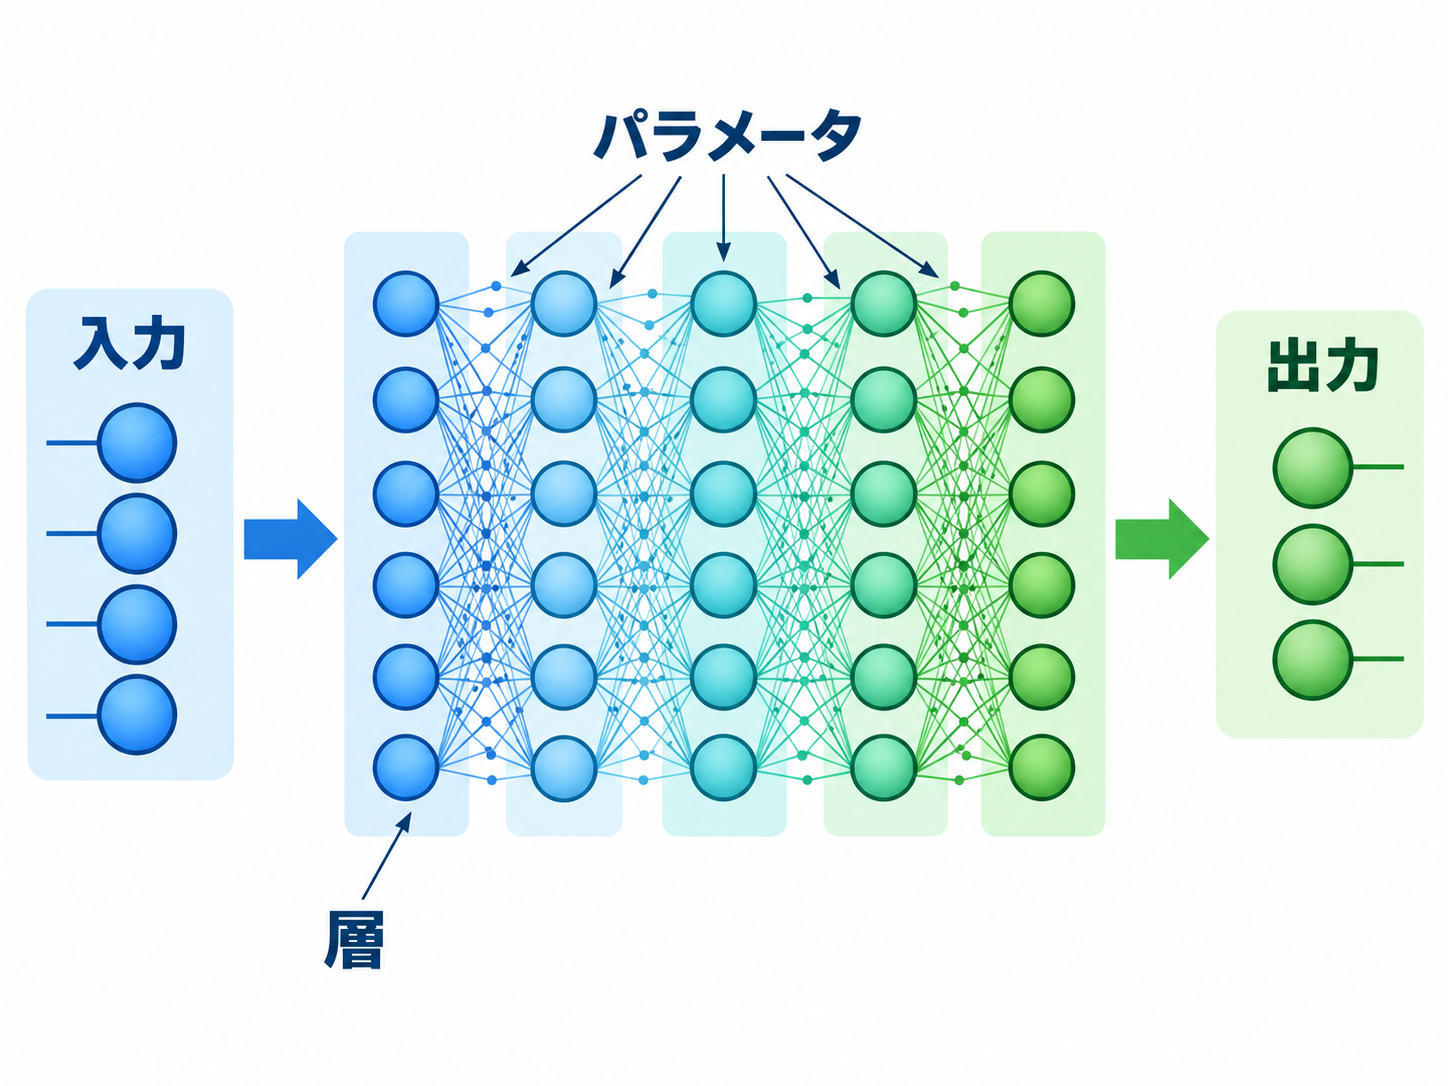
IBMによると、ニューラルネットワークは、相互につながった複数の層のノードが協調してデータを処理する仕組みです。深層学習では層を重ねたネットワークを使い、大量のデータにある複雑なパターンや関係を扱います。生成AIの基盤モデルを学習すると、その関係を数値で表現したパラメータが形成されます(出典: IBM)。つまり、文章を入力したときに一つの巨大な辞書から完成済みの回答を取り出すのではなく、学習で調整された多数の数値が組み合わさり、出力の作られ方に影響すると捉えるほうが実態に近くなります。
たとえば、架空の文章生成モデルに「雨の日の店内を描写してください」と頼む場面を考えてみましょう。モデルは「雨」という項目に保存された定型文をそのまま返す、と考える必要はありません。学習で得た言葉の並びや関係の表現と、今回の依頼内容を使って文章を生成します。どのパラメータがどの単語を担当したかを、利用者が一本ずつ追うような仕組みでもありません。無数の調整結果が全体として働くため、パラメータは「知識カード」よりも「出力の傾向を形づくる設定値の集まり」と考えると、後の説明も読み解きやすくなるでしょう。
学習データ・モデル・プロンプトとの境界
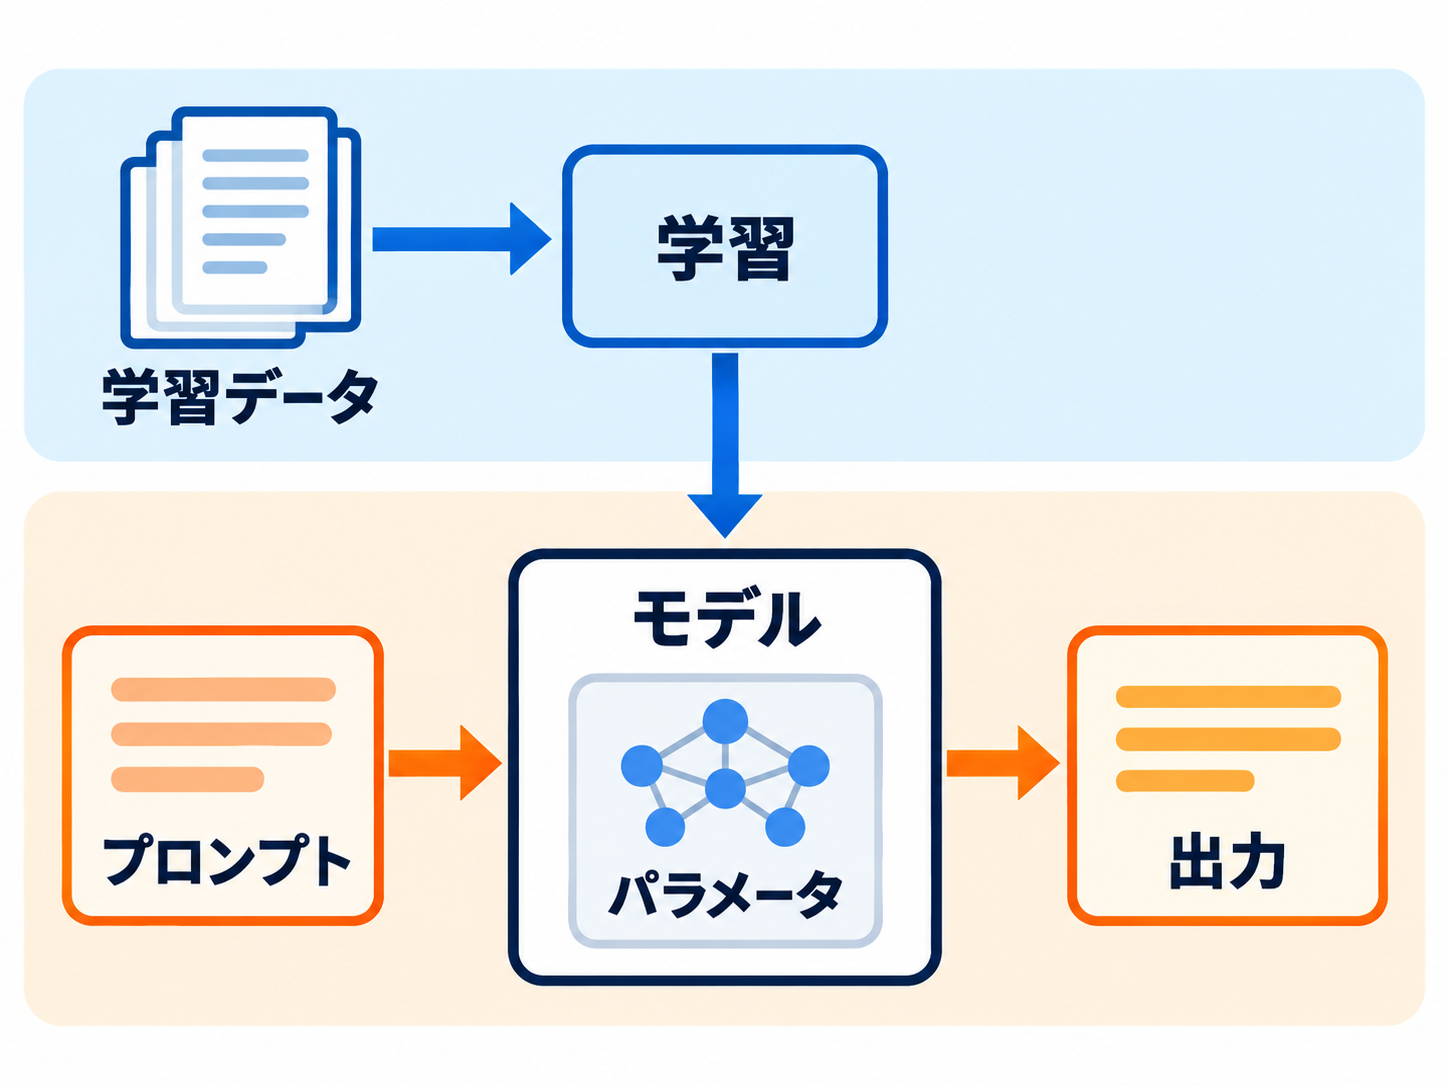
パラメータを難しく感じる原因の一つは、学習データやプロンプトと混同しやすいことです。学習データは、モデルを作る過程で使われる文章や画像などの材料です。パラメータは、その材料にあるパターンや関係を学ぶ中で調整される数値を指します。モデルは、学習によって得られた仕組み全体です。プロンプトは、完成した生成AIに利用者が渡す依頼や質問を意味します。IBMは、生成モデルが学習データの単純化された表現を符号化し、その表現から元のデータと似ていても同一ではない新しい内容を作ると説明しています(出典: IBM)。
違いを整理すると、次のようになります。
| 用語 | 短い意味 | 料理にたとえた役割 |
| --- | --- | --- |
| 学習データ | 学習時に使われる文章や画像など | 練習で触れた食材やレシピ |
| パラメータ | 学習によって調整される大量の数値 | 練習で身に付いた火加減や配分の傾向 |
| モデル | 学習後に予測や生成を行う仕組み | 調理できる状態になった料理人の技能全体 |
| プロンプト | 利用時に渡す質問や依頼 | 今回作ってほしい料理の注文 |
| 出力 | モデルが依頼に応じて生成した内容 | 注文を受けて作られた一皿 |
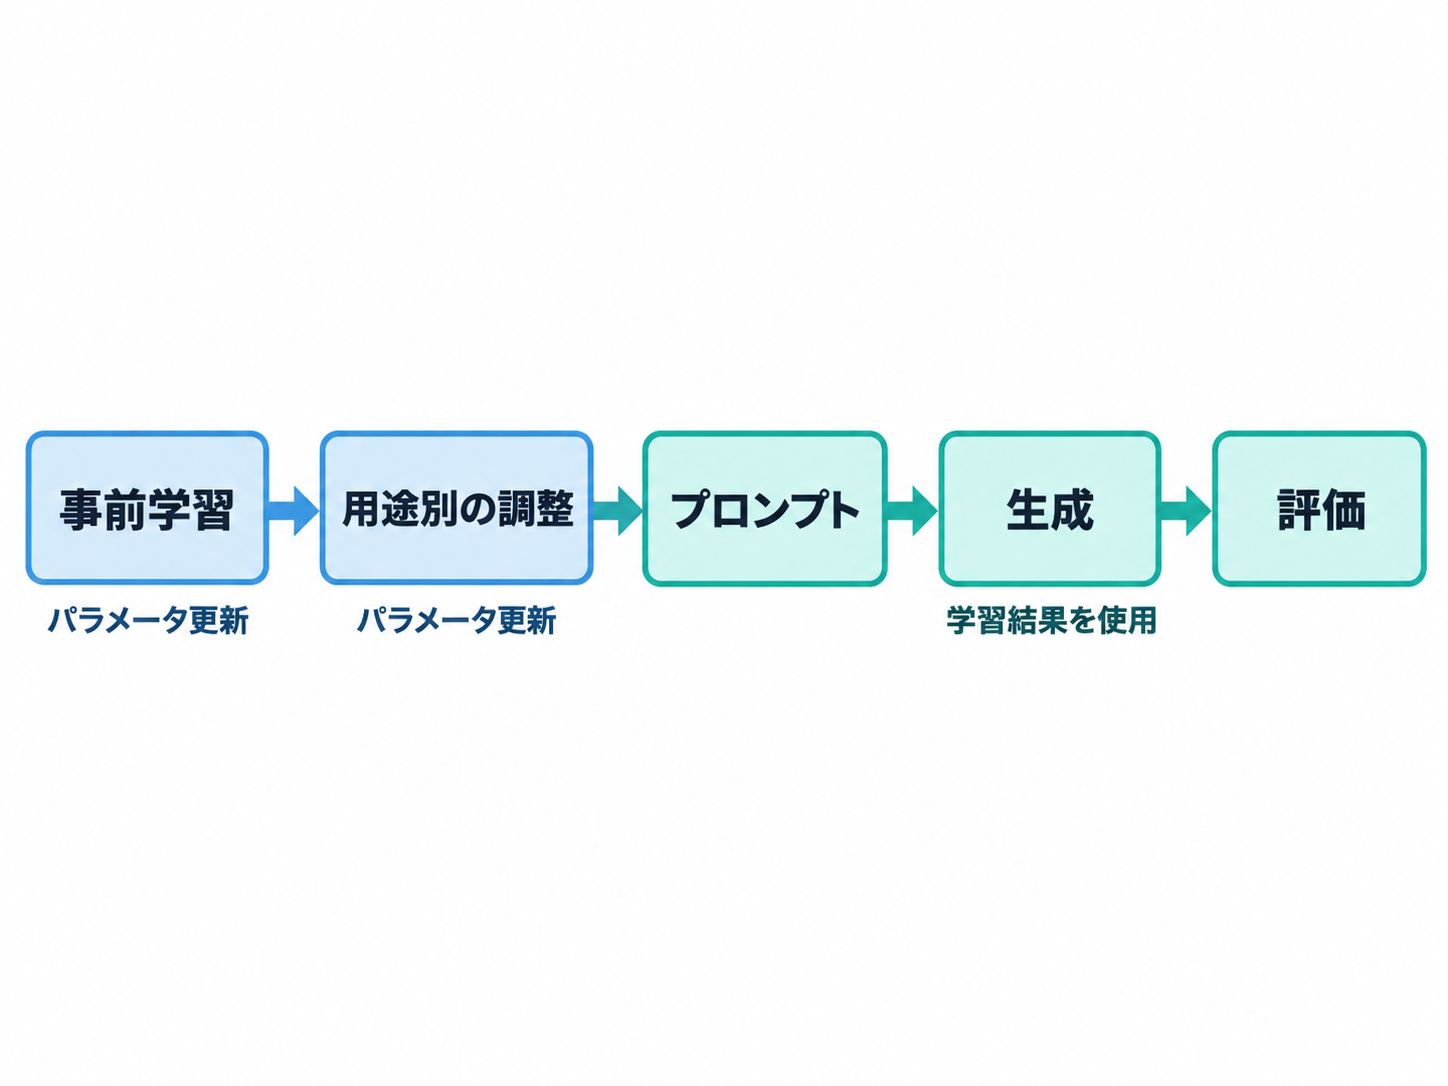
このたとえにも限界はありますが、「材料」「身に付いた調整」「今回の注文」を分ける助けになります。普段の会話でプロンプトを書き換えることは、注文内容を変えることに当たります。モデルを用途別に追加学習するファインチューニングとは別の操作です。Googleの用語集では、ファインチューニングを、事前学習済みモデルに対して特定用途向けの二段階目の学習を行い、パラメータを調整することと説明しています(出典: Google for Developers)。
したがって、チャット欄に長い説明を一度入力しただけで、基盤モデルのパラメータそのものが恒久的に増えた、と考えるのは適切ではありません。Googleの用語集では、チャットの過去のやり取りは後続の会話で使われる文脈になるとされています(出典: Google for Developers)。画面上で会話を覚えているように見える場合でも、「会話の文脈として参照していること」と「学習工程でパラメータを更新したこと」は分けて考える必要があります。
学習時の調整と回答時の生成
AIが学ぶ場面と、利用者に回答する場面は同じではありません。IBMは生成AIの流れを、大きく「学習」「調整」「生成・評価・追加調整」の三段階に整理しています。最初の学習では、大量のデータを使って基盤モデルを作ります。用途に合わせる段階では、特定分野の例や望ましい回答形式などを使って調整します。利用時には、完成したモデルがプロンプトを受け取り、内容を生成します(出典: IBM)。パラメータが中心的に作られたり変更されたりするのは学習や調整の工程であり、回答時には、その学習結果を使って出力が組み立てられます。
文章を扱う大規模言語モデルの動きを知ると、この区別がより明確になります。Googleの用語集は、Transformerを基盤とする大規模言語モデルを自己回帰モデルとし、それまでに予測されたトークンを基に次のトークンを予測すると説明しています。トークンとは、モデルが文章を処理するときの文字や単語に相当する小さな単位です(出典: Google for Developers)。回答時に行われているのは、学習資料の中から完成文を一件検索して表示することではなく、プロンプトや会話の文脈を手掛かりに、続く内容を順に生成する処理だと理解できます。
架空の例として、同じモデルに「会議の案内を書いてください」とだけ頼む場合と、「初参加者向けに、日時、場所、持ち物を見出し付きで整理してください」と頼む場合を比べてみます。モデルのパラメータを利用者がその場で作り直さなくても、入力された条件が異なるため、生成される文章の構成は変わり得ます。ここから分かるのは、回答の使いやすさがパラメータ数だけで決まるわけではないことです。モデルが学習・調整された状態に加え、今回のプロンプトが必要な目的や条件を伝えているかも、出力を読むうえで欠かせない視点になります。
パラメータ数から分かること、分からないこと
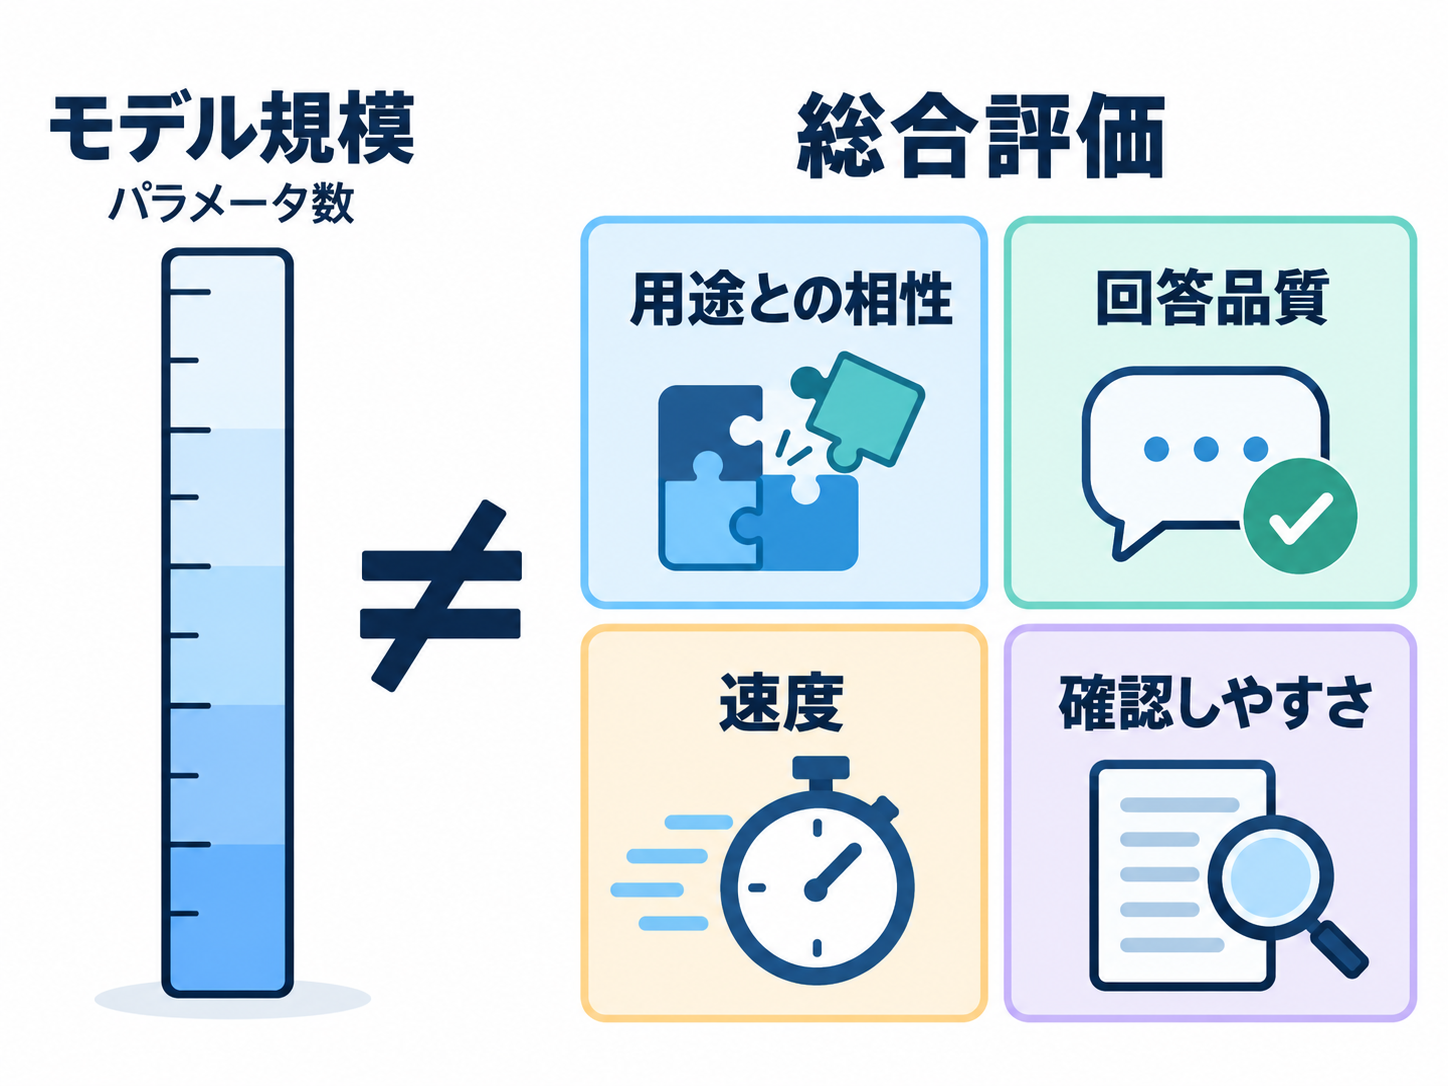
「パラメータが多いモデルほど優秀ですか」という疑問への短い答えは、「数だけでは決められません」です。パラメータ数からは、学習によって調整される数値をどの程度持つモデルなのかという規模感を読み取れます。しかし、そのモデルが自分の用途に合うか、事実に基づく回答を安定して返すか、指示した形式を守れるかまでは分かりません。IBMの説明でも、生成AIは基盤モデルを作って終わるのではなく、用途別の調整、出力の評価、追加調整を経て精度や関連性の改善を図る流れになっています(出典: IBM)。
モデルの大きさには、扱いやすさとの兼ね合いもあります。Googleの用語集によると、蒸留は、大きな教師モデルの予測をできる限り再現する小さな生徒モデルを作る方法です。小さなモデルには推論時間、メモリ使用量、エネルギー使用量を抑えられる利点がある一方、一般には教師モデルと同等の予測品質になるとは限らないと説明されています(出典: Google for Developers)。これは「小さければ常に十分」という意味でも、「大きければ常に最適」という意味でもありません。目的と条件に応じた評価が必要だということです。
たとえば、架空の社内利用を考えてみましょう。文章の表現案を幅広く出す用途と、指定した分類項目へ短い文を振り分ける用途では、求める能力が異なります。前者では表現の多様さを重視し、後者では形式の安定性や確認のしやすさを優先するかもしれません。候補モデルのパラメータ数に差があっても、その数字だけで両方の用途の勝者を決めることはできません。比較するなら、同じ架空の質問例、同じ回答条件、同じ確認基準を用意し、目的に合う出力かを見る必要があります。パラメータ数は比較項目の一つであり、比較結果そのものではないのです。
「知識の倉庫」という誤解が生む見落とし
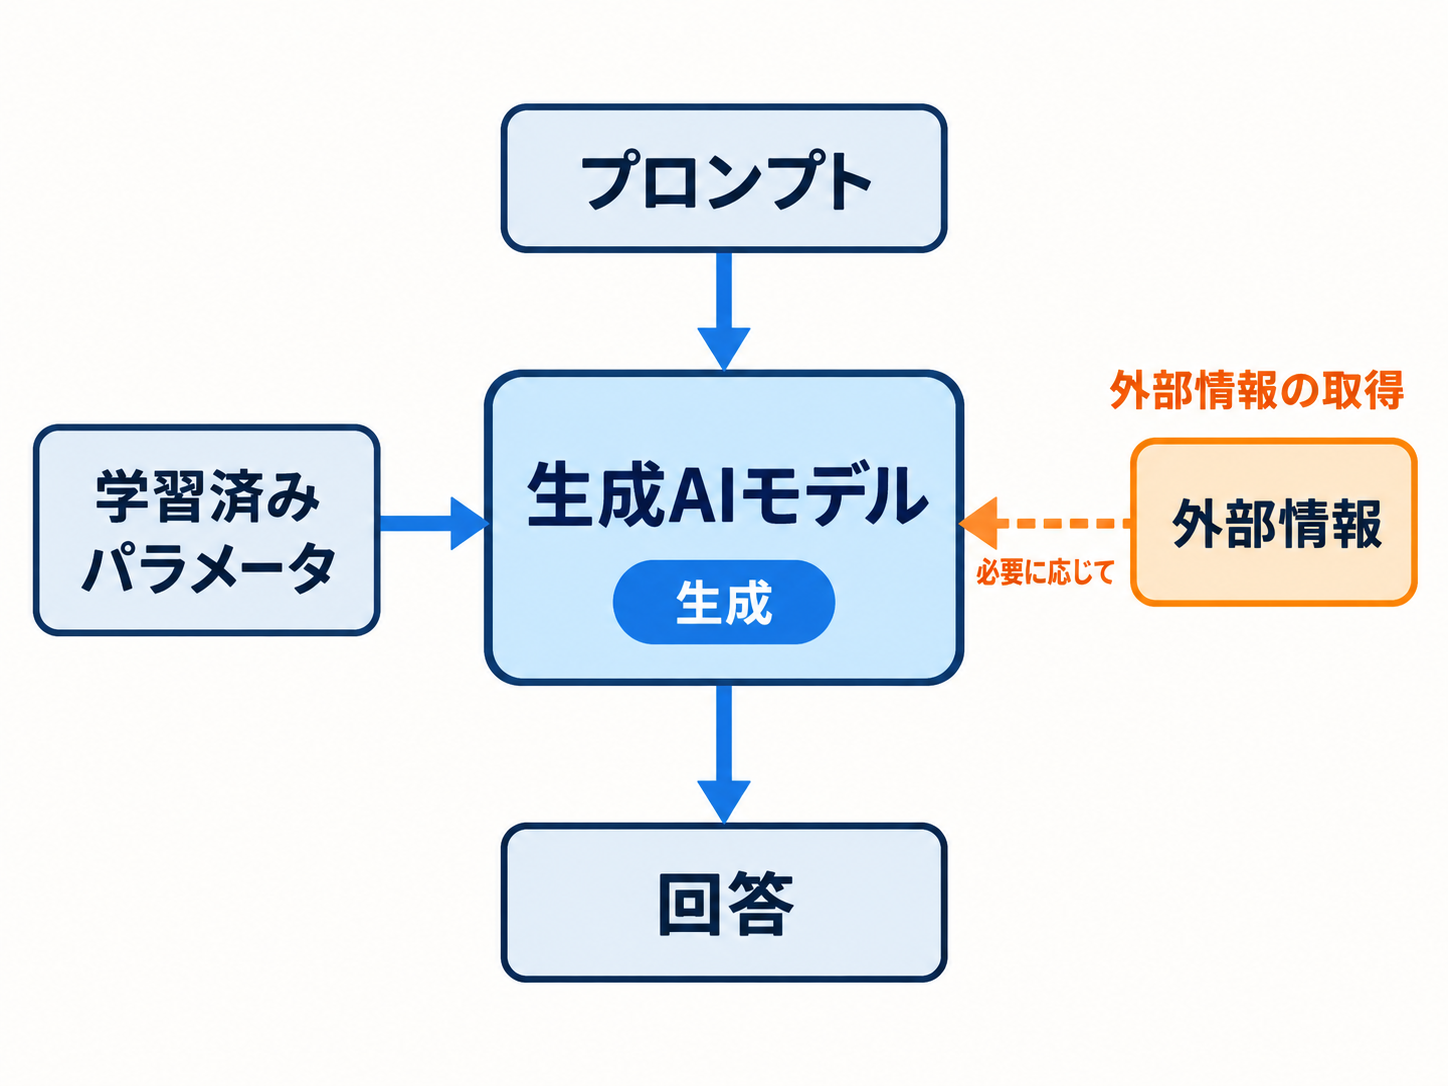
パラメータを「事実が保存された引き出し」と考えると、生成AIへの期待を誤りやすくなります。IBMは、生成モデルが学習データの単純化された表現を持ち、そこから新しい内容を生成すると説明しています(出典: IBM)。この説明からも、学習データがそのまま検索用の一覧表として並んでいる、と捉えるべきではありません。パラメータ数が大きいからといって、特定の人物、制度、製品の最新情報を何件正確に答えられるかを、その数字から計算することもできません。
生成と外部情報の検索も区別が必要です。IBMは、検索拡張生成、いわゆるRAGを、学習データの外部にある関連情報源を利用して生成AIアプリケーションの回答を改善する方法として紹介しています(出典: IBM)。この仕組みを利用するアプリケーションなら外部資料を回答に取り込めますが、あらゆる生成AIの回答が毎回ウェブや社内資料を検索しているとは限りません。「文章を自然に生成できること」と「現在の根拠資料を取得して示せること」は別の能力として確認する必要があります。
もう一つの誤解は、パラメータ数が大きければ誤った回答がなくなるという見方です。Googleの用語集では、出力が現実に基づく性質を事実性として説明する一方、創作を求めるプロンプトでは事実性より創造性が求められる場合があるとしています(出典: Google for Developers)。モデルの評価は、目的に合わせて行わなければなりません。企画名の案を出す場面では発想の幅が役立ちますが、法令、医療、契約、金額、日付などを扱う場面では、生成された文章の自然さだけを根拠に採用できません。参照資料や担当者による確認が必要かどうかを、用途ごとに判断する姿勢が欠かせないでしょう。
明日から数字に振り回されない見方
パラメータという言葉を覚える目的は、技術者のように数式を扱うことではありません。AIモデルを紹介する大きな数字に出会ったとき、何を意味し、何を保証しないのかを切り分けられれば十分です。「パラメータ数は、学習で調整される数値の規模を表す一つの手掛かりです。ただし、用途への適合性や回答の正しさを単独で保証する点数ではありません」と言い換えられれば、宣伝文句や比較記事も落ち着いて読めます。
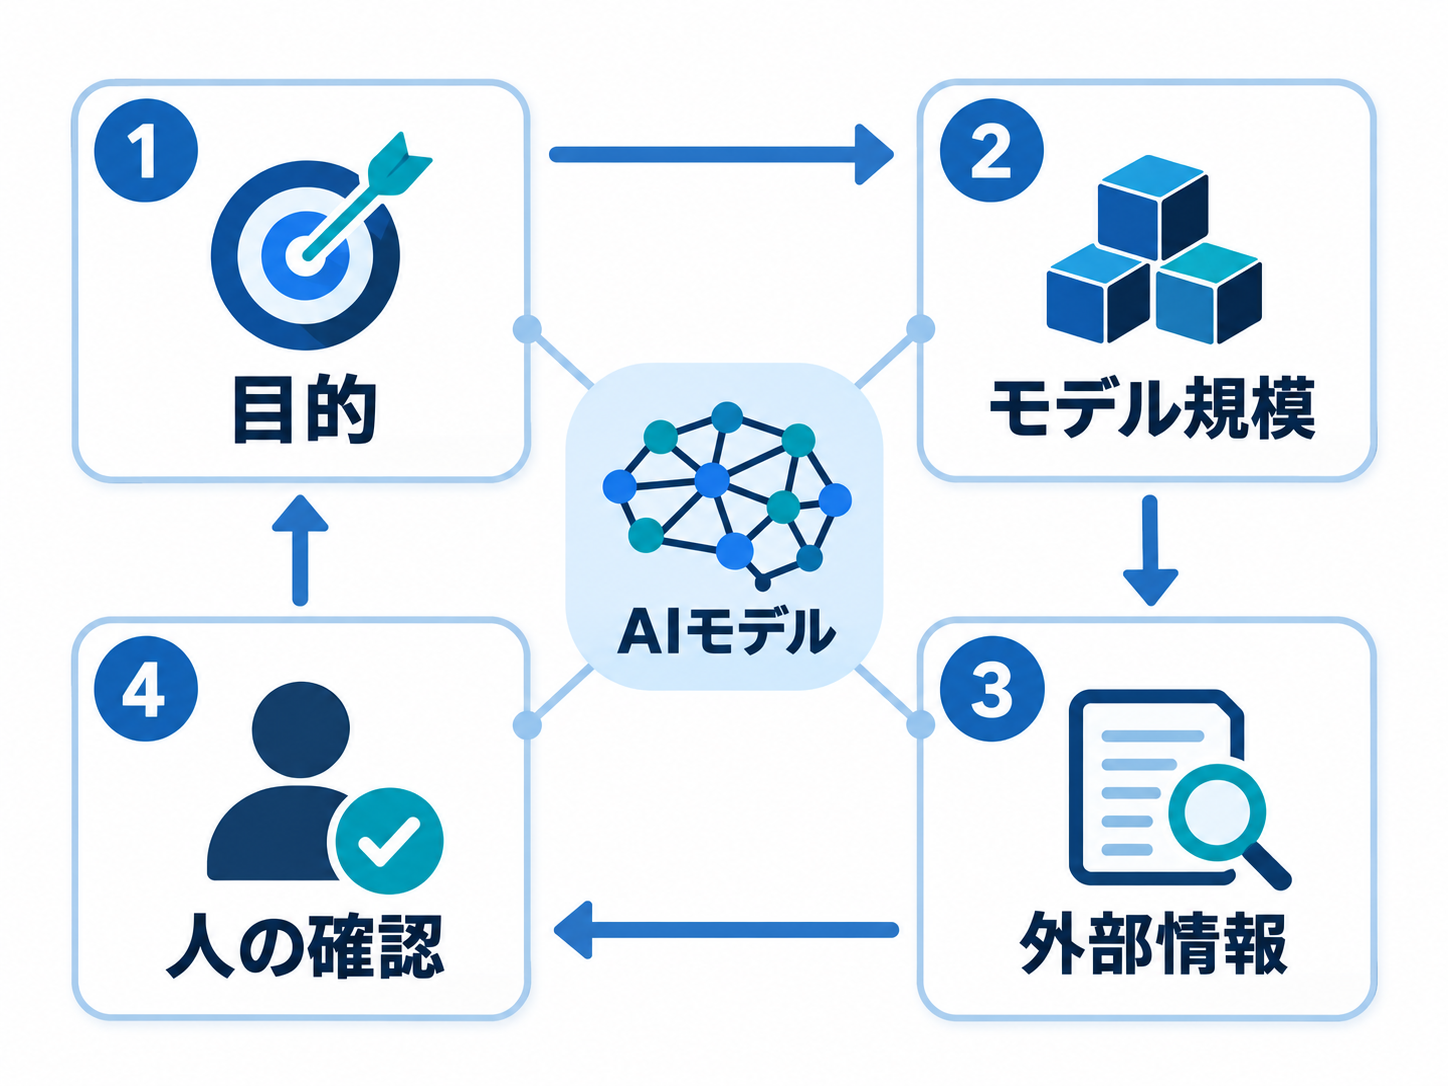
仕事や日常で生成AIを使うときは、次の四点を分けて確認すると実用的です。
- 何をさせたいのかを、文章作成、分類、要約、事実確認などの言葉で明確にします。
- パラメータ数はモデルの規模に関する情報として読み、性能全体の順位だとは決めつけません。
- 最新情報や正確な日付が必要なら、外部情報源を参照する仕組みや出典表示の有無を確認します。
- 出力は目的に合う基準で読み直し、重要な判断では元資料や担当者にも確かめます。
プロンプトにも、この見方を反映できます。以下は提案用の架空例であり、回答の正確さを保証するものではありません。
> 次の文章を初心者向けに要約してください。本文に書かれている内容と、そこから推測した内容を分け、確認できない日付や数値は補わないでください。
この依頼では、モデルの内部にあるパラメータを変更しているのではなく、今回の出力で守ってほしい条件を伝えています。得られた要約は、原文と照合してから使います。次にAIモデルの紹介でパラメータ数を見かけたら、「どのような用途で評価されたのか」「外部資料を参照するのか」「自分が必要とする出力を確認できるか」という三つの問いを添えてみてください。その瞬間から、桁の大きさだけではなく、目的と根拠に沿ってAIを選ぶ視点へ切り替えられます。
参考情報
- What Is Artificial Intelligence (AI)? — IBM、2024年8月9日公開、2026年10月2日更新、2026年10月31日取得です。
- AI vs. Machine Learning: How Do They Differ? — Google Cloud、資料上で公開日・更新日の記載を確認できず、2026年10月31日取得です。
- Glossario del machine learning: AI generativa — Google for Developers、資料上で公開日・更新日の記載を確認できず、2026年10月31日取得です。