
AI LAB
2026/10/22
OpenAI最上位モデルがGoogle Cloudへ、企業AI調達は「用途別の使い分け」へ
Google Cloudで広がるOpenAIモデルの選択肢
企業が生成AIを導入するとき、モデルの性能だけでは意思決定できません。既存のクラウド契約を使えるか、機密データをどう守るか、業務ごとにコストを調整できるかといった運用条件が、実際の採用を左右します。OpenAI Group PBCは、最新の大規模言語モデルをGoogle Cloudから利用できるようにする計画を発表しました。最初に提供されるのは、最上位モデルのGPT-6 Astraと、その小型版に当たるGPT-6.1 Sol、GPT-6 Lunaです。3モデルは、Google Cloudの「Model Garden」に追加され、数週間以内に一般提供される予定です。Model Gardenは、Google、そのパートナー、オープンソースのエコシステムから集めた200種類以上のニューラルネットワークを扱うサービスです。大規模言語モデルだけでなく、翻訳など特定の処理に最適化された小規模モデルも含まれています。企業の担当者は、単一のモデルですべての業務を処理するのではなく、品質、価格、用途に応じて候補を選びやすくなります。
今回の発表で注目すべき点は、OpenAIのモデルがGoogle Cloudという別企業の基盤に加わることだけではありません。Google Cloudをすでに利用している企業が、クラウド環境や調達の枠組みを大きく変えずにモデルを検討できる点にあります。生成AI市場では、モデル単体の優劣に加え、企業が既存のシステムへどれだけ無理なく組み込めるかが競争軸になっていると考えられます。
Astra、Sol、Lunaが示す性能と価格の段階設計
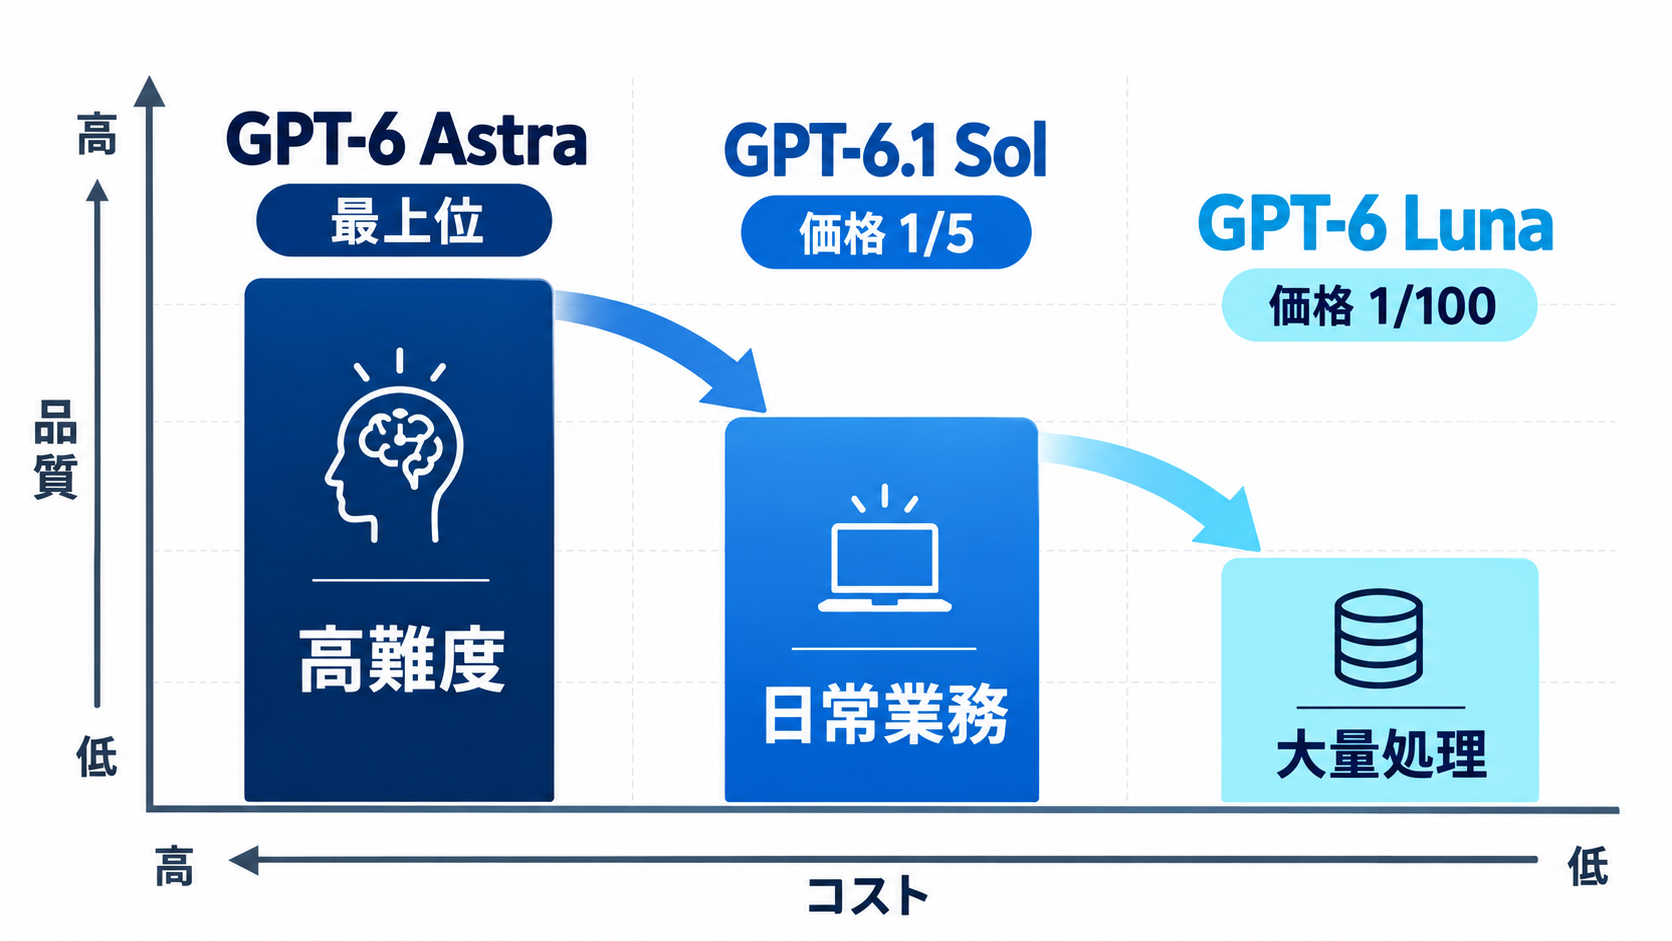
GPT-6 Astraは、OpenAIが主力に位置づける最上位モデルです。同社がここ数週間に公表した、AIによる数学上の発見の一部にも使われています。また、言語モデルがサイバーセキュリティ上の脆弱性を発見し、悪用できる能力を測る「ExploitBench」では満点を記録したとされています。この結果は高度な推論能力を示す材料になる一方、同じ能力が防御と攻撃の双方に利用され得ることも意識させます。Google Cloudでは、Astraに加えてGPT-6.1 SolとGPT-6 Lunaも提供されます。両モデルはAstraより出力品質の一部を抑える代わりに、トークン単価を大幅に下げた構成です。発表された比較では、Solの価格はAstraの5分の1、Lunaは100分の1に相当します。大量の文書を分類する処理と、複雑な分析を伴う処理に同じモデルを割り当てる必要はないため、この価格差は企業の設計判断に直結するでしょう。
たとえば、経営判断に使う精密な分析や難度の高い技術調査にはAstraを検討し、日常的な文章処理にはSol、量が多く比較的定型的な処理にはLunaを試す、といった役割分担が考えられます。ただし、具体的な得意分野や業務別の精度、応答速度については、今回確認できた範囲では詳細が示されていません。価格差だけでモデルを固定せず、自社データを用いた評価で品質と費用の境界を確かめる必要があります。
高性能モデルを企業で扱うための安全設計
Astraには、企業利用を想定した安全面の最適化が施されています。OpenAIは、自社が評価したほかのフロンティアモデルと比べて、意図や方針から外れた結果が少ないと説明しています。また、ユーザーが指定した実行制限をモデル自身が回避しないよう設定されているとのことです。ここでいうフロンティアモデルとは、その時点で最先端級の能力を備えた汎用AIモデルを指します。企業システムでは、回答が正確かどうかだけでなく、許可された範囲内で動くかが問われます。顧客対応AIなら返金や契約変更を独断で実行させない、開発支援AIなら本番環境の認証情報へアクセスさせない、といった境界設定が欠かせません。モデルが高性能になるほど実行できる作業の幅も広がるため、制限を守る性質は運用上の価値を持ちます。
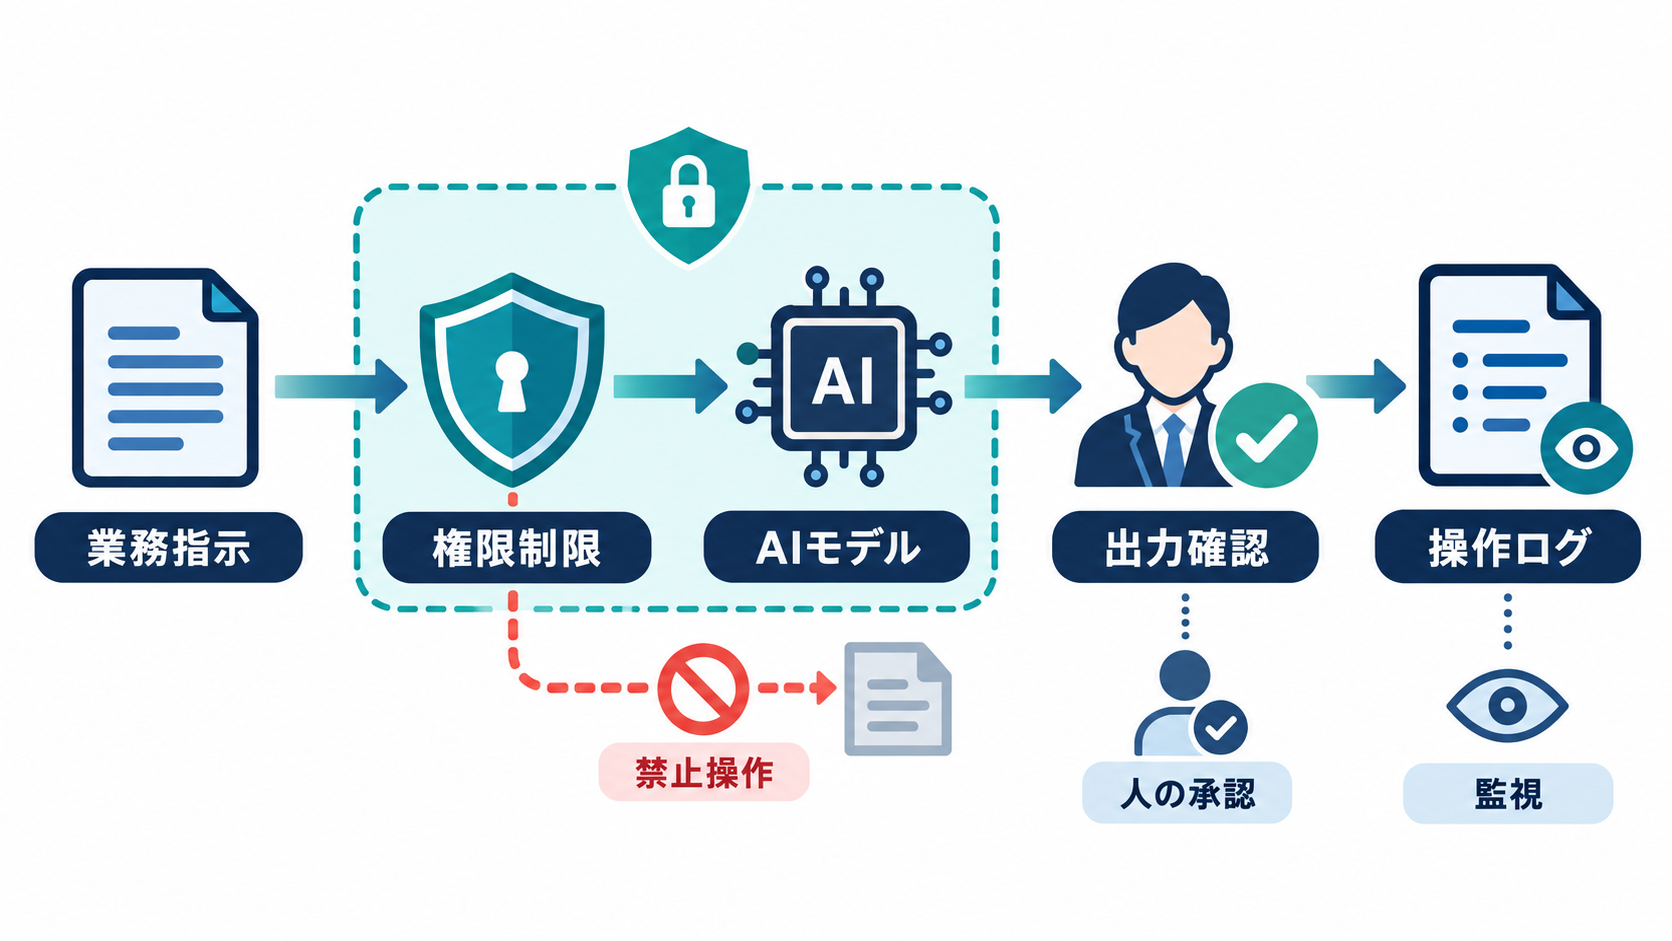
もっとも、「安全最適化済み」という説明だけで企業側の管理が不要になるわけではありません。ExploitBenchで示された脆弱性探索能力を業務で使う場合も、対象システム、権限、記録、承認手順を明確にする必要があります。モデルの設定に加え、入力データの管理、出力の確認、人による承認、操作ログの保存を組み合わせることで、ようやく実務に適した統制になります。導入評価では性能テストと安全性テストを分けず、同じ利用シナリオの中で確認するのが現実的です。
既存のクラウド契約を生かせる調達上の利点
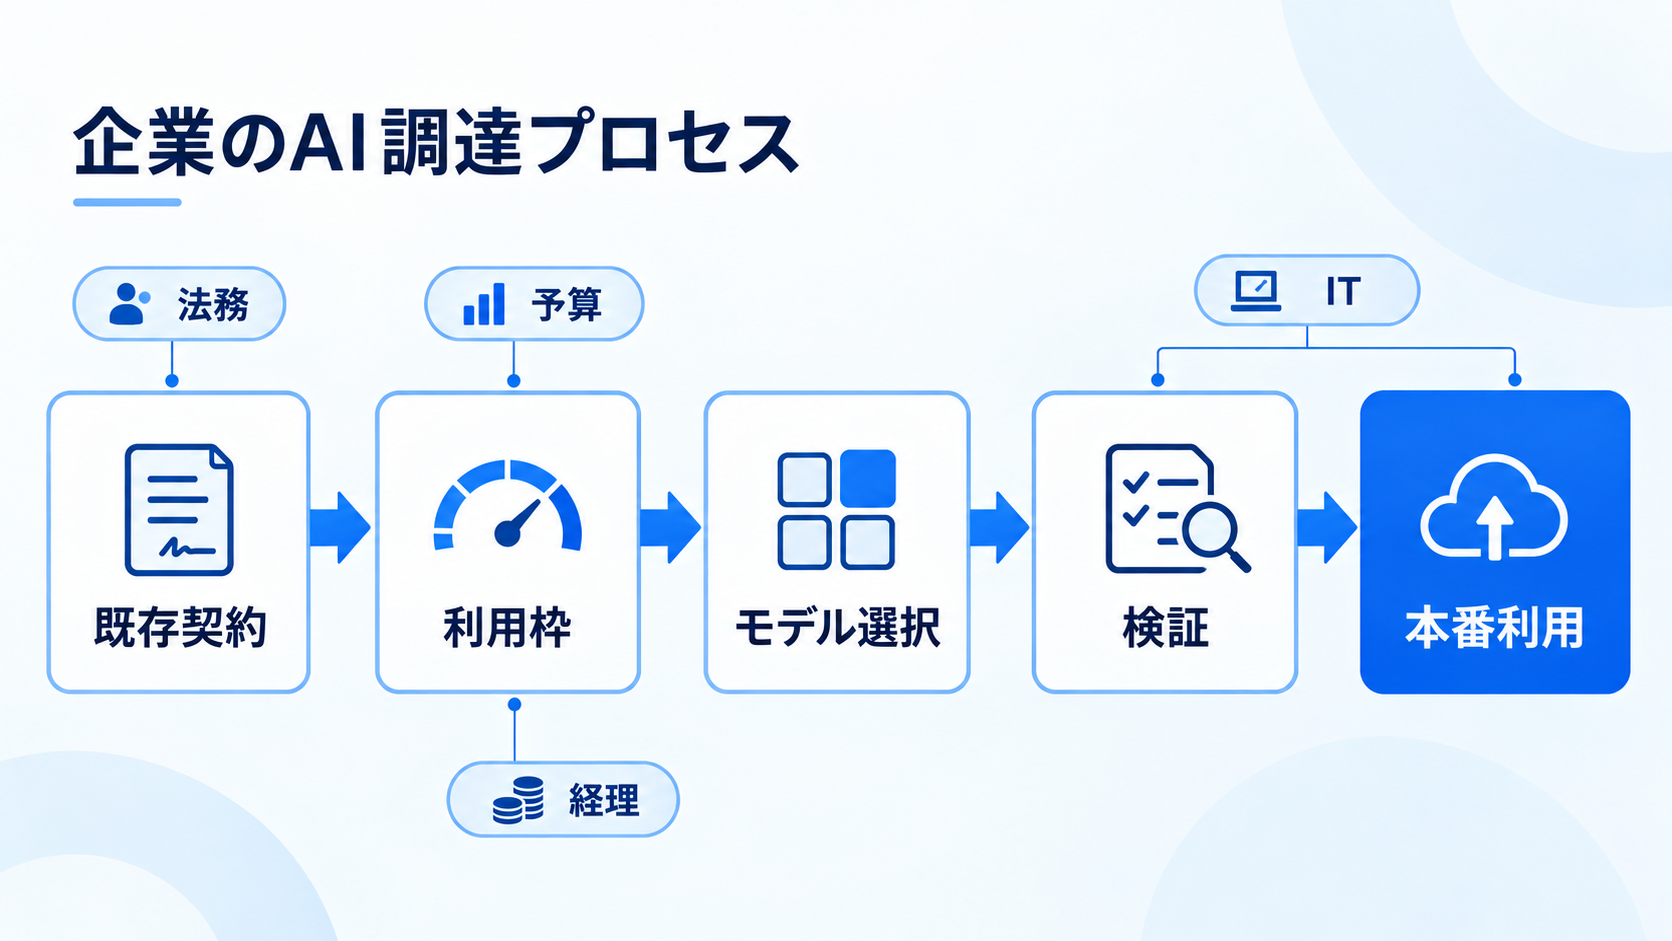
クラウド事業者は、一定期間の利用額を約束する企業に割引を提供することがあります。OpenAIの説明によると、Google Cloudの顧客は、こうした既存の利用契約を同社モデルへのアクセス費用に充てられます。新しいAIサービスを導入するたびに別の予算枠や支払い手続きを用意する必要が減るため、技術部門だけでなく、調達、経理、法務にとっても扱いやすい形です。企業のAI導入が遅れる理由は、モデルを動かせないことだけではありません。新規ベンダーの審査、契約条件の確認、請求管理、利用額の予測など、社内手続きにも時間がかかります。すでにGoogle Cloudとの取引関係や利用枠がある企業なら、その延長線上でAstra、Sol、Lunaを評価できる可能性があります。モデルの選択肢が増えるだけでなく、検証から本番利用へ移る際の調達経路も整理しやすくなるでしょう。
ただし、利用枠を転用できることと、費用が自動的に下がることは同じではありません。Astraのような高価格帯モデルを広範囲に使えば、契約枠を早く消費する可能性があります。担当部門には、処理件数だけでなく、入力と出力のトークン量、再試行の頻度、人による確認コストまで含めた試算が求められます。既存予算を使える利便性を、モデルを無制限に利用してよいという意味に取り違えない管理が必要です。
Confidential Computeが支える機密データ処理
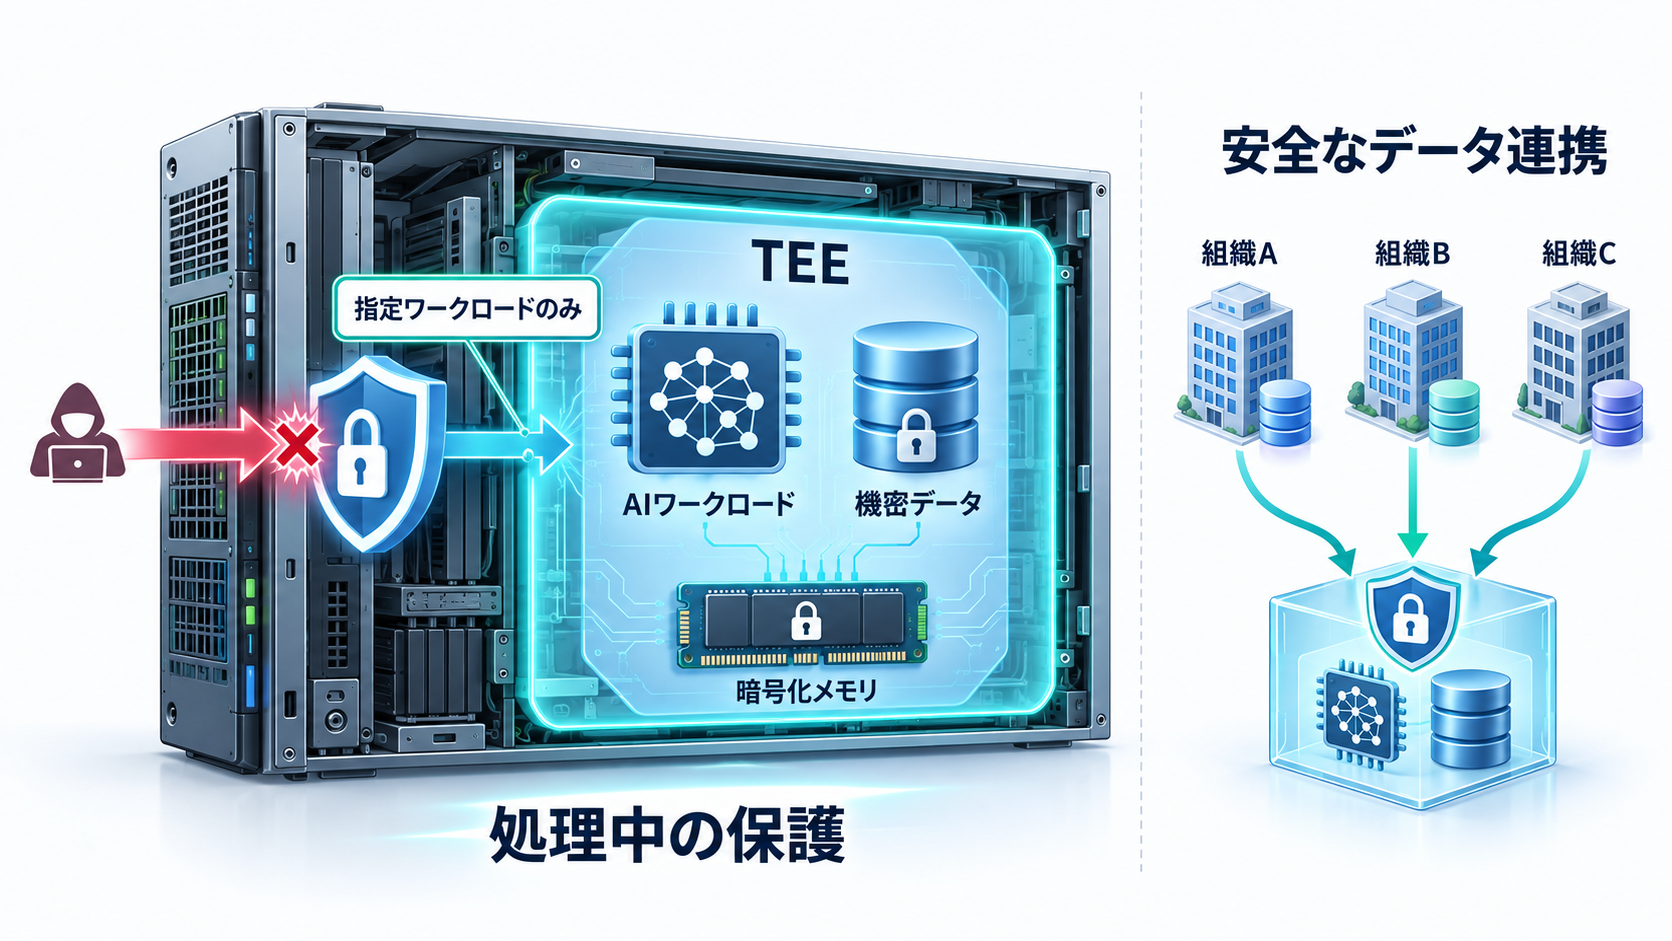
OpenAIとGoogleは、Model Gardenでの提供後、3モデルをGoogleの「Confidential Compute」関連サービスでも利用できるようにする計画です。Confidential Computeは、処理中のデータを保護することを狙ったインフラ技術です。その中核には、サーバー向けCPUが備える「TEE(Trusted Execution Environment)」と呼ばれる隔離実行環境があります。TEEでは、サーバーのメモリの一部を暗号化し、指定されたワークロードだけがアクセスできる状態を作ります。保存時の暗号化や通信経路の暗号化だけではなく、計算のためにデータを扱っている最中も保護範囲を広げる考え方です。GoogleのConfidential Computeサービスは、この仕組みを使って顧客のワークロードを保護します。複数の組織がAI学習用のデータセットを共有するような場面でも、データを扱う環境を限定する手段になり得ます。
日本企業にとっては、機密文書、研究情報、取引データなどを生成AIで処理する際の選択肢が増えることになります。ただし、TEEを使えば、データ利用に関するすべてのリスクが解消するわけではありません。誰が処理を開始できるのか、モデルへ何を入力してよいのか、生成結果をどこへ保存するのかといった運用設計は別途必要です。一般提供の時期や具体的な対応構成は現時点で明らかにされていないため、導入判断では提供条件と技術仕様を確認する必要があります。
コーディングと業務自動化へ広がる提供先
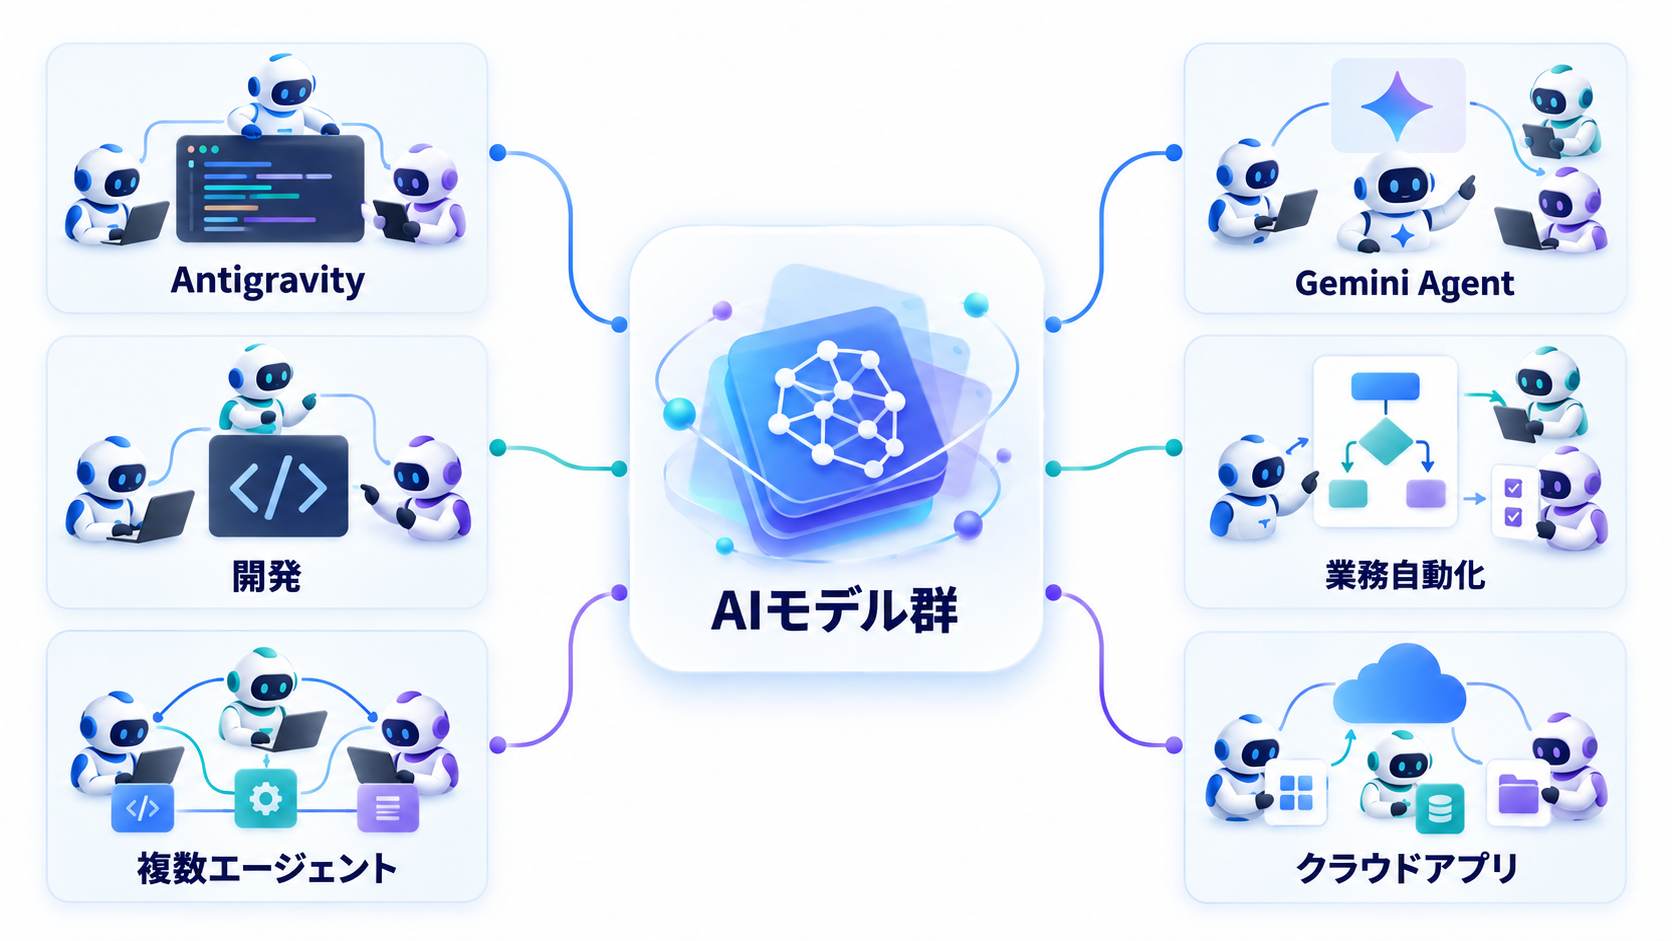
OpenAIは、Googleの「Antigravity」と「Gemini Agent」からも自社モデルを利用できるようにする計画です。Antigravityは、複数のAIエージェントを組み合わせる「エージェント・アンサンブル」により、ソフトウェア開発を高速化するバイブコーディングツールです。バイブコーディングとは、開発者が自然言語で目的や修正内容を指示し、AIによるコード生成や編集を活用して開発を進める手法を指します。Gemini Agentは、複数のクラウドアプリケーションにまたがる業務を自動化する製品です。たとえば、情報の収集、内容の判断、別システムへの入力という一連の流れでは、単発の回答を返すチャットAIよりも、複数工程を扱うエージェント型の仕組みが適しています。そこへAstra、Sol、Lunaが加われば、工程の難度や必要な品質に応じてモデルを使い分ける構成が考えられます。
この展開は、生成AIモデルの提供場所が単なるモデル一覧にとどまらず、開発環境や業務自動化の入口へ広がることを示しています。ただし、各製品でどのモデルをどのように選択できるのか、既存のGoogle製モデルとどう連携するのかは詳しく公表されていません。企業が評価する際は、単発の回答品質だけでなく、複数工程を通した成功率、失敗時の停止方法、人へ処理を戻す仕組みまで確認する必要があります。
日本企業が検証すべきモデル選定の順序
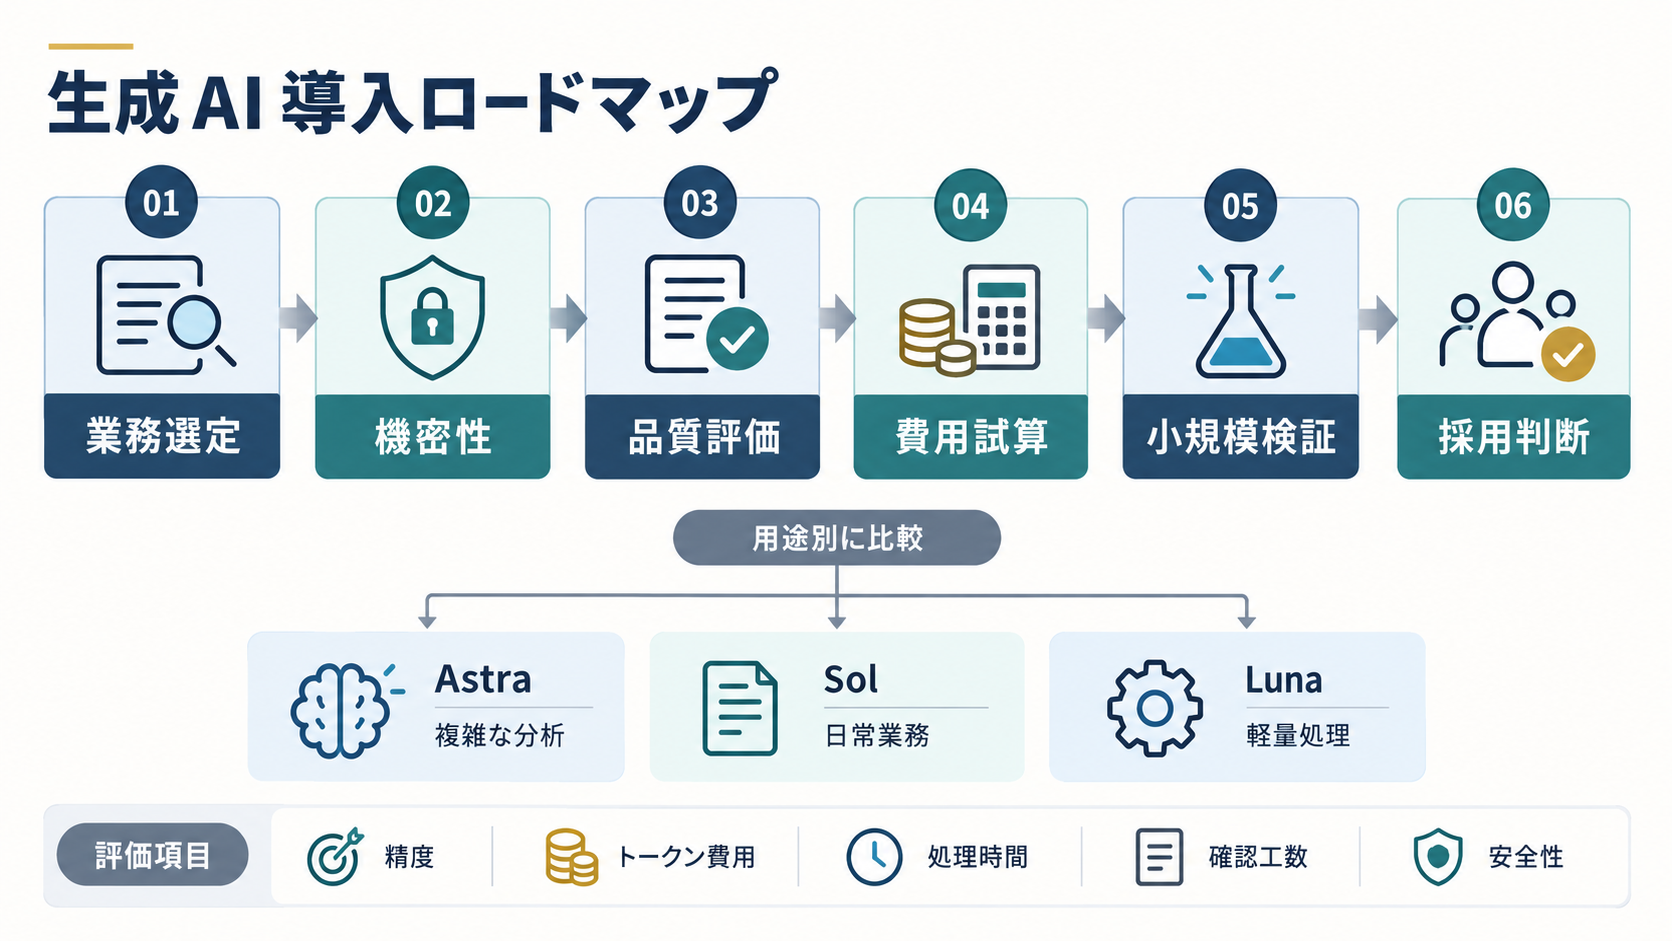
今回の動きから読み取れるのは、「最も高性能なモデルを一つ選ぶ」という発想から、業務ごとにモデルを割り当てる運用への移行です。Astra、Sol、Lunaには明確な価格差があり、Google Cloud側にはModel Garden、Confidential Compute、開発支援、業務自動化という複数の利用経路があります。選択肢が増えた分だけ、導入前に業務要件を分解する作業が欠かせません。検証の起点はモデル名ではなく、処理する仕事です。誤りが業務へ与える影響、扱うデータの機密性、月間の処理量、人の確認を入れられるかを整理すると、必要な品質と許容コストが見えやすくなります。高難度かつ件数の少ない処理にはAstra、品質と費用の均衡を求める処理にはSol、大量で定型的な処理にはLunaという仮説を置き、同一の評価データで比較する方法が考えられます。これは製品特性を断定するものではなく、検証計画を立てるための出発点です。
Google Cloudの利用契約がある企業は、既存の予算枠を確認すると同時に、データ保護と権限管理の条件も洗い出すとよいでしょう。モデル単価が低くても、誤回答の修正や監視に多くの工数がかかれば、総費用は下がりません。小規模な実データ評価を行い、品質、トークン費用、処理時間、確認工数、安全上の逸脱を同じ表で記録すれば、用途別の判断材料になります。一般提供が始まった段階で比較を開始できるよう、候補業務と評価基準を先に準備しておくことが具体的な一歩になります。