
2026/11/01
AI活用
Codexでプルリクエストの一次レビューを標準化する――差分読解から確認記録まで
対象読者:上級者向け
レビュー担当者に集中する作業と判断
午後、開発者からプルリクエストのレビュー依頼が届きます。レビュー担当者はGitホスティングサービスの差分画面を開き、変更の目的をチケットで確認します。続いてIDEで関連コードを検索し、リポジトリの規約、既存の実装、テスト結果を照合します。指摘が見つかれば、該当箇所、問題になる条件、修正の方向性をコメントにまとめます。最後に承認できるか、修正後に再確認するかを判断するまでが一連の業務です。
AIを使わないレビューでも、差分表示、コード検索、テストランナー、チェックリストといった道具は利用されています。したがって、比較すべきなのは「人がすべてを目視する状態」と「何も道具を使わない状態」ではありません。同じプルリクエスト、同じベースブランチ、同じ品質基準を対象に、Codexが情報収集と一次整理を補助した場合に工程がどう変わるかを見ます。
人だけでレビューする場合、担当者は変更ファイルを読みながら、呼び出し元や依存先を行き来します。コーディング規約との不一致を探し、変更に対応するテストがあるかも確認しなければなりません。差分そのものが小さくても、影響範囲を判断するには周辺コードを読む必要があります。プルリクエストの説明が簡潔すぎれば、実装意図を開発者へ質問する作業も発生するでしょう。
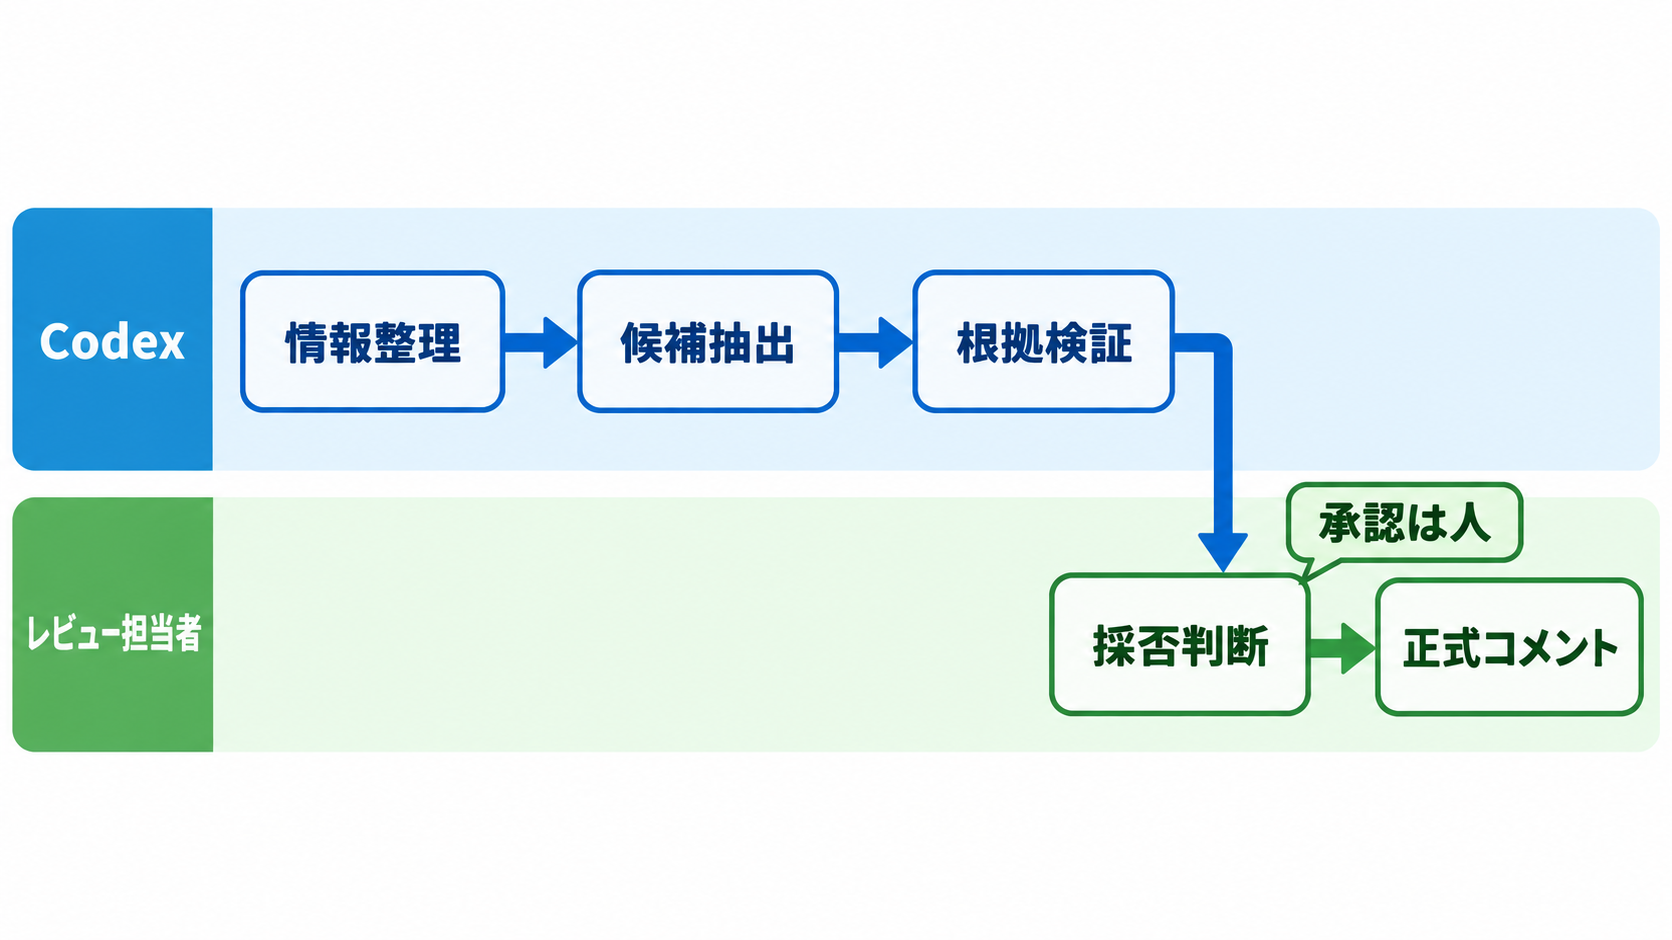
ここでCodexに任せるのは承認判断ではなく、差分の読み取り、関連箇所の探索、規約との照合、確認候補の構造化です。成果物は「そのまま投稿するレビューコメント」ではなく、レビュー担当者が検証する一次レビュー記録とします。バグかどうか、仕様に反しているか、修正を要求すべきかは、業務要件と運用事情を知る人が判断します。この境界を決めておくことが、レビュー支援を安全に始める条件です。
差分読解で往復が生じる六つの工程
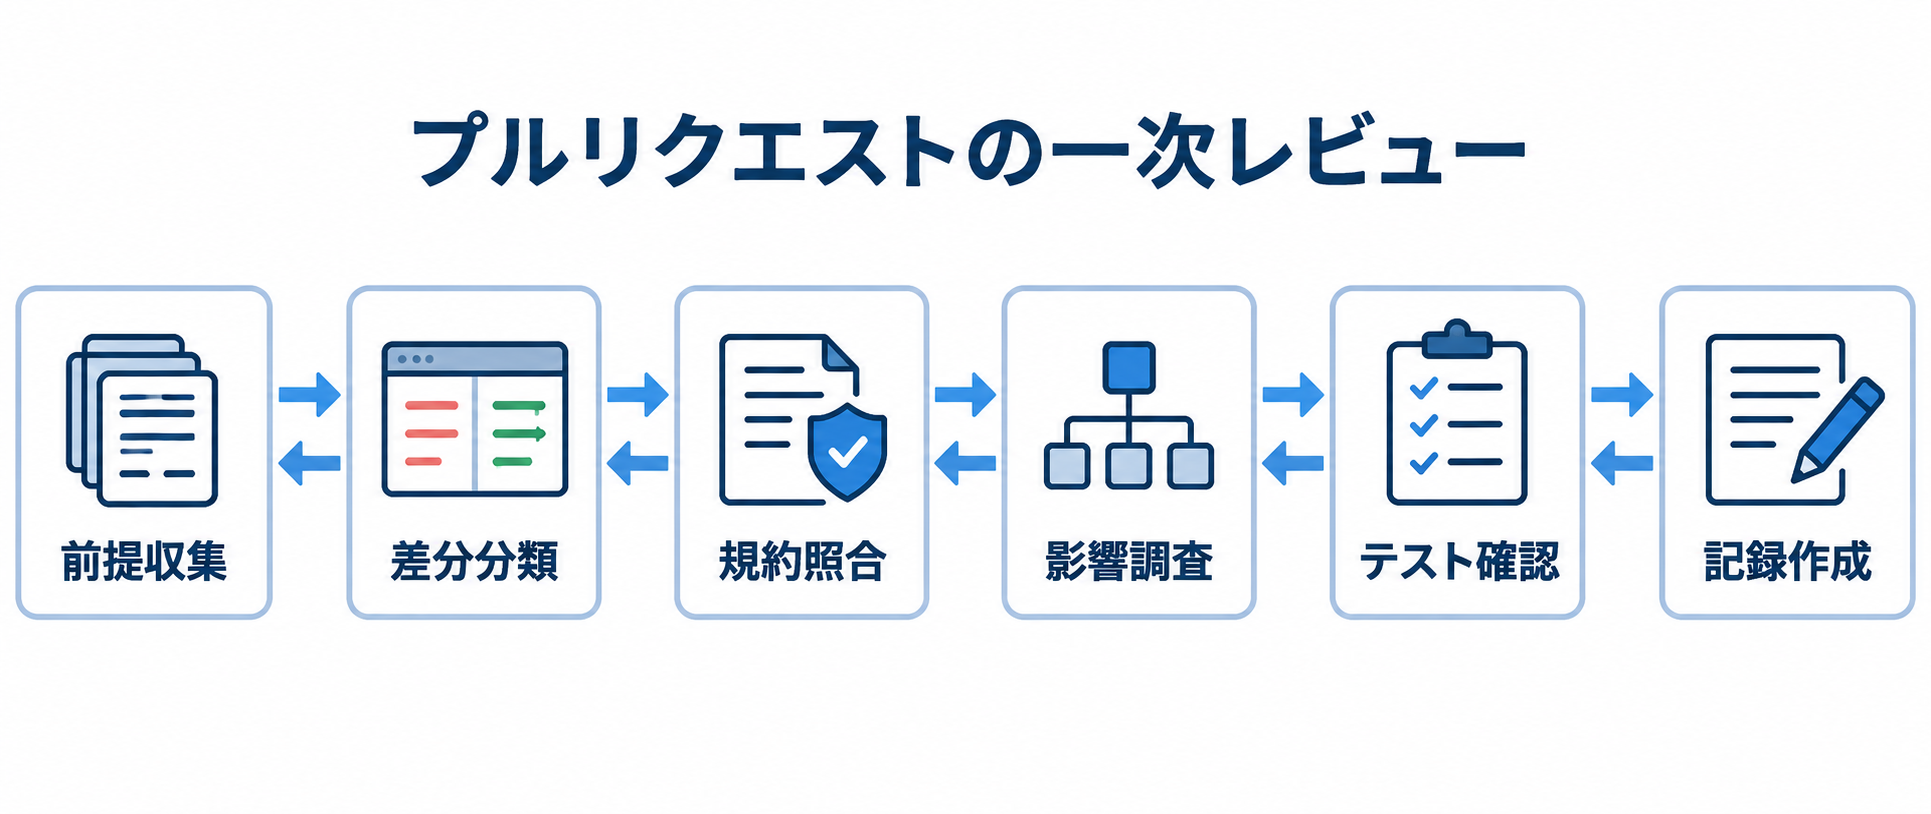
コードレビューの負担は、差分を読む時間だけでは測れません。最初に必要なのは、変更目的と受け入れ条件を探す作業です。プルリクエスト本文、関連チケット、設計資料、リポジトリ内の説明が分散していると、担当者はレビューを始める前に前提を組み立て直します。目的が曖昧なまま差分を読むと、後から仕様を知って読み直すことになりかねません。
二つ目は差分の分類です。変更を機能追加、リファクタリング、テスト、設定変更などに分け、それぞれに適した観点を当てます。三つ目は規約照合で、命名や例外処理だけでなく、チーム固有の責務分割や禁止事項まで確認します。規約が文書化されていない場合、経験者の記憶に依存しやすく、担当者によって指摘の粒度が変わります。
四つ目は影響範囲の調査です。公開インターフェースの変更、呼び出し元、データ形式、エラー処理、権限境界などを追います。五つ目はテストの確認で、変更された条件分岐に対応するケースがあるか、既存テストが何を保証しているかを読み解きます。テストが成功したという事実だけでは、必要な振る舞いを網羅しているとは限りません。
六つ目は確認記録の作成です。担当者は、発見内容を重要度、根拠、再現条件、修正候補に分け、開発者が判断できる文章へ整えます。ここで根拠の薄い指摘を混ぜると、説明と再確認の往復が増えます。反対に、確信が持てない候補をすべて捨てれば、確認すべきリスクを見逃す可能性があります。
Codexによる一次レビューは、これらの工程をなくすものではありません。複数のファイルを行き来する探索と、同じ形式への整理をまとめて依頼し、人が検証すべき候補を絞る使い方です。特に効果を確かめやすいのは、規約が文書化され、テスト方法と受け入れ条件が明確なリポジトリです。前提が曖昧な場合は、AIの出力を増やすより、先に不足情報を特定するほうがよいでしょう。
Codexを組み込んだ一次レビュー工程
Codexを加えた後も、入力と品質条件は変えません。対象は同じベースブランチとの差分であり、目標は既存のレビュー基準を満たすことです。変わるのは、担当者がすべての探索を手作業で始める代わりに、Codexへ読み取り範囲と出力形式を指定し、候補一覧を起点に検証できる点です。
| 工程 | AIを使わない場合 | Codexによる補助 | 人が残す判断 |
| --- | --- | --- | --- |
| 前提確認 | 説明や規約を個別に探す | 参照元と不足情報を整理する | 要件の正しさを確定する |
| 差分読解 | ファイルを順に読み関連箇所を検索する | 変更を目的別に分類して関連箇所を候補化する | 読む範囲が十分か判断する |
| 規約照合 | 記憶と文書を行き来する | 指示文書との不一致候補を列挙する | 例外を認めるか判断する |
| テスト確認 | 差分とテストを手作業で対応付ける | 変更条件と既存テストの対応表を作る | 必要な保証水準を決める |
| 記録作成 | 指摘文を一件ずつ下書きする | 根拠付きの確認記録を下書きする | 投稿、保留、却下を決める |
OpenAIの開発ワークフロー例では、`AGENTS.md`は任意のファイルですが、存在する場合はCodexがリポジトリの継続的な指示として読み取ると説明されています。目的、コーディング規約、テスト基準、関連資料、プロジェクト固有の境界などを記録する用途が示されています(出典: OpenAI Developers)。この仕組みを利用すると、担当者がレビューのたびに同じ規約を説明する作業を減らせます。
同資料には、`harness/code_review/`を含むディレクトリ構成例も掲載されています。ただし、これはCodexが要求する固定構成ではなく、推奨されるワークフロー上の慣例です(出典: OpenAI Developers)。自社で採用する場合は、既存のレビュー記録や監査方法に合わせて保存先を決めます。
重要なのは、Codexの出力を「指摘」ではなく「指摘候補」として扱うことです。候補には、対象ファイル、該当箇所、根拠、発生条件、想定される影響、確認方法を付けさせます。レビュー担当者は実装と仕様を照合し、根拠を再現できたものだけを正式なコメントへ変換します。これにより、自動化の範囲と承認責任を混同せずに済みます。
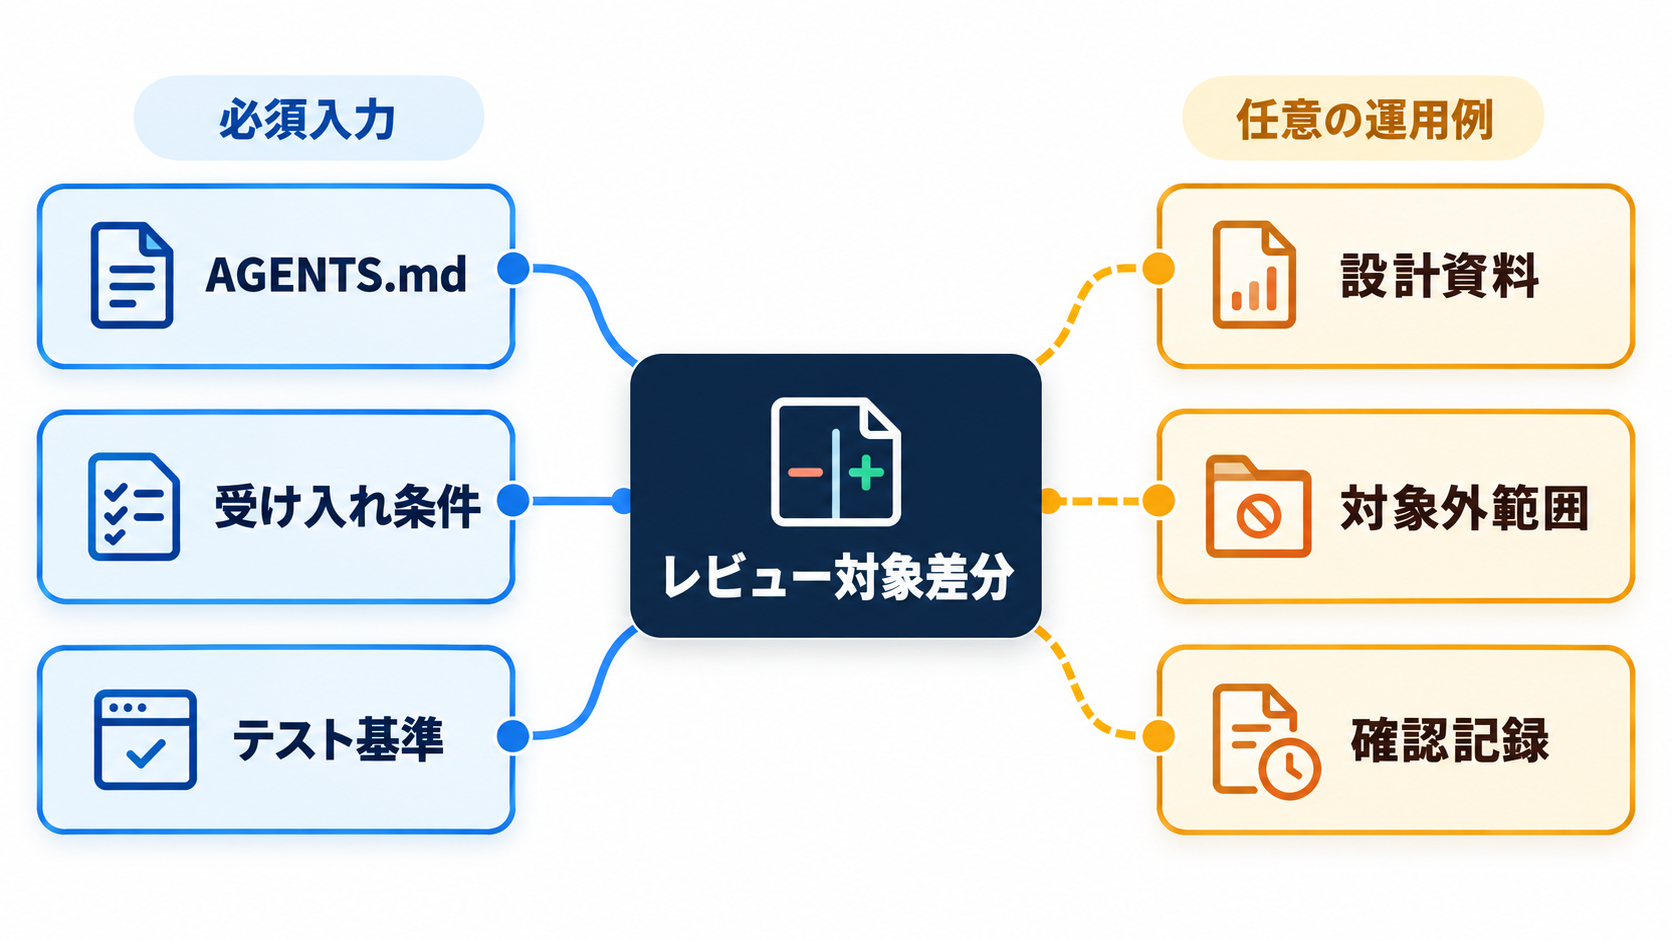
レビュー開始前に固定する入力と境界
実践には、Gitのブランチと差分、使用言語、テスト構成、アプリケーションの責務を理解できることが前提です。少なくとも、比較対象となるベースブランチ、プルリクエストの目的、受け入れ条件、レビュー対象外の変更、実行可能な検証方法を用意します。これらが不明なままでは、Codexが広い範囲を探索しても、重要な指摘と単なる実装上の好みを分離できません。
`AGENTS.md`を使う場合は、組織全体の一般論を詰め込むのではなく、このリポジトリで判断に影響する情報を記載します。たとえば、レイヤーごとの責務、変更時に必要なテスト、互換性を維持するインターフェース、触れてはいけない生成物、認証情報の扱いなどです。Codexの公式ワークフロー例でも、リポジトリの概要、コーディング規約、テスト基準、関連コンテキスト、固有の振る舞い、スコープと境界が候補として挙げられています(出典: OpenAI Developers)。
レビュー記録の書式も先に決めます。これは製品の必須仕様ではなく、チームで採用する運用例です。記録項目を「重要度」「対象箇所」「観察した事実」「問題になる条件」「影響」「確認方法」「修正候補」「人の判定」にそろえると、AIの出力と最終判断を区別できます。保存するなら、既存の監査方針に従い、例として`harness/code_review/pr-番号.md`のような場所を検討できます。
作業権限は読み取り中心から始めます。一次レビューでは、アプリケーションコードの編集、コミット、プッシュ、プルリクエストへのコメント投稿を同時に許可する必要はありません。公式のワークフロー例でも、コミット、プッシュ、デプロイ、認証情報、外部への書き込みは個別の明示的な承認の後ろに置く考え方が示されています(出典: OpenAI Developers)。レビューと修正を別の承認段階に分ければ、候補を確認する前に変更が加わる事態を避けられます。
社外秘、顧客情報、認証情報を含むリポジトリでは、所属組織の利用規程とデータ分類を確認します。対象にできないファイルやディレクトリがあるなら、依頼文に書くだけでなく、アクセス権や作業環境でも制限する必要があります。AIへの指示は統制の一部にすぎず、権限管理の代わりにはなりません。
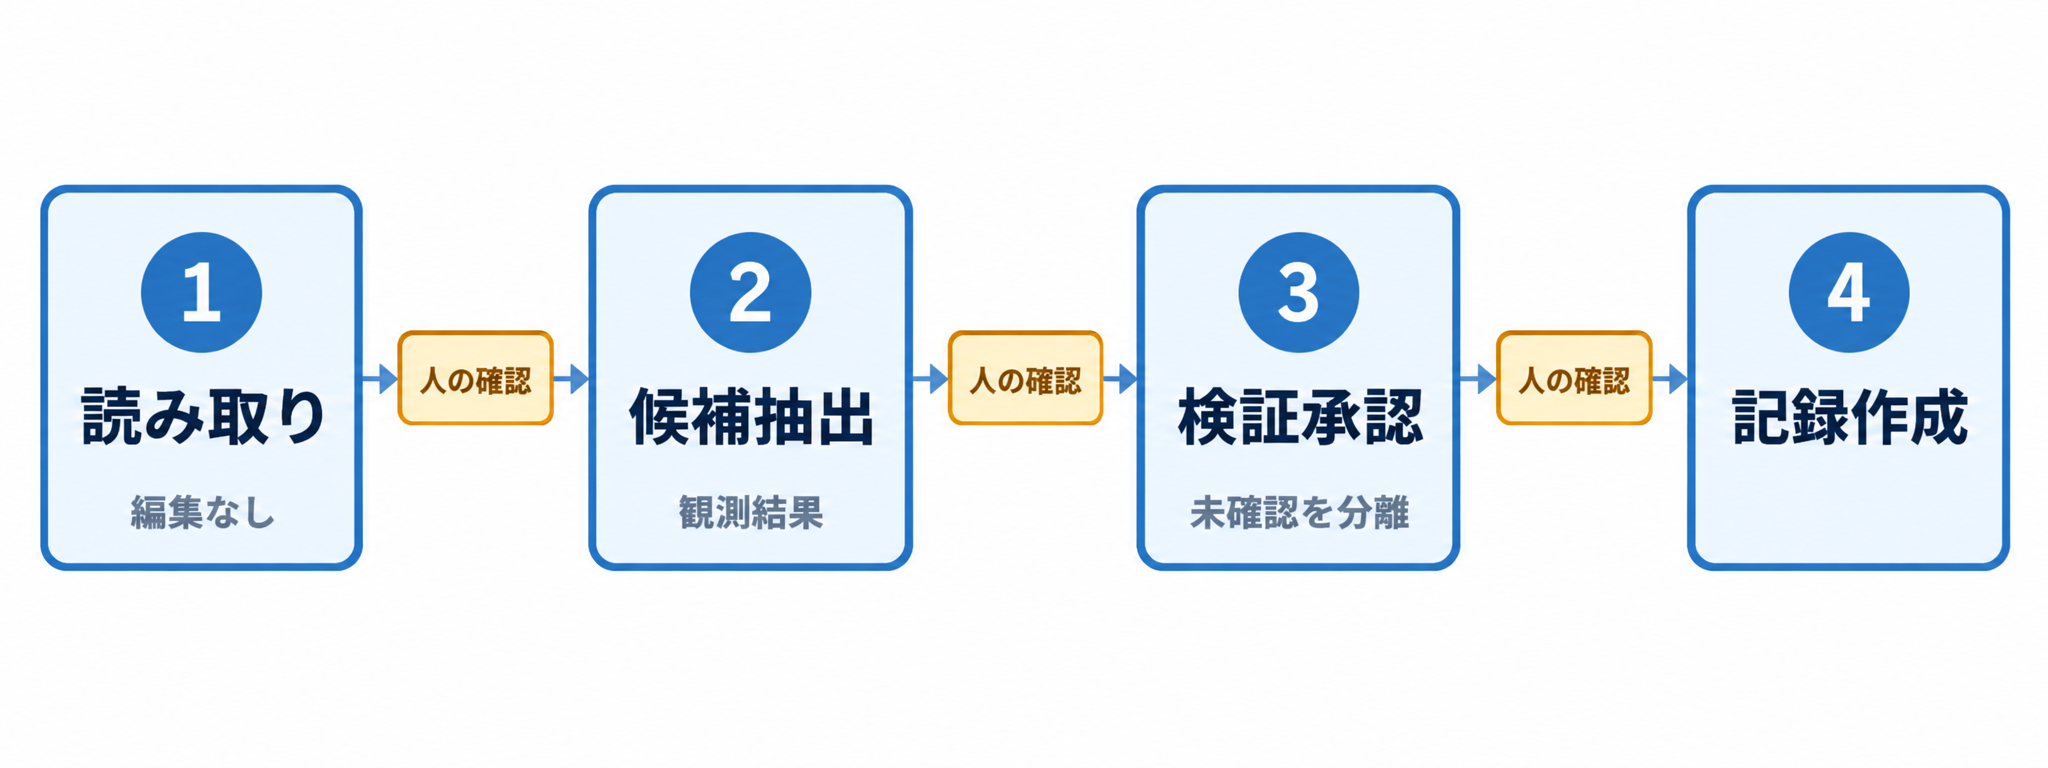
読み取りから確認記録までの四段階
操作は、リポジトリを対象にしたCodexの作業で、読み取り、候補抽出、検証、記録の四段階に分けます。ここで示すお願い文は公式の固定コマンドではなく、業務へ適用するための提案例です。山括弧の部分を自分のリポジトリに合わせて置き換えます。最初から修正まで依頼せず、各段階の出力を確認してから次へ進めます。
第一段階では、適用される指示と差分の範囲を確認させます。コピーして使う読み取り用のお願い文は次のとおりです。
このリポジトリに適用されるAGENTS.mdと関連する開発資料を読んでください。
ベースブランチは<ベースブランチ名>です。
このブランチとの差分を一次コードレビューするため、読み取りだけを行ってください。
変更ファイルを目的別に分類し、関連して確認すべきコード、テスト、規約を示してください。
不足している要件や判断できない点は、推測せず質問として分離してください。
コード、設定、テスト、Gitの状態、外部サービスは変更しないでください。
第二段階では、指摘候補の条件を固定します。好みの違いを大量に列挙させず、差分によって生じる問題と根拠を求めます。
承認済みの読み取り範囲だけを対象に一次レビューを続けてください。
各候補を、重要度、対象ファイルと箇所、観察した事実、問題になる条件、影響、確認方法、修正候補の順で整理してください。
差分だけでは断定できない項目は、指摘ではなく確認質問にしてください。
既存コードにも存在する問題は、今回の変更で悪化する根拠がない限り対象外にしてください。
まだファイルを編集せず、レビュー記録の下書きだけを返してください。
第三段階では、実行してよい検証を人が選びます。リポジトリ内の文書で確認できるテスト方法を使い、対象範囲、必要な依存関係、外部接続の有無を確かめてから承認します。実行を許可した後は、成功や失敗の要約だけでなく、実際に観測した結果と未実行項目を分けさせます。公式のワークフロー例でも、観測されたテストと検証の証拠を求め、未実行の確認を成功したものとして扱わない方針が示されています(出典: OpenAI Developers)。
第四段階で、人が確認する記録を整えます。架空の成果物例は次のようになります。
重要度: 中
対象: src/orders/update.tsの在庫更新分岐
観察した事実: 更新失敗時にも後続処理へ進む経路があります。
問題になる条件: 在庫サービスがエラーを返した場合です。
想定影響: 注文状態と在庫状態が一致しない可能性があります。
確認方法: 既存のエラー処理方針と失敗時テストを照合します。
修正候補: 後続処理を止めるか、補償処理を追加します。
人の判定: 未確認
この例は実在するコードの検証結果ではありません。担当者は対象箇所を開き、呼び出し元、例外処理、仕様、テストを確認します。根拠が成立した候補だけをコメントへ転記し、成立しないものは理由を記録して除外します。
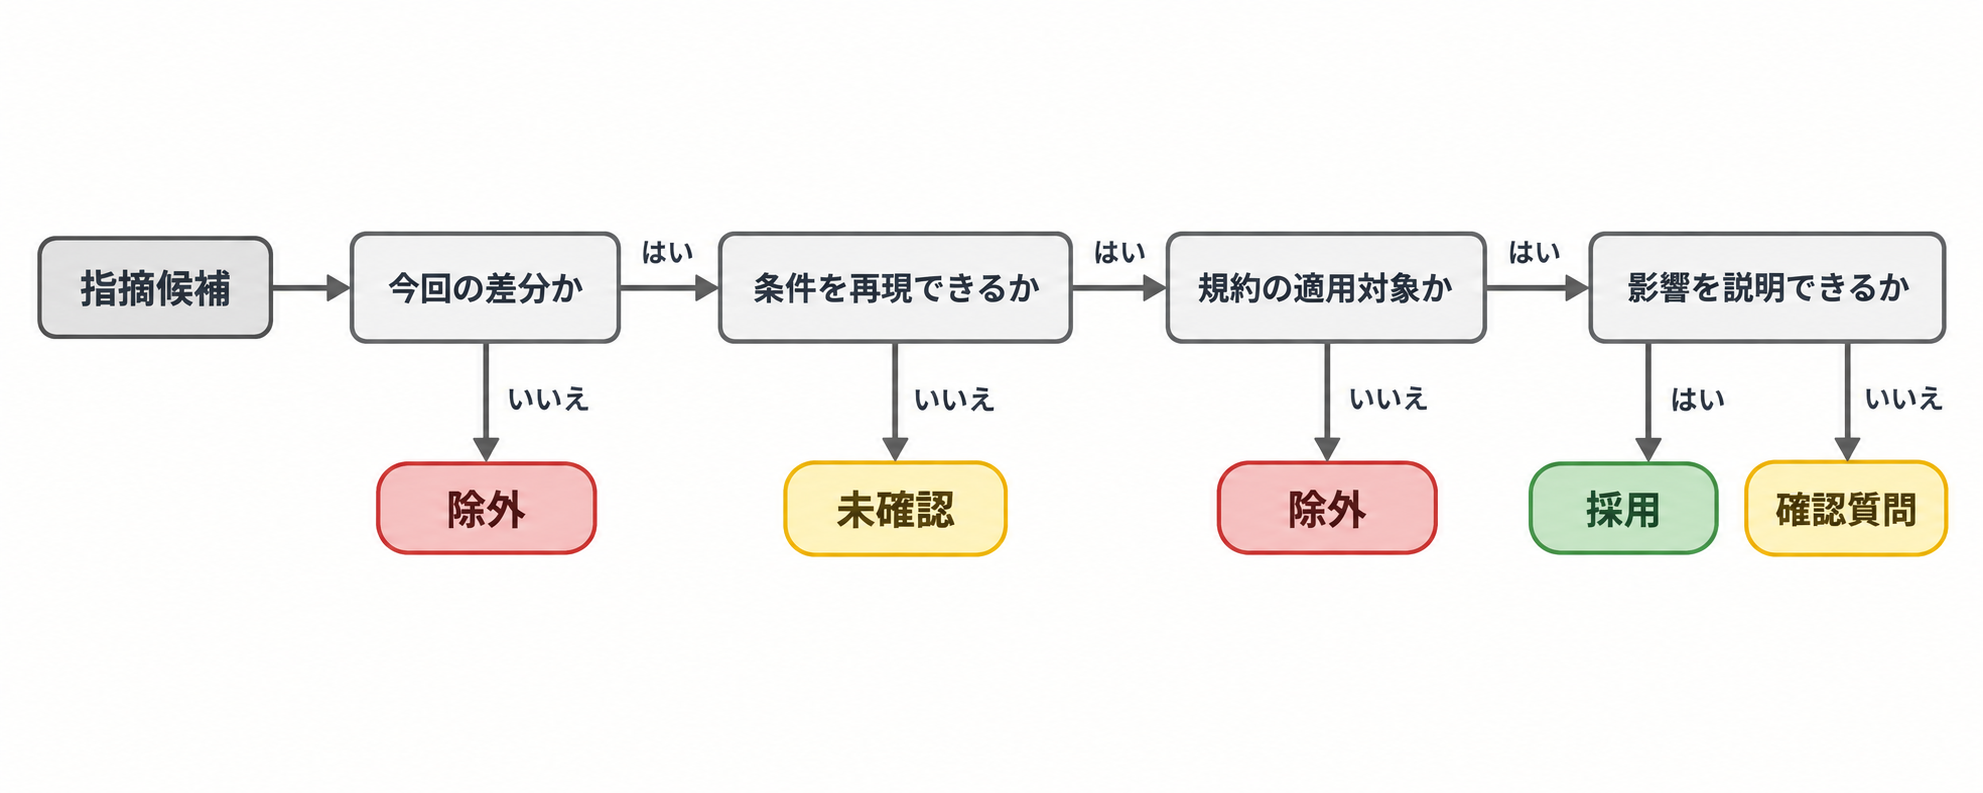
誤検知を除外して承認責任を保つ確認手順
Codexの下書きを受け取ったら、最初に差分との因果関係を確認します。指摘された処理が今回追加または変更されたものか、既存の問題を再掲しているだけかを分けます。行番号だけに頼らず、関数やクラスの責務、呼び出し元、データの流れを読みます。差分外のコードが原因に見えても、今回の変更で到達条件が増えるならレビュー対象になり得ます。その判断は人が行います。
続いて、再現条件を検証します。候補に書かれた入力、状態、権限、例外経路が実際に成立するかを確認し、可能なら既存テストまたは承認した追加の検証で確かめます。テストが通った場合も、対象の条件をそのテストが本当に実行しているかまで読みます。実行できない検証は「未確認」と記録し、推測を観測事実へ書き換えてはいけません。
規約違反の候補では、適用範囲を確かめます。`AGENTS.md`やリポジトリ資料に書かれた規約でも、生成コード、移行途中の領域、互換性維持のための例外があり得ます。文書と実装が矛盾している場合は、AIにどちらかを選ばせず、規約の所有者へ確認します。Codexの公式ワークフロー例では、小さく区切った作業ファイルが人による品質確認のゲートを支え、履歴を読みやすくする考え方が説明されています(出典: OpenAI Developers)。一次レビューでも、候補抽出と採否判断を分けることで同じ考え方を適用できます。
チーム独自の重要度を使う場合は、判定基準を文章にします。たとえば、データ破損、権限逸脱、互換性破壊につながる候補と、保守性の改善提案を同じ段階で扱わないようにします。ただし、重要度はCodexの製品機能として自動的に保証されるものではありません。チームが定義した基準に照らして、人が付け直す運用です。
正式なレビューコメントへ移す前には、対象箇所、根拠、影響、要求する対応が過不足なく伝わるかを読み直します。修正方法が複数あるなら、一案を絶対条件のように書かず、満たすべき品質条件を示します。却下した候補も、誤検知の傾向を知るために短く理由を残すと、次回の依頼文や`AGENTS.md`を改善する材料になります。
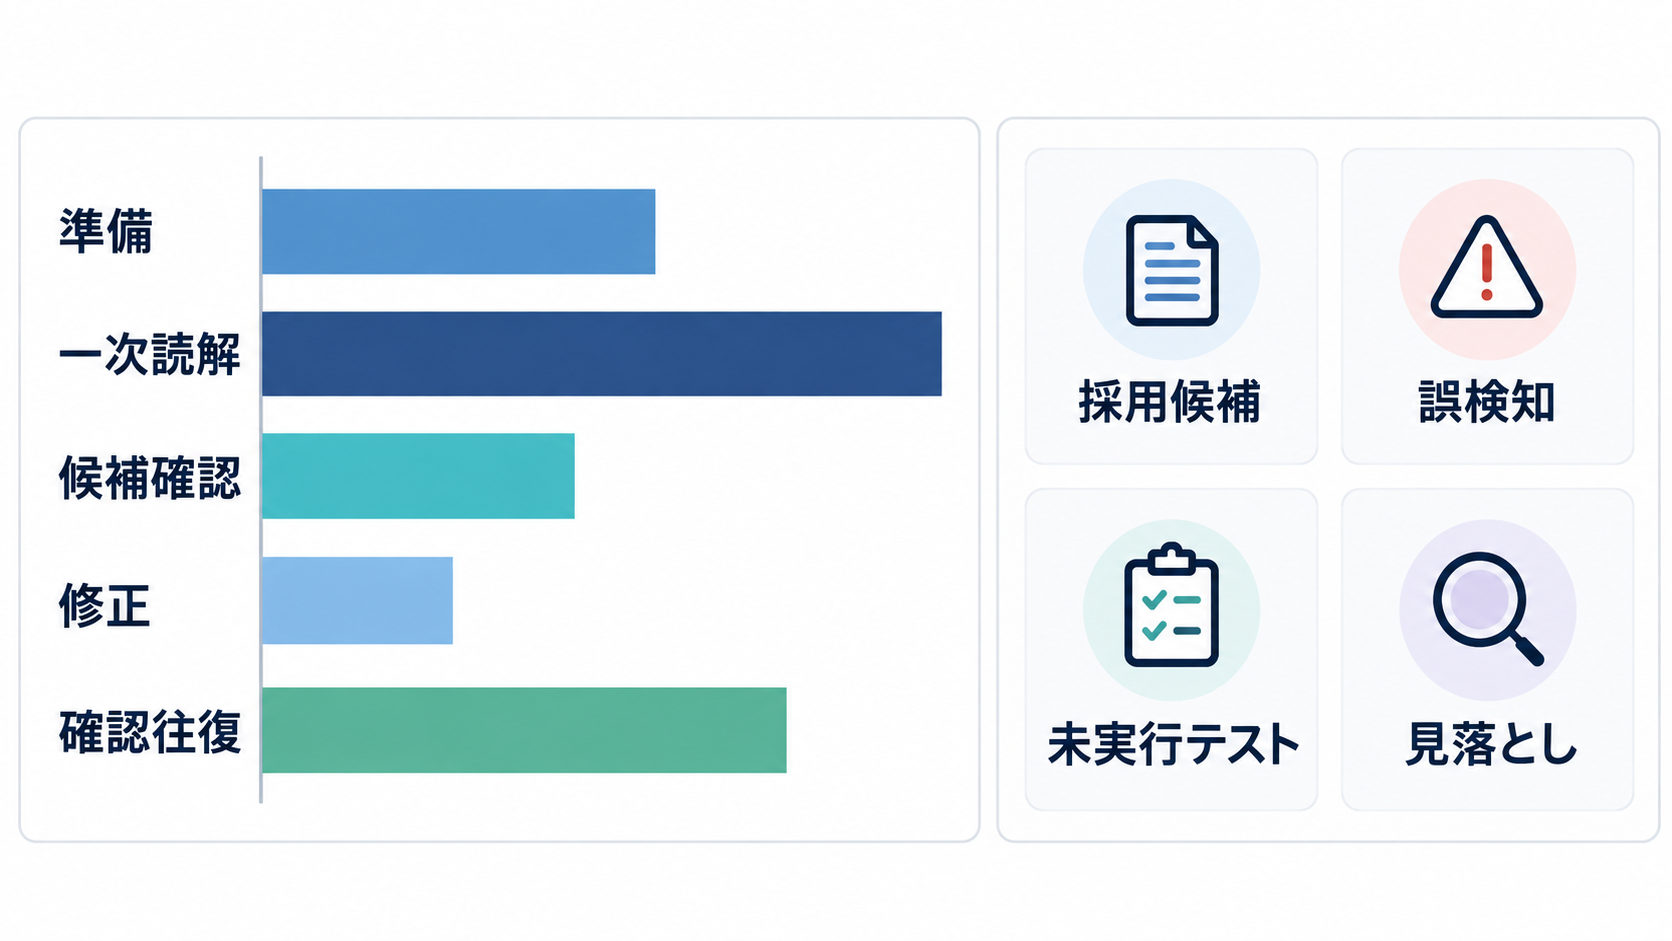
準備と確認を含めた効果測定
効果を測る際は、Codexが候補を返すまでの時間だけを比べてはいけません。準備資料を探す時間、依頼文を整える時間、候補を検証する時間、誤検知を除外する時間、正式なコメントを作る時間まで含めます。比較対象には、変更規模、言語、テスト構成、担当者の習熟度が近いプルリクエストを選びます。条件が大きく異なる案件を並べても、AIによる差なのか実装難易度による差なのか判断できません。
記録する項目としては、前提資料の収集時間、一次読解時間、候補の確認と修正に要した時間、正式に採用した指摘数、誤検知として除外した候補数、開発者との確認往復回数、レビュー後に見つかった見落とし、実行できたテストと未実行項目が考えられます。数値だけでなく、関連コードの探索が容易になったか、重要な判断へ集中できたかも短く記録します。ただし、自己評価は担当者や案件によって揺れるため、作業記録と分けて扱うほうが安全です。
改善が見られない場合は、AIの利用そのものを増やすのではなく、工程別に原因を探します。準備に手間がかかるなら、リポジトリの規約やテスト方法が分散している可能性があります。誤検知が多ければ、対象範囲、除外条件、重要度の定義が曖昧かもしれません。確認時間が長い場合は、一度に多くの観点を依頼せず、セキュリティ、互換性、テスト不足などに分ける方法を検討できます。これらは導入方法の提案であり、一定の削減率や品質向上を保証するものではありません。
最初の一歩には、影響範囲を理解している小規模なプルリクエストを一件選びます。Codexには読み取りとレビュー記録の下書きだけを依頼し、コメント投稿や修正は許可しません。通常のレビューも省略せず、人が見つけた論点とCodexの候補を照合します。そのうえで、準備、確認、修正を含む工程別の記録を残せば、自社のリポジトリで続ける価値があるかを判断できます。