
AI LAB
2026/10/21
IBM「Granite Speech」3モデル刷新、精度・速度・話者識別で企業音声AIを使い分け
1つの万能モデルではなく、業務に合わせて選ぶ音声AI
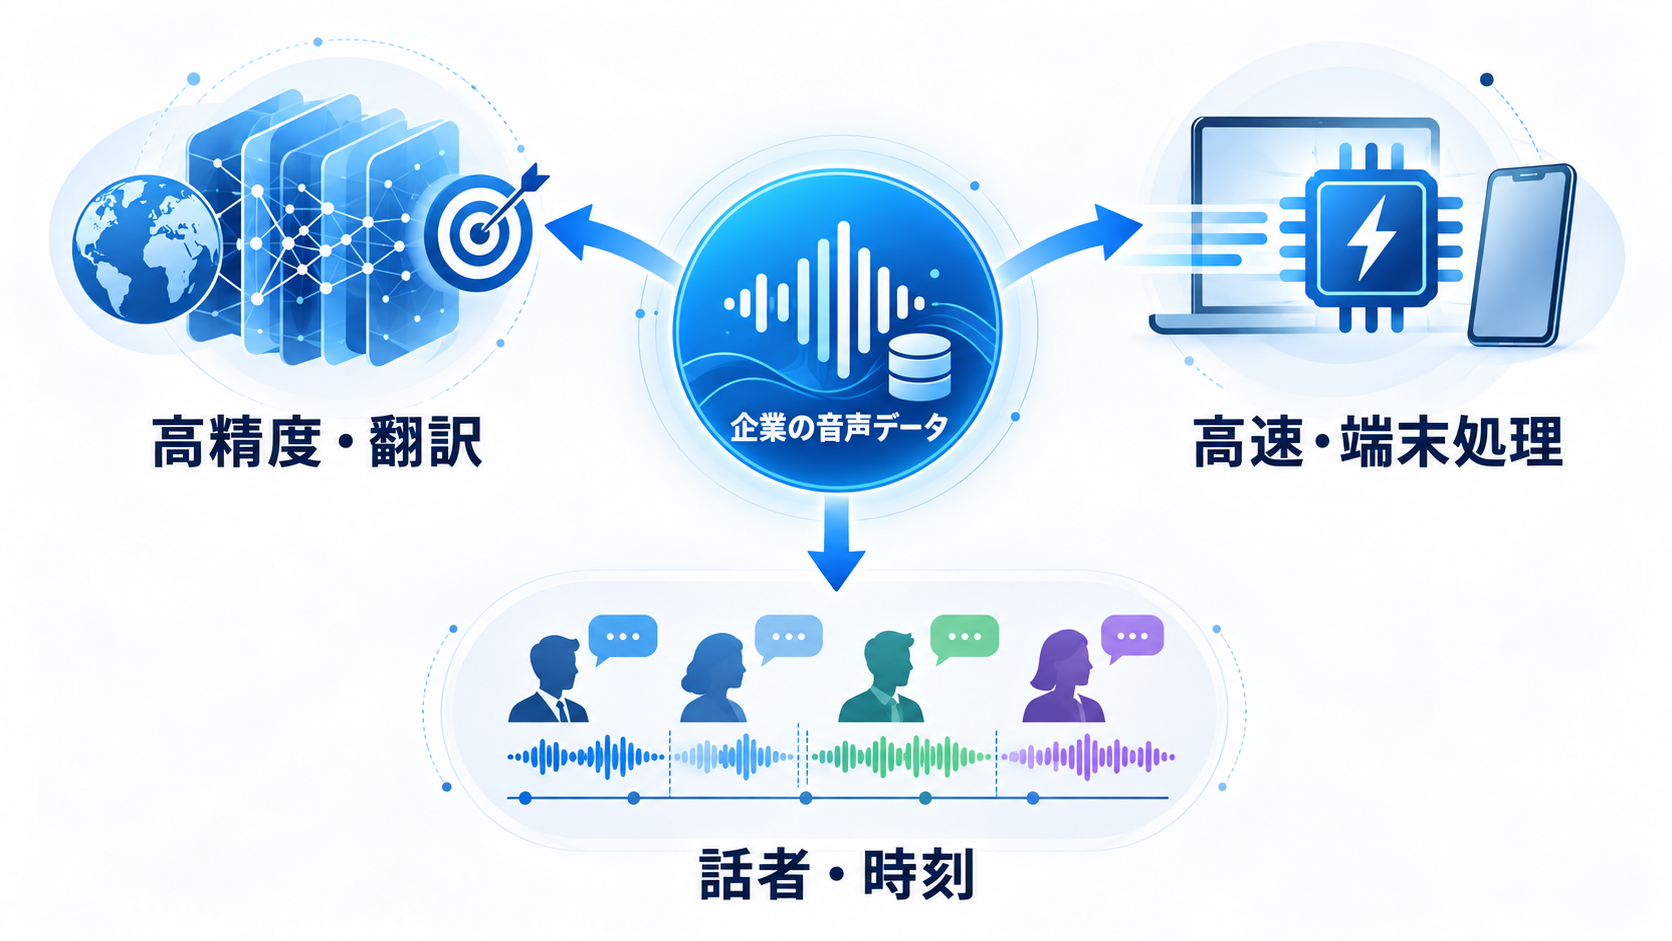
会議音声を議事録にしたい企業と、端末上で大量の音声を即座に文字化したい企業では、求める性能が異なります。前者では誰がいつ発言したかが重要ですが、後者では処理速度やモデルの軽さが優先されます。IBMが公開したGranite Speechコレクションの更新は、こうした違いを1つのモデルで吸収するのではなく、用途の異なる3モデルを使い分ける設計です。新モデルのgranite-speech-5.0-2bは、精度を重視する多言語の文字起こしと翻訳を担います。granite-speech-5.0-470m-turboctcは、4億7,000万パラメータという比較的小さな構成を維持しながら、高速処理と端末上での利用に照準を合わせています。更新版のgranite-speech-4.1-2b-plusは、会議やサポート通話、インタビューのように複数人が長時間話す録音を対象としています。
企業にとっての要点は、単純な精度ランキングだけでは採用モデルを決められないことです。翻訳の有無、音響環境、固有名詞の多さ、話者情報の必要性、処理場所、同時処理量によって適切な選択が変わります。IBMは3モデルをいずれもApache 2.0ライセンスで提供し、Transformersで利用できるようにしています。モデルを自社環境へ組み込みやすい条件は整っていますが、実運用では対象音声に近いデータを用いて、精度と処理性能を個別に確かめる必要があるでしょう。
高精度な文字起こしと翻訳を担うGranite Speech 5.0 2B
granite-speech-5.0-2bは、従来のgranite-speech-4.1-2bを引き継ぐ20億パラメータ級のモデルです。文字起こしでは英語、フランス語、ドイツ語、スペイン語、ポルトガル語、日本語に対応します。これらの言語と英語の間で翻訳できるほか、英語からイタリア語および中国語への翻訳も扱います。ただし、対応する翻訳方向は一律ではないため、導入前に目的の言語ペアを確認することが欠かせません。学習には39万時間の公開音声が使われ、日本語の自動音声認識、キーワード誘導、翻訳を補う合成データも加えられています。英語の短い音声では従来版より認識精度が上がり、雑音や残響、話者とマイクの距離がある録音への耐性も改善されました。会議室の反響や離れた位置からの発言は、整備された読み上げ音声より認識が難しくなります。実際の業務音声を意識した改善と捉えられます。
Open ASR Leaderboardの公開英語短文テストセットを平均した評価では、単語誤り率を示すWERが5.06%となり、公開ウェイトの主要な音声認識モデルの中で2位とされています。この結果は2026年10月15日時点の非公式評価であり、英語の短い音声を中心とした比較です。そのため、日本語の会議や自社固有の騒音環境でも同じ順位や誤り率になるとは限りません。それでも、公開ウェイトのモデルを検討する企業にとって、精度重視の候補を絞る材料にはなります。対応基盤にはTransformersのほか、vLLM、llama.cpp、Apple Silicon向けのmlx-audioが含まれています。
言語指定と2,000語のキーワード誘導が生む業務適応力
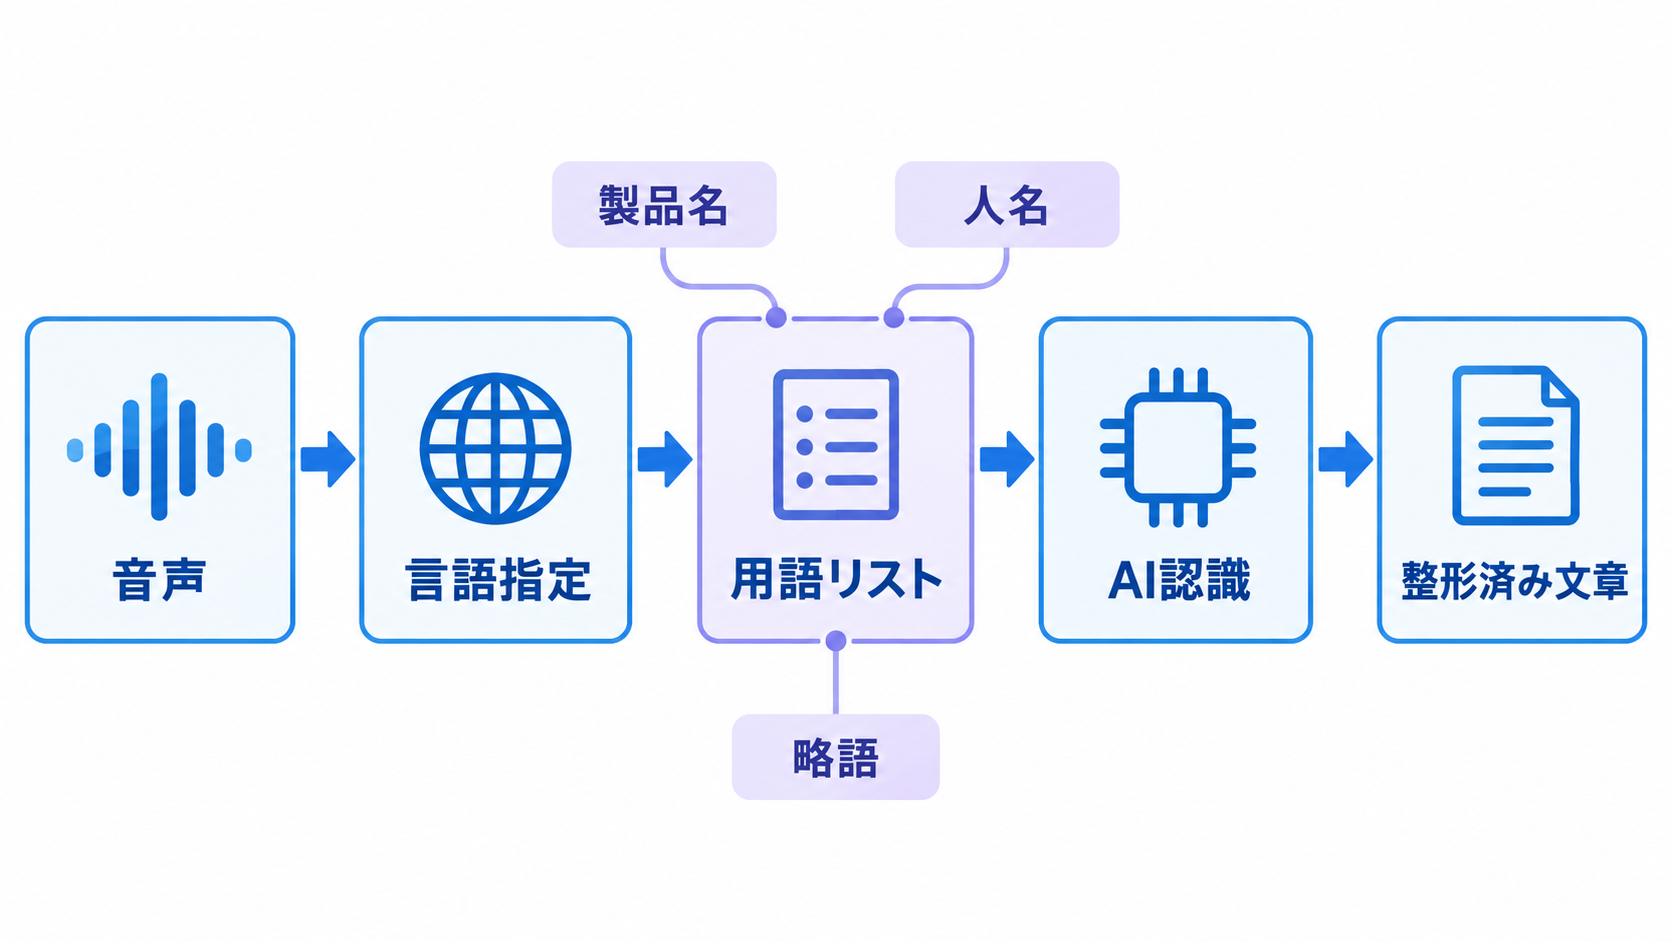
音声認識を業務に導入すると、一般的な会話は正しく変換できても、製品名、社員名、部署名、略語で誤りが増えることがあります。granite-speech-5.0-2bは、最大2,000語のキーワード一覧を与え、文字起こしや翻訳を指定語へ誘導できます。対応言語のすべてで利用できるため、商品カタログや社内用語集を認識処理へ反映したい場面に向いています。この機能は、モデル自体を再学習せずに業務語彙を扱いやすくする手段です。ただし、キーワードを登録すれば必ず正しく認識されるわけではありません。似た発音の語が多い場合や録音品質が低い場合には、誘導が別の誤認識につながる可能性もあります。試験時にはキーワードを含む音声だけでなく、含まない音声も評価し、通常語への影響を確認するのが安全です。部署ごとに2,000語を埋めるのではなく、利用頻度と誤認識時の影響を基準に優先順位を付ける運用が現実的でしょう。
入力言語をプロンプトで明示し、多言語の文字起こしを誘導できる点も追加されました。句読点や大文字表記が必要な場合は、整形済みの出力をプロンプトで求められます。IBMのテストでは、大文字化のF1スコアが89.7から99.5の範囲でした。長時間音声や自然な会話の翻訳も改善され、短い読み上げ文だけでなく、会話が続く録音で品質を保ちやすくなっています。企業利用では、言語、出力形式、キーワード一覧を処理ごとに変えるより、業務別のテンプレートとして管理すると、結果の再現性を確保しやすくなります。
約1.6倍に高速化したTurbo CTCの狙い
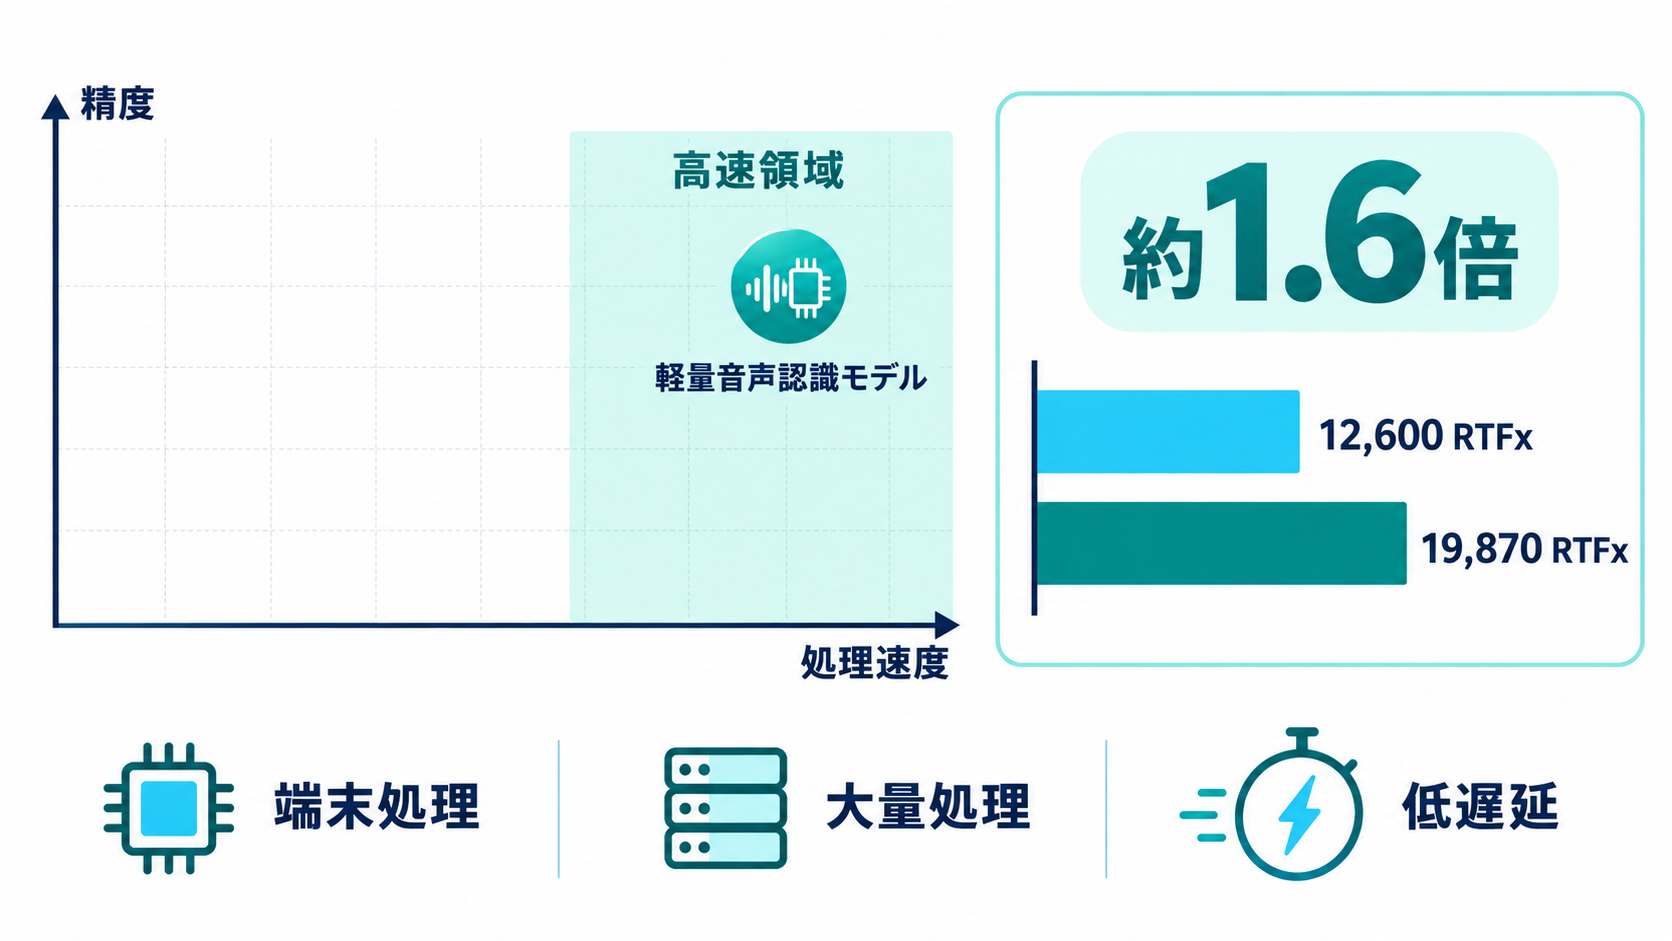
granite-speech-5.0-470m-turboctcは、精度だけでなく処理量と応答速度を重視するモデルです。2026年8月の公開時点では英語専用でしたが、今回の更新で英語、日本語、スペイン語、ドイツ語、フランス語、イタリア語、ポルトガル語の文字起こしに対応しました。句読点と大文字表記をモデルが直接出力するため、別の句読点付与処理や大文字・小文字の補正処理を後段に置かずに済みます。高速化では、音声処理に使うConformerの1ブロックをコンパイルし、その計算グラフを積層全体で再利用する方法が採られました。Open ASR Leaderboard上の処理速度は、公開当初のおよそ12,600 RTFxから19,870 RTFxへ上昇し、同じ精度水準で約1.6倍になったとされています。RTFxは、音声の実時間に対してどれだけ速く処理できるかを表す指標です。数値が高いほど、一定時間内に多くの音声を処理できることを示します。
この評価は2026年10月時点の英語短文9テストセットに基づくため、社内サーバーや端末で同じ速度が保証されるわけではありません。ハードウェア、音声の長さ、バッチ処理の方法、推論ソフトウェアによって実効性能は変わります。更新版は残響を明示的に意識した学習によって、反響のある部屋や遠距離収音にも強くなりました。コールセンターの大量処理、端末上の文字入力支援、低遅延が求められるストリーミング処理では有力な候補ですが、話者識別や翻訳が必要なら別モデルとの比較が必要です。ブラウザで試せるWebGPUストリーミングデモも用意されています。
会議で「誰が、いつ、何を話したか」を扱う2B Plus
会議録や通話分析では、文章が正しくても話者が入れ替わっていれば利用価値が下がります。更新版のgranite-speech-4.1-2b-plusは、発言内容に加えて話者と時刻を扱う用途へ調整されています。名称が5.0に変わらなかったのは、アーキテクチャ、プロンプト形式、APIが従来版と同じだからです。重みを改善した置き換え版として提供されるため、既存の利用者は連携部分を大きく変更せずに更新できると説明されています。話者ラベルの誤りを測るWDERは4.40から4.10へ下がり、改善率は7%です。話者情報を含めて文字起こしの誤りを測るcpWERも30.50から28.48へ低下し、全体で7%改善しました。タイムスタンプの平均的なずれを示すAASは、すべての音声を対象とした評価で210.86から98.54へ半分以下になっています。短い音声では29.27から26.20への改善です。いずれも誤りやずれを表す指標なので、数値が低いほど良好です。
長時間音声のWERは13.53から10.22へ下がり、24%改善しました。20語のキーワード一覧を使用した評価では、対象語のWERが11.79から6.48となり、誤りが45%減っています。会議、サポート通話、インタビューのように長く続く複数話者の録音では、これらの改善が検索、字幕、聞き直し、要約前のデータ整備に影響します。ただし、参加者の声質が似ている会議や発言が重なる場面では、一般に話者分離が難しくなります。自社評価では文字の正しさだけでなく、話者ラベル、時刻、重複発話を分けて確認する必要があります。
WERとRTFxを業務価値へ読み替える評価設計
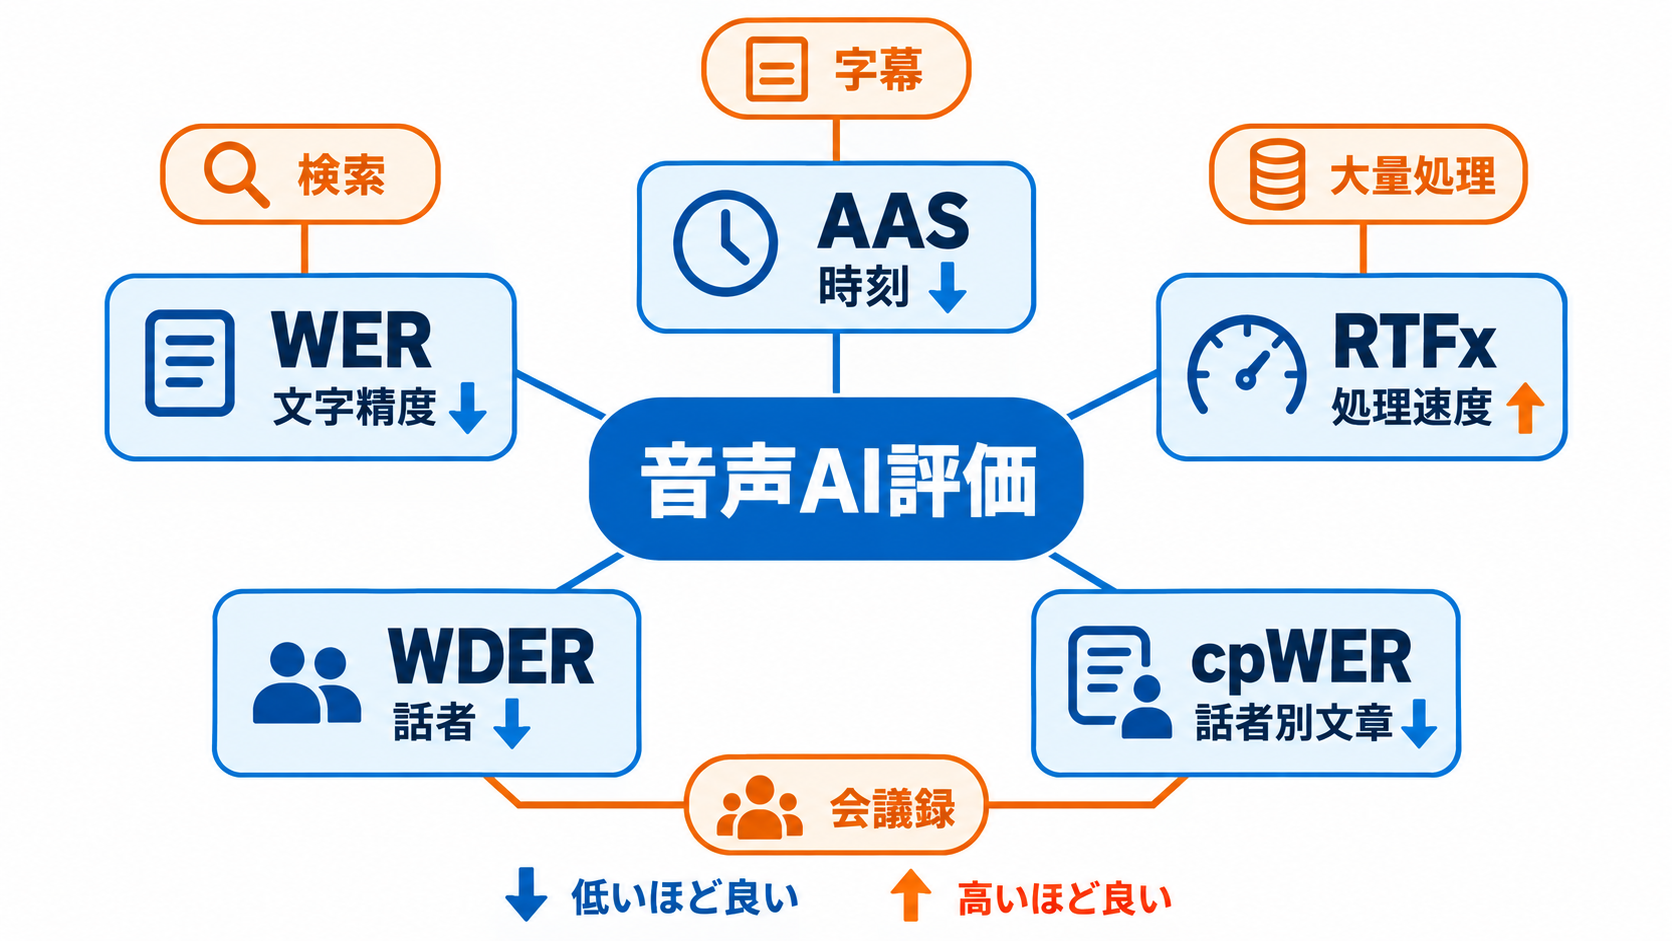
音声AIの比較で頻繁に登場するWERは、置換、削除、挿入された単語の数を基に、正解文に対する誤りの割合を示す指標です。低いほど認識結果は正確ですが、同じWERでも業務上の影響は異なります。助詞の誤りと契約金額の誤りを同じ1語として数えるためです。製品名や人名が検索キーになる業務では、全体のWERに加えて重要語の認識率を見るほうが実態に合います。RTFxは処理速度を比較する助けになりますが、モデルの起動時間や通信時間、ファイルの分割、同時実行数まですべて表す指標ではありません。AASはタイムスタンプのずれ、WDERは単語に付いた話者情報の誤り、cpWERは話者を考慮した文字起こしの誤りを捉えます。字幕の同期を重視するならAAS、会議参加者ごとの発言抽出を重視するならWDERやcpWERが判断材料になります。用途によって見るべき指標を変える必要があります。
評価データの条件にも注意が必要です。granite-speech-5.0-2bとTurbo CTCについて示されたランキングは、主に公開された英語の短文テストセットを使っています。日本語の商談、工場内の騒音、電話回線、複数人の重なり発話などは条件が異なります。導入判断では、公開指標を候補選定に使い、その後で自社の代表的な音声を用いた試験へ進む方法が堅実です。全体精度、重要語、話者、時刻、処理時間を別々に採点すれば、改善すべき箇所とモデル選択の理由を社内で説明しやすくなるでしょう。
日本企業が試験導入で確認すべきモデル選択の分岐
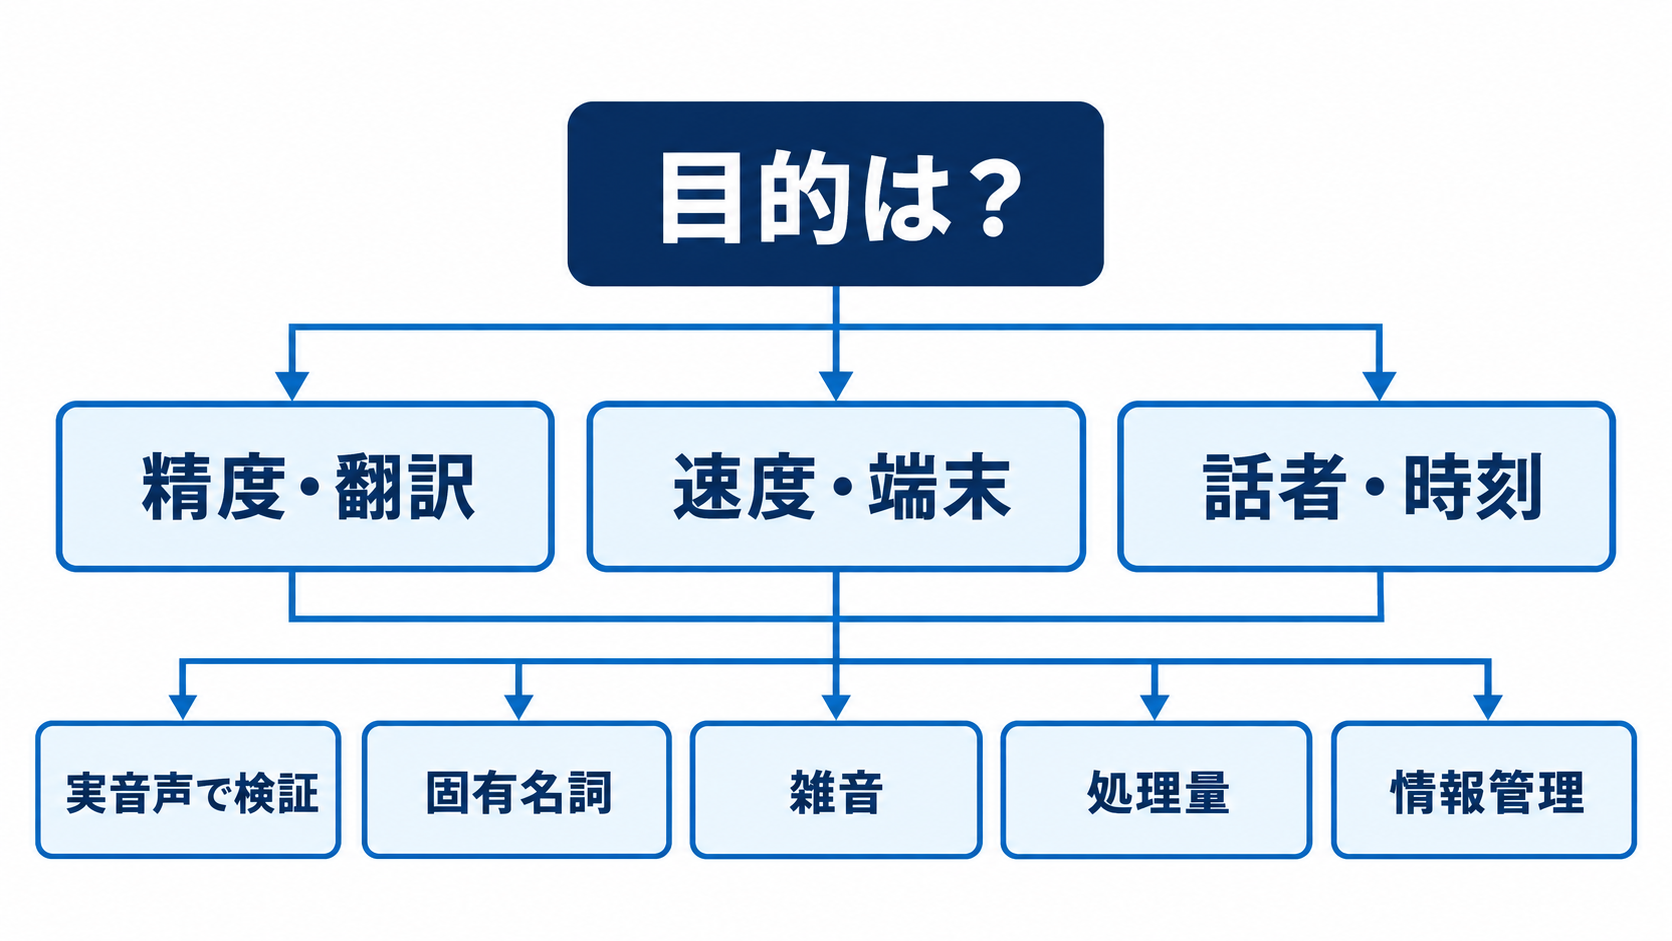
高い文字起こし精度、翻訳、最大2,000語のキーワード誘導が必要なら、granite-speech-5.0-2bが出発点になります。大量処理、低遅延、端末上での利用を優先するなら、granite-speech-5.0-470m-turboctcが候補です。会議や複数話者の通話で、発言者と時刻を残したい場合にはgranite-speech-4.1-2b-plusが適しています。モデル名やパラメータ数だけでなく、最終成果物に必要な情報から逆算すると選びやすくなります。試験導入では、静かな録音だけを集めると本番との差が見えません。会議室の反響、遠いマイク、電話音声、社内固有名詞、長時間録音など、実際に起こる条件を評価データへ含めるべきです。日本語と外国語が混在する業務では、言語指定の方法や翻訳方向も確認します。キーワード一覧については、部署名や製品名を登録した場合の改善幅と、通常の語への副作用を併せて測る必要があります。
Apache 2.0で公開されていることは、自社システムへ組み込む際の選択肢を広げます。ただし、ライセンスだけで運用上の検討が完了するわけではありません。音声に個人情報や機密情報が含まれる場合には、保存場所、アクセス権、保持期間、利用目的を整理することが求められます。IBMは、追加のリスク検知が必要な本番環境でGranite Guardianを組み合わせることも推奨しています。
最初の一歩としては、実際の業務音声から条件の異なる小規模な評価セットを作り、3モデルのうち用途に合う候補を比較するのがよいでしょう。平均WERだけで選ばず、固有名詞、話者、タイムスタンプ、処理速度、必要な計算資源を同じ表で確認すれば、精度と運用コストの折り合いを判断しやすくなります。