
AI LAB
2026/10/22
16.9MBの音声認識AI「Whistle」を実測――Whisper baseとの比較で見えた速さと30秒の落とし穴

16.9MBの小型モデルが狙うオンデバイス音声認識
会議の議事録、作業現場での音声入力、車載機器の操作などでは、録音データをクラウドへ送らず、その場で文字に変換したい場面があります。Cactus ComputeのWhistleは、こうした用途を想定した音声認識モデルです。モデルファイルは16.9MBで、GPUを前提とせずCPU上で動作します。英語、ドイツ語、フランス語、スペイン語、イタリア語、オランダ語、ポーランド語の7言語を扱い、文字列だけでなく単語ごとの開始時刻、終了時刻、認識確率も返せます。小ささは、単にダウンロード時間を短くするだけの特徴ではありません。メモリやストレージに余裕のない端末へ組み込みやすく、ネットワーク接続が不安定な環境でも処理を継続できる可能性があります。端末内で処理を完結させる構成を選べば、音声を外部サービスへ送信しないシステムも設計できます。ただし、モデルが小さいことと、業務音声を正確に処理できることは別の問題です。
MarkTechPostの検証が示した中心的な論点もそこにあります。Whistleは、条件によってはOpenAIの音声認識モデルWhisper baseより低い単語誤り率と高い処理速度を示しましたが、常に優位だったわけではありません。検索方法を変えると精度差が消え、音声が長くなるにつれて速度差も縮まりました。30秒を超える入力では、エラーを通知せず音声の一部を落とす挙動まで確認されています。導入判断ではモデルサイズの数字より、対象音声の長さ、話し方、運用方法を先に確認する必要があるでしょう。
同じ音声と統計ルールで比較したベンチマーク設計
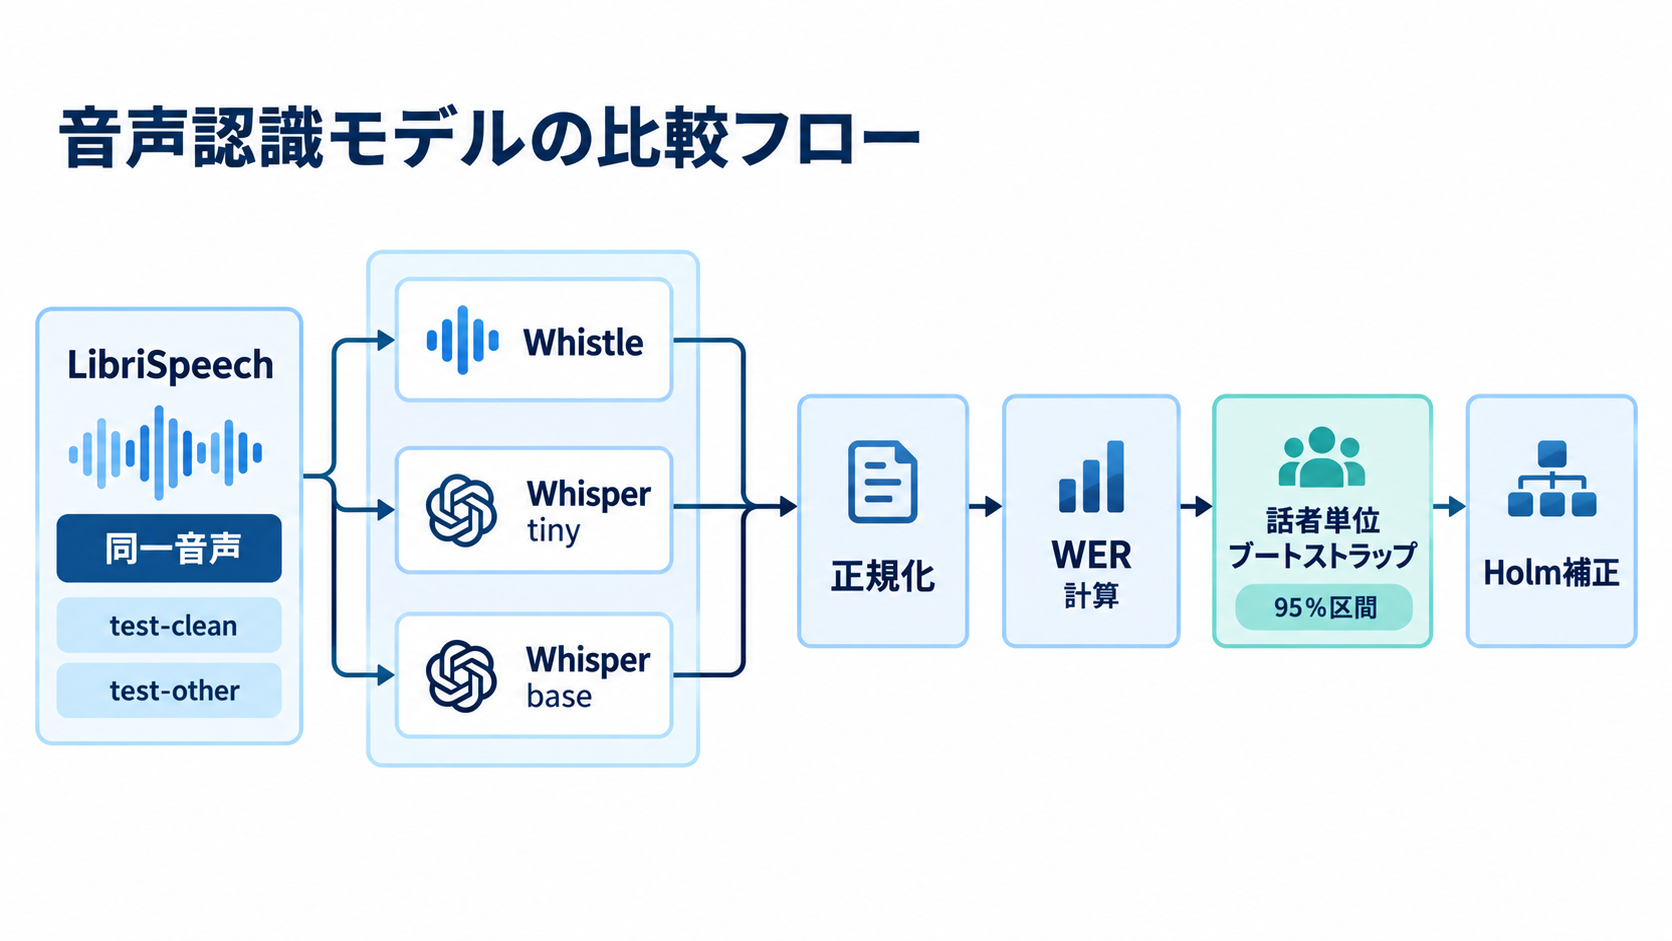
精度比較には、英語の朗読音声データセットLibriSpeechが使われました。比較的聞き取りやすいtest-cleanと、録音条件や発話が難しいtest-otherから、乱数シードを固定して各300件を抽出しています。Whistleの1回の処理対象を30秒以内とする条件などを適用した結果、それぞれ299件が評価対象になりました。そのうちtest-otherの100件、test-cleanの60件には、Whisper tinyとWhisper baseも同じ音声で実行されています。指標はWER、すなわち単語誤り率です。正解文に対する単語の置換、削除、挿入を合計し、正解文の単語数で割ります。値が低いほど誤りが少ない指標ですが、数十件の結果だけを比べると、たまたま難しい話者が多く含まれた影響を受けかねません。そこで検証では、同じ話者の音声をひとまとまりとして再抽出する話者クラスターペア・ブートストラップを2,000回行い、95%区間を算出しました。
複数の比較を同時に行うことで偶然の有意差が生じやすくなる問題には、Holm法による補正も適用されています。判定ルールは最終結果を見る前に記録され、Whistleと各方式の差について、信頼区間がゼロをまたがず、補正後の基準も満たした場合にだけ優位と判定しました。利用したモデル、推論エンジン、データセットの版も固定し、ファイルのハッシュ値を記録しています。ただし、試行はApple M4を搭載した1台での一回分であり、すべてのCPUや実行環境に当てはまる性能保証ではありません。
精度差を左右したWhisperの探索方法
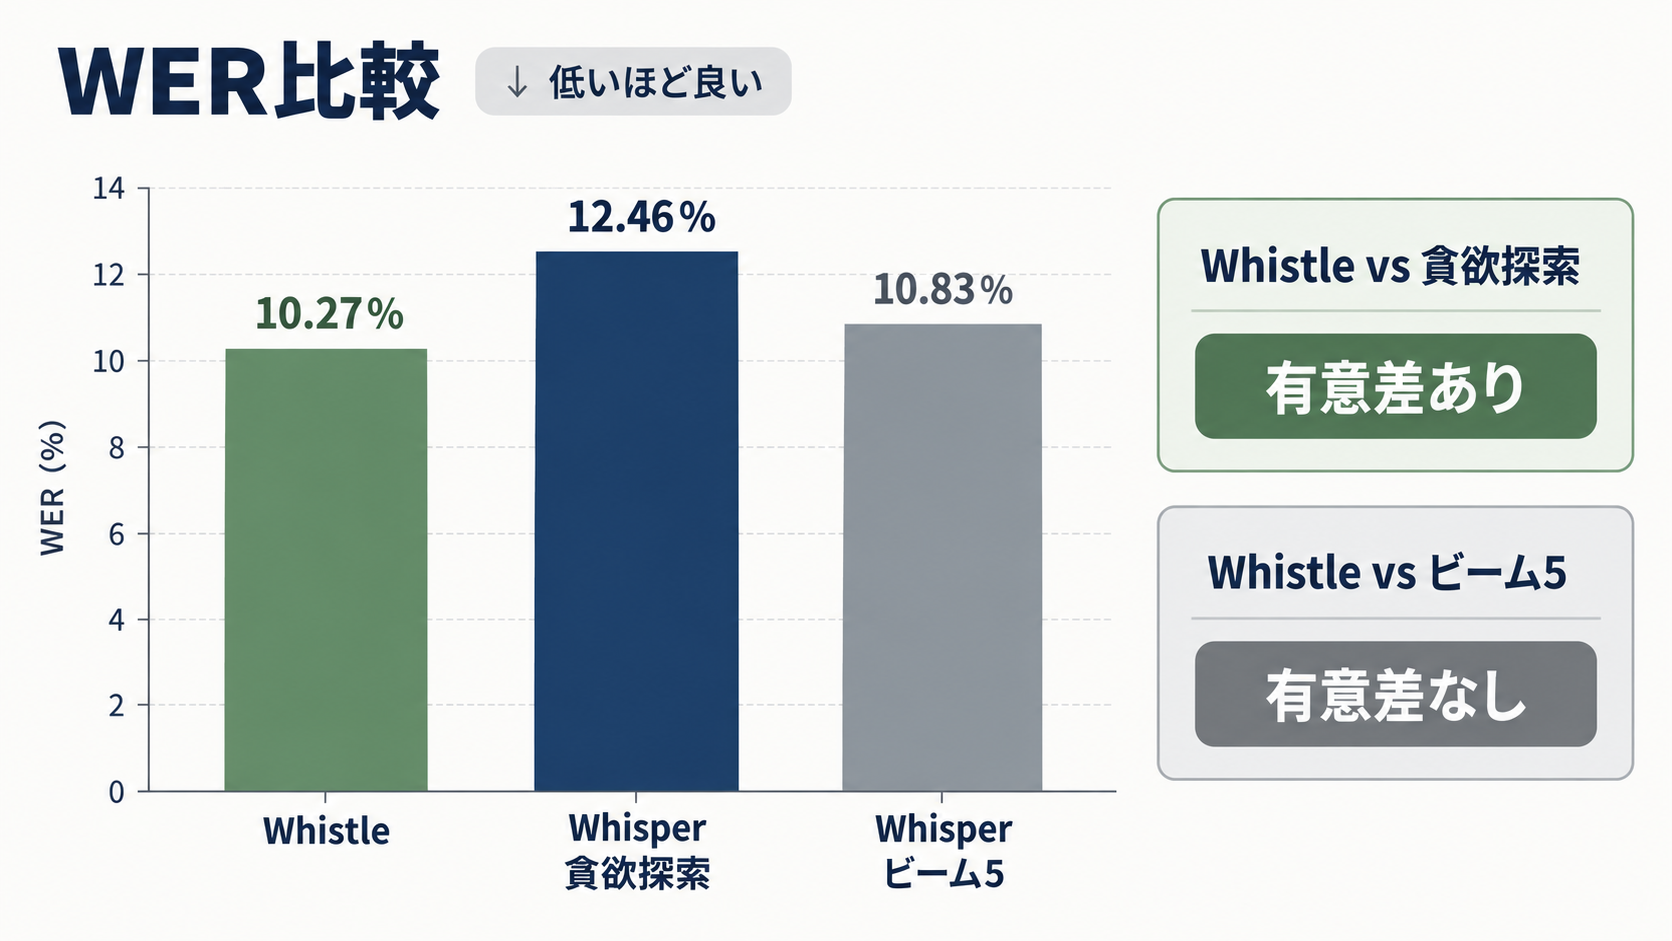
主要評価となったtest-otherの対応サンプルでは、WhistleのWERは10.27%でした。Whisper baseを標準的な貪欲探索で動かした場合は12.46%で、Whistleとの差は2.19ポイントです。この差は話者単位の区間推定とHolm補正を経ても残りました。難度が高い朗読音声に限れば、小型のWhistleが貪欲探索のWhisper baseを上回った結果です。ところが、Whisper baseでビーム幅5の探索を使うとWERは10.83%まで下がり、Whistleとの差は統計的に有意ではなくなりました。貪欲探索は各段階で有力な候補を一つ選ぶ方法ですが、ビーム探索は複数候補を保持して文全体を検討します。比較対象を単にWhisper baseと呼ぶだけでは不十分で、推論時の探索設定までそろえなければ結論が変わり得ることが分かります。test-cleanと追加の6言語についても、今回のサンプル規模では有意な差が確認されませんでした。
Cactus Computeが公開している全分割の数値は、test-otherでWhistleが10.49%、Whisper baseがビーム探索で11.0%、貪欲探索で12.4%です。test-cleanでは、それぞれ4.31%、4.9%、5.0%とされています。ただし、これらは今回の抽出サンプルで再測定した値ではなく、公開済みの全体集計です。実測値と公開値を混ぜて優劣を断定すべきではありません。企業が自社データで比較するときも、モデル名だけでなく、正規化処理、探索幅、言語指定、音声分割方法まで記録することが欠かせません。
短い音声で際立つ速度とメモリ効率
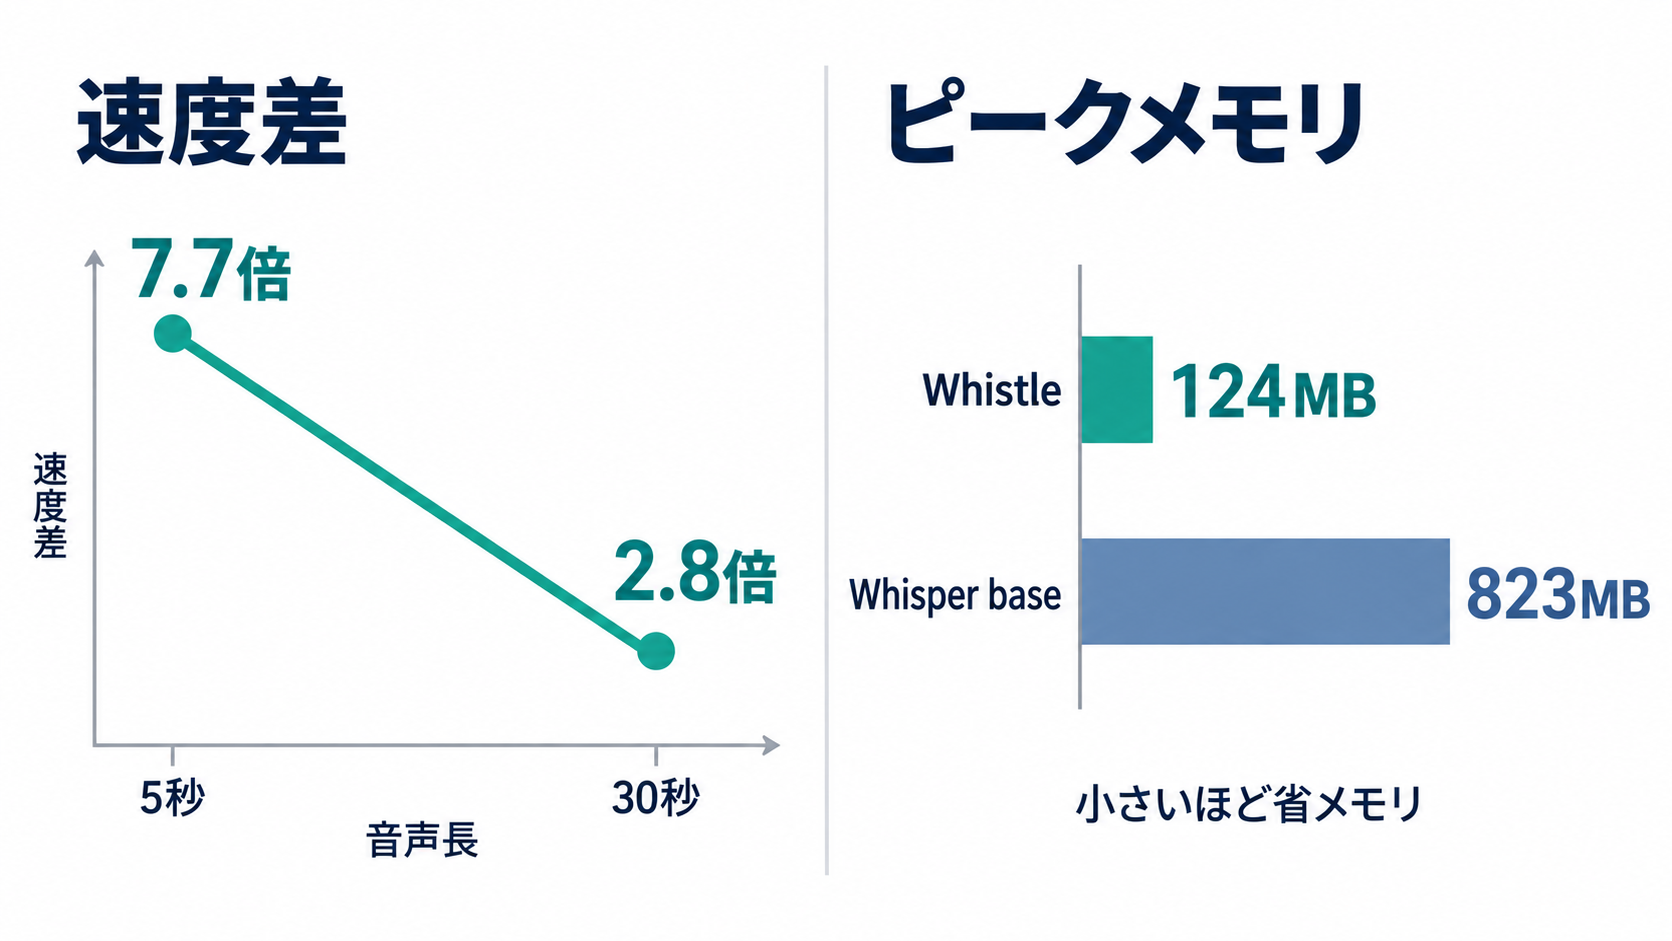
Whistleの強みが明確に表れたのは、CPU上の処理速度とメモリ使用量です。検証環境ではピークメモリが124MBで、Whisper baseは823MBでした。最初に試した3.5秒の音声は、Whistleで約33ミリ秒の実時間で文字起こしされています。メモリ容量の小さい端末や、同じ機器で複数の処理を動かす構成では、この差が採用可否に直結する場合があります。処理速度の倍率は一定ではありません。5秒のクリップではWhistleがWhisperより7.7倍高速でしたが、30秒では2.8倍まで縮まりました。Whistleは入力が長くなると処理量も増えるため、短い音声で得られた倍率を長時間録音へそのまま当てはめられません。それでも、ボタン操作に伴う短い音声コマンドや数秒単位の発話では、応答開始までの待ち時間を抑えやすい設計だと考えられます。
注意したいのは、速度値がApple M4上の一回の測定結果である点です。CPUの種類、スレッド数、実装、量子化方式、ビーム幅によって結果は変わります。また、処理時間が短いことから消費電力や発熱まで自動的に低いとは判断できません。スマートフォン、組み込みボード、業務用PCのどれに載せるかを決めたうえで、実機のピークメモリ、連続処理時の遅延、CPU占有率を測る必要があります。Whistleの数字は候補を絞る材料であり、容量計画を確定する数値ではないでしょう。
30秒超の音声を黙って欠落させる運用リスク
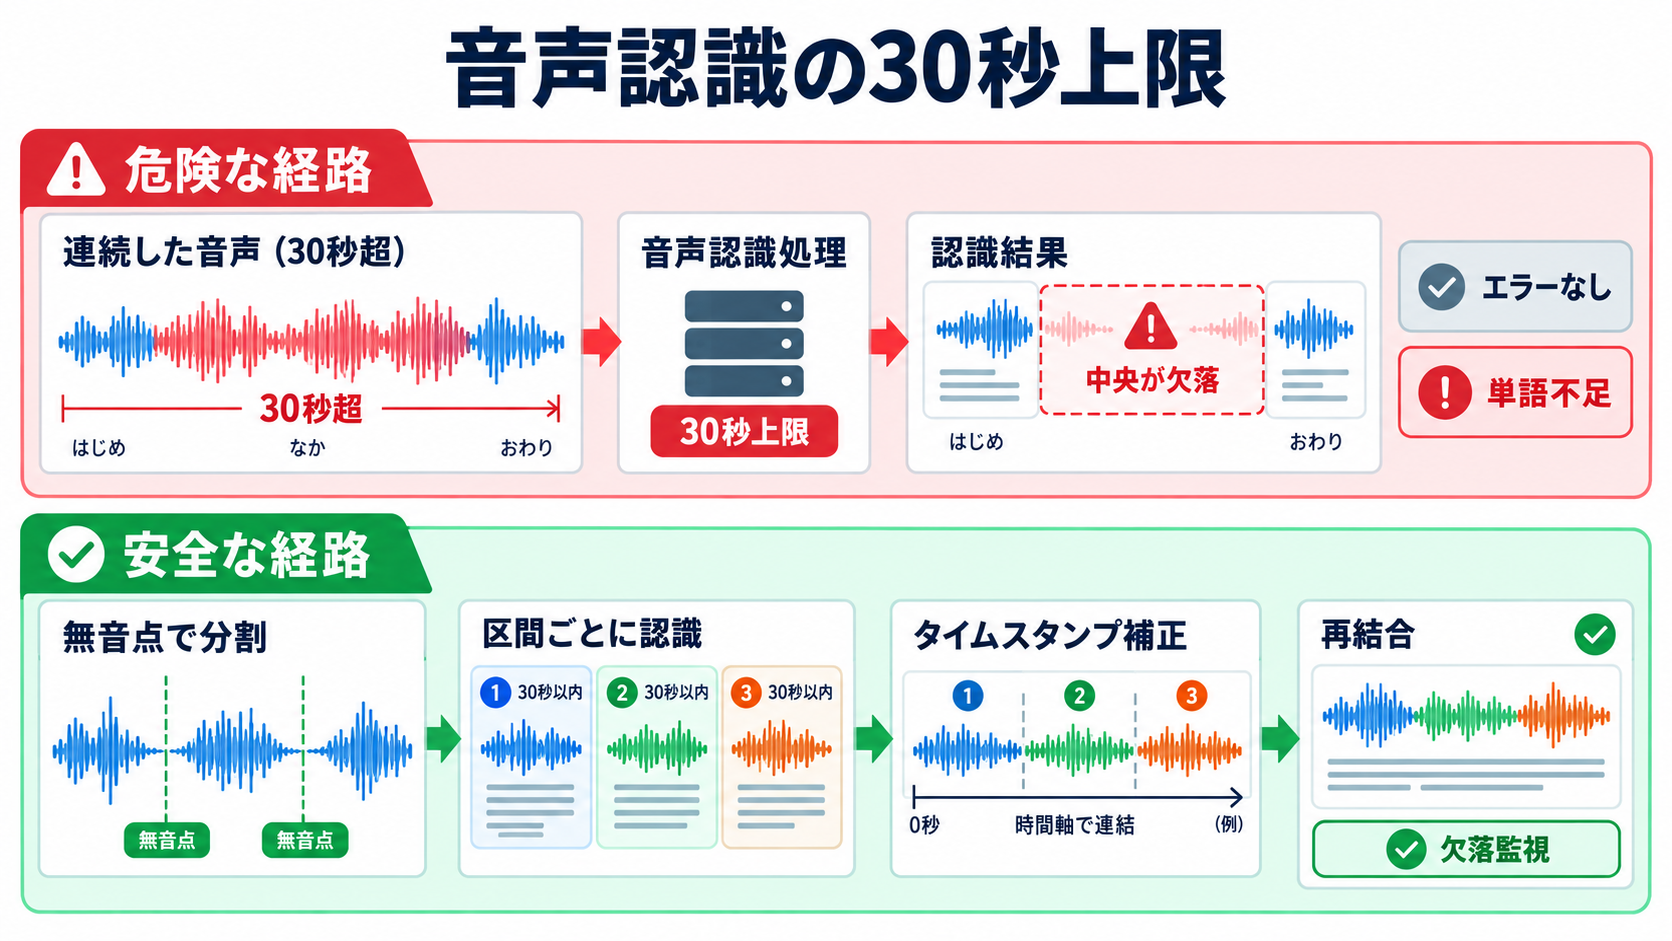
最も注意すべき結果は、精度や速度の順位ではなく、長い音声に対する挙動です。固定した推論エンジン版へ30秒を超える音声を渡すと、音声中央部が欠落し、実際の半分未満の単語しか返さないケースが確認されました。しかも、処理はエラーとして失敗せず、短い文字列を正常な結果のように返します。APIの成功・失敗だけを監視するシステムでは、欠落を見逃す恐れがあります。長時間音声を複数区間へ分ける場合も、切り方によって精度が変わりました。一定間隔で機械的に区切った方式のWERは6.74%でしたが、無音に近い位置を選んで分割した方式では3.75%まで低下しています。単語の途中や発話が連続する場所を切ると、前後の文脈や音素が分断されるためです。会議録や通話録音でWhistleを使うなら、30秒以内という制約をアプリケーション側で管理し、静かな箇所を境界に選ぶ処理が必要になります。
実装時には、入力時間が上限を超えたら自動的に分割経路へ送ることに加え、音声時間に対して出力単語数が極端に少なくないかも監視すべきです。分割後の各区間について開始時刻を保持すれば、返された単語タイムスタンプを録音全体の時刻へ戻せます。エンジンを更新する際には、長時間入力の挙動を回帰試験へ含める必要もあるでしょう。黙って欠落する問題は平均WERに表れにくいため、通常の精度試験とは独立した異常系テストとして扱うのが安全です。
ストリーミングとキーワード指定の実用条件
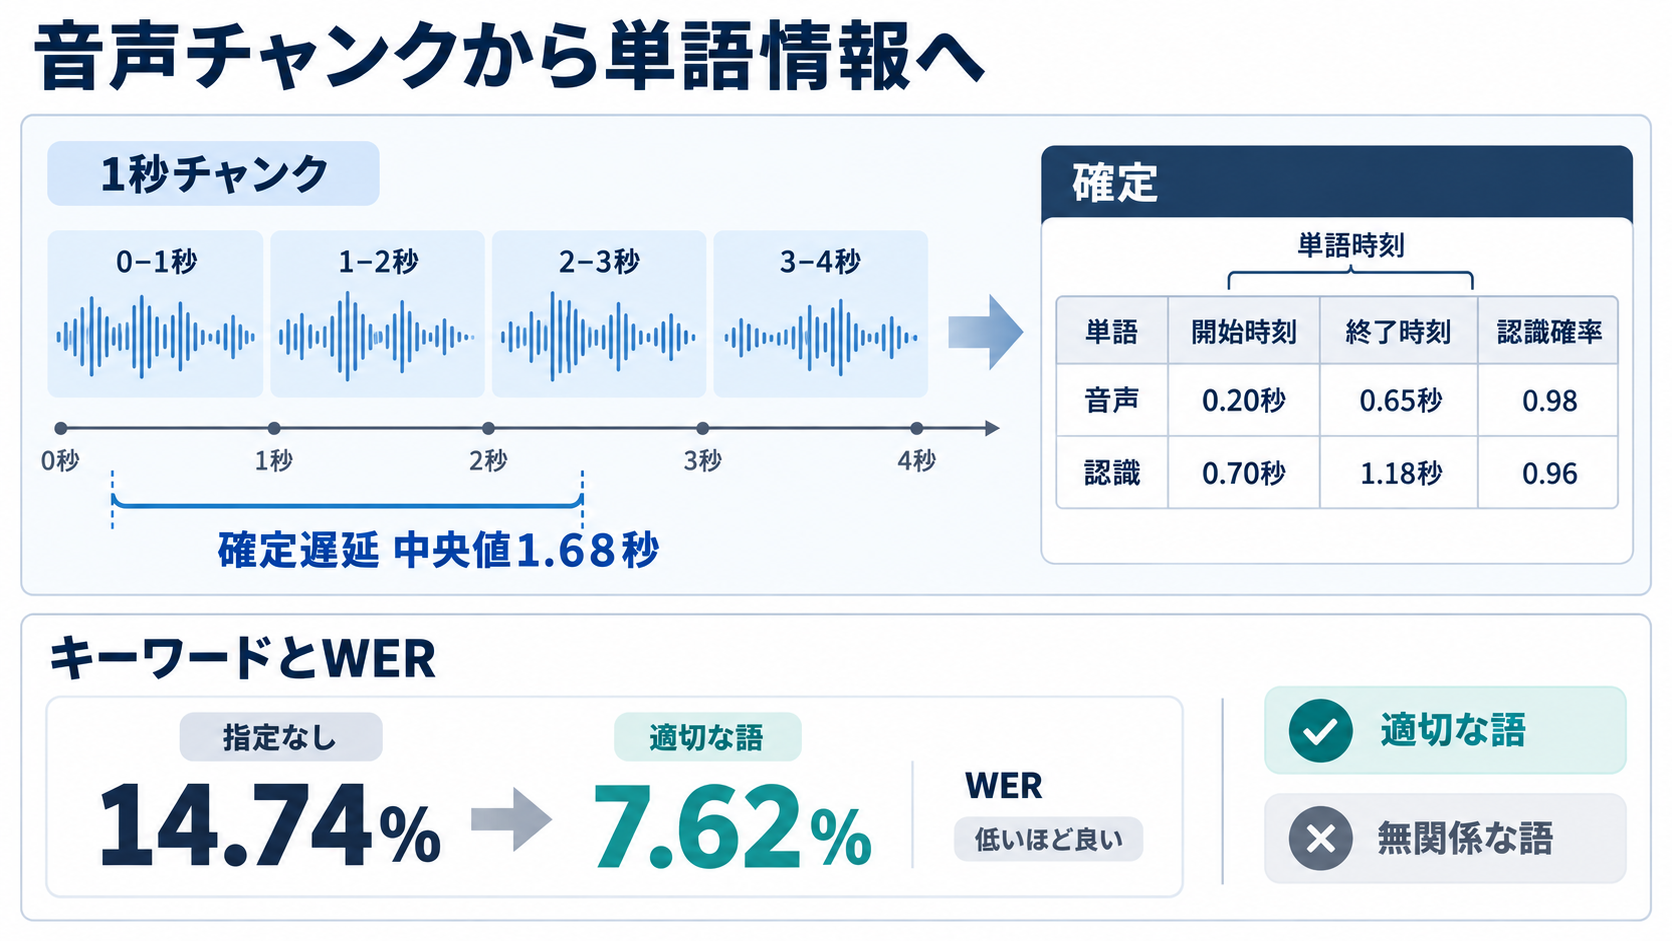
30秒制約への別の対応策が、音声を小刻みに渡すストリーミング処理です。1秒単位で音声を入力した試験では、単語が話されてから結果として確定するまでの遅延中央値は1.68秒でした。バッチ処理とのWER差は統計的に有意ではありません。完全な同時字幕と呼べる遅延ではないものの、音声コマンド、入力補助、発話中の字幕表示など、数秒以内の応答を許容できる用途では検討対象になります。単語ごとの開始・終了時刻と認識確率を返せる点も、業務アプリケーションでは有用です。字幕の強調表示、録音位置へのジャンプ、信頼度が低い箇所だけを人が確認する画面などを構成できます。ただし、確率値をそのまま品質保証の合否へ使うのではなく、自社音声で誤認識率との関係を確認し、レビューへ回す基準を決める必要があります。
キーワードバイアスでは、対象音声に実際に登場する適切な語を指定すると、WERが14.74%から7.62%へ下がりました。別のクリップから選んだ無関係な語を与えても、明確な改善はありませんでした。この機能は万能な精度向上スイッチではなく、製品名、担当者名、業界用語など、出現し得る語を利用場面に応じて渡す仕組みです。全社共通の巨大な辞書を固定するより、顧客、画面、業務フローごとに候補を絞り、キーワードなしの場合と比較する方が効果を評価しやすいでしょう。
多言語・雑音・音声埋め込みを見る際の境界線
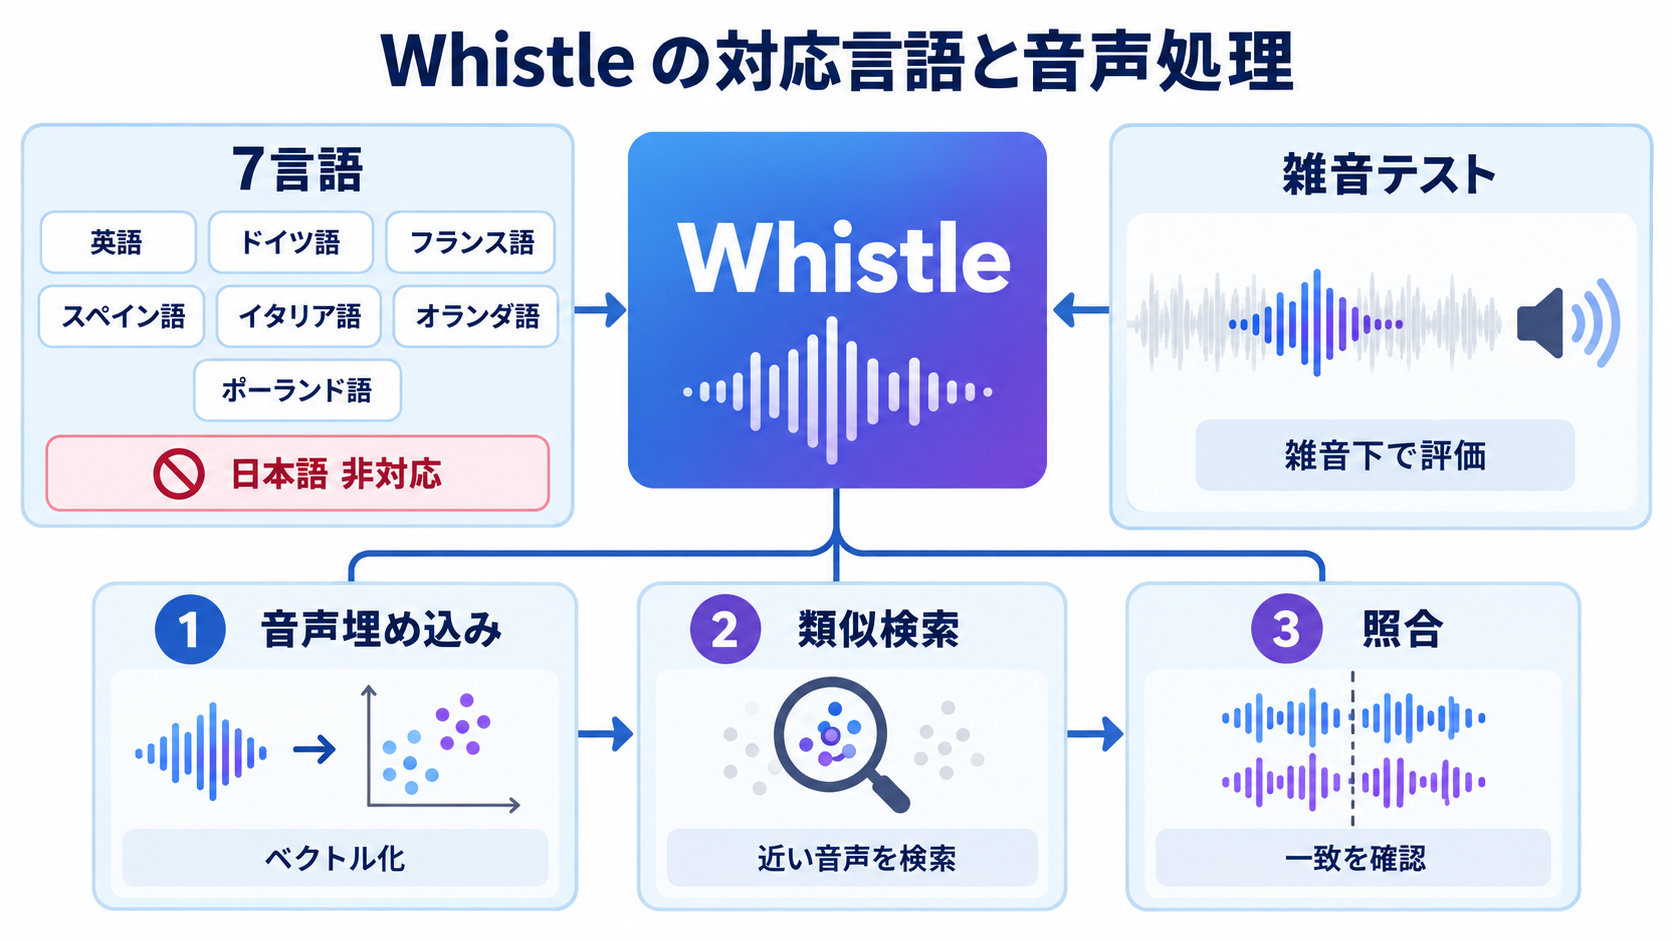
Whistleが対応するのは、英語、ドイツ語、フランス語、スペイン語、イタリア語、オランダ語、ポーランド語の7言語です。日本語は対象に含まれていません。海外拠点向けの製品や欧州言語の音声入力には候補となりますが、日本語と英語が混ざる社内会議などへそのまま展開するのは適切ではないでしょう。言語ごとの試験では、今回のサンプル規模でWhisper baseとの有意差が確認されなかったため、英語test-otherの勝利だけを多言語全体へ広げて解釈できません。雑音を加えた音声も検証対象になりましたが、実運用の騒音は一種類ではありません。空調音のように一定の音、キーボード音、車内音、複数人の重なり、通信による音切れでは、認識への影響が異なります。自社評価では静かな朗読音声だけでなく、実際に使うマイクと場所で収録したサンプルを含めるべきです。WERの平均値に加え、商品名、金額、否定語など、誤ると業務上の影響が大きい語を個別に確認する必要があります。
Whistleは文字起こしに加えて音声埋め込みも取得できます。埋め込みとは、音声の特徴を数値の並びとして表したもので、似た音声の検索や照合へ利用できる可能性があります。ただし、文字起こし精度が高ければ検索品質も自動的に高くなるわけではありません。どの特徴が保持され、話者、録音環境、発話内容のどれに強く反応するかを用途別に検証する必要があります。文字列、タイムスタンプ、確率、埋め込みは別々の出力として品質基準を設けるのが妥当です。
音声からツール実行までを分けて評価する導入手順
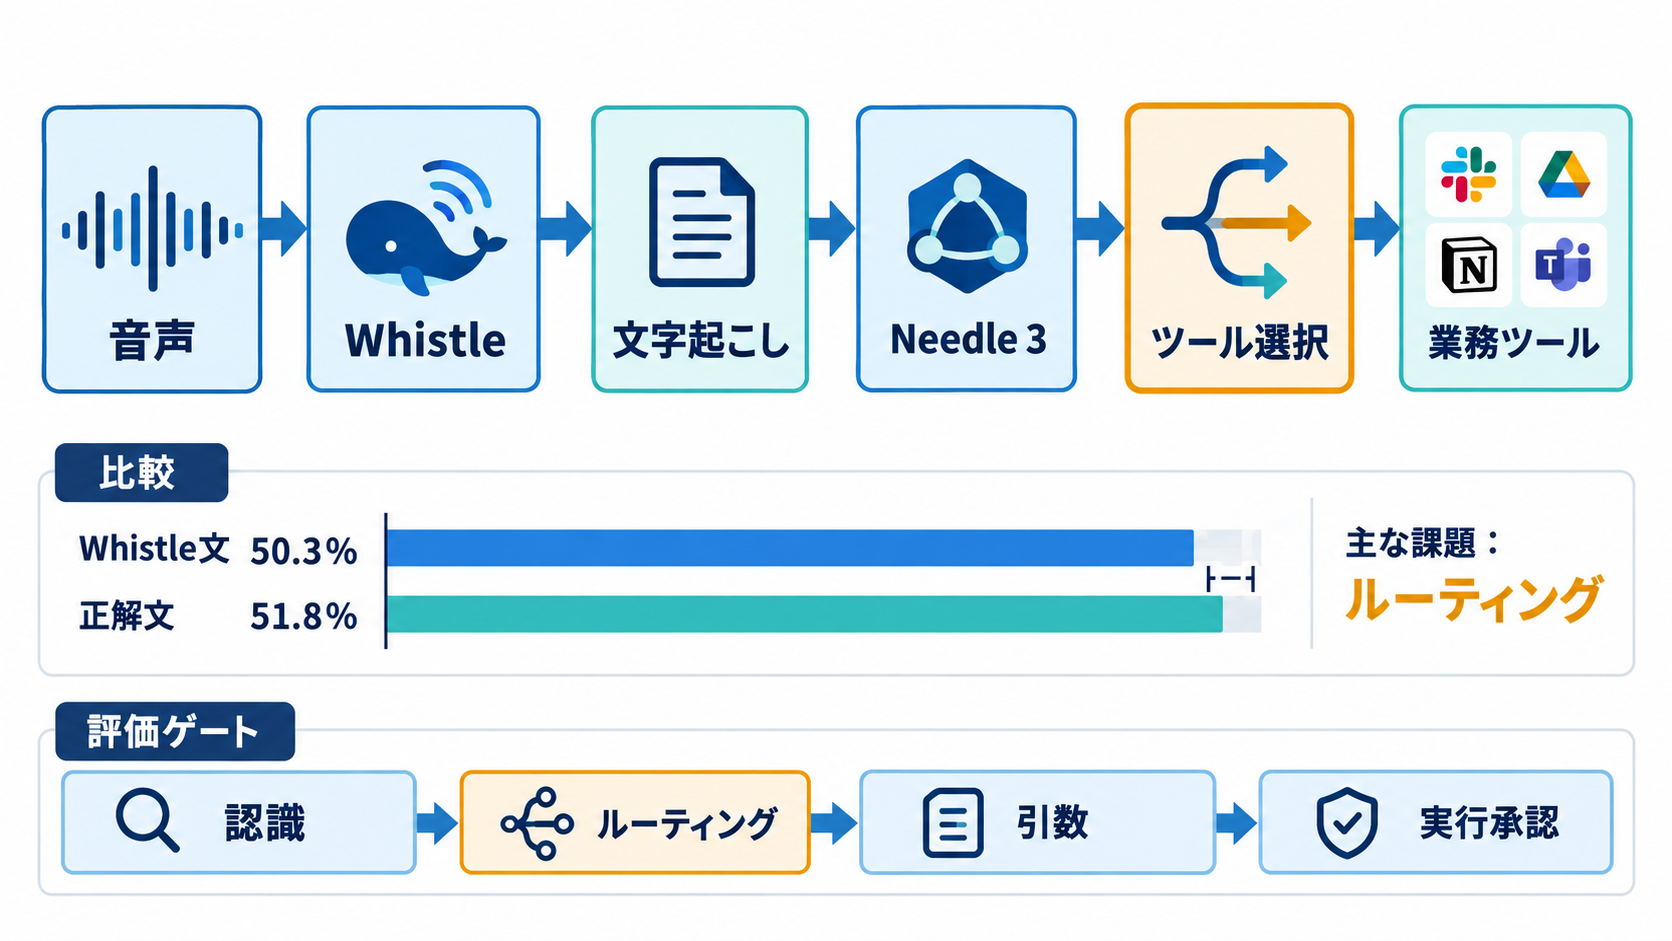
Whistleの文字起こし結果をCactus ComputeのNeedle 3へ渡し、音声からツール呼び出しを選ぶ試験も行われました。Whistleの認識文を使ったルーティング精度は50.3%で、人が用意した正解文を使った場合は51.8%です。両者の差が小さいことから、この試験では音声認識よりも、要求に対応するツールを選ぶルーティング部分が主な制約だったと考えられます。ただし、約50%という値は、そのまま無人の業務実行へ投入できる水準を意味しません。音声エージェントを評価するときは、文字起こしとツール選択を一つの成功率だけで管理しない方が原因を特定しやすくなります。Whistleが正しく認識したのに別のツールを選んだケース、誤認識したものの正しいツールへ到達したケース、ツールは正しいが引数を誤ったケースを分ける必要があります。金銭処理、外部送信、データ削除などの操作には、認識確率にかかわらず確認画面や承認工程を置くべきでしょう。
企業が概念実証を始める際の確認項目は、次のように整理できます。
- 実際の話者、マイク、雑音を含む代表音声で、Whisperの探索設定も固定して比較します。
- 30秒を超える入力を拒否または分割し、無音付近での分割と欠落検知を試験します。
- 精度だけでなく、実機上の遅延、ピークメモリ、連続稼働時の安定性を測ります。
- ツール実行では、文字起こし、ルーティング、引数生成、最終実行を別々に採点します。
最初の一歩としては、対象業務から短い音声と長い音声をそれぞれ集め、Whistle、Whisper baseの貪欲探索、同ビーム探索を同一条件で測るのが現実的です。Whistleの価値は、単一のベンチマークで勝つことではなく、16.9MBという小ささとCPU処理が、特定の業務条件で十分な精度を保てるかにあります。その判断には、30秒制約と失敗時の挙動を含む評価が欠かせません。