
2026/11/01
今更聞けないAI知識
AIの「モデル」は答え集ではありません——学習から生まれる「判断の型」の正体
AIサービスの説明に出てくる「モデル」の正体
AIサービスを使おうとすると、画面や紹介文に「モデルを選ぶ」「新しいモデルに切り替える」といった表現が現れることがあります。モデルという言葉を知らないままでも操作はできますが、「アプリとは別のものなのか」「モデルを変えると何が変わるのか」と戸惑う人は少なくないでしょう。
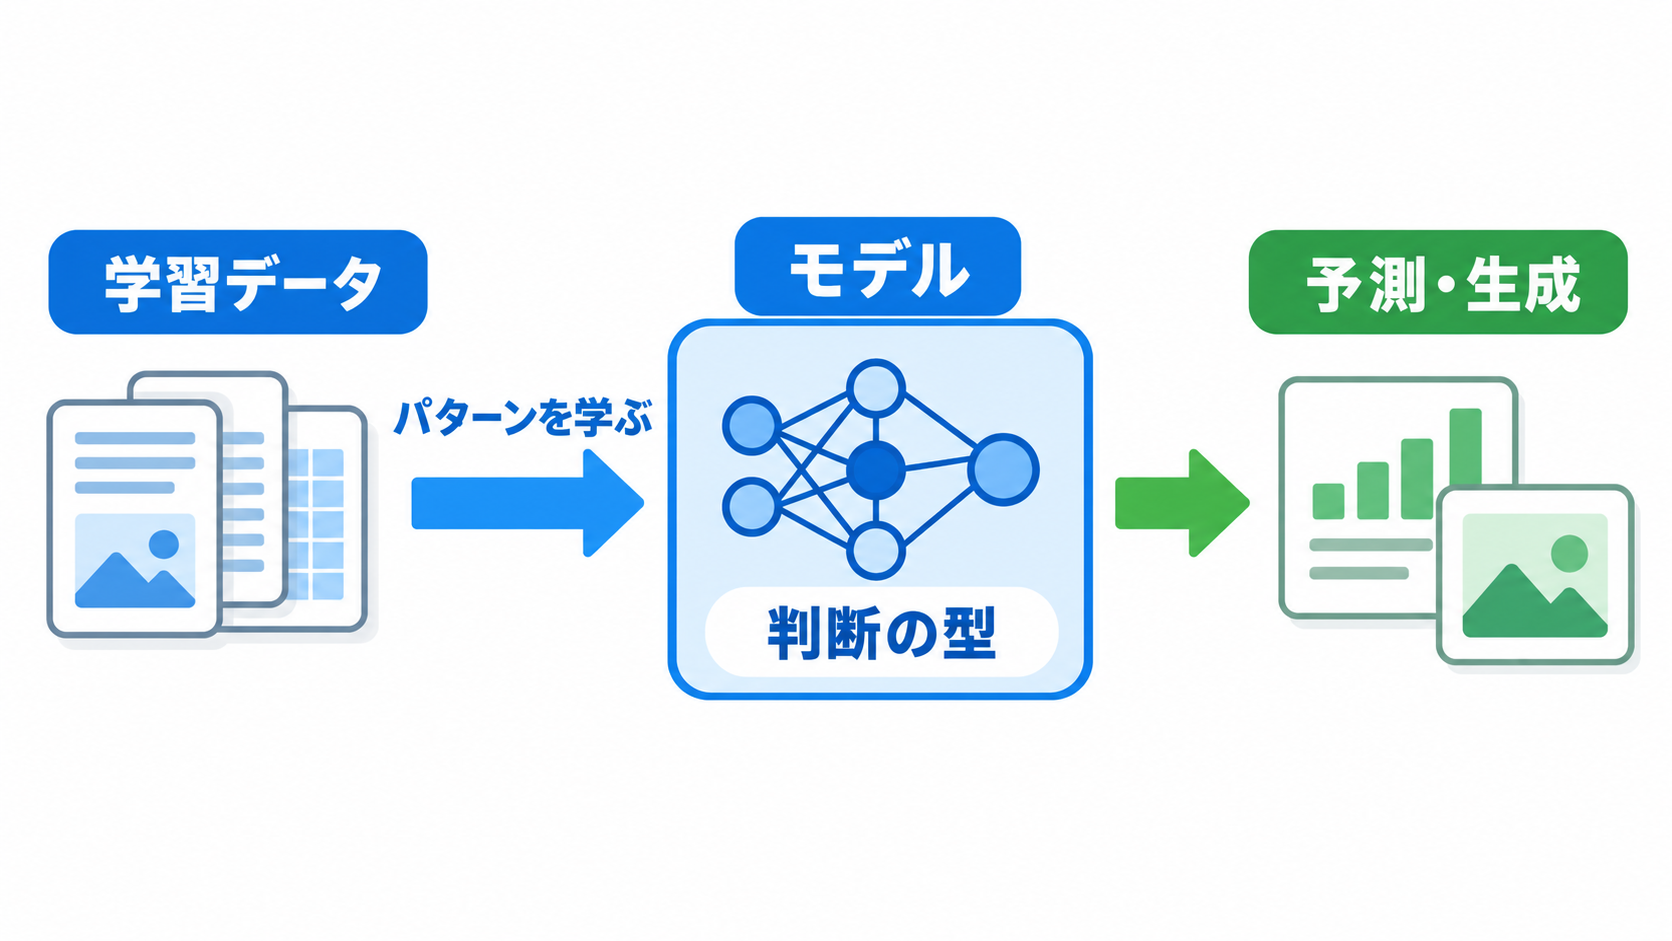
一言で表すと、AIのモデルとは、学習データからパターンを身につけ、予測や生成に使う仕組みです。Google Cloudは、機械学習モデルを、アルゴリズムを学習データに適用した結果としてプログラムが学んだものだと説明しています(出典: Google Cloud)。ここで大切なのは、モデルが学習に使ったデータそのものではなく、データから得た規則性が反映された仕組みだという点です。
たとえば、文章を扱う生成AIでは、入力された言葉の並びを手がかりに、続きとして適すると予測した内容を組み立てます。画像を扱うモデルなら、指示に対応する画像の特徴や関係をもとに出力します。生成AIは、学習データを単純に取り出すだけではなく、その簡略化された表現を利用して、元のデータと似ていても同一ではない新しい内容を作るとIBMは説明しています(出典: IBM)。
モデルという言葉を理解する目的は、専門家になることではありません。「AIが知っているから正しい」と考えるのではなく、「学習で作られた判断の型から出力している」と捉えられるようになることが実用上の利点です。この見方を持つと、自然な文章でも確認が必要な理由や、同じ質問に異なる答えが返る可能性を理解しやすくなります。モデルはAIサービスの能力を支える中心部分ですが、それだけでサービス全体を表す言葉ではありません。
練習結果が残った「判断の型」というたとえ
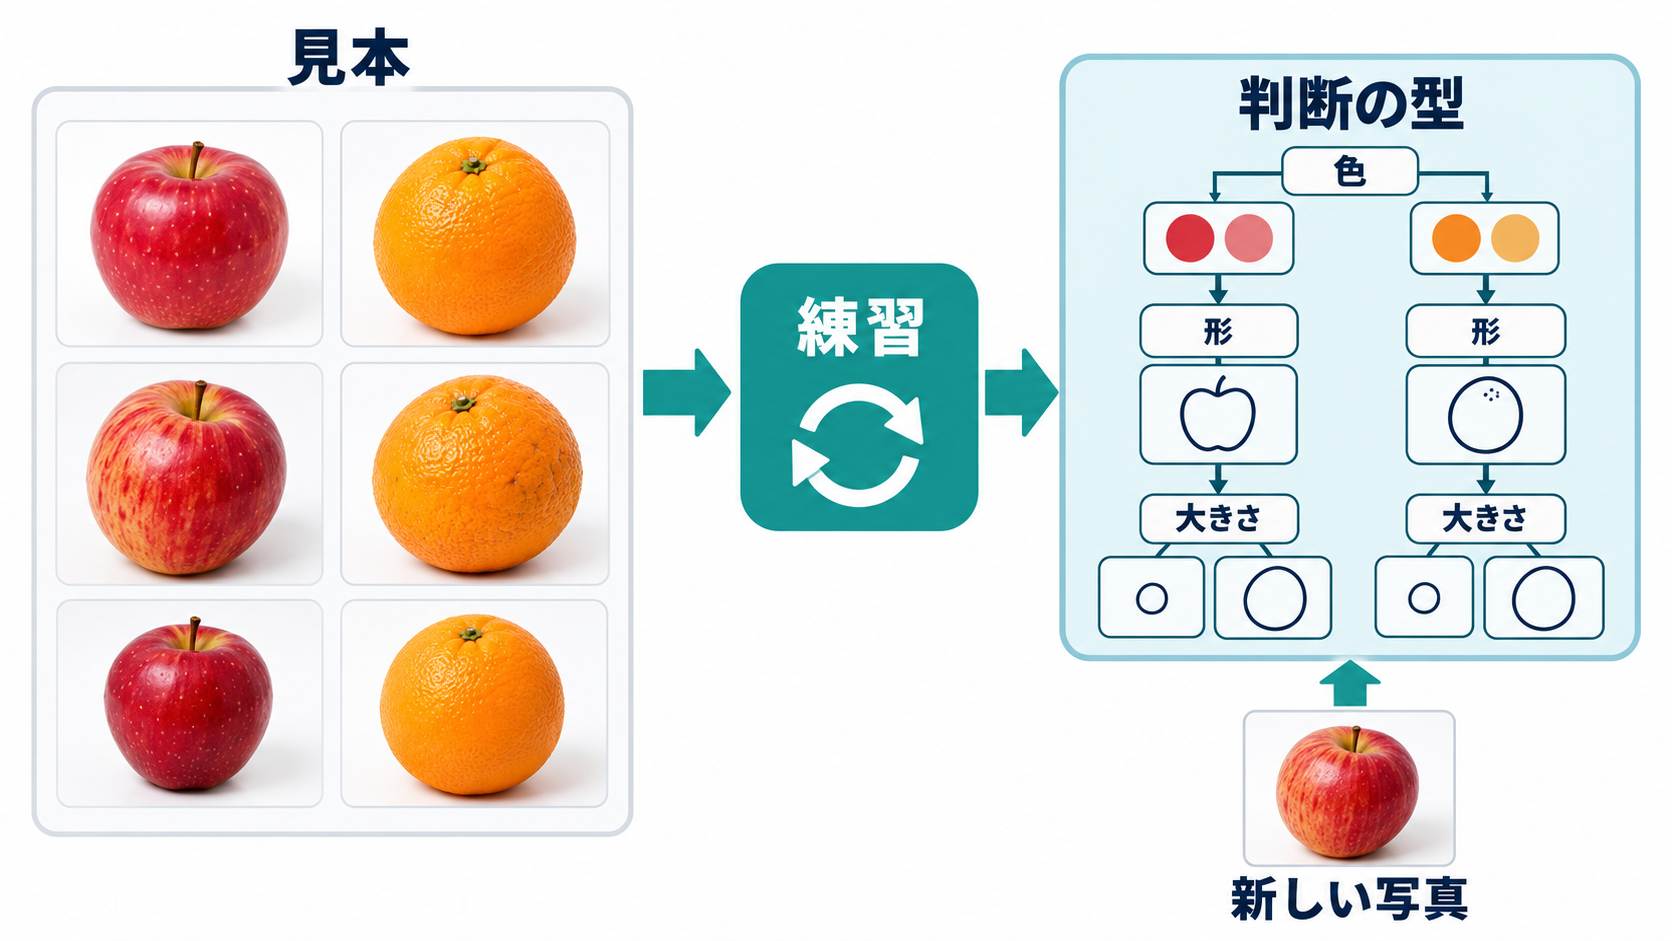
モデルを身近なものに置き換えるなら、何度も練習した結果が反映された「判断の型」と考えると分かりやすいでしょう。たとえば、果物の仕分けを練習する場面を想像してください。練習用の写真を見ながら、色、形、大きさなどの傾向を確かめていくと、初めて見る写真でも「リンゴらしい」「オレンジらしい」と判断しやすくなります。モデルに相当するのは写真の束ではなく、練習を通じて形作られた見分け方です。
このたとえには限界もあります。AIが人間と同じように果物を理解し、意味を意識して考えているという説明ではありません。機械学習は、データに含まれるパターンを利用して、特定の入力に対する予測や判断を行う技術です。Google Cloudも、機械学習をAIの一部と位置づけ、データから知識を取り出して特定の仕事を行うための方法として説明しています(出典: Google Cloud)。
「練習問題と答えを全部暗記している」と考えるのも正確ではありません。モデルは、学習データを一冊の資料集のように保管し、質問のたびに該当ページを開いているわけではないからです。生成モデルでは、データ中の要素やパターン、関係が数値的な表現としてモデルに反映されます。IBMの解説では、大規模な基盤モデルの学習によって、データ中の対象、パターン、関係を符号化した多数のパラメーターが形成されるとされています(出典: IBM)。パラメーターとは、入力からどのような出力を導きやすいかを左右する、調整済みの数値です。
料理にたとえるなら、学習データは練習に使った食材やレシピ、学習方法は練習の進め方、モデルは練習後に身についた作り方の傾向に近いものです。ただし、料理人の経験や意識まで備えているという意味ではありません。「材料」「練習方法」「練習後の型」を分けて捉えると、モデルという言葉の位置づけが見えやすくなります。
学習データ・学習方法・モデル・アプリの役割分担
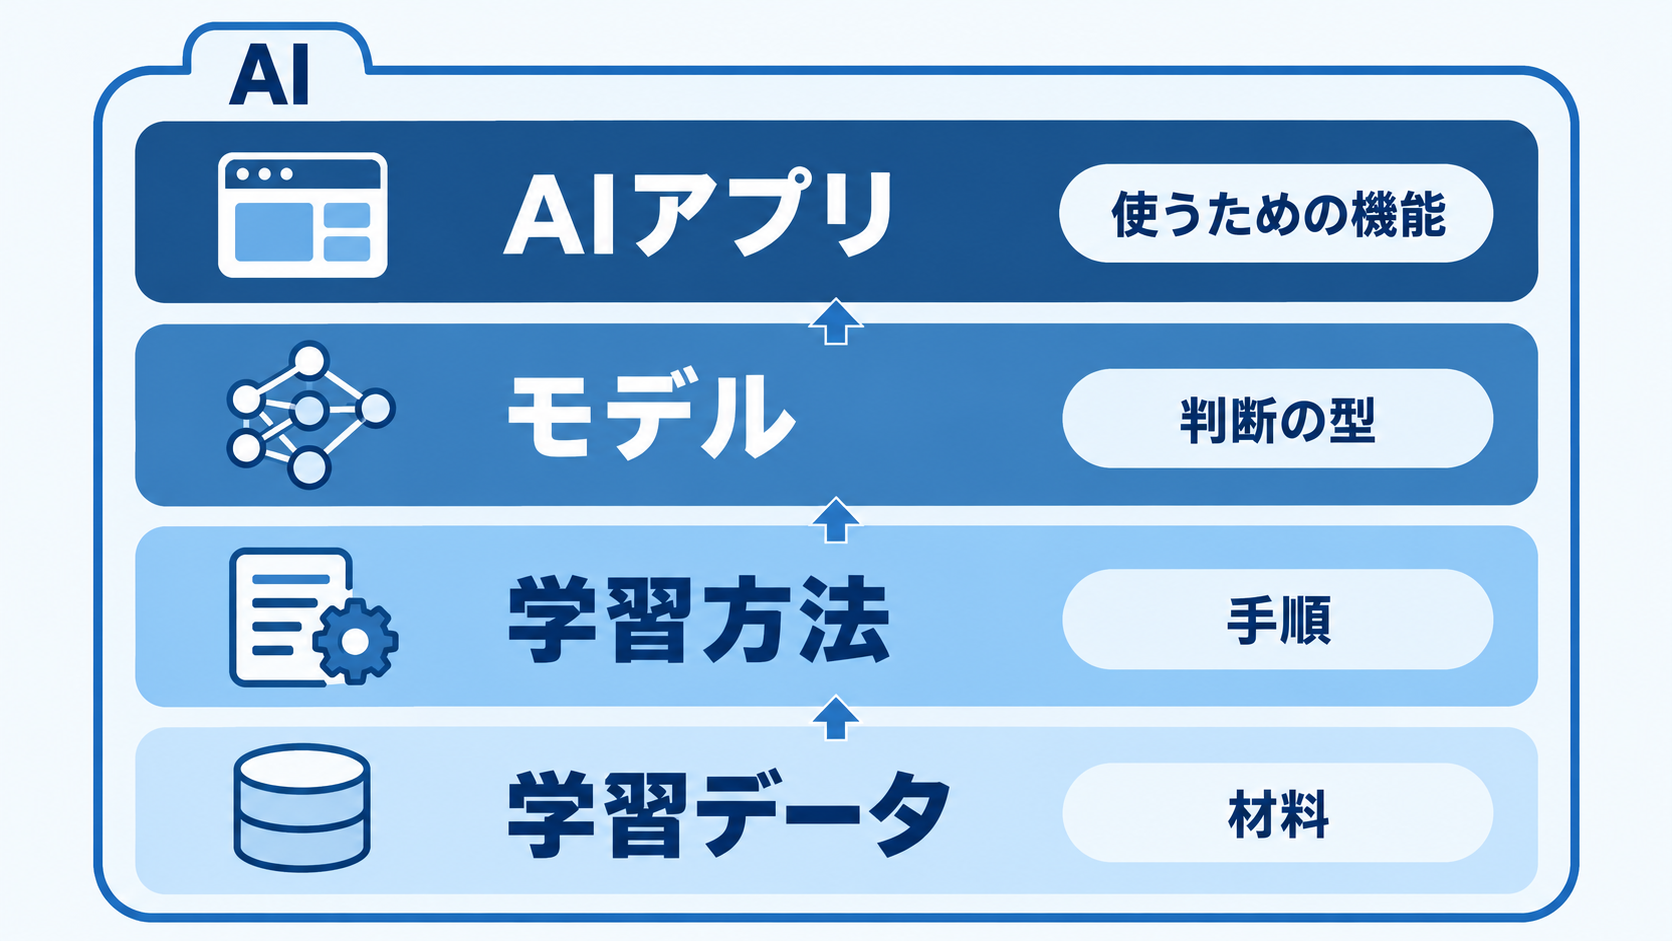
AIに関する説明が難しく感じられる原因の一つは、学習データ、アルゴリズム、モデル、アプリが同じもののように語られることです。実際には、それぞれ役割が異なります。学習データは材料であり、アルゴリズムは材料からパターンを学ぶための手順です。その手順をデータに適用した結果がモデルになり、利用者が触れる画面や機能を加えたものがAIアプリです。
| 用語 | 短い意味 | 身近なたとえ |
| --- | --- | --- |
| 学習データ | 学習に使う文章や画像などの材料です | 練習問題や見本です |
| 学習方法 | 材料からパターンを得るための手順です | 練習の進め方です |
| モデル | 学習結果が反映された予測や生成の仕組みです | 練習後にできた判断の型です |
| AIアプリ | モデルを利用者が使える形にした製品や機能です | 道具や受付を備えたサービスです |
AIは機械学習より広い概念です。IBMはAIを、人間の学習、理解、問題解決、意思決定などを模倣する能力をコンピューターや機械に持たせる技術として説明しています。機械学習はその内側にあり、アルゴリズムをデータで訓練して、予測や判断に使うモデルを作る方法です(出典: IBM)。したがって、「AIとモデルは同じものです」とまとめると、範囲が広すぎます。
AIアプリもモデルそのものではありません。チャット画面を例にすると、入力欄、会話履歴の扱い、利用上の制限、外部情報を参照する仕組みなどが、モデルの周囲に組み合わされる場合があります。同じ系統のモデルを使っていても、アプリ側の設計が異なれば、利用者が受け取る体験も同じとは限りません。反対に、一つのアプリで用途に応じて複数のモデルが使われる可能性もあります。
この区別は、サービスの評価にも役立ちます。回答が期待と違ったとき、原因をすべて「AIモデルの性能」に帰すのではなく、入力の書き方、アプリから渡された情報、モデルの得意分野、参照情報の有無を分けて考えられるからです。利用者が内部構造をすべて知る必要はありませんが、モデルがアプリの中で働く一要素だと分かれば、説明文を落ち着いて読めるでしょう。
データからモデルが作られるまでの流れ
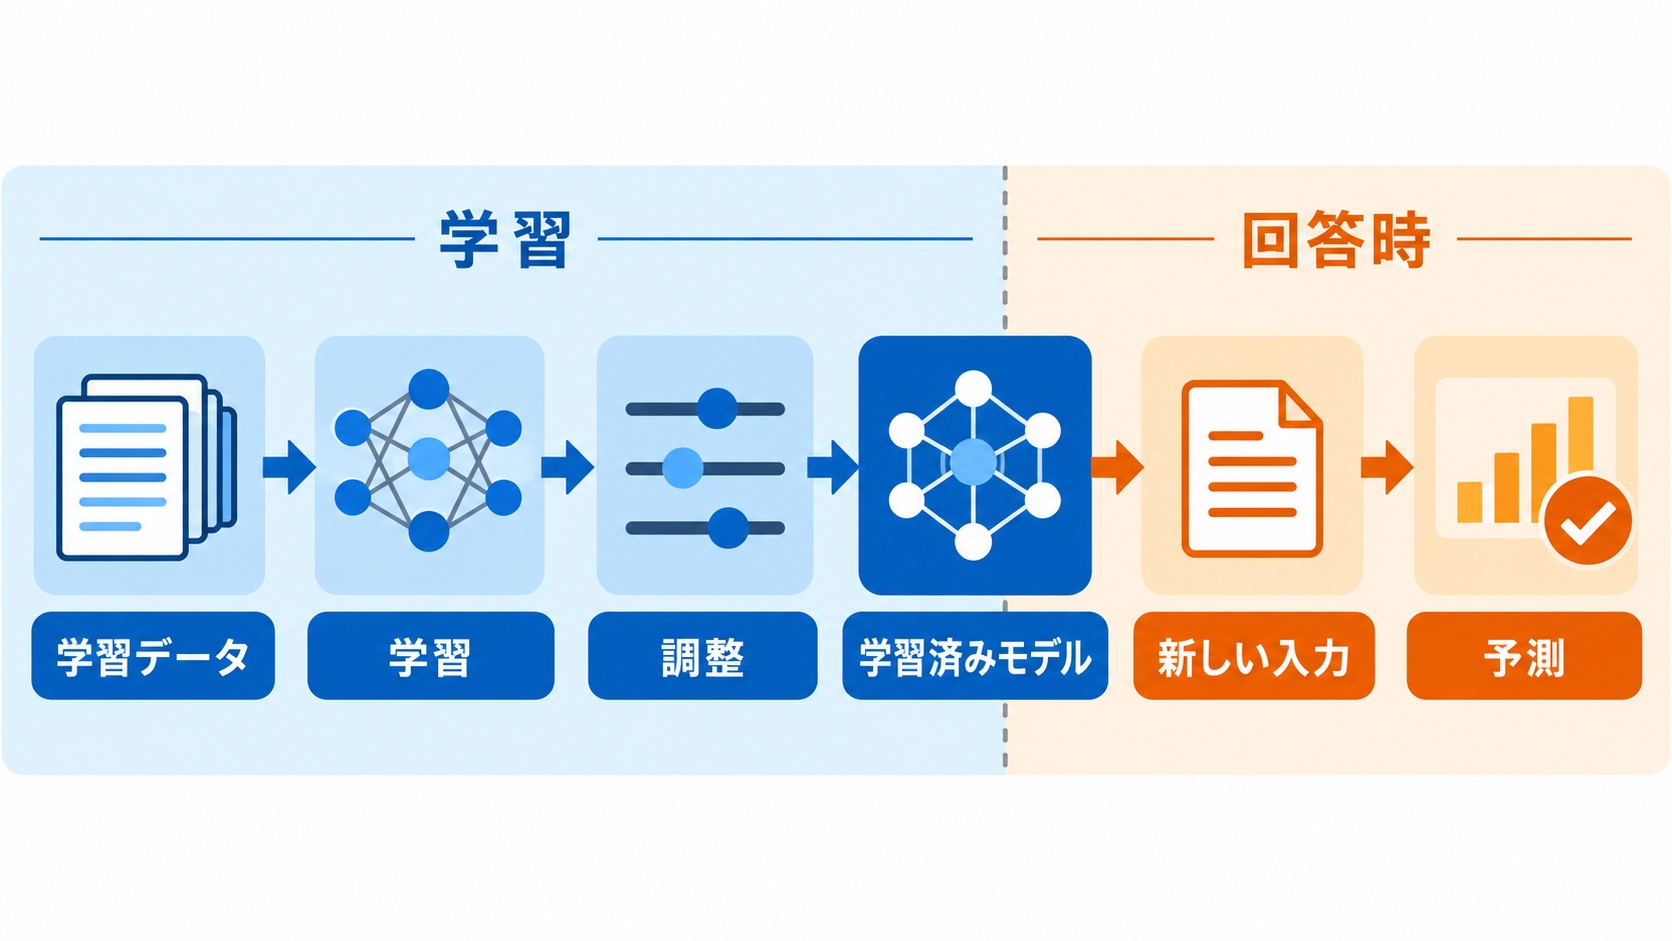
モデルが作られる過程は、「材料を集める」「学習方法を使う」「調整されたモデルを得る」という流れで捉えられます。教師あり学習と呼ばれる方法では、入力例に正解を示すラベルを付け、入力と出力の対応をモデルに学ばせます。IBMは、こうして学習したモデルが、まだ見ていない新しいデータのラベルを予測することを目標にすると説明しています(出典: IBM)。たとえば、架空の例として、迷惑メールかどうかを示した過去の文章を材料にし、新しいメールを分類するためのモデルを作る場面が考えられます。
生成AIで広く使われる基盤モデルは、大量で多様なデータを使って事前学習された大規模なモデルです。Google for Developersの用語集では、基盤モデルは幅広い依頼に対応でき、追加の微調整の土台にもなるモデルと定義されています(出典: Google for Developers)。微調整とは、事前学習済みモデルに特定用途向けの追加学習を行い、その用途に合わせてパラメーターを調整することです。
学習にはデータを与えるだけでなく、出力をどの程度よいと判断するか、誤差をどう減らすかといった設計も関わります。その結果、モデルの内部には、入力された要素同士の関係を出力へ反映するための数値が形成されます。モデルはこの数値的な状態を使うため、学習データをそのまま一覧表として抱えた「検索可能な倉庫」とは性質が異なります。
また、学習量が多ければ、あらゆる用途で必ず優れたモデルになるわけではありません。どのようなデータを使ったか、何を目標に調整したか、どの種類の入力と出力を扱うかによって、向き不向きが生じます。Google Cloudは、機械学習には決定木、回帰、クラスタリング、ニューラルネットワークなど多様な方法があり、それぞれ適する問題が異なると説明しています(出典: Google Cloud)。モデルを比べる際は、単純な大きさだけでなく、「何のために作られた仕組みなのか」を見る必要があります。
この学習工程は、利用者が質問を入力して回答を受け取る工程とは別です。製品ごとの提供条件やデータの扱いは個別に確認すべきですが、少なくとも、質問を一度送っただけで基盤モデル全体がその場で作り直される、と考えるのは適切ではありません。学習と回答を分けることが、モデルを理解する大きな手がかりになります。
回答するときにモデルがしていること
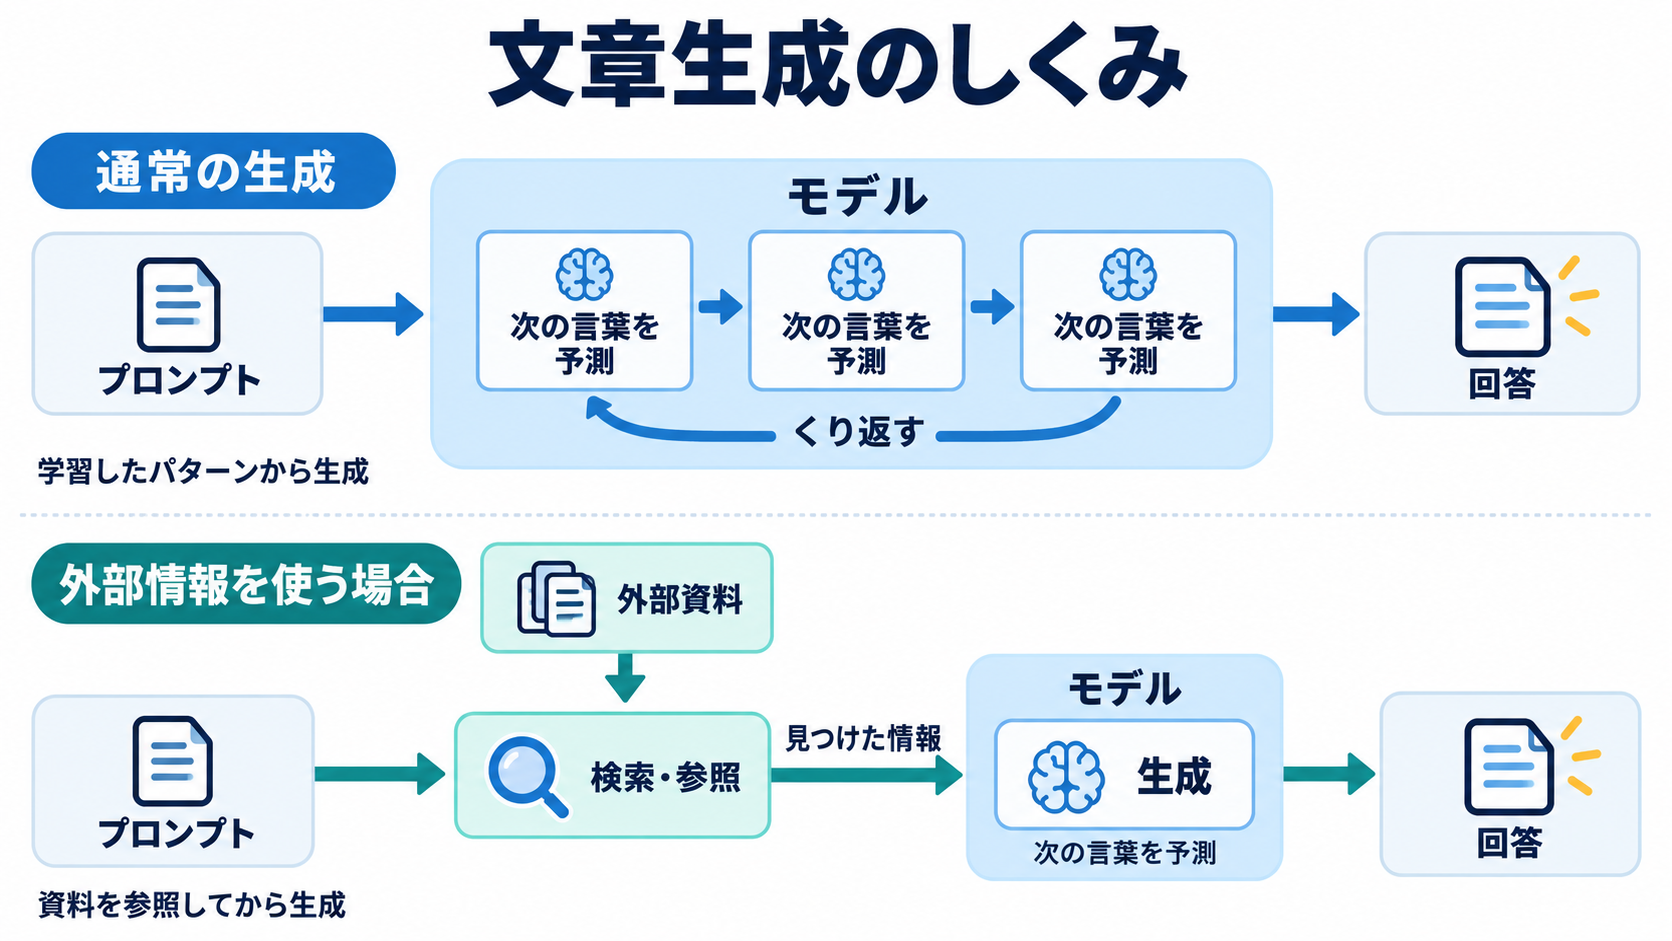
学習済みモデルを入力に適用して予測や生成を行う段階は、一般に推論と呼ばれます。文章生成モデルの場合、利用者が入力した依頼、つまりプロンプトを手がかりに、続きとして適する言葉の並びを予測します。Google for Developersは、自己回帰型の言語モデルについて、それまでに予測したトークンをもとに次のトークンを予測すると説明しています。トークンとは、モデルが文章を処理するときの文字や単語に近い単位です(出典: Google for Developers)。
ここで、モデルが万能な答え集ではない理由が見えてきます。出力は、保管された正解文を一件ずつ検索して表示するものとは限りません。学習で形成されたパターンと、現在与えられた入力をもとに内容を組み立てるため、読みやすく自然な文章でも、事実として正しいとは限らないのです。もっともらしい誤情報を生成する現象は、一般にハルシネーションと呼ばれます。
検索との違いも同じ視点で整理できます。検索は、条件に合うウェブページや文書などの情報源を見つけることが中心です。生成モデルは、入力に応じた出力を作ることが中心になります。外部の情報源を検索して生成に組み合わせるRAGという方法もあり、IBMはこれを、学習データの外にある関連情報を利用して生成AIアプリの正確さや関連性を高める技術として紹介しています(出典: IBM)。ただし、外部資料を参照する機能があるかどうか、その出典が表示されるかどうかは、個別のサービスで確認しなければなりません。
同じモデルでも、プロンプトの情報量や条件が変われば、出力も変わり得ます。たとえば「案内文を書いてください」だけの場合と、「初めて来店する人向けに、予約時間と持ち物を含む案内文を200字程度で提案してください」と入力する場合では、後者のほうが目的と形式を判断する材料が多くなります。これは架空の入力例であり、必ず期待どおりになるという意味ではありません。重要な内容は、元資料や信頼できる情報源と照合する姿勢が必要です。
明日から「モデル」という言葉を見るための三つの視点
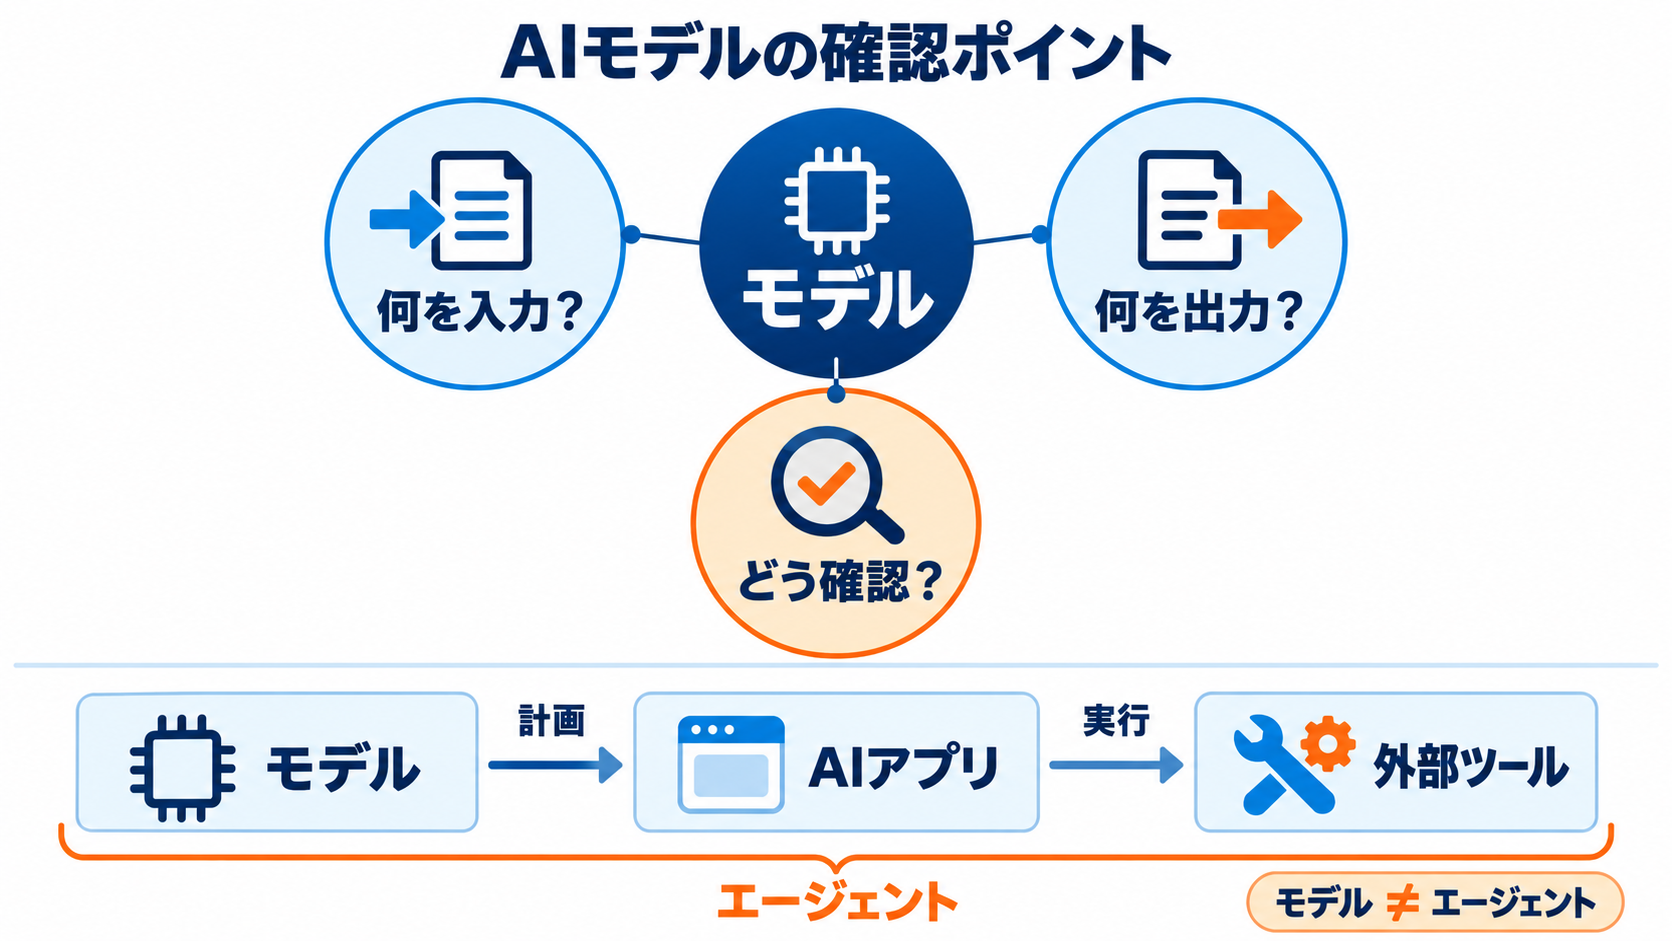
AIサービスの紹介でモデルという言葉を見かけたら、名前や新しさだけで判断せず、「何を入力できるか」「何を出力するためのものか」「どのような確認が必要か」という三つの視点を持つと理解しやすくなります。文章、画像、音声など、扱う内容が違えば、モデルに期待される役割も変わります。目的に合うかどうかは、モデル名の印象だけでは決まりません。
仕事で文章案を作る場面なら、モデルの出力を完成品ではなく下書きとして扱う方法が考えられます。提案例として、社内連絡の目的、読者、含めたい事実、避けたい表現を入力し、返ってきた文章を担当者が確認します。このとき、日付、固有名詞、数値、社内ルールは元資料と照合します。モデルが自然な文章を作れることと、その内容が組織の事実に合っていることは別だからです。
もう一つの誤解は、モデルが自分だけで画面操作や予約、送信まで行うという考え方です。AIエージェントは、利用者に代わって入力を判断し、計画を作り、利用可能な外部ツールを呼び出して行動するソフトウェアとして定義されています(出典: Google for Developers)。IBMも、生成AIモデルが内容を作ることを中心とするのに対し、エージェントは他のツールとやり取りして仕事の完了を目指すと説明しています(出典: IBM)。つまり、モデルはエージェントを支えることがありますが、モデルとエージェントは同義ではありません。
モデルを理解した後の具体的な一歩は、普段使うAIサービスの説明を開き、「モデル」「データ参照」「出典」「確認方法」に関する記載を探すことです。すべての仕組みを覚える必要はありません。出力を見たときに、「これは答えの保管庫から取り出したものではなく、学習で作られた判断の型による予測や生成です」と思い出せれば、任せてよい部分と人が確認すべき部分を分けやすくなるでしょう。
参考情報
以下の資料は2026年11月1日に取得しました。取得日は資料の公開日とは異なります。IBMの資料には、2024年8月9日公開、2026年10月2日更新と表示されています。
- What Is Artificial Intelligence (AI)?
- AI vs. Machine Learning: How Do They Differ?
- Machine Learning Glossary: Generative AI