
2026/11/02
AIニュース
インドが描く「データを動かさないAI」 DEPAが企業の学習データ統制を変える
病院や銀行のデータを外へ持ち出さずにAIを育てる構想
病院には診断や治療に関する記録があり、銀行には融資判断や取引に関する情報があります。生成AIの開発にとって価値の高いデータですが、別の企業へ一括提供すれば、個人情報の漏えいや目的外利用、知的財産の流出といった問題が生じかねません。データを保有する組織が管理権を失う懸念もあり、機密性の高い業界ほどAI学習への利用をためらいやすい状況です。
インド電子情報技術省(MeitY)が示した「AI学習向けData Empowerment and Protection Architecture」、通称DEPAは、この対立をデータ移転ではなく計算環境の設計によって解こうとしています。インド政府の首席科学顧問であるアジャイ・クマール・スード教授は、その考え方を「データがモデルへ移動するのではなく、モデルがデータの場所へ移動する」と表現しています。ここでいう移動とは、データを開発会社のサーバーへコピーする代わりに、学習処理を管理された環境内へ持ち込むという意味です。
構想の背景には、海外で開発された汎用モデルだけでは、インド固有の社会課題や言語、制度に十分対応しないのではないかという問題意識があります。同時に、海外の大手テクノロジー企業へ国内データを広く開放せず、保有者が利用条件を決められる状態を維持する狙いもあります。DEPAの中心は単なる国産AIの振興策ではなく、組織がデータの管理権を保ったまま、複数主体によるモデル開発へ参加できる仕組みを作ることにあります。企業にとって注目すべき点も、データを共有するか否かの二択ではなく、どの条件なら安全に計算へ参加させられるかという発想への転換です。
TDP・DEP・TDCを分離する学習フロー
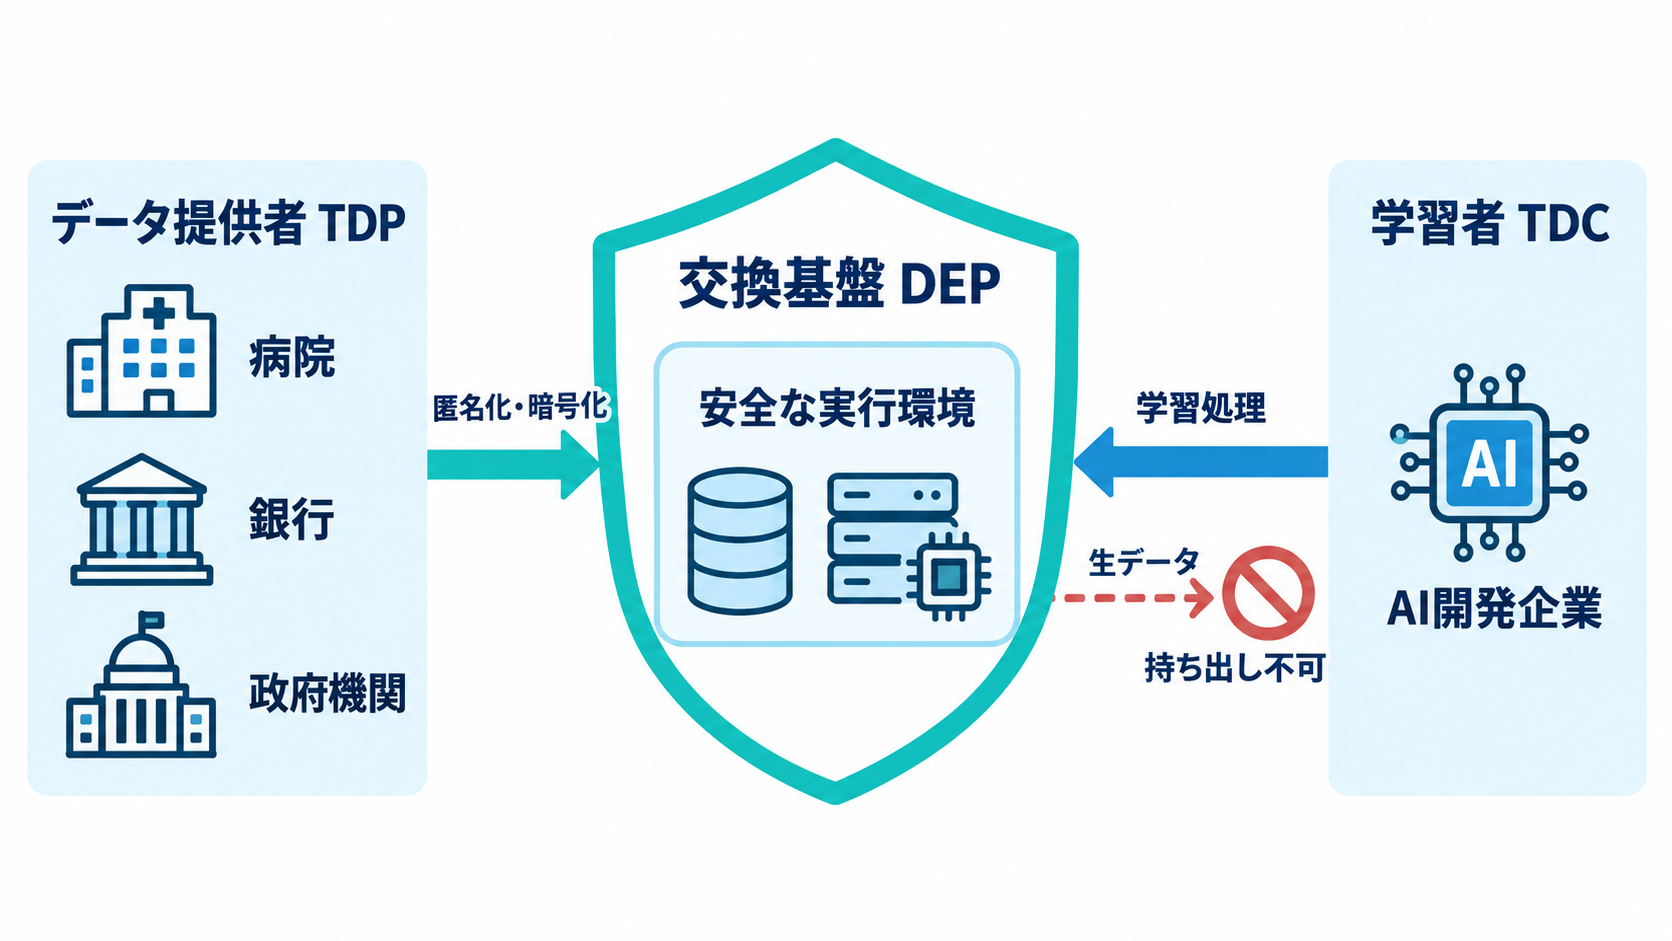
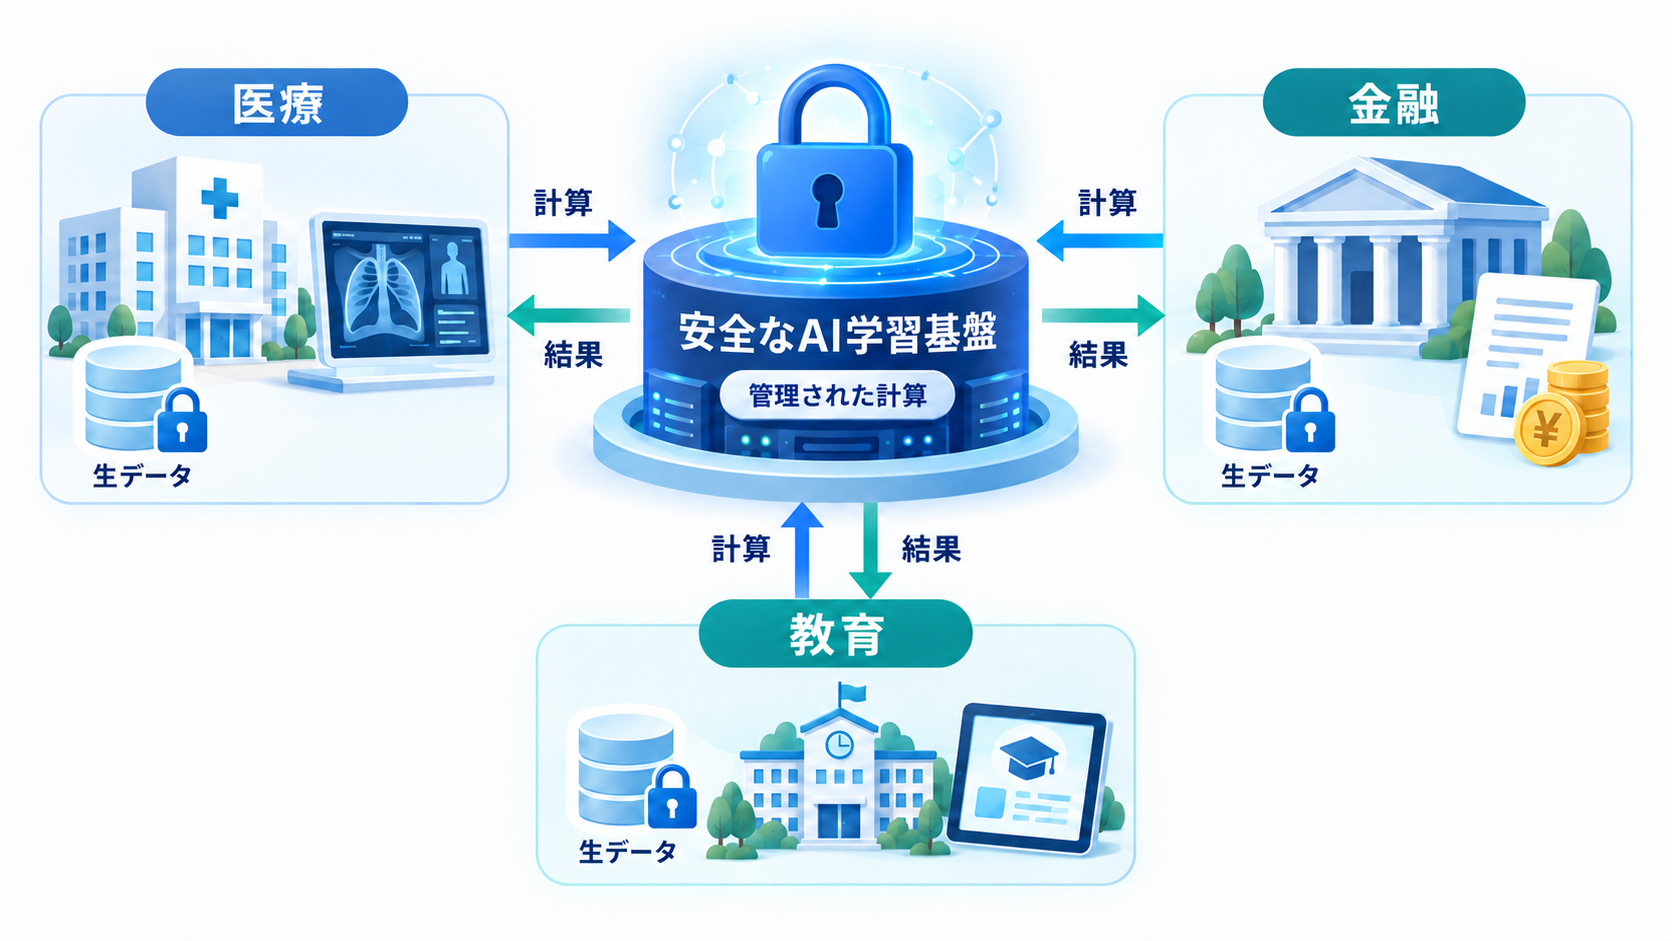
DEPAでは、データを提供する組織、処理環境を運営する主体、モデルを学習させる利用者を分けています。病院、銀行、政府機関などは「Training Data Provider(TDP)」となり、匿名化および暗号化したデータを「Data Exchange Platform(DEP)」へ共有します。モデル開発者に相当する「Training Data Consumer(TDC)」は、DEP上の管理された環境へアクセスし、許可された条件の範囲で学習処理を実行します。
| 主体 | 主な役割 | 管理する対象 |
| --- | --- | --- |
| TDP | 学習用データを提供します | 利用目的やアクセス条件を指定します |
| DEP | 隔離された計算環境を運営します | 暗号化、実行制御、監査記録を担います |
| TDC | 許可されたデータでモデルを学習します | 学習処理とモデル開発を担当します |
重要なのは、TDCが生データを自由にダウンロードして自社環境へ持ち帰る仕組みではないことです。TDPが定めた利用規則はDEPによって適用され、TDCの処理はハードウェアを基盤とするセキュアデータ環境内で行われます。学習に必要な計算は許可しても、データそのものへの無制限な閲覧や複製は認めないという境界を設けています。データ保有者とモデル開発者の間に、規則を技術的に執行する層を置く設計です。
この分離は、複数の組織が関わるほど意味を持ちます。単独の病院や銀行だけでは偏りや量の不足が生じる場合でも、各組織が管理権を手放さずに参加できれば、より多様なデータを学習へ利用できる可能性があります。ただし、インド政府は既に複数のデータ交換基盤を運営しているものの、それらをDEPAの要件に対応させるためにどれほどの作業が残っているかは明らかにしていません。示されているのは完成済みサービスの利用手順ではなく、制度と計算基盤を組み合わせたアーキテクチャの方向性だと捉える必要があります。
暗号化だけに依存しない多層の保護策
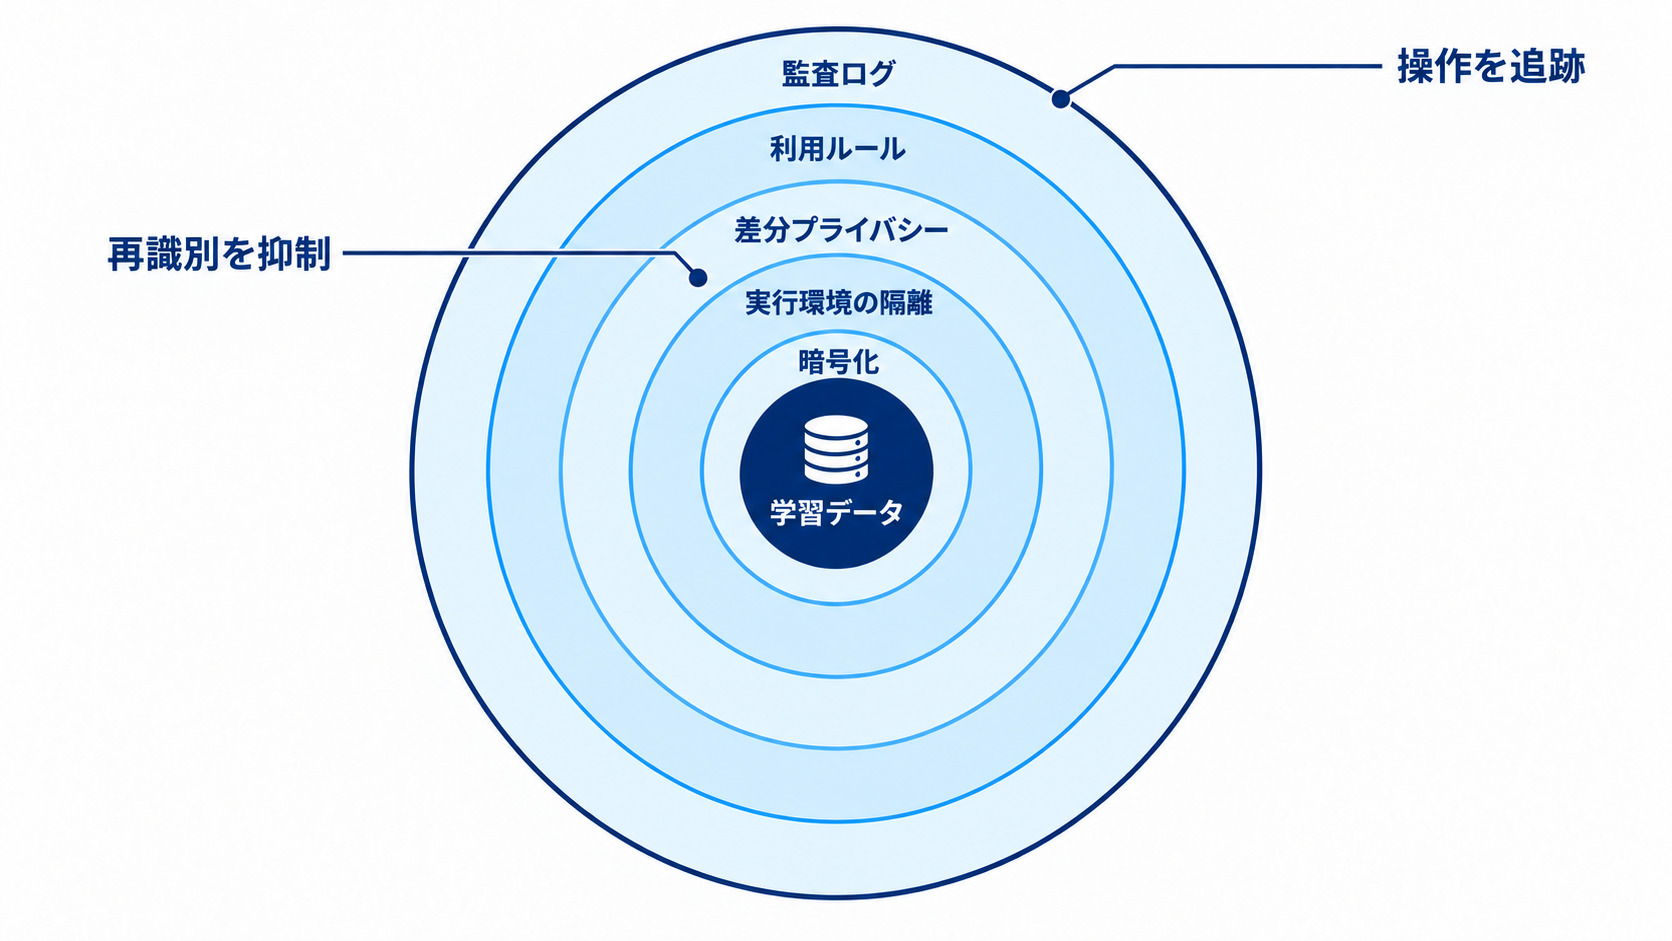
DEPAが想定するセキュアデータ環境では、データを暗号化し、処理中もほかの領域から隔離します。保存時や通信時だけでなく、学習処理が実行される段階まで保護対象に含める点が特徴です。ハードウェアを使った隔離は、通常のアクセス権設定より深い層で実行環境を分け、開発者や基盤運用者がデータを直接参照できる範囲を狭めるために使われます。
匿名化されたデータであっても、ほかの情報との組み合わせによって個人が推測される危険を完全にはなくせません。そのため、DEPAは差分プライバシーの技術を体系的に適用し、モデルが特定個人の情報を学習したり、出力を通じて明らかにしたりする可能性を抑える方針です。差分プライバシーとは、集計結果や学習処理に制御されたノイズを加え、ある個人のデータが含まれているかどうかを判別しにくくする考え方です。保護を強めるほどモデルの有用性に影響する場合もあるため、実運用ではデータの用途と許容リスクに応じた調整が欠かせません。
環境内の操作は変更できない形で記録し、後から監査できるようにします。誰が、どのデータへ、何の目的でアクセスし、どの処理を実行したかを追跡できれば、規則違反が疑われた際の検証や責任分界に役立ちます。暗号化、隔離、差分プライバシー、利用規則、監査ログを重ねることで、一つの防御策が破られただけでは全体が崩れない構成を目指しています。
ただし、この仕組みだけでAIの安全性全般を保証できるわけではありません。入力データが偏っていればモデルにも偏りが反映されるおそれがあり、学習後のモデルが想定外の目的で使われる問題も別途管理する必要があります。DEPAが直接扱う中心領域は、データを学習へ投入するまでの許可と処理環境です。モデルの品質評価、出力監視、配備後の用途制限については、企業や規制当局が補完的な統制を設けなければなりません。
医療・金融・教育で想定される価値
インド政府が用途として挙げる一つが医療です。医療情報は病院や行政機関ごとに分散しやすく、機密性も高いため、横断的なAI学習へ回すことが難しいデータです。DEPAを通じて断片化した情報を安全に利用できれば、AIによる診断支援、創薬、公衆衛生管理などへつなげられるとMeitYは見込んでいます。ただし、これは構想が目指す利用像であり、具体的な成果が既に得られたことを意味するものではありません。
金融分野では、多数の銀行が持つ異なるデータを安全に組み合わせることで、従来の審査では信用力を十分に示せなかった個人や零細・中小企業を評価しやすくする考えです。MeitYは、正規の信用供与を受けにくい4億人とMSME、すなわち零細・中小企業への金融アクセス拡大につながる可能性を示しています。ここでの焦点は、すべてのデータを一つの巨大なデータベースへ統合することではありません。金融機関が保有する情報を手元に残しながら、合意された目的の計算だけを共同で実施する点にあります。
教育では、データ形式やシステムの違いを越えて学習履歴を活用し、個別最適化された教育や持ち運び可能な技能証明へ結び付ける構想です。MeitYの文書は、2億5,000万人の学生と290億ドル規模のEdTech市場を対象として挙げています。医療、金融、教育に共通するのは、一つの機関だけでは全体像を把握できず、共有したくてもプライバシーや競争上の理由からデータを外へ出しにくいことです。
企業の視点では、人数や市場規模の大きさだけに目を向けるべきではありません。DEPAが提示している事業上の価値は、これまで利用できなかったデータへ無条件にアクセスできることではなく、複数組織が用途を限定して共同学習できる可能性にあります。その価値を実現するには、データ形式の標準化、品質管理、参加組織間の責任分担、学習結果の利用権などを決める必要があり、セキュアな計算環境だけで完結する取り組みではありません。
デジタル公共インフラからAI公共基盤へ
DEPAは、インドが推進してきたデジタル公共インフラ(DPI)の延長線上にあります。DPIとは、決済、本人確認、文書共有など、社会や企業が共通して利用できるデジタル基盤を公共的な発想で整備する取り組みです。インドでは銀行間の即時決済を支えるUnified Payments Interface(UPI)が代表例として知られています。個別企業が利用者とデータを囲い込むのではなく、共通仕様の上で多様な事業者がサービスを作れる環境を目指してきました。
配車分野では、手数料ゼロを掲げるBharat TaxiもDPIの考え方を示す事例として挙げられています。こうした政策には、海外の大手テクノロジー企業だけが市場とデータを支配する状態を避け、国内の企業や公共機関にも競争と開発の余地を残す意図があります。DEPAは、その対象を決済や配車からAI学習へ広げる試みと位置付けられます。計算資源だけを国内に置くのではなく、誰がデータの利用条件を決め、誰が監査できるかまで公共基盤の設計対象に含めています。
インド政府はDPIを国内政策にとどめず、友好国へ提供する外交手段としても用いてきました。DEPAについても、世界銀行や国連が進める包摂的で責任あるAIの議論に対するインドの貢献と説明しています。複数国の組織が生データを一か所へ集めずに共同研究できれば、国境を越えた科学協力に利用できるという見立てです。
ここには、AIを特定企業の製品としてだけでなく、データ提供者、計算基盤、監査機関、モデル開発者が参加するエコシステムとして捉える姿勢があります。海外製モデルを排除する構想というより、参加するモデル開発者に国内側の利用条件を守らせる共通層を作ろうとしている点が重要です。DEPAが実際に広く採用されれば、AI基盤の競争軸はモデル性能や計算費用だけでなく、データ主権と監査可能性にも広がると考えられます。
実装段階で問われる運営責任と実効性
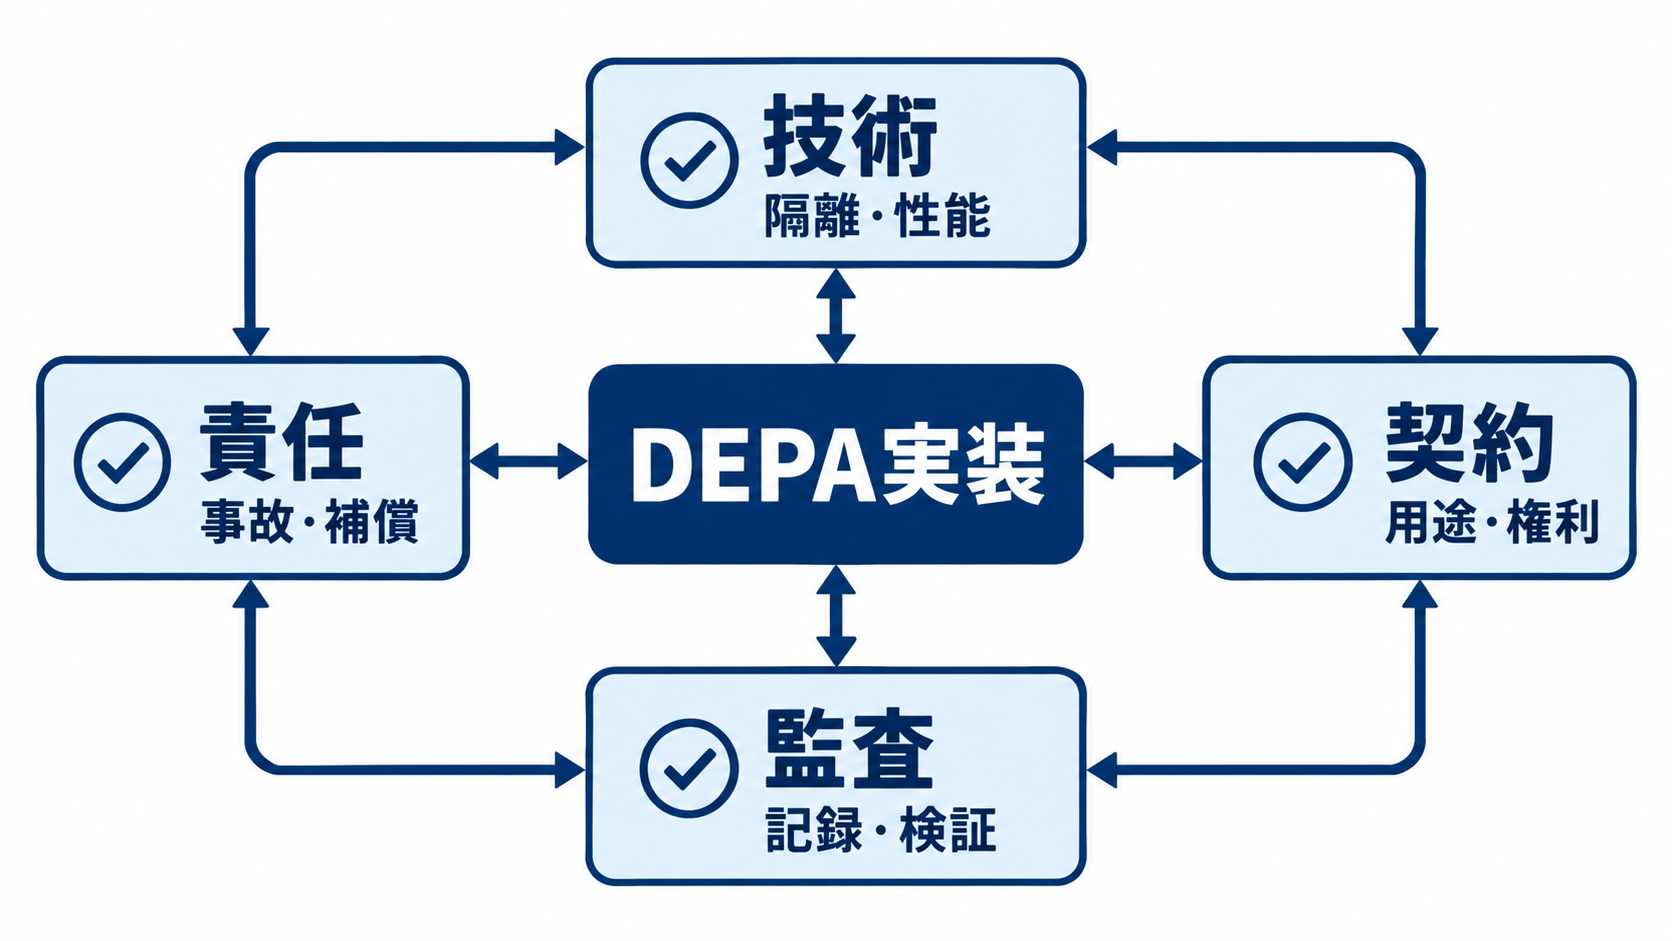
設計思想が明確でも、参加者が安心して使える制度になるかどうかは運用で決まります。現時点では、既存のデータ交換基盤をDEPAへ適合させるために必要な作業量、具体的な提供開始時期、参加費用などの詳細は明らかにされていません。企業が導入可能性を判断するには、概念図だけでなく、技術仕様、認証方法、障害発生時の責任、監査を担当する組織などを確認する必要があります。
第一の論点は、データ提供者が指定した条件をDEPがどこまで確実に執行できるかです。許可した学習回数を超えていないか、別のモデル開発へ転用されていないか、出力されたモデルから機密情報を推測できないかを検証する仕組みが求められます。監査ログが変更不能であっても、記録すべき操作の定義が不十分なら、問題の全体像を再現できません。ログを閲覧できる主体や保存期間、違反を検知した後の措置も決めておく必要があります。
第二の論点は、保護と実用性の均衡です。強い匿名化や差分プライバシーは個人の特定リスクを下げますが、分析に必要な特徴まで失わせる可能性があります。ハードウェアによる隔離にも、対応できる計算基盤、性能、運用コストという制約があります。保護技術の名称が並んでいるだけで安全と判断せず、対象データと脅威を定義し、その対策が実際に機能するかを試験する姿勢が欠かせません。
事業面では、学習後に生まれたモデルの権利や利益配分も課題になります。複数機関のデータが性能向上に貢献した場合、モデルを誰が利用できるのか、提供者はどのような対価を得るのか、誤った出力による損害を誰が負うのかを事前に定めなければなりません。DEPAはデータ移転に伴う危険を減らす有力な枠組みですが、契約、組織統治、品質保証まで自動的に解決するものではありません。実証段階では、技術検証と同じ重さで運営モデルを評価する必要があります。
日本企業が始めるべきデータ境界の棚卸し
日本企業にとってDEPAの考え方は、インド市場へ進出する場合だけに関係するものではありません。製造、医療、金融、物流などでは、企業や業界をまたいでデータを利用できればAIの精度向上が期待できる一方、顧客情報、営業秘密、工場の稼働情報を外部へ渡すことには慎重にならざるを得ません。「データを提供するか、AI開発を諦めるか」という選択を避け、データの所在を変えずに許可した計算だけを受け入れる発想は、国内の共同開発にも応用できます。
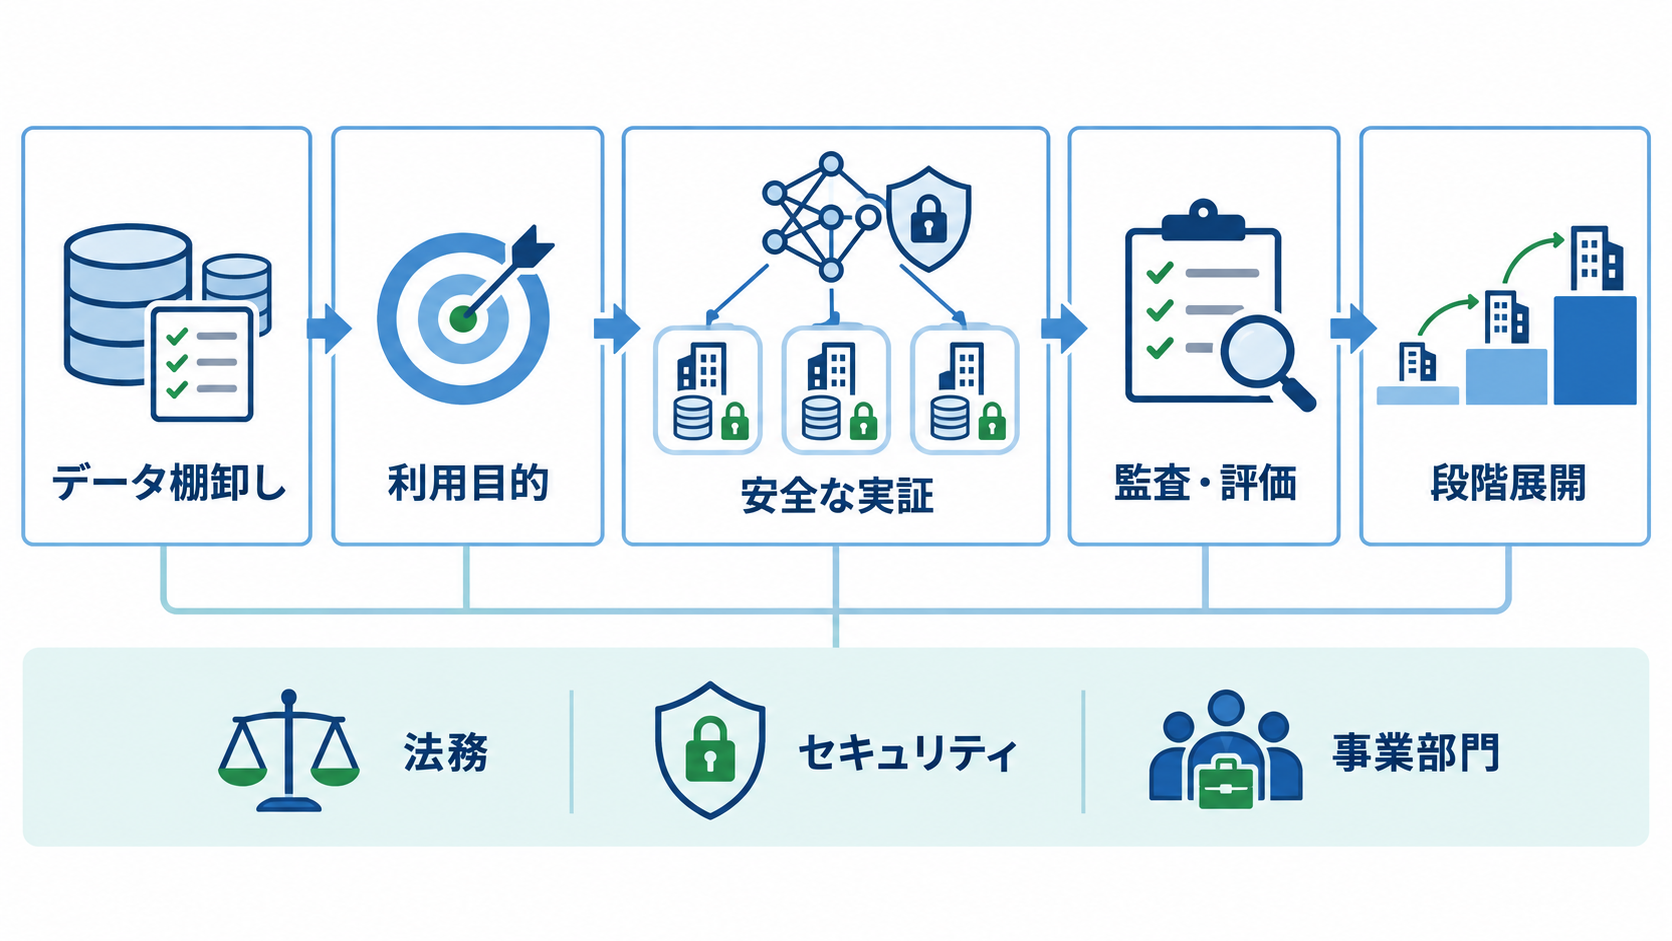
検討の出発点は製品選定ではなく、データ境界の棚卸しです。どのデータを誰が管理しているのか、個人情報や営業秘密が含まれるか、何の目的なら利用を認められるか、学習後に残るモデルを誰が扱えるかを整理します。その上で、データをコピーせずに実行環境へ処理を持ち込めるか、アクセス制御と監査ログで契約条件を検証できるかを確認します。匿名化済みという説明だけで判断せず、再識別やモデルからの情報抽出を想定した試験も必要でしょう。
共同学習を計画する企業は、対象を限定した実証から始めるのが現実的です。個人を直接識別しないデータセットと明確な業務課題を選び、参加者、利用目的、評価指標、終了後のデータとモデルの扱いを合意します。セキュリティ部門だけに任せず、法務、データ管理、事業部門、モデル開発担当が同じ設計を確認することも欠かせません。技術的にアクセスできる状態と、契約上利用してよい状態を一致させる必要があるためです。
DEPAの進展を追う際は、参加組織の数や政策上の目標だけでなく、利用規則が技術的に執行された事例、監査結果、データ提供者が条件を変更または撤回できる仕組みに注目するとよいでしょう。自社でも、共有を全面禁止しているデータの中に、計算環境と用途を限定すれば利用できるものがないかを一つ選び、管理条件を書き出すところから始められます。それが「モデルをデータの場所へ動かす」という考え方を、自社のAI戦略へ落とし込む最初の一歩になります。